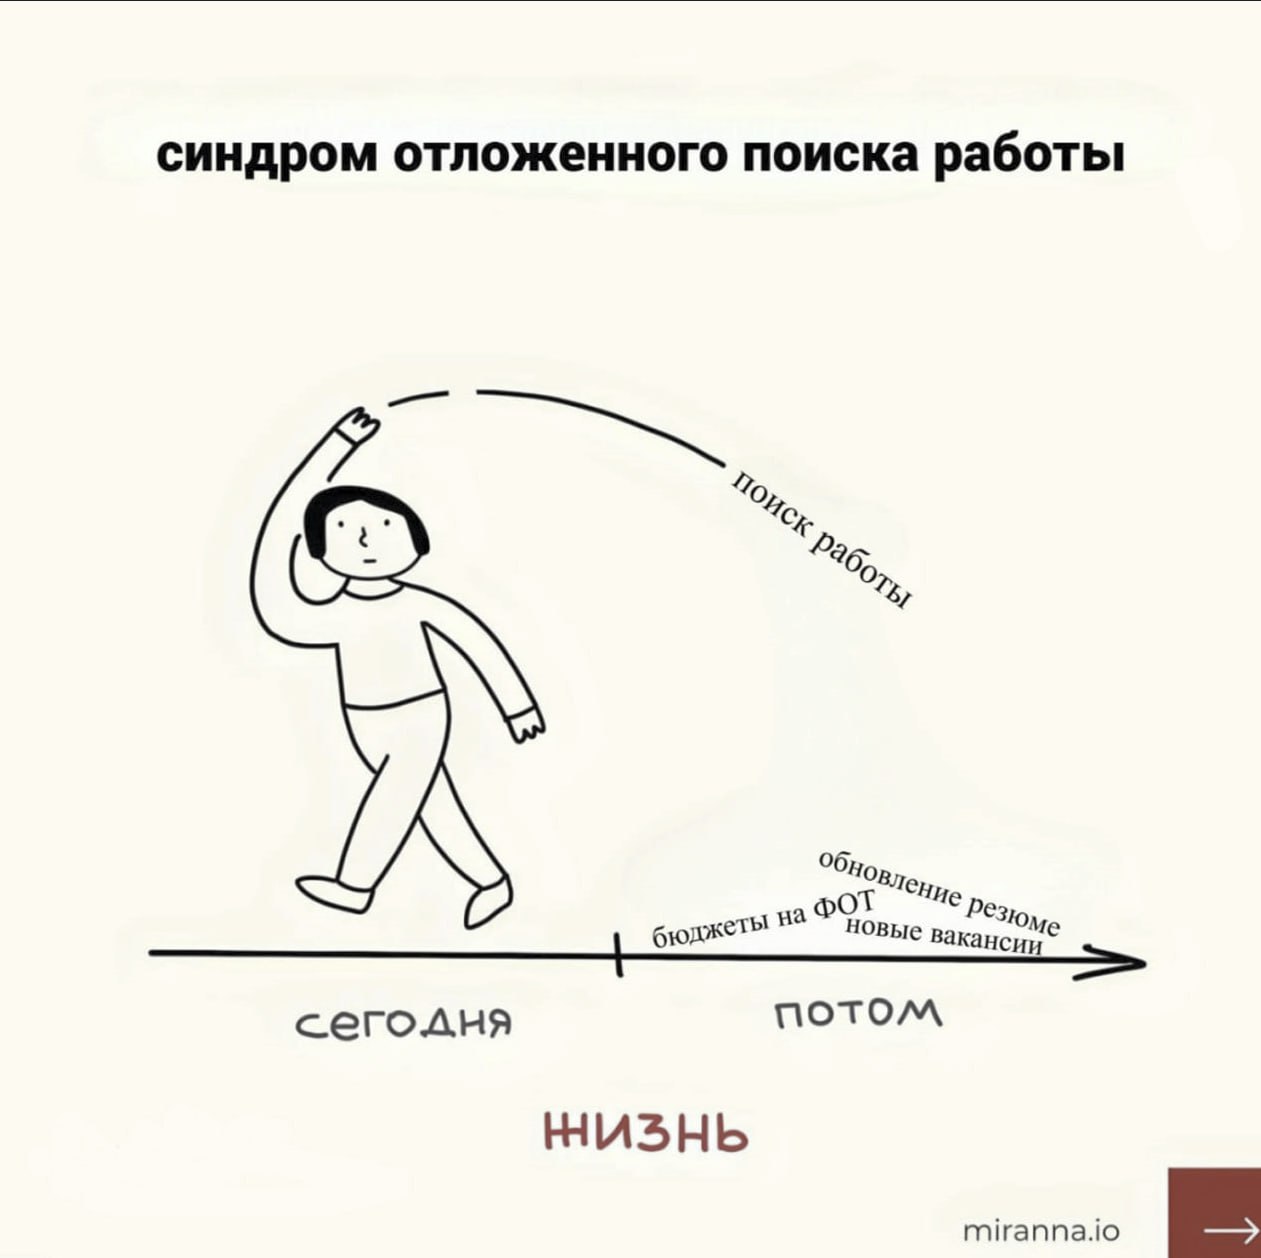
Обратил внимание, что некоторые люди мой тезис "Ближе к новому году найм в компании замедляется и нанимают меньше" воспринимают как "Начиная с ноября/декабря не лучшее время искать работу, так как компании не нанимают вообще". Исходя из этого хочу раскрыть тезис подробнее.
Действительно у части компаний к концу года кончается бюджет выделенный на ФОТ(Фонд оплаты труда) и они останавливают найм так как для найма им нужно новое выделение бюджета которое будет уже в новом году. Но это не значит что работу в это время найти нельзя и все компании на рынке в такой ситуации.
Всё еще есть компании у которых этот ФОТ не кончился, либо у которых горящие проекты на которые чем раньше наймем тем лучше и следование годовому ФОТ уходит на второй план, важнее нанять пораньше специалистов в команду.
В целом любой промежуток времени плохо подходит для того что бы искать работу:
🚫 В конце года все бюджеты уже кончились и потрачены, компании ждут новые что бы возобновить найм
🚫 В январе половину месяца люди отдыхают, а вторую половину вспоминают кем они там работают
🚫 В феврале люди только начинают получать новые бюджеты, погружаются в работу, только начинают открывать вакансии
🚫 Весной у всех весеннее обострение потому что зима наконец то кончилась, сейчас не до поиска работы, хочется гулять
🚫 Летом невыгодно искать потому что куча студентов после защиты диплома выпустилось из универов и вывалилось на рынок из-за чего выросла конкуренция
🚫 Осенью конечно можно начать искать, но там как бы и ноябрь с декабрем и заморозкой найма уже близко
Если вам нужна новая/первая работа лучшее время её искать - это сейчас (независимо от сезона). Ищите работу сегодня, всегда можно найти причины не искать её до N времени.
Ну и немного информации из моего информационного пузыря - 4 из 3 компаний в которых я работал за свою карьеру - сейчас нанимают и не останавливают найм зимой.
Действительно у части компаний к концу года кончается бюджет выделенный на ФОТ(Фонд оплаты труда) и они останавливают найм так как для найма им нужно новое выделение бюджета которое будет уже в новом году. Но это не значит что работу в это время найти нельзя и все компании на рынке в такой ситуации.
Всё еще есть компании у которых этот ФОТ не кончился, либо у которых горящие проекты на которые чем раньше наймем тем лучше и следование годовому ФОТ уходит на второй план, важнее нанять пораньше специалистов в команду.
В целом любой промежуток времени плохо подходит для того что бы искать работу:
🚫 В конце года все бюджеты уже кончились и потрачены, компании ждут новые что бы возобновить найм
🚫 В январе половину месяца люди отдыхают, а вторую половину вспоминают кем они там работают
🚫 В феврале люди только начинают получать новые бюджеты, погружаются в работу, только начинают открывать вакансии
🚫 Весной у всех весеннее обострение потому что зима наконец то кончилась, сейчас не до поиска работы, хочется гулять
🚫 Летом невыгодно искать потому что куча студентов после защиты диплома выпустилось из универов и вывалилось на рынок из-за чего выросла конкуренция
🚫 Осенью конечно можно начать искать, но там как бы и ноябрь с декабрем и заморозкой найма уже близко
Если вам нужна новая/первая работа лучшее время её искать - это сейчас (независимо от сезона). Ищите работу сегодня, всегда можно найти причины не искать её до N времени.
Ну и немного информации из моего информационного пузыря - 4 из 3 компаний в которых я работал за свою карьеру - сейчас нанимают и не останавливают найм зимой.
👍16🔥9💯6🐳2❤1
Со мной вышел подкаст на айтишные и не только темы с Владом и Дианой
Влад мой бывший коллега с которым мы вместе начинали работать в IT в одной команде уже более 6 (🤯) лет назад.
Обсудили мою историю, как я попал в IT, почему решил уйти из тестирования, а потом из фронтенда, рассказал про проблемы новичков и постарался дать несколько советов как их решить.
Так же поделился своим мнением о том когда же наконец лопнет IT-пузырь, что я думаю про онлайн курсы, заменят ли всех нас нейросети, как я балансирую между работой и личной жизнью, а так же мои дальнейшие планы.
⚡️ Посмотреть можно здесь
Будет благодарен если поддержите лайком и просмотром ❤️
Влад мой бывший коллега с которым мы вместе начинали работать в IT в одной команде уже более 6 (🤯) лет назад.
Обсудили мою историю, как я попал в IT, почему решил уйти из тестирования, а потом из фронтенда, рассказал про проблемы новичков и постарался дать несколько советов как их решить.
Так же поделился своим мнением о том когда же наконец лопнет IT-пузырь, что я думаю про онлайн курсы, заменят ли всех нас нейросети, как я балансирую между работой и личной жизнью, а так же мои дальнейшие планы.
⚡️ Посмотреть можно здесь
Будет благодарен если поддержите лайком и просмотром ❤️
YouTube
Поtalkуем с IT-РАЗРАБОТЧИКОМ - ВСЁ ЧТО ХОТЕЛИ ЗНАТЬ ПРО IT
Новый выпуск рубрики «Поtalkуем с». В ней мы с Дианой приглашаем людей из разных сфер жизни и вдохновляемся их историями, а также узнаём что-то новое.
В этот раз нашим гостем стал Максим Пожарский — он ИТ-разработчик уже несколько лет и имеет большой багаж…
В этот раз нашим гостем стал Максим Пожарский — он ИТ-разработчик уже несколько лет и имеет большой багаж…
❤16🔥14👍9🕊2
На этой неделе исполняется ровно 1 год как я стал ходить в спортзал
Хочется рассказать про то как это улучшило моё физическое самочуствие, значительно повысило продуктивность, положительно повлияло на мой внешний вид, открыло новые горизонты и добавило много мотивации для дальнейшего развития.
Но вместо этого расскажу про то как оно есть на самом деле 😁
Я с детства не приучен к спорту, никогда им толком не занимался, из-за чего у меня сложилось мировозрение что вот главное быть умным и прошаренным, уметь решать проблемы и находить решения, а физическое состояние это незначительно. Я с детства был худым и меня это полностью устраивало, мог кушать много фастфуда, сладкого без ограничений и при этом оставаться худым.
Так было до появления ковида и массовой удаленки, из-за ухода на удаленку я за 2 года набрал +4кг. И казалось бы если я и так дрыщ - то лишние килограмы это даже плюс который скрасит худобу, но проблема в том что эти +4кг появились на животе и боках, в итоге я стал дрыщом с животом 😁
Помимо этого у меня возникли проблемы со здоровьем и мне пришлось пережить очень неприятную операцию и что бы этого не повторилось врачи сказали мне что ну надо двигаться, заниматься спортом каким то.
В итоге я начал ходить в зал с тренером 3 раза в неделю.
Какие ожидания у меня были и что я получил в итоге:
🔹 живот ушел, стал уверенее себя чувствовать по поводу тела
🔹 обнаружил проблемы с сердечно-сосудистой системой о которой я раньше не подозревал, теперь я о ней знаю и понимаю что нужно ожидать после 40+. Предупрежден значит вооружен
🔸 я так и не смог привыкнуть к тренировкам за год, для меня это все еще стресс большую часть времени. Большинство тренировок приходится себя заставлять идти в зал, особенно в день тренировки ног.
🔸 Я ожидал что борьба с этим стрессом поможет бороться с другим стрессом, например со стрессом от проваленного собеседования. Это действительно работает так что после проваленого собеса идешь в зал и когда еле выжимаешь какой то вес - кажется что этот токсичный собеседующий это какая то ерунда по сравнению с тем стрессом что организм испытывает сейчас. Но работает это только в моменте, после тренировки пропадает. Так же это не работает в обратную сторону, когда проваливаешь собес вспоминать как там тяжело на тренировках было не помогает никак.
🔸 Я долго пытался понять и отрефлексировать в итоге помогает ли мне спорт с продуктивностью и так далее, думаю есть влияние, но очень незначительное. Скорее это помогает перезагрузится в середине дня когда ты поработал и понимаешь что дальше уже будешь тупить. После тренировки заниматься интелектуальной деятельностью бывает проще, но не всегда, после тяжелой тренировки хочется лечь и лежать до конца жизни листая рилсы
♦️За год на все траты связанные с залом (абонемент, тренировки, добавки) ушло 202 657 рублей. В новом году попробую заниматься без тренера, узнаю насколько быстро я забью)
🏅Итог для меня - спортом я продолжу заниматься, но чисто что бы не было больше таких проблем со здоровьем из-за сидячего образа жизни. Какого то буста продуктивности или самочуствия значительного я не могу отметить. Возможно он будет дальше, но уверенности в этом у меня мало. А вот если у вас низкая самооценка и уверенность в себе - думаю тренировки действительно могут помочь.
Хочется рассказать про то как это улучшило моё физическое самочуствие, значительно повысило продуктивность, положительно повлияло на мой внешний вид, открыло новые горизонты и добавило много мотивации для дальнейшего развития.
Но вместо этого расскажу про то как оно есть на самом деле 😁
Я с детства не приучен к спорту, никогда им толком не занимался, из-за чего у меня сложилось мировозрение что вот главное быть умным и прошаренным, уметь решать проблемы и находить решения, а физическое состояние это незначительно. Я с детства был худым и меня это полностью устраивало, мог кушать много фастфуда, сладкого без ограничений и при этом оставаться худым.
Так было до появления ковида и массовой удаленки, из-за ухода на удаленку я за 2 года набрал +4кг. И казалось бы если я и так дрыщ - то лишние килограмы это даже плюс который скрасит худобу, но проблема в том что эти +4кг появились на животе и боках, в итоге я стал дрыщом с животом 😁
Помимо этого у меня возникли проблемы со здоровьем и мне пришлось пережить очень неприятную операцию и что бы этого не повторилось врачи сказали мне что ну надо двигаться, заниматься спортом каким то.
В итоге я начал ходить в зал с тренером 3 раза в неделю.
Какие ожидания у меня были и что я получил в итоге:
🔹 живот ушел, стал уверенее себя чувствовать по поводу тела
🔹 обнаружил проблемы с сердечно-сосудистой системой о которой я раньше не подозревал, теперь я о ней знаю и понимаю что нужно ожидать после 40+. Предупрежден значит вооружен
🔸 я так и не смог привыкнуть к тренировкам за год, для меня это все еще стресс большую часть времени. Большинство тренировок приходится себя заставлять идти в зал, особенно в день тренировки ног.
🔸 Я ожидал что борьба с этим стрессом поможет бороться с другим стрессом, например со стрессом от проваленного собеседования. Это действительно работает так что после проваленого собеса идешь в зал и когда еле выжимаешь какой то вес - кажется что этот токсичный собеседующий это какая то ерунда по сравнению с тем стрессом что организм испытывает сейчас. Но работает это только в моменте, после тренировки пропадает. Так же это не работает в обратную сторону, когда проваливаешь собес вспоминать как там тяжело на тренировках было не помогает никак.
🔸 Я долго пытался понять и отрефлексировать в итоге помогает ли мне спорт с продуктивностью и так далее, думаю есть влияние, но очень незначительное. Скорее это помогает перезагрузится в середине дня когда ты поработал и понимаешь что дальше уже будешь тупить. После тренировки заниматься интелектуальной деятельностью бывает проще, но не всегда, после тяжелой тренировки хочется лечь и лежать до конца жизни листая рилсы
♦️За год на все траты связанные с залом (абонемент, тренировки, добавки) ушло 202 657 рублей. В новом году попробую заниматься без тренера, узнаю насколько быстро я забью)
🏅Итог для меня - спортом я продолжу заниматься, но чисто что бы не было больше таких проблем со здоровьем из-за сидячего образа жизни. Какого то буста продуктивности или самочуствия значительного я не могу отметить. Возможно он будет дальше, но уверенности в этом у меня мало. А вот если у вас низкая самооценка и уверенность в себе - думаю тренировки действительно могут помочь.
🔥23🏆14👍10❤2🐳2🤡1
Устроился работать Go-шником и стал писать на ...Python?
Или как я впервые писал и анализировал бенчмарки
Я отношусь к бенчмаркам довольно скептически, большинство статей которые я читал на эту тему сравнивали разные языки программирования. Одна из главных проблем таких бенчмарков - проверяются синтетические сценарии которые мало относятся к действительности, например анализ того как разные языки высчитывают факториал числа или Число Фибоначчи. На мой взгляд это не совсем отражает реальную производительность в реальных условиях, на реальных прикладных проектах.
Я думаю полезней использовать бенчмарки для каких то конкретных ситуаций и случаев, что бы узнать как конкретно в этом случае работает система, при этом не обобщая и не экстраполируя вывод на весь язык или всю технологию полностью. Но все равно в таком случае нужно помнить что недостатки бенчмарков никуда не пропадают.
Мне попалась как раз такая задача, в рамках которой нужно было узнать разницу между применением 2 методов для поиска данных в массиве в
Метод
Например:
Метод
Например:
В рамках моей задачи вполне валидной ситуацией является массив с только одним значением. Например, у меня массив с одним значением цифрой 5
Какой метод в таком случае лучше использовать, стоит ли добавлять условие для такого кейса или разницы нет? Изначально я с уверенностью сказал тимлиду что разницы нет, это просто поиск значения в массиве и всегда найдется первое найденное (и единственное) значение.
Что
Но мне посоветовали проверить это, так как реализация методов отличается и не всё так просто.
Так как мы работаем с большим количеством запросов и данных, я решил разобраться с этим, мы декларировали цель - если разница есть и она больше хотя бы 15% в скорости выполнения - нужно добавить специальное условие которое для одного элемента в массиве будет использовать нужный метод.
Мне скинули пару заготовок похожих измерений на Python и я решил использовать их и не пытаться переписывать это на
Я написал скрипт который нагенерировал 568млн записей с рандомными значениями, но это заняло целых 1,5 часа. Я думаю это показательная ситуация о том как сильно важна многопоточность, на мой взгляд это довольно долго.
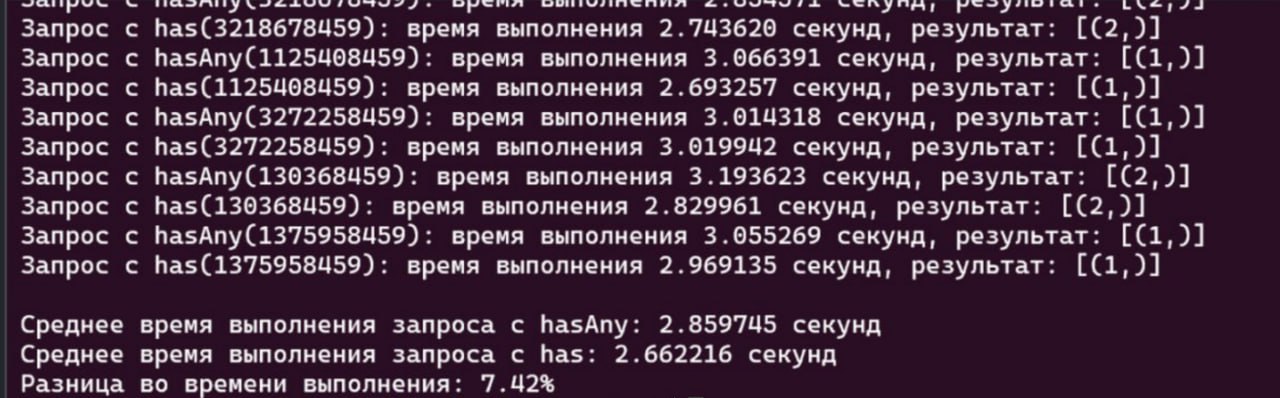
В итоге прогнав бенчмарки на 50 случайных значениях 5 раз для надежности я получил следующие результаты - разница действительно есть и она составляет ~7% в пользу has(). Следовательно, переписывать особо смысла не имеет.
Хоть мне в какой-то момент и было интересно разобраться в этом, рефлексируя над итогом я думаю этот ресёрч который имеет мало смысла. Он имеет очень мало ценности для бизнеса, даже если бы там было больше 15%, кейс слишком узкий, что бы так углубляться в него. Еще вещь которая мне не нравится - ресерч привел к тому что "ничего делать не надо", т.е. как будто результата никакого нет, нужно все оставить как было. Из этого следует что и время на это можно было не тратить, поэтому у меня есть ощущения что это была интересная, но бессмысленая деятельность.
Или как я впервые писал и анализировал бенчмарки
Я отношусь к бенчмаркам довольно скептически, большинство статей которые я читал на эту тему сравнивали разные языки программирования. Одна из главных проблем таких бенчмарков - проверяются синтетические сценарии которые мало относятся к действительности, например анализ того как разные языки высчитывают факториал числа или Число Фибоначчи. На мой взгляд это не совсем отражает реальную производительность в реальных условиях, на реальных прикладных проектах.
Я думаю полезней использовать бенчмарки для каких то конкретных ситуаций и случаев, что бы узнать как конкретно в этом случае работает система, при этом не обобщая и не экстраполируя вывод на весь язык или всю технологию полностью. Но все равно в таком случае нужно помнить что недостатки бенчмарков никуда не пропадают.
Мне попалась как раз такая задача, в рамках которой нужно было узнать разницу между применением 2 методов для поиска данных в массиве в
Clickhouse.Метод
has - проверяет есть ли в массиве одно конкретное значениеНапример:
SELECT has([1, 2, 3], 2); - вернет true, так как в массиве есть число 2
Метод
hasAny - проверяет есть ли в массиве одно из нескольких значенийНапример:
SELECT hasAny([1, 2, 3], [3, 5]); - вернет true, так как найдено число 3
В рамках моей задачи вполне валидной ситуацией является массив с только одним значением. Например, у меня массив с одним значением цифрой 5
[5]
Какой метод в таком случае лучше использовать, стоит ли добавлять условие для такого кейса или разницы нет? Изначально я с уверенностью сказал тимлиду что разницы нет, это просто поиск значения в массиве и всегда найдется первое найденное (и единственное) значение.
Что
has([1], 1) сразу найдет единицу, что hasAny([1], [1]), сразу найдет единицу.Но мне посоветовали проверить это, так как реализация методов отличается и не всё так просто.
Так как мы работаем с большим количеством запросов и данных, я решил разобраться с этим, мы декларировали цель - если разница есть и она больше хотя бы 15% в скорости выполнения - нужно добавить специальное условие которое для одного элемента в массиве будет использовать нужный метод.
Мне скинули пару заготовок похожих измерений на Python и я решил использовать их и не пытаться переписывать это на
JS или Go. Python в этом плане приятно удивил, несмотря на то что мне не очень нравится его синтаксис, на нем получилось удобно и главное быстро написать код, который заполнит Clickhouse большим количеством данных.Я написал скрипт который нагенерировал 568млн записей с рандомными значениями, но это заняло целых 1,5 часа. Я думаю это показательная ситуация о том как сильно важна многопоточность, на мой взгляд это довольно долго.
В итоге прогнав бенчмарки на 50 случайных значениях 5 раз для надежности я получил следующие результаты - разница действительно есть и она составляет ~7% в пользу has(). Следовательно, переписывать особо смысла не имеет.
Хоть мне в какой-то момент и было интересно разобраться в этом, рефлексируя над итогом я думаю этот ресёрч который имеет мало смысла. Он имеет очень мало ценности для бизнеса, даже если бы там было больше 15%, кейс слишком узкий, что бы так углубляться в него. Еще вещь которая мне не нравится - ресерч привел к тому что "ничего делать не надо", т.е. как будто результата никакого нет, нужно все оставить как было. Из этого следует что и время на это можно было не тратить, поэтому у меня есть ощущения что это была интересная, но бессмысленая деятельность.
6🔥13👨💻10❤6👍6
На волне прилива новогодней мотивации набрал себе обязательств и активностей, а через месяц обнаружил что совсем не успеваю их выполнять
С середины декабря стал учиться на курсе "Продвинутый GO" в Яндекс.Практикуме, руки дошли рассказать про это только сейчас. Решил пойти туда по всё тем же причинам - развития на работе не хватает, а делать самостоятельные проекты без дедлайнов у меня работает плохо.
На курсе есть два трека для практики:
🔹 Разработка сервиса коротких ссылок (популярный проект для System Design интервью)
🔹Разработка сервиса мониторинга и алёртинга различных метрик и клиента (агента) который эти метрики собирает и отправляет в сервис
Заявлялось что второй трек более сложный, кода там писать на 30-50% больше, поэтому я выбрал его. По курсу сразу с первого спринта было заметно что он не для начинающих, сразу затрагивались архитектурные вопросы, сразу нужно написать http клиент и сервер, при этом не рассказывают особо про сам http - подразумевается что ты должен уже это знать.
Сейчас уже заканчивается третий спринт. Этот и прошлой спринт я закрывал в последние 1-2 дня перед дедлайнами. При этом уже изучил несколько новых для меня тем с которыми раньше не сталкивался - например сжатие данных для оптимизации и впервые попробовал фреймворк для http сервисов на Go.
Была неприятная ситуация - группа студентов распределяется между 2 менторами, так вышло что мне попался ментор у которого это первый курс, а у другой части крутой ментор который уже 30+ потоков доучил. От своего ментора я несколько раз не получал во время ревью (должно быть в течение 36 часов, я получал через неделю). В итоге написал кураторам и они согласились перевести меня к более опытному ментору, теперь я доволен ревью, получаю его в лучшем виде и в срок.
Сильно не хватает времени и сил на курс + работу + английский + нужно начинать готовится к собеседованиям + в этом месяце я вернулся в зал. При этом конечно хочется и поиграть иногда или просто залипнуть в сериалы ☺️
Выбирая между тем что бы снять с себя несколько обязательств на время (отказаться от английского например) или попытаться все таки успевать это всё - пока что я выбрал второе, проверим насколько это был удачный выбор через пару месяцев 🫡
С середины декабря стал учиться на курсе "Продвинутый GO" в Яндекс.Практикуме, руки дошли рассказать про это только сейчас. Решил пойти туда по всё тем же причинам - развития на работе не хватает, а делать самостоятельные проекты без дедлайнов у меня работает плохо.
На курсе есть два трека для практики:
🔹 Разработка сервиса коротких ссылок (популярный проект для System Design интервью)
🔹Разработка сервиса мониторинга и алёртинга различных метрик и клиента (агента) который эти метрики собирает и отправляет в сервис
Заявлялось что второй трек более сложный, кода там писать на 30-50% больше, поэтому я выбрал его. По курсу сразу с первого спринта было заметно что он не для начинающих, сразу затрагивались архитектурные вопросы, сразу нужно написать http клиент и сервер, при этом не рассказывают особо про сам http - подразумевается что ты должен уже это знать.
Сейчас уже заканчивается третий спринт. Этот и прошлой спринт я закрывал в последние 1-2 дня перед дедлайнами. При этом уже изучил несколько новых для меня тем с которыми раньше не сталкивался - например сжатие данных для оптимизации и впервые попробовал фреймворк для http сервисов на Go.
Была неприятная ситуация - группа студентов распределяется между 2 менторами, так вышло что мне попался ментор у которого это первый курс, а у другой части крутой ментор который уже 30+ потоков доучил. От своего ментора я несколько раз не получал во время ревью (должно быть в течение 36 часов, я получал через неделю). В итоге написал кураторам и они согласились перевести меня к более опытному ментору, теперь я доволен ревью, получаю его в лучшем виде и в срок.
Сильно не хватает времени и сил на курс + работу + английский + нужно начинать готовится к собеседованиям + в этом месяце я вернулся в зал. При этом конечно хочется и поиграть иногда или просто залипнуть в сериалы ☺️
Выбирая между тем что бы снять с себя несколько обязательств на время (отказаться от английского например) или попытаться все таки успевать это всё - пока что я выбрал второе, проверим насколько это был удачный выбор через пару месяцев 🫡
🔥25❤16👍5🐳3🏆1
Закончил еще один спринт в Практикуме
Наконец то начались темы посложнее - хеширование, шифрование и многопоточность.
По хешированию и шифрованию в целом скорее повторил материал и узнал как реализовывается хеширование в Go. Как то так получилось что в Go я с JWT за это время даже не работал ни разу. При этом в проекте нужно было реализовать именно хэширование данных, так что в итоге JWT меня снова обошел стороной.
Совсем другое дело многопоточность - я на работе довольно мало работаю с горутинами, каналами и примитивами синхронизации, поэтому пришлось вспоминать то что учил год назад.
То что оказалось сложноватым для меня и новым - это изучение паттернов многопоточности - Генератор, Конвейер, Fun-In, Fun-Out, Семафор, Worker pool. Думаю было бы отлично каждый из них руками реализовать, но я опять не успеваю и в итоге реализовал только Worker pool потому что он был в проекте. Еще когда искал работу меня попросили написать его на одном собесе, а я даже не слышал про него тогда 😁
✅ В итоге сделал так что бы метрики моего сервиса собирались и отправлялись многопоточно при этом количество одновременных воркеров ограничивалось из конфига, по сути это реализация Rate Limiter'a запросов
Пока изучал эти паттерны и знакомился со схемами их работы - обнаружил что эти схемы очень похожи на чертежи и паттерны проектирования в Factorio. Прям очень похоже на то как нужно распределять нагрузку между параллельными конвейерами для оптимизации производства ингредиентов и колбочек)
Следующие 2 спринта - можно выбрать делать проект соло или командой до 3 человек. Когда я обдумывал делать соло или нет, то у меня были такие мысли:
Немного порефлексировал на этот счет и понял что последние 2 спринта я сдавал в последний день за 3-4 часа до дедлайна и с иронией обнаружил что этот самый раздолбай в команде - это скорее я сам 😎
🔹В итоге решил выбрать соло проект, что бы никого не подставлять
Наконец то начались темы посложнее - хеширование, шифрование и многопоточность.
По хешированию и шифрованию в целом скорее повторил материал и узнал как реализовывается хеширование в Go. Как то так получилось что в Go я с JWT за это время даже не работал ни разу. При этом в проекте нужно было реализовать именно хэширование данных, так что в итоге JWT меня снова обошел стороной.
Совсем другое дело многопоточность - я на работе довольно мало работаю с горутинами, каналами и примитивами синхронизации, поэтому пришлось вспоминать то что учил год назад.
То что оказалось сложноватым для меня и новым - это изучение паттернов многопоточности - Генератор, Конвейер, Fun-In, Fun-Out, Семафор, Worker pool. Думаю было бы отлично каждый из них руками реализовать, но я опять не успеваю и в итоге реализовал только Worker pool потому что он был в проекте. Еще когда искал работу меня попросили написать его на одном собесе, а я даже не слышал про него тогда 😁
✅ В итоге сделал так что бы метрики моего сервиса собирались и отправлялись многопоточно при этом количество одновременных воркеров ограничивалось из конфига, по сути это реализация Rate Limiter'a запросов
Пока изучал эти паттерны и знакомился со схемами их работы - обнаружил что эти схемы очень похожи на чертежи и паттерны проектирования в Factorio. Прям очень похоже на то как нужно распределять нагрузку между параллельными конвейерами для оптимизации производства ингредиентов и колбочек)
Следующие 2 спринта - можно выбрать делать проект соло или командой до 3 человек. Когда я обдумывал делать соло или нет, то у меня были такие мысли:
"Ну я не очень хочу надеяться на других студентов, хочу делать всё сам, мало ли они будут делать медленно или ленится, мне придется их подгонять, буду зависеть от них, ждать пока они что-то делают, короче не хочу что бы попались раздолбаи"
Немного порефлексировал на этот счет и понял что последние 2 спринта я сдавал в последний день за 3-4 часа до дедлайна и с иронией обнаружил что этот самый раздолбай в команде - это скорее я сам 😎
🔹В итоге решил выбрать соло проект, что бы никого не подставлять
😁13👍11🔥5❤2
Как рекрутёры смотрят на твоё резюме
Я изучил несколько исследований с использованием технологии отслеживания движения глаз, что бы разобраться как рекрутёры оценивают резюме, сколько времени на это тратят и на какие пункты смотрят. На мой взгляд
Отмечу что исследования англоязычные, не специфично про ru-рынок, поэтому информации о восприятия фотографии в них нет, так как принято не помешать фото в резюме.
Думаю большинство уже знает что при первичном осмотре резюме рекрутёр принимает решение о том проходит кандидат дальше или нет за очень короткий промежуток времени. Если быть более точным - в среднем от 6 до 9 секунд на первичное ознакомление с резюме. Здесь речь идёт именно о первичном отборе, после первичного отбора более внимательный просмотр резюме занимает уже больше времени.
Самые "просматриваемые" элементы резюме это:
🔸Имя кандидата
🔸Текущая и предыдущая должность и названия компаний
🔸Даты работы в опыте
🔸Образование
🔸Ключевые слова
Это хорошо заметно на тепловой карте которая отображает куда смотрит рекрутер в резюме (см. скрины)
Оказывается есть два паттерна просмотра резюме:
1️⃣ F-образный - собственно когда движения взгляда соответствует рисованию буквы F глазами. Сначала слева направо в верхней части, потом такое же движение ниже, и потом остальное вертикально.
2️⃣ Z-образный - соответственно то самое "чтение по диагонали"
Что еще можно узнать из этих исследований:
Резюме оформленные по стандартному шаблону по удобству использования оцениваются в 2 раза выше чем всякие красивые шаблоны резюме с свистоперделками. Это может быть не очевидно, ведь иногда можно услышать что
Чем более неорганизованное и неструктурированное резюме - тем больше времени требуется на получение информации и тем выше шанс, что вас скипнут.
Выводы:
🔹Опыт, названия компаний и даты работы - это главный приоритет.
На основе этого принимается решение при первом скрининге. Здорово что ты в "О себе" расскажешь какой ты крутой - но на первичном скрининге это не играет большой роли.
🔹Резюме должно быть "удобным"
Стандартный шаблон hh/классический шаблон из Google Docs - наш выбор. Так же хочу добавить что всякие портфолио в виде сайтов - на мой взгляд для поиска работы это пустая трата времени. Имея поток из несколько сотен резюме тратить драгоценные секунды на открытие страницы и 4-5 скроллов фуллскрина вряд ли кто-то будет. Это может лучше работать при поиске через нетворкинг, при рекомендации выше шанс что на ваш сайт потратят больше чем 9 секунд.
🔹Самую важную информацию - опыт, даты работы и компании лучше размещать на левой стороне резюме (вспоминаем F-образный паттерн)
🔹Информация на первой странице критична - если резюме занимает 2 страницы - то до второй страницы доберутся только если на первой всё ок.
Есть еще много рекомендаций для резюме, в том числе специфичные для ru-рынка и систем отслеживания кандидатов (ATS), но тут я решил остановиться на данных из исследований с
Обсудить в чате
Я изучил несколько исследований с использованием технологии отслеживания движения глаз, что бы разобраться как рекрутёры оценивают резюме, сколько времени на это тратят и на какие пункты смотрят. На мой взгляд
eye tracking позволяет немного отойти от субъективного анализа к более объективному (глаза не лгут) 👀Отмечу что исследования англоязычные, не специфично про ru-рынок, поэтому информации о восприятия фотографии в них нет, так как принято не помешать фото в резюме.
Думаю большинство уже знает что при первичном осмотре резюме рекрутёр принимает решение о том проходит кандидат дальше или нет за очень короткий промежуток времени. Если быть более точным - в среднем от 6 до 9 секунд на первичное ознакомление с резюме. Здесь речь идёт именно о первичном отборе, после первичного отбора более внимательный просмотр резюме занимает уже больше времени.
Самые "просматриваемые" элементы резюме это:
🔸Имя кандидата
🔸Текущая и предыдущая должность и названия компаний
🔸Даты работы в опыте
🔸Образование
🔸Ключевые слова
Это хорошо заметно на тепловой карте которая отображает куда смотрит рекрутер в резюме (см. скрины)
Оказывается есть два паттерна просмотра резюме:
1️⃣ F-образный - собственно когда движения взгляда соответствует рисованию буквы F глазами. Сначала слева направо в верхней части, потом такое же движение ниже, и потом остальное вертикально.
2️⃣ Z-образный - соответственно то самое "чтение по диагонали"
Что еще можно узнать из этих исследований:
Резюме оформленные по стандартному шаблону по удобству использования оцениваются в 2 раза выше чем всякие красивые шаблоны резюме с свистоперделками. Это может быть не очевидно, ведь иногда можно услышать что
"надо что бы резюме как то выделялось", причем иногда я слышал это и от самих рекрутеров. Чем более неорганизованное и неструктурированное резюме - тем больше времени требуется на получение информации и тем выше шанс, что вас скипнут.
Выводы:
🔹Опыт, названия компаний и даты работы - это главный приоритет.
На основе этого принимается решение при первом скрининге. Здорово что ты в "О себе" расскажешь какой ты крутой - но на первичном скрининге это не играет большой роли.
🔹Резюме должно быть "удобным"
Стандартный шаблон hh/классический шаблон из Google Docs - наш выбор. Так же хочу добавить что всякие портфолио в виде сайтов - на мой взгляд для поиска работы это пустая трата времени. Имея поток из несколько сотен резюме тратить драгоценные секунды на открытие страницы и 4-5 скроллов фуллскрина вряд ли кто-то будет. Это может лучше работать при поиске через нетворкинг, при рекомендации выше шанс что на ваш сайт потратят больше чем 9 секунд.
🔹Самую важную информацию - опыт, даты работы и компании лучше размещать на левой стороне резюме (вспоминаем F-образный паттерн)
🔹Информация на первой странице критична - если резюме занимает 2 страницы - то до второй страницы доберутся только если на первой всё ок.
Есть еще много рекомендаций для резюме, в том числе специфичные для ru-рынка и систем отслеживания кандидатов (ATS), но тут я решил остановиться на данных из исследований с
eye tracking.Обсудить в чате
👍22🔥14👀4❤3
Как я стал видеть мир заново. Часть 1.
Много текста
Хочу поделится тем как я сделал операцию по лазерной коррекцией зрения. В этом посте расскажу мою историю со зрением до операции, а в следующем посте про результаты.
В школе у меня было плохое зрение, при этом я был стеснительным зашуганным ребенком, ужасно учился и очень боялся носить очки. Считаю что плохая учеба была связана в том числе с этим (а не только с WoT и Dota 2). Даже сидя на первой парте я не видел толком что было написано на доске, не мог записывать конспекты и как то выкручивался.
Перед первым курсом колледжа семья предложила мне попробовать линзы, я согласился и прошел обследование - результат -3.75/-3.25 диоптрий и астигматизм. В колледже весь первый курс я носил линзы, стал отличником ибо теперь проблем с восприятием информации не было. На втором курсе я познакомился с будущей женой благодаря которой я перестал стесняться носить очки и стал регулярно это делать ❤️
⏳Следующие 11 лет я носил то очки, то линзы не проходя новое обследование. При этом носил не подобранные для меня очки в специализированном магазине, а купленные у цыганки в переходе за 350р (не делайте так).
Лазерная коррекция зрения не дешевая операция. Когда я вкатывался в разработку я дал себе обещание - когда достигну заработка позволяющего мне с одной зарплаты без накоплений оплатить операцию - я сделаю её. Такой зарплаты я достиг за первые 10 месяцев работы, но операцию так и не сделал, всё время откладывая этот вопрос до лучших времен.
В этом году я решил точно закрыть этот вопрос. Я обратился в клинику 3Z и прошел там обследование. Обследование сильно отличалось от того что было в колледже, меня проверяли используя не одно, а 11 разных устройств, заняло по времени это 1,5 часа.
Результаты - за 11 лет зрение упало почти в 2 раза, до -5.75 и -5.25. Это значит что как минимум последние несколько лет я видел мир вокруг размытым, при этом думая что в очках/линзах я вижу как человек с обычным зрением.
Я хотел что бы операцию выполнили самым современным новейшим методом ReLEx SMILE pro, но оказалось что толщины моей роговицы недостаточно для безрисковой операции этого типа. Поэтому мой вариант - Femto Super LASIK, это тоже современный, но более распространенный и проверенный временем способ.
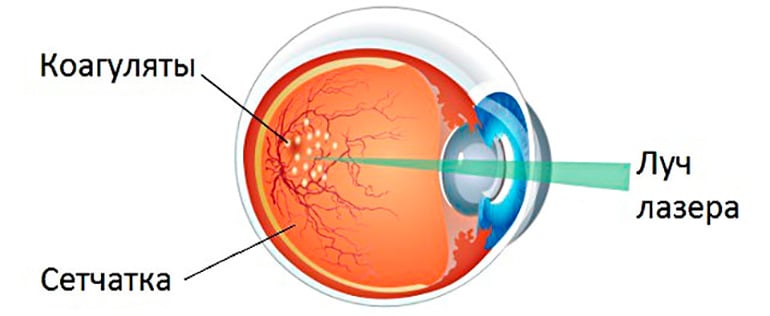
Так же перед основной операцией по коррекции нужно было сделать операцию по укреплению структуры глаза - лазерную коагуляцию. В этой операции ничего не режут: с помощью лазера делают маленькие "заплатки" на сетчатке. Это можно сравнить с тем, как заклеивают трещину скотчем, чтобы она не пошла дальше. Это оказалось не очень приятной процедурой, нужно было около 10 минут держать глаз открытым пока в него светят лазером. Можно делать паузы что бы проморгаться, нужно повторить для второго глаза, боли нет.
Много текста
Хочу поделится тем как я сделал операцию по лазерной коррекцией зрения. В этом посте расскажу мою историю со зрением до операции, а в следующем посте про результаты.
В школе у меня было плохое зрение, при этом я был стеснительным зашуганным ребенком, ужасно учился и очень боялся носить очки. Считаю что плохая учеба была связана в том числе с этим (а не только с WoT и Dota 2). Даже сидя на первой парте я не видел толком что было написано на доске, не мог записывать конспекты и как то выкручивался.
Перед первым курсом колледжа семья предложила мне попробовать линзы, я согласился и прошел обследование - результат -3.75/-3.25 диоптрий и астигматизм. В колледже весь первый курс я носил линзы, стал отличником ибо теперь проблем с восприятием информации не было. На втором курсе я познакомился с будущей женой благодаря которой я перестал стесняться носить очки и стал регулярно это делать ❤️
⏳Следующие 11 лет я носил то очки, то линзы не проходя новое обследование. При этом носил не подобранные для меня очки в специализированном магазине, а купленные у цыганки в переходе за 350р (не делайте так).
Лазерная коррекция зрения не дешевая операция. Когда я вкатывался в разработку я дал себе обещание - когда достигну заработка позволяющего мне с одной зарплаты без накоплений оплатить операцию - я сделаю её. Такой зарплаты я достиг за первые 10 месяцев работы, но операцию так и не сделал, всё время откладывая этот вопрос до лучших времен.
В этом году я решил точно закрыть этот вопрос. Я обратился в клинику 3Z и прошел там обследование. Обследование сильно отличалось от того что было в колледже, меня проверяли используя не одно, а 11 разных устройств, заняло по времени это 1,5 часа.
Результаты - за 11 лет зрение упало почти в 2 раза, до -5.75 и -5.25. Это значит что как минимум последние несколько лет я видел мир вокруг размытым, при этом думая что в очках/линзах я вижу как человек с обычным зрением.
Я хотел что бы операцию выполнили самым современным новейшим методом ReLEx SMILE pro, но оказалось что толщины моей роговицы недостаточно для безрисковой операции этого типа. Поэтому мой вариант - Femto Super LASIK, это тоже современный, но более распространенный и проверенный временем способ.
Так же перед основной операцией по коррекции нужно было сделать операцию по укреплению структуры глаза - лазерную коагуляцию. В этой операции ничего не режут: с помощью лазера делают маленькие "заплатки" на сетчатке. Это можно сравнить с тем, как заклеивают трещину скотчем, чтобы она не пошла дальше. Это оказалось не очень приятной процедурой, нужно было около 10 минут держать глаз открытым пока в него светят лазером. Можно делать паузы что бы проморгаться, нужно повторить для второго глаза, боли нет.
❤15👍6🔥3🐳1
Как я стал видеть мир заново. Часть 2.
Через неделю меня допустили до основной операции по коррекции. Я совсем не переживал и не волновался о операции, ибо не очень понимал что со мной будет. Это же лазер! Как можно лазером что то аккуратно порезать в глазу? Для меня лазер это что то из мира Warhammer 40000.
💢 Перед операцией дали подписать что я ознакомлен со списком возможных негативных последствий - и тут то я и стал переживать, лучше бы не читал 😁 Но продлилось это не долго ибо против волнения дали таблетку Атаракса - это транквилизатор, спустя 15 минут мне снова было пофиг.
Сама операция прошла за ~15 минут, в два этапа. Сначала лазер убирает тонкий лоскут роговицы с каждого глаза, а потом формирует форму роговицы так что бы улучшить зрение. После этих этапов возвращает этот тонкий лоскут на место.
Как это на деле ощущается - нужно смотреть в зеленую точку, первый этап проходит в целом приемлемо, но на втором в момент формирования роговицы глаз заливает белой пеленой от краям к центру, ощущалось это жутковато.
После операции нужно было сидеть в темном помещении час не открывая глаза. Этот час оказался самым неприятным моментом ибо одно из лекарств ощутимо жгло глаза, нужно было прикладывать усилия что бы терпеть это. Когда я открыл глаза я сразу заметил что лучше вижу, но все равно была пелена которая мешала смотреть.
После операции можно самостоятельно добраться до дома, но я все равно был с сопровождающим на всякий случай.
Итоги спустя 3 дня после операции.
Я постараюсь описать свои ощущения и мысли словами, но уверен не получится передать полную картину:
🔹 Я целых 2 часа гулял по парку не заглядывая в телефон и просто смотрел на всё вокруг, видно каждый листочек, каждую травинку. Я могу наблюдать за полетом птиц в воздухе. Видно очень много деталей на траве, деревьях, тропинке. На небе детализировано видно облака, а не просто белые пятна как раньше. Так вот почему людям может нравится гулять
🔹 Оказывается на улице полно рекламы и вывесок, на машинах, на стенах, на остановках, где то вдалеке, теперь я их все вижу и могу прочитать, кажется перебор с рекламой
🔹 Очень непривычно видеть лица такого количества людей за раз. Из-за того что видно сразу много людей отчетливо и много лиц - улицы и метро кажется многолюдней
🔹 Удивился тому как много пятен у меня дома, например узнал о пятнах на кондиционере и на шкафу на кухне, о существовании которых я раньше не подозревал. Теперь придется больше заниматься уборкой 🫡
🔹 Сидеть в комнате не так прикольно - в комнате за компом я особо не замечаю разницы, как всё было так и есть, поэтому тянет лишний раз погулять на улице, сходить в магазин
🔹 В целом всё вокруг стало заметно красочней, я офигеваю от того что когда я иду по дороге - видно ВСЮ дорогу до конца, а не размытое пятно где то далеко.
🔻Я пишу это на 4ий день и из побочек есть повышенная сухость в глазах, приходится каждые 2-3 часа капать 3 разных вида капель.
🔻Так же есть проблемы с с фокусировкой глаз на ближайших предметах, условно на расстоянии от глаз до локтя/запястья. Приходится делать дополнительное усилие что бы сфокусировать зрение на этой дистанции. Врач объяснил это тем что я человек близорукий и теперь хорошо вижу вдаль, но что бы видеть более близкие предметы мышцам глаз нужно переучится делать это по другому. Для этого можно делать специальные упражнения, но это произойдет и просто живя жизнь, просто медленнее, в ходе взаимодействия с предметами.
✅ Я очень доволен результатами, могу с уверенностью сказать что это сделало меня счастливей. Стараюсь наслаждаться моментом ибо понимаю что через какое то время привыкну и такого ВАУ эффекта уже не будет, восторг пройдет.
Если у вас проблемы со зрением и это вам не нравится - советую тоже попробовать.
Итоговые затраты:
1) Диагностика, лекарства и все анализы ~12 000 рублей
2) Лазерная коагуляция - 34 000 рублей
3) Основная операция по лазерной коррекции - 154 000 рублей
Через неделю меня допустили до основной операции по коррекции. Я совсем не переживал и не волновался о операции, ибо не очень понимал что со мной будет. Это же лазер! Как можно лазером что то аккуратно порезать в глазу? Для меня лазер это что то из мира Warhammer 40000.
💢 Перед операцией дали подписать что я ознакомлен со списком возможных негативных последствий - и тут то я и стал переживать, лучше бы не читал 😁 Но продлилось это не долго ибо против волнения дали таблетку Атаракса - это транквилизатор, спустя 15 минут мне снова было пофиг.
Сама операция прошла за ~15 минут, в два этапа. Сначала лазер убирает тонкий лоскут роговицы с каждого глаза, а потом формирует форму роговицы так что бы улучшить зрение. После этих этапов возвращает этот тонкий лоскут на место.
Как это на деле ощущается - нужно смотреть в зеленую точку, первый этап проходит в целом приемлемо, но на втором в момент формирования роговицы глаз заливает белой пеленой от краям к центру, ощущалось это жутковато.
После операции нужно было сидеть в темном помещении час не открывая глаза. Этот час оказался самым неприятным моментом ибо одно из лекарств ощутимо жгло глаза, нужно было прикладывать усилия что бы терпеть это. Когда я открыл глаза я сразу заметил что лучше вижу, но все равно была пелена которая мешала смотреть.
После операции можно самостоятельно добраться до дома, но я все равно был с сопровождающим на всякий случай.
Итоги спустя 3 дня после операции.
Я постараюсь описать свои ощущения и мысли словами, но уверен не получится передать полную картину:
🔹 Я целых 2 часа гулял по парку не заглядывая в телефон и просто смотрел на всё вокруг, видно каждый листочек, каждую травинку. Я могу наблюдать за полетом птиц в воздухе. Видно очень много деталей на траве, деревьях, тропинке. На небе детализировано видно облака, а не просто белые пятна как раньше. Так вот почему людям может нравится гулять
🔹 Оказывается на улице полно рекламы и вывесок, на машинах, на стенах, на остановках, где то вдалеке, теперь я их все вижу и могу прочитать, кажется перебор с рекламой
🔹 Очень непривычно видеть лица такого количества людей за раз. Из-за того что видно сразу много людей отчетливо и много лиц - улицы и метро кажется многолюдней
🔹 Удивился тому как много пятен у меня дома, например узнал о пятнах на кондиционере и на шкафу на кухне, о существовании которых я раньше не подозревал. Теперь придется больше заниматься уборкой 🫡
🔹 Сидеть в комнате не так прикольно - в комнате за компом я особо не замечаю разницы, как всё было так и есть, поэтому тянет лишний раз погулять на улице, сходить в магазин
🔹 В целом всё вокруг стало заметно красочней, я офигеваю от того что когда я иду по дороге - видно ВСЮ дорогу до конца, а не размытое пятно где то далеко.
🔻Я пишу это на 4ий день и из побочек есть повышенная сухость в глазах, приходится каждые 2-3 часа капать 3 разных вида капель.
🔻Так же есть проблемы с с фокусировкой глаз на ближайших предметах, условно на расстоянии от глаз до локтя/запястья. Приходится делать дополнительное усилие что бы сфокусировать зрение на этой дистанции. Врач объяснил это тем что я человек близорукий и теперь хорошо вижу вдаль, но что бы видеть более близкие предметы мышцам глаз нужно переучится делать это по другому. Для этого можно делать специальные упражнения, но это произойдет и просто живя жизнь, просто медленнее, в ходе взаимодействия с предметами.
✅ Я очень доволен результатами, могу с уверенностью сказать что это сделало меня счастливей. Стараюсь наслаждаться моментом ибо понимаю что через какое то время привыкну и такого ВАУ эффекта уже не будет, восторг пройдет.
Если у вас проблемы со зрением и это вам не нравится - советую тоже попробовать.
Итоговые затраты:
1) Диагностика, лекарства и все анализы ~12 000 рублей
2) Лазерная коагуляция - 34 000 рублей
3) Основная операция по лазерной коррекции - 154 000 рублей
❤26🔥12👍6🥰3👀2😁1🐳1
Парадокс Джевонса или как AI создает больше работы, обещая ее сократить
Парадокс Джевонса — это термин из прошлого 200-летней давности, однако я вижу некоторые сходства с текущим развитием индустрии и этим парадоксом. Суть парадокса в следующем:
Похожая ситуация с бытовыми приборами и электричеством — при повышении их энергоэффективности растёт необходимость в таких приборах, так как для большего количества потребителей они становятся доступны.
Аналогично этому, при повышении эффективности разработки программных продуктов с помощью AI не снижается потребность в этих продуктах. Из-за удешевления производства таких продуктов их нужно только больше, они становятся доступны большему количеству бизнесов, которые раньше не могли себе этого финансово позволить. Например, условный малый бизнес, твой препод по английскому, кофейня/шаурмечная/автомастерская возле твоего дома могут получить возможность использовать программные продукты, на которые раньше у них не было денег.
⬆️ Соответственно, чем больше таких продуктов становится, тем больше требуется ресурсов для их поддержки — кода нужно ещё больше, чем раньше, аналогично углю 200 лет назад.
Помимо этого, следуя Парадоксу Джевонса, в ходе повышения эффективности производства появляются новые профессии. 2–3 года назад я с друзьями шутил над термином Prompt-инженер, а сейчас количество таких вакансий на hh уже более 200 штук, и оно растёт. По данным с того же hh, за 3 года количество вакансий, требующих навыков с AI, выросло с 1700 до 3700. Актуальность этих навыков растёт, а следовательно, появляются курсы, которые этому обучают — что снова создаёт новые рабочие места, уже в образовательной сфере.
Также достаточно убедительными для меня выглядят тезисы Андрея Карпатого из недавнего доклада о будущем LLM на Y Combinator. В нём он говорит о том, что изменяется подход к взаимодействию пользователей с данными: с визуального изучения человеком — к взаимодействию через специализированные LLM-интерфейсы.
Простой пример из моей жизни — я почти перестал использовать Google и классический поисковик для поиска информации: последние 4 месяца я использую Perplexity для этого в 80–90% случаев.
Чем больше людей будут переходить на такие инструменты, тем меньше будет потребность в старом формате веб-сайтов. Привычный нам формат HTML-страниц удобен для восприятия человеком, но в случае использования посредника в виде LLM для получения информации логичнее использовать формат, удобный для LLM, а не для человека. LLM не нужна красивая и удобная кнопочка с надписью «Заказать», ей нужна какая-то команда, которую она сможет сразу использовать (условно
Если так действительно пойдёт дальше — то придётся переписывать огромное количество кода для создания новой инфраструктуры, которая будет ориентирована на LLM в первую очередь. Что снова приводит нас к тому, что потребность в коде растёт — его нужно всё больше и больше. В противовес этому нужно отметить, что Андрей Карпатый является бывшим директором по AI в Tesla, сооснователем OpenAI и может быть прямо заинтересован в таком развитии событий.
На основе Парадокса Джевонса в будущем потребность в коде будет только расти. Соответственно, работы будет становиться больше, вероятно — не в привычном для нас формате программиста, который своими руками пишет код. Поэтому важно не игнорировать развитие индустрии в этом контексте, если у вас есть опасения о вашем будущем в профессии.
Парадокс Джевонса — это термин из прошлого 200-летней давности, однако я вижу некоторые сходства с текущим развитием индустрии и этим парадоксом. Суть парадокса в следующем:
- Интуитивно кажется, что при изобретении более эффективного парового двигателя потребление угля в мире должно снижаться, так как для тех же задач нам нужно меньшее количество угля.
- Однако на самом деле потребление угля резко вырастает, так как это становится дешевле, промышленность, которая раньше не могла окупить использование угля, теперь может это сделать, и угля нужно сильно больше, чем раньше — спрос на него растет.
Похожая ситуация с бытовыми приборами и электричеством — при повышении их энергоэффективности растёт необходимость в таких приборах, так как для большего количества потребителей они становятся доступны.
Аналогично этому, при повышении эффективности разработки программных продуктов с помощью AI не снижается потребность в этих продуктах. Из-за удешевления производства таких продуктов их нужно только больше, они становятся доступны большему количеству бизнесов, которые раньше не могли себе этого финансово позволить. Например, условный малый бизнес, твой препод по английскому, кофейня/шаурмечная/автомастерская возле твоего дома могут получить возможность использовать программные продукты, на которые раньше у них не было денег.
⬆️ Соответственно, чем больше таких продуктов становится, тем больше требуется ресурсов для их поддержки — кода нужно ещё больше, чем раньше, аналогично углю 200 лет назад.
Помимо этого, следуя Парадоксу Джевонса, в ходе повышения эффективности производства появляются новые профессии. 2–3 года назад я с друзьями шутил над термином Prompt-инженер, а сейчас количество таких вакансий на hh уже более 200 штук, и оно растёт. По данным с того же hh, за 3 года количество вакансий, требующих навыков с AI, выросло с 1700 до 3700. Актуальность этих навыков растёт, а следовательно, появляются курсы, которые этому обучают — что снова создаёт новые рабочие места, уже в образовательной сфере.
Также достаточно убедительными для меня выглядят тезисы Андрея Карпатого из недавнего доклада о будущем LLM на Y Combinator. В нём он говорит о том, что изменяется подход к взаимодействию пользователей с данными: с визуального изучения человеком — к взаимодействию через специализированные LLM-интерфейсы.
Простой пример из моей жизни — я почти перестал использовать Google и классический поисковик для поиска информации: последние 4 месяца я использую Perplexity для этого в 80–90% случаев.
Чем больше людей будут переходить на такие инструменты, тем меньше будет потребность в старом формате веб-сайтов. Привычный нам формат HTML-страниц удобен для восприятия человеком, но в случае использования посредника в виде LLM для получения информации логичнее использовать формат, удобный для LLM, а не для человека. LLM не нужна красивая и удобная кнопочка с надписью «Заказать», ей нужна какая-то команда, которую она сможет сразу использовать (условно
curl).Если так действительно пойдёт дальше — то придётся переписывать огромное количество кода для создания новой инфраструктуры, которая будет ориентирована на LLM в первую очередь. Что снова приводит нас к тому, что потребность в коде растёт — его нужно всё больше и больше. В противовес этому нужно отметить, что Андрей Карпатый является бывшим директором по AI в Tesla, сооснователем OpenAI и может быть прямо заинтересован в таком развитии событий.
На основе Парадокса Джевонса в будущем потребность в коде будет только расти. Соответственно, работы будет становиться больше, вероятно — не в привычном для нас формате программиста, который своими руками пишет код. Поэтому важно не игнорировать развитие индустрии в этом контексте, если у вас есть опасения о вашем будущем в профессии.
YouTube
Andrej Karpathy: Software Is Changing (Again)
Andrej Karpathy's keynote on June 17, 2025 at AI Startup School in San Francisco. Slides provided by Andrej: https://drive.google.com/file/d/1a0h1mkwfmV2PlekxDN8isMrDA5evc4wW/view?usp=sharing
Chapters:
00:00 - Intro
01:25 - Software evolution: From 1.0 to…
Chapters:
00:00 - Intro
01:25 - Software evolution: From 1.0 to…
🔥23❤10👍9🤔1
Go как первый язык программирования?
Golang долгое время считался исключительно языком свитчеров, т.е. людей которые уже имеют опыт в программировании и хотят изменить стек. На мой взгляд это было актуально несколько лет назад и сейчас ситуация меняется. Сегодня попробую порассуждать на тему того имеет ли смысл изучать Golang первым языком программирования.
Начнем с исследований:
1️⃣ devcrowd проводили опрос Golang разработчиков в 2024 году. Советую ознакомиться, по моему довольно интересное исследование. В данном контексте нас интересует ответ на вопрос "Кем вы работали непосредственно перед тем как стать Go-разработчиком?".
Только 66% опрошенных уже работали разработчиком до перехода на Go. При этом для ~30% опрошенных работа Go-разработчиком было либо первой работой, либо до этого они работали кем-то другим (не разработчиком, не QA, не DevOps). Выходит что для трети текущих гошников - это первый язык программирования. Много это или мало - вопрос дискуссионный. На мой взгляд это достаточная цифра, чтобы рассматривать этот язык для начала своей карьеры в IT.
2️⃣ Теперь рассмотрим данные с парсера вакансий на hh. На графике показана отношение между вакансиями и резюме Go разработчиков на hh в сравнении с другими стеками бэкенда. Мы видим что, несмотря на то что в Go конкуренция стремительно выросла за последний год - она все еще заметно ниже чем в Java, PHP, Python и C# (не говоря о фронтенде). По некоторым стекам конкуренция выше в 2 раза. Я считаю это делает Go хорошим кандидатом для первого языка за счет более простого поиска работы, даже учитывая текущую ситуацию на рынке труда.
Теперь поговорим о популярных тезисах которые отговаривают учить Go первым языком:
🔸 Go это про хайлоад, бигтехи, микросервисную архитектуру, многопоточность - это всё явно будет перегруз по информации для новичка.
С одной стороны это так - большинство вакансий в сфере связаны с микросервисами, высокими нагрузками, брокерами сообщений. Но при этом все равно существуют вакансии в которых на Go пишут типичные REST API круды, хоть их и меньше. Так же по сути этот тезис говорит о том что "нужно больше знаний для работы, чем для типичного джангиста на Python". Думаю это действительно так, но на практике это означает что нужно просто закладывать на обучение несколько дополнительных месяцев.
🔸 Вакансий на Go в несколько раз меньше чем на других языках, а меньше доступных вакансий - меньше собесов.
Это тоже правда, вакансий меньше - но и конкуренция меньше. По моему опыту, когда я перекатывался в Go - получить N собесов было проще чем такое же количество собесов на фронтендера, следовательно, легче научиться проходить эти собеседования.
🔸 Пройти собеседование на Go разработчика сложнее - нужно знать много чего кроме самого Go, базы данных, кафку, систем дизайн.
По моему опыту - подготовится к собеседованию на Go оказалось проще чем на собеседование на фронтендера. Я для подготовки к собеседованиям использовал подход со шпаргалкой и записью в конспект самых популярных вопросов с собеседований. Для переката в Go в моей шпаргалке накопилось около 100 вопросов, при этом ~80% из них - это вопросы по базе Golang, многопоточности и сетям. Остальные 20% это вопросы по БД, микросервисам, кафке и тд. Иногда таких вопросов вообще не было. При этом в шпаргалке для собесов на фронтендера - собралось около 250 вопросов. С одной стороны эти вопросы могут быть сложнее, особенно учитывая многопоточность - но самих вариаций вопросов меньше, в итоге подготовится к собеседованиям занимает меньше времени. Систем дизайн меня спрашивали только на вакансии с грейдом Senior.
Учитывая эти факторы и потребность компаний в Go разработчиках - Я считаю что Golang постепенно перестанет быть языком свитчеров и еще через пару лет станет в один ряд с типичными для новичков языками как JS, Python, Java, PHP и прочие.
Если вы сейчас на этапе выбора своего первого языка - я рекомендую не проходить мимо Go и рассмотреть его как кандидата на изучение.
Golang долгое время считался исключительно языком свитчеров, т.е. людей которые уже имеют опыт в программировании и хотят изменить стек. На мой взгляд это было актуально несколько лет назад и сейчас ситуация меняется. Сегодня попробую порассуждать на тему того имеет ли смысл изучать Golang первым языком программирования.
Начнем с исследований:
Только 66% опрошенных уже работали разработчиком до перехода на Go. При этом для ~30% опрошенных работа Go-разработчиком было либо первой работой, либо до этого они работали кем-то другим (не разработчиком, не QA, не DevOps). Выходит что для трети текущих гошников - это первый язык программирования. Много это или мало - вопрос дискуссионный. На мой взгляд это достаточная цифра, чтобы рассматривать этот язык для начала своей карьеры в IT.
Теперь поговорим о популярных тезисах которые отговаривают учить Go первым языком:
🔸 Go это про хайлоад, бигтехи, микросервисную архитектуру, многопоточность - это всё явно будет перегруз по информации для новичка.
С одной стороны это так - большинство вакансий в сфере связаны с микросервисами, высокими нагрузками, брокерами сообщений. Но при этом все равно существуют вакансии в которых на Go пишут типичные REST API круды, хоть их и меньше. Так же по сути этот тезис говорит о том что "нужно больше знаний для работы, чем для типичного джангиста на Python". Думаю это действительно так, но на практике это означает что нужно просто закладывать на обучение несколько дополнительных месяцев.
🔸 Вакансий на Go в несколько раз меньше чем на других языках, а меньше доступных вакансий - меньше собесов.
Это тоже правда, вакансий меньше - но и конкуренция меньше. По моему опыту, когда я перекатывался в Go - получить N собесов было проще чем такое же количество собесов на фронтендера, следовательно, легче научиться проходить эти собеседования.
🔸 Пройти собеседование на Go разработчика сложнее - нужно знать много чего кроме самого Go, базы данных, кафку, систем дизайн.
По моему опыту - подготовится к собеседованию на Go оказалось проще чем на собеседование на фронтендера. Я для подготовки к собеседованиям использовал подход со шпаргалкой и записью в конспект самых популярных вопросов с собеседований. Для переката в Go в моей шпаргалке накопилось около 100 вопросов, при этом ~80% из них - это вопросы по базе Golang, многопоточности и сетям. Остальные 20% это вопросы по БД, микросервисам, кафке и тд. Иногда таких вопросов вообще не было. При этом в шпаргалке для собесов на фронтендера - собралось около 250 вопросов. С одной стороны эти вопросы могут быть сложнее, особенно учитывая многопоточность - но самих вариаций вопросов меньше, в итоге подготовится к собеседованиям занимает меньше времени. Систем дизайн меня спрашивали только на вакансии с грейдом Senior.
Учитывая эти факторы и потребность компаний в Go разработчиках - Я считаю что Golang постепенно перестанет быть языком свитчеров и еще через пару лет станет в один ряд с типичными для новичков языками как JS, Python, Java, PHP и прочие.
Если вы сейчас на этапе выбора своего первого языка - я рекомендую не проходить мимо Go и рассмотреть его как кандидата на изучение.
Please open Telegram to view this post
VIEW IN TELEGRAM
Please open Telegram to view this post
VIEW IN TELEGRAM
👍25❤14🔥3⚡2🤔2
Почему я выбрал Golang, а не Node.js?
Несколько раз Фронтенд разработчики задавали мне этот вопрос. Действительно с первого взгляда кажется что если ты фронтендер и хочешь свичнуться в бэкенд - наиболее органичный путь для этого - перейти в Backend на JavaScript.
Для начала объясню почему я согласен, что такой путь действительно является последовательным для перехода из Frontend в Backend:
✅ Не нужно учить новый язык программирования, синтаксис тебе уже известен, нужно лишь изучить особенности платформы Node.js
✅ Если в компании хотя бы часть бэкенда написана на JS - есть возможность плавно начать получить опыт в бэкенде не меняя место работы, например начать писать юнит-тесты помогая бэкендерам или даже брать мелкие задачи из техдолга
✅ По моему опыту компании идут на встречу такому развитию сотрудника, ведь для них выгодно иметь разработчика, который при необходимости может делать задачи и на фронте и на бэке, по сути иметь фуллстека под рукой
Почему я все таки решил пойти по другому пути и сразу переквалифицироваться в Go Backend минуя более плавный переход через ноду:
⚠️ Путь перехода через Node.js более долгий. На тот момент моя компания предлагала мне такой вариант в котором я буду по чуть-чуть брать задачи по бэкенду, набираться опыта, а после того как получу некоторую экспертизу по бэкенду на Node - смогу перейти в другую команду в которой пишут на Go. По моей оценке такой путь занял бы от полугода до года в лучшем случае. Я уже имел опыт когда компания обещала мне переход из одной сферы в другую - и по моему опыту компания затягивала этот переход, так как одной команде не выгодно терять опытного специалиста, а другой не выгодно принимать нового специалиста с маленьким опытом в новой сфере.
⚠️ Я много слышал о том что "настоящий высоконагруженный бекенд" в основном пишется не на JS, а на более строгих языках. В компании в которой я работал на тот момент хоть и были микросервисы на JS - все таки основные самые важные и требовательные к надежности сервисы (например, обработка платежной информации) были написаны на Go и С++.
⚠️ Я точно понимал - я не хочу быть фуллстеком. Мы обсуждали это на одном из подкастов - в моем понимании фуллстек это что-то из разряда "Я умею чуть-чуть и на бэкенде и на фронтенде, но глубоко не знаком ни с тем ни с тем". Помимо этого в моем понимании фуллстек в компании - это часто попытка сэкономить деньги, что бы не нанимать двух специалистов, т.е. знать нужно больше, при этом платят примерно столько же.
⚠️ Я проводил анализ рынка труда и видел что на тот момент Go был очень хайповым языком, компании осознали что они нуждаются в гошниках, при этом гошников на рынке труда было очень мало. Из этого следует что Go разработчики более востребованы, на рынке ощущается их нехватка.
⚠️ Честно скажу - одной из причин было сравнение зарплат Golang разработчиков и Node.js разработчиков. Для примера по статистике с Хабра за первую половину 2024 года - Go входил в Топ-4 по зарплатам, в то время как JavaSciprt не попадал даже в Топ-10.
💡На основе данных факторов я решил что все таки более резкий и по своему более сложный переход сразу в Go бэкенд для меня является более приоритетным.
Хотя такой резкий переход сложнее и более трудоемкий - он сразу позволяет начать получить опыт в Backend, без всяких полутонов и зависаний в состоянии "Ну ты поделай пару бекенд задач и мы подумаем можно ли тебя перевести в другую команду когда-нибудь попозже"
Несколько раз Фронтенд разработчики задавали мне этот вопрос. Действительно с первого взгляда кажется что если ты фронтендер и хочешь свичнуться в бэкенд - наиболее органичный путь для этого - перейти в Backend на JavaScript.
Для начала объясню почему я согласен, что такой путь действительно является последовательным для перехода из Frontend в Backend:
✅ Не нужно учить новый язык программирования, синтаксис тебе уже известен, нужно лишь изучить особенности платформы Node.js
✅ Если в компании хотя бы часть бэкенда написана на JS - есть возможность плавно начать получить опыт в бэкенде не меняя место работы, например начать писать юнит-тесты помогая бэкендерам или даже брать мелкие задачи из техдолга
✅ По моему опыту компании идут на встречу такому развитию сотрудника, ведь для них выгодно иметь разработчика, который при необходимости может делать задачи и на фронте и на бэке, по сути иметь фуллстека под рукой
Почему я все таки решил пойти по другому пути и сразу переквалифицироваться в Go Backend минуя более плавный переход через ноду:
⚠️ Путь перехода через Node.js более долгий. На тот момент моя компания предлагала мне такой вариант в котором я буду по чуть-чуть брать задачи по бэкенду, набираться опыта, а после того как получу некоторую экспертизу по бэкенду на Node - смогу перейти в другую команду в которой пишут на Go. По моей оценке такой путь занял бы от полугода до года в лучшем случае. Я уже имел опыт когда компания обещала мне переход из одной сферы в другую - и по моему опыту компания затягивала этот переход, так как одной команде не выгодно терять опытного специалиста, а другой не выгодно принимать нового специалиста с маленьким опытом в новой сфере.
⚠️ Я много слышал о том что "настоящий высоконагруженный бекенд" в основном пишется не на JS, а на более строгих языках. В компании в которой я работал на тот момент хоть и были микросервисы на JS - все таки основные самые важные и требовательные к надежности сервисы (например, обработка платежной информации) были написаны на Go и С++.
⚠️ Я точно понимал - я не хочу быть фуллстеком. Мы обсуждали это на одном из подкастов - в моем понимании фуллстек это что-то из разряда "Я умею чуть-чуть и на бэкенде и на фронтенде, но глубоко не знаком ни с тем ни с тем". Помимо этого в моем понимании фуллстек в компании - это часто попытка сэкономить деньги, что бы не нанимать двух специалистов, т.е. знать нужно больше, при этом платят примерно столько же.
⚠️ Я проводил анализ рынка труда и видел что на тот момент Go был очень хайповым языком, компании осознали что они нуждаются в гошниках, при этом гошников на рынке труда было очень мало. Из этого следует что Go разработчики более востребованы, на рынке ощущается их нехватка.
⚠️ Честно скажу - одной из причин было сравнение зарплат Golang разработчиков и Node.js разработчиков. Для примера по статистике с Хабра за первую половину 2024 года - Go входил в Топ-4 по зарплатам, в то время как JavaSciprt не попадал даже в Топ-10.
💡На основе данных факторов я решил что все таки более резкий и по своему более сложный переход сразу в Go бэкенд для меня является более приоритетным.
Хотя такой резкий переход сложнее и более трудоемкий - он сразу позволяет начать получить опыт в Backend, без всяких полутонов и зависаний в состоянии "Ну ты поделай пару бекенд задач и мы подумаем можно ли тебя перевести в другую команду когда-нибудь попозже"
👍21❤10💯5🔥3👨💻1
Как менялось мое отношение к аналитике
Речь пойдет именно про бизнес/системную аналитику и требования в IT проектах.
Моё первое место работы было банком и именно банк сформировал мои ожидания от уровня требований и проработки задач.
1️⃣ В банке у нас для каждой отдельной задачи всегда назначался бизнес аналитик. Он полностью отвечал за формирование требований, про то что надо сделать, с кем связаться что бы это сделать, что учесть, даже согласовывал с QA тест-кейсы что бы они проверяли все важные случаи. У него всегда можно было спросить какие-то непонятки по задаче и получить ответ. По сути задача сводилась к тому что "сделать как в ТЗ" (ТЗ даже было 😁)
🔸 Это сформировало у меня мнение, что такая ситуация - это стандарт индустрии, я сменил несколько проектов внутри банка и на каждом было по несколько аналитиков.
2️⃣ После этого я попал в небольшую региональную аутсорс компанию, которая работала над проектами из Великобритании. Там была небольшая команда, требования мы часто получали на словах прямо от заказчика и меня это не удивляло.
В моем понимании для маленького аутсорса это нормально, странно было бы от него ожидать большего, всё-таки ресурсы сильно ограничены тем сколько платит заказчик за каждого члена команды, поэтому в команде было много кросс функциональности в одном человеке. Да и задач было не так много что бы выделять отдельную роль под аналитику.
3️⃣ Далее я открыл для себя мир разработки по новому - впервые попал в продуктовую компанию которая зарабатывала на своем продукте. Работа довольно сильно отличалась от аутсорса - но было одно сходство - отсутствие аналитиков.
Требования для задачи на этот раз получал менеджер проекта напрямую от заказчика, а после структурирования передавал нашей команде.
В этой компании я впервые узнал про совместную проработку задач на PBR, покер-планирование, начал в этом участвовать и мне это нравилось.
🔸Тогда отсутствие аналитиков я объяснял себе тем что "ну видимо просто повезло попасть на такое исключение, наверняка в остальных компаниях с этим всё лучше".
4️⃣ Когда я еще раз сменил работу на другую продуктовую компанию (в которой тоже нет аналитики, ТЗ и разработчики сами прорабатывают задачи) - я начал задумываться может всё-таки вот этот стандарт индустрии - а ситуация в банке это исключение из правила?
Окончательно я убедился в этом когда походил по собеседованиям в бигтех компании типа Ozon, Авито и тд (которые мне казались эталоном) и на собеседованиях удивлялись моим вопросам про аналитику и говорили что этим всем занимаются разработчики у них.
🔹Сейчас я окончательно изменил свое мнение, на собеседованиях я больше не говорю что "ищу место с понятными задачами". Наоборот теперь я продаю себя как специалиста, который знает и умеет самостоятельно проводить ресерч, выяснять и формулировать требования, разбирается что нужно сделать, а не только как и готов к этому
На текущий момент я думаю - это и есть стандарт индустрии
Речь пойдет именно про бизнес/системную аналитику и требования в IT проектах.
Моё первое место работы было банком и именно банк сформировал мои ожидания от уровня требований и проработки задач.
1️⃣ В банке у нас для каждой отдельной задачи всегда назначался бизнес аналитик. Он полностью отвечал за формирование требований, про то что надо сделать, с кем связаться что бы это сделать, что учесть, даже согласовывал с QA тест-кейсы что бы они проверяли все важные случаи. У него всегда можно было спросить какие-то непонятки по задаче и получить ответ. По сути задача сводилась к тому что "сделать как в ТЗ" (ТЗ даже было 😁)
🔸 Это сформировало у меня мнение, что такая ситуация - это стандарт индустрии, я сменил несколько проектов внутри банка и на каждом было по несколько аналитиков.
2️⃣ После этого я попал в небольшую региональную аутсорс компанию, которая работала над проектами из Великобритании. Там была небольшая команда, требования мы часто получали на словах прямо от заказчика и меня это не удивляло.
В моем понимании для маленького аутсорса это нормально, странно было бы от него ожидать большего, всё-таки ресурсы сильно ограничены тем сколько платит заказчик за каждого члена команды, поэтому в команде было много кросс функциональности в одном человеке. Да и задач было не так много что бы выделять отдельную роль под аналитику.
3️⃣ Далее я открыл для себя мир разработки по новому - впервые попал в продуктовую компанию которая зарабатывала на своем продукте. Работа довольно сильно отличалась от аутсорса - но было одно сходство - отсутствие аналитиков.
Требования для задачи на этот раз получал менеджер проекта напрямую от заказчика, а после структурирования передавал нашей команде.
В этой компании я впервые узнал про совместную проработку задач на PBR, покер-планирование, начал в этом участвовать и мне это нравилось.
🔸Тогда отсутствие аналитиков я объяснял себе тем что "ну видимо просто повезло попасть на такое исключение, наверняка в остальных компаниях с этим всё лучше".
4️⃣ Когда я еще раз сменил работу на другую продуктовую компанию (в которой тоже нет аналитики, ТЗ и разработчики сами прорабатывают задачи) - я начал задумываться может всё-таки вот этот стандарт индустрии - а ситуация в банке это исключение из правила?
Окончательно я убедился в этом когда походил по собеседованиям в бигтех компании типа Ozon, Авито и тд (которые мне казались эталоном) и на собеседованиях удивлялись моим вопросам про аналитику и говорили что этим всем занимаются разработчики у них.
🔹Сейчас я окончательно изменил свое мнение, на собеседованиях я больше не говорю что "ищу место с понятными задачами". Наоборот теперь я продаю себя как специалиста, который знает и умеет самостоятельно проводить ресерч, выяснять и формулировать требования, разбирается что нужно сделать, а не только как и готов к этому
На текущий момент я думаю - это и есть стандарт индустрии
🔥16❤6🤔4💯3
Случайности не случайны... или как выиграть в лотерее
Обычно когда нам нужно сгенерировать какое-то случайное число - мы просто используем готовую функцию из библиотеки языка программирования, вызываем её и получаем некоторое случайное число.
Но если задуматься - как это число может быть случайным? Оно создается с помощью какого то алгоритма который написал человек. Алгоритм изначально известен, следовательно, он создает число на основе чего-то созданного заранее определенным образом, что уже исключает то что это число случайное.
В действительности можно разделить числа на случайные, псевдослучайные и криптографически стойкие случайные числа.
Те числа которые мы в общем случае генерируем в задаче на литкод собеседовании - псевдослучайные. Если знать то по какому алгоритму они создают число - можно предугадать какое число выпадет при нужных условиях.
Криптографически стойкие случайные числа - это уже более приближенный вариант к "чистой случайности". Если мы добавим к генерации какой-то эффект который трудно предсказать - это значительно повысит вероятность того что зная условия будет сложно предсказать значение числа. Способов это сделать много, начиная от использования каких то системных параметров, например времени или такта процессора, заканчивая специальными устройствами которые считывают радиоактивный фон или тепловые помехи от работы резисторов.
Такие числа максимально приближены к "случайности", но всё-таки не являются ей. На данный момент мы не имеем возможности генерировать гарантированно 100% чистую случайность, даже если использовать разнообразные физические процессы вроде каких либо данных из космоса или атмосферные шумы - в теории это все равно можно повторить и предсказать, хоть и технически невозможно на данный момент.
Псевдослучайные числа используются когда нам нужна имитация случайности. Если речь идет о генерации чувствительных данных, например токенов, ключей, шифрования и так далее - используются криптографически стойкие числа.
Так же одна из сфер где важно применять более случайные числа - это лотереи и казино. 🎰
Если этого не делать - может произойти ситуация когда кто-то попытается предсказать результат случайного события и получить выгоду. Например, история Эдди Типтона который имея доступ к генератору чисел успешно программно повлиял на выдачу результатов (правда в итоге его арестовали 😢)
Конкретно в Golang для генерации обоих чисел используются пакеты
Теперь, когда ваш друг скажет, что он “случайно” опоздал на встречу — знайте, что это, скорее всего, не случайность, а просто плохо сработавший генератор событий
Обычно когда нам нужно сгенерировать какое-то случайное число - мы просто используем готовую функцию из библиотеки языка программирования, вызываем её и получаем некоторое случайное число.
Но если задуматься - как это число может быть случайным? Оно создается с помощью какого то алгоритма который написал человек. Алгоритм изначально известен, следовательно, он создает число на основе чего-то созданного заранее определенным образом, что уже исключает то что это число случайное.
В действительности можно разделить числа на случайные, псевдослучайные и криптографически стойкие случайные числа.
Случайность числа определяется тем можем ли мы повторить исходные условия и действия - и получить то же самое число.Те числа которые мы в общем случае генерируем в задаче на литкод собеседовании - псевдослучайные. Если знать то по какому алгоритму они создают число - можно предугадать какое число выпадет при нужных условиях.
Криптографически стойкие случайные числа - это уже более приближенный вариант к "чистой случайности". Если мы добавим к генерации какой-то эффект который трудно предсказать - это значительно повысит вероятность того что зная условия будет сложно предсказать значение числа. Способов это сделать много, начиная от использования каких то системных параметров, например времени или такта процессора, заканчивая специальными устройствами которые считывают радиоактивный фон или тепловые помехи от работы резисторов.
Такие числа максимально приближены к "случайности", но всё-таки не являются ей. На данный момент мы не имеем возможности генерировать гарантированно 100% чистую случайность, даже если использовать разнообразные физические процессы вроде каких либо данных из космоса или атмосферные шумы - в теории это все равно можно повторить и предсказать, хоть и технически невозможно на данный момент.
Псевдослучайные числа используются когда нам нужна имитация случайности. Если речь идет о генерации чувствительных данных, например токенов, ключей, шифрования и так далее - используются криптографически стойкие числа.
Так же одна из сфер где важно применять более случайные числа - это лотереи и казино. 🎰
Если этого не делать - может произойти ситуация когда кто-то попытается предсказать результат случайного события и получить выгоду. Например, история Эдди Типтона который имея доступ к генератору чисел успешно программно повлиял на выдачу результатов (правда в итоге его арестовали 😢)
Конкретно в Golang для генерации обоих чисел используются пакеты
math/rand и crypto/rand. Казалось бы почему бы не использовать всегда пакет crypto/rand с более случайными числами? На деле это просто дороже так как происходит обращение к системным источникам, а мы ведь любим экономить байты 😉Теперь, когда ваш друг скажет, что он “случайно” опоздал на встречу — знайте, что это, скорее всего, не случайность, а просто плохо сработавший генератор событий
🔥19👍4⚡3❤3🐳3👎1
Свежий опрос по Golang за 2025 год
В одном из прошлых постов на тему выбирать ли Go как первый язык программирования я ссылался на исследование рынка от devcrowd. Там я через немного косвенный подсчет определил что примерно треть текущих Go-разработчиков на рынке - учили Go как первый язык.
В новом исследовании ребята прямо решили задать этот вопрос в виде "Какой язык программирования у вас был основной до Go?", согласно ответам почти 22% выбрали его как первый. Это более точная информация которая немного ниже чем то что я косвенно подсчитывал по результатам прошлого года.
Рекомендую ознакомится самим, но так же поделюсь тем что я отметил для себя интересным:
🏢 Последние 2 года часто слышал про то что компании активно начинают выгонять сотрудников в офис что бы огромные арендуемые площади не простаивали, постковидные времена удаленки кончаются и работодатели активней хотят бороться с overemployment.
На деле по результатам опроса - 60% работают полностью удаленно, а еще 20% иногда посещают офис, нарратив про возвращение в офис с Go-шниками не подтверждается
🧠 Использование AI в работе увеличилось, если год назад треть разработчиков не использовало AI никак - то сейчас таких осталось только 10%.
На мой взгляд если вы до сих пор не используете AI в работе - вы уже ощутимо отстаете от индустрии. Если такие слова как Cursor, Claude Code, Codex, LLM-агенты, MCP - для вас что то незнакомое - пора бежать актуализировать свои знания. При этом 67% недовольны качеством работы AI. Это интересная закономерность - почти все используют и одновременно большинство недовольны этим использованием 😁
🔨 Почти 90% стараются стабильно обновлять версию Go и не устаревать больше чем на 1-2 версии. Для меня было удивительна эта цифра, хотя я сам всегда являюсь инициатором обновления версии Go на проектах, в близжайшем окружении оказалось что ребята не стремятся к этому. В моем понимании следить за версией нужно, как и своевременно обновляться. Если у вас версия 1.23 или старше - самое время обновится, так как последний фикс на нее полгода назад.
💵 По зарплатам картина от года в году не сильно поменялась, разве что подросли зарплаты у джунов. Большинство мидлов в вилке от 150 до 300к рублей, большинство синьеров от 300 до 450к рублей. Эти данные немного не совпадают с статистикой Хабр.Карьеры на которую я часто ссылаюсь (на хабре медианные вилки повыше). Из забавного в опросе есть один человек Senior с зарплатой до 100 тысяч рублей, либо это была шутка либо чуваку пора бежать оттуда
🤨 Так же из смешного на вопрос "Как вы чаще всего работаете с ошибками в Go?" где 9 человек ответили "Не обращаю на это внимания". Видимо некоторые люди могут перейти из PHP/Python в Go, но PHP/Python из них не уходит
🔎 Большинство разработчиков либо не планируют искать работу в ближайший год, либо рассматривают предложения, но активно не ищут. Я думаю это говорит о том что хайп го еще никуда не делся (хоть и уменьшился) и что бы найти специалиста с опытом - нужно не только рассматривать ищущих работу - но и заниматься хантингом тех кто уходить из текущей компании не планирует
В одном из прошлых постов на тему выбирать ли Go как первый язык программирования я ссылался на исследование рынка от devcrowd. Там я через немного косвенный подсчет определил что примерно треть текущих Go-разработчиков на рынке - учили Go как первый язык.
В новом исследовании ребята прямо решили задать этот вопрос в виде "Какой язык программирования у вас был основной до Go?", согласно ответам почти 22% выбрали его как первый. Это более точная информация которая немного ниже чем то что я косвенно подсчитывал по результатам прошлого года.
Рекомендую ознакомится самим, но так же поделюсь тем что я отметил для себя интересным:
🏢 Последние 2 года часто слышал про то что компании активно начинают выгонять сотрудников в офис что бы огромные арендуемые площади не простаивали, постковидные времена удаленки кончаются и работодатели активней хотят бороться с overemployment.
На деле по результатам опроса - 60% работают полностью удаленно, а еще 20% иногда посещают офис, нарратив про возвращение в офис с Go-шниками не подтверждается
🧠 Использование AI в работе увеличилось, если год назад треть разработчиков не использовало AI никак - то сейчас таких осталось только 10%.
На мой взгляд если вы до сих пор не используете AI в работе - вы уже ощутимо отстаете от индустрии. Если такие слова как Cursor, Claude Code, Codex, LLM-агенты, MCP - для вас что то незнакомое - пора бежать актуализировать свои знания. При этом 67% недовольны качеством работы AI. Это интересная закономерность - почти все используют и одновременно большинство недовольны этим использованием 😁
🤨 Так же из смешного на вопрос "Как вы чаще всего работаете с ошибками в Go?" где 9 человек ответили "Не обращаю на это внимания". Видимо некоторые люди могут перейти из PHP/Python в Go, но PHP/Python из них не уходит
🔎 Большинство разработчиков либо не планируют искать работу в ближайший год, либо рассматривают предложения, но активно не ищут. Я думаю это говорит о том что хайп го еще никуда не делся (хоть и уменьшился) и что бы найти специалиста с опытом - нужно не только рассматривать ищущих работу - но и заниматься хантингом тех кто уходить из текущей компании не планирует
Please open Telegram to view this post
VIEW IN TELEGRAM
🔥17👍5❤4
Отрицательный рост из сеньера в джуна
Несколько раз встречал дискуссию на тему того как разработчики с хорошим опытом в одном стеке (мидлы/сеньеры) думаю о смене стека и при этом говорят о том что они станут джунами при этом
Меня поражает насколько люди готовы обесценивать свой опыт и насколько готовы следовать формальностям в виде опыта и грейдов при самооценке себя как специалиста.
Под специалистом в данном контексте я имею в виду человека который пару лет уже поработал где то
Например, что я чаще всего слышу при смене стека с Frontend на Backend:
🔻я не занимался бэком до этого коммерчески, значит я джун, мне нужно даунгредится до начальной позиции
🔻 я не работал с базами данных в коммерческом проекте - значит я джун
🔻 я еще не писал на этом новом языке коммерческий код - значит я джун
🔻 я не смогу выполнять задачи так же эффективно как мидл/сеньер первое время - значит я джун
При этом практически полностью упускаются другие важные навыки которые УЖЕ есть у человека с опытом работы в разработке, но отсутствуют или слабо развиты у джуна:
🔹Самое главное - человек уже умеет программировать, логическо-техническое мышление сформировано, не нужно тратить время на изучение циклов, асинхронности, функциональщины/ООП, паттернов вроде DRY/KISS и прочего. В моем опыте научится программировать было самым сложным, а не изучение какого то конкретного синтаксиса
🔹Человек уже умеет декомпозировать задачи на подзадачи и более мелкие шаги необходимые для реализации, что для разработки очень важно
🔹Человек уже умеет прорабатывать и уточнять требования задачи, особенно если до этого работал без аналитики. Знает что если что то непонятно в какие моменты нужно сходить в проект соседней команды и узнать как аналогичное решение сделано у них. Знает в каком моменте надо сходить в другой отдел за вопросами, а в какой момент можно самостоятельно принять решение о реализации
🔹Человек уже умеет коммуницировать с командой и другими специалистами. Знает что с одними коллегами лучше созваниваться, а с некоторыми лучше списаться в чате
🔹 Если речь о работе на удаленке - умеет работать без начальника сидящего за спиной с кнутом, создает видимый результат, не пропадает зарывшись в задачу на 5 дней без видимых продвижений и не задавая вопросов
Это большой и важный скоуп знаний которые никуда не пропадают при изменении всего одного параметра - стека.
Redis, очереди, БД, какие то сторонние сервисы - для опытного разработчика это просто очередная система у которой есть интерфейс, контракт для работы с ней, есть документация и определенные паттерны работы. Изучение как работать с Kafka или как применять API очередной криптобиржи концептуально мало отличается.
А в эпоху нейронок и повсеместного использования AI - знания синтаксиса конкретного языка программирования становятся все менее и менее ценными, в то время как ценность вышеописанных навыков - остается прежней.
Несколько раз встречал дискуссию на тему того как разработчики с хорошим опытом в одном стеке (мидлы/сеньеры) думаю о смене стека и при этом говорят о том что они станут джунами при этом
Меня поражает насколько люди готовы обесценивать свой опыт и насколько готовы следовать формальностям в виде опыта и грейдов при самооценке себя как специалиста.
Под специалистом в данном контексте я имею в виду человека который пару лет уже поработал где то
Например, что я чаще всего слышу при смене стека с Frontend на Backend:
🔻я не занимался бэком до этого коммерчески, значит я джун, мне нужно даунгредится до начальной позиции
🔻 я не работал с базами данных в коммерческом проекте - значит я джун
🔻 я еще не писал на этом новом языке коммерческий код - значит я джун
🔻 я не смогу выполнять задачи так же эффективно как мидл/сеньер первое время - значит я джун
При этом практически полностью упускаются другие важные навыки которые УЖЕ есть у человека с опытом работы в разработке, но отсутствуют или слабо развиты у джуна:
🔹Самое главное - человек уже умеет программировать, логическо-техническое мышление сформировано, не нужно тратить время на изучение циклов, асинхронности, функциональщины/ООП, паттернов вроде DRY/KISS и прочего. В моем опыте научится программировать было самым сложным, а не изучение какого то конкретного синтаксиса
🔹Человек уже умеет декомпозировать задачи на подзадачи и более мелкие шаги необходимые для реализации, что для разработки очень важно
🔹Человек уже умеет прорабатывать и уточнять требования задачи, особенно если до этого работал без аналитики. Знает что если что то непонятно в какие моменты нужно сходить в проект соседней команды и узнать как аналогичное решение сделано у них. Знает в каком моменте надо сходить в другой отдел за вопросами, а в какой момент можно самостоятельно принять решение о реализации
🔹Человек уже умеет коммуницировать с командой и другими специалистами. Знает что с одними коллегами лучше созваниваться, а с некоторыми лучше списаться в чате
🔹 Если речь о работе на удаленке - умеет работать без начальника сидящего за спиной с кнутом, создает видимый результат, не пропадает зарывшись в задачу на 5 дней без видимых продвижений и не задавая вопросов
Это большой и важный скоуп знаний которые никуда не пропадают при изменении всего одного параметра - стека.
Redis, очереди, БД, какие то сторонние сервисы - для опытного разработчика это просто очередная система у которой есть интерфейс, контракт для работы с ней, есть документация и определенные паттерны работы. Изучение как работать с Kafka или как применять API очередной криптобиржи концептуально мало отличается.
А в эпоху нейронок и повсеместного использования AI - знания синтаксиса конкретного языка программирования становятся все менее и менее ценными, в то время как ценность вышеописанных навыков - остается прежней.
1❤23🔥15💯9👍8🍾1
Борьба хехеру с автооткликами
Во второй половине 2025 года произошел расцвет продуктов для автооткликов на вакансии которые позволяли не тратить свое время на отклики, сопроводительные письма, а делать это автоматически с помощью публично доступного API.
В связи с экономической ситуацией рынок труда стал еще жестче и веерные автоотклики стали одним из валидных и рабочих способов для того что бы получить собеседования и найти работу как новичкам так и айтишникам с опытом
💵 Продуктов стало так много (лично я насчитал 7 платных продуктов не считая опенсорс решений) что автотклики заполонили платформу и хехера решила ограничить доступ к API под предлогом защиты персональных данных и остановки спама нерелевантных откликов. Проблема действительно имела место быть, так как не все продукты работали хорошо, не все правильно настраивали их и поэтому это увеличило количество нерелевантных откликов
💰На деле же хехера решила внедрить этот функционал на своей стороне. С точки зрения бизнеса - это вполне рациональное решение, есть мы видим спрос на такую фичу у соискателей - хорошая идея реализовать ее самостоятельно и получать деньги за нее самим, а не отдавать прибыль продуктам сделанных поверх публичного API.
🙈 Но оказалось после того как хехера добавила возможность платных автоотликов для соискателей - вместе с этим она добавила возможность по клику убирать из выдачи таких кандидатов у работодателя. Отличное решение, правда кандидаты узнав про это по какой-то причине обозлились на хехеру и почувствовали что их кинули, в итоге фича спросом не пользуется.
Реакция пользователей разделилась на 2 лагеря:
🔺 Те кому закрытие API не понравилось так как они лишились инструмента помогающего найти работу на сложном рынке труда
🔻 Те кто считал что это сделает ситуацию "честнее", ведь те кто не использовал автоотклики проигрывали в кокнуренции тем кто использовал
На деле же, ситуацию это не улучшило никак, ибо продукты создающие автоотклики просто перейдут с API на e2e парсинг/скраппинг и продолжат свою работу, возможно повысив цены из-за того что такой способ работы дороже из-за больших затрат на разработку и обход защиты хехеры.
Итоги:
➖минус репутация хехеры
➖больше головной боли создателей продуктов автооткликов
➖увеличение стоимости таких продуктов для потребителя
➖отсутствие решения проблемы
*Хехера - мифологическое существо завлекающее путников ищущих работу в свое логово, создавая иллюзию возможностей найти работу и высасывает их силы, крадет время жизни человека и оставляет его ни с чем
Во второй половине 2025 года произошел расцвет продуктов для автооткликов на вакансии которые позволяли не тратить свое время на отклики, сопроводительные письма, а делать это автоматически с помощью публично доступного API.
В связи с экономической ситуацией рынок труда стал еще жестче и веерные автоотклики стали одним из валидных и рабочих способов для того что бы получить собеседования и найти работу как новичкам так и айтишникам с опытом
💵 Продуктов стало так много (лично я насчитал 7 платных продуктов не считая опенсорс решений) что автотклики заполонили платформу и хехера решила ограничить доступ к API под предлогом защиты персональных данных и остановки спама нерелевантных откликов. Проблема действительно имела место быть, так как не все продукты работали хорошо, не все правильно настраивали их и поэтому это увеличило количество нерелевантных откликов
💰На деле же хехера решила внедрить этот функционал на своей стороне. С точки зрения бизнеса - это вполне рациональное решение, есть мы видим спрос на такую фичу у соискателей - хорошая идея реализовать ее самостоятельно и получать деньги за нее самим, а не отдавать прибыль продуктам сделанных поверх публичного API.
🙈 Но оказалось после того как хехера добавила возможность платных автоотликов для соискателей - вместе с этим она добавила возможность по клику убирать из выдачи таких кандидатов у работодателя. Отличное решение, правда кандидаты узнав про это по какой-то причине обозлились на хехеру и почувствовали что их кинули, в итоге фича спросом не пользуется.
Реакция пользователей разделилась на 2 лагеря:
🔺 Те кому закрытие API не понравилось так как они лишились инструмента помогающего найти работу на сложном рынке труда
🔻 Те кто считал что это сделает ситуацию "честнее", ведь те кто не использовал автоотклики проигрывали в кокнуренции тем кто использовал
На деле же, ситуацию это не улучшило никак, ибо продукты создающие автоотклики просто перейдут с API на e2e парсинг/скраппинг и продолжат свою работу, возможно повысив цены из-за того что такой способ работы дороже из-за больших затрат на разработку и обход защиты хехеры.
Итоги:
➖минус репутация хехеры
➖больше головной боли создателей продуктов автооткликов
➖увеличение стоимости таких продуктов для потребителя
➖отсутствие решения проблемы
*Хехера - мифологическое существо завлекающее путников ищущих работу в свое логово, создавая иллюзию возможностей найти работу и высасывает их силы, крадет время жизни человека и оставляет его ни с чем
💯17😁11🔥8🐳3❤2👍2