
http://analysisacademy.com/wp-content/uploads/2016/12/daaa.gif
@analysisacademy
تحلیل تشخیصی
نظریه آغازین مربوط به تحلیل تشخیصی به دهه1930 و آثار آماردان انگلیسی کارل پیرسون و دیگران در زمینه فواصل گروه ها و یا ضرایب تشابه نژادی برمی گردد. اما به طور خاص، این روش اولین بار توسط فیشر در سال 1936 ابداع شد و بر پایه روش شناسی مورد استفاده در رگرسیون خطی چند متغییره(یعنی جبر ماتریس ها) جهت حل معادلات خطی توسعه یافت.
@analysisacademy
تحلیل تشخیصی برای طبقه بندی پاسخگویان بر اساس مقادیر(کدهای) یک متغییر وابسته اسمی دو یا چند وجهی به کار می رود. در واقع در مواردی که متغییر وابسته اسمی و متغییر مستقل کمی باشد به منظور پیش بینی تغییرات متغییر وابسته از روی متغییرهای مستقل از تحلیل تشخیصی استفاده می شود. تحلیل تشخیصی روشی است که متغییرهای مستقل را برای ایجاد یک متغییر جدید ترکیب می کند که هر یک از پاسخگویان برای آن مقداری به دست می آورند. این متغییر جدید که تابع تشخیصی نامیده می شود به گونه ای محاسبه می شد که پاسخگویان را بر حسب مقداری که به دست می آورند در طبقات مختلف مختلف متغییر وابسته تفکیک کند. بنابراین تحلیل تشخیصی درصدد است تا ترکیبهای خطی بین متغییرهای مستقل را که قادرند به بهترین نحو گروههای پاسخگویان را از هم جدا کنند شناسایی کند. این ترکیب های خطی توابع تشخیصی نام دارند.
@analysisacademy
از این رو می توان گفت که تحلیل تشخیصی شبیه رگرسیون خطی چند متغییره است با این تفاوت که در رگرسیون خطی متغییر وابسته در سطح فاصله ای/نسبی است اما در تحلیل تشخیصی مقیاس متغییر وابسته اسمی دو یا چند وجهی است . بررسی عوامل موثر بر رای دادن و ندادن به یک حزب سیاسی، مهاجرت و عدم مهاجرت روستاییان به شهرها،سوددهی یا عدم سوددهی یک شرکت، استقبال یا عدم استقبال شهروندان از یک کارت اعتباری خاص، رضایت و عدم رضایت کارکنان یک سازمان، خرید یا عدم خرید یک محصول خاص و ... جملگی نمونه هایی هستند که برای بررسی و آزمون آنها می توانیم روش تحلیل تشخیصی را به کار ببریم البته در صورتی که مقیاس تمامی متغییرهای مستقل فاصله ای یا نسبتی باشد.
@analysisacademy
کاربردهای تحلیل تشخیصی
در هنگام تحلیل داده ها،تحلیل تشخیصی را می توان برای چندین هدف مورد استفاده قرار داد. در این قسمت مهمترین اهداف و کاربردهای تحلیل تشخیصی را که عمومیت بیشتری دارند برمی شمریم:
1-طبقه بندی پاسخگویان به چندین گروه با استفاده از معادله پیش بینی تشخیصی
2-بررسی اختلاف های میانگین متغیر مستقل بین گروههایی که بر اساس متغییر وابسته تشکیل می شوند.
3-تعیین درصدی از واریانس متغییر وابسته که توسط متغییرهای مستقل تبیین شده اند.
4-تعیین درصدی از واریانس متغییر وابسته که توسط هم متغییرهای مستقل و هم متغییرهای کنترل تبیین شده اند.
5-ارزیابی اهمیت نسبی متغییرهای مستقل در طبقه بندی متغییرهای وابسته
6- کنار گذاشتن متغییرهایی که ارتباط کمتری با تمایزات گروهی دارند.
7-آزمون تئوری از طریق مشاهده این موضوع گه آیا پاسخگویان یا موارد همانگونه که پیش بینی می شد طبقه بنذی شده اند.
@analysisacademy
تحلیل تشخیصی
نظریه آغازین مربوط به تحلیل تشخیصی به دهه1930 و آثار آماردان انگلیسی کارل پیرسون و دیگران در زمینه فواصل گروه ها و یا ضرایب تشابه نژادی برمی گردد. اما به طور خاص، این روش اولین بار توسط فیشر در سال 1936 ابداع شد و بر پایه روش شناسی مورد استفاده در رگرسیون خطی چند متغییره(یعنی جبر ماتریس ها) جهت حل معادلات خطی توسعه یافت.
@analysisacademy
تحلیل تشخیصی برای طبقه بندی پاسخگویان بر اساس مقادیر(کدهای) یک متغییر وابسته اسمی دو یا چند وجهی به کار می رود. در واقع در مواردی که متغییر وابسته اسمی و متغییر مستقل کمی باشد به منظور پیش بینی تغییرات متغییر وابسته از روی متغییرهای مستقل از تحلیل تشخیصی استفاده می شود. تحلیل تشخیصی روشی است که متغییرهای مستقل را برای ایجاد یک متغییر جدید ترکیب می کند که هر یک از پاسخگویان برای آن مقداری به دست می آورند. این متغییر جدید که تابع تشخیصی نامیده می شود به گونه ای محاسبه می شد که پاسخگویان را بر حسب مقداری که به دست می آورند در طبقات مختلف مختلف متغییر وابسته تفکیک کند. بنابراین تحلیل تشخیصی درصدد است تا ترکیبهای خطی بین متغییرهای مستقل را که قادرند به بهترین نحو گروههای پاسخگویان را از هم جدا کنند شناسایی کند. این ترکیب های خطی توابع تشخیصی نام دارند.
@analysisacademy
از این رو می توان گفت که تحلیل تشخیصی شبیه رگرسیون خطی چند متغییره است با این تفاوت که در رگرسیون خطی متغییر وابسته در سطح فاصله ای/نسبی است اما در تحلیل تشخیصی مقیاس متغییر وابسته اسمی دو یا چند وجهی است . بررسی عوامل موثر بر رای دادن و ندادن به یک حزب سیاسی، مهاجرت و عدم مهاجرت روستاییان به شهرها،سوددهی یا عدم سوددهی یک شرکت، استقبال یا عدم استقبال شهروندان از یک کارت اعتباری خاص، رضایت و عدم رضایت کارکنان یک سازمان، خرید یا عدم خرید یک محصول خاص و ... جملگی نمونه هایی هستند که برای بررسی و آزمون آنها می توانیم روش تحلیل تشخیصی را به کار ببریم البته در صورتی که مقیاس تمامی متغییرهای مستقل فاصله ای یا نسبتی باشد.
@analysisacademy
کاربردهای تحلیل تشخیصی
در هنگام تحلیل داده ها،تحلیل تشخیصی را می توان برای چندین هدف مورد استفاده قرار داد. در این قسمت مهمترین اهداف و کاربردهای تحلیل تشخیصی را که عمومیت بیشتری دارند برمی شمریم:
1-طبقه بندی پاسخگویان به چندین گروه با استفاده از معادله پیش بینی تشخیصی
2-بررسی اختلاف های میانگین متغیر مستقل بین گروههایی که بر اساس متغییر وابسته تشکیل می شوند.
3-تعیین درصدی از واریانس متغییر وابسته که توسط متغییرهای مستقل تبیین شده اند.
4-تعیین درصدی از واریانس متغییر وابسته که توسط هم متغییرهای مستقل و هم متغییرهای کنترل تبیین شده اند.
5-ارزیابی اهمیت نسبی متغییرهای مستقل در طبقه بندی متغییرهای وابسته
6- کنار گذاشتن متغییرهایی که ارتباط کمتری با تمایزات گروهی دارند.
7-آزمون تئوری از طریق مشاهده این موضوع گه آیا پاسخگویان یا موارد همانگونه که پیش بینی می شد طبقه بنذی شده اند.
http://analysisacademy.com/wp-content/uploads/2016/12/EIGENVALUE.png
@analysisacademy
مقدار ویژه در تحلیل عاملی اکتشافی
مقدار ویژه میزان وارایانس تبیین شده بوسیله هر عامل را بیان می کند. یکی از ضوابط پرکاربرد در تعیین تعداد عاملها ، مقدار ویژه است که آن را معیار راکد نیز می گویند در تحلیل عاملی مقدار ویژه برابر است 1 می باشد در تحلیل عاملی مولفه های اصلی که مقدار ویژه آنان کمتر از 1 باشد به عنوان عاملهایی است که از نظر آماری معنی دار نیست و باید از تحلیل کنار گذاشته شود .
@analysisacademy
مقدار ویژه برای هر عامل نشان داده می شود، نسبتی از واریانس کل متغییرهاست که آن عامل تبیین می کند. به بیان دیگر مقدار ویژه عبارت است از سهم نسبی هر عامل از کل واریانس تمامی متغییرهای تحقیق. مقدار ویژه که آن را با ضریب لاندا و نماد آماری λ نشان می دهند از طریق مجموع مجذورات بارهای عاملی مربوط به تمامی متغییرهای آن عامل محاسبه می شود.
@analysisacademy
به عبارتی مجموع مجذورات بارهای عاملی هر عامل را مقدار ویژه آن عامل می نامند که از طریق فرمول زیر به دست می آید.به عنوان مثال مقدار ویژه برای عامل (f1) که در آن λ عبارت است از سهم عامل اول از کل واریانس تمامی متغییرها یعنی مجموع مجذورات ستون I ام (عامل اول) از ماتریس B
λ=Σb2 j
دامنه تغییران مقدار ویژه بین 0 تا 1 نوسان دارد و هرچه مقدار آن برای یک عامل بیشتر باشد سهم آن عامل در تبیین واریانس کل متغییرها بیش تر است و برعکس مقدار ویژه کمتر برای یک عامل دلالت بر سهم کمتر عامل مربوطه از کل واریانس تمامی متغییرها دارد.
@analysisacademy
در تحقیقات علوم اجتماعی فراوانی تجمعی درصد واریانس مربوط به مقدار ویژه نباید کمتر از 50 درصد باشد. در صورت وجود چنین حالتی باید به ماتریس عاملها نگاه کنیم و در آن متغییرهایی را که بار عاملی کمتری نسبت به متغییرهای دیگر دارند از تحلیل حذف کنیم. این عمل باعث می شود مقدار ویژه و در نتیجه درصد فراوانی تجمعی زیادتر شود.
آکادمی تحلیل آماری ایران برگزار می کند: دوره پنج روزه اس پی اس اس دیماه ۱۳۹۵
@analysisacademy
مقدار ویژه در تحلیل عاملی اکتشافی
مقدار ویژه میزان وارایانس تبیین شده بوسیله هر عامل را بیان می کند. یکی از ضوابط پرکاربرد در تعیین تعداد عاملها ، مقدار ویژه است که آن را معیار راکد نیز می گویند در تحلیل عاملی مقدار ویژه برابر است 1 می باشد در تحلیل عاملی مولفه های اصلی که مقدار ویژه آنان کمتر از 1 باشد به عنوان عاملهایی است که از نظر آماری معنی دار نیست و باید از تحلیل کنار گذاشته شود .
@analysisacademy
مقدار ویژه برای هر عامل نشان داده می شود، نسبتی از واریانس کل متغییرهاست که آن عامل تبیین می کند. به بیان دیگر مقدار ویژه عبارت است از سهم نسبی هر عامل از کل واریانس تمامی متغییرهای تحقیق. مقدار ویژه که آن را با ضریب لاندا و نماد آماری λ نشان می دهند از طریق مجموع مجذورات بارهای عاملی مربوط به تمامی متغییرهای آن عامل محاسبه می شود.
@analysisacademy
به عبارتی مجموع مجذورات بارهای عاملی هر عامل را مقدار ویژه آن عامل می نامند که از طریق فرمول زیر به دست می آید.به عنوان مثال مقدار ویژه برای عامل (f1) که در آن λ عبارت است از سهم عامل اول از کل واریانس تمامی متغییرها یعنی مجموع مجذورات ستون I ام (عامل اول) از ماتریس B
λ=Σb2 j
دامنه تغییران مقدار ویژه بین 0 تا 1 نوسان دارد و هرچه مقدار آن برای یک عامل بیشتر باشد سهم آن عامل در تبیین واریانس کل متغییرها بیش تر است و برعکس مقدار ویژه کمتر برای یک عامل دلالت بر سهم کمتر عامل مربوطه از کل واریانس تمامی متغییرها دارد.
@analysisacademy
در تحقیقات علوم اجتماعی فراوانی تجمعی درصد واریانس مربوط به مقدار ویژه نباید کمتر از 50 درصد باشد. در صورت وجود چنین حالتی باید به ماتریس عاملها نگاه کنیم و در آن متغییرهایی را که بار عاملی کمتری نسبت به متغییرهای دیگر دارند از تحلیل حذف کنیم. این عمل باعث می شود مقدار ویژه و در نتیجه درصد فراوانی تجمعی زیادتر شود.
آکادمی تحلیل آماری ایران برگزار می کند: دوره پنج روزه اس پی اس اس دیماه ۱۳۹۵

http://analysisacademy.com/wp-content/uploads/2016/12/model.png
@analysisacademy
ارزیابی مدل اندازه گیری انعکاسی و ترکیبی
پیش از این در دوره های مختلف آکادمی تحلیل آماری ایران پیرامون مدل های اندازه گیری انعکاسی و ترکیبی و روش های تشخیص این دو نوع مدل که بر اساس پرسش نامه ها یا به عبارتی شاخص های اندازه گیری متغیر های مکنون ایجاد شده است بحث کامل شده است. مدل های اندازه گیری در مدل سازی معادلات ساختاری به دو دسته اصلی مدل اندازه گیری انعکاسی و ترکیبی تقسیم می شود که در مقالات گذشته آن ها را معرفی و تفاوت های آنها را بیان کرده ایم.
@analysisacademy
متاسفانه یکی از اشتباهات رایج و بزرگ محققین در پژوهش های خویش عدم تدوین درست مدل اندازه گیری به عنوان مدلی انعکاسی و ترکیبی است که این اشتباه از عدم تشخیص آنها برای انتخاب یکی از این رویکرد ها ناشی می شود. در این مقاله تلاش شده روش های تشخیص مدل اندازه گیری انعکاسی از مدل اندازه گیری ترکیبی و ارزیابی این دو مدل از جنبه های مختلف بحث شود.
@analysisacademy
مفهوم مدل های ترکیبی که عمداتا از سال ۲۰۰۲ در تحقیقات بازاریابی روسیتر مطرح شد و در واقع انتقادی به تقلید صرف از رویه ی چرچیل در سال ۱۹۷۹ در ساخت مقیاس های اندازه گیری بود. چرا که او اساسا بر تکوین مقیاس بر اساس ملاحظات نظری اصرار داشت. اما علی رغم طرح مثال های مختلف و اجرای این مدل ها در دوره های آکادمی، محققین عزیز در تشخیص و ارزیابی این مدل های اندازه گیری انعکاسی و ترکیبی وارزیابی مدل اندازه گیری انعکاسی و ترکیبی با شک و تردید و مشکل روبرو هستند.
امید است که این ترجمه بر اساس مقاله کلتمن و همکارانش در سال ۲۰۰۸ که به ارزیابی مدل انعکاسی و ترکیبی بر اساس ملاحظات نظری و تجربی انجام گرفته است کمک شایانی به تشخیص محققین آکادمی و سایر محققین دیگر و نیز گسترش مقیاس های ترکیبی که بر پایه ی ادبیات نظری و نه ملاحظات صرف تجربی است گردد.
@analysisacademy
آکادمی تحلیل آماری ایران برگزار می کند: دوره پنج روزه اس پی اس اس دیماه ۱۳۹۵
@analysisacademy
ارزیابی مدل اندازه گیری انعکاسی و ترکیبی
پیش از این در دوره های مختلف آکادمی تحلیل آماری ایران پیرامون مدل های اندازه گیری انعکاسی و ترکیبی و روش های تشخیص این دو نوع مدل که بر اساس پرسش نامه ها یا به عبارتی شاخص های اندازه گیری متغیر های مکنون ایجاد شده است بحث کامل شده است. مدل های اندازه گیری در مدل سازی معادلات ساختاری به دو دسته اصلی مدل اندازه گیری انعکاسی و ترکیبی تقسیم می شود که در مقالات گذشته آن ها را معرفی و تفاوت های آنها را بیان کرده ایم.
@analysisacademy
متاسفانه یکی از اشتباهات رایج و بزرگ محققین در پژوهش های خویش عدم تدوین درست مدل اندازه گیری به عنوان مدلی انعکاسی و ترکیبی است که این اشتباه از عدم تشخیص آنها برای انتخاب یکی از این رویکرد ها ناشی می شود. در این مقاله تلاش شده روش های تشخیص مدل اندازه گیری انعکاسی از مدل اندازه گیری ترکیبی و ارزیابی این دو مدل از جنبه های مختلف بحث شود.
@analysisacademy
مفهوم مدل های ترکیبی که عمداتا از سال ۲۰۰۲ در تحقیقات بازاریابی روسیتر مطرح شد و در واقع انتقادی به تقلید صرف از رویه ی چرچیل در سال ۱۹۷۹ در ساخت مقیاس های اندازه گیری بود. چرا که او اساسا بر تکوین مقیاس بر اساس ملاحظات نظری اصرار داشت. اما علی رغم طرح مثال های مختلف و اجرای این مدل ها در دوره های آکادمی، محققین عزیز در تشخیص و ارزیابی این مدل های اندازه گیری انعکاسی و ترکیبی وارزیابی مدل اندازه گیری انعکاسی و ترکیبی با شک و تردید و مشکل روبرو هستند.
امید است که این ترجمه بر اساس مقاله کلتمن و همکارانش در سال ۲۰۰۸ که به ارزیابی مدل انعکاسی و ترکیبی بر اساس ملاحظات نظری و تجربی انجام گرفته است کمک شایانی به تشخیص محققین آکادمی و سایر محققین دیگر و نیز گسترش مقیاس های ترکیبی که بر پایه ی ادبیات نظری و نه ملاحظات صرف تجربی است گردد.
@analysisacademy
آکادمی تحلیل آماری ایران برگزار می کند: دوره پنج روزه اس پی اس اس دیماه ۱۳۹۵

http://analysisacademy.com/wp-content/uploads/2016/12/slide_32.jpg
@analysisacademy
تحلیل کلاستر
تحلیل کلاستر را می توان همراه با روش تحلیل تشخیصی به عنوان یکی از متداول ترین روش های طبقه بندی نامید. هدف اصلی تحلیل کلاستر، که به عنوان تحلیل بخش بندی یا تحلیل تاکسونومی/طبقه بندی نیز خوانده می شود، این است که زیر گروه های همگن از پاسخگویان را شناسایی کند. تحلیل کلاستر درصدد است تا بر اساس اطلاعاتی در خصوص یک سری متغییرها پاسخگویان را با توجه به آنها گروه بندی کند. به عبارتی، تحلیل کلاستر درصدد است تا مجموعه ای از گروه ها را شناسایی کند که از این طریق بتوان از یک طرف تفاوتهای درون گروهی را به حداقل رساند و از طرف دیگر تفاوتهای بین گروهی را به حداکثر میزان ممکن رساند. البته روش های تحلیل طبقات پنهان و تحلیل عاملی نیز چنین کارکردهایی دارند، یعنی به خوشه بندی پاسخگویان و یا متغییرها می پردازند.
@analysisacademy
کاربردهای تحلیل کلاستر
همان طور که اشاره شد، دلیل اصلی استفاده از تحلیل کلاستر، تشکیل گروههایی از واحدهای مشابه به نام کلاستر می باشد. تحلیل کلاستر کاربرهای زیادی دارد که در زیر به چهار کاربرد مهم آن اشاره می شود. البته در عمل و در اجرای تحقیق، ترکیبی از این کاربردهای تحلیل کلاستر موردنظر است:
1-توسعه یک طبقه بندی یا نوع شناسی از پاسخگویان یا متغییرها
2-آزمون طرح های مفهومی برای گروه بندی پاسخگویان یا متغییرها
3-تولید فرضیه از طریق کشف داده ها/
4-آزمون فرضیه و یا تلاش برای تعیین این که آیا داده ها، گروه هایی را که از قبل تعریف شده اند تایید می کنند یا خیر
@analysisacademy
تحلیل کلاستر
تحلیل کلاستر را می توان همراه با روش تحلیل تشخیصی به عنوان یکی از متداول ترین روش های طبقه بندی نامید. هدف اصلی تحلیل کلاستر، که به عنوان تحلیل بخش بندی یا تحلیل تاکسونومی/طبقه بندی نیز خوانده می شود، این است که زیر گروه های همگن از پاسخگویان را شناسایی کند. تحلیل کلاستر درصدد است تا بر اساس اطلاعاتی در خصوص یک سری متغییرها پاسخگویان را با توجه به آنها گروه بندی کند. به عبارتی، تحلیل کلاستر درصدد است تا مجموعه ای از گروه ها را شناسایی کند که از این طریق بتوان از یک طرف تفاوتهای درون گروهی را به حداقل رساند و از طرف دیگر تفاوتهای بین گروهی را به حداکثر میزان ممکن رساند. البته روش های تحلیل طبقات پنهان و تحلیل عاملی نیز چنین کارکردهایی دارند، یعنی به خوشه بندی پاسخگویان و یا متغییرها می پردازند.
@analysisacademy
کاربردهای تحلیل کلاستر
همان طور که اشاره شد، دلیل اصلی استفاده از تحلیل کلاستر، تشکیل گروههایی از واحدهای مشابه به نام کلاستر می باشد. تحلیل کلاستر کاربرهای زیادی دارد که در زیر به چهار کاربرد مهم آن اشاره می شود. البته در عمل و در اجرای تحقیق، ترکیبی از این کاربردهای تحلیل کلاستر موردنظر است:
1-توسعه یک طبقه بندی یا نوع شناسی از پاسخگویان یا متغییرها
2-آزمون طرح های مفهومی برای گروه بندی پاسخگویان یا متغییرها
3-تولید فرضیه از طریق کشف داده ها/
4-آزمون فرضیه و یا تلاش برای تعیین این که آیا داده ها، گروه هایی را که از قبل تعریف شده اند تایید می کنند یا خیر

http://analysisacademy.com/wp-content/uploads/2016/12/R-SQUARE.png
@analysisacademy
ضریب تعیین و ارزیابی آن
ضریب تعیین یکی از مفاهیم اصلی و اولیه ای است که در دوره های آکادمی تحلیل آماری ایران بشدت روی آن تکیه می شود. چرا که متاسفانه دانشجویان و اساتید به شدت از ارزیابی آن غفلت می کنند این در حالی است که به گفته دکتر هایر این ضریب و برازش مدل مهمترین مباحث طرح شده در این حوزه در نظر گرفته می شود.
ضریب تعیین به مجذور ضریب همبستگی چند گانه اطلاق می شود و آن را R square یا R2 می خوانند. این ضریب میزان تبیین واریانس یا تغییرات متغیر وابسته توسط مجموعه متغیر های مستقل را نشان می دهد. مقدار این ضریب بین صفر و یک در نوسان است. هرچه مقدار این ضریب به یک نزدیک باشد نشان از این دارد که متغیر های مستقل توانسته اند میزان زیادی از واریانس یا به زبان ساده تر رفتار متغیر وابسته را پیش بینی کنند و هر چه این مقدار به صفر نزدیک باشد یعنی این توضیح تغییرات متغیر وابسته کمتر بوده است و محقق انتخاب مناسبی در متغیر های مستقل خویش از ادبیات پژوهشی نداشته است.
@analysisacademy
همانطور که در ابتدای بحث خدمت شما عرض کردم متاسفانه غفلت فوق العاده عجیبی پیرامون این شاخص در تحقیقات ما و حتی بدتر در داوری های اساتید از کارهای پژوهشی دانشجویان وجود دارد. یعنی اگر جامع تر به کار نگاه کنیم یک محقق وقتی صاحب مدل و فرضیات علی در پژوهش خود است در حقیقت هدفش رسیدن به یک پیش بینی با کیفیت از متغیر های وابسته است و اگر در پایان کار به این مهم نرسد به گفته پروفسور هایر محقق بهتر است در پژوهش خود از ابتدای کار تجدید نظر نماید.
@analysisacademy
اما گاها محققین نمیدانند از چه معیار و شاخصی برای ارزیابی ضریب تعیین کار خود بهره ببرند. اولین بار در سال ۱۹۹۸ چن و همکارانش سه مقدار ۰٫۱۹ و ۰٫۳۳ و ۰٫۶۷ درصد را به عنوان مقادیر ضعیف و متوسط و قوی برای بررسی مقدار R2ارائه نمودند که بعد ها توسط هنسلر در سال ۲۰۰۹ و پروفسور هایر در سال ۲۰۱۱ مورد تایید و استناد مجدد قرار گرفت. یعنی اگر کاری دارای ضریب تعیین کمتر از ۰٫۱۹ درصد باشد باید در مورد کل روابط و روش پیمایش تجدید نظر نمود. اما متاسفانه در ایران می بینیم پژوهش های بسیاری که حتی این شاخص گزارش نشده و یا در صورت گزارش مقدار بسیار ضعیفی دارد و به راحتی از بوته داوری اساتید بدون ذره ای توجه خارج می شود(مرادی، ۱۳۹۵)
از طرفی هایر و همکارانش در سال ۲۰۱۱ بیان کردند که این ضریب با تعداد متغیر های مستقل بهبود می یابد بنابراین آن ها در این موارد این سه مقدار را برای پیش بینی ضعیف، متوسط و قوی ارائه نمودند یعنی ۰٫۲۵ و ۰٫۵۰ و ۰٫۷۵٫
محققین دیگر این اشکال ضریب تعیین را که میزان موفقیت مدل را بیش از اندازه برآورد می کند و متاسفانه حجم نمونه و درجات آزادی را در محاسبات خود در نظر نمی گیرد با اصلاح این ضریب و ارائه شکل تعدیل شده آن برطرف نمودند. یعنی از ضریب تعیین تعدیل یافته یا R2adjاستفاده نمودند. در حقیقت ضریب تعیین برای نمونه گزارش می شود و ضریب تعیین تعدیل یافته برای جامعه آماری است. در حقیقت این ضریب مقدار ضریب تعیین معمولی را به منظور انعکاس بیشتر میزان نیکویی برازش مدل تصحیح میکند.
محسن مرادی
@analysisacademy
ضریب تعیین و ارزیابی آن
ضریب تعیین یکی از مفاهیم اصلی و اولیه ای است که در دوره های آکادمی تحلیل آماری ایران بشدت روی آن تکیه می شود. چرا که متاسفانه دانشجویان و اساتید به شدت از ارزیابی آن غفلت می کنند این در حالی است که به گفته دکتر هایر این ضریب و برازش مدل مهمترین مباحث طرح شده در این حوزه در نظر گرفته می شود.
ضریب تعیین به مجذور ضریب همبستگی چند گانه اطلاق می شود و آن را R square یا R2 می خوانند. این ضریب میزان تبیین واریانس یا تغییرات متغیر وابسته توسط مجموعه متغیر های مستقل را نشان می دهد. مقدار این ضریب بین صفر و یک در نوسان است. هرچه مقدار این ضریب به یک نزدیک باشد نشان از این دارد که متغیر های مستقل توانسته اند میزان زیادی از واریانس یا به زبان ساده تر رفتار متغیر وابسته را پیش بینی کنند و هر چه این مقدار به صفر نزدیک باشد یعنی این توضیح تغییرات متغیر وابسته کمتر بوده است و محقق انتخاب مناسبی در متغیر های مستقل خویش از ادبیات پژوهشی نداشته است.
@analysisacademy
همانطور که در ابتدای بحث خدمت شما عرض کردم متاسفانه غفلت فوق العاده عجیبی پیرامون این شاخص در تحقیقات ما و حتی بدتر در داوری های اساتید از کارهای پژوهشی دانشجویان وجود دارد. یعنی اگر جامع تر به کار نگاه کنیم یک محقق وقتی صاحب مدل و فرضیات علی در پژوهش خود است در حقیقت هدفش رسیدن به یک پیش بینی با کیفیت از متغیر های وابسته است و اگر در پایان کار به این مهم نرسد به گفته پروفسور هایر محقق بهتر است در پژوهش خود از ابتدای کار تجدید نظر نماید.
@analysisacademy
اما گاها محققین نمیدانند از چه معیار و شاخصی برای ارزیابی ضریب تعیین کار خود بهره ببرند. اولین بار در سال ۱۹۹۸ چن و همکارانش سه مقدار ۰٫۱۹ و ۰٫۳۳ و ۰٫۶۷ درصد را به عنوان مقادیر ضعیف و متوسط و قوی برای بررسی مقدار R2ارائه نمودند که بعد ها توسط هنسلر در سال ۲۰۰۹ و پروفسور هایر در سال ۲۰۱۱ مورد تایید و استناد مجدد قرار گرفت. یعنی اگر کاری دارای ضریب تعیین کمتر از ۰٫۱۹ درصد باشد باید در مورد کل روابط و روش پیمایش تجدید نظر نمود. اما متاسفانه در ایران می بینیم پژوهش های بسیاری که حتی این شاخص گزارش نشده و یا در صورت گزارش مقدار بسیار ضعیفی دارد و به راحتی از بوته داوری اساتید بدون ذره ای توجه خارج می شود(مرادی، ۱۳۹۵)
از طرفی هایر و همکارانش در سال ۲۰۱۱ بیان کردند که این ضریب با تعداد متغیر های مستقل بهبود می یابد بنابراین آن ها در این موارد این سه مقدار را برای پیش بینی ضعیف، متوسط و قوی ارائه نمودند یعنی ۰٫۲۵ و ۰٫۵۰ و ۰٫۷۵٫
محققین دیگر این اشکال ضریب تعیین را که میزان موفقیت مدل را بیش از اندازه برآورد می کند و متاسفانه حجم نمونه و درجات آزادی را در محاسبات خود در نظر نمی گیرد با اصلاح این ضریب و ارائه شکل تعدیل شده آن برطرف نمودند. یعنی از ضریب تعیین تعدیل یافته یا R2adjاستفاده نمودند. در حقیقت ضریب تعیین برای نمونه گزارش می شود و ضریب تعیین تعدیل یافته برای جامعه آماری است. در حقیقت این ضریب مقدار ضریب تعیین معمولی را به منظور انعکاس بیشتر میزان نیکویی برازش مدل تصحیح میکند.
محسن مرادی

http://analysisacademy.com/wp-content/uploads/2016/12/Experimental-research-design.jpg
@analysisacademy
طرح آزمایشی میدانی در مقابل طرح آزمابشی آزمایشگاهی
یکی از انواع طرح های تحقیقاتی بخصوص در حوزه تحقیقات بازاریابی معطوف به طرح های آزمایشی می شود که حتی بعضا بسیاری از دانشجویان طرح های پژوهشی آکادمیک خود را در دانشگاه بر اساس آن قرار می دهند. در این مقاله به مقایسه دو وضعیت اصلی این طرح های آزمایشی می پردازیم. البته نباید فراموش کرد که این طرح ها در رشته های مختلف مثل روانشناسی و جامعه شناسی و … هم انجام می پذیرد
@analysisacademy
دو نوع شرایط برای اجرای یک طرح آزمایشی وجود دارد: دنیای واقعی(میدانی) و آزمایشگاه
طرح آزمایشی میدانی: آزمایش های میدانی نتیجه یک شرایط تجربی است که به دلیل الگوسازی شرایط واقعی بسیار واقعی تر است و در نتیجه دارای اعتبار بیرونی بیشتری است. آزمایش میدانی در یک شرایط طبیعی با حداقل عناصر تصنعی در آزمایش، انجام می گیرد. جنبه منفی طرح آزمایشی میدانی این است که معمولا دارای هزینه بیشتری است. به دلیل فقدان کنترل بر روی متغیر های موثر بر متغیر وابسته، اعتبار درونی کمتری دارد و همچنین ممکن است باعث گوش به زنگ شدن رقبا در مورد این که شرکت در فکر بازاریابی محصولات خود است بشود.
@analysisacademy
طرح آزمایشی آزمایشگاهی: بیانگر آزمایشی است که در شرایط تصنعی اجرا می شود. به بیان دیگر، آزمایش آزمایشگاهی، اثرات متغیر های مزاحم را از طریق جدا کردن تحقیق در یک وضعیت فیزیکی جدا از روال همیشگی و با دستکاری یک یا چند متغیر مشتقل تحت شرایط شدیدا مشخص و کنترل شده به حداقل می رساند. مثل آزمون تبلیغات تلوزیونی در یک سالن سینما به جای تبلیغ در تلوزیون های خانه های خریداران.
این جدا سازی به محقق امکان می دهد تا اطمینان حاصل کند که اگر رویه های آزمایشی یکسان با آزمودنی های یکسان تکرار شود، نتایج یکسانی را به همراه دارد. یعنی به طور مثال، آگهی تبلیغاتی که عکس العمل مثبت یک گروه آزمودنی که شدیدا تحت شرایط کنترل شده آزمایشگاهی هستند را به دنبال دارد، هنگامی که با همین گروه و گروه های آزمودنی مشابه دیگری در شرایط آزمایش گاهی مشابه، مجددا آزمایش گردد، عکس العمل های یکسان و یا تقریبا یکسانی را ایجاد خواهد کرد.
طرح های آزمایشی آزمایشگاهی معمولا هزینه کمتری را به دنبال دارد و به دلیل کنترل بیشتر بر روی محیط آزمایش، اعتبار درونی بیشتری دارد. علاوه بر این راز داری و پوشیدگی بیشتری در مقابل اعمال بالقوه بازاریابی رقبا خواهد داشت. همچنین امکان استفاده از مقیاس های حرفه ای تر در شرایط آزمایشگاهی بیشتر از شرایط میدانی است.
معایب طرح های آزمایشی آزمایشگاهی شامل از دست دادن واقع گرایی و به عبارت دیگر اعتبار بیرونی پایینتر می باشد. این مشکلات به دلیل شرایط تصنعی ایجاد شده در طرح آزمایشی می باشد. براس مثال یک کارت اعتباری در اختیار عده ای از خریداران گذاشته می شود و در شرایط آزمایشگاهی از آن ها خواسته می شود که از فروشگاهی خرید نمایند تا ما بتوانیم از زوایای خاصی رفتار خرید مصرف کنندگان را مطالعه نماییم. اگر چه در این حالت اطلاعات مختلفی پیرامون موارد مورد نظر بدست میآید اما باید به خاطر داشت که تعمیم پذیری یا همان اعتبار بیرونی آن یافته ها به شرایط دیگر بازار با مشکلات فراوانی روبرو است که محققین عزیز آکادمی تحلیل آماری ایران باید آن را مد نظر داشته باشند.
محسن مرادی
مطالب سایت و کانال بدون ذکر سایت منبع انجام نشود.
@analysisacademy
طرح آزمایشی میدانی در مقابل طرح آزمابشی آزمایشگاهی
یکی از انواع طرح های تحقیقاتی بخصوص در حوزه تحقیقات بازاریابی معطوف به طرح های آزمایشی می شود که حتی بعضا بسیاری از دانشجویان طرح های پژوهشی آکادمیک خود را در دانشگاه بر اساس آن قرار می دهند. در این مقاله به مقایسه دو وضعیت اصلی این طرح های آزمایشی می پردازیم. البته نباید فراموش کرد که این طرح ها در رشته های مختلف مثل روانشناسی و جامعه شناسی و … هم انجام می پذیرد
@analysisacademy
دو نوع شرایط برای اجرای یک طرح آزمایشی وجود دارد: دنیای واقعی(میدانی) و آزمایشگاه
طرح آزمایشی میدانی: آزمایش های میدانی نتیجه یک شرایط تجربی است که به دلیل الگوسازی شرایط واقعی بسیار واقعی تر است و در نتیجه دارای اعتبار بیرونی بیشتری است. آزمایش میدانی در یک شرایط طبیعی با حداقل عناصر تصنعی در آزمایش، انجام می گیرد. جنبه منفی طرح آزمایشی میدانی این است که معمولا دارای هزینه بیشتری است. به دلیل فقدان کنترل بر روی متغیر های موثر بر متغیر وابسته، اعتبار درونی کمتری دارد و همچنین ممکن است باعث گوش به زنگ شدن رقبا در مورد این که شرکت در فکر بازاریابی محصولات خود است بشود.
@analysisacademy
طرح آزمایشی آزمایشگاهی: بیانگر آزمایشی است که در شرایط تصنعی اجرا می شود. به بیان دیگر، آزمایش آزمایشگاهی، اثرات متغیر های مزاحم را از طریق جدا کردن تحقیق در یک وضعیت فیزیکی جدا از روال همیشگی و با دستکاری یک یا چند متغیر مشتقل تحت شرایط شدیدا مشخص و کنترل شده به حداقل می رساند. مثل آزمون تبلیغات تلوزیونی در یک سالن سینما به جای تبلیغ در تلوزیون های خانه های خریداران.
این جدا سازی به محقق امکان می دهد تا اطمینان حاصل کند که اگر رویه های آزمایشی یکسان با آزمودنی های یکسان تکرار شود، نتایج یکسانی را به همراه دارد. یعنی به طور مثال، آگهی تبلیغاتی که عکس العمل مثبت یک گروه آزمودنی که شدیدا تحت شرایط کنترل شده آزمایشگاهی هستند را به دنبال دارد، هنگامی که با همین گروه و گروه های آزمودنی مشابه دیگری در شرایط آزمایش گاهی مشابه، مجددا آزمایش گردد، عکس العمل های یکسان و یا تقریبا یکسانی را ایجاد خواهد کرد.
طرح های آزمایشی آزمایشگاهی معمولا هزینه کمتری را به دنبال دارد و به دلیل کنترل بیشتر بر روی محیط آزمایش، اعتبار درونی بیشتری دارد. علاوه بر این راز داری و پوشیدگی بیشتری در مقابل اعمال بالقوه بازاریابی رقبا خواهد داشت. همچنین امکان استفاده از مقیاس های حرفه ای تر در شرایط آزمایشگاهی بیشتر از شرایط میدانی است.
معایب طرح های آزمایشی آزمایشگاهی شامل از دست دادن واقع گرایی و به عبارت دیگر اعتبار بیرونی پایینتر می باشد. این مشکلات به دلیل شرایط تصنعی ایجاد شده در طرح آزمایشی می باشد. براس مثال یک کارت اعتباری در اختیار عده ای از خریداران گذاشته می شود و در شرایط آزمایشگاهی از آن ها خواسته می شود که از فروشگاهی خرید نمایند تا ما بتوانیم از زوایای خاصی رفتار خرید مصرف کنندگان را مطالعه نماییم. اگر چه در این حالت اطلاعات مختلفی پیرامون موارد مورد نظر بدست میآید اما باید به خاطر داشت که تعمیم پذیری یا همان اعتبار بیرونی آن یافته ها به شرایط دیگر بازار با مشکلات فراوانی روبرو است که محققین عزیز آکادمی تحلیل آماری ایران باید آن را مد نظر داشته باشند.
محسن مرادی
مطالب سایت و کانال بدون ذکر سایت منبع انجام نشود.

http://analysisacademy.com/wp-content/uploads/2016/12/factor.analysis.png
@analysisacademy
کاربرد های تحلیل عاملی اکتشافی
تحلیل عاملی اکتشافی، رایج ترین شکل تحلیل عاملی است که از سال ۱۹۰۷ ابداع و در سالهای بعد به تدریج توسعه یافت. در این نوع تحلیل ما درصدد هستیم تا ساختار زیر بنایی مجموعه نسبتا بزرگی از متغیر ها را کشف نماییم. نباید فراموش کرد که محقق در این تحلیل هیچ تئوری اولیه ای ندارد. برخی از مهترین کاربرد های تحلیل عاملی اکتشافی در زیر فهرست شده اند:
@analysisacademy
1. تعیین تعداد عامل های مشترک که بر مجموعه ای از متغیر ها تاثیر می گذارند.
2. تعیین شدت رابطه بین هر عامل و هر متغیر مشاهده شده
3. خلاصه سازی تعداد زیادی متغیر مشاهده شده به تعداد کوچکتری از عامل ها با هدف مدل سازی
4. استفاده از مدل های ساخته شده در این روش برای کاربرد در روش مدل سازی معادلات ساختاری
5. شناسایی ماهیت سازه های زیر بنایی مجموعه ای از متغیر ها در یک حوزه مفهومی مشخص
6. تعیین اینکه کدام یک از سوالات یک پرسش نامه با همدیگر ارتباط دارند.
7. شناسایی خوشه هایی از پاسخ گویان و گروههایی از آنان
8. ساخت مقیاس هایی برای اندازه گیری یک سازه مشخص در یک حوزه مفهومی خاص
9. تعیین این موضوع برای مجموعه ای از گویه ها که در یک دسته طبقه بندی می شوند در جهت اینکه کدام یک دارای وزن اهمیت بیشتری در آن دسته هستند.
10. بدست آوردن نمرات یا همان بارهای عاملی برای استفاده در تحلیل های مختلف
11. تعیین این مساله که آیا عامل های استخراج شده با تئوری و نظریه ای که محقق انتظار دارد تطابق دارد یا خیر
12. بررسی روایی همگرا گویه های انعکاسی دسته بندی شده در هر عامل
13. بررسی روایی واگرا بین گویه های انعکاسی دسته بندی شده در هر عامل
محسن مرادی
مطالب سایت و کانال کپی برداری نشود.
@analysisacademy
کاربرد های تحلیل عاملی اکتشافی
تحلیل عاملی اکتشافی، رایج ترین شکل تحلیل عاملی است که از سال ۱۹۰۷ ابداع و در سالهای بعد به تدریج توسعه یافت. در این نوع تحلیل ما درصدد هستیم تا ساختار زیر بنایی مجموعه نسبتا بزرگی از متغیر ها را کشف نماییم. نباید فراموش کرد که محقق در این تحلیل هیچ تئوری اولیه ای ندارد. برخی از مهترین کاربرد های تحلیل عاملی اکتشافی در زیر فهرست شده اند:
@analysisacademy
1. تعیین تعداد عامل های مشترک که بر مجموعه ای از متغیر ها تاثیر می گذارند.
2. تعیین شدت رابطه بین هر عامل و هر متغیر مشاهده شده
3. خلاصه سازی تعداد زیادی متغیر مشاهده شده به تعداد کوچکتری از عامل ها با هدف مدل سازی
4. استفاده از مدل های ساخته شده در این روش برای کاربرد در روش مدل سازی معادلات ساختاری
5. شناسایی ماهیت سازه های زیر بنایی مجموعه ای از متغیر ها در یک حوزه مفهومی مشخص
6. تعیین اینکه کدام یک از سوالات یک پرسش نامه با همدیگر ارتباط دارند.
7. شناسایی خوشه هایی از پاسخ گویان و گروههایی از آنان
8. ساخت مقیاس هایی برای اندازه گیری یک سازه مشخص در یک حوزه مفهومی خاص
9. تعیین این موضوع برای مجموعه ای از گویه ها که در یک دسته طبقه بندی می شوند در جهت اینکه کدام یک دارای وزن اهمیت بیشتری در آن دسته هستند.
10. بدست آوردن نمرات یا همان بارهای عاملی برای استفاده در تحلیل های مختلف
11. تعیین این مساله که آیا عامل های استخراج شده با تئوری و نظریه ای که محقق انتظار دارد تطابق دارد یا خیر
12. بررسی روایی همگرا گویه های انعکاسی دسته بندی شده در هر عامل
13. بررسی روایی واگرا بین گویه های انعکاسی دسته بندی شده در هر عامل
محسن مرادی
مطالب سایت و کانال کپی برداری نشود.

http://analysisacademy.com/wp-content/uploads/2016/12/PPPLOTACADEMY.png
@analysisacademy
نمودارهای احتمال- احتمال و چارک-چارک
نمودار احتمال- احتمال(P-P)
نمودار احتمال-احتمال تابع توزیع تجمعی تجربی از یک متغییر را با یک تابع توزیع نظری خاص( به عنوان مثال، تابع توزیع نرمال استاندارد)مقایسه می کند. به عبارتی این نمودار برای آزمون تبعیت توزیع یم متغغیرر از یک توزیع مشخص به کار می رود.
اگر توزیع متغییر از توزیع نظری تبعیت کند در آن صورت نقاط روی یک خط راست کلاستربندی می شود اما چنانچه این دو توزیع با یکدیگر هماهنگ نباشند آنگاه نقاط در اطراف این خط پخش خواهند شد.
@analysisacademy
دستور در spss:
Analyze>Descriptive statistics>P-P plot
نمودار چارک-چارک(Q-Q)
نمودار Q-Q همانند نمودار P-P برای تشخیص این موضوع به کار می رود که چگونه یک توزیع نظری می تواند به خوبیداده های تجربی را الگوبندی کند. نمودار Q-Q مقادیر مرتب شده یک متغییر را با چارک های یک توزیع نظری خاص (به عنوان مثال توزیع نرمال) مقایسه می کند. اگر این دو توزیع با هم هماهنگ باشند، در آن صورت نقاط روی نمودار یک الگوی خطی را تشکیل می دهند که از ریشه با یک شیب واحد می گذرد.
دستور در spss:
Analyze>Descriptive statistics>P-P plot
@analysisacademy
نمودارهای احتمال- احتمال و چارک-چارک
نمودار احتمال- احتمال(P-P)
نمودار احتمال-احتمال تابع توزیع تجمعی تجربی از یک متغییر را با یک تابع توزیع نظری خاص( به عنوان مثال، تابع توزیع نرمال استاندارد)مقایسه می کند. به عبارتی این نمودار برای آزمون تبعیت توزیع یم متغغیرر از یک توزیع مشخص به کار می رود.
اگر توزیع متغییر از توزیع نظری تبعیت کند در آن صورت نقاط روی یک خط راست کلاستربندی می شود اما چنانچه این دو توزیع با یکدیگر هماهنگ نباشند آنگاه نقاط در اطراف این خط پخش خواهند شد.
@analysisacademy
دستور در spss:
Analyze>Descriptive statistics>P-P plot
نمودار چارک-چارک(Q-Q)
نمودار Q-Q همانند نمودار P-P برای تشخیص این موضوع به کار می رود که چگونه یک توزیع نظری می تواند به خوبیداده های تجربی را الگوبندی کند. نمودار Q-Q مقادیر مرتب شده یک متغییر را با چارک های یک توزیع نظری خاص (به عنوان مثال توزیع نرمال) مقایسه می کند. اگر این دو توزیع با هم هماهنگ باشند، در آن صورت نقاط روی نمودار یک الگوی خطی را تشکیل می دهند که از ریشه با یک شیب واحد می گذرد.
دستور در spss:
Analyze>Descriptive statistics>P-P plot

http://analysisacademy.com/wp-content/uploads/2016/12/LogReg_2.png
@analysisacademy
رگرسیون لجستیک
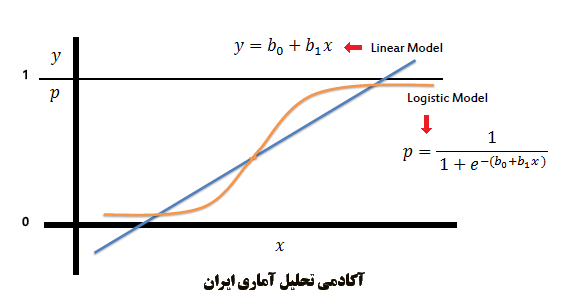
همانطور که می دانیم ، برای انجام تحلیل رگرسیون خطی متغییر وابسته باید کمی و در سطح سنجش فاصله ای/نسبی باشد. اما گاهی اوقات اتفاق می افتد که متغییر وابسته تحقیق در مقیاس فاصله ای/نسبی نبوده و مقیاس آن به صورت اسمی( دووجهی یا چندوجهی) است. یکی از سوالات شرکت کنندگان در دوره های کاربردی SPSS آکادمی تحلیل آماری شرکت می کنند این است که در چنین حالتی با توجه به اینکه پیش فرض اساسی تحلیل رگرسیون مقیاس فاصله ای /نسبی متغییر وابسته است چه باید کرد. در چنین حالتی نرم افزارهای آماری این امکان را برای ما فراهم نموده اند تا بتوانیم عوامل پیش بینی کننده تغییرات یک متغییر اسمی را نیز شناسایی کنیم. این روش، که رگرسیون لجستیک نام دارد در اواخر دهه 1960 و اوایل دهه 1970 به عنوان بدیلی برای روش رگرسیون خطی و همچنین تابع تشخیصی مطرح شد. زمانی که متغییر وابسته در سطح اسمی است و متغییرهای مستقل هم ترتیبی و هم فاصله ای هستند روش های رگرسیون خطی معمولی و تحلیل تشخیصی مقدار برآورد را کمتر از مقدار واقعی نشان می دهند.
رگرسیون لجستیک شبیه رگرسیون خطی است با این تفاوت که نحوه محاسبه ضرایب در این دو روش یکسان نمی باشد. بدین معنی که رگرسیون لجستیک به جای حداقل کردن مجذور خطاها احتمالی را که یک واقعه رخ می دهد حداکثر می کند همچنین در تحلیل رگرسیون خطی همانطور که در دوره های آکادمی تحلیل آماری ایران به آن اشاره می شود برای آزمون برازش مدل و معنی دار بودن اثر هر متغییر در مدل به ترتیب از آماره های F و T استفاده می شود در حالی که در رگرسیون لجستیک از آماره های کای اسکوئر و والد استفاده می شود.
رگرسیون لجستیک نسبت به تحلیل تشخیصی نیز ارجحیت دارد و مهمترین دلیل آن است که در تحلیل تشخیصی گاهی اوقات احتمال وقوع یک پدیده خارج از طیف صفر تا یک قرار می گیرد و متغییرهای پیش بین نیز باید دارای توزیع نرمال چند متغییره باشند در حالی که در رگرسیون لجستیک، احتمال وقوع یک پدیده در داخل محدوده صفر تا یک قرار دارد و رعایت پیش فرض نرمال بودن متغییرهای پیش بین لازم نیست.
@analysisacademy
رگرسیون لجستیک
همانطور که می دانیم ، برای انجام تحلیل رگرسیون خطی متغییر وابسته باید کمی و در سطح سنجش فاصله ای/نسبی باشد. اما گاهی اوقات اتفاق می افتد که متغییر وابسته تحقیق در مقیاس فاصله ای/نسبی نبوده و مقیاس آن به صورت اسمی( دووجهی یا چندوجهی) است. یکی از سوالات شرکت کنندگان در دوره های کاربردی SPSS آکادمی تحلیل آماری شرکت می کنند این است که در چنین حالتی با توجه به اینکه پیش فرض اساسی تحلیل رگرسیون مقیاس فاصله ای /نسبی متغییر وابسته است چه باید کرد. در چنین حالتی نرم افزارهای آماری این امکان را برای ما فراهم نموده اند تا بتوانیم عوامل پیش بینی کننده تغییرات یک متغییر اسمی را نیز شناسایی کنیم. این روش، که رگرسیون لجستیک نام دارد در اواخر دهه 1960 و اوایل دهه 1970 به عنوان بدیلی برای روش رگرسیون خطی و همچنین تابع تشخیصی مطرح شد. زمانی که متغییر وابسته در سطح اسمی است و متغییرهای مستقل هم ترتیبی و هم فاصله ای هستند روش های رگرسیون خطی معمولی و تحلیل تشخیصی مقدار برآورد را کمتر از مقدار واقعی نشان می دهند.
رگرسیون لجستیک شبیه رگرسیون خطی است با این تفاوت که نحوه محاسبه ضرایب در این دو روش یکسان نمی باشد. بدین معنی که رگرسیون لجستیک به جای حداقل کردن مجذور خطاها احتمالی را که یک واقعه رخ می دهد حداکثر می کند همچنین در تحلیل رگرسیون خطی همانطور که در دوره های آکادمی تحلیل آماری ایران به آن اشاره می شود برای آزمون برازش مدل و معنی دار بودن اثر هر متغییر در مدل به ترتیب از آماره های F و T استفاده می شود در حالی که در رگرسیون لجستیک از آماره های کای اسکوئر و والد استفاده می شود.
رگرسیون لجستیک نسبت به تحلیل تشخیصی نیز ارجحیت دارد و مهمترین دلیل آن است که در تحلیل تشخیصی گاهی اوقات احتمال وقوع یک پدیده خارج از طیف صفر تا یک قرار می گیرد و متغییرهای پیش بین نیز باید دارای توزیع نرمال چند متغییره باشند در حالی که در رگرسیون لجستیک، احتمال وقوع یک پدیده در داخل محدوده صفر تا یک قرار دارد و رعایت پیش فرض نرمال بودن متغییرهای پیش بین لازم نیست.
http://analysisacademy.com/wp-content/uploads/2016/08/download22.jpg
@analysisacademy
حجم نمونه در رگرسیون لجستیک
اگرچه در ادبیات مربوط به رگرسیون لجستیک قواعد خاصی برای حجم نمونه و نیز حداقل نسبت تعداد نمونه به تعداد متغییر مستقل پیشنهاد نشده است، اما برخی نویسندگان در حوزه آمار چند متغییره حداقل حجم نمونه برای تحلیل رگرسیون لجستیک خوب را 100 نفر و برخی نیز 50 نفر عنوان کرده اند. در خصوص حداقل نسبت تعداد نمونه به تعداد متغییر مستقل نیز به عنوان یک قاعده کلی حداقل نسبت 10 متغییر مستقل به 1 نمونه لازم است اما آنچه مسلم است این است که هر چه تعداد متغییرهای مستقل بیشتر باشد حجم نمونه در رگرسیون لجستیک باید بیشتر باشد ضمن آنکه در رگرسیون لجستیک به حجم نمونه بسیار بیشتر از حجم نمونه در رگرسیون خطی نیاز داریم؛ این نکته ای است که به دفعات در دوره های spss آکادمی تحلیل آماری ایران به آن اشاره شده است.
همچنین در خصوص حجم نمونه نابرابر در طبقات متغییر وابسته نیز در طبقه ای که حجم نمونه آن کمتر است به ازای هر متغییر مستقل حداقل نمونه 10 نمونه لازم است.
@analysisacademy
حجم نمونه در رگرسیون لجستیک
اگرچه در ادبیات مربوط به رگرسیون لجستیک قواعد خاصی برای حجم نمونه و نیز حداقل نسبت تعداد نمونه به تعداد متغییر مستقل پیشنهاد نشده است، اما برخی نویسندگان در حوزه آمار چند متغییره حداقل حجم نمونه برای تحلیل رگرسیون لجستیک خوب را 100 نفر و برخی نیز 50 نفر عنوان کرده اند. در خصوص حداقل نسبت تعداد نمونه به تعداد متغییر مستقل نیز به عنوان یک قاعده کلی حداقل نسبت 10 متغییر مستقل به 1 نمونه لازم است اما آنچه مسلم است این است که هر چه تعداد متغییرهای مستقل بیشتر باشد حجم نمونه در رگرسیون لجستیک باید بیشتر باشد ضمن آنکه در رگرسیون لجستیک به حجم نمونه بسیار بیشتر از حجم نمونه در رگرسیون خطی نیاز داریم؛ این نکته ای است که به دفعات در دوره های spss آکادمی تحلیل آماری ایران به آن اشاره شده است.
همچنین در خصوص حجم نمونه نابرابر در طبقات متغییر وابسته نیز در طبقه ای که حجم نمونه آن کمتر است به ازای هر متغییر مستقل حداقل نمونه 10 نمونه لازم است.
http://analysisacademy.com/wp-content/uploads/2016/12/download-1.jpg
@analysisacademy
مراحل انجام تحقیق تجربی
پیش از در مقالات گذشته پیرامون تحقیق تجربی و انواع میدانی و آزمایشگاهی آن و همچنین تفاوت های آن ها با یکدیگر آشنا شدیم. تحقیق تجربی یا آزمایشی یکی از دقیقترین و کارآمدترین روشهای تحقیق است که برای آزمون فرضیهها مورد استفاده قرار میگیرد هدف این تحقیق بررسی تأثیر محرکها, روشها و یا شرایط خاص محیطی بر روی یک گروه آزمودنی میباشد.
در این راستا یک تحقیق تجربی مشتمل بر مراحل زیر می باشد:
1. تصریح سنجی
2. تجزیه و تحلیل داده ها
3. روش سنجی
4. ارزیابی الگو و تخمین ها و استنباط آماری
5. تحلیل نتایج و در صورت نیاز پیش بینی(صمدی ،1388، 17).
مرحله اول : تصریح سنجی
اولین و مهمترین مرحله در یک کار تجربی، مشخص کردن متغیر های وابسته و مستقل، شکل تابعی الگو و مقادیر و علائم مورد انتظار پارامترها است. اغلب پژوهش گران الگویی را انتخاب کرده، پارامترهای آن را تخمین زده و فرضیه های مدنظر خود را به بوته آزمایش می گذارند. اما سوال اساسی این است که چه الگویی باید انتخاب شود تا کار کاربردی با آن شروع شود. تعیین چنین الگویی بسیار اساسی بوده و به تصریح سنجی معروف است. در متون اقتصادسنجی و به هنگام ارزیابی تجربی الگوها، دو نوع خطا معرفی می شود:
خطای تصریح
خطای تعیین غلط الگو
خطای تصریح زمانی مطرح می شود که محقق الگوی درست و مناسبی را انتخاب می کند، اما به شیوه های متعددی در تخمین آن دچار خطا می شود. وجود خود همبستگی پیاپی، ناهمسانی واریانس ها، نرمال نبودن اجزا جمله اخلال، خطای تصریح جز اخلال، حذف یک متغیر مهم، وارد کردن یک متغیر غیر ضروری، شکل تابعی غلط، خطای اندازه گیری (در متغیرهای مستقل ) و ... برخی از این نوع خطاها هستند.
اما خطای تعیین غلط الگو در وضعیتی رخ می دهد که الگوی واقعی معلوم نیست و ممکن است که در نتیجه انتخاب اشتباه بین نظریه های رقیب رخ دهد.(همان ، 19).
@analysisacademy
مرحله دوم : تجزیه و تحلیل داده ها (داده سنجی)
مرحله بسیار مهم بعدی استخراج داده های مور نیاز و مناسب می باشد. برخی از داده ها مستقیما از منابع آماری قابل استخراج بوده ، برخی دیگر مانند نرخ ارز واقعی موثر و ... باید محاسبه گردد و برای برخی از متغیرهای دیگر باید متغیر نماینده و یا جانشین تعیین گردد (صمدی،23).
مرحله سوم : روش سنجی
پس از تبیین مدل، باید روش مناسب بررسی مساله و همچنین روش مناسب تخمین انتخاب شود. در تحقیق حاضر با توجه به ماهیت داده ها از روش پانل دیتا که ترکیبی از داده های سری زمانی و مقطعی است، استفاده شده است.
مرحله چهارم : تخمین و استباط آماری
در این قسمت از مطالعه جهت تصریح مدل ابتدا رابطه متغیرهای مستقل از منظر آمار استنباطی بررسی می گردد و از بین متغیرهای توضیحی ، متغیرهای موثر انتخاب می شود.
مرحله پنجم: نتیجه گیری
در مرحله پنجم بر اساس تخمین مدل ، نتیجه گیری می شود و در نهایت بر اساس نتایج پیشنهادات و راهکارها ارائه می شود.
@analysisacademy
مراحل انجام تحقیق تجربی
پیش از در مقالات گذشته پیرامون تحقیق تجربی و انواع میدانی و آزمایشگاهی آن و همچنین تفاوت های آن ها با یکدیگر آشنا شدیم. تحقیق تجربی یا آزمایشی یکی از دقیقترین و کارآمدترین روشهای تحقیق است که برای آزمون فرضیهها مورد استفاده قرار میگیرد هدف این تحقیق بررسی تأثیر محرکها, روشها و یا شرایط خاص محیطی بر روی یک گروه آزمودنی میباشد.
در این راستا یک تحقیق تجربی مشتمل بر مراحل زیر می باشد:
1. تصریح سنجی
2. تجزیه و تحلیل داده ها
3. روش سنجی
4. ارزیابی الگو و تخمین ها و استنباط آماری
5. تحلیل نتایج و در صورت نیاز پیش بینی(صمدی ،1388، 17).
مرحله اول : تصریح سنجی
اولین و مهمترین مرحله در یک کار تجربی، مشخص کردن متغیر های وابسته و مستقل، شکل تابعی الگو و مقادیر و علائم مورد انتظار پارامترها است. اغلب پژوهش گران الگویی را انتخاب کرده، پارامترهای آن را تخمین زده و فرضیه های مدنظر خود را به بوته آزمایش می گذارند. اما سوال اساسی این است که چه الگویی باید انتخاب شود تا کار کاربردی با آن شروع شود. تعیین چنین الگویی بسیار اساسی بوده و به تصریح سنجی معروف است. در متون اقتصادسنجی و به هنگام ارزیابی تجربی الگوها، دو نوع خطا معرفی می شود:
خطای تصریح
خطای تعیین غلط الگو
خطای تصریح زمانی مطرح می شود که محقق الگوی درست و مناسبی را انتخاب می کند، اما به شیوه های متعددی در تخمین آن دچار خطا می شود. وجود خود همبستگی پیاپی، ناهمسانی واریانس ها، نرمال نبودن اجزا جمله اخلال، خطای تصریح جز اخلال، حذف یک متغیر مهم، وارد کردن یک متغیر غیر ضروری، شکل تابعی غلط، خطای اندازه گیری (در متغیرهای مستقل ) و ... برخی از این نوع خطاها هستند.
اما خطای تعیین غلط الگو در وضعیتی رخ می دهد که الگوی واقعی معلوم نیست و ممکن است که در نتیجه انتخاب اشتباه بین نظریه های رقیب رخ دهد.(همان ، 19).
@analysisacademy
مرحله دوم : تجزیه و تحلیل داده ها (داده سنجی)
مرحله بسیار مهم بعدی استخراج داده های مور نیاز و مناسب می باشد. برخی از داده ها مستقیما از منابع آماری قابل استخراج بوده ، برخی دیگر مانند نرخ ارز واقعی موثر و ... باید محاسبه گردد و برای برخی از متغیرهای دیگر باید متغیر نماینده و یا جانشین تعیین گردد (صمدی،23).
مرحله سوم : روش سنجی
پس از تبیین مدل، باید روش مناسب بررسی مساله و همچنین روش مناسب تخمین انتخاب شود. در تحقیق حاضر با توجه به ماهیت داده ها از روش پانل دیتا که ترکیبی از داده های سری زمانی و مقطعی است، استفاده شده است.
مرحله چهارم : تخمین و استباط آماری
در این قسمت از مطالعه جهت تصریح مدل ابتدا رابطه متغیرهای مستقل از منظر آمار استنباطی بررسی می گردد و از بین متغیرهای توضیحی ، متغیرهای موثر انتخاب می شود.
مرحله پنجم: نتیجه گیری
در مرحله پنجم بر اساس تخمین مدل ، نتیجه گیری می شود و در نهایت بر اساس نتایج پیشنهادات و راهکارها ارائه می شود.

http://analysisacademy.com/wp-content/uploads/2016/12/imagesp.png
@analysisacademy
سرقت علمی
«دستبرد یا سرقت علمی» و اصطلاحاتی مانند دزدی یا سرقت علمی، ادبی یا فكری در فارسی، در برابر واژة Plagiarism به كار میروند.
كاربرد این واژه در مفهوم «سرقت ادبی» را به «ماركوس والریوس مارتیلیوس» شاعر هجوسرای رومی سده نخست میلادی نسبت دادهاند. وی خود را ارباب و صاحب و كلمات را برده خویش میدانست و به كسانی كه اشعار وی را به نام خود عرضه میكردند، لقب plagiarius (به معنای بچه دزد، غارتگر، فریب دهنده) داده بود.
سرقت علمی در تمام کشورهای دنیا وجود داشته و وجود خواهد داشت.
مانند ناخالصی هر مورد دیگری در جهان هستی، پژوهش و علم هم، دارای آفت هایی هستند.
در گذشته به دلیل آنکه سیستم جستجوی الکترونیکی کاملی برای شناسایی موارد تخلف علمی در دنیا وجود نداشت. به رغم آنکه در همه جای دنیا تخلف علمی انجام می شد، اما موارد آن خیلی به سختی کشف می گردید.
به عنوان عضوی از جامعه علمی، از ما انتظار می رود مسائل اخلاقی را در این جامعه رعایت کنیم که یکی از آنها، ذکر ایده ها، عبارات و مفاهیمی است که آگاهانه از دیگران وام گرفته ایم. واضح است که بدون وام گرفتن از عبارات و یا ایده های دیگران نمی توانیم متن علمی بنویسیم ولی مهم است که بدانید چقدر از متون قدیمی یا جدید استفاده کرده ایم .
بخشی از این مهم با "شناخت منابع" انجام می شود که می تواند به شکل نقل قول در متن، پاورقی یا نوشته های پایانی باشد و عامل افتراق متون علمی از سایر متون است و در واقع به عنوان بخشی از قدرت تحقیقات علمی محسوب می گردد . سرقت علمی- ادبی، حداقل به 3 دلیلی که در پی آمده، غیر اخلاقی است:
نوعی دستبرد است، چرا که ایده ها و عبارات دیگران را که بخشی از دارایی عقلانی آنهاست سرقت شده و به اسم فرد دیگری عرضه می گردد
زیرا فردی که اقدام به سرقت علمی- ادبی می نماید از این عمل خویش سود می برد.
مدرک تحصیلی، نشانی از توانایی و دانش صاحب آن است، اگر فرد با تکیه به این مدرک و بدون احراز شرایط واقعی علمی در جایی استخدام شود، می تواند برای دیگران خطرناک باشد.
@analysisacademy
انواع سرقت علمی
1- سرقت ادبی مستقیم Copy & Paste: نویسنده اثر را كلمه به كلمه و بدون هیچ استنادی و یا استفاده از علامت نقل قول به عنوان اثر خود وانمود كند.
2-سرقت ادبی تغییر کلمات Word Switch: زمانی که متنی از منبع اصلی گرفته شده و تنها دو، سه کلمه از آن تغییر یابد.
3- سرقت ادبی در سبک نگارش Style: زمانی که نویسنده جملات منبع اصلی را پاراگراف به پاراگراف و خط به خط دنبال کند، هر چند هیچ یک از کلمات وی همانند منبع اصلی نباشد.
4-سرقت ادبی از نوع تشبیه Metaphor ))
تشبیه یا استعاره یعنی یک ایده واضح که به خواننده این امکان را می دهد که حس و درک نزدیک تری از یک رویداد و یا واقعه داشته باشد.پس تشبیه و استعاره به عنوان بخش مهمی از سبک خلاقانه یک نویسنده به حساب می آید.
در برخی موارد فرد توانایی توضیح دادن درباره ایده های مهم کار خود را ندارد، بنابراین از جملات سلیس متن اصلی استفاده می نماید.
5-سرقت ادبی ایده Idea
زمانیکه فرد نویسنده در مقاله خود راه حل و یا ایده خلاقانه ایی را بیان می کند، این ایده و راه حل منسوب به وی خواهد بود. در بسیاری از موارد، افراد تازه کار در افتراق بین اطلاعات عمومی رایج و ایده های نویسنده در منبع اصلی مشکل دارند.
حیطه دانش عمومی، به هر گونه ایده و یا راه حلی گفته می شود که بیشتر افراد با هر سطح سواد و دانشی آنرا پذیرفته اند. بنابراین نیاز به منبع دادن ندارند.
@analysisacademy
نحوه صحیح رفرنس دادن :
1-نقل قول مستقیم
بازنویسى دقیق كلام شفاهى یا كتبى دیگران نقل قول مستقیم است، وقتى مى خواهیم عین كلام كسى را در نوشته خود نقل كنیم. باید:
آن را بین دو گیومه ( « » ) بیاوریم و بلافاصله منبع را ذكر كنیم.
حتى هنگامى كه یك عبارت یا یك كلمه خاص و مهم را از كسى یا منبعى نقل مى كنیم. آن را در گیومه بیاوریم.
حتماً صفحه و كل دقیق مطلب نقل شده را ذكر كنیم
2-نقل قول غیرمستقیم و خلاصه كردن
هنگامى كه اطلاعات و مطالب منبعى را در نوشته خود تركیب مى كنیم و آن را با كلام خودمان بنویسیم، نقل قول غیر مستقیم كرده ایم .
نقل قول غیرمستقیم، بازنویسى یا بازگویى یك قطعه كوچك از یك متن است كه طى آن معناى اصلى به صورت دیگرى بیان مى شود.
3-نقل قول غیرمستقیم و خلاصه كردن
خلاصه یانقل قول غیرمستقیم باید به قلم ما باشد و از كلمات و جمله هاى خود براى بیان مطالب دیگران استفاده كنیم. به یاد داشته باشیم كه فقط تغییر دادن یك یا دو كلمه نقل قول غیرمستقیم نیست؛ بلكه باید مطلبى را كه خوانده ایم خوب فهم كنیم و سپس آن را با استفاده از كلمات و عبارات خود بیان كنیم.
@analysisacademy
@analysisacademy
سرقت علمی
«دستبرد یا سرقت علمی» و اصطلاحاتی مانند دزدی یا سرقت علمی، ادبی یا فكری در فارسی، در برابر واژة Plagiarism به كار میروند.
كاربرد این واژه در مفهوم «سرقت ادبی» را به «ماركوس والریوس مارتیلیوس» شاعر هجوسرای رومی سده نخست میلادی نسبت دادهاند. وی خود را ارباب و صاحب و كلمات را برده خویش میدانست و به كسانی كه اشعار وی را به نام خود عرضه میكردند، لقب plagiarius (به معنای بچه دزد، غارتگر، فریب دهنده) داده بود.
سرقت علمی در تمام کشورهای دنیا وجود داشته و وجود خواهد داشت.
مانند ناخالصی هر مورد دیگری در جهان هستی، پژوهش و علم هم، دارای آفت هایی هستند.
در گذشته به دلیل آنکه سیستم جستجوی الکترونیکی کاملی برای شناسایی موارد تخلف علمی در دنیا وجود نداشت. به رغم آنکه در همه جای دنیا تخلف علمی انجام می شد، اما موارد آن خیلی به سختی کشف می گردید.
به عنوان عضوی از جامعه علمی، از ما انتظار می رود مسائل اخلاقی را در این جامعه رعایت کنیم که یکی از آنها، ذکر ایده ها، عبارات و مفاهیمی است که آگاهانه از دیگران وام گرفته ایم. واضح است که بدون وام گرفتن از عبارات و یا ایده های دیگران نمی توانیم متن علمی بنویسیم ولی مهم است که بدانید چقدر از متون قدیمی یا جدید استفاده کرده ایم .
بخشی از این مهم با "شناخت منابع" انجام می شود که می تواند به شکل نقل قول در متن، پاورقی یا نوشته های پایانی باشد و عامل افتراق متون علمی از سایر متون است و در واقع به عنوان بخشی از قدرت تحقیقات علمی محسوب می گردد . سرقت علمی- ادبی، حداقل به 3 دلیلی که در پی آمده، غیر اخلاقی است:
نوعی دستبرد است، چرا که ایده ها و عبارات دیگران را که بخشی از دارایی عقلانی آنهاست سرقت شده و به اسم فرد دیگری عرضه می گردد
زیرا فردی که اقدام به سرقت علمی- ادبی می نماید از این عمل خویش سود می برد.
مدرک تحصیلی، نشانی از توانایی و دانش صاحب آن است، اگر فرد با تکیه به این مدرک و بدون احراز شرایط واقعی علمی در جایی استخدام شود، می تواند برای دیگران خطرناک باشد.
@analysisacademy
انواع سرقت علمی
1- سرقت ادبی مستقیم Copy & Paste: نویسنده اثر را كلمه به كلمه و بدون هیچ استنادی و یا استفاده از علامت نقل قول به عنوان اثر خود وانمود كند.
2-سرقت ادبی تغییر کلمات Word Switch: زمانی که متنی از منبع اصلی گرفته شده و تنها دو، سه کلمه از آن تغییر یابد.
3- سرقت ادبی در سبک نگارش Style: زمانی که نویسنده جملات منبع اصلی را پاراگراف به پاراگراف و خط به خط دنبال کند، هر چند هیچ یک از کلمات وی همانند منبع اصلی نباشد.
4-سرقت ادبی از نوع تشبیه Metaphor ))
تشبیه یا استعاره یعنی یک ایده واضح که به خواننده این امکان را می دهد که حس و درک نزدیک تری از یک رویداد و یا واقعه داشته باشد.پس تشبیه و استعاره به عنوان بخش مهمی از سبک خلاقانه یک نویسنده به حساب می آید.
در برخی موارد فرد توانایی توضیح دادن درباره ایده های مهم کار خود را ندارد، بنابراین از جملات سلیس متن اصلی استفاده می نماید.
5-سرقت ادبی ایده Idea
زمانیکه فرد نویسنده در مقاله خود راه حل و یا ایده خلاقانه ایی را بیان می کند، این ایده و راه حل منسوب به وی خواهد بود. در بسیاری از موارد، افراد تازه کار در افتراق بین اطلاعات عمومی رایج و ایده های نویسنده در منبع اصلی مشکل دارند.
حیطه دانش عمومی، به هر گونه ایده و یا راه حلی گفته می شود که بیشتر افراد با هر سطح سواد و دانشی آنرا پذیرفته اند. بنابراین نیاز به منبع دادن ندارند.
@analysisacademy
نحوه صحیح رفرنس دادن :
1-نقل قول مستقیم
بازنویسى دقیق كلام شفاهى یا كتبى دیگران نقل قول مستقیم است، وقتى مى خواهیم عین كلام كسى را در نوشته خود نقل كنیم. باید:
آن را بین دو گیومه ( « » ) بیاوریم و بلافاصله منبع را ذكر كنیم.
حتى هنگامى كه یك عبارت یا یك كلمه خاص و مهم را از كسى یا منبعى نقل مى كنیم. آن را در گیومه بیاوریم.
حتماً صفحه و كل دقیق مطلب نقل شده را ذكر كنیم
2-نقل قول غیرمستقیم و خلاصه كردن
هنگامى كه اطلاعات و مطالب منبعى را در نوشته خود تركیب مى كنیم و آن را با كلام خودمان بنویسیم، نقل قول غیر مستقیم كرده ایم .
نقل قول غیرمستقیم، بازنویسى یا بازگویى یك قطعه كوچك از یك متن است كه طى آن معناى اصلى به صورت دیگرى بیان مى شود.
3-نقل قول غیرمستقیم و خلاصه كردن
خلاصه یانقل قول غیرمستقیم باید به قلم ما باشد و از كلمات و جمله هاى خود براى بیان مطالب دیگران استفاده كنیم. به یاد داشته باشیم كه فقط تغییر دادن یك یا دو كلمه نقل قول غیرمستقیم نیست؛ بلكه باید مطلبى را كه خوانده ایم خوب فهم كنیم و سپس آن را با استفاده از كلمات و عبارات خود بیان كنیم.
@analysisacademy

تشخیص سرقت علمی
ممکن است سرقت علمی ناآگاهانه صورت گیرد، یعنی عبارت کوتاهی از مقاله ای برداشته شود و چنانچه تعداد این عبارات(زنجیرۀ بیش از 3 واژه مشابه) از مثلا 30 درصد بیشتر شود، مقاله شما در لیست سیاه سرقت ادبی قرار می گیرد.
برای سنجیدن میزان سرقت علمی و ادبی نرم افزارهایی وجود دارد که شما مقاله خود را در این نرم افزار یا سایت وارد می کنید و این نرم افزار به شما میزان کپی بدون منبع دیگران را نشان میدهد.
یکی از مهمترین نرم افزارها در رابطه با سرقت علمی در دنیا نرم افزار «ترنیتن»(Turnitin) است که در سایتwww.turnitin.com قابل دستیابی است، البته یک مقداری از امکانات سایت پولی است. اما معتبرترین سایت برای سنجش متن شما است. این سایت به پایگاههای اطلاعات زیادی متصل است.
بهترین راه برای جلوگیری از سرقت ادبی و علمی منبع جمله یا پاراگراف است و قرار دادن عبارات در گیومه یا کوتیشن است. و یا اینکه ترتیب واژه ها تغییر کند یا کلمات شبیه به هم استفاده شود.
چنانچه مقاله ای را به ژورنالی بفرستید، داوران ایتدا با استفاده از این نوع نرم افزارها میزان اصالت متن شما را می سنجند. مثلا در سایت www.articlechecker.com متن خود را وارد کنید و بعد کلید compare را بزنید تا در دو موتور جستجوی گوگل و یاهو به دنبال عبارات مشابه بگردد.
سایتwww.copyscape.com سایت بسیار خوبی برای سنجیدن میزان سرقت ادبی و علمی است اگرچه سایت رایگان نمی باشد.
ممکن است سرقت علمی ناآگاهانه صورت گیرد، یعنی عبارت کوتاهی از مقاله ای برداشته شود و چنانچه تعداد این عبارات(زنجیرۀ بیش از 3 واژه مشابه) از مثلا 30 درصد بیشتر شود، مقاله شما در لیست سیاه سرقت ادبی قرار می گیرد.
برای سنجیدن میزان سرقت علمی و ادبی نرم افزارهایی وجود دارد که شما مقاله خود را در این نرم افزار یا سایت وارد می کنید و این نرم افزار به شما میزان کپی بدون منبع دیگران را نشان میدهد.
یکی از مهمترین نرم افزارها در رابطه با سرقت علمی در دنیا نرم افزار «ترنیتن»(Turnitin) است که در سایتwww.turnitin.com قابل دستیابی است، البته یک مقداری از امکانات سایت پولی است. اما معتبرترین سایت برای سنجش متن شما است. این سایت به پایگاههای اطلاعات زیادی متصل است.
بهترین راه برای جلوگیری از سرقت ادبی و علمی منبع جمله یا پاراگراف است و قرار دادن عبارات در گیومه یا کوتیشن است. و یا اینکه ترتیب واژه ها تغییر کند یا کلمات شبیه به هم استفاده شود.
چنانچه مقاله ای را به ژورنالی بفرستید، داوران ایتدا با استفاده از این نوع نرم افزارها میزان اصالت متن شما را می سنجند. مثلا در سایت www.articlechecker.com متن خود را وارد کنید و بعد کلید compare را بزنید تا در دو موتور جستجوی گوگل و یاهو به دنبال عبارات مشابه بگردد.
سایتwww.copyscape.com سایت بسیار خوبی برای سنجیدن میزان سرقت ادبی و علمی است اگرچه سایت رایگان نمی باشد.
http://analysisacademy.com/wp-content/uploads/2016/12/IMG_20160818_211617-1S-3-1.jpg
@analysisacademy
دوره 5 روزه SPSS مقدماتی تا پیشرفته دیماه 1395
آکادمی تحلیل آماری ایران برگزار می کند: دوره 5 روزه SPSS مقدماتی تا پیشرفته دیماه 1395
دوره آموزشی: دوره آموزشی 40ساعته مقدماتی تا پیشرفته SPSS با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی
زمان: چهارشنبه، پنج شنبه و جمعه 15-16-17 دیماه از ساعت 13 تا 21 و پنجشنبه و جمعه 23 و 24 دیماه از ساعت 13 تا 21(دوره پنج روزه است)
هزینه ثبت نام شرکت کنندگان آزاد 550 هزار تومان
هزینه ثبت نام دانشجویی 450 هزار تومان
مدرس: دکتر محسن مرادی
محل تشکیل :آکادمی تحلیل آماری ایران
دوره آموزشی کاربردی مهارتی و تضمینی می باشد
رزرو با 09100071804
ظرفیت محدود
فرم ثبت نام کارگاه
مزیتها:
•آموزش نیمه خصوصی، عملیاتی و تضمینی است.
• این دوره ها نیاز به هیچ گونه پیش زمینه آموزشی ندارد و آموزشها از مقدماتی تا پیشرفته صورت می پذیرد.
• در پایان گواهینامه بین المللیمعتبر از انگلستان به مدعوین اعطا خواهد شد که در جهت ارتقای رزومه محققین در داخل و خارج از کشور نقش بسزایی ایفا می کند.
•برای هر یک از مدعوین تضمین تسلط کامل و ۱۰۰درصد بر نرم افزار با متد نوین آموزش صورت میپذیرد.
•پس از دوره رفع اشکال به صورت تماس تلفنی و پاسخ به ایمیل مقدور می باشد.
•مهم ترین مزیت این دوره ها در مقایسه با دوره های دیگر این است که شما بر خلاف دوره های مشابه دیگر که صحبت از یادگیری با تعداد ساعت های کم یا تضمینی یاد گرفتن نرم افزار ها را می شنوید، در اینجا RUNکردن مدل ها و یادگیری نرم افزار ها تنها ده درصد مطالب کلاس را تشکیل می دهد. در واقع مدل ها های آزمون شده در نرم افزار اگر اغراق نباشد تنها یک نقاشی کم ارزش است و کار محقق تازه در کلاس از آن به بعد آغاز می شود. اینکه چطور فصل 3 و 4 پایان نامه خود را بنویسد یا چطور از این نرم افزار ها در نوشتن مقالات خود استفاده کند و یا چطور با توجه به استاندارد های روز دنیا این مطالب پیچیده آماری را به سادگی تفسیر و تحلیل کند وظیفه اصلی این دوره ها است که در دوره های موسسات یا اشخاص دیگر به گواهی شرکت کنندگان وجود ندارد. این موضوع دلیل اقبال محققین و دانشجویان عزیز در طی این چهار سال اخیر از دوره های آکادمی تحلیل آماری ایران است.
سخنی بسیار مهم با شما محقق عزیز:
پیش از اینکه به سرفصلهای دوره ها پرداخته شود باید چند نکته کوتاه اما بسیار پر اهمیت را با شما در میان گذاریم:
این آکادمی، با برگزاری بیش از ۳۸۰دوره آموزشی در تهران، شیراز، اصفهان، کرمان، مشهد، گیلان و مازندران، تبریز، ارس، دوبی و دوحه قطر و … در حوزه پایان نامه نویسی، مقاله نویسی و تحلیل آماری کارهای پژوهشی صادقانه بیان می کند که شما با آموزش صحیح این مباحث قادر خواهید بود که کار فصل سوم، چهارم و به طور کلی آزمونهای آماری و پیشبرد سایر مراحل تحقیق خود را شخصا بهعهده گیرید؛ متاسفانه افراد سودجو در موسسات غیرقانونی در میدان انقلاب و همینطور برگزارکننده های دوره های مجازی و فروشندگان بسته های آموزشی اکثرا سعی در اتلاف وقت و هزینه شما دارند. به گواهی کلیه اساتید و فراگیرانی که در این دوره ها شرکت کرده اند و به صورت موفقیت آمیز کار پژوهش خود را از ابتدا تا انتهای کار انجام داده اند و به این تخصص به عنوان یک حرفه کاملا درآمدزا نگریسته اند شما را به پرهیز از اعتماد به دیگران به جای اعتماد به خودتان دعوت می کنیم.
فراموش نکنید شما به جای صرف هزینه یک تا دو میلیون تومانی به طور مستقیم و هزینه های غیر مستقیم و بار روانی سنگین، با شرکت در دوره های کاملا کاربردی و تضمینی آکادمی که با شیوه نوین جهانی در ایران تنها و تنها توسط اساتید زبده و متخصص ما برگزار می گردد می توانید به انجام صفر تا صد تحلیل پایان نامه و مقالات خود پرداخته و همانند بسیاری از شرکت کنندگان این دوره ها علاوه بر اخذ یک گواهینامه بین المللی و تخصص در این حوزه مقالات معتبری را برای ادامه مسیر علمی تان در داخل و خارج از کشور به چاپ رسانید؛ حال انتخاب با شماست.
@analysisacademy
دوره 5 روزه SPSS مقدماتی تا پیشرفته دیماه 1395
آکادمی تحلیل آماری ایران برگزار می کند: دوره 5 روزه SPSS مقدماتی تا پیشرفته دیماه 1395
دوره آموزشی: دوره آموزشی 40ساعته مقدماتی تا پیشرفته SPSS با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی
زمان: چهارشنبه، پنج شنبه و جمعه 15-16-17 دیماه از ساعت 13 تا 21 و پنجشنبه و جمعه 23 و 24 دیماه از ساعت 13 تا 21(دوره پنج روزه است)
هزینه ثبت نام شرکت کنندگان آزاد 550 هزار تومان
هزینه ثبت نام دانشجویی 450 هزار تومان
مدرس: دکتر محسن مرادی
محل تشکیل :آکادمی تحلیل آماری ایران
دوره آموزشی کاربردی مهارتی و تضمینی می باشد
رزرو با 09100071804
ظرفیت محدود
فرم ثبت نام کارگاه
مزیتها:
•آموزش نیمه خصوصی، عملیاتی و تضمینی است.
• این دوره ها نیاز به هیچ گونه پیش زمینه آموزشی ندارد و آموزشها از مقدماتی تا پیشرفته صورت می پذیرد.
• در پایان گواهینامه بین المللیمعتبر از انگلستان به مدعوین اعطا خواهد شد که در جهت ارتقای رزومه محققین در داخل و خارج از کشور نقش بسزایی ایفا می کند.
•برای هر یک از مدعوین تضمین تسلط کامل و ۱۰۰درصد بر نرم افزار با متد نوین آموزش صورت میپذیرد.
•پس از دوره رفع اشکال به صورت تماس تلفنی و پاسخ به ایمیل مقدور می باشد.
•مهم ترین مزیت این دوره ها در مقایسه با دوره های دیگر این است که شما بر خلاف دوره های مشابه دیگر که صحبت از یادگیری با تعداد ساعت های کم یا تضمینی یاد گرفتن نرم افزار ها را می شنوید، در اینجا RUNکردن مدل ها و یادگیری نرم افزار ها تنها ده درصد مطالب کلاس را تشکیل می دهد. در واقع مدل ها های آزمون شده در نرم افزار اگر اغراق نباشد تنها یک نقاشی کم ارزش است و کار محقق تازه در کلاس از آن به بعد آغاز می شود. اینکه چطور فصل 3 و 4 پایان نامه خود را بنویسد یا چطور از این نرم افزار ها در نوشتن مقالات خود استفاده کند و یا چطور با توجه به استاندارد های روز دنیا این مطالب پیچیده آماری را به سادگی تفسیر و تحلیل کند وظیفه اصلی این دوره ها است که در دوره های موسسات یا اشخاص دیگر به گواهی شرکت کنندگان وجود ندارد. این موضوع دلیل اقبال محققین و دانشجویان عزیز در طی این چهار سال اخیر از دوره های آکادمی تحلیل آماری ایران است.
سخنی بسیار مهم با شما محقق عزیز:
پیش از اینکه به سرفصلهای دوره ها پرداخته شود باید چند نکته کوتاه اما بسیار پر اهمیت را با شما در میان گذاریم:
این آکادمی، با برگزاری بیش از ۳۸۰دوره آموزشی در تهران، شیراز، اصفهان، کرمان، مشهد، گیلان و مازندران، تبریز، ارس، دوبی و دوحه قطر و … در حوزه پایان نامه نویسی، مقاله نویسی و تحلیل آماری کارهای پژوهشی صادقانه بیان می کند که شما با آموزش صحیح این مباحث قادر خواهید بود که کار فصل سوم، چهارم و به طور کلی آزمونهای آماری و پیشبرد سایر مراحل تحقیق خود را شخصا بهعهده گیرید؛ متاسفانه افراد سودجو در موسسات غیرقانونی در میدان انقلاب و همینطور برگزارکننده های دوره های مجازی و فروشندگان بسته های آموزشی اکثرا سعی در اتلاف وقت و هزینه شما دارند. به گواهی کلیه اساتید و فراگیرانی که در این دوره ها شرکت کرده اند و به صورت موفقیت آمیز کار پژوهش خود را از ابتدا تا انتهای کار انجام داده اند و به این تخصص به عنوان یک حرفه کاملا درآمدزا نگریسته اند شما را به پرهیز از اعتماد به دیگران به جای اعتماد به خودتان دعوت می کنیم.
فراموش نکنید شما به جای صرف هزینه یک تا دو میلیون تومانی به طور مستقیم و هزینه های غیر مستقیم و بار روانی سنگین، با شرکت در دوره های کاملا کاربردی و تضمینی آکادمی که با شیوه نوین جهانی در ایران تنها و تنها توسط اساتید زبده و متخصص ما برگزار می گردد می توانید به انجام صفر تا صد تحلیل پایان نامه و مقالات خود پرداخته و همانند بسیاری از شرکت کنندگان این دوره ها علاوه بر اخذ یک گواهینامه بین المللی و تخصص در این حوزه مقالات معتبری را برای ادامه مسیر علمی تان در داخل و خارج از کشور به چاپ رسانید؛ حال انتخاب با شماست.

سرفصل های کارگاه SPSS:
-روش علمی و انواع پژوهش
-تعریف متغیرها و دسته بندی متغیرها
-سطوح اندازه گیری متغییرها
-فرضیه و انواع آن
-شیوه انتخاب آزمونهای مناسب و متناسب با فرضیات
-انواع خطاها
-داده های پارامتری و ناپارامتری
-درجه آزادی
-سطح معنی داری
-آزمون یک دامنه و دو دامنه
-انواع توزیع آماری
-آشنایی با نرم افزار و ورود دادهها
-شاخصهای توصیف داده ها و نمودارها
-تعیین پایایی ابزار پرسشنامه
-تعیین روایی ابزار پرسشنامه
-سنجش رابطه بین متغییرها(ضرایب همبستگی)
-آزمونهای مقایسات میانگین گروهی و زوجی
-آزمون مقایسه میانگین چند جامعه
-آزمون مقایسات ناپارامتری
-تحلیل رگرسیون خطی
-تحلیل عاملی اکتشافی
-تحلیل مسیر
-شیوه به کارگیری کلیه تکنیکها در پایان نامه و مقالات علمی و پژوهشی
و…
مدرس: دکتر محسن مرادی
دکتری مدیریت بازرگانی
تحلیلگر بیش از 500 پروژه تخصصی
مشاور تحقیقات بازار ۱۵شرکت اقتصادی در تهران و شهرستانها
مدرس دوره های تحقیقات کمی و کیفی بین المللی
و مدرس همایش های بین المللی
رزرو با : ۰۹۱۰۰۰۷۱۸۰۴
جهت مشاوره رایگان دوره با شماره بالا تماس گیرید
"تخفیف ویژه برای دانشجویان تحصیلات تکمیلی ارشد و دکتری"
جهت کسب اطلاعات روزانه در مورد دوره های کمی و کیفی هفته های آتی آکادمی تحلیل آماری ایران پیج ما در اینستاگرام را فالو نمایید:
https://www.instagram.com/analysisacademy
توجه:کسانی که فرصت حضور در کلاسهای آکادمی را ندارند به تعداد محدود می توانند از شرایط ویژه مشاوره و انجام تحلیل آماری فصل سوم و چهارم پایان نامه یا مقاله خود توسط تیم مجرب آکادمی زیر نظر دکتر مرادی بهره مند شوند. جهت اعمال نظر تیم مذکور درخواست خود را به ایمیل analysisacademy1@gmail.com ارسال فرمایید.
آدرس: تهران، خیابان مطهری، بین میرعماد و مفتح، جنب ایستگاه مترو مفتح، پلاک۲۴۰، طبقه دوم، آکادمی تحلیل آماری ایران
-روش علمی و انواع پژوهش
-تعریف متغیرها و دسته بندی متغیرها
-سطوح اندازه گیری متغییرها
-فرضیه و انواع آن
-شیوه انتخاب آزمونهای مناسب و متناسب با فرضیات
-انواع خطاها
-داده های پارامتری و ناپارامتری
-درجه آزادی
-سطح معنی داری
-آزمون یک دامنه و دو دامنه
-انواع توزیع آماری
-آشنایی با نرم افزار و ورود دادهها
-شاخصهای توصیف داده ها و نمودارها
-تعیین پایایی ابزار پرسشنامه
-تعیین روایی ابزار پرسشنامه
-سنجش رابطه بین متغییرها(ضرایب همبستگی)
-آزمونهای مقایسات میانگین گروهی و زوجی
-آزمون مقایسه میانگین چند جامعه
-آزمون مقایسات ناپارامتری
-تحلیل رگرسیون خطی
-تحلیل عاملی اکتشافی
-تحلیل مسیر
-شیوه به کارگیری کلیه تکنیکها در پایان نامه و مقالات علمی و پژوهشی
و…
مدرس: دکتر محسن مرادی
دکتری مدیریت بازرگانی
تحلیلگر بیش از 500 پروژه تخصصی
مشاور تحقیقات بازار ۱۵شرکت اقتصادی در تهران و شهرستانها
مدرس دوره های تحقیقات کمی و کیفی بین المللی
و مدرس همایش های بین المللی
رزرو با : ۰۹۱۰۰۰۷۱۸۰۴
جهت مشاوره رایگان دوره با شماره بالا تماس گیرید
"تخفیف ویژه برای دانشجویان تحصیلات تکمیلی ارشد و دکتری"
جهت کسب اطلاعات روزانه در مورد دوره های کمی و کیفی هفته های آتی آکادمی تحلیل آماری ایران پیج ما در اینستاگرام را فالو نمایید:
https://www.instagram.com/analysisacademy
توجه:کسانی که فرصت حضور در کلاسهای آکادمی را ندارند به تعداد محدود می توانند از شرایط ویژه مشاوره و انجام تحلیل آماری فصل سوم و چهارم پایان نامه یا مقاله خود توسط تیم مجرب آکادمی زیر نظر دکتر مرادی بهره مند شوند. جهت اعمال نظر تیم مذکور درخواست خود را به ایمیل analysisacademy1@gmail.com ارسال فرمایید.
آدرس: تهران، خیابان مطهری، بین میرعماد و مفتح، جنب ایستگاه مترو مفتح، پلاک۲۴۰، طبقه دوم، آکادمی تحلیل آماری ایران
http://analysisacademy.com/wp-content/uploads/2016/12/مدل-اشباع-و-استقلال.jpg
@analysisacademy
مدل استقلال و مدل اشباع شده
مدل اشباع شده
بر این مبنا که مدل اشباع شده به عنوان مدلی تعریف می شود که در آن همه مسیرهای ممنکن ترسیم شده اند می توان آن را نقطه مقابل مدل استقلال دانست، اگر مدل استقلال مدلی است که در آن کای اسکوئر به حداکثر ممکن می رسد مدل اشباع مدلی است که در آن مقدار کای اسکوئر حداقل ممکن یا صفر خواهد بود.
مدل استقلال
مدل استقلال مدلی است که در آن متغییرهای موجود در مدل فاقد هر گونه رابطه یک سویه یادو سویهبا یکدیگرند و کوواریانس میان آنها صفر فرض شده است. این نوع مدلها یکی از انواع مدلهایی هستند که به نام مدل صفر خوانده می شوند و مبنایی برای ارزیابیمدل مفروض را فراهم می آورند. هر چند مطالعات کاربردی چنین مدلی به خودی خود مفید به نظر نمی رسد اما مقایسه مقدار کای اسکوئر مدل مفروض با مدل استقلال نشان می دهد که مدل تدوین شده تا چه اندازه در بهبود (کاهش) این مقدار موفق عمل کرده است و بنابراین شاخصی را برای ارزیابی برازش فراهم می آورد.
@analysisacademy
مدل استقلال و مدل اشباع شده
مدل اشباع شده
بر این مبنا که مدل اشباع شده به عنوان مدلی تعریف می شود که در آن همه مسیرهای ممنکن ترسیم شده اند می توان آن را نقطه مقابل مدل استقلال دانست، اگر مدل استقلال مدلی است که در آن کای اسکوئر به حداکثر ممکن می رسد مدل اشباع مدلی است که در آن مقدار کای اسکوئر حداقل ممکن یا صفر خواهد بود.
مدل استقلال
مدل استقلال مدلی است که در آن متغییرهای موجود در مدل فاقد هر گونه رابطه یک سویه یادو سویهبا یکدیگرند و کوواریانس میان آنها صفر فرض شده است. این نوع مدلها یکی از انواع مدلهایی هستند که به نام مدل صفر خوانده می شوند و مبنایی برای ارزیابیمدل مفروض را فراهم می آورند. هر چند مطالعات کاربردی چنین مدلی به خودی خود مفید به نظر نمی رسد اما مقایسه مقدار کای اسکوئر مدل مفروض با مدل استقلال نشان می دهد که مدل تدوین شده تا چه اندازه در بهبود (کاهش) این مقدار موفق عمل کرده است و بنابراین شاخصی را برای ارزیابی برازش فراهم می آورد.

http://analysisacademy.com/wp-content/uploads/2016/12/پرسش-نامه-مکاتبه-ای.png
@analysisacademy
پرسشنامههای مکاتبهای در تحقیقات بازاریابی
انواع مختلف پرسشنامههایی که بدون فعالیت پرسشگر و توسط پاسخگو تکمیل میشوند در این مقوله قرار میگیرند. در بیشتر موارد این پرسشنامهها برای پاسخگویان پست میشود اما ممکن است پرسشنامهها از طریق ابزارهای دیگری نیز (مانند کارکنان فروش، فروشندههای فروشگاهها) توزیع شود. بهتازگی برخی از شرکتهای فعال در تحقیقات بازاریابی تجارب خوبی در ارسال این نوع پرسشنامهها از طریق اینترنت و دریافت پاسخ کامل آن از همان طریق به دست آوردهاند.
ظرفیت خلاق این نوآوری جدید (اینترنت) بسیار بالاست زیرا بهسرعت میتواند پاسخها را منتقل و دریافت کند. هرچند، باوجود استفاده زیاد و فزاینده اینترنت بهویژه در میان شرکتهای تجاری ،به خاطر امکان جهتدار بودن کاربران جوان اینترنت، استفاده از آن کمی موردتردید قرارگرفته است.
پرسشنامههای مکاتبهای برای برخی از افراد نمونه آماری پست میگردد و از آنها درخواست میشود آن را پس از تکمیل بازگردانند. مزیت اصل این روش هزینه پایین و پوشش نسبتاً وسیع آن هست هرچند که موانع و سختیهایی را نیز در این نوع روش میتوان یافت از آن جمله اینکه میزان پاسخهای ارسالی ممکن است کمی پایین باشد هرچند که این مسئله تا حدودی بستگی به ماهیت نوع تحقیق و جمعیت آماری داشته باشد. پایین بودن میزان پاسخها در عمل مشکلاتی را ایجاد میکند برای مثال اگر گفته شود که پنج درصد جمعیت نمونه پرسشنامهها را تکمیل و ارسال کرده باشند پژوهشگر چگونه میتواند مطمئن باشد که این پاسخگویان میتوانند نماینده کل نمونه باشند. بیشتر ممکن است بستگی به اثربخشی و کارایی نوشته و نامهای داشته باشد که همراه با پرسشنامه برای توضیح هدف تحقیق و نیز برای تشویق پاسخگو به مشارکت در تحقیق فرستاده میشود داشته باشد. گاهی ممکن است میزان پاسخ با پیشنهاد جایزه و یا هدیه و یا برنامه مدبرانهای افزایش یابد.
در طراحی پژوهش پیمایشی واضح است که این فعالیتها میباید در بودجه کامل پژوهش در نظر گرفته شود تا بتوان برآورد دقیقی از هزینههای موردنیاز برای تکمیل پژوهش به عمل آورد. در مقایسه این روش جمعآوری دادهها با دیگر روشها گفته میشود که پاسخهایی که از طریقپرسشنامههای مکاتبهای جمع میشود زمان نسبتاً طولانیتری نسبت به مصاحبههای تلفنی میطلبد بهعبارتیدیگر پرسشنامههای مکاتبهای به پاسخگویان این فرصت را میدهند تا به دنبال اطلاعاتی برای پاسخ دادن به سؤالات باشند که این امر در مورد مصاحبه تلفنی و یا رودررو امکانپذیر نیست این مسئله بهویژه در برخی از تحقیقات صنعتی اهمیت زیادی دارد.
برخی دیگر از مشکلات بالقوه پرسشنامههای مکاتبهای از این حقیقت ناشی میشود که پرسشنامه بهتنهایی ابزار اصلی ارتباط بین محقق و نمونه آماری است. یکی دیگر از مسائلی که باید بدان توجه داشت این است که سؤالات پرسشنامه میباید بسیار واضح، بدون ابهام و فهم آن برای مخاطب آسان باشد.
علاوه بر وجود یک پرسشگر باتجربه و آموزشدیده قابلفهم بودن و ساده بودن واژههای بهکاررفته در پرسشنامه از اهمیت زیادی برخوردار است (برای مثال اگر پاسخ شما بلی است لطفاً به سؤال شماره X بروید). بنابراین بهطورکلی میتوان گفت یک پرسشنامه مکاتبهای خوب طراحیشده و درست مدیریتشده بهویژه در پرسشنامههای طولانی و پرسشنامههایی که تعجیلی در تکمیل آن وجود نداشته باشد میتواند روش بسیار مناسب و کمهزینهای برای جمعآوری دادهها باشد.
مطالب کانال و سایت بدون ذکر سایت منبع استفاده نشود
@analysisacademy
پرسشنامههای مکاتبهای در تحقیقات بازاریابی
انواع مختلف پرسشنامههایی که بدون فعالیت پرسشگر و توسط پاسخگو تکمیل میشوند در این مقوله قرار میگیرند. در بیشتر موارد این پرسشنامهها برای پاسخگویان پست میشود اما ممکن است پرسشنامهها از طریق ابزارهای دیگری نیز (مانند کارکنان فروش، فروشندههای فروشگاهها) توزیع شود. بهتازگی برخی از شرکتهای فعال در تحقیقات بازاریابی تجارب خوبی در ارسال این نوع پرسشنامهها از طریق اینترنت و دریافت پاسخ کامل آن از همان طریق به دست آوردهاند.
ظرفیت خلاق این نوآوری جدید (اینترنت) بسیار بالاست زیرا بهسرعت میتواند پاسخها را منتقل و دریافت کند. هرچند، باوجود استفاده زیاد و فزاینده اینترنت بهویژه در میان شرکتهای تجاری ،به خاطر امکان جهتدار بودن کاربران جوان اینترنت، استفاده از آن کمی موردتردید قرارگرفته است.
پرسشنامههای مکاتبهای برای برخی از افراد نمونه آماری پست میگردد و از آنها درخواست میشود آن را پس از تکمیل بازگردانند. مزیت اصل این روش هزینه پایین و پوشش نسبتاً وسیع آن هست هرچند که موانع و سختیهایی را نیز در این نوع روش میتوان یافت از آن جمله اینکه میزان پاسخهای ارسالی ممکن است کمی پایین باشد هرچند که این مسئله تا حدودی بستگی به ماهیت نوع تحقیق و جمعیت آماری داشته باشد. پایین بودن میزان پاسخها در عمل مشکلاتی را ایجاد میکند برای مثال اگر گفته شود که پنج درصد جمعیت نمونه پرسشنامهها را تکمیل و ارسال کرده باشند پژوهشگر چگونه میتواند مطمئن باشد که این پاسخگویان میتوانند نماینده کل نمونه باشند. بیشتر ممکن است بستگی به اثربخشی و کارایی نوشته و نامهای داشته باشد که همراه با پرسشنامه برای توضیح هدف تحقیق و نیز برای تشویق پاسخگو به مشارکت در تحقیق فرستاده میشود داشته باشد. گاهی ممکن است میزان پاسخ با پیشنهاد جایزه و یا هدیه و یا برنامه مدبرانهای افزایش یابد.
در طراحی پژوهش پیمایشی واضح است که این فعالیتها میباید در بودجه کامل پژوهش در نظر گرفته شود تا بتوان برآورد دقیقی از هزینههای موردنیاز برای تکمیل پژوهش به عمل آورد. در مقایسه این روش جمعآوری دادهها با دیگر روشها گفته میشود که پاسخهایی که از طریقپرسشنامههای مکاتبهای جمع میشود زمان نسبتاً طولانیتری نسبت به مصاحبههای تلفنی میطلبد بهعبارتیدیگر پرسشنامههای مکاتبهای به پاسخگویان این فرصت را میدهند تا به دنبال اطلاعاتی برای پاسخ دادن به سؤالات باشند که این امر در مورد مصاحبه تلفنی و یا رودررو امکانپذیر نیست این مسئله بهویژه در برخی از تحقیقات صنعتی اهمیت زیادی دارد.
برخی دیگر از مشکلات بالقوه پرسشنامههای مکاتبهای از این حقیقت ناشی میشود که پرسشنامه بهتنهایی ابزار اصلی ارتباط بین محقق و نمونه آماری است. یکی دیگر از مسائلی که باید بدان توجه داشت این است که سؤالات پرسشنامه میباید بسیار واضح، بدون ابهام و فهم آن برای مخاطب آسان باشد.
علاوه بر وجود یک پرسشگر باتجربه و آموزشدیده قابلفهم بودن و ساده بودن واژههای بهکاررفته در پرسشنامه از اهمیت زیادی برخوردار است (برای مثال اگر پاسخ شما بلی است لطفاً به سؤال شماره X بروید). بنابراین بهطورکلی میتوان گفت یک پرسشنامه مکاتبهای خوب طراحیشده و درست مدیریتشده بهویژه در پرسشنامههای طولانی و پرسشنامههایی که تعجیلی در تکمیل آن وجود نداشته باشد میتواند روش بسیار مناسب و کمهزینهای برای جمعآوری دادهها باشد.
مطالب کانال و سایت بدون ذکر سایت منبع استفاده نشود
http://analysisacademy.com/wp-content/uploads/2016/12/pearson-2-small2.png
@analysisacademy
نحوه تفسیر دامنه ضریب همبستگی
آماردانان و تحلیل گران مختلف، دامنه های متفاوتی را برای تفسیر ضریب همبستگی در نظر گرفته اند که پرداختن به آنها ، خارج از موضوع این مطلب است. در این جا به مهم ترین این دسته بندی و نحوه تفسیر آنها که کاربرد بیشتری دارند، اشاره می کنیم:
دامنه همبستگی 20/0 تا 35/0
همبستگی بین این دامنه ، هر چند که از نظر آماری ممکن است معنی دار باشد، تنها رابطه نسبتا ضعیفی را بین متغییرها نشان می دهد. همبستگی 20/0 نشان می دهد که فقط 4 درصد واریانس بین دو متغییر مشترک است.
دامنه همبستگی 35/0 تا 65/0
در این دامنه، همبستگی ها از نظر آماری بالاتر از سطح یک درصد معنی دار هستند. وقتی همبستگی حدود 40/0 باشد، پیش بینی ساده گروهی امکان پذیر است.
دامنه همبستگی بین 65/0 تا 85/0
با استفاده از همبستگی های این دامنه می توان پیش بینی های گروهی انجام داد که به اندازه کافی دقیق باشند. به عنوان مثال، می توان درصد موفقیت نامزدها را در یک انتخابات با خطای بسیار کمی پیش بینی کرد. از ضرایب همبستگی بالاتر از 75/0 می توان برای پیش بینی های فردی تا حد قابل قبولی استفاده کرد.
همبستگی های بالاتر از 85/0
همبستگی های بالاتر از 85/0 نشان دهنده رابطه نزدیک بین دو متغییر است. همبستگی 85/0 حاکی از آن است که اندازه مورداستفاده برای پیش بینی حدود 72 درصد با عملکرد مورد پیش بینی، واریانسی مشترک دارد. مطالعات پیش بینی در علوم اجتماعی و تربیتی به ندرت تا این حد بالاست. با این حال اگر همبستگی در این حد به دست آمد، برای پیش بینی گروهی و انفرادی بسیار مفید است.
@analysisacademy
نحوه تفسیر دامنه ضریب همبستگی
آماردانان و تحلیل گران مختلف، دامنه های متفاوتی را برای تفسیر ضریب همبستگی در نظر گرفته اند که پرداختن به آنها ، خارج از موضوع این مطلب است. در این جا به مهم ترین این دسته بندی و نحوه تفسیر آنها که کاربرد بیشتری دارند، اشاره می کنیم:
دامنه همبستگی 20/0 تا 35/0
همبستگی بین این دامنه ، هر چند که از نظر آماری ممکن است معنی دار باشد، تنها رابطه نسبتا ضعیفی را بین متغییرها نشان می دهد. همبستگی 20/0 نشان می دهد که فقط 4 درصد واریانس بین دو متغییر مشترک است.
دامنه همبستگی 35/0 تا 65/0
در این دامنه، همبستگی ها از نظر آماری بالاتر از سطح یک درصد معنی دار هستند. وقتی همبستگی حدود 40/0 باشد، پیش بینی ساده گروهی امکان پذیر است.
دامنه همبستگی بین 65/0 تا 85/0
با استفاده از همبستگی های این دامنه می توان پیش بینی های گروهی انجام داد که به اندازه کافی دقیق باشند. به عنوان مثال، می توان درصد موفقیت نامزدها را در یک انتخابات با خطای بسیار کمی پیش بینی کرد. از ضرایب همبستگی بالاتر از 75/0 می توان برای پیش بینی های فردی تا حد قابل قبولی استفاده کرد.
همبستگی های بالاتر از 85/0
همبستگی های بالاتر از 85/0 نشان دهنده رابطه نزدیک بین دو متغییر است. همبستگی 85/0 حاکی از آن است که اندازه مورداستفاده برای پیش بینی حدود 72 درصد با عملکرد مورد پیش بینی، واریانسی مشترک دارد. مطالعات پیش بینی در علوم اجتماعی و تربیتی به ندرت تا این حد بالاست. با این حال اگر همبستگی در این حد به دست آمد، برای پیش بینی گروهی و انفرادی بسیار مفید است.
