http://analysisacademy.com/wp-content/uploads/2016/11/Untitled12.jpg
@analysisacademy
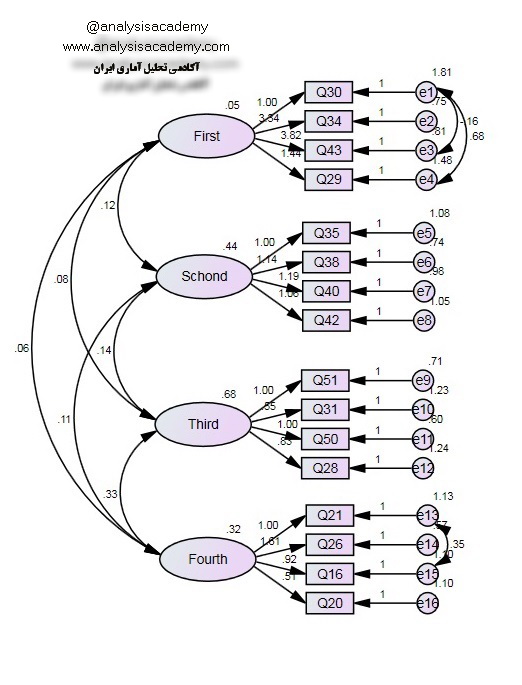
بار عاملی Factor Loading
قدرت رابطه بین عامل (متغیر پنهان) و متغیر قابل مشاهده بوسیله بار عاملی نشان داده میشود. بار عاملی مقداری بین صفر و یک است. اگر بار عاملی کمتر از 0.3 باشد رابطه ضعیف درنظر گرفته شده و از آن صرفنظر میشود. بارعاملی بین 0.3 تا 0.6 قابل قبول است و اگر بزرگتر از 0.6 باشد خیلی مطلوب است. (کلاین، 1994)
در تحلیل عاملی متغیرهائی که یک متغیر پنهان (عامل) را میسنجند، باید با آن عامل، بار عاملی بالا و با سایر عاملها، بار عاملی پائین داشته باشند. جهت بررسی معنادار بودن رابطه بین متغیرها از آماره آزمون t یا همان t-value استفاده میشود. چون معناداری در سطح خطای 0.05 بررسی میشود بنابراین اگر میزان بارهای عاملی مشاهده شده با آزمون t-value از 1.96 کوچکتر محاسبه شود، رابطه معنادار نیست .
@analysisacademy
بار عاملی Factor Loading
قدرت رابطه بین عامل (متغیر پنهان) و متغیر قابل مشاهده بوسیله بار عاملی نشان داده میشود. بار عاملی مقداری بین صفر و یک است. اگر بار عاملی کمتر از 0.3 باشد رابطه ضعیف درنظر گرفته شده و از آن صرفنظر میشود. بارعاملی بین 0.3 تا 0.6 قابل قبول است و اگر بزرگتر از 0.6 باشد خیلی مطلوب است. (کلاین، 1994)
در تحلیل عاملی متغیرهائی که یک متغیر پنهان (عامل) را میسنجند، باید با آن عامل، بار عاملی بالا و با سایر عاملها، بار عاملی پائین داشته باشند. جهت بررسی معنادار بودن رابطه بین متغیرها از آماره آزمون t یا همان t-value استفاده میشود. چون معناداری در سطح خطای 0.05 بررسی میشود بنابراین اگر میزان بارهای عاملی مشاهده شده با آزمون t-value از 1.96 کوچکتر محاسبه شود، رابطه معنادار نیست .
http://analysisacademy.com/wp-content/uploads/2016/11/focusgroup2.jpg
@analysisacademy
گروه کانونی
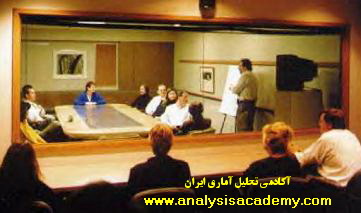
گروه كانوني، يكي از تكنيكهاي مصاحبه كيفي است كه براي ايجاد تعامل بين اعضاي گروه طراحي شده است تا انگيزه براي بحث عميق تر را فراهم نموده و جنبه هاي مختلف و جديد موضوع مورد بحث را آشكار نمايد. يكي از ويژگيهاي مصاحبههاي گروه كانوني، تعامل ميان اعضاي گروه (مصاحبه شوندگان) است كه تمايل به تفكر و تبادل نگرشها و ايدهها را برمي انگيزد؛ در حالي كه ممكن است به راحتي در طول جلسات مصاحبه مستقيم انفرادي ظهور نيابد (کیتزینگر و باربور، 1999). بايد دانست تشكيل گروه كانوني، جلسهاي براي حل مشكل يا تصميم گيري نيست؛ بلكه تنها يك جلسه مصاحبه است .
یکی از روشهای گردآوری دادهها در طرحهای کیفی، گروههای کانونی است. گروههای کانونی، جلسات بحث سازماندهی شده هستند که گروهی از افراد که بتوان به نظر آنان به عنوان کانون بحث موضوعی متمرکز شد، انتخاب می شوند. سپس از طریق مصاحبه گروهی، این افراد نظرها و تجربههای خود را بازنمایی می کنند. آنها با گروههای اسمی، دلفی و طوفان ذهنی به شرح زیر متفاوتند. در این شیوه، پژوهشگران با اعضای یک سازمان به صورت فردی، مانند گروههای اسمی دیدار نمیکنند. گروههای کانونی بر خلاف گروههای دلفی، معمولا از کارشناسان آموزش دیده تشکیل نمیشوند. گروههای کانونی برای ایدههای نو (جلسات طوفان ذهنی) برگزار نمی شوند. گروههای کانونی بیشتر برای گردآوری اطلاعات از افراد غیرمتخصص طراحی می شوند.
گروههای کانونی بر دیگر روشهای پژوهش برتری دارند، زیرا هدف اصلی آنها کشف نگرشها، احساسات، باورها، تجربهها و واکنش افراد است که با روشهای دیگر مانند مشاهده، مصاحبه فردی و پرسشنامههای پیمایشی قابل درک نیست. گروههای کانونی نظرها و فرآیندهای هیجانی درون بافت گروهی را کشف و استنباط میکنند. پژوهشگر در گروههای کانونی قادر است که اطلاعات بیشتری را در زمان کوتاهتری در مقایسه با مصاحبههای فردی به دست آورد (مورگان و کروگر، 1993). از گروههای کانونی میتوان به صورت یک روش مستقل و یا به عنوان روشی برای تکمیل دیگر روشها، به ویژه برای تطبیق دادههای حاصل از روش های گوناگون و بررسی اعتبار داده ها استفاده کرد ( مورگان، 1988). در این پژوهش، از گروه های کانونی برای تائيد و نهايي كردن ليستهاي مرتبط با بررسي محيط داخلي و خارجي و راهبردها استفاده شده است.
تعریف :
1- تعریف کروگر ( Kruger ) از گروههای کانونی:
روشی برای تبادل افکار و مذاکره است که طبق یک برنامه ریزی دقیق طراحی می شود تا ادراکات و بینش مصاحبه شوندگان را در محیطی به دور از تهدید و فشار بسنجد.
2- تعریف مورگان (Morgan ):
گروههای کانونی شکلی از مصاحبه گروهی هستند اما تمیز و تشخیص بین این دو خیلی مهم است. بطوری که مصاحبه گروهی شامل مصاحبه همزمان تعدادی از افراد بوده و تمرکز اصلی بر پرسشها و پاسخ های مطرح شده بین محقق و مصاحبه شوندگان میباشد.
هدف از ایجاد گروه های کانونی:
تجزیه و تحلیل محصولات، خدمات یا فرآیندها به منظور بهبود آنها یا شناسایی، شفاف سازی، تشریح و اصلاح مساله.
سنجش و ارزیابی یک فرآیند برای تشخیص درست آن.
فراهم کردن اطلاعات واقعی به عنوان راهنمایی در تصمیم گیری، جایگزینی عقاید و نظرات و متمرکز بر دادههای موجود.
ایجاد پایهای از دانش مشترک در خصوص یک مساله یا موضوع، مصرف کنندگان و سایر گروههای هدف در ارتباط با تنوع گستردهای از موضوعات و مسائل مختلف.
انعکاس دانش و آگاهی به دست آمده از گروهی به گروه دیگر.
روش اجرای گروههای کانونی:
انتخاب شرکتکنندگان گروههای کانونی، بیشتر بر نمونهگیری هدفدار تکیه دارند (میلز و هابرمن، 1984). پژوهشگر، شرکتکنندگان را بر پایه طرح پژوهش و توانایی همکاری آنان با آن انتخاب میکند.
تعداد افراد گروههای کانونی:
پژوهشگران درباره تعداد شرکتکنندگان در گروه های کانونی اتفاق نظر ندارند. عدهای معتقدند گروه باید بین 4-12 نفر در صورت متجانس بودن و بین 6-12 نفر برای گروههای نامتجانس باشد (براون، 1999). تعیین تشکیل تعداد گروههای کانونی مورد نیاز برای یک بررسی، مشکلتر از انتخاب تعداد افراد شرکت کننده در هر گروه است، و هیچ کس خارج از گروه پژوهش نمیتواند در این مورد تصمیم بگیرد. شاید بهترین روش، اجرای متوالی گروههای کانونی است، تا زمانی که موضوعهای عنوان شده به وسیله شرکتکنندگان در گروه تکراری نباشند و اطلاعات جدید بیشتری حاصل نشود.
@analysisacademy
گروه کانونی
گروه كانوني، يكي از تكنيكهاي مصاحبه كيفي است كه براي ايجاد تعامل بين اعضاي گروه طراحي شده است تا انگيزه براي بحث عميق تر را فراهم نموده و جنبه هاي مختلف و جديد موضوع مورد بحث را آشكار نمايد. يكي از ويژگيهاي مصاحبههاي گروه كانوني، تعامل ميان اعضاي گروه (مصاحبه شوندگان) است كه تمايل به تفكر و تبادل نگرشها و ايدهها را برمي انگيزد؛ در حالي كه ممكن است به راحتي در طول جلسات مصاحبه مستقيم انفرادي ظهور نيابد (کیتزینگر و باربور، 1999). بايد دانست تشكيل گروه كانوني، جلسهاي براي حل مشكل يا تصميم گيري نيست؛ بلكه تنها يك جلسه مصاحبه است .
یکی از روشهای گردآوری دادهها در طرحهای کیفی، گروههای کانونی است. گروههای کانونی، جلسات بحث سازماندهی شده هستند که گروهی از افراد که بتوان به نظر آنان به عنوان کانون بحث موضوعی متمرکز شد، انتخاب می شوند. سپس از طریق مصاحبه گروهی، این افراد نظرها و تجربههای خود را بازنمایی می کنند. آنها با گروههای اسمی، دلفی و طوفان ذهنی به شرح زیر متفاوتند. در این شیوه، پژوهشگران با اعضای یک سازمان به صورت فردی، مانند گروههای اسمی دیدار نمیکنند. گروههای کانونی بر خلاف گروههای دلفی، معمولا از کارشناسان آموزش دیده تشکیل نمیشوند. گروههای کانونی برای ایدههای نو (جلسات طوفان ذهنی) برگزار نمی شوند. گروههای کانونی بیشتر برای گردآوری اطلاعات از افراد غیرمتخصص طراحی می شوند.
گروههای کانونی بر دیگر روشهای پژوهش برتری دارند، زیرا هدف اصلی آنها کشف نگرشها، احساسات، باورها، تجربهها و واکنش افراد است که با روشهای دیگر مانند مشاهده، مصاحبه فردی و پرسشنامههای پیمایشی قابل درک نیست. گروههای کانونی نظرها و فرآیندهای هیجانی درون بافت گروهی را کشف و استنباط میکنند. پژوهشگر در گروههای کانونی قادر است که اطلاعات بیشتری را در زمان کوتاهتری در مقایسه با مصاحبههای فردی به دست آورد (مورگان و کروگر، 1993). از گروههای کانونی میتوان به صورت یک روش مستقل و یا به عنوان روشی برای تکمیل دیگر روشها، به ویژه برای تطبیق دادههای حاصل از روش های گوناگون و بررسی اعتبار داده ها استفاده کرد ( مورگان، 1988). در این پژوهش، از گروه های کانونی برای تائيد و نهايي كردن ليستهاي مرتبط با بررسي محيط داخلي و خارجي و راهبردها استفاده شده است.
تعریف :
1- تعریف کروگر ( Kruger ) از گروههای کانونی:
روشی برای تبادل افکار و مذاکره است که طبق یک برنامه ریزی دقیق طراحی می شود تا ادراکات و بینش مصاحبه شوندگان را در محیطی به دور از تهدید و فشار بسنجد.
2- تعریف مورگان (Morgan ):
گروههای کانونی شکلی از مصاحبه گروهی هستند اما تمیز و تشخیص بین این دو خیلی مهم است. بطوری که مصاحبه گروهی شامل مصاحبه همزمان تعدادی از افراد بوده و تمرکز اصلی بر پرسشها و پاسخ های مطرح شده بین محقق و مصاحبه شوندگان میباشد.
هدف از ایجاد گروه های کانونی:
تجزیه و تحلیل محصولات، خدمات یا فرآیندها به منظور بهبود آنها یا شناسایی، شفاف سازی، تشریح و اصلاح مساله.
سنجش و ارزیابی یک فرآیند برای تشخیص درست آن.
فراهم کردن اطلاعات واقعی به عنوان راهنمایی در تصمیم گیری، جایگزینی عقاید و نظرات و متمرکز بر دادههای موجود.
ایجاد پایهای از دانش مشترک در خصوص یک مساله یا موضوع، مصرف کنندگان و سایر گروههای هدف در ارتباط با تنوع گستردهای از موضوعات و مسائل مختلف.
انعکاس دانش و آگاهی به دست آمده از گروهی به گروه دیگر.
روش اجرای گروههای کانونی:
انتخاب شرکتکنندگان گروههای کانونی، بیشتر بر نمونهگیری هدفدار تکیه دارند (میلز و هابرمن، 1984). پژوهشگر، شرکتکنندگان را بر پایه طرح پژوهش و توانایی همکاری آنان با آن انتخاب میکند.
تعداد افراد گروههای کانونی:
پژوهشگران درباره تعداد شرکتکنندگان در گروه های کانونی اتفاق نظر ندارند. عدهای معتقدند گروه باید بین 4-12 نفر در صورت متجانس بودن و بین 6-12 نفر برای گروههای نامتجانس باشد (براون، 1999). تعیین تشکیل تعداد گروههای کانونی مورد نیاز برای یک بررسی، مشکلتر از انتخاب تعداد افراد شرکت کننده در هر گروه است، و هیچ کس خارج از گروه پژوهش نمیتواند در این مورد تصمیم بگیرد. شاید بهترین روش، اجرای متوالی گروههای کانونی است، تا زمانی که موضوعهای عنوان شده به وسیله شرکتکنندگان در گروه تکراری نباشند و اطلاعات جدید بیشتری حاصل نشود.
نحوه اجرای گروههای کانونی:
اجرای يک گروه کانونی در سه مرحله انجام میشود (کروگر، 1988):
مرحله اول: مفهومسازی
در اين مرحله هدف از تشكيل گروه و علت اجرای گروه کانونی؛ نوع اطلاعات به لحاظ اهميت ويژه آنها؛ مرجع درخواستکننده اطلاعات ميشود.
مرحله دوم: مصاحبه
تهيه پرسشهای مربوطه؛ پرسشهای مورد نظر بايستی به صورت دقيق طراحی شوند؛ برای يک جلسه گروه کانونی تعداد 5 تا 6 پرسش کافی است ( بايستی تعداد سؤالات کمتر از 10 مورد باشد).
مرحله سوم: تجزيه و تحليل دادهها و تهيه گزارش ( کروگر، 1988):
در اين مرحله دادهها مورد بررسي و تجزيه و تحليل قرار ميگيرند، براي اين منظور پاسخهاي داده شده از روش تحليل محتوا دستهبندي شده و مورد استفاده قرار ميگيرند.
اجرای يک گروه کانونی در سه مرحله انجام میشود (کروگر، 1988):
مرحله اول: مفهومسازی
در اين مرحله هدف از تشكيل گروه و علت اجرای گروه کانونی؛ نوع اطلاعات به لحاظ اهميت ويژه آنها؛ مرجع درخواستکننده اطلاعات ميشود.
مرحله دوم: مصاحبه
تهيه پرسشهای مربوطه؛ پرسشهای مورد نظر بايستی به صورت دقيق طراحی شوند؛ برای يک جلسه گروه کانونی تعداد 5 تا 6 پرسش کافی است ( بايستی تعداد سؤالات کمتر از 10 مورد باشد).
مرحله سوم: تجزيه و تحليل دادهها و تهيه گزارش ( کروگر، 1988):
در اين مرحله دادهها مورد بررسي و تجزيه و تحليل قرار ميگيرند، براي اين منظور پاسخهاي داده شده از روش تحليل محتوا دستهبندي شده و مورد استفاده قرار ميگيرند.
http://analysisacademy.com/wp-content/uploads/2016/11/imagesthesis2-1.jpg
@analysisacademy
وضعیت پایان نامه نویسی در رشته مدیریت در ایران
بررسی گذرای چگونگی وضعیت تحقیقات مدیریت در ایران نشان می دهد دوران کمی گرایی در غرب متعادل شده است، همچنان اثرهای خود را بر شیوه پایان نامه نویسی در رشته مدیریت در کشور ما تداوم بخشیده است. آنچه امروز در فرآیند پایان نامه نویسی در دانشکده های ایران رخ می دهد شکل ناقصی از آن دوران است. علاوه بر انجماد روش شناختی که از ابتدای آغاز مدیریت در ایران اسیر آن بوده ایم بعد از جنگ هشت ساله مدیران دانش آموخته ای در رشته های فنی به دوره های عالی در رشته مدیریت رو آوردند و جریان کمی گرایی افراطی را در این رشته باز تولید کردند. آنها مدلهای پیچیده ریاضی را برای سازمان ها یی طراحی کردند که از ابتدایی ترین مسایل رنج می بردند. از سوی دیگر دیگر پاره ای دانشجویان باورهای مقبول جهانی که بارها آزموده شده اند مورد تردید قرار دادند و همچنان می دهند و هزاران پرسشنامه غیر معتبر توزیع می شود تا بهمیم نقش آموزش چیست یا آموزش بر بهره وری تاثیر دارد ؟ یا اینکه نقش فرهنگ سازمانی بر عملکرد چیست؟
حاصل آن شده است که امروز در کتابخانه دانشکده های مدیریت صدها پایان نامه مشاهده می شود که به مدل ریاضی ختم شده اند که معلوم نیست در کجا کاربرد یافته اند و به کار کجا می آیند؟ یا انواع نمودارهای حاصل از محاسبات با نرم افزار Spss ارایه شدهذ اند که معمولا نانی است که در تنور موسسات پایان نامه نویسی پخته شده است.
به نظر می رسد سنجش اثربخشی پایان نامه های مدیریتی در عرصه کسب و کار ایران خود موضوع چالش برانگیزی برای به صدا درآوردن زنگ خطر هدر رفتن فرصت ملی در این حوزه باشد.
@analysisacademy
وضعیت پایان نامه نویسی در رشته مدیریت در ایران
بررسی گذرای چگونگی وضعیت تحقیقات مدیریت در ایران نشان می دهد دوران کمی گرایی در غرب متعادل شده است، همچنان اثرهای خود را بر شیوه پایان نامه نویسی در رشته مدیریت در کشور ما تداوم بخشیده است. آنچه امروز در فرآیند پایان نامه نویسی در دانشکده های ایران رخ می دهد شکل ناقصی از آن دوران است. علاوه بر انجماد روش شناختی که از ابتدای آغاز مدیریت در ایران اسیر آن بوده ایم بعد از جنگ هشت ساله مدیران دانش آموخته ای در رشته های فنی به دوره های عالی در رشته مدیریت رو آوردند و جریان کمی گرایی افراطی را در این رشته باز تولید کردند. آنها مدلهای پیچیده ریاضی را برای سازمان ها یی طراحی کردند که از ابتدایی ترین مسایل رنج می بردند. از سوی دیگر دیگر پاره ای دانشجویان باورهای مقبول جهانی که بارها آزموده شده اند مورد تردید قرار دادند و همچنان می دهند و هزاران پرسشنامه غیر معتبر توزیع می شود تا بهمیم نقش آموزش چیست یا آموزش بر بهره وری تاثیر دارد ؟ یا اینکه نقش فرهنگ سازمانی بر عملکرد چیست؟
حاصل آن شده است که امروز در کتابخانه دانشکده های مدیریت صدها پایان نامه مشاهده می شود که به مدل ریاضی ختم شده اند که معلوم نیست در کجا کاربرد یافته اند و به کار کجا می آیند؟ یا انواع نمودارهای حاصل از محاسبات با نرم افزار Spss ارایه شدهذ اند که معمولا نانی است که در تنور موسسات پایان نامه نویسی پخته شده است.
به نظر می رسد سنجش اثربخشی پایان نامه های مدیریتی در عرصه کسب و کار ایران خود موضوع چالش برانگیزی برای به صدا درآوردن زنگ خطر هدر رفتن فرصت ملی در این حوزه باشد.

http://analysisacademy.com/wp-content/uploads/2016/11/images1.jpg
@analysisacademy
نکته هایی برای تهیه طرح تحقیق:
1-موضوعی را آگاهانه انتخاب کنید.
2-در حوزه موضوع مطالعه کنید.
3-مساله ای را در حوزه موضوع در یک سازمان(دولتی،عمومی، خصوصی) شناسایی کنید.
به تفاوت زیر میان مساله و پرسش توجه کنید:
الف)معمولا پرسش دغدغه ای ذهنی است که باید برای آن پاسخ یافت. این پرسش می تواند درباره یک موضوع سازمانی یا غیرسازمانی باشد .
ب)مساله یک کنجکاوی فقط ذهنی نیست بلکه مانعی است که بر سر راه هدف موردنظر وجود دارد.
ج)گاهی مساله فاصله ای است میان آنچه در شرایط فعلی وجود دارد یا آنچه تمایل داریم وجود داشته باشد.
4-پرسش یا مساله را به تایید استاد برسانید.
5-بقیه مراحل تکمیل فرم ها را به راهنمایی استاد انجام دهید.
6-برای توسعه دانش مدیریت توصیه می شود که در به کارگیری روش های نو در تحقیق همت کنید.
7-اگر دارای تجربه سازمانی هستید هستید سعی کنید از روش موردپژوهی بهره بگیرید.
@analysisacademy
نکته هایی برای تهیه طرح تحقیق:
1-موضوعی را آگاهانه انتخاب کنید.
2-در حوزه موضوع مطالعه کنید.
3-مساله ای را در حوزه موضوع در یک سازمان(دولتی،عمومی، خصوصی) شناسایی کنید.
به تفاوت زیر میان مساله و پرسش توجه کنید:
الف)معمولا پرسش دغدغه ای ذهنی است که باید برای آن پاسخ یافت. این پرسش می تواند درباره یک موضوع سازمانی یا غیرسازمانی باشد .
ب)مساله یک کنجکاوی فقط ذهنی نیست بلکه مانعی است که بر سر راه هدف موردنظر وجود دارد.
ج)گاهی مساله فاصله ای است میان آنچه در شرایط فعلی وجود دارد یا آنچه تمایل داریم وجود داشته باشد.
4-پرسش یا مساله را به تایید استاد برسانید.
5-بقیه مراحل تکمیل فرم ها را به راهنمایی استاد انجام دهید.
6-برای توسعه دانش مدیریت توصیه می شود که در به کارگیری روش های نو در تحقیق همت کنید.
7-اگر دارای تجربه سازمانی هستید هستید سعی کنید از روش موردپژوهی بهره بگیرید.

http://analysisacademy.com/wp-content/uploads/2016/11/writing-a-literature-review-4-6382.jpg
@analysisacademy
هدف های پیشینه یابی و پیشینه کاوی موضوع
جستجو برای اینکه بفهمیم دیگران درباره موضوع موردنظر چه گفنه اند(پیشینه نظری) و برای حل مساله چه کرده اند(پیشینه عملی)، پژوهشگر را کمک میکند تا هدف های زیر تحقق یابند:
1-برقراری ارتباط منطقی میان دستاوردهای پژوهش های قبلی با مساله پژوهش
پژوهش های گوناگون که در یک حوزه خاص انجام می گیرند ممکن است در برداشت نخست غیرمرتبط به نظر رسند اما باید با یک جمع بندی موثر بین آنها رابطه برقرارکرد.
2-دستیابی به چارچوب نظری
با بررسی نظریه ها و مدلهای اجرایی پژوهشگر قادر خواهد بود که چارچوب نظری را از میان نظریه های دیگران انتخاب کند یا خود مبانی جدیدی را طراحی کند.
3-شناسایی روش های پژوهش مورد استفاده در پژوهش های گذشته
پژوهشگر در بررسی پژوهش ها و گزارش های عملی حل مساله با روش های گوناگون به کار رفته آشنا می شود و درمی یابد چه روش هایی در حل مساله کارآمد یا ناکارآمد بوده اند.
4-تعیین درجه اهمیت متغییرهای موثر در مساله
رابطه متغییرهای مهم که از چارچوب نظری استخراج می شوند برای فرضیه سازی، اطلاعاتی را ارائه می کنند. هر مساله که در سازمان رخ می دهد تعداد زیادی متغییر در آن تاثیر دارند که هر یک نسبت و ارتباط خاصی با مساله پژوهش دارند که می توان اهمیت و درجه متغییرهای آنها را با توجه به هدف پژوهش بر روی یک پیوستار نشان داد. اطلاعاتی که در بررسی پیشینه پژوهش فراهم می آید می تواند در این طبقه بندی مفید باشد و بر توسعه و تکامل چارچوب نظری اثر بگذارد و آزمون پذیری فرضیه ها را امکان پذیر کند.
5-پیدا کردن حوزه های نظری جدید در ارتباط با مساله
در جریان بررسی پیشینه پژوهشگر نباید تنها به دنبال آن باشد که چه کارهایی انجام شده است بلکه باید از مسایل پژوهشی نادیده گرفته شده نیز آگاه شود. معمولا موضوع هایی یافت می شوند که پژوهش هایی کمتر درباره آنها انجام شده است و یک پژوهشگر در جریان پیشینه یابی ممکن است به برداشتی خلاق درباره آنها دست یابد که ارزیابی دوباره مساله را ضروری سازد.
6-پرهیز از به کارگیری روش های بیهوده
7-آگاهی از روش شناسی در حوزه موضوع و مساله
8-پرهیز از تکرار پژوهش های انجام شده
9-افزایش آگاهی نسبت به اهمیت مساله انتخاب شده
@analysisacademy
هدف های پیشینه یابی و پیشینه کاوی موضوع
جستجو برای اینکه بفهمیم دیگران درباره موضوع موردنظر چه گفنه اند(پیشینه نظری) و برای حل مساله چه کرده اند(پیشینه عملی)، پژوهشگر را کمک میکند تا هدف های زیر تحقق یابند:
1-برقراری ارتباط منطقی میان دستاوردهای پژوهش های قبلی با مساله پژوهش
پژوهش های گوناگون که در یک حوزه خاص انجام می گیرند ممکن است در برداشت نخست غیرمرتبط به نظر رسند اما باید با یک جمع بندی موثر بین آنها رابطه برقرارکرد.
2-دستیابی به چارچوب نظری
با بررسی نظریه ها و مدلهای اجرایی پژوهشگر قادر خواهد بود که چارچوب نظری را از میان نظریه های دیگران انتخاب کند یا خود مبانی جدیدی را طراحی کند.
3-شناسایی روش های پژوهش مورد استفاده در پژوهش های گذشته
پژوهشگر در بررسی پژوهش ها و گزارش های عملی حل مساله با روش های گوناگون به کار رفته آشنا می شود و درمی یابد چه روش هایی در حل مساله کارآمد یا ناکارآمد بوده اند.
4-تعیین درجه اهمیت متغییرهای موثر در مساله
رابطه متغییرهای مهم که از چارچوب نظری استخراج می شوند برای فرضیه سازی، اطلاعاتی را ارائه می کنند. هر مساله که در سازمان رخ می دهد تعداد زیادی متغییر در آن تاثیر دارند که هر یک نسبت و ارتباط خاصی با مساله پژوهش دارند که می توان اهمیت و درجه متغییرهای آنها را با توجه به هدف پژوهش بر روی یک پیوستار نشان داد. اطلاعاتی که در بررسی پیشینه پژوهش فراهم می آید می تواند در این طبقه بندی مفید باشد و بر توسعه و تکامل چارچوب نظری اثر بگذارد و آزمون پذیری فرضیه ها را امکان پذیر کند.
5-پیدا کردن حوزه های نظری جدید در ارتباط با مساله
در جریان بررسی پیشینه پژوهشگر نباید تنها به دنبال آن باشد که چه کارهایی انجام شده است بلکه باید از مسایل پژوهشی نادیده گرفته شده نیز آگاه شود. معمولا موضوع هایی یافت می شوند که پژوهش هایی کمتر درباره آنها انجام شده است و یک پژوهشگر در جریان پیشینه یابی ممکن است به برداشتی خلاق درباره آنها دست یابد که ارزیابی دوباره مساله را ضروری سازد.
6-پرهیز از به کارگیری روش های بیهوده
7-آگاهی از روش شناسی در حوزه موضوع و مساله
8-پرهیز از تکرار پژوهش های انجام شده
9-افزایش آگاهی نسبت به اهمیت مساله انتخاب شده

http://analysisacademy.com/wp-content/uploads/2016/11/zarurat.jpg
@analysisacademy
نکته هایی در مورد اهمیت و ضرورت موضوع تحقیق
با وجود اینکه پژوهشگر اهمیت تحقیق خود را با نوع مساله ای که انتخاب کرده است بیان می دارد، اما باید مشخص کند پرداختن به این تحقیق در چه زمینه ای از اهمیت بیشتری برخوردار است و چه دستاوردهایی را در پی دارد به اهمیت و ضرورت تحقیق از دو دیدگاه می توان توجه کرد:
1-اهمیت و ضرورت تحقیق از دیدگاه جایگاه و ارزش علمی مساله آن
بحث درباره اهمیت موضوع تحقیق از نظر علمی با بررسی پیشینه علمی-عملی مربوط پدیدار می گردد. پژوهشگر باید بتواند با توجه به نظریه های موجود اهمیت تحقیق خود را نشان دهد. او برای این کار باید نشان دهد که تحقیق اش از دیدگاهی جدید به مساله نگاه می کند. اغلب پژوهشگران در مطالعات خود متوجه جای خالی نظریه های علمی می شوند که با تحقیق می توان این کمبود را جبران کرد. اگر تحقیق در زمینه ای است که تئوری های آن سیر تکاملی خود را پیموده است در آن صورت می توان آزمون تئوری یا بهبود و گسترش آن باشد. امکان دارد گاهی پژوهشگر از نظریه هایی استفاده کند که دیگران به کار برده اند و پرسشهای خود را همانند پرسشهای تحقیقات پیشین تنظیم نماید، ولی داده ها از گروههای متفاوت جامعه دیگری و در زمان دیگری جمع آوری شود از این رو نتیجه های حاصل از تحقیق می تواند موجب گسترش تئوری های پیشین گردد یا اینکه امکان دارد موضوع را به شیوه ای جدید و ظریفتر از نظریه های موجود بیان کرد.
2-اهمیت و ضرورت تحقیق از نظر مدیران اجرایی و ضرورتهای سازمانی
ارزش اجرایی موضوع و مساله تحقیق را می توان با ارایه خلاصه ای از نوشته های خبرگان آگاه، که موضوع را مهم می دانند و خواستار تحقیق بر روی این مسایل هستند به اثبات رسانید. ارایه آمارها از رویدادهای سازمانی می تواند بیانگر اهمیت تحقیق باشد.
@analysisacademy
نکته هایی در مورد اهمیت و ضرورت موضوع تحقیق
با وجود اینکه پژوهشگر اهمیت تحقیق خود را با نوع مساله ای که انتخاب کرده است بیان می دارد، اما باید مشخص کند پرداختن به این تحقیق در چه زمینه ای از اهمیت بیشتری برخوردار است و چه دستاوردهایی را در پی دارد به اهمیت و ضرورت تحقیق از دو دیدگاه می توان توجه کرد:
1-اهمیت و ضرورت تحقیق از دیدگاه جایگاه و ارزش علمی مساله آن
بحث درباره اهمیت موضوع تحقیق از نظر علمی با بررسی پیشینه علمی-عملی مربوط پدیدار می گردد. پژوهشگر باید بتواند با توجه به نظریه های موجود اهمیت تحقیق خود را نشان دهد. او برای این کار باید نشان دهد که تحقیق اش از دیدگاهی جدید به مساله نگاه می کند. اغلب پژوهشگران در مطالعات خود متوجه جای خالی نظریه های علمی می شوند که با تحقیق می توان این کمبود را جبران کرد. اگر تحقیق در زمینه ای است که تئوری های آن سیر تکاملی خود را پیموده است در آن صورت می توان آزمون تئوری یا بهبود و گسترش آن باشد. امکان دارد گاهی پژوهشگر از نظریه هایی استفاده کند که دیگران به کار برده اند و پرسشهای خود را همانند پرسشهای تحقیقات پیشین تنظیم نماید، ولی داده ها از گروههای متفاوت جامعه دیگری و در زمان دیگری جمع آوری شود از این رو نتیجه های حاصل از تحقیق می تواند موجب گسترش تئوری های پیشین گردد یا اینکه امکان دارد موضوع را به شیوه ای جدید و ظریفتر از نظریه های موجود بیان کرد.
2-اهمیت و ضرورت تحقیق از نظر مدیران اجرایی و ضرورتهای سازمانی
ارزش اجرایی موضوع و مساله تحقیق را می توان با ارایه خلاصه ای از نوشته های خبرگان آگاه، که موضوع را مهم می دانند و خواستار تحقیق بر روی این مسایل هستند به اثبات رسانید. ارایه آمارها از رویدادهای سازمانی می تواند بیانگر اهمیت تحقیق باشد.

☑️خبرهای مهم از فضای پژوهش ایران و جهان
@analysisacademy
به تاریخ 11 آبان، 1 نوامبر 2016 ناشر مجلات نیچر 58 مقاله دانشمندان ایرانی را بخاطر جعل علمی و دستکاری توسط نویسندگان تعلیق کرد.
💡ناشر مجلات نیچر 58 مقاله دانشمندان ایرانی را بخاطر دستکاری توسط نویسندگان تعلیق کرد.
گزینش این مقالات در ادامه ی موارد کشف شده ی مشابه در سال 2015 می باشد.
به گزارش سرویس خبری آزمایشگاه پارس سیلیکو ، قسمتی از این 58 مقاله که توسط 282 پژوهشگر ایرانی نوشته شده اند، امروز توسط یک ناشر علمی پیشرو جمع آوری شدند. گفته می شود نشانه هایی یافت شده اند دال بر اینکه در روندهای ارزیابی علمی و انتشار آنها تبانی صورت گرفته است.
موسسه ی BioMed Central (BMC تعداد 28 مقاله را جمع آوری کرده و 40 مورد دیگر را نیز مورد بررسی قرار داده است. در همین حال موسسه ی Springer نیز 30 مقاله را تعلیق و 9 مورد دیگر را نیز مورد بررسی قرار داده است. هر دوی این سازمانها تحت مدیریت Springer Nature هستند که ناشر مجلات Nature است.
این اقدامات در پی یک تحقیق و توسط یک افشاگر انجام شده که به شواهدی دال بر سرقت ادبی، دستکاری در نام نویسندگان و نیز دستکاری درفرایند ارزیابی علمی دست یافته است که به هدف فریب سیستم ارزیابی علمی و انتشار و اختصاص غیرقانونی نویسندگی مقاله صورت گرفته است.
تمام مقالاتی که توسط Springer جمع آوری شده اند، دارای دستکاری هایی در نام نویسندگان و در فرایند داوری و ارزیابی علمی بودند و 70 درصد آنها نیز نشانی از سرقت ادبی و علمی را در خود داشتند. در مورد مقالات BMC نیز تمام موارد دارای دستکاری در نویسندگی بودند، 57 درصد آنها دارای شواهدی در مورد دستکاری در فرایند داوری و ارزیابی علمی و 93 درصد نیز دارای سرقت ادبی و علمی بودند.
سال پیش نیز Springer 64 مقاله را بعلت نگرانی هایی در مورد "ارزیابی علمی تقلبی" جمع آوری کرد که در آنها گزارشهای داوری و ارزیابی علمی از طریق ایمیل های جعلی منتسب به نام دانشمندان واقعی ثبت شده بودند. در همان سال موسسه ی BMC نیز 43 مورد دیگر را به دلایل مشابهی تعلیق و لغو کرد. چندین ناشر عمده ی دیگر نیز کشفیات مشایهی از ارزیابی های علمی جعلی را گزارش کرده بودند.
این دو سازمان می گویند که آنها در پی این رخدادها به مبارزه با ارزیابی علمی جعلی اقدام کرده اند و موسسه ی BMC در همین راستا به فرایند پیشنهاد دادن داوران و ارزیابی کنندگان مقاله توسط خود نویسندگان به طور مستقیم پایان داده است. حالا این پیشنهادات عموما از طریق یک نامه ی ضمیمه ارایه می شود که در آن سندیت و اعتبار داور و ارزیابی کننده محرز شده باشد. همچنین این موسسه شرایط سختگیرانه تری را برای تغییر نام نویسنده در طول فرایند انتشار وضع کرده
نویسندگان این مقالات از این موضوع آگاه شده اند و بعضی نیز پاسخهایی داده اند. جمع آوری و تعلیق ها در سه نشریه ی اسپرینگر رخ داده است، یکی در Comparative Clinical Pathology، چهار تا در Journal of Parasitic Diseases و 25 مورد نیز در Tumour Biology
در موسسه ی BMC نیز 4 نشریه درگیر هستند.
23 مقاله در Diagnostic Pathology،
و دو تا دحرفهاتر Cancer Cell International و Journal of Ovarian Research
و یکی در World Journal of Surgical
@analysisacademy
منبع ازمایشگاه پارس سیلیکو
@analysisacademy
به تاریخ 11 آبان، 1 نوامبر 2016 ناشر مجلات نیچر 58 مقاله دانشمندان ایرانی را بخاطر جعل علمی و دستکاری توسط نویسندگان تعلیق کرد.
💡ناشر مجلات نیچر 58 مقاله دانشمندان ایرانی را بخاطر دستکاری توسط نویسندگان تعلیق کرد.
گزینش این مقالات در ادامه ی موارد کشف شده ی مشابه در سال 2015 می باشد.
به گزارش سرویس خبری آزمایشگاه پارس سیلیکو ، قسمتی از این 58 مقاله که توسط 282 پژوهشگر ایرانی نوشته شده اند، امروز توسط یک ناشر علمی پیشرو جمع آوری شدند. گفته می شود نشانه هایی یافت شده اند دال بر اینکه در روندهای ارزیابی علمی و انتشار آنها تبانی صورت گرفته است.
موسسه ی BioMed Central (BMC تعداد 28 مقاله را جمع آوری کرده و 40 مورد دیگر را نیز مورد بررسی قرار داده است. در همین حال موسسه ی Springer نیز 30 مقاله را تعلیق و 9 مورد دیگر را نیز مورد بررسی قرار داده است. هر دوی این سازمانها تحت مدیریت Springer Nature هستند که ناشر مجلات Nature است.
این اقدامات در پی یک تحقیق و توسط یک افشاگر انجام شده که به شواهدی دال بر سرقت ادبی، دستکاری در نام نویسندگان و نیز دستکاری درفرایند ارزیابی علمی دست یافته است که به هدف فریب سیستم ارزیابی علمی و انتشار و اختصاص غیرقانونی نویسندگی مقاله صورت گرفته است.
تمام مقالاتی که توسط Springer جمع آوری شده اند، دارای دستکاری هایی در نام نویسندگان و در فرایند داوری و ارزیابی علمی بودند و 70 درصد آنها نیز نشانی از سرقت ادبی و علمی را در خود داشتند. در مورد مقالات BMC نیز تمام موارد دارای دستکاری در نویسندگی بودند، 57 درصد آنها دارای شواهدی در مورد دستکاری در فرایند داوری و ارزیابی علمی و 93 درصد نیز دارای سرقت ادبی و علمی بودند.
سال پیش نیز Springer 64 مقاله را بعلت نگرانی هایی در مورد "ارزیابی علمی تقلبی" جمع آوری کرد که در آنها گزارشهای داوری و ارزیابی علمی از طریق ایمیل های جعلی منتسب به نام دانشمندان واقعی ثبت شده بودند. در همان سال موسسه ی BMC نیز 43 مورد دیگر را به دلایل مشابهی تعلیق و لغو کرد. چندین ناشر عمده ی دیگر نیز کشفیات مشایهی از ارزیابی های علمی جعلی را گزارش کرده بودند.
این دو سازمان می گویند که آنها در پی این رخدادها به مبارزه با ارزیابی علمی جعلی اقدام کرده اند و موسسه ی BMC در همین راستا به فرایند پیشنهاد دادن داوران و ارزیابی کنندگان مقاله توسط خود نویسندگان به طور مستقیم پایان داده است. حالا این پیشنهادات عموما از طریق یک نامه ی ضمیمه ارایه می شود که در آن سندیت و اعتبار داور و ارزیابی کننده محرز شده باشد. همچنین این موسسه شرایط سختگیرانه تری را برای تغییر نام نویسنده در طول فرایند انتشار وضع کرده
نویسندگان این مقالات از این موضوع آگاه شده اند و بعضی نیز پاسخهایی داده اند. جمع آوری و تعلیق ها در سه نشریه ی اسپرینگر رخ داده است، یکی در Comparative Clinical Pathology، چهار تا در Journal of Parasitic Diseases و 25 مورد نیز در Tumour Biology
در موسسه ی BMC نیز 4 نشریه درگیر هستند.
23 مقاله در Diagnostic Pathology،
و دو تا دحرفهاتر Cancer Cell International و Journal of Ovarian Research
و یکی در World Journal of Surgical
@analysisacademy
منبع ازمایشگاه پارس سیلیکو
http://analysisacademy.com/wp-content/uploads/2016/11/Figure-27-Analytical-steps-in-Grounded-Theory-according-to-Chesler.png
@analysisacademy
کاربرد داده ها در پژوهش گرانددی
داده ها میتوانند به عنوان ادبیات فنی Technical Literature و غیر فنی Non – Technical Literature مورد استفاده قرار گیرند. ادبیات فنی به گزارش مطالعات پژوهشی و مقاله های نظری و تحلیلی مرتبط با نوشته های حرفه ای گفته میشود. ادبیات غیر فنی نیز بیوگرافیها، یادداشتهای روزانه، اسناد، خاطرات، دست نوشته ها، بایگانی ها، گزارشها و کاتالوگها است که میتوانند به عنوان داده های اولیه یا مکمل مصاحبه ها و مشاهده های میدانی به کار روند.
این دو نوع اسناد را میتوان در موردهای زیر برای نظریه سازی با روش گرانددی به کار برد:
1. ایجاد حساسیت نظری در پژوهشگر برای درک بهتر موضوع مطالعه، (در نظر گرفتن زاویه های متفاوت موضوع و کمک به طرح سؤالها و مسائل مهم(.
2.ارایه ایده های سازنده در زمینه ساخت مفاهیم و مقوله ها و رابطه علّی بین آنها.
3.پالایش مدل نظری.
4.توضیح و تشریح بهتر نظریه و کمک در تنظیم خط داستان
5.کمک به درک جامع از کل فرآیند تحقیق.
6. معرفی میدان مطالعه یا بستر پدیده مورد بررسی
@analysisacademy
کاربرد داده ها در پژوهش گرانددی
داده ها میتوانند به عنوان ادبیات فنی Technical Literature و غیر فنی Non – Technical Literature مورد استفاده قرار گیرند. ادبیات فنی به گزارش مطالعات پژوهشی و مقاله های نظری و تحلیلی مرتبط با نوشته های حرفه ای گفته میشود. ادبیات غیر فنی نیز بیوگرافیها، یادداشتهای روزانه، اسناد، خاطرات، دست نوشته ها، بایگانی ها، گزارشها و کاتالوگها است که میتوانند به عنوان داده های اولیه یا مکمل مصاحبه ها و مشاهده های میدانی به کار روند.
این دو نوع اسناد را میتوان در موردهای زیر برای نظریه سازی با روش گرانددی به کار برد:
1. ایجاد حساسیت نظری در پژوهشگر برای درک بهتر موضوع مطالعه، (در نظر گرفتن زاویه های متفاوت موضوع و کمک به طرح سؤالها و مسائل مهم(.
2.ارایه ایده های سازنده در زمینه ساخت مفاهیم و مقوله ها و رابطه علّی بین آنها.
3.پالایش مدل نظری.
4.توضیح و تشریح بهتر نظریه و کمک در تنظیم خط داستان
5.کمک به درک جامع از کل فرآیند تحقیق.
6. معرفی میدان مطالعه یا بستر پدیده مورد بررسی

http://analysisacademy.com/wp-content/uploads/2016/11/grounded-theory-introduction-.jpg
@analysisacademy
شیوه های تحلیل داده در پژوهش گرانددی
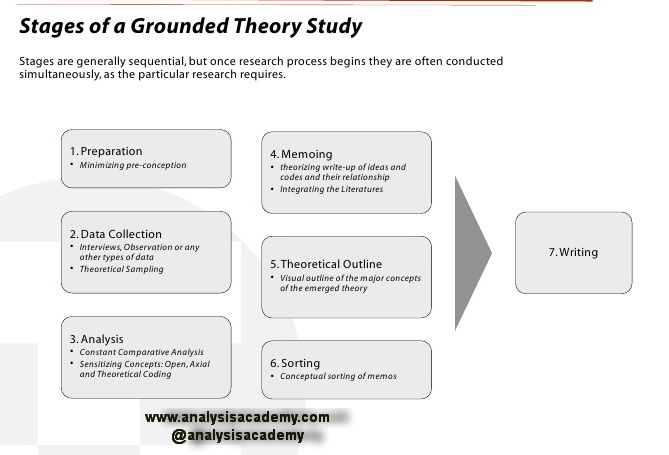
پژوهشگر در فرآیند ساخت نظریه گرانددی، در هنگام انجام پژوهش به جای یک یا چند سؤال پژوهشی خاص و از پیش طراحی شده، سؤالهای تحقیق را در فرآیند گردآوری و تحلیل داده ها طراحی کرده و سپس مسیر گردآوری داده های بعدی را بر اساس آنچه حساسیت نظری میخوانند و مشخص میسازد. این فرآیند را به اصطلاح "نمونه گیری نظری" میگویند.
تحلیل داده ها فرآیندی است که در آن پژوهشگر، داده هایی را که گردآوری می کند بلافاصله مورد تحلیل قرار میدهد، نه اینکه مانند پژوهشهای کمی صبر کند تا تمام داده ها گردآوری شود و بر مبنای تحلیل آنها تصمیم گیری کند که چه داده های دیگری گردآوری کند. پژوهشگر ابتدا به گردآوری داده ها میپردازد برای مثال داده های گردآوری شده در انجام اولین مصاحبه( این داده ها را تحلیل میکند تا به اولین مقوله ها پی برد سپس به جستجوی سرنخهایی برای گردآوری بیشتر دادهها میپردازد. این رگه ها میتواند مقوله های ناپخته یا اطلاعاتی باشد که کمبود آنها در فرایند تحقیق احساس میشود یا فرد جدیدی که میتواند اطلاعات تازه ای را به جریان تحقیق اضافه کند، پس از آن پژوهشگر دوباره به عملیات میدانی میپردازد تا اطلاعات اضافی را گردآوری کند. در این اقدام سعی او بر آن است که در راستای بهبود بخشیدن و پردازش و آشکارتر کردن معانی مقوله ها به منظور نظریه پردازی عمل کند. این فرایند برای گردآوری و تحلیل داده ها به صورت رفت و برگشت انجام میشود و ادامه مییابد تا اینکه پژوهشگر به اشباع یک مقوله برسد. منظور از اشباع در پژوهش گرانددی حالتی است که پژوهشگر در آن به این نتیجه میرسد که داده ها و اطلاعات جدید یا شناخت بیشتری نسبت به تدوین مقوله ها به دست نمیدهد.
@analysisacademy
شیوه های تحلیل داده در پژوهش گرانددی
پژوهشگر در فرآیند ساخت نظریه گرانددی، در هنگام انجام پژوهش به جای یک یا چند سؤال پژوهشی خاص و از پیش طراحی شده، سؤالهای تحقیق را در فرآیند گردآوری و تحلیل داده ها طراحی کرده و سپس مسیر گردآوری داده های بعدی را بر اساس آنچه حساسیت نظری میخوانند و مشخص میسازد. این فرآیند را به اصطلاح "نمونه گیری نظری" میگویند.
تحلیل داده ها فرآیندی است که در آن پژوهشگر، داده هایی را که گردآوری می کند بلافاصله مورد تحلیل قرار میدهد، نه اینکه مانند پژوهشهای کمی صبر کند تا تمام داده ها گردآوری شود و بر مبنای تحلیل آنها تصمیم گیری کند که چه داده های دیگری گردآوری کند. پژوهشگر ابتدا به گردآوری داده ها میپردازد برای مثال داده های گردآوری شده در انجام اولین مصاحبه( این داده ها را تحلیل میکند تا به اولین مقوله ها پی برد سپس به جستجوی سرنخهایی برای گردآوری بیشتر دادهها میپردازد. این رگه ها میتواند مقوله های ناپخته یا اطلاعاتی باشد که کمبود آنها در فرایند تحقیق احساس میشود یا فرد جدیدی که میتواند اطلاعات تازه ای را به جریان تحقیق اضافه کند، پس از آن پژوهشگر دوباره به عملیات میدانی میپردازد تا اطلاعات اضافی را گردآوری کند. در این اقدام سعی او بر آن است که در راستای بهبود بخشیدن و پردازش و آشکارتر کردن معانی مقوله ها به منظور نظریه پردازی عمل کند. این فرایند برای گردآوری و تحلیل داده ها به صورت رفت و برگشت انجام میشود و ادامه مییابد تا اینکه پژوهشگر به اشباع یک مقوله برسد. منظور از اشباع در پژوهش گرانددی حالتی است که پژوهشگر در آن به این نتیجه میرسد که داده ها و اطلاعات جدید یا شناخت بیشتری نسبت به تدوین مقوله ها به دست نمیدهد.
http://analysisacademy.com/wp-content/uploads/2016/11/apa-advanced-lr-59-638-1.jpg
@analysisacademy
DOI به چه معنا است؟
مخفف عبارت: digital object identifier است که این عدد نشان دهنده یک سند دیجیتالی است که به صورت آنلاین در اینترنت قرار گرفته است. معمولا مجلات معتبر قبل از چاپ رسمی مقاله در قالب جلد و شماره، مقاله را به صورت آنلاین بدون شماره جلد و شماره صفحه قرار می دهند. این کار برای دسترسی سریعتر سایر افراد به مقاله هایی است که هنوز موقع چاپ آنها نرسیده است. معمولا در این شرایط شماره DOI به مقاله داده می شود که می توان موقع رفرنس دادن به مقاله آنلاین آن را ذکر کرد. توجه کنید که این عدد مختص به یک مقاله خاص و غیر قابل تکرار است.
@analysisacademy
DOI به چه معنا است؟
مخفف عبارت: digital object identifier است که این عدد نشان دهنده یک سند دیجیتالی است که به صورت آنلاین در اینترنت قرار گرفته است. معمولا مجلات معتبر قبل از چاپ رسمی مقاله در قالب جلد و شماره، مقاله را به صورت آنلاین بدون شماره جلد و شماره صفحه قرار می دهند. این کار برای دسترسی سریعتر سایر افراد به مقاله هایی است که هنوز موقع چاپ آنها نرسیده است. معمولا در این شرایط شماره DOI به مقاله داده می شود که می توان موقع رفرنس دادن به مقاله آنلاین آن را ذکر کرد. توجه کنید که این عدد مختص به یک مقاله خاص و غیر قابل تکرار است.

http://analysisacademy.com/wp-content/uploads/2016/11/moderator.png
@analysisacademy
تعیین میزان اثرمتغییر تعدیلگر دو ارزشی در نرم افزار اسمارت پی ال اس
دانشجویان کارگاههای آکادمی تحلیل آماری ایران بعد از گذراندن دوره های نرم افزارهای ایموس(AMOS) و پی ال اس(Smart PLS) به خوبی با دو روش مرحله ای و interaction برای run کردن متغییرهای تعدیلگر در تحقیقاتشان آشنا شده اند یعنی متغییرهای دو بخشی را در ایموس(AMOS) و متغییرهایی که دارای سوال می باشند و اصطلاحا در کارگاهها متغییر کمی نامیده می شود را با نرم افزار اسمارت پی ال اس (Smart PLS) مورد تجزیه و تحلیل قرار دادند . همواره بسیاری از دانشجویان آکادمی این سوال را داشتند که چطور ما متغییر تعدیلگر دو ارزشی مثل جنسیت را در اسمارت پی ال اس run کنیم ؛ به راحتی با توجه به مهارتهایی که در دوره spss آکادمی کسب کردند می توانند از گزینه select case ، case های هر ارزش را جدا کنند و سپس مدل را بدون اینکه متغییر تعدیلگر را وارد مدل کنند یکبار برای ارزش اول و بار دیگر برای ارزش دوم run کنند سپس یکبار هم مدل را با مجموع دو ارزش run کنند حال سه ضریب تعیین برای سه اجرای مدل در نرم افزار اسمارت پی ال اس وجود دارد .
حال فرمولی در این قسمت معرفی می شود به اندازه اثر کوهن که شدت اثر تعدیلی متغییر را به دست می آورد یعنی مشخص می کند متغییر اسمی دو ارزشی مثل جنسیت چه شدت اثری بر میزان رابطه بین دو متغییر برونزا و درونزا دارد؛ البته در مقالات 2016 ذکر شده که می توان این ضریب را با سه مقدار 0.02 ،0.15 و 0.35 مقایسه نمود و پی برد مانند رویه ایی که در کارگاهها آکادمی ذکر شده آیا این مقدار ضعیف است،متوسط است یا قوی.
@analysisacademy
تعیین میزان اثرمتغییر تعدیلگر دو ارزشی در نرم افزار اسمارت پی ال اس
دانشجویان کارگاههای آکادمی تحلیل آماری ایران بعد از گذراندن دوره های نرم افزارهای ایموس(AMOS) و پی ال اس(Smart PLS) به خوبی با دو روش مرحله ای و interaction برای run کردن متغییرهای تعدیلگر در تحقیقاتشان آشنا شده اند یعنی متغییرهای دو بخشی را در ایموس(AMOS) و متغییرهایی که دارای سوال می باشند و اصطلاحا در کارگاهها متغییر کمی نامیده می شود را با نرم افزار اسمارت پی ال اس (Smart PLS) مورد تجزیه و تحلیل قرار دادند . همواره بسیاری از دانشجویان آکادمی این سوال را داشتند که چطور ما متغییر تعدیلگر دو ارزشی مثل جنسیت را در اسمارت پی ال اس run کنیم ؛ به راحتی با توجه به مهارتهایی که در دوره spss آکادمی کسب کردند می توانند از گزینه select case ، case های هر ارزش را جدا کنند و سپس مدل را بدون اینکه متغییر تعدیلگر را وارد مدل کنند یکبار برای ارزش اول و بار دیگر برای ارزش دوم run کنند سپس یکبار هم مدل را با مجموع دو ارزش run کنند حال سه ضریب تعیین برای سه اجرای مدل در نرم افزار اسمارت پی ال اس وجود دارد .
حال فرمولی در این قسمت معرفی می شود به اندازه اثر کوهن که شدت اثر تعدیلی متغییر را به دست می آورد یعنی مشخص می کند متغییر اسمی دو ارزشی مثل جنسیت چه شدت اثری بر میزان رابطه بین دو متغییر برونزا و درونزا دارد؛ البته در مقالات 2016 ذکر شده که می توان این ضریب را با سه مقدار 0.02 ،0.15 و 0.35 مقایسه نمود و پی برد مانند رویه ایی که در کارگاهها آکادمی ذکر شده آیا این مقدار ضعیف است،متوسط است یا قوی.
http://analysisacademy.com/wp-content/uploads/2016/08/what-is-inferential-statistics.jpg
@analysisacademy
رابطه نمونه با جامعه آماری
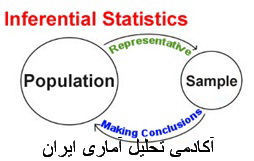
نمونه معرف جامعه است و هدف از همه نمونه گیری ها در پژوهش های علمی شناسایی یک گروه برای مطالعه است. این گروه ممکن است مجموعه ای از افراد یا چیزها باشد. نمونه گیری به دلایل زیر انجام مگیرد:
1-قوانین علمی باید دارای کلیت باشد تا بتوان آنها را در همه زمینه هایی که موضوع پژوهش در آنها مصداق پیدا می کند به کار برد.
2-نمونه برداری موجب آسانی کار پژوهش، صرفه جویی در وقت، هزینه و تعداد پژوهشگران می شود.
3-گاه آزمایش کامل یا مشاهده چیزی موجب ضایع شدن کل آن چیز یا محصول می شود. لذا باید نمونه گرفت.
4-دقت برخی آزمونها تابع حجم نمونه است.به دلیل آنکه در جامعه آماری روابط ضعیف بین متغییرها مشاده می شود لذا باید نمونه گیری های ویژه ای کرد.
فرآیند نمونه گیری
نمونه گیری، فرآیندی است که طی آن تعدادی از واحدها به گونه ای برگزیده می شوند که معرف(بیانگر) جامعه بزرگتری که از آن انتخاب شده اند باشند. این گزینش می تواند به سه گونه انجام پذیرد:
1-نمونه گیری انباشته (chunk) یا کومه ای (Lumpy)
در این نمونه گیری بخشی از جامعه به عنوان نمونه برداشته می شود، این نوع نمونه ها از لحاظ علمی بی ارزش هستند زیرا شواهدی در دست نیست که نشان دهد چنین نمونه ای معرف جامعه است.
2-نمونه گیری قضاوتی(Judgmental)
گزینش بخشی از جامعه که اعضای آن بر پایه داوری شخص پژوهشگر یا خبره مشخص می شود.
3-نمونه گیری تصادفی(Random)
روشی برای انتخاب بخشی از جامعه یا کل است، به گونه ای که همه نمونه های ممکن که دارای تعداد ثابت n هستند برای انتخاب شدن احتمال یکسان داشته باشند. گاهی نمونه گیری تصادفی را نمونه گیری احتمالی (Probability) می گویند، هر گاه در نمونه گیری، عنصر انتخاب شده دوباره به جامعه برگردانده شود، نمونه گیری را با جایگزینی (Replacement) می نامند.
@analysisacademy
رابطه نمونه با جامعه آماری
نمونه معرف جامعه است و هدف از همه نمونه گیری ها در پژوهش های علمی شناسایی یک گروه برای مطالعه است. این گروه ممکن است مجموعه ای از افراد یا چیزها باشد. نمونه گیری به دلایل زیر انجام مگیرد:
1-قوانین علمی باید دارای کلیت باشد تا بتوان آنها را در همه زمینه هایی که موضوع پژوهش در آنها مصداق پیدا می کند به کار برد.
2-نمونه برداری موجب آسانی کار پژوهش، صرفه جویی در وقت، هزینه و تعداد پژوهشگران می شود.
3-گاه آزمایش کامل یا مشاهده چیزی موجب ضایع شدن کل آن چیز یا محصول می شود. لذا باید نمونه گرفت.
4-دقت برخی آزمونها تابع حجم نمونه است.به دلیل آنکه در جامعه آماری روابط ضعیف بین متغییرها مشاده می شود لذا باید نمونه گیری های ویژه ای کرد.
فرآیند نمونه گیری
نمونه گیری، فرآیندی است که طی آن تعدادی از واحدها به گونه ای برگزیده می شوند که معرف(بیانگر) جامعه بزرگتری که از آن انتخاب شده اند باشند. این گزینش می تواند به سه گونه انجام پذیرد:
1-نمونه گیری انباشته (chunk) یا کومه ای (Lumpy)
در این نمونه گیری بخشی از جامعه به عنوان نمونه برداشته می شود، این نوع نمونه ها از لحاظ علمی بی ارزش هستند زیرا شواهدی در دست نیست که نشان دهد چنین نمونه ای معرف جامعه است.
2-نمونه گیری قضاوتی(Judgmental)
گزینش بخشی از جامعه که اعضای آن بر پایه داوری شخص پژوهشگر یا خبره مشخص می شود.
3-نمونه گیری تصادفی(Random)
روشی برای انتخاب بخشی از جامعه یا کل است، به گونه ای که همه نمونه های ممکن که دارای تعداد ثابت n هستند برای انتخاب شدن احتمال یکسان داشته باشند. گاهی نمونه گیری تصادفی را نمونه گیری احتمالی (Probability) می گویند، هر گاه در نمونه گیری، عنصر انتخاب شده دوباره به جامعه برگردانده شود، نمونه گیری را با جایگزینی (Replacement) می نامند.
http://analysisacademy.com/wp-content/uploads/2016/11/sample-sizeacademy2.png
@analysisacademy
عوامل موثر در تعیین حجم(اندازه) نمونه
عواملی که در تعیین حجم و اندازه گروه نمونه نقش دارند عبارتند از:
الف-اهداف تحقیق
ب-روش تحقیق و روشهای آماری وابسته به آن
ج-امکانات مالی و زمانی محقق
د-حجم جامعه آماری
ه-نحوه کنترل متغییرهای ناخواسته
و-میزان تاثیذپذیری متغییر وابسته از متغییر مستقل
ز-درصد خطاپذیری در نتایج
ح-ناهمگونی شدید متغییرها و عوامل مورد مطالعه در جامعه آماری
ط-میزان روایی و پایایی وسایل اندازه گیری متغییر وابسته
@analysisacademy
عوامل موثر در تعیین حجم(اندازه) نمونه
عواملی که در تعیین حجم و اندازه گروه نمونه نقش دارند عبارتند از:
الف-اهداف تحقیق
ب-روش تحقیق و روشهای آماری وابسته به آن
ج-امکانات مالی و زمانی محقق
د-حجم جامعه آماری
ه-نحوه کنترل متغییرهای ناخواسته
و-میزان تاثیذپذیری متغییر وابسته از متغییر مستقل
ز-درصد خطاپذیری در نتایج
ح-ناهمگونی شدید متغییرها و عوامل مورد مطالعه در جامعه آماری
ط-میزان روایی و پایایی وسایل اندازه گیری متغییر وابسته

http://analysisacademy.com/wp-content/uploads/2016/11/Job-Satisfaction-Questionnaire2.jpg
@analysisacademy
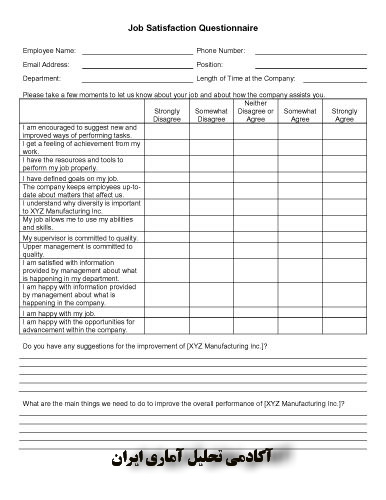
شیوه هایی برای پی بردن به اینکه چه پرسشهایی باید در پرسشنامه آورده شود وجود دارد که عبارتند از:
1)توجه به متغییرهایی که باید اندازه گیری شود.
2)شاخص هایی که برای این متغییرها مطرح شده اند.
3)حدسهایی درباره ارتباطهایی که متغییرهای مساله را به هم مربوط می کند یا درباره عواملی که ممکن است ارتباطها را تبیین کنند.
4)شیوه ای که آن داده ها مورد تجزیه و تحلیل قرار می گیرند.
5)شیوه تدوین و انجام پرسشنامه
@analysisacademy
شیوه هایی برای پی بردن به اینکه چه پرسشهایی باید در پرسشنامه آورده شود وجود دارد که عبارتند از:
1)توجه به متغییرهایی که باید اندازه گیری شود.
2)شاخص هایی که برای این متغییرها مطرح شده اند.
3)حدسهایی درباره ارتباطهایی که متغییرهای مساله را به هم مربوط می کند یا درباره عواملی که ممکن است ارتباطها را تبیین کنند.
4)شیوه ای که آن داده ها مورد تجزیه و تحلیل قرار می گیرند.
5)شیوه تدوین و انجام پرسشنامه
http://analysisacademy.com/wp-content/uploads/2016/08/115421_0caf0.jpg
@analysisacademy
الگوهای معادله ساختاری، مجموعه هایی از معادلات خطی هستند که برای تعیین یک پدیده برحسب متغیرهای علت و معلول از پیش فرض شده به کار می روند. کلی ترین شکل این الگوها امکان اندازه گیری متغیرهایی که نمی توانند مستقیماً اندازه گیری شوند را فراهم می کند. الگوهای معادله ساختاری به ویژه در علوم اجتماعی و رفتاری مفیدند و برای مطالعه رابطه بین وضعیت های اجتماعی و حصول آن ها، تصمیم های مربوط به قابلیت سوددهی شرکت ها، کارایی برنامه های رفتار اجتماعی و دیگر مکانیسم ها مورد استفاده قرار می گیرد.
تدوین مدل : قبل از هر نوع جمع آوری داده و تحلیل، پژوهشگر بایستی مدلی را تدوین نماید که به نظر می رسد مقادیر واریانس- کواریانس آن را تأیید نمایند. به بیان دیگر تدوین مدل تصمیم در این باره است که کدام متغیرها در مدل نظری قرار گیرند و این که این متغیرها چگونه با هم در ارتباط هستند.
یک مدل هنگامی به خوبی تدوین شده است که مدل واقعی جامعه با مدل نظری فرض شده سازگار باشد. به عبارت دیگر ماتریس کواریانس نمونه ای S به طور بسنده ای بوسیله مدل نظری تحت آزمون بازتولید شود. بنابراین هدف تحقق مدلی است که نزدیکترین برازش را با ساختار کواریانس مدل دارا باشد. مثال ساده ای را با دو متغیر X و Y در نظر بگیرید. ما براساس پژوهش قبلی می دانیم که این دو متغیر با یکدیگر ارتباط دارند. اما چرا؟ کدام ارتباط نظری بیانگر این رابطه است؟ آیا X بر Y اثر می گذارد یا عکس این حالت برقرار می باشد و یا متغیر سومی به نام Z بر هردوی آن ها اثر می گذارد. گاه ممکن است با در نظر مدل اولیه نامناسب باعث شویم یک پارامتر با اهمیت از مدل حذف شود (مثلا غفلت کردن از وجود رابطه X و Y) و یا این که یک متغیر مهم را از مدل حذف نماییم. علاوه بر این ممکن است یک پارامتر یا متغیر نامناسب در مدل وارد شوند که سبب ایجاد اریبی در برآورد پارامترها شده و نوعی خطا را در تدوین مدل بوجود می آورد.
تشخیص مدل : در مدل سازی معادلات ساختاری حل مسئله تشخیص مدل پیش از برآورد پارامترها بسیار با اهمیت است. در تشخیص مدل این سؤال مطرح می شود که : آیا براساس داده های نمونه ای موجود در ماتریس کواریانس نمونه ای S و مدل نظری تعریف شده بوسیله ماتریس کواریانس جامعه می توان مجموعه ی منحصر به فردی از برآورد پارامترها یافت؟
پیش از توضیح در مورد تشخیص مدل توضیحاتی را در مورد پارامترهای مدل ارائه می دهیم .هر پارامتر در مدل باید به عنوان یک پارامتر آزاد، ثابت یا مقید مشخص شود. یک پارامتر آزاد پارامتری است که شناخته شده نیست و نیازمند برآورد است. پارامتر ثابت، پارامتری است که آزاد نیست امابرای آن یک مقدار مشخص(به طور معمول مقدار صفر یا ۱) تعریف شده است. یک پارامتر مقید نیز پارامتری است که مشخص نیست اما برابر با یک یا تعداد بیشتری پارامتر است.
تشخیص مدل در واقع به طرح پارامترها به عنوان ثابت، آزاد یا مقید بستگی دارد. پس از آن که مدل و پارامترها تدوین شدند، این پارامترها برای برای شکل دادن به یک و تنها یک با یکدیگر ترکیب می شوند. اگر دو یا تعداد بیشتری از مجموعه پارامترها ماتریس یکسانی را تولید کنند، انگاه این مجموعه ها معادل یا همتا خوانده می شوند.
بر این اساس سه سطح برای تشخیص مدل وجود دارد.
۱- یک مدل فرومشخص است اگر یک یا تعداد بیشتری از متغیرها نتوانند به طور یکتایی مشخص شوند زیرا اطلاعات کافی در ماتریس S وجود ندارد.
۲- یک مدل کاملا مشخص است اگر همه پارامترها به دلیل وجود اطلاعات کافی در ماتریس S به طور منحصر به فردی تعیین شوند..
۳- یک مدل فرامشخص است هنگامی که بیش از یک جواب برای یک یا چند پارامتر وجود دارد.
اگر مدل فرومشخص باشد برآورد پارامترها قابل اعتماد نبوده و در چنین حالتی درجات آزادی مدل صفر یا منفی است. این مدل ممکن است با افزودن قیدهایی مشخص شود. مدل های کاملا مشخص و فرامشخص برای برآورد پارامترها مناسب هستند.
برآورد مدل : گام بعدی بدست آوردن برآوردهایی برای هریک از پارامترهای تعیین شده در مدل است که ماتریس نظری را تولید می کنند. برآورد پارامترها باید به گونه ای باشد که نزدیک ترین ماتریس به ماتریس واریانس کواریانس نمونه ای بازتولید شود و خطا یعنی S- حداقل شود. برخی از روش های اولیه برای این منظور شامل حداقل مربعات غیروزنی، حداقل مربعات معمول، حداقل مربعات تعمیم یافته و روش حداکثر درستنمایی است. از میان این روش ها تنها روش حداقل مربعات غیروزنی وابسته به مقیاس است.
@analysisacademy
الگوهای معادله ساختاری، مجموعه هایی از معادلات خطی هستند که برای تعیین یک پدیده برحسب متغیرهای علت و معلول از پیش فرض شده به کار می روند. کلی ترین شکل این الگوها امکان اندازه گیری متغیرهایی که نمی توانند مستقیماً اندازه گیری شوند را فراهم می کند. الگوهای معادله ساختاری به ویژه در علوم اجتماعی و رفتاری مفیدند و برای مطالعه رابطه بین وضعیت های اجتماعی و حصول آن ها، تصمیم های مربوط به قابلیت سوددهی شرکت ها، کارایی برنامه های رفتار اجتماعی و دیگر مکانیسم ها مورد استفاده قرار می گیرد.
تدوین مدل : قبل از هر نوع جمع آوری داده و تحلیل، پژوهشگر بایستی مدلی را تدوین نماید که به نظر می رسد مقادیر واریانس- کواریانس آن را تأیید نمایند. به بیان دیگر تدوین مدل تصمیم در این باره است که کدام متغیرها در مدل نظری قرار گیرند و این که این متغیرها چگونه با هم در ارتباط هستند.
یک مدل هنگامی به خوبی تدوین شده است که مدل واقعی جامعه با مدل نظری فرض شده سازگار باشد. به عبارت دیگر ماتریس کواریانس نمونه ای S به طور بسنده ای بوسیله مدل نظری تحت آزمون بازتولید شود. بنابراین هدف تحقق مدلی است که نزدیکترین برازش را با ساختار کواریانس مدل دارا باشد. مثال ساده ای را با دو متغیر X و Y در نظر بگیرید. ما براساس پژوهش قبلی می دانیم که این دو متغیر با یکدیگر ارتباط دارند. اما چرا؟ کدام ارتباط نظری بیانگر این رابطه است؟ آیا X بر Y اثر می گذارد یا عکس این حالت برقرار می باشد و یا متغیر سومی به نام Z بر هردوی آن ها اثر می گذارد. گاه ممکن است با در نظر مدل اولیه نامناسب باعث شویم یک پارامتر با اهمیت از مدل حذف شود (مثلا غفلت کردن از وجود رابطه X و Y) و یا این که یک متغیر مهم را از مدل حذف نماییم. علاوه بر این ممکن است یک پارامتر یا متغیر نامناسب در مدل وارد شوند که سبب ایجاد اریبی در برآورد پارامترها شده و نوعی خطا را در تدوین مدل بوجود می آورد.
تشخیص مدل : در مدل سازی معادلات ساختاری حل مسئله تشخیص مدل پیش از برآورد پارامترها بسیار با اهمیت است. در تشخیص مدل این سؤال مطرح می شود که : آیا براساس داده های نمونه ای موجود در ماتریس کواریانس نمونه ای S و مدل نظری تعریف شده بوسیله ماتریس کواریانس جامعه می توان مجموعه ی منحصر به فردی از برآورد پارامترها یافت؟
پیش از توضیح در مورد تشخیص مدل توضیحاتی را در مورد پارامترهای مدل ارائه می دهیم .هر پارامتر در مدل باید به عنوان یک پارامتر آزاد، ثابت یا مقید مشخص شود. یک پارامتر آزاد پارامتری است که شناخته شده نیست و نیازمند برآورد است. پارامتر ثابت، پارامتری است که آزاد نیست امابرای آن یک مقدار مشخص(به طور معمول مقدار صفر یا ۱) تعریف شده است. یک پارامتر مقید نیز پارامتری است که مشخص نیست اما برابر با یک یا تعداد بیشتری پارامتر است.
تشخیص مدل در واقع به طرح پارامترها به عنوان ثابت، آزاد یا مقید بستگی دارد. پس از آن که مدل و پارامترها تدوین شدند، این پارامترها برای برای شکل دادن به یک و تنها یک با یکدیگر ترکیب می شوند. اگر دو یا تعداد بیشتری از مجموعه پارامترها ماتریس یکسانی را تولید کنند، انگاه این مجموعه ها معادل یا همتا خوانده می شوند.
بر این اساس سه سطح برای تشخیص مدل وجود دارد.
۱- یک مدل فرومشخص است اگر یک یا تعداد بیشتری از متغیرها نتوانند به طور یکتایی مشخص شوند زیرا اطلاعات کافی در ماتریس S وجود ندارد.
۲- یک مدل کاملا مشخص است اگر همه پارامترها به دلیل وجود اطلاعات کافی در ماتریس S به طور منحصر به فردی تعیین شوند..
۳- یک مدل فرامشخص است هنگامی که بیش از یک جواب برای یک یا چند پارامتر وجود دارد.
اگر مدل فرومشخص باشد برآورد پارامترها قابل اعتماد نبوده و در چنین حالتی درجات آزادی مدل صفر یا منفی است. این مدل ممکن است با افزودن قیدهایی مشخص شود. مدل های کاملا مشخص و فرامشخص برای برآورد پارامترها مناسب هستند.
برآورد مدل : گام بعدی بدست آوردن برآوردهایی برای هریک از پارامترهای تعیین شده در مدل است که ماتریس نظری را تولید می کنند. برآورد پارامترها باید به گونه ای باشد که نزدیک ترین ماتریس به ماتریس واریانس کواریانس نمونه ای بازتولید شود و خطا یعنی S- حداقل شود. برخی از روش های اولیه برای این منظور شامل حداقل مربعات غیروزنی، حداقل مربعات معمول، حداقل مربعات تعمیم یافته و روش حداکثر درستنمایی است. از میان این روش ها تنها روش حداقل مربعات غیروزنی وابسته به مقیاس است.

http://analysisacademy.com/wp-content/uploads/2016/08/115421_0caf0.jpg
@analysisacademy
آزمون مدل : پس از آنکه برآورد پارامترها برای یک مدل تدوین شده و مشخص بدست آمدند، محقق باید تعیین کند که داده ها تا چه حد با مدل برازش دارند؟ دو شیوه برای برسی برازش مدل وجود دارد : ابتدا ملاحظه برخی آزمون های عمومیت یافته برای برازش کل مدل است و شیوه دوم بررسی برازش پارامترهای منفرد در هریک از اجزای مدل است. آزمو نهای کلی با عنوان معیارهای برازش مدل شناخته می شوند. بسیاری از این شاخص ها برمبنای مقایسه ماتریس کواریانس اقتباس شده از مدل با ماتریس کواریانس نمونه ای S ساخته شده اند.
برای بررسی برازش پارامترهای منفرد سه آزمون اصلی مورد استفاده قرار می گیرند. اول آنکه آیا یک پارامتر آزاد به طور معناداری با صفر تفاوت دارد یا خیر؟ دوم آنکه آیا علامت پارامتر با آنچه به لحاظ نظری مورد انتظار بوده هماهنگ است؟ و سوم اینکه برآورد پارامترها باید در دامنه مقادیر مورد انتظار قرارگیرند.
هریک از این سؤالات با کمک روش ها و آزمون های آماری مناسب پاسخ داده می شوند.
اصلاح مدل : اگر برازش یک مدل نظری به قوتی که انتظار داشتیم نبود آنگاه گام بعدی اصلاح مدل و ارزیابی مدل اصلاح شده می باشد. فرآیند نمایان سازی خطاهای تدوین مدل به نحوی که مدل های جایگزین تدوین شده به طور مناسب تری ارزیابی شوند ، «جستجوی تدوین» نامیده می شود. هدف از یک جستجوی تدوین تعویض مدل اصلی با مدلی است که در برخی جهات دارای برازش بهتری بوده و پارامترهایی را برآورد می کند که به لحاظ آماری معنادار و به لحاظ نظری دارای معنا و مفهوم باشند. بررسی ماتریس باقیمانده ها، ملاحظه معناداری آماری پارامترهای مدل و همچنین استفاده از مضرب لاگرانژ و آماره والد از جمله روش های مورد استفاده برای این منظور هستند.
@analysisacademy
آزمون مدل : پس از آنکه برآورد پارامترها برای یک مدل تدوین شده و مشخص بدست آمدند، محقق باید تعیین کند که داده ها تا چه حد با مدل برازش دارند؟ دو شیوه برای برسی برازش مدل وجود دارد : ابتدا ملاحظه برخی آزمون های عمومیت یافته برای برازش کل مدل است و شیوه دوم بررسی برازش پارامترهای منفرد در هریک از اجزای مدل است. آزمو نهای کلی با عنوان معیارهای برازش مدل شناخته می شوند. بسیاری از این شاخص ها برمبنای مقایسه ماتریس کواریانس اقتباس شده از مدل با ماتریس کواریانس نمونه ای S ساخته شده اند.
برای بررسی برازش پارامترهای منفرد سه آزمون اصلی مورد استفاده قرار می گیرند. اول آنکه آیا یک پارامتر آزاد به طور معناداری با صفر تفاوت دارد یا خیر؟ دوم آنکه آیا علامت پارامتر با آنچه به لحاظ نظری مورد انتظار بوده هماهنگ است؟ و سوم اینکه برآورد پارامترها باید در دامنه مقادیر مورد انتظار قرارگیرند.
هریک از این سؤالات با کمک روش ها و آزمون های آماری مناسب پاسخ داده می شوند.
اصلاح مدل : اگر برازش یک مدل نظری به قوتی که انتظار داشتیم نبود آنگاه گام بعدی اصلاح مدل و ارزیابی مدل اصلاح شده می باشد. فرآیند نمایان سازی خطاهای تدوین مدل به نحوی که مدل های جایگزین تدوین شده به طور مناسب تری ارزیابی شوند ، «جستجوی تدوین» نامیده می شود. هدف از یک جستجوی تدوین تعویض مدل اصلی با مدلی است که در برخی جهات دارای برازش بهتری بوده و پارامترهایی را برآورد می کند که به لحاظ آماری معنادار و به لحاظ نظری دارای معنا و مفهوم باشند. بررسی ماتریس باقیمانده ها، ملاحظه معناداری آماری پارامترهای مدل و همچنین استفاده از مضرب لاگرانژ و آماره والد از جمله روش های مورد استفاده برای این منظور هستند.