До речі, щодо відкритості OpenAI. Цей проект починався як неприбуткова дослідницька організація, яка публікувала всі свої дослідження у відкритому доступі. Хороша тенденція, яку започаткували AI-лабораторії тех-гігантів, і яка сприяла швидкому поширенню cutting edge знань. З часом відкритості в OpenAI ставало менше. Пізніше компанія перестала бути некомерційною. А щоб залучати фінансування, стартапу потрібно показувати вражаючі демо. Такі як ChatGPT. (Це я продовжую переказувати ідеї ЛеКуна з розмови в попередньому пості.)
Якщо в технічних пейперах по GPT-3 та InstructGPT можна знайти багато подробиць про навчання, датасет моделі (див. ілюстрацію) та ручне шліфування відповідей, то в пейпері по GPT-4 розробників та дослідників з усього світу чекало розчарування: Given both the competitive landscape and the safety implications of large-scale models like GPT-4, this report contains no further details about the architecture (including model size), hardware, training compute, dataset construction, training method, or similar.
Здається, час перейменовувати компанію на Closed AI.
Якщо в технічних пейперах по GPT-3 та InstructGPT можна знайти багато подробиць про навчання, датасет моделі (див. ілюстрацію) та ручне шліфування відповідей, то в пейпері по GPT-4 розробників та дослідників з усього світу чекало розчарування: Given both the competitive landscape and the safety implications of large-scale models like GPT-4, this report contains no further details about the architecture (including model size), hardware, training compute, dataset construction, training method, or similar.
Здається, час перейменовувати компанію на Closed AI.

🤔40😁14😢9👍2
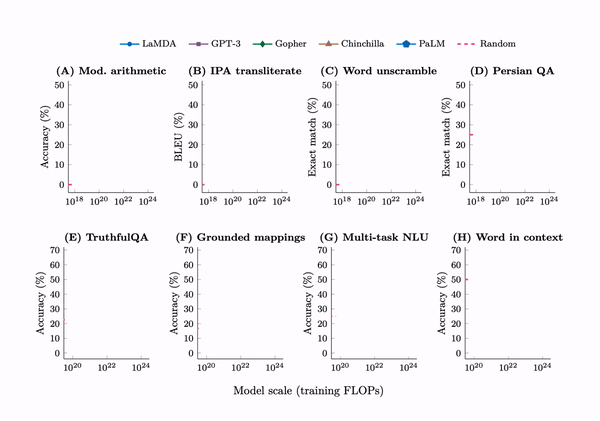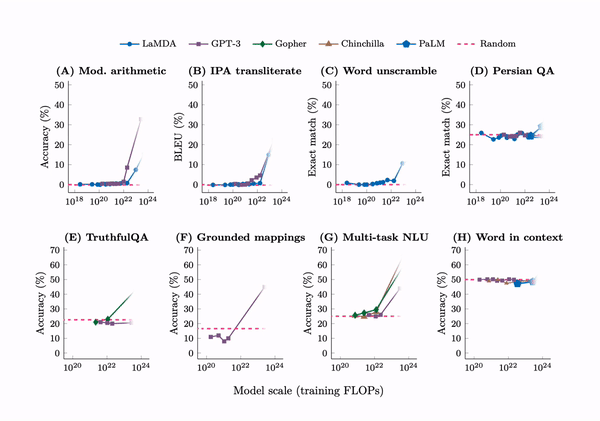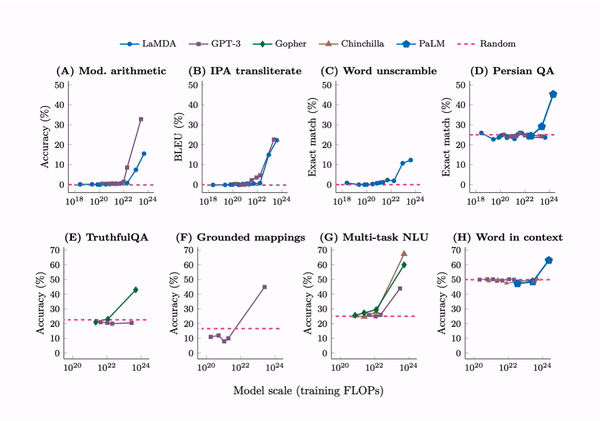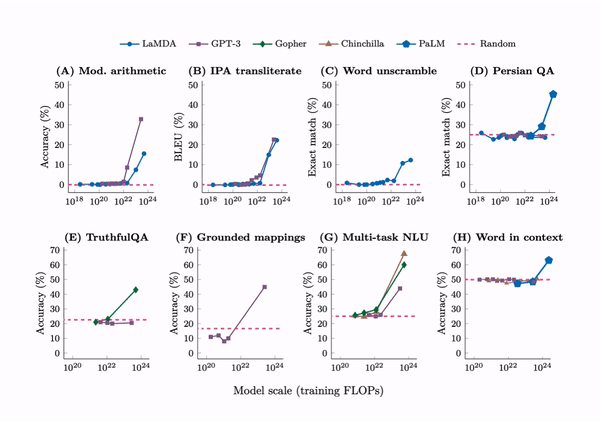
Далі — лекція професора Стенфорда, фахівця з обчислювальної лінгвістики Крістофера Поттса. Складність — середня. Погляд на LLMs з точки зору NLP. З 6 хвилини — цікавий фрагмент про стрімкий прогрес мовних моделей за останні роки, і особливо цікавий слайд про те, як драматично зростає здібність моделей виконувати певні задачі зі зростанням їх розміру (див.ілюстрацію). Висвітлено механізм навчання ChatGPT, виклики і можливі підходи до використання мовних моделей для універсальних задач.
Серед океану інфошуму про LLMs фахівців з обчислювальної лінгвістики незаслужено обходять увагою. Хоча, здавалось би, саме до них треба іти за поясненнями цього феномену в першу чергу.
Серед океану інфошуму про LLMs фахівців з обчислювальної лінгвістики незаслужено обходять увагою. Хоча, здавалось би, саме до них треба іти за поясненнями цього феномену в першу чергу.
👍38❤2🤔1🤩1
Microsoft інтегрує AI-асистента в свої офісні сервіси. А тепер давайте згадаємо про беззаперечну перевагу Microsoft над конкурентами в дистрибуції. У Office 345 млн платних користувачів. Багато компаній зараз працюють над офісними застосунками з AI, і дехто може зробити продукт, кращий ніж у Microsoft. Але хто зможе викатити його на таку кількість користувачів? Здається, ніхто. Google теж працює над AI-фічами для свого офісного пакета, але має лише 9 млн платних користувачів-організацій.
Памятаєте, колись був популярним Slack? Коли під час пандемії всі переходили на ремоут, Microsoft запустив по своїм каналам дистрибуції Teams. Тепер у нього 280 млн користувачів, а у Slack — 18 млн.
Microsoft має шанс стати лідером в ніші AI productivity apps суто за рахунок потужної ринкової позиції.
Памятаєте, колись був популярним Slack? Коли під час пандемії всі переходили на ремоут, Microsoft запустив по своїм каналам дистрибуції Teams. Тепер у нього 280 млн користувачів, а у Slack — 18 млн.
Microsoft має шанс стати лідером в ніші AI productivity apps суто за рахунок потужної ринкової позиції.
👍68❤5🔥2
🤝 В четвер буду тут. Має бути непоганий нетворкінг, тож якщо працюєте в VC чи будуєте стартап, зверніть увагу.
==
23 березня в Unit.City (та онлайн) відбудеться Challenger AI Accelerator | Demo Day, під час якого 8 команд презентують свої рішення в Digital & AI/ML сфері.
Серед учасників: Elomia Health, CheckEye, BeHolder, Softbrik, AirLaw, ParkingAround, Scally, GetPin. Ви також матимете нагоду послухати панельну дискусію на тему стійкості української бізнес-екосистеми та персонально поспілкуватись із командами, міжнародними інвесторами та представниками корпорацій. Реєстрація: bit.ly/challenger_AI_DemoDay
==
23 березня в Unit.City (та онлайн) відбудеться Challenger AI Accelerator | Demo Day, під час якого 8 команд презентують свої рішення в Digital & AI/ML сфері.
Серед учасників: Elomia Health, CheckEye, BeHolder, Softbrik, AirLaw, ParkingAround, Scally, GetPin. Ви також матимете нагоду послухати панельну дискусію на тему стійкості української бізнес-екосистеми та персонально поспілкуватись із командами, міжнародними інвесторами та представниками корпорацій. Реєстрація: bit.ly/challenger_AI_DemoDay
Linkedin
Challenger AI Accelerator | Demo Day | LinkedIn
🚀Join us for an exciting glimpse into the future of AI/ML startups!
Demo Day, hosted by the largest non-equity startup accelerator platform in CEE CHALLENGER, will be held on Thursday, March 23, 2023. This pivotal event marks the end of a 4-months Challenger…
Demo Day, hosted by the largest non-equity startup accelerator platform in CEE CHALLENGER, will be held on Thursday, March 23, 2023. This pivotal event marks the end of a 4-months Challenger…
👍24🔥7❤4
Brodetskyi. Tech, VC, Startups
Вам еще не надоела движуха вокруг Pornhub? Надеюсь что нет, потому что я хочу поделиться с вами отличным текстом FT о собственниках MindGeek — компании, которой принадлежат самые популярные порносайты в интернете, в том числе Pornhub, YouPorn, RedTube и Brazzers.…
Компанію MindGeek, яка володіє Pornhub та іншими популярними порно-стрімінгами, купив новий канадський private equity фонд з іронічною назвою Ethical Capital Partners. Переглянув лінкедіни його топів, там люди з цікавими бекграундами: директор мережі канабіс-клінік, кримінальний адвокат, керівник держагентства з обігу наркотиків, фіндиректор канабіс-стартапу. Досвідчені профі ринків етичного капіталу!
До речі, заплутану схему з реальними власниками MindGeek кілька років тому викрили в розслідуванні FT, писав про це. Для розуміння масштабу: revenue MindGeek за 2018 рік — $460 млн, profit margin — 50%. Вері гуд бізнес. З компанією досі судяться за незаконні відео, на яких вона заробляла роками.
До речі, заплутану схему з реальними власниками MindGeek кілька років тому викрили в розслідуванні FT, писав про це. Для розуміння масштабу: revenue MindGeek за 2018 рік — $460 млн, profit margin — 50%. Вері гуд бізнес. З компанією досі судяться за незаконні відео, на яких вона заробляла роками.
👍50😁35❤4😱2🤔1
Crazy stuff. Guys from Stanford fine-tuned Meta's LLaMa model using OpenAI's text-davinci-003 model (improved InstructGPT). The result is a powerful model that performs many tasks on par with OpenAI's model. But the cost of training was just $600.
https://youtu.be/xslW5sQOkC8
https://crfm.stanford.edu/2023/03/13/alpaca.html
https://youtu.be/xslW5sQOkC8
https://crfm.stanford.edu/2023/03/13/alpaca.html
🤯39❤7👍4🔥1
Особливості національного бізнесу. Або як Uber заводить водіям кеш.
https://ain.ua/2023/03/20/beb-vykrylo-brend-taksi/
https://ain.ua/2023/03/20/beb-vykrylo-brend-taksi/
AIN.UA
БЕБ викрило сервіс таксі на ухиленні від сплати податків. Це український партнер Uber
Детективи Бюро економічної безпеки (БЕБ) України викрили схему ухилення від сплати податків на суму 52 млн грн посадовими особами українського представництва всесвітньо відомого бренду таксі. За ін…
🤯38👍10🎉3❤2😁1
Google відкриває доступ до свого AI-асистента Bard. Поки доступно в US/UK. Записався в waiting list через VPN. Коли отримаю доступ, порівняю його з Bing AI і поділюсь враженнями.
Який би з сервісів не став кращим в довгостроковій перспективі, динаміка мені подобається. Користувачам ця конкуренція між гігантами приносить лише нові потужні сервіси. Звісно, кости на підтримання такого сервісу зовсім інші, ніж для звичайного пошуку, відповідно і прибутковість такого пошуку нижча. Пізніше проаналізую дані і напишу про це.
Який би з сервісів не став кращим в довгостроковій перспективі, динаміка мені подобається. Користувачам ця конкуренція між гігантами приносить лише нові потужні сервіси. Звісно, кости на підтримання такого сервісу зовсім інші, ніж для звичайного пошуку, відповідно і прибутковість такого пошуку нижча. Пізніше проаналізую дані і напишу про це.
Google
Try Bard and share your feedback
Bard is an early experiment from Google that lets you collaborate with generative AI. If you’re in the U.S. and U.K., you can sign up to try it.
👍68❤12🔥3
Brodetskyi. Tech, VC, Startups
The future of email with ChatGPT https://twitter.com/multikev/status/1616784555788075009
Brave new world of communication
😁195👍29❤3
В коментарях спитали про лист із закликом загнати джина в пляшку. Мій короткий коментар: не спрацює, хоча речі там озвучуються раціональні. Базова теорія ігор: домінантна стратегія для кожного з гравців в даній ситуації — продовжувати свої розробки, що б там не робили конкуренти. Якщо вони припинять, ти їх переженеш, якщо не припинять — принаймні не відстанеш.
Тому не спрацює.
Тому не спрацює.
Future of Life Institute
Pause Giant AI Experiments: An Open Letter - Future of Life Institute
We call on all AI labs to immediately pause for at least 6 months the training of AI systems more powerful than GPT-4.
👍64🤔4😢2❤1🤯1
Brodetskyi. Tech, VC, Startups
І ось гарний матеріал комп'ютерників з Прінстона про те, яких помилок припускаються журналісти, пишучи про ШІ: • Хибне порівняння ШІ та людей: коли програму наділяють суб'єктністю чи порівнюють з людським інтелектом • Перебільшення та хибні твердження про…
Якщо вас теж лякають графіки про те, як мовні моделі справляються з різними інтелектуальними задачами, цей текст дозволить трохи розслабитись.
По-перше, деякі з бенчмарків, на яких тестували GPT-4, були в навчальному датасеті (це називається training data contamination). При тестуванні на нових аналогічних тестах GPT-4 показує зовсім інші результати (0/10 замість 10/10). Тобто, інколи нейромережа класно проходить тест лише тому, що запам'ятала буквально його питання і відповіді.
По-друге, проходження професійного тесту далеко не дорівнює наявності професійних компетенцій.
Professional exams, especially the bar exam, notoriously overemphasize subject-matter knowledge and underemphasize real-world skills, which are far harder to measure in a standardized, computer-administered way. In other words, not only do these exams emphasize the wrong thing, they overemphasize precisely the thing that language models are good at.
Ну а ще будь-який бенчмарк стає ціллю для тренування, і перестає бути корисним, тому що все тренування перетворюється в підгонку результату під конкретний тест — емпіричне правило, відоме як закон Гудхарта.
В кінці є лінки на джерела про недоліки тестів для LLMs та альтернативні підходи до оцінювання їх продуктивності.
Виходить, ввів вас в оману цим графіком від Open AI, вибачаюсь! Краще перечитайте ще один текст від пана Нараянана з Прінстона, щоб краще помічати такі маніпуляції.
По-перше, деякі з бенчмарків, на яких тестували GPT-4, були в навчальному датасеті (це називається training data contamination). При тестуванні на нових аналогічних тестах GPT-4 показує зовсім інші результати (0/10 замість 10/10). Тобто, інколи нейромережа класно проходить тест лише тому, що запам'ятала буквально його питання і відповіді.
По-друге, проходження професійного тесту далеко не дорівнює наявності професійних компетенцій.
Professional exams, especially the bar exam, notoriously overemphasize subject-matter knowledge and underemphasize real-world skills, which are far harder to measure in a standardized, computer-administered way. In other words, not only do these exams emphasize the wrong thing, they overemphasize precisely the thing that language models are good at.
Ну а ще будь-який бенчмарк стає ціллю для тренування, і перестає бути корисним, тому що все тренування перетворюється в підгонку результату під конкретний тест — емпіричне правило, відоме як закон Гудхарта.
В кінці є лінки на джерела про недоліки тестів для LLMs та альтернативні підходи до оцінювання їх продуктивності.
Виходить, ввів вас в оману цим графіком від Open AI, вибачаюсь! Краще перечитайте ще один текст від пана Нараянана з Прінстона, щоб краще помічати такі маніпуляції.
www.normaltech.ai
GPT-4 and professional benchmarks: the wrong answer to the wrong question
OpenAI may have tested on the training data. Besides, human benchmarks are meaningless for bots.
👍57❤6🔥3👏2🤔1
👨🏻💻 Нещодавно мав цікавий досвід — бізнес-школа KSE провела спільний буткемп з Центром підприємництва МІТ, де я був одним з менторів. Розповів про це детальніше в LinkedIn.
Дуже зацінив програму "Disciplined Entrepreneurship" від керівника цього центру. В її основі проста ідея: підприємництво це не мистецтво і не дар, а звичайне ремесло, якому можна навчитись. В МІТ студентам дають детальний фреймворк, який допомагає людям з технічним/інженерним мисленням розвинути мислення бізнесове/продуктове: хто користувач, які його потреби, як він приймає рішення, скільки можна заробити на цьому ринку, як порахувати юніт-економіку і т.д. Суперпрактичні і корисні речі для фаундерів. Без жодного натяку на фігню з поп-книжок про позитивне мислення та квадранти грошового потоку. Купа прикладів, таблиць, питань та детальних пояснень. Все класно структуровано, читаєш і кайфуєш. Такий фірмовий МІТ style — from nerds for nerds.
Ну а про власне буткемп і команди написав на LinkedIn, лінк вище, а на фото спойлер.
Дуже зацінив програму "Disciplined Entrepreneurship" від керівника цього центру. В її основі проста ідея: підприємництво це не мистецтво і не дар, а звичайне ремесло, якому можна навчитись. В МІТ студентам дають детальний фреймворк, який допомагає людям з технічним/інженерним мисленням розвинути мислення бізнесове/продуктове: хто користувач, які його потреби, як він приймає рішення, скільки можна заробити на цьому ринку, як порахувати юніт-економіку і т.д. Суперпрактичні і корисні речі для фаундерів. Без жодного натяку на фігню з поп-книжок про позитивне мислення та квадранти грошового потоку. Купа прикладів, таблиць, питань та детальних пояснень. Все класно структуровано, читаєш і кайфуєш. Такий фірмовий МІТ style — from nerds for nerds.
Ну а про власне буткемп і команди написав на LinkedIn, лінк вище, а на фото спойлер.
❤74👍14🔥14👏1
🗂 В епоху, коли LLMs стають доступними і дешевими, однією з конкурентних переваг для AI-продукту стає наявність унікальних даних, на яких можна навчати чи файнтюнити модель.
Тому я з великим інтересом прочитав, як в Bloomberg натренували мовну модель на фінансових даних і текстах.
Половина тренувальних даних — загальнодоступні датасети, на яких зараз навчаються всі мовні моделі. Інша половина — фінансові звіти компаній, ділові прес-релізи, новини і аналітика Bloomberg.
Результат — модель BloombergGPT з 50 млрд параметрів показує на звичайних тестах результати на рівні з GPT-3, а на фінансових — значно обганяє всі неспеціалізовані моделі такого ж розміру. До фінансових тестів тут відносять sentiment analysis (позитивна чи негативна новина для компанії та інвесторів), аналіз новин та заголовків, пошук та аналіз сутностей в текстах.
Найцікавіше — фінансовий аналіз: given input from S&P 500 earnings reports that includes text and at least one table with financial data, the task is to answer conversational questions that require numerical reasoning over the input. Я використовував для подібних задач Bing AI, що допомогло мені зекономити немало часу при написанні проекту з Financial Reporting and Analysis. Більшість часу пішло на написання промптів і упаковку цифр, а з таким інструментом як BloombergGPT це було б ще швидше.
Ще один приклад в коментарях — автоматична генерація заголовків для новин.
Було лише питанням часу, коли саме Bloomberg, компанія з найбільшим масивом фінансових даних, створить такий інструмент. Можна уявити, скільки процесів там оптимізують з його допомогою і скільки нових фіч додадуть для клієнтів.
Фінансовим аналітикам теж пора потроху освоювати prompt engineering.
Тому я з великим інтересом прочитав, як в Bloomberg натренували мовну модель на фінансових даних і текстах.
Половина тренувальних даних — загальнодоступні датасети, на яких зараз навчаються всі мовні моделі. Інша половина — фінансові звіти компаній, ділові прес-релізи, новини і аналітика Bloomberg.
Результат — модель BloombergGPT з 50 млрд параметрів показує на звичайних тестах результати на рівні з GPT-3, а на фінансових — значно обганяє всі неспеціалізовані моделі такого ж розміру. До фінансових тестів тут відносять sentiment analysis (позитивна чи негативна новина для компанії та інвесторів), аналіз новин та заголовків, пошук та аналіз сутностей в текстах.
Найцікавіше — фінансовий аналіз: given input from S&P 500 earnings reports that includes text and at least one table with financial data, the task is to answer conversational questions that require numerical reasoning over the input. Я використовував для подібних задач Bing AI, що допомогло мені зекономити немало часу при написанні проекту з Financial Reporting and Analysis. Більшість часу пішло на написання промптів і упаковку цифр, а з таким інструментом як BloombergGPT це було б ще швидше.
Ще один приклад в коментарях — автоматична генерація заголовків для новин.
Було лише питанням часу, коли саме Bloomberg, компанія з найбільшим масивом фінансових даних, створить такий інструмент. Можна уявити, скільки процесів там оптимізують з його допомогою і скільки нових фіч додадуть для клієнтів.
Фінансовим аналітикам теж пора потроху освоювати prompt engineering.

🔥56👍23❤4🤔1
Brodetskyi. Tech, VC, Startups
100 most cited AI papers in 2022 з цікавою статистикою за три роки по країнам (лідери: США з великим відривом, Китай, UK) і організаціям: Google, Meta Microsoft. І власне списком пейперів. Класний зріз по галузі, що зараз найгарячіше: LLMs, diffusion models…
AI Index Report 2023 від Стенфорда [PDF]
400 сторінок статистики про індустрію AI. Багато графіків, буде корисно при підготовці тематичних звітів та презентацій.
Найцікавіші розділи — про R&D та економіку, про бенчмарки і етику теж цікаві, про policy та education занадто US-центричні.
Можна проглянути хайлайти на початку кожного з розділів, зручно.
Новини 2023 року (наприклад, GPT-4) в цей звіт не потрапили.
Читайте також: 100 most cited AI papers in 2022
400 сторінок статистики про індустрію AI. Багато графіків, буде корисно при підготовці тематичних звітів та презентацій.
Найцікавіші розділи — про R&D та економіку, про бенчмарки і етику теж цікаві, про policy та education занадто US-центричні.
Можна проглянути хайлайти на початку кожного з розділів, зручно.
Новини 2023 року (наприклад, GPT-4) в цей звіт не потрапили.
Читайте також: 100 most cited AI papers in 2022
👍46🤔5❤2
Знайомі фаундери проходили цю програму за моєю рекомендацією і давали потім позитивні відгуки. Подавайтесь, для кого це релевантно, тут дають круті знання і можливості.
====
🟡StartUp Academy 3.0 — це онлайн-програма для фаундерів та С-level керівників стартапів про те, як управляти та масштабувати технологічні бізнеси. Учасники отримають:
▫️лекції та менторські сесії від засновників та топменеджерів глобальних бізнесів;
▫️до $110K негрошової підтримки у вигляді кредитів на користування хмарними сервісами, безоплатного доступу до продуктів, послуг та консультацій;
▫️можливість залучити інвестиції від найкращих венчурних фондів CEE
Минулого року п’ять бізнесів залучили інвестиції на суму від $100K до $1M.
🔖 Подати заявку можуть стартапи seed+ стадії розвитку із CEE. Для учасників з України зарезервовано 15% місць.
РЕЄСТРАЦІЯ
====
🟡StartUp Academy 3.0 — це онлайн-програма для фаундерів та С-level керівників стартапів про те, як управляти та масштабувати технологічні бізнеси. Учасники отримають:
▫️лекції та менторські сесії від засновників та топменеджерів глобальних бізнесів;
▫️до $110K негрошової підтримки у вигляді кредитів на користування хмарними сервісами, безоплатного доступу до продуктів, послуг та консультацій;
▫️можливість залучити інвестиції від найкращих венчурних фондів CEE
Минулого року п’ять бізнесів залучили інвестиції на суму від $100K до $1M.
🔖 Подати заявку можуть стартапи seed+ стадії розвитку із CEE. Для учасників з України зарезервовано 15% місць.
РЕЄСТРАЦІЯ

🔥24❤5👍1🤔1🤯1
Новини chip race.
Japan is expected to spend $7 billion on fab equipment next year, which would mark a 82% jump from this year — the largest in the world
В той час як США одним тільки Chips Act виділяють $280 млрд на розвиток chip manufacturing всередині країни на наступні роки.
До речі, саме про глобальну гонку чіпів ми записали подкаст, скоро вийде. Поки що переслухайте попередній випуск про LLMs.
Japan is expected to spend $7 billion on fab equipment next year, which would mark a 82% jump from this year — the largest in the world
В той час як США одним тільки Chips Act виділяють $280 млрд на розвиток chip manufacturing всередині країни на наступні роки.
До речі, саме про глобальну гонку чіпів ми записали подкаст, скоро вийде. Поки що переслухайте попередній випуск про LLMs.
Bloomberg.com
Japan to Spend $7 Billion on Chip Gear in 2024, the Biggest Spending Jump in World
Japan is poised to sharply raise its chip-gear spending in an attempt to boost its position in the global semiconductor market, as it tightens exports amid a US-led push to limit China’s tech ambitions.
👍34❤7
Сміявсь: SMMниця українського телеканалу нагенерувала купу фейкових фактів до дня народження Олеся Гончара і гарненько їх оформила. Контент-план виконано! От що буває, якщо не розбиратись як працюють LLM.
😁108🤯6🔥2🤬1