Forwarded from DLStories
ShiftViT: Visual Transformer без Attention (ну, почти visual transformer =) )
И снова исследователи стараются нам показать, что Attention — не панацея. Ученые из Microsoft Research взяли классическую архитектуру ViT (ну, почти классическую) и заменили в ней все слои Attention на слои Shift. В итоге получили сеть с меньшим количеством параметров и сравнимыми с ViT результатами на ImageNet.
Вот как работает ShiftViT:
Архитектура ShiftViT состоит из блоков (stages на первой картинке к посту). Как и в классическом ViT, входное изображение сначала разбивается на патчи и подается на вход первому блоку. Каждый из блоков далее состоит из двух частей: embedding generator и shift block. Embedding generator принимает на вход выход предыдущего блока и генерирует трехмерный тензор-ембеддинг размера (height, width, channels) для подачи на вход shift block. Shift block содержит три слоя: shift operation, layer norm и MLP.
Shift operation устроен очень просто: он берет на вход трехмерный тензор и "сдвигает" в нем несколько каналов вдоль разных осей на небольшое количество пикселей. Иллюстрация процедуры — на второй картинке к посту. Слой Shift не имеет обучаемых параметров: то, каким образом будут сдвигаться каналы входного тезнзора, полностью определяется гиперпараметрами. Из-за этого модель ShiftViT того же размера, что и классический ViT, имеет на ~33% меньше параметров, чем оригинальный ViT.
У ShiftViT, однако, есть еще одно небольшое отличие от ViT: во всех блоках, начиная со второго, авторы ShiftViT используют 2х2 convolution в качестве embedding generator. Еще одно доказательство, что свертки не канули в небытие, хехе.
Идея операции Shift понятна: с помощью сдвига каналов во входном тензоре и последующего применения MLP+свертки авторы добиваются обмена информации между разными частями исходного изображения. Такой суперупрощенный Attention получается.
Из-за того, что ShiftViT имеет меньше параметров, чем ViT, он должен работать быстрее. Учитывая, что ShiftViT получает сравнимые с ViT результаты на разных бенчмарках для задач классификации, детекции и сегментации, подход выглядит интересным. Однако грустно, что авторы сравнивали ShiftViT и ViT на ImageNet, но не на JFT-300M: известно, что главная фишка Трансформеров — хорошие результаты при обучении на огромном количестве данных. Интересно было бы посмотреть на результаты ShiftViT на JFT-300M: покажет ли он настолько же хорошую генерализацию.
P.S. Это не первая работа, где ученые пытаются выкинуть Attention из ViT и заменить чем-то попроще. Вот пример статьи, где Attention заменяли на обычный pooling и тоже получали хорошие результаты.
📄Статья
Продолжение темы про дипфейки: https://www.unite.ai/google-has-banned-the-training-of-deepfakes-in-colab/
Forwarded from DLStories
Бесплатные летние школы и конференции по искусственному интеллекту
Этим летом в России пройдут как минимум две научные школы и одна конференция по теме ИИ и deep learning:
1️⃣ Лето с AIRI: 4-недельная школа по ИИ для студентов и аспирантов. Участники проведут две недели с ведущими учёными из AIRI, МФТИ, ВШЭ, Сколтеха, University of Massachusetts Lowell, Mila Quebec AI Institute, МГТУ им. Баумана, РАН и других авторитетных научно-исследовательских организаций и ВУЗов. В программе — лекции, практические семинары, сореванования и воркшопы на разные темы ИИ: планирование поведения, обучение с подкреплением, нейросетевые методов анализа естественного языка, компьютерное зрение, объяснимые методы в искусственном интеллекте и т.п.
Где: Сочи, Сириус
Когда: 4-17 июля 2022
Дедлайн подачи заявки: 1 июня 2022
2️⃣ Летняя конференция AIRI. В продолжение летней школы AIRI проведет конференцию о современных результатах в области построения предиктивных моделей машинного обучения с учетом физико-математических моделей процессов. Проводится совместно с организаторами научных школ машинного обучения (SMILES, Евгений Бурнаев) и глубокого обучения и байесовских методов (Deep Learning and Bayesian Methods, Дмитрий Ветров).
Где: Сочи, Сириус
Когда: 18-26 июля 2022
Дедлайн подачи заявки: 12 июня 2022
3️⃣ Научная школа по экспериментальной и теоретической нейробиологии "Сложные нейронные сети и когнитивно специализированные нейроны". На школе будет цикл лекций и семинаров ведущих ученых о новых достижениях в экспериментальной и теоретической нейробиологии, а также неформальные обсуждения ключевых проблем исследований мозга. Приглашаются студенты, аспиранты и молодые ученые, интересующиеся экспериментальной и теоретической нейробиологией.
Где: Ингушетия, Армхи
Когда: 17-24 июля 2022
Дедлайн подачи заявки: 5 июня 2022
Forwarded from Python Tasks & ML | Задачи по питону и машинному обучению
В VK стартовал набор в Академию больших данных MADE — это бесплатное обучение для специалистов с опытом в разработке.
👉 Регистрируйтесь до 6 августа: https://vk.cc/ceWlaM
Программа длится один год, но будьте готовы к серьезной нагрузке: занятия займут 25–40 часов в неделю. За это время вы сможете повысить свой профессиональный уровень или освоить новое направление в IT.
Что вас ждёт:
🔹Много практики и работа над реальными проектами.
🔹Преподаватели — ведущие эксперты в области Data Science. Например, несколько дисциплин ведёт Сергей Николенко, автор бестселлера «Глубокое обучение» и создатель курсов в СПбГУ, НИУ ВШЭ и Harbour Space University.
🔹Профессиональное сообщество, где преподаватели, выпускники и слушатели делятся знаниями, общаются и помогают в решении сложных задач.
Для поступления нужно сдать экзамены по математике и программированию, пройти соревнование по машинному обучению и анкетирование.
Forwarded from Мишин Лернинг
🎥 YouTube лекция: DeepMind's Perceiver and Perceiver IO: new data family architecture
Лекция от DeepMind и Stanford про одну из важнейших архитектур 2021го года — Perceiver & Perceiver IO
Latent is all you need, как говорится..
Архитектура Perceiver IO от deepmind: — трансформер-генералист. Его можно использовать для огромного количества задач как в CV так и в NLP.
То есть архитектура Perceiver IO подходит для обработки изображений, текста, аудио, видео и их комбинаций!
📇 Perceiver 📄 Perceiver IO
👉 https://youtu.be/wTZ3o36lXoQ
YouTube
Stanford CS25: V1 I DeepMind's Perceiver and Perceiver IO: new data family architecture
A central goal of artificial intelligence is to build systems that can flexibly process all the world's data, but current neural network architectures are designed to handle essentially one data configuration. This includes models like 2D convnets and more…
https://4pda.to/2022/07/17/401519/petvation_umnaya_dver_dlya_zhivotnykh_s_funktsiej_skanirovaniya_lits/
Компания Petvation предложила миру умную дверь для животных, способную распознавать лица зарегистрированных питомцев, предотвращая доступ посторонним. Проект оказался весьма популярным и собрал на Kickstarter почти 100 000 долларов, чего достаточно для начала массового производства.
Компания Petvation предложила миру умную дверь для животных, способную распознавать лица зарегистрированных питомцев, предотвращая доступ посторонним. Проект оказался весьма популярным и собрал на Kickstarter почти 100 000 долларов, чего достаточно для начала массового производства.
4PDA - Новости мира мобильных устройств
Petvation — умная дверь для животных с функцией сканирования лиц - 4PDA
● Судей в Китае обязали использовать ИИ. Верховный суд КНР обязал судей при принятии решений консультироваться с ИИ. Прокуратура страны также использует нейросети для оценки доказательств и опасности подозреваемого для общества. »»»
legal.report
Судей в Китае обязали использовать искусственный интеллект - legal.report
Верховный суд КНР обязал судей при принятии решений консультироваться с искусственным интеллектом
Forwarded from Курсы Data Science
Канал DS_edu_courses сделал гайд по бесплатным/недорогим курсам для начинающих свой путь в профессию Data Science.
Пользуйтесь сами, делитесь с друзьями, пишите в комментариях, какие курсы можно еще добавить в этот список.
- Математика, статистика:
Основы математики для цифровых профессий. Яндекс
Математика для поступающих в магистратуру. МФТИ
Линейная алгебра. CSC
Линейная алгебра. МФТИ
Математический анализ (часть 1). CSC
Математический анализ (часть 2). CSC
Основы математического анализа. МФТИ
Теория вероятностей (часть 1). CSC
Теория вероятностей (часть 2). CSC
Теория вероятностей – наука о случайности (часть 1). ТГУ
Теория вероятностей – наука о случайности (часть 2). ТГУ
Основы статистики (часть 1). Институт биоинформатики
Основы статистики (часть 2). Институт биоинформатики
Основы статистики (часть 3). Институт биоинформатики
Математическая статистика. CSC
Прикладной статистический анализ. ВШЭ
Статистика для анализа данных. ВШЭ
Эконометрика. ВШЭ
- Алгоритмы:
Алгоритмы: теория и практика. Методы. CSC
Алгоритмы: теория и практика. Структуры данных. CSC
Подготовка к алгоритмическому собеседованию. Яндекс
- Python:
Программирование на Python. Институт биоинформатики
Python: основы и применение. Институт биоинформатики
"Поколение Python": курс для начинающих. BEEGEEK
"Поколение Python": курс для продвинутых. BEEGEEK
Python-разработка для начинающих. Нетология
Основы Python. Хекслет
Python для извлечения и обработки данных. ВШЭ
Python для искусственного интеллекта. МФТИ
Data Science: будущее для каждого. Нетология
Практикум по математике и Python. Степик
Основы Pandas для начинающих. Степик
Практикум по Pandas. Степик
- R:
Анализ данных в R (часть 1). Институт биоинформатики
Анализ данных в R (часть 2). Институт биоинформатики
Основы программирования на R. Институт биоинформатики
R для лингвистов: программирование и анализ данных. ВШЭ
- Базы данных:
Интерактивный тренажер по SQL. ДВФУ
Оконные функции SQL. Степик
Введение в SQL и работу с базой данных. Нетология
Свободное погружение в СУБД. CSC
Базы данных. СПбГУ
Упражнения по SQL
- ML:
Введение в Data Science и машинное обучение. Институт биоинформатики
Машинное обучение. ОмГТУ
Быстрый старт в искусственный интеллект. МФТИ
Анализ данных на практике. МФТИ
Основы машинного обучения. ВШЭ
- Нейронные сети:
Нейронные сети. Институт биоинформатики
Введение в искусственные нейронные сети. ОмГТУ
Специальные архитектуры нейронных сетей. ОмГТУ
Нейронные сети и компьютерное зрение Samsung
Нейронные сети и обработка текста. Samsung
Анализ текстовых данных. ВШЭ
Компьютерное зрение. ВШЭ
- Другое:
Hadoop. Система для обработки больших объемов данных. VK
Введение в Linux. Институт биоинформатики
Введение в Git. Хекслет
Основы Git. Степик
Основы командной строки. Хекслет
Инженер облачных сервисов. Яндекс
Excel для работы. Яндекс
Поддержать канал донатом
OpenCV будет поддерживать распознавание лиц, но видимо это будет каким-то платным сервисом https://opencv.org/opencv-face-recognition/
Forwarded from Градиентное погружение (Максим Герасимов)
Kaggle Accelerator
Ещё неделю назад заметил новую фичу на Kaggle, помимо конфигураций P100 (16 гб), TPU v3-8, теперь доступны T4×2 (15 + 15 гб видеопамяти).
P100 они не заменят и будут уступать, но позволят:
1) При должном желании (сложно) запускать 2 эксперимента вместо одного, при этом недельная квота GPU (30-40 часов) общая для T4×2 и P100, а это дополнительные гпу часы.
2) Ускорить инференс/обучение (в некоторых случаях).
3) Тюнить параметры параллельно.
4) Запускать большие модели (до 30 гб).
Кажется что это самый большой плюс.
Да, все ещё неудобно, но лучше чем zero-offload.
Training using 2 T4 with Pytorch DataParallel
Single-Machine Model Parallel Best Practices
Российский стартап Аватар Машина выпустил генеративного чатбота-психолога с искусственным интеллектом Sabina AI. Бот работает в Telegram, и мгновенно генерирует полные и развернутые ответы на заданную психологическую проблему или ситуацию, описанную пользователем. Sabina AI ведет логичный и связный разговор в узком домене психологических тематик: она готова обсудить тревоги, проблемы в отношениях, страхи и фобии, самооценку и личное развитие.
https://neurohive.io/ru/gotovye-prilozhenija/sabina-ai-chatbot/
https://neurohive.io/ru/gotovye-prilozhenija/sabina-ai-chatbot/
Neurohive - Нейронные сети
Российский стартап представил чатбота-психолога Sabina AI
Российский стартап Аватар Машина выпустил генеративного чатбота-психолога с искусственным интеллектом Sabina AI.
Forwarded from DLStories
Помните, были дипфейки раньше популярны? На их основе еще всякие мошенники делали картинки/видео с разными людьми и деньги вымогали.
Нас ждет новое поколение дипфейков, основанное на диффузионных моделях, способных изменять картикни. Например, на тех, о которых выше были посты. Подобные модели ужекачественно меняют детали изображений, а через пару месяцев-лет, верю, докрутят еще получше.
Встает вопрос: как от этого защититься? Как сделать так, чтобы из селфи из инстаграма не нагенерили дипфейков?
Исследователи из MIT занялись этой проблемой и сделали тулзу, которая добавляет к вашей картинке небольшой шум и делает так, что вашу картинку не получится изменить, используя диффузионную модель. Короче, они изобрели adversarial attack на диффузионные модели. Общая иллюстрация идеи — на картинке к посту.
Атака работает привычным нам способом. Модель для измнения картинок — это обычная text-to-image диффузия с condition’ом в виде картинки, которую нужно изменить. Есть два варианта атаки на такую модель: атака только на механизм condition и атака на всю систему целиком.
- Атака на condition mechanism. Идея: мы пытаемся так несильно изменить входящее изображение, чтобы его эмбеддинг был как можно ближе к эмбеддингу случайной картинки. Это заставляет tetx-to-image модель игнорировать детали входящей картинки и генерировать абсолютно новую картинку, основываясь только на тексте. Пример работы — 2 картинка к посту.
- Атака на всю сеть. Это обычная adversarial attack по типу FGSM с единственным нюансом: градиенты считаются только на последних четырех шагах диффузии. Но этого оказывается достаточно, чтобы сломать процесс изменения картинки. Пример работы этой атаки — на 3 картинке к посту.
Ограничения такого подхода такие же, что и у любых adversarial атак:
- работает для конкретной модели, т.е. white-box;
- требует довольно большого количества памяти (но работает при этом довольно быстро)
Ссылки:
- Блогпост от MIT.
Позащищать свои селфи перед загрузкой в запрещеннограм:
- Код на GitHub.
Forwarded from эйай ньюз
The Unreasonable Effectiveness of Fully-Connected Layers for Low-Data Regimes
Вернемся к обучению сеток. Эта статья предлагает простой трюк, чтобы выжать еще несколько процентов точности на маленьких датасетах. Бесплатно (почти) и без смс.
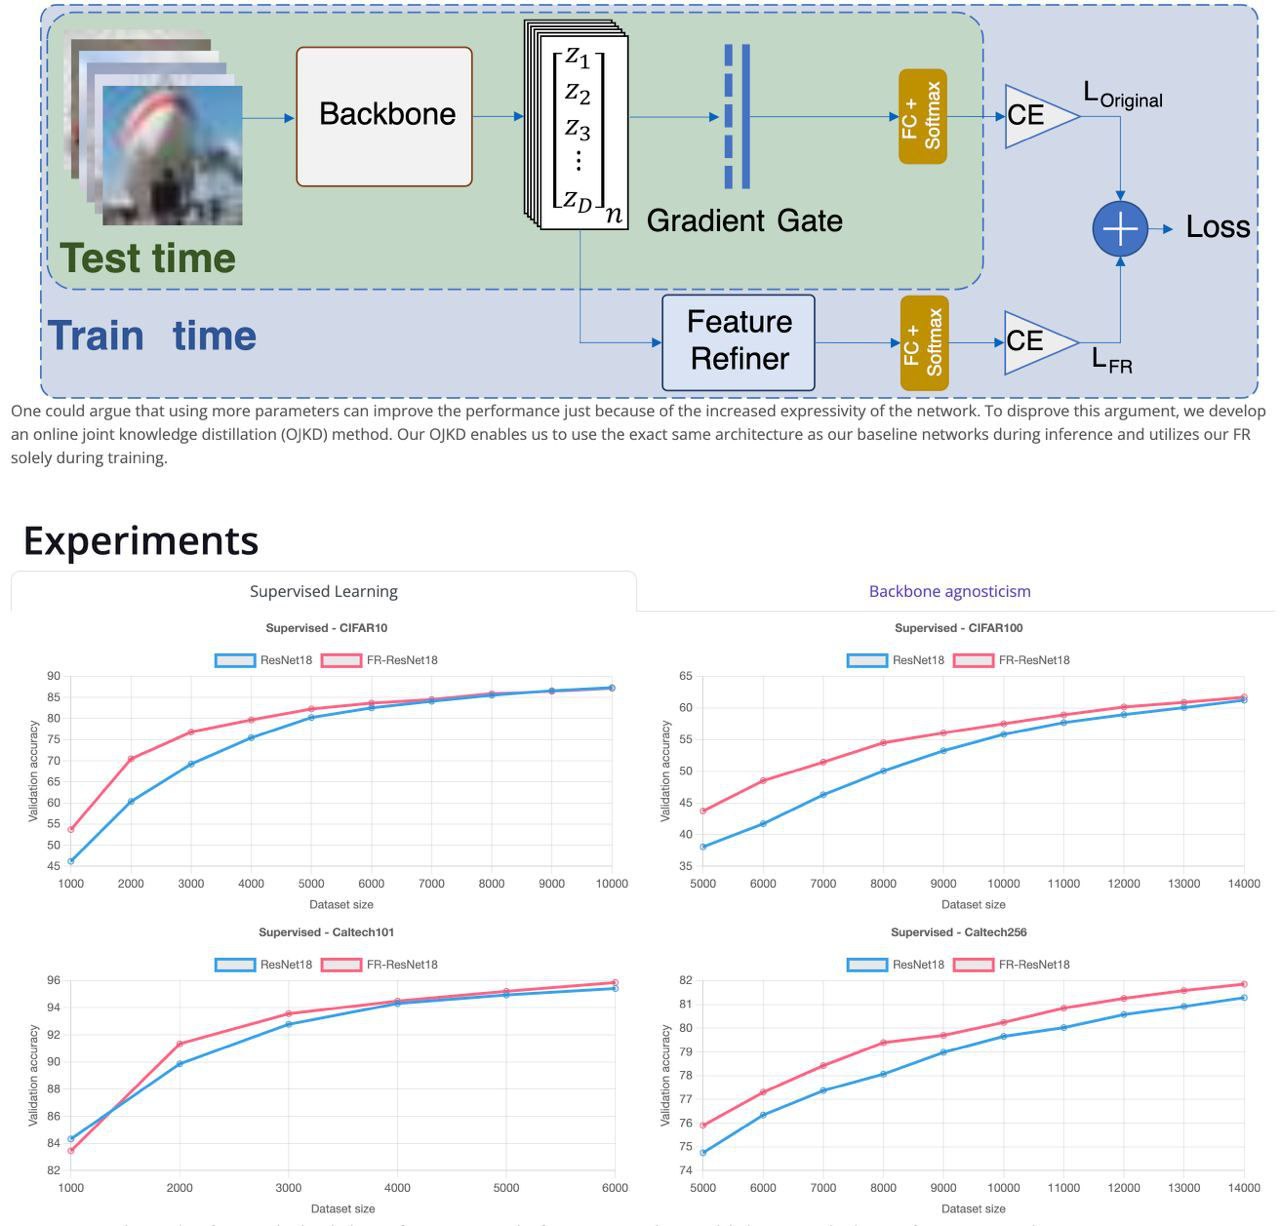
Суть такая: Прилепим к вашему резнету (подставь любое имя) дополнительную одну голову с тремя полносвязными слоями (Feature Refiner + FC + Softmax на картинке). А во время тренировки будем вычислять лосс на двух головах, которые решают одну и ту же задачу. С той лишь разницой, что через голову (с двумя доп. слоями) мы пускаем градиенты по всей сети, а через оригинальную мелкую голову мы обучаем только саму мелкую голову.
Таким образом, жирная голова выдирает более глубокие фичи и обучает всю сеть, а мелкая голова просто учится подстраивать свои веса к текущей репрезентации сети, при этом не меняя веса самой сети. А во время теста, мы выбрасываем жирную голову и используем только мелкую, то есть скорость предсказания не увеличивается. Поразительно, но это метод дает халявный прирост в точности (1-5%) классификации на датасетах с ограниченным размером данных, таких как CIFAR и Caltech.
❱❱ Arxiv
@ai_newz
Forwarded from Александра Дунаева
Небольшая методичка по выбору о оценке моделей машинного обучения https://arxiv.org/pdf/1811.12808.pdf
Forwarded from Machine learning Interview
Подробнная статья о собеседование инженера-программиста по машинному обучению в Google. Собеседование действительно сложное. Вопросы комплексные и специфичные для Google и охватывают широкий круг тем.
Правильная подготовка может иметь большое значение и может помочь вам получить работу по машинному обучению в таких компаниях как Google. В статье приведено полное руководство по прохождению интервью, чтобы помочь вам максимально увеличить ваши шансы на успех.
@machinelearning_interview
Please open Telegram to view this post
VIEW IN TELEGRAM
Forwarded from эйай ньюз
Хорошая новость для тех, кто не попал на NeurIPS. Скоро стартует курс по диффузионным моделям от Hugging Face 🔥.
А 30 ноября (завтра) его откроют докладами от крутых чуваков - создателей Stable Diffusion (Stability + Runwayml) и Make-a-Video (Meta AI).
Зарегаться можно тут.
@ai_newz
А 30 ноября (завтра) его откроют докладами от крутых чуваков - создателей Stable Diffusion (Stability + Runwayml) и Make-a-Video (Meta AI).
Зарегаться можно тут.
@ai_newz
Forwarded from эйай ньюз
ТОРЧ МУЛЬТИМОДАЛЬНЫЙ
Meta AI выкатила на NeurIPS новую либу TorchMultimodal для тренировки SOTA мультимодалтьных и мультитаск моделей по типу CLIP, FLAVA, data2vec, Omnivore, и т.д.
Зачем? А затем что сейчас быстро растет интерес к моделям, которые понимают несколько типов ввода (текст, изображения, видео и аудио) и при необходимости используют это понимание для создания выходных данных различных форм (текст, изображения, видео). И для их эффективной тренировки нужен набор готовых инструментов. На картинке список основных примитивов, которые предоставляет эта либа.
❱❱ Блог
❱❱ GitHub
@ai_newz