
OpenCV будет поддерживать распознавание лиц, но видимо это будет каким-то платным сервисом https://opencv.org/opencv-face-recognition/
Forwarded from Градиентное погружение (Максим Герасимов)
Kaggle Accelerator
Ещё неделю назад заметил новую фичу на Kaggle, помимо конфигураций P100 (16 гб), TPU v3-8, теперь доступны T4×2 (15 + 15 гб видеопамяти).
P100 они не заменят и будут уступать, но позволят:
1) При должном желании (сложно) запускать 2 эксперимента вместо одного, при этом недельная квота GPU (30-40 часов) общая для T4×2 и P100, а это дополнительные гпу часы.
2) Ускорить инференс/обучение (в некоторых случаях).
3) Тюнить параметры параллельно.
4) Запускать большие модели (до 30 гб).
Кажется что это самый большой плюс.
Да, все ещё неудобно, но лучше чем zero-offload.
Training using 2 T4 with Pytorch DataParallel
Single-Machine Model Parallel Best Practices
Российский стартап Аватар Машина выпустил генеративного чатбота-психолога с искусственным интеллектом Sabina AI. Бот работает в Telegram, и мгновенно генерирует полные и развернутые ответы на заданную психологическую проблему или ситуацию, описанную пользователем. Sabina AI ведет логичный и связный разговор в узком домене психологических тематик: она готова обсудить тревоги, проблемы в отношениях, страхи и фобии, самооценку и личное развитие.
https://neurohive.io/ru/gotovye-prilozhenija/sabina-ai-chatbot/
https://neurohive.io/ru/gotovye-prilozhenija/sabina-ai-chatbot/
Neurohive - Нейронные сети
Российский стартап представил чатбота-психолога Sabina AI
Российский стартап Аватар Машина выпустил генеративного чатбота-психолога с искусственным интеллектом Sabina AI.
Forwarded from DLStories
Помните, были дипфейки раньше популярны? На их основе еще всякие мошенники делали картинки/видео с разными людьми и деньги вымогали.
Нас ждет новое поколение дипфейков, основанное на диффузионных моделях, способных изменять картикни. Например, на тех, о которых выше были посты. Подобные модели ужекачественно меняют детали изображений, а через пару месяцев-лет, верю, докрутят еще получше.
Встает вопрос: как от этого защититься? Как сделать так, чтобы из селфи из инстаграма не нагенерили дипфейков?
Исследователи из MIT занялись этой проблемой и сделали тулзу, которая добавляет к вашей картинке небольшой шум и делает так, что вашу картинку не получится изменить, используя диффузионную модель. Короче, они изобрели adversarial attack на диффузионные модели. Общая иллюстрация идеи — на картинке к посту.
Атака работает привычным нам способом. Модель для измнения картинок — это обычная text-to-image диффузия с condition’ом в виде картинки, которую нужно изменить. Есть два варианта атаки на такую модель: атака только на механизм condition и атака на всю систему целиком.
- Атака на condition mechanism. Идея: мы пытаемся так несильно изменить входящее изображение, чтобы его эмбеддинг был как можно ближе к эмбеддингу случайной картинки. Это заставляет tetx-to-image модель игнорировать детали входящей картинки и генерировать абсолютно новую картинку, основываясь только на тексте. Пример работы — 2 картинка к посту.
- Атака на всю сеть. Это обычная adversarial attack по типу FGSM с единственным нюансом: градиенты считаются только на последних четырех шагах диффузии. Но этого оказывается достаточно, чтобы сломать процесс изменения картинки. Пример работы этой атаки — на 3 картинке к посту.
Ограничения такого подхода такие же, что и у любых adversarial атак:
- работает для конкретной модели, т.е. white-box;
- требует довольно большого количества памяти (но работает при этом довольно быстро)
Ссылки:
- Блогпост от MIT.
Позащищать свои селфи перед загрузкой в запрещеннограм:
- Код на GitHub.
Forwarded from эйай ньюз
The Unreasonable Effectiveness of Fully-Connected Layers for Low-Data Regimes
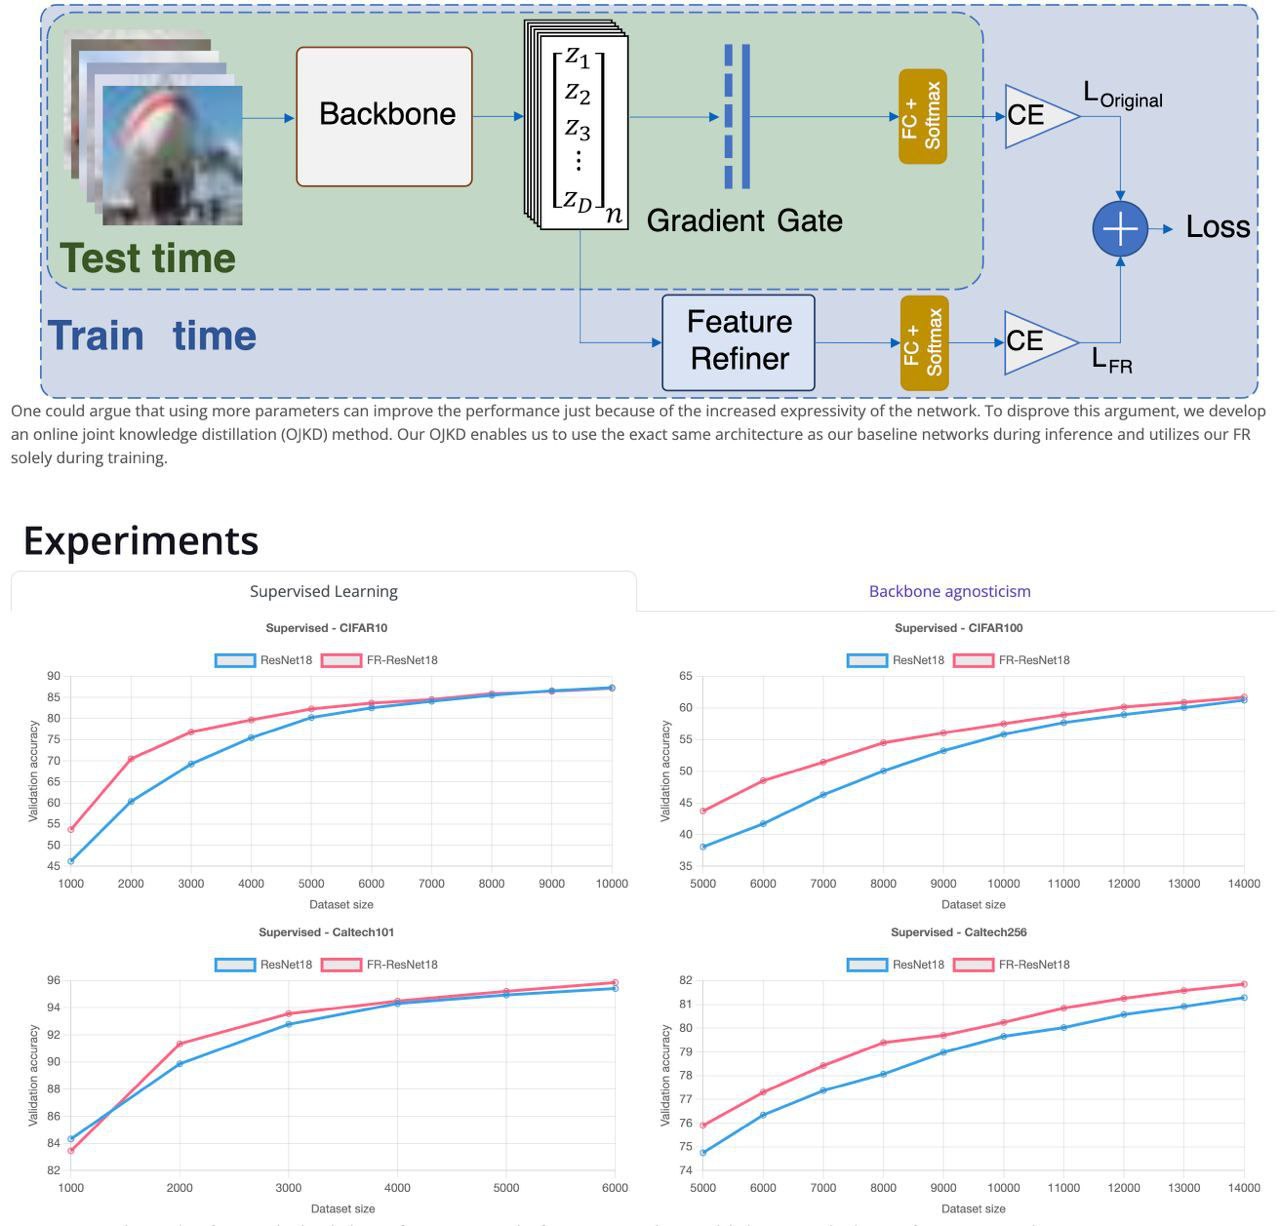
Вернемся к обучению сеток. Эта статья предлагает простой трюк, чтобы выжать еще несколько процентов точности на маленьких датасетах. Бесплатно (почти) и без смс.
Суть такая: Прилепим к вашему резнету (подставь любое имя) дополнительную одну голову с тремя полносвязными слоями (Feature Refiner + FC + Softmax на картинке). А во время тренировки будем вычислять лосс на двух головах, которые решают одну и ту же задачу. С той лишь разницой, что через голову (с двумя доп. слоями) мы пускаем градиенты по всей сети, а через оригинальную мелкую голову мы обучаем только саму мелкую голову.
Таким образом, жирная голова выдирает более глубокие фичи и обучает всю сеть, а мелкая голова просто учится подстраивать свои веса к текущей репрезентации сети, при этом не меняя веса самой сети. А во время теста, мы выбрасываем жирную голову и используем только мелкую, то есть скорость предсказания не увеличивается. Поразительно, но это метод дает халявный прирост в точности (1-5%) классификации на датасетах с ограниченным размером данных, таких как CIFAR и Caltech.
❱❱ Arxiv
@ai_newz
Forwarded from Александра Дунаева
Небольшая методичка по выбору о оценке моделей машинного обучения https://arxiv.org/pdf/1811.12808.pdf
Forwarded from Machine learning Interview
Подробнная статья о собеседование инженера-программиста по машинному обучению в Google. Собеседование действительно сложное. Вопросы комплексные и специфичные для Google и охватывают широкий круг тем.
Правильная подготовка может иметь большое значение и может помочь вам получить работу по машинному обучению в таких компаниях как Google. В статье приведено полное руководство по прохождению интервью, чтобы помочь вам максимально увеличить ваши шансы на успех.
@machinelearning_interview
Please open Telegram to view this post
VIEW IN TELEGRAM
Forwarded from эйай ньюз
Хорошая новость для тех, кто не попал на NeurIPS. Скоро стартует курс по диффузионным моделям от Hugging Face 🔥.
А 30 ноября (завтра) его откроют докладами от крутых чуваков - создателей Stable Diffusion (Stability + Runwayml) и Make-a-Video (Meta AI).
Зарегаться можно тут.
@ai_newz
А 30 ноября (завтра) его откроют докладами от крутых чуваков - создателей Stable Diffusion (Stability + Runwayml) и Make-a-Video (Meta AI).
Зарегаться можно тут.
@ai_newz
Forwarded from эйай ньюз
ТОРЧ МУЛЬТИМОДАЛЬНЫЙ
Meta AI выкатила на NeurIPS новую либу TorchMultimodal для тренировки SOTA мультимодалтьных и мультитаск моделей по типу CLIP, FLAVA, data2vec, Omnivore, и т.д.
Зачем? А затем что сейчас быстро растет интерес к моделям, которые понимают несколько типов ввода (текст, изображения, видео и аудио) и при необходимости используют это понимание для создания выходных данных различных форм (текст, изображения, видео). И для их эффективной тренировки нужен набор готовых инструментов. На картинке список основных примитивов, которые предоставляет эта либа.
❱❱ Блог
❱❱ GitHub
@ai_newz
Forwarded from Machine learning Interview
Какие актуальные инструменты нужны для развития в Data Science?
🔥 5 декабря в 18:00 пройдет открытый урок онлайн-курса «Machine Learning. Professional» в OTUS.
➖ Тема: «Один в поле не воин: методы ансамблирования в машинном обучении» — https://otus.pw/IhUZ/
Кому подходит этот урок:
🟠 IT-специалистам которые хотят освоить продвинутые методы ML и перейти в Data Science
🟠 Дата-сайентистам, желающим углубиться в профессию
🟠 Тем, кто самостоятельно изучает Data Science и уже изучил основы ML
⚠️ На занятии вы узнаете основные подходы к ансамблированию, которые сегодня используют в ML, изучите устройство наиболее популярных методов ансамблирования (Bagging, Random Forest, Boosting) и примените их на практике.
🟡 Пройдите вступительный тест, чтобы записаться на урок
https://otus.pw/IhUZ/
Кому подходит этот урок:
⚠️ На занятии вы узнаете основные подходы к ансамблированию, которые сегодня используют в ML, изучите устройство наиболее популярных методов ансамблирования (Bagging, Random Forest, Boosting) и примените их на практике.
https://otus.pw/IhUZ/
Please open Telegram to view this post
VIEW IN TELEGRAM
Forwarded from Yandex for ML
🧠 3-4 декабря Яндекс проведет YaTalks — свою главную конференцию для IT-сообщества. Программа состоит из четырех тематических треков — про мобайл, бэкенд, фронтенд и, конечно, ML. На конференции выступят более 100 экспертов из международных и российских компаний.
Программа трека про машинное обучение очень насыщенная.
🔹 Например, Алексей Гусаков расскажет о том, как развивался ML в Яндексе и как в компании взаимодействуют R&D и бизнес.
🔹 Спикеры из Яндекса, СберМаркета, Ozon и SupportAI подискутируют о роли ML в электронной коммерции.
🔹 Стоит послушать дискуссию и про модную тему генерации изображений нейросетями — как они работают, какие возможности открывают и как изменят работу дизайнеров и иллюстраторов.
🔹 Сергей Орешков из MaritimeAI поднимет тему нестандартного применения ML — в экомониторинге: он расскажет, как нейросети, например, помогают отслеживать чистоту Байкала.
🔹 Наконец, нельзя пропустить доклад про нейродубляж: Сергей Дуканов, руководитель команды перевода видео Яндекса, расскажет, как работает технология нейросетевого закадрового перевода, разработанная в Яндексе.
Кстати, благодаря нейросетевому переводу, трансляцию YaTalks можно будет смотреть в прямом эфире как на русском, так и на английском языках.
Кроме докладов будут и другие форматы: random coffee, питчинги opensource-проектов и индивидуальные консультации с экспертами, с которыми можно обсудить новые технологии, профессиональное развитие в IT, работу с командой и многое другое.
👉 Чтобы принять участие в конференции, нужно зарегистрироваться.
Forwarded from эйай ньюз
Media is too big
VIEW IN TELEGRAM
Вышло обновление для Quest Pro, теперь там можно делать вот такие крутые Mixed Reality штуки.
Особенно эффектно выглядит рисование.
@ai_newz
Особенно эффектно выглядит рисование.
@ai_newz
Forwarded from Reactor Live
Google разработала переводчик почерка медработников
Новая функция станет частью утилиты Google Lens, которая уже встроена в поисковую систему. Чтобы понять врачебные каракули, нужно сфотографировать текст, а искусственный интеллект «переведёт», что именно там написано.
Создатели программы консультировались с фармацевтами всего мира. Пока перевод доступен только для языка хинди.
Forwarded from Типичный программист
Годнота для программистов на удалёнке: ИИ от NVIDIA помогает подглядывать в шпаргалки на онлайн-собеседованиях
NVIDIA наконец-то опубликовала исходники нейросети MAXINE, которая перерисовывает ваши глаза так, чтобы они всегда смотрели в камеру. Что удобно, это происходит в режиме реального времени.
В действительности ваши глаза могут бегать по экрану, читать нужный ответ со шпаргалки во время экзамена или собеседования в IT-компанию мечты. Или, к примеру, вы можете сидеть на созвоне с коллегами, но заниматься своими делами, пока виртуальный вы будете смотреть в камеру с очень заинтересованным взглядом.
Рассказываем, что за нейросеть. И показываем, как ей воспользоваться прямо на вашем ПК: https://tproger.ru/articles/ii-ot-nvidia-pomogaet-podgljadyvat-v-shpargalki-na-onlajn-sobesedovanijah/
#нейросети #собеседование #ии