
DSML.KZ Новости
Разбор задач виртуального собеседования t.me/main_ds_kz/889 flexiquiz.com/SC/N/c247d732-bc8e-42ca-a9f1-8df8d6ea264c Первые задачи приведем почти без комментариев, а верный ответ выделим жирным. Также приведена частота выбора того или иного ответа по последним…
Разбор задач виртуального собеседования
t.me/main_ds_kz/889
flexiquiz.com/SC/N/c247d732-bc8e-42ca-a9f1-8df8d6ea264c
Часть II.
5. Функция активации (1 балл)
Какие из перечисленных функций активации могут быть использованы в выходном слое нейронной сети, если мы хотим получить на выходе вероятности n классов p1, p2..pn (n > 2), так чтобы их сумма была равно 1?
- Softmax (74%)
- ReLu (7%)
- Sigmoid (19%)
- Tanh (0%)
6. Tf-idf (1 балл)
Дана коллекция документов:
1) 'TF-IDF - статистическая мера, используемая для оценки важности слова в контексте документа, являющегося частью коллекции документов или корпуса'
2) 'TF (term frequency — частота слова) - это отношение числа вхождений некоторого
слова к общему числу слов данного документа
3) 'IDF (inverse document frequency - это обратная частота документа) — инверсия частоты, с которой некоторое слово встречается в документах коллекции'
4) Иными словами, IDF - это логарифм отношения общего числа документов к числу документов с этим словом и 0. Если это же слово не встречалось, tf-idf равно нулю.'
5) 'Мера TF-IDF является произведением двух сомножителей: TF и IDF'
Пусть мы привели все слова к нижнему регистру и натренировали tf-idf на данной коллекции.
У какого из слов нового документа
''таким образом, tf idf важная статистическая мера документа"
самое большое значение tf-idf?
Варианты ответов
- таким (9%)
- образом (0%)
- tf (4%)
- idf (26%)
- важная (9%)
- статистическая (39%)
- мера (0%)
- документа (13%)
Solution code snippet
idf: 0.341
tf: 0.341
документа: 0.405
мера: 0.488
статистическая: 0.605
7. Честная монета (1 балл)
Подкидывают 10 честных монет (орел и решка равновероятны).
Какова вероятность, что все они упадут орлом?
Answer: (0.5) ** 10 = 0.0009766
Остальные задачи ждите в следующих постах
t.me/main_ds_kz/889
flexiquiz.com/SC/N/c247d732-bc8e-42ca-a9f1-8df8d6ea264c
Часть II.
5. Функция активации (1 балл)
Какие из перечисленных функций активации могут быть использованы в выходном слое нейронной сети, если мы хотим получить на выходе вероятности n классов p1, p2..pn (n > 2), так чтобы их сумма была равно 1?
- Softmax (74%)
- ReLu (7%)
- Sigmoid (19%)
- Tanh (0%)
6. Tf-idf (1 балл)
Дана коллекция документов:
1) 'TF-IDF - статистическая мера, используемая для оценки важности слова в контексте документа, являющегося частью коллекции документов или корпуса'
2) 'TF (term frequency — частота слова) - это отношение числа вхождений некоторого
слова к общему числу слов данного документа
3) 'IDF (inverse document frequency - это обратная частота документа) — инверсия частоты, с которой некоторое слово встречается в документах коллекции'
4) Иными словами, IDF - это логарифм отношения общего числа документов к числу документов с этим словом и 0. Если это же слово не встречалось, tf-idf равно нулю.'
5) 'Мера TF-IDF является произведением двух сомножителей: TF и IDF'
Пусть мы привели все слова к нижнему регистру и натренировали tf-idf на данной коллекции.
У какого из слов нового документа
''таким образом, tf idf важная статистическая мера документа"
самое большое значение tf-idf?
Варианты ответов
- таким (9%)
- образом (0%)
- tf (4%)
- idf (26%)
- важная (9%)
- статистическая (39%)
- мера (0%)
- документа (13%)
Solution code snippet
dataset = [
    'TF-IDF - статистическая мера, используемая для оценки важности слова в контексте документа, являющегося частью коллекции документов или корпуса',
    'TF (term frequency — частота слова) - это отношение числа вхождений некоторого слова к общему числу слов данного документа',
    'IDF (inverse document frequency - это обратная частота документа) — инверсия частоты, с которой некоторое слово встречается в документах коллекции',
    'Иными словами, IDF - это логарифм отношения общего числа документов к числу документов с этим словом и 0. Если это же слово не встречалось, tf-idf равно нулю.',
    'Мера TF-IDF является произведением двух сомножителей: TF и IDF'
]
test_sentenses = ["таким образом, tf idf важная статистическая мера документа"]

from sklearn.feature_extraction.text import TfidfVectorizer
vectorizer = TfidfVectorizer(lowercase=True)
vectorizer.fit(dataset)
transformed = vectorizer.transform(test_sentenses)
best_word_idx = transformed.argmax()
output = vectorizer.get_feature_names_out()[best_word_idx]
for idx, value in zip(transformed.indices, transformed.data):
    print(f'{vectorizer.get_feature_names_out()[idx]}: {value:.3f}')
Code snippet Output:idf: 0.341
tf: 0.341
документа: 0.405
мера: 0.488
статистическая: 0.605
7. Честная монета (1 балл)
Подкидывают 10 честных монет (орел и решка равновероятны).
Какова вероятность, что все они упадут орлом?
Answer: (0.5) ** 10 = 0.0009766
Остальные задачи ждите в следующих постах
🔥17👍1👏1
Разбор задач виртуального собеседования
t.me/main_ds_kz/889
flexiquiz.com/SC/N/c247d732-bc8e-42ca-a9f1-8df8d6ea264c
Часть III. Основы теории вероятности и статистики
t.me/main_ds_kz/889
flexiquiz.com/SC/N/c247d732-bc8e-42ca-a9f1-8df8d6ea264c
Часть III. Основы теории вероятности и статистики
🔥11👏2👍1
Разбор задач виртуального собеседования
t.me/main_ds_kz/889
flexiquiz.com/SC/N/c247d732-bc8e-42ca-a9f1-8df8d6ea264c
Часть IV. Код
Реккурентная последовательность (1 балл)
Пусть последовательность задана следующим образом:
a[1] = 1
a[2] = 7
a[k] = a[k-1] + a[k-2], k > 2
Найдите сумму цифр 2019го члена данной последовательности
(Забавный факт: сумма цифр 2019 числа Фиббоначи равна 2018)
Code Snippet
Посчитайте число простых чисел, меньших чем число 201920190, в записи которых нет цифры 7
Решение
По сути просто гуглим алгоритм решета Эрастофена и немного адоптируем под нашу задачу
Например:
geeksforgeeks.org/python-program-for-sieve-of-eratosthenes/
Интуиция алгоритма: перебирать простые числа и сразу вычеркивать все кратные ему из списка претендентов. Каждую следующую итерацию начинать с наименьшего из претендентов.
Code snippet
На этом разбор первого раунда виртуального собеседования подходит к конце, ставьте огоньки, репостите задачки тем, кто проходит собесы и ждите следующего раунда ;)
t.me/main_ds_kz/889
flexiquiz.com/SC/N/c247d732-bc8e-42ca-a9f1-8df8d6ea264c
Часть IV. Код
Реккурентная последовательность (1 балл)
Пусть последовательность задана следующим образом:
a[1] = 1
a[2] = 7
a[k] = a[k-1] + a[k-2], k > 2
Найдите сумму цифр 2019го члена данной последовательности
(Забавный факт: сумма цифр 2019 числа Фиббоначи равна 2018)
Code Snippet
def fibbonaci(n_iter: int, prev: int = 1, current: int = 1) -> int:Проверить забавный факт
if n_iter == 1:
return prev
if n_iter == 2:
return current
for _ in range(n_iter - 2):
prev, current = current, prev + current
return current
fib = fibbonaci(2019, 1, 7)
sum_digits = sum(map(int, str(fib)))
print(sum_digits)
190710
fib = fibbonaci(2019, 1, 1)Простые числа (3 балла)
sum_digits = sum(map(int, str(fib)))
print(sum_digits)
2018
Посчитайте число простых чисел, меньших чем число 201920190, в записи которых нет цифры 7
Решение
По сути просто гуглим алгоритм решета Эрастофена и немного адоптируем под нашу задачу
Например:
geeksforgeeks.org/python-program-for-sieve-of-eratosthenes/
Интуиция алгоритма: перебирать простые числа и сразу вычеркивать все кратные ему из списка претендентов. Каждую следующую итерацию начинать с наименьшего из претендентов.
Code snippet
def find_prime_numbers(num):4033301
prime = [True for i in range(num+1)]
p = 2
while (p * p <= num):
if (prime[p] == True):
for i in range(p * p, num+1, p):
prime[i] = False
p += 1
prime_numbers = [i for i in range(2, num+1) if prime[i] and '7' not in str(i)]
return prime_numbers
prime_numbers = find_prime_numbers(201920190)
len(prime_numbers)
На этом разбор первого раунда виртуального собеседования подходит к конце, ставьте огоньки, репостите задачки тем, кто проходит собесы и ждите следующего раунда ;)
Telegram
DSML KZ Новости
Лучшая подготовка к собеседованию - это другое собеседование!
Поэтому пока люди жалуются на свои университеты в опросе выше, сообщество Жана ДСМЛ запускают новую серию постов про вопросы с собеседований в дата саенс команды Казахстана
А начнем мы с компании…
Поэтому пока люди жалуются на свои университеты в опросе выше, сообщество Жана ДСМЛ запускают новую серию постов про вопросы с собеседований в дата саенс команды Казахстана
А начнем мы с компании…
🔥14👍1👏1
Какой вуз по вышеперечисленным отзывам вы бы выбрали?
Anonymous Poll
9%
- Университет 1
37%
- Университет 2
18%
- Университет 3
10%
- Университет 4
7%
- Университет 5
20%
- Университет 6
Лучший технический ВУЗ Казахстана по версии DSML kz
Этап 2 - Анонимные отзывы (часть 1)
Процедура
- выбираю с каждого университета по 5 случайных отзывов (random seed 42)
- информация не проверялась, авторская грамматика сохранена
Университет 1 - МУИТ (5 место)
Университет 2 - НУ (1 место)
Университет 3 - КБТУ (3 место)
Университет 4 - КФ МГУ (4 место)
Университет 5 - Astana IT University (6 место)
Университет 6 - СДУ (2 место)
Сырые данные по отзывам (180 отзывов):
https://docs.google.com/spreadsheets/d/17tFevNI1XqX6hz5jsLOTubrEOaQyvgUz9fBKbmN2z7M/edit?usp=sharing
Google Docs
university_responses
❤3
Лучший технический вуз Казахстана. Раунд 3: неанонимное голосование
Final Results
6%
КФ МГУ
4%
МУИТ
26%
КБТУ
27%
НУ
15%
AITU
22%
СДУ
Публикуем результаты нашего маленького исследования про лучший технический вуз Казахстана в 2022 году по версии сообщества Дата Саенс Казахстан.
Напоминаю, что исследование проходило в 3 этапа:
1 этап. Сравнение университетов по отзывов самих студентов и выпускников на базе 180 отзывов с которыми можно ознакомиться по ссылке ниже:
https://docs.google.com/spreadsheets/d/17tFevNI1XqX6hz5jsLOTubrEOaQyvgUz9fBKbmN2z7M/edit?usp=sharing
2 этап. Открытое анонимное голосование, где респондентам предлагалось выбрать лучший университет на основании 5 случайных отзывов (не зная самих универов)
3 этап Открытое неанонимное голосование (1740 голосов)
Помимо финальных итогов снова приложил таблицу 1го этапа, который как по мне содержит большее количество инсайтов
🔥25👍5😁1
DSML.KZ Новости
Лучшая подготовка к собеседованию - это другое собеседование! Поэтому пока люди жалуются на свои университеты в опросе выше, сообщество Жана ДСМЛ запускают новую серию постов про вопросы с собеседований в дата саенс команды Казахстана А начнем мы с компании…
Виртуальное собеседование на позицию ML Engineer
Спасибо всем, кто поучаствовал в нашем 1 этапе виртуального собеседования. Попробовали свои силы 70 человек, из которых 20 его успешно преодолели! Я надеюсь это было интересно и хоть немного позновательно.
Дальнейшие туры предполагают больший акцент на беседу, поэтому больше такого интерактива как в первом туре у нас не получится. Тем не менее, я подготовил пул задач, используемых во время очного этапа собеседования (60-90 минут). Спустя неделю или две я приведу их решения, а пока можете взять листочек с бумагой и вновь проверить свои силы!
1) Комбинаторика и ТВ (с @m1ckyro5a)
- посчитайте вероятность того, что среди 5 подбрасываний честной монетки будет ровно 1 орел.
- посчитайте вероятность того, что первый орел выпадет на четном подбрасывании
- оцените вероятность что сумма чисел после броска 2 игральных кубиков будет 5
- Оценка максимального правдоподобия:
Дано распределение
Оцените параметр альфа методом максимального правдоподобия
2) Метрики и ТВ (с @m1ckyro5a)
- На острове буйствует загадочный вирус, которым болеют 10% населения острова. Местные предприниматели подготовили прибор, который с ошибается с 10% вероятностью (как для болеющих - так и для не болеющих). Какая вероятность того, что пациент реально болен, если прибор показал положительный результат?
- Какие метрики качества вы бы предложили для оценки эффективности данного прибора?
3.1) Алгоритмы джуниор-миддл (с неким @sneddy)
Есть 2 строки, посчитайте сколько минимум символов нужно добавить или убавить, чтобы они стали анаграммами
На выходе ожидается функция, принимающая 2 строки и выдающая ответ за разумные асимптотики по времени
3.2) Алгоритмы синьор (с неким @sneddy)
Напишите класс, который при инициализации получает число n и поддерживает команды
- put(self, a:float) -> None - добавить число в структуру
- get() -> float - выдать текущее произведение последних n добавленных чисел
Follow-up:
Напишите класс, который поддерживает команды
- put(self, a:float) -> None - добавить число в структуру
- get(self, k) -> float - выдать текущее произведение последних k добавленных чисел
На выходе ожидаются структуры с разумными асимптотиками на время и память, корректно работающие на различных корнер кейсах
Решения в комментариях приветствуются! Но большая просьба не забыть поставить спойлер:
- Ctrl + Shift + P
- или правой кнопкой мыши Formatting -> Spoiler)
Обещаю давать фидбек в течение суток)
Спасибо всем, кто поучаствовал в нашем 1 этапе виртуального собеседования. Попробовали свои силы 70 человек, из которых 20 его успешно преодолели! Я надеюсь это было интересно и хоть немного позновательно.
Дальнейшие туры предполагают больший акцент на беседу, поэтому больше такого интерактива как в первом туре у нас не получится. Тем не менее, я подготовил пул задач, используемых во время очного этапа собеседования (60-90 минут). Спустя неделю или две я приведу их решения, а пока можете взять листочек с бумагой и вновь проверить свои силы!
1) Комбинаторика и ТВ (с @m1ckyro5a)
- посчитайте вероятность того, что среди 5 подбрасываний честной монетки будет ровно 1 орел.
- посчитайте вероятность того, что первый орел выпадет на четном подбрасывании
- оцените вероятность что сумма чисел после броска 2 игральных кубиков будет 5
- Оценка максимального правдоподобия:
Дано распределение
X = alpha / x^alphaи наблюдения 3,4,5
Оцените параметр альфа методом максимального правдоподобия
2) Метрики и ТВ (с @m1ckyro5a)
- На острове буйствует загадочный вирус, которым болеют 10% населения острова. Местные предприниматели подготовили прибор, который с ошибается с 10% вероятностью (как для болеющих - так и для не болеющих). Какая вероятность того, что пациент реально болен, если прибор показал положительный результат?
- Какие метрики качества вы бы предложили для оценки эффективности данного прибора?
3.1) Алгоритмы джуниор-миддл (с неким @sneddy)
Есть 2 строки, посчитайте сколько минимум символов нужно добавить или убавить, чтобы они стали анаграммами
На выходе ожидается функция, принимающая 2 строки и выдающая ответ за разумные асимптотики по времени
3.2) Алгоритмы синьор (с неким @sneddy)
Напишите класс, который при инициализации получает число n и поддерживает команды
- put(self, a:float) -> None - добавить число в структуру
- get() -> float - выдать текущее произведение последних n добавленных чисел
Follow-up:
Напишите класс, который поддерживает команды
- put(self, a:float) -> None - добавить число в структуру
- get(self, k) -> float - выдать текущее произведение последних k добавленных чисел
На выходе ожидаются структуры с разумными асимптотиками на время и память, корректно работающие на различных корнер кейсах
Решения в комментариях приветствуются! Но большая просьба не забыть поставить спойлер:
- Ctrl + Shift + P
- или правой кнопкой мыши Formatting -> Spoiler)
Обещаю давать фидбек в течение суток)
👍43🔥11🕊2
Виртуальное собеседование на позицию ML Engineer
Решение. Часть 1.
1) Комбинаторика и ТВ (с @m1ckyro5a)
1.1. посчитайте вероятность того, что среди 5 подбрасываний честной монетки будет ровно 1 орел.
Решение: вероятность наступления 5 независимых событий - их произведение то есть (1/2)^5
1.2 посчитайте вероятность того, что первый орел выпадет на четном подбрасывании
Решение:
- вероятность 2го орла = вероятность 1й решка а второй орел = (1/2)^2
- вероятность 2k-го орла - (1/2)^(2k) = (1/4)^k
- вероятность четного орла: сумма геометрической прогрессии со знаменателем 1/4: a_0 / (1 - d) = (1/4) / (1 - 1/4) = 1/3
1.3 оцените вероятность что сумма чисел после броска 2 игральных кубиков будет 5
Решение:
Подходящие исходы: <1,4>; <2,3>; <3,2>;<4,1>
Всего исходов: 6*6.
Ответ: 4/36=1/9
1.4 Оценка максимального правдоподобия
Решение от @sultanyaril
L(a) = a / (3 ^ a) * a / (4 ^ a) * a / (5 ^ a) = a^3 / 60^a;
lnL(a) = lna^3 - ln60^a = 3 lna - a ln60
dlnL(a)/da = 3/a - ln60 = 0 -> a = 3/ln60 = 0.73272
2) Метрики и ТВ (с @m1ckyro5a)
Задача на формулу Байеса, условия были стырены из блога Дъяконова - там же можно найти и решение.
В вопросе о метриках хотелось бы услышать вопросы о балансе между False Positive и False Negative ошибках. Например если лечение очень дорогое и болезненное то FP ошибки оч нежелательны, если же ход болезни очень тяжел - то FN.
Самый популярный ошибочный ответ - AUC ROC который совсем не подходит потому что данная метрика может быть расчитана когда модель выдает некоторую вероятность или скор. В случае же бинарного предикта как в нашем случае (есть болезнь или нет) AUC ROC не имеет особого смысла. Подходят любые вариации ф-скора скошенного в сторону либо пресижена либо рекола в зависимости от ответов на наводящие вопросы выше.
3.1) Алгоритмы джуниор-миддл (с неким @sneddy)
Есть 2 строки, посчитайте сколько минимум символов нужно добавить или убавить, чтобы они стали анаграммами
Решение:
По сути задание на внимательность, знание структуры данных хэш и синтаксиса питона
В целом хотелось увидеть любое верное решение эффективнее чем через лист за квадрат
Например забить обе строки в dict отображающий символ в каунт, затем вычесть из каждого уникального каунта первого дикта каунт из второго.
Популярная ошибка: не учесть что уникальный символ может встретиться во второй строке, но не встретиться в первой.
Если использовать Counter задача превратащается в однострочник - поэтому мы просили не использовать ничего из библиотеки collections
from typing import Dict
def build_dict(input_str: str) -> Dict[str, int]:
    output_dict = {}
    for elem in input_str:
        if elem not in output_dict:
            output_dict[elem] = 0
        output_dict[elem] += 1
    return output_dict
def anagram_distance(s1: str, s2: str) -> int:
    d1 = build_dict(s1)
    d2 = build_dict(s2)
    diff = 0
    for elem, count in d1.items():
        diff += abs(count - d2.get(elem, 0))
    for elem, count in d2.items():
        if elem not in d1:
             diff += count
     return diff
👍11🔥2
Виртуальное собеседование на позицию ML Engineer
Решение. Часть 2.
3.2) Алгоритмы синьор (с неким @sneddy)
В первом случае нам заранее известно произведение скольких чисел нужно хранить. Поэтому в качестве хранилища будем использовать очередь размера n. После каждой операции пут в случае превышения очередью размера n мы будем выкидывать ее первое значение.
Также будем хранить текущее ненулевое произведение последних n чисел, которое обновляется после каждой операции put (умножить на новое число и поделить на первое число в очереди если она переполнилась). Тогда для выполнения гет нам нужно лишь возвращать это текущее произведение.
Самое популярное пространство для бага - не учесть что логика немного ломается в случае добавления нуля. Как вариант можно хранить отдельно количество нулей в очереди и если они есть в get отдавать 0, а как только они заканчиваются - выдавать текущее ненулевое произведение
Follow-up:
В этом случае придется хранить всё, вопрос только в каком виде. Как вариант можно хранить в обычном листе кумулятивные произведения от 1 элемента массива до текущего. В таком случае чтобы ответить на запрос get(self, k) достаточно выдать отношение кумулятивного произведения последнего элемента и -(k+1)-го.
Также в случае хранения кумулятивных произведений возникает опасность численного переполнения. Она может быть решена с некоторой вычислительной ошибкой хранением не самих произведений чисел а его логарифма Тогда кумулятивные произведения перейдут в кумулятивные суммы логарифмов, а отношение произведений - к разности сумм.
Код последний задачи я не приложил - но надеюсь что моего объяснения будет достаточно, чтобы внимательный читатель мог его воспроизвести
👍4🔥3
Еженедельный Субботний Онлайн Дата Завтрак
Место: Наш дискорд сервер Ссылка: discord.gg/dMuEsU3h
Канал: Data Breakfast
Время: 12:00 по каз. времени
Приходите, обсудим дата топики, карьеру, просто пообщаемся
Краткое саммари прошлого дата бранча
- Макс @myxik вновь рассказывал почему NU не оч
- обсудили с кем стоит сравнивать с NU: с другими универами или с министерствами
- обсудили элитарность казахстанских школ
- обсудили сокращения в бтсд
- выпуск авторского шоу Рената Алимбекова разоблачение нехороших людей
👍18🔥6🕊5
Kolesa Group 8 октября проведут Kolesa Conf 2022 — масштабнейшую IT-конференцию этой осени!
В этом году офлайн-конференция будет платной, но будет доступна бесплатная прямая трансляция.
Data — один из 4 потоков конференции. С докладами выступят 10+ крутых специалистов из разных IT-компаний. Среди них:
• Data-аналитики Kolesa Group Ануар Уахитов, Асылжан Акынова и Дина Мукашева расскажут про:
- то, как использовать данные для увеличения чувствительности A/B-теста;
- создание синтетической контрольной группы с помощью Propensity Score Matching;
- аналитику при запуске нового продукта.
• CDO Kaspi Bank Думан Уватаев выступит с докладом «NLP Трансформеры: «Мен сізді жақсы түсінемін».
• Data Science teem lead и Project Manager Beeline Казахстан Саян Омаров и Мерей Балгабаев поделятся кейсом, как они внедряют решение видеоаналитики для своих офисов продаж.
Регистрация
https://bit.ly/3QIszzJ
🔥29
DSML Circle Jerk
Я думаю, вы знаете, что делать:
- добавлять друг друга в линкедине и эндорсить ds-related скиллы
- добавлять друг друга в инстаграмме и ставить друг другу огоньки в историях
- знакомиться вживую, если живете друг с другом в одном городе и пить пиво
- кидать друг другу донаты в онлифанс
docs.google.com/spreadsheets/d/1FHj4ihO0LcproYK4gfOIDsVzyie5lg5rSS-jUaW0Mnk/edit?usp=sharing
Я думаю, вы знаете, что делать:
- добавлять друг друга в линкедине и эндорсить ds-related скиллы
- добавлять друг друга в инстаграмме и ставить друг другу огоньки в историях
- знакомиться вживую, если живете друг с другом в одном городе и пить пиво
docs.google.com/spreadsheets/d/1FHj4ihO0LcproYK4gfOIDsVzyie5lg5rSS-jUaW0Mnk/edit?usp=sharing
👍27🔥8❤🔥4👏1
Еженедельный Субботний Онлайн Дата Завтрак
Место: Наш дискорд сервер Ссылка: https://discord.gg/cdDuACus
Канал: Data Breakfast
Время: 12:00 по каз. времени
Приходите, обсудим дата топики, карьеру, просто пообщаемся
Краткое саммари прошлого дата бранча
- Обсудили надобность магистратуры в ДС: зачем она нужна, кто с какой целью туда идет и что хочет получить на выходе?
- Обсудили облака и где работать лучше всех в облаках
- Разговаривали про местных агашек и ДС: почему им тяжело платить ДСерам хорошо и причем здесь студентики
- Обсудили поиск вакансий на удаленку
- Обсудили налоги в Казахстане по сравнению с другими странами
- Выпуск авторского шоу Рената Алимбекова: разоблачения нехороших людей
Discord
Discord - A New Way to Chat with Friends & Communities
Discord is the easiest way to communicate over voice, video, and text. Chat, hang out, and stay close with your friends and communities.
🔥10👍1
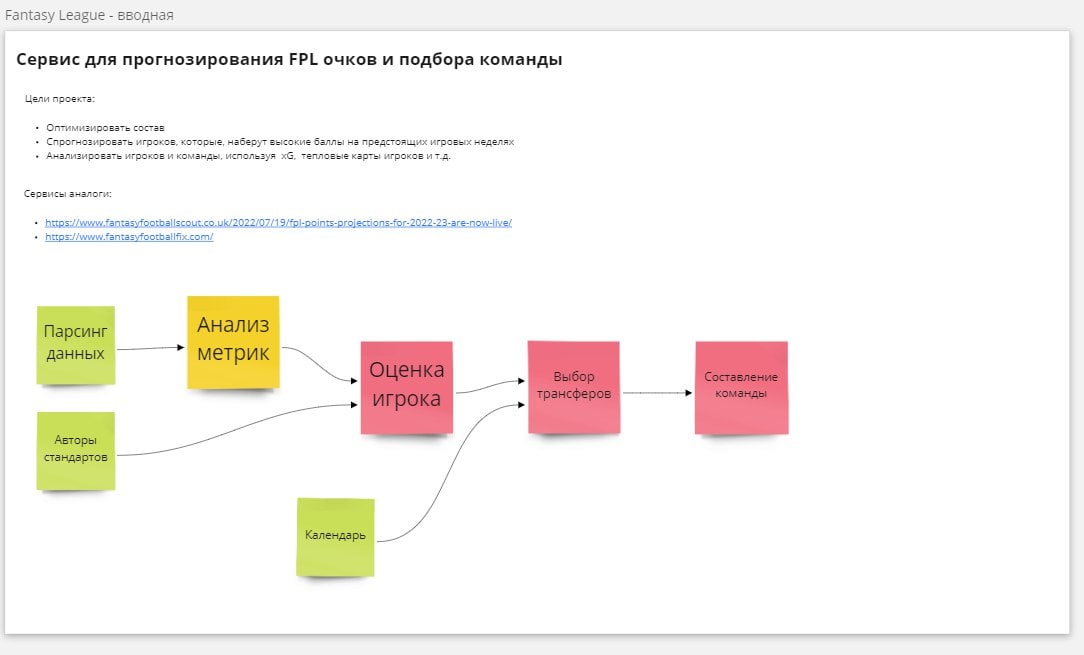
Пет проект по прогнозирования FPL очков и подбора команды (футбол)
Лохид просил, и @alimbekovkz сделал
Мы хотим с сделать по проект прогнозирования фэнтази очков АПЛ.
Цели проекта:
- Оптимизировать состав
- Спрогнозировать игроков, которые, наберут высокие баллы на предстоящих игровых неделях
- Анализировать игроков и команды, используя xG, тепловые карты игроков и т.д.
Кто может участвовать?
Все желающие
Что нужно делать?
Парсить данные, визуализировать, придумывать как оценивать игроков
Что нужно сделать?
Написать @alimbekovkz, он создаст группу, чатик, даст доступ в MIRO и т.д.
DSML Футбол: https://t.me/dsml_football
MIRO доска с идеями проекта:
https://miro.com/app/board/uXjVOTowBr4=/?share_link_id=647987850884
🔥10👍3