
Один символ, который ломает код
Видишь что-то подозрительное в этом участке кода?
Буква “a” - кириллическая, а не латинская .
Это пример homoglyph-атаки - визуального обмана, при котором используются визуально похожие символы (гомоглифы), но из разных кодировок. Часто используется в фишинге для регистрации доменов, реже - для компрометации исходного кода, чтобы ввести в заблуждение код-ревьюверов.
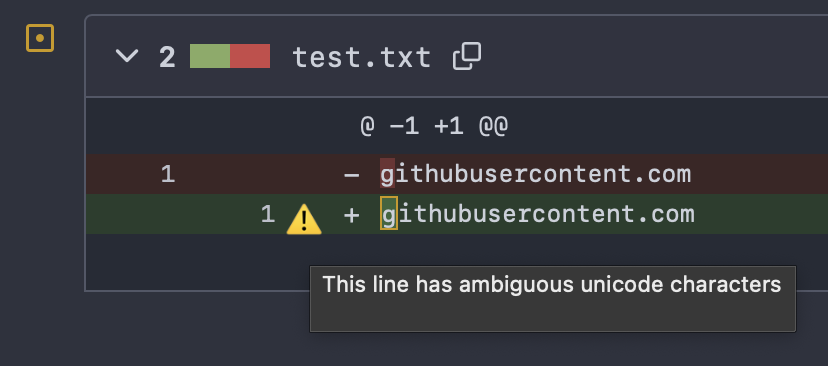
Недавно исследователь провел эксперимент для крупного проекта curl: отправил pull request, в котором помимо основного полезного кода были заменены ASCII-сиволы на их похожие Unicode-альтернативы. Никто из ревьюверов не заметил этих изменений.
С тех пор Github стал подсвечивать измененные символы, но если ревьювишь код, то на всякий случай попроси свою LLM посмотреть его на гомоглифы.
Видишь что-то подозрительное в этом участке кода?
user = "admin"
if user == "аdmin":
    grant_access()
Это пример homoglyph-атаки - визуального обмана, при котором используются визуально похожие символы (гомоглифы), но из разных кодировок. Часто используется в фишинге для регистрации доменов, реже - для компрометации исходного кода, чтобы ввести в заблуждение код-ревьюверов.
Недавно исследователь провел эксперимент для крупного проекта curl: отправил pull request, в котором помимо основного полезного кода были заменены ASCII-сиволы на их похожие Unicode-альтернативы. Никто из ревьюверов не заметил этих изменений.
С тех пор Github стал подсвечивать измененные символы, но если ревьювишь код, то на всякий случай попроси свою LLM посмотреть его на гомоглифы.
🔥8❤7🍌2💊2🌭1🏆1
Атака на Dependabot: внедрение вредоносного кода через Github-бота
Есть такой Dependabot - популярный бот на Github, который регулярно проверяет проекты на наличие устаревших зависимостей. Если он находит обновления, то создает pull request (PR), в котором предлагает внести изменения в код для обновления.
Есть разработчики - они обычно настраивают рабочий процесс так, чтобы автоматически объединять все PR от Dependabot. Проверка происходит через переменную
И есть злоумышленники. Они знают, что
* создает форк целевого репозитория, у которого разработчики выставили настройки автоматического приема PR от Dependabot;
* добавляет свой вредоносный код в основную ветку своего форка;
* активирует Dependabot в своем форке и добавляет какую-нибудь устаревшую зависимость, чтобы привлечь внимание бота. Dependabot создает свою ветку обновлений в форке, и поскольку она основана на основной ветке форка, то содержит вредоносный код злодея.
* создает PR в целевом репозитории жертвы, используя ветку бота
* и ничего не получается, ведь в созданном PR значение
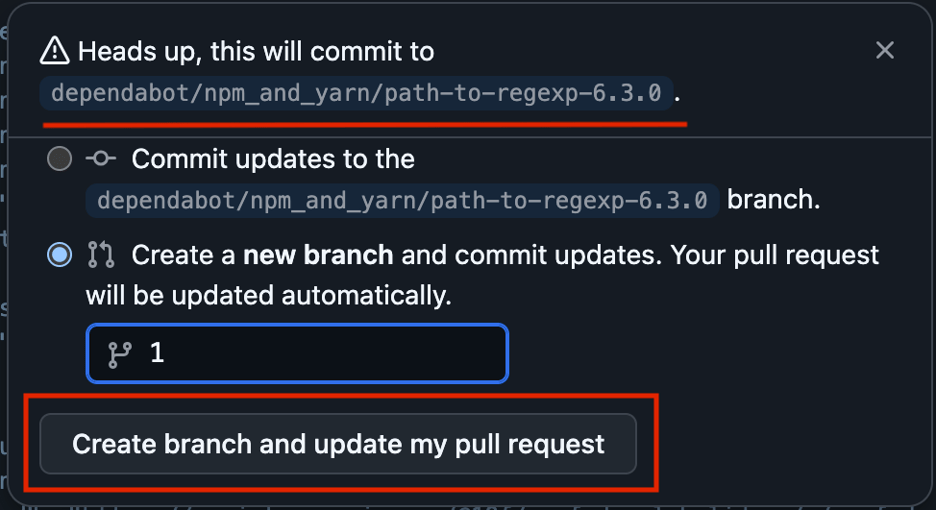
И вот на этом этапе происходит магия: когда Dependabot сам пересоздает и принудительно отправляет изменения, он становится «исполнителем» этого последнего события. Значение
PR с вредоносным кодом оказывается в целевом репозитории.
Нетривиальная атака. Поэтому попадает в коллекцию атак на разработчиков, о которой на следующей неделе расскажу на мероприятии IT IS Conf в Екатеринбурге.
Есть такой Dependabot - популярный бот на Github, который регулярно проверяет проекты на наличие устаревших зависимостей. Если он находит обновления, то создает pull request (PR), в котором предлагает внести изменения в код для обновления.
Есть разработчики - они обычно настраивают рабочий процесс так, чтобы автоматически объединять все PR от Dependabot. Проверка происходит через переменную
github.actor. Если ее значение = dependabot[bot], то происходит слияние кода. И есть злоумышленники. Они знают, что
github.actor не всегда указывает на того, кто изначально создал PR, и существует возможность для атаки confused deputy. Для этого злодей выполняет следующие действия:* создает форк целевого репозитория, у которого разработчики выставили настройки автоматического приема PR от Dependabot;
* добавляет свой вредоносный код в основную ветку своего форка;
* активирует Dependabot в своем форке и добавляет какую-нибудь устаревшую зависимость, чтобы привлечь внимание бота. Dependabot создает свою ветку обновлений в форке, и поскольку она основана на основной ветке форка, то содержит вредоносный код злодея.
* создает PR в целевом репозитории жертвы, используя ветку бота
* и ничего не получается, ведь в созданном PR значение
github.actor (инициатор) все еще принадлежит злодею, поэтому он возвращается к оригинальному PR от Dependabot и комментирует: @dependabot recreate
* Dependabot выполняет команду: пересоздает свою ветку и принудительно отправляет в нее изменения (force-push). Принудительная отправка изменений в ветку повторно запускает процесс слияния в целевом репозитории (репозитории-жертве). И вот на этом этапе происходит магия: когда Dependabot сам пересоздает и принудительно отправляет изменения, он становится «исполнителем» этого последнего события. Значение
github.actor меняется и условие для автослияния выполняется:if: ${{ github.actor == ‘dependabot[bot]’ }}
PR с вредоносным кодом оказывается в целевом репозитории.
Нетривиальная атака. Поэтому попадает в коллекцию атак на разработчиков, о которой на следующей неделе расскажу на мероприятии IT IS Conf в Екатеринбурге.
🔥7❤3🏆3✍1👍1🤯1
Материалы для погружения в AppSec
На связи Саша Чуфистов. По следам воркшопа, совместно с Денисом, мы собрали материалы для дальнейшего погружения в тему безопасности веб-приложений.
1. Теория и кейсы, с которых стоит начать практику:
* Фреймворк для автоматизации активной и пассивной разведки сэкономит часы ручной работы при поиске точек входа в исследуемое приложение.
* Много полезных oneliners для избавления от рутинных действий при поиске базовых уязвимостей вроде XSS или SSRF.
2. Практика:
* Для участников воркшопа я подготовил уязвимое приложение и готовый образ.
amd64:
arm64:
Также можно собрать его самостоятельно, по инструкции из данного репозитория.
3. Уязвимости, которые мы разбирали:
1. Полный гайд по xss.
2. Полный гайд по lfi.
3. Полный гайд по idor.
Если нужно больше практики, но вы еще не заглядывали на portswigger labs, то вы найдете там все, что было рассмотрено на воркшопе, и не только👉
На связи Саша Чуфистов. По следам воркшопа, совместно с Денисом, мы собрали материалы для дальнейшего погружения в тему безопасности веб-приложений.
1. Теория и кейсы, с которых стоит начать практику:
* Фреймворк для автоматизации активной и пассивной разведки сэкономит часы ручной работы при поиске точек входа в исследуемое приложение.
* Много полезных oneliners для избавления от рутинных действий при поиске базовых уязвимостей вроде XSS или SSRF.
2. Практика:
* Для участников воркшопа я подготовил уязвимое приложение и готовый образ.
amd64:
docker pull achuf/phd_workshop_app:latest
arm64:
docker pull achuf/phd_workshop_app_arm64:latest
Также можно собрать его самостоятельно, по инструкции из данного репозитория.
3. Уязвимости, которые мы разбирали:
1. Полный гайд по xss.
2. Полный гайд по lfi.
3. Полный гайд по idor.
Если нужно больше практики, но вы еще не заглядывали на portswigger labs, то вы найдете там все, что было рассмотрено на воркшопе, и не только
Please open Telegram to view this post
VIEW IN TELEGRAM
🔥6❤2👍2🏆1
Чтобы не заплыть в аналитике, роадмапах, продуктовых стратегиях, security-исследованиях и докладах собираем палатку, посуду, фонарик, любимый транспорт и выезжаем в оффлайн.
Если где-то поймаю связь и буду мерзнуть ночью, то подготовлю подборку материалов, которые изучим на следующей неделе. Бодрых выходных.
Если где-то поймаю связь и буду мерзнуть ночью, то подготовлю подборку материалов, которые изучим на следующей неделе. Бодрых выходных.
🔥6❤🔥4🏆3😎1
Makrushin
Если где-то поймаю связь и буду мерзнуть ночью
«Секретные» материалы, которые изучим на следующей неделе
Было холодно, поэтому подготовил подборку:
* Применение малых языковых моделей (SLM) для поиска секретов.
Доклад, в котором исследователи достигли точности 86% в задаче обнаружения секретов с помощью Llama 3.2 1B. Интересно изучить методологию и посмотреть бенчмарки.
* А этот пост уже про то, какие секреты удалось найти на Github. Месяц сканирования публичных репозиториев, новые типы секретов (связанные с ИИ-провайдерами) - новые находки старыми способами.
* В контексте архитектуры MCP (Model Context Protocol) секреты имеют новое значение. Можно забирать кейс для личных исследований.
* Велопоходное фото.
#дайджест
🔥9👍4🤣3🏆1
Повышение эффективности обнаружения секретов в коде
Год другой, но те же тактики: в 2025 украденные учетные записи являются главными “фигурантами” инцидентов. Атакующие все чаще используют учетки от “non-human identities” (NHI): секреты от всевозможных сервисных аккаунтов, ботов, ИИ-агентов. Один из ключевых источников, который хранит в себе эти секреты - код.
В 2020 году рассматривали методы для поиска секретов в коде. С тех пор, к анализу энтропии, регулярным выражениям и сигнатурам, которые часто ошибались и путали строку пароля с названием функции, добавились большие языковые модели (LLM). Но у LLM есть ключевое ограничение в задаче поиска секрета: они требуют значительных вычислительных ресурсов. Это приводит к значительным временным задержкам в процессе поиска.
Исследователи подтвердили гипотезу, что SLM эффективнее в этой задаче. Рецепт, который привел к 86% точности (выявленный секрет действительно является секретом) и 82% полноты (доля обнаруженных секретов от всех существующих секретов в коде):
1️⃣ готовим данные для обучения модели: с помощью LLM проводим обнаружение и классификация секретов из публичных Github-репозиториев. Можно использовать вторую LLM для оценки результата.
2️⃣ Для повышения качества полученного датасета применяем алгоритмы MinHash и LSH (Locality Sensitive Hashing) для кластеризации полученных данных: объединяем похожие фрагменты кода в один кластер и убираем дубликаты.
3️⃣ Выбираем модель, которую будем дообучать. Наша цель: не более 10 секунд на поиск секрета (доступный ресурс: однопоточная машинка с ARM). В качестве базовой модели для этого выбираем LLAMA-3.2-1B.
4️⃣ Добавляем наши “фильтры” к исходной модели: дообучаем небольшие матрицы внутри выбранной модели с помощью метода LoRA.
5️⃣ Охапку дров и плов готов:Оцениваем результаты: следим за совпадениями на уровне файла (есть ли в нем секреты?) и совпадениями на уровне секрета (какой это тип секрета?).
Полученный результат не отменяет эффективность сигнатурных методов. Модель работает как дополнение к существующим правилам.
Год другой, но те же тактики: в 2025 украденные учетные записи являются главными “фигурантами” инцидентов. Атакующие все чаще используют учетки от “non-human identities” (NHI): секреты от всевозможных сервисных аккаунтов, ботов, ИИ-агентов. Один из ключевых источников, который хранит в себе эти секреты - код.
В 2020 году рассматривали методы для поиска секретов в коде. С тех пор, к анализу энтропии, регулярным выражениям и сигнатурам, которые часто ошибались и путали строку пароля с названием функции, добавились большие языковые модели (LLM). Но у LLM есть ключевое ограничение в задаче поиска секрета: они требуют значительных вычислительных ресурсов. Это приводит к значительным временным задержкам в процессе поиска.
Исследователи подтвердили гипотезу, что SLM эффективнее в этой задаче. Рецепт, который привел к 86% точности (выявленный секрет действительно является секретом) и 82% полноты (доля обнаруженных секретов от всех существующих секретов в коде):
Полученный результат не отменяет эффективность сигнатурных методов. Модель работает как дополнение к существующим правилам.
Please open Telegram to view this post
VIEW IN TELEGRAM

🔥3🏆2
Поиск секретов в коде с помощью LLM: подход GitHub
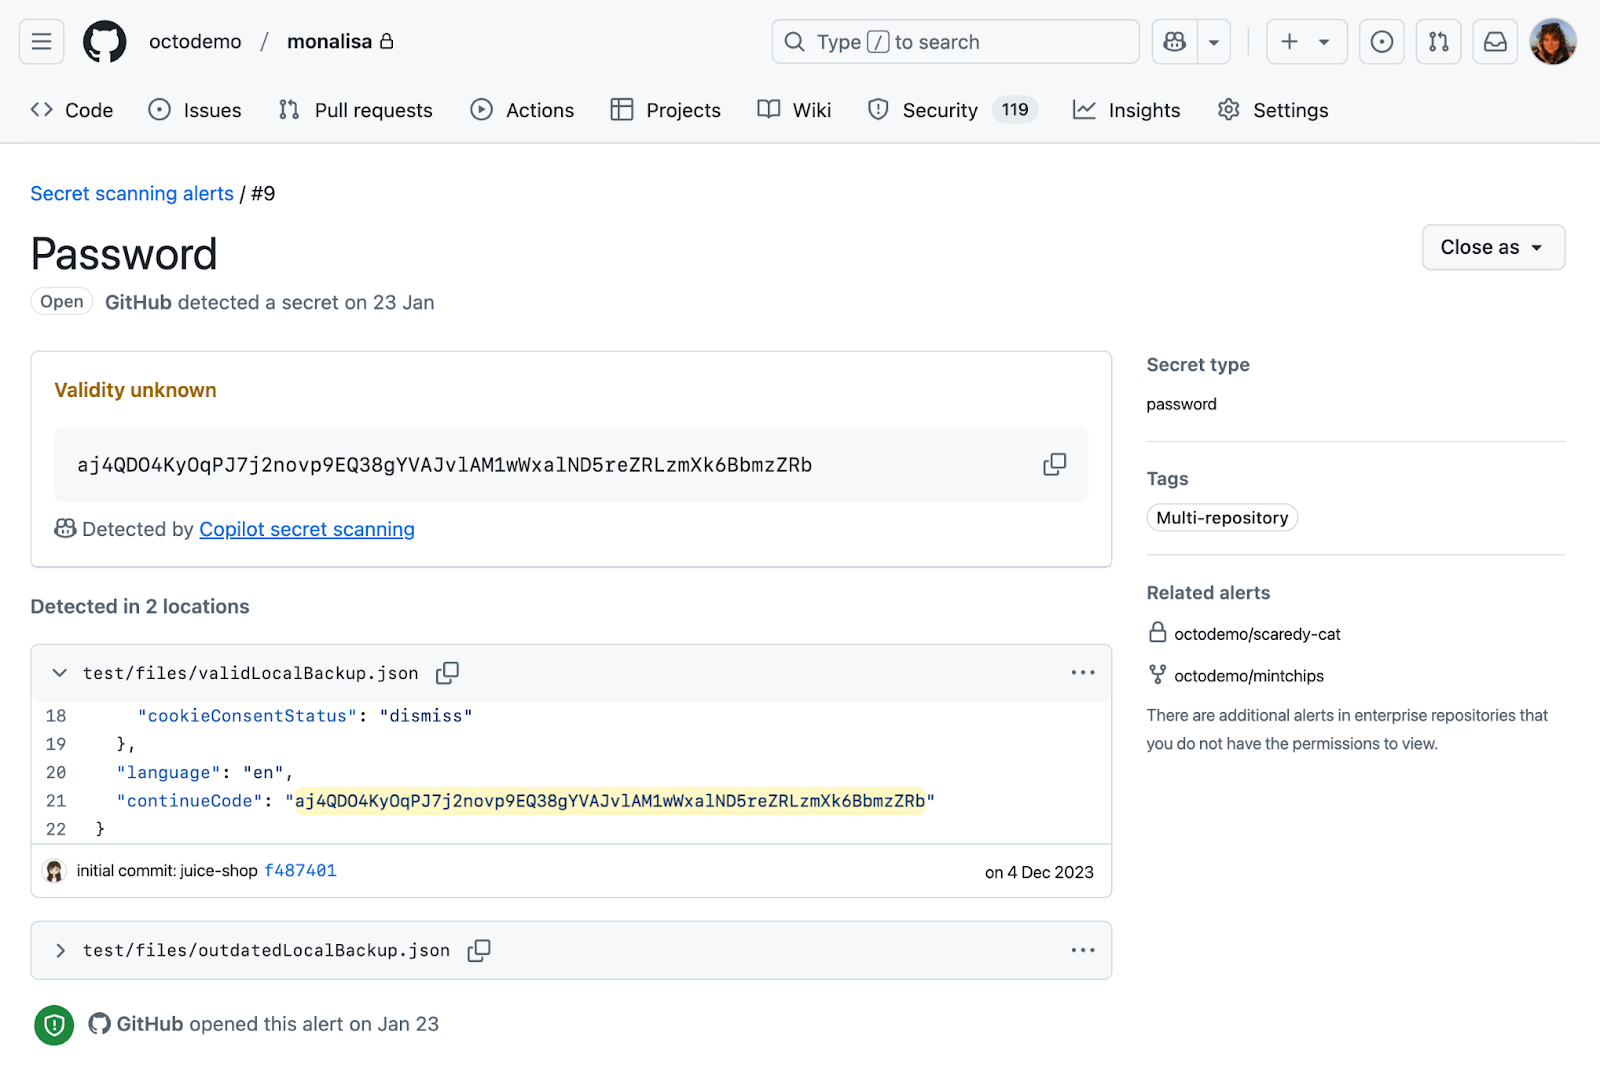
Исследователи Wiz пришли к выводу, что языковые модели лучше справляется с поиском секретов, чем традиционные регулярки. Исследователи команды GitHub тоже пришли к этому выводу, но только с помощью LLM.
Обычные регулярки хороши только там, где формат строк строго определен (ключи, API-токены), но не учитывают многообразие структур строк паролей. LLM снижает количество шума, потому что учитывает контекст. Ожидаемо, использование LLM требует линейного увеличения вычислительных ресурсов с каждым новым клиентом. И чтобы сэкономить немного ресурса, команде пришлось исключить из проверок все медиафайлы или файлы, которые содержали в названии “test”, “mock”, “spec”.
Если занимаешься поиском секретов в репозиториях, то из исследования можно позаимствовать следующие инсайты:
⭐️ Регулярные выражения - это база для выявления детерминированных строк, но она сильно шумит при поиске паролей.
⭐️ LLM снижает шум и хорошо справляются с задачей поиска за счет анализа контекста. При этом использовать LLM для активных и крупных репозиториев - дорого.
⭐️ Чтобы экономить ресурсы можно выбрать два пути: сокращать размер базы для анализа (как GitHub) или оптимизировать использование вычислительных ресурсов для анализа (как Wiz). Еще лучше использовать оба подхода.
⭐️ Стратегии подсказок (промптов) для LLM влияют на точность обнаружения и на количество потребляемых ресурсов. GitHub попробовал стратегии Zero-Shot (дать модели только задачу, без примеров), Chain-of-Thought (попросить модель прийти к ответу через цепочку рассуждений), Fill-in-the-Middle (дать контекст “до” и контекст “после”, затем попросить дополнить середину) и MetaReflection (после первого ответа модели попросить ее проанализировать и доработать собственный ответ). В итоге MetaReflection дала лучшую точность.
Исследователи Wiz пришли к выводу, что языковые модели лучше справляется с поиском секретов, чем традиционные регулярки. Исследователи команды GitHub тоже пришли к этому выводу, но только с помощью LLM.
Обычные регулярки хороши только там, где формат строк строго определен (ключи, API-токены), но не учитывают многообразие структур строк паролей. LLM снижает количество шума, потому что учитывает контекст. Ожидаемо, использование LLM требует линейного увеличения вычислительных ресурсов с каждым новым клиентом. И чтобы сэкономить немного ресурса, команде пришлось исключить из проверок все медиафайлы или файлы, которые содержали в названии “test”, “mock”, “spec”.
Если занимаешься поиском секретов в репозиториях, то из исследования можно позаимствовать следующие инсайты:
Please open Telegram to view this post
VIEW IN TELEGRAM
3✍3🤩3🏆3
Новый и супер-быстрый инструмент для поиска секретов в коде
Чтобы оценить инструменты поиска секретов исследователи подготовили специальный датасет SecretBench и провели на его основе сравнение популярных проектов. Лидером среди opensource стал gitleaks: у него 46% точности и 88% полноты. А еще авторы сделали ключевой вывод:
Недавно команда mongodb опубликовала инструмент Kingfisher, который обладает рядом преимуществ относительно других опенсорс-проектов:
💡 написан на Rust, а значит, есть преимущества перед Golang-тулами за счет ускорения потока обработки. Это дает ощутимый выигрыш в производительности при сканировании больших объемов кода, например, монорепозиториев или всей истории коммитов.
💡 использует Hyperscan - быстрый движок для поиска по регулярным выражениям, который может одновременно обрабатывать тысячи шаблонов за один прогон. Regex matching занимает до 90% от всего времени сканирования, поэтому наличие этого движка позволяет отбросить gitleaks, который использует стандартные regex-средства в Go.
💡 кроме regex-движка еще использует инструмент для синтаксического анализа кода - Tree-Sitter. Строит AST-дерево, чтобы понимать, где в коде находятся строки, комментарии, переменные и проводить поиск только в нужных местах. Это помогает лучше понимать контекст, в котором находится секрет и точнее его интерпретировать. Но эту функцию также лучше применять для больших файлов.
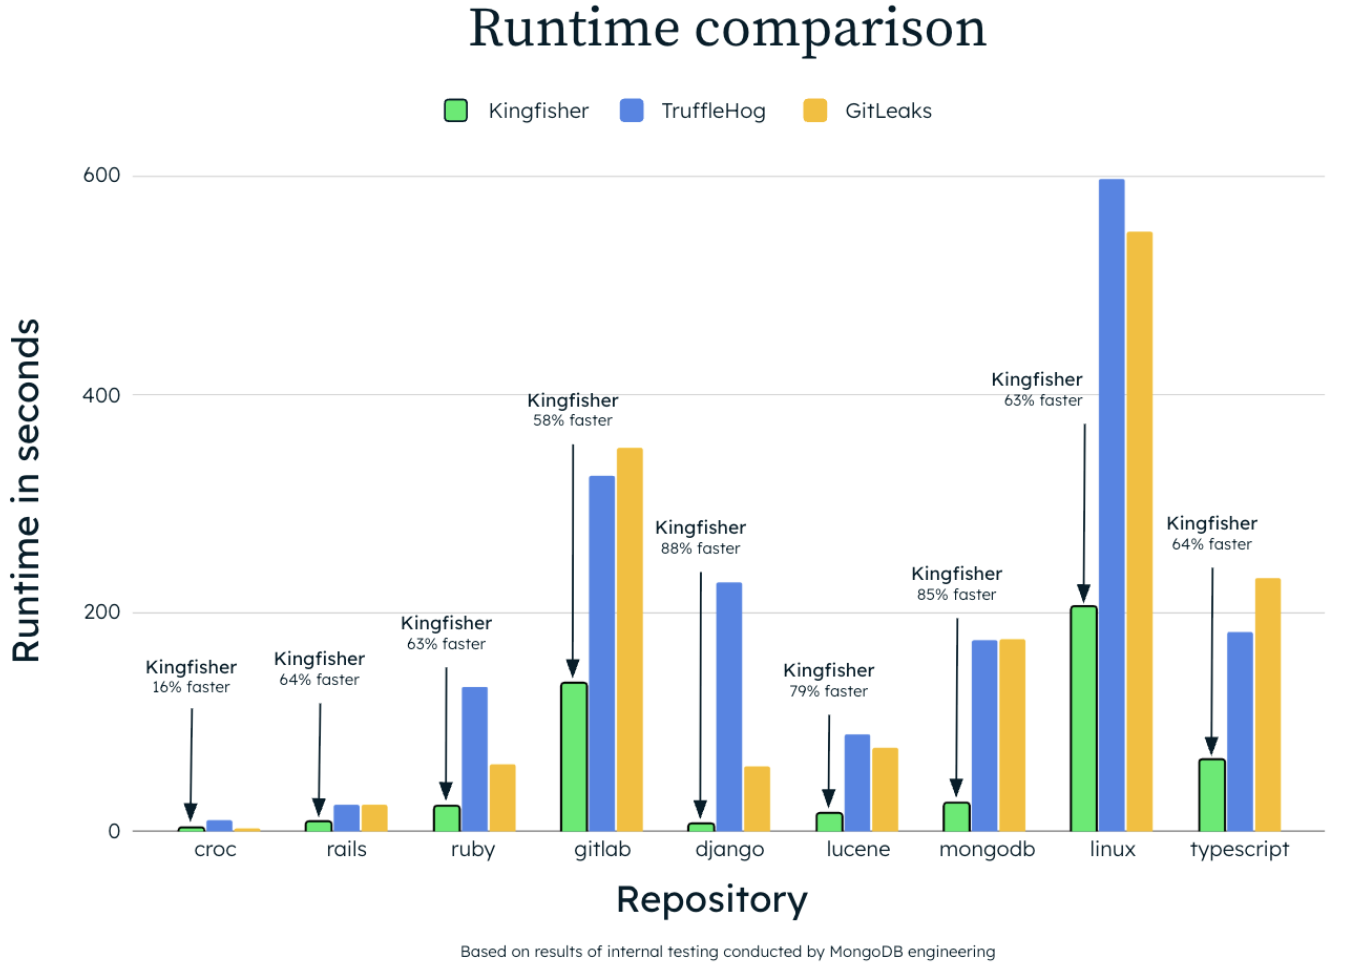
Результаты внутренних тестов Kingfisher от авторов показывают кратное преимущество в скорости. Интересно, как инструмент ведет себя в точности и скорости для небольших проектов. 🧐
Чтобы оценить инструменты поиска секретов исследователи подготовили специальный датасет SecretBench и провели на его основе сравнение популярных проектов. Лидером среди opensource стал gitleaks: у него 46% точности и 88% полноты. А еще авторы сделали ключевой вывод:
На данный момент нет ни одного инструмента, который обладал бы одновременно высокими показателями точности и полноты.
Недавно команда mongodb опубликовала инструмент Kingfisher, который обладает рядом преимуществ относительно других опенсорс-проектов:
Результаты внутренних тестов Kingfisher от авторов показывают кратное преимущество в скорости. Интересно, как инструмент ведет себя в точности и скорости для небольших проектов. 🧐
Please open Telegram to view this post
VIEW IN TELEGRAM
1🏆6❤2
Ретроспектива ПМЭФ: безопасность киберфизических систем
Задача: выйти из ящика ИБ-конференций и мероприятий для разработчиков и запрыгнуть в совершенно другой контекст, чтобы поискать свежие идеи. Решение: посетить ПМЭФ (спасибо PT-товарищам за приглашение), принести с собой кибербез и поискать тренды, которые повлияют на него в ближайшее время.
Делюсь заметками, которые закидывал в телефон, пока слушал доклады и общался с коллегами:
⭐️ Безопасность киберфизических систем - это приоритет для крупных предприятий и производств. Особенно с появлением автономных ИИ-агентов. Разница между скоростью исправления уязвимостей в таких системах и скоростью приземления в них агентов настолько большая, что кажется, кибератаки совсем потеряют приставку “кибер”. Можно даже рассмотреть свежий пример: уязвимость в стандарте связи, который используется в поездах. Используя SDR-устройство, редиска может перехватывать и подделывать трафик в грузовых поездах и отправить команду активации тормоза. Это может привести к сходу с рельсов. Уязвимость не исправлена до сих пор.
⭐️ Безопасность ИИ. Понятно, что тема актуальная. И понятно, что защитные меры нужно двигать максимально “влево” в жизненном цикле этих систем. Интересно, с какой скоростью MLSecOps повторяет путь DevSecOps.
⭐️ Рынок труда и образование в ИБ меняются быстрее, чем образовательные стандарты. Частота, с которой Дима обновляет схему карьерных треков, как бы намекает, что подход к обучению трансформируется из контентно-центричного в проектно-центричный. Главное, не забыть про математику.
Задача: выйти из ящика ИБ-конференций и мероприятий для разработчиков и запрыгнуть в совершенно другой контекст, чтобы поискать свежие идеи. Решение: посетить ПМЭФ (спасибо PT-товарищам за приглашение), принести с собой кибербез и поискать тренды, которые повлияют на него в ближайшее время.
Делюсь заметками, которые закидывал в телефон, пока слушал доклады и общался с коллегами:
Please open Telegram to view this post
VIEW IN TELEGRAM
Please open Telegram to view this post
VIEW IN TELEGRAM
🔥8🏆4❤2
Исследуем способы точного и быстрого поиска секретов
В процессе создания платформы безопасной разработки мы провели исследование актуальных инструментов поиска секретов в исходном коде. В статье “Секретные ингредиенты безопасной разработки” поделились критериями выбора движков для анализа, особенностями их работы и результатами сравнительных тестов.
AppSec-инженеры и DevSecOps-специалисты, которые строят безопасный конвейер разработки, найдут в материале подсказки, какие проекты с открытым исходным кодом стоит рассмотреть для внедрения. Исследователи безопасности и охотники за ошибками, возможно, откроют новые утилиты и нюансы их использования на больших объемах данных. Владельцы продуктов и разработчики еще раз получат напоминание и рецепт поиска секретов в своем коде.

2👀6👍2🏆2
Бот, который собирает security-идеи
В 2020 году, когда X еще назывался Twitter, я написал простого Telegram-бота, который парсил Twitter-ленту и ловил интересные идеи в направлении поиска уязвимостей. Раз в день он анализировал все посты с хэштегом bugbountytips за 24 часа, выбирал посты с наибольшим охватом по количеству лайков и ретвитов, и публиковал в канале.
С тех пор Twitter закрыл свое API и назвал себя X. Теперь в X есть защита от скраппинга, которая мешает ботам проводить сбор контента. А количество ценных идей и размер security-сообщества в этом источнике не уменьшились.
Немного вайбкодинга - и бот реанимирован:
✨ Бот использует Playwright для сбора и анализа контента в X: анализирует все посты за 24 часа с хэштегами bugbountytip, bugbountytips, bugbounty, pentest, redteam, которые собирают определенное количество лайков. Кстати, если есть идеи, какие еще хэштеги или источники (например, Medium) хочется регулярно мониторить, то пиши в комментарии - добавлю.
✨ Передает эти посты для анализа в модель DeepSeek-V3, которая разбирает каждый пост и готовит экспертный комментарий.
✨ Публикует результат в канале @bhhub в 13:37 (UTC+0).
Иногда этот бот будет писать о самых интересных, по его мнению, исследованиях здесь. Если вдруг он начнет галлюцинировать, уходить из security-профессии или матюкаться - это не специально. На всякий случай вот его аватарка.
В 2020 году, когда X еще назывался Twitter, я написал простого Telegram-бота, который парсил Twitter-ленту и ловил интересные идеи в направлении поиска уязвимостей. Раз в день он анализировал все посты с хэштегом bugbountytips за 24 часа, выбирал посты с наибольшим охватом по количеству лайков и ретвитов, и публиковал в канале.
С тех пор Twitter закрыл свое API и назвал себя X. Теперь в X есть защита от скраппинга, которая мешает ботам проводить сбор контента. А количество ценных идей и размер security-сообщества в этом источнике не уменьшились.
Немного вайбкодинга - и бот реанимирован:
Иногда этот бот будет писать о самых интересных, по его мнению, исследованиях здесь. Если вдруг он начнет галлюцинировать, уходить из security-профессии или матюкаться - это не специально. На всякий случай вот его аватарка.
Please open Telegram to view this post
VIEW IN TELEGRAM
7🔥18🤣5👍3🏆1
Маленький шаг в большом опенсорсе: добавили CVSS в Trivy
Под капотом нашей AppSec-платформы в SourceCraft — крупный опенсорсный проект Trivy. Это инструмент Software Composition Analysis — он позволяет обнаружить проблемы в зависимостях, которые разработчики используют в своем коде.
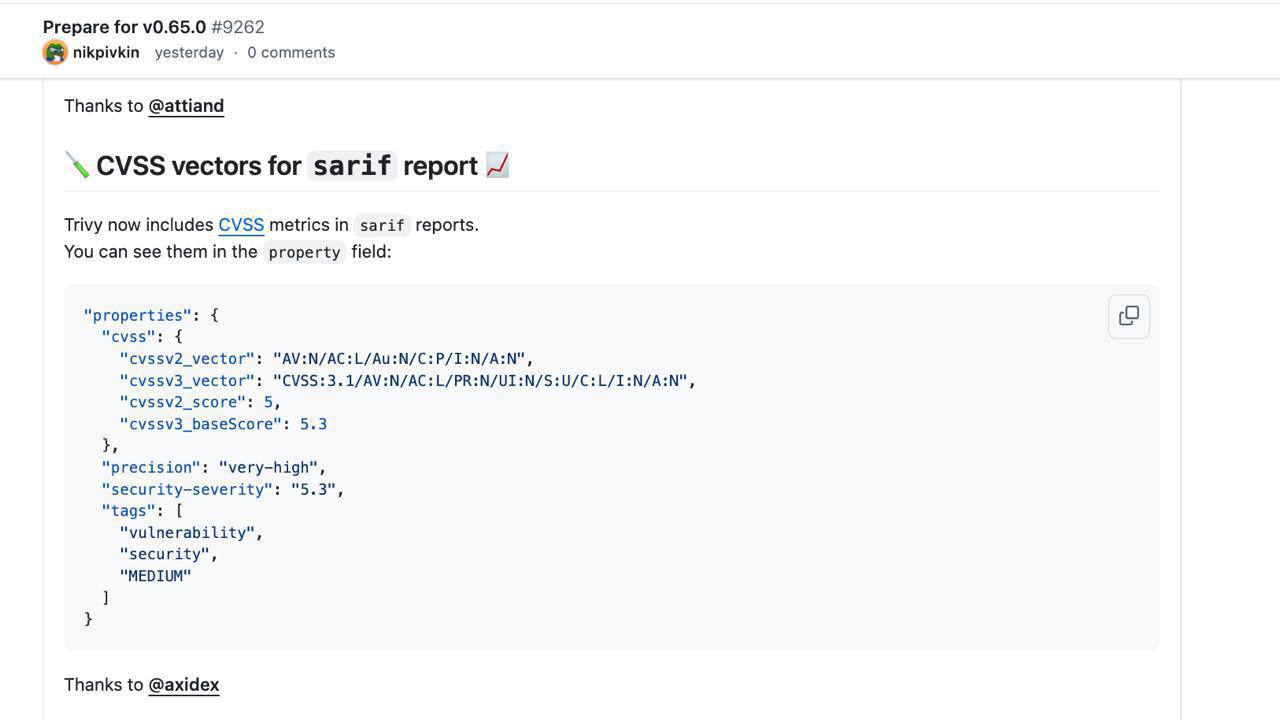
В этот раз мы не только интегрируем но и контрибьютим: в релизе Trivy 0.65.0 наш разработчик Степан добавил CVSS-вектор. Значит, скоро на странице Supply Chain появится и сам CVSS-вектор, который позволит инженеру точнее триажить уязвимости.
Команда Trivy отметила вклад. Стёпа, поздравляю с первой опенсорс-контрибуцией! И спасибо Андрею, который предложил идею выйти на связь с разработчиками проекта и внести изменения.
1👏11🔥5❤3🏆1
Мониторим обновления в базах уязвимостей: платформа OpenCVE
До тех пор, пока CVE остается главным индексом известных уязвимостей, команды security-аналитиков и инженеров будут строить свои процессы отслеживания изменений в этой базе. И не только отслеживать, но и обогащать дополнительными данными, чтобы аккуратно выставлять приоритеты для исправления.
Встретил проект OpenCVE, который предоставляет платформу с открытым исходным кодом для мониторинга ключевых баз уязвимостей. Проект интересен тем, что помимо стандартного Severity и CVSS регулярно пополняет свою базу CVE дополнительными метриками:
✨ EPSS (Exploit Prediction Scoring System) - вероятность того, что уязвимость будет эксплуатироваться в реальных атаках в ближайшие 30 дней.
✨ SSVC (Stakeholder-Specific Vulnerability Categorization) - система критериев, которая помогает принять решение, насколько срочно нужно исправлять проблему.
✨ KEV (Known Exploited Vulnerabilities) - каталог уязвимостей, которые уже эксплуатируются в реальных атаках.
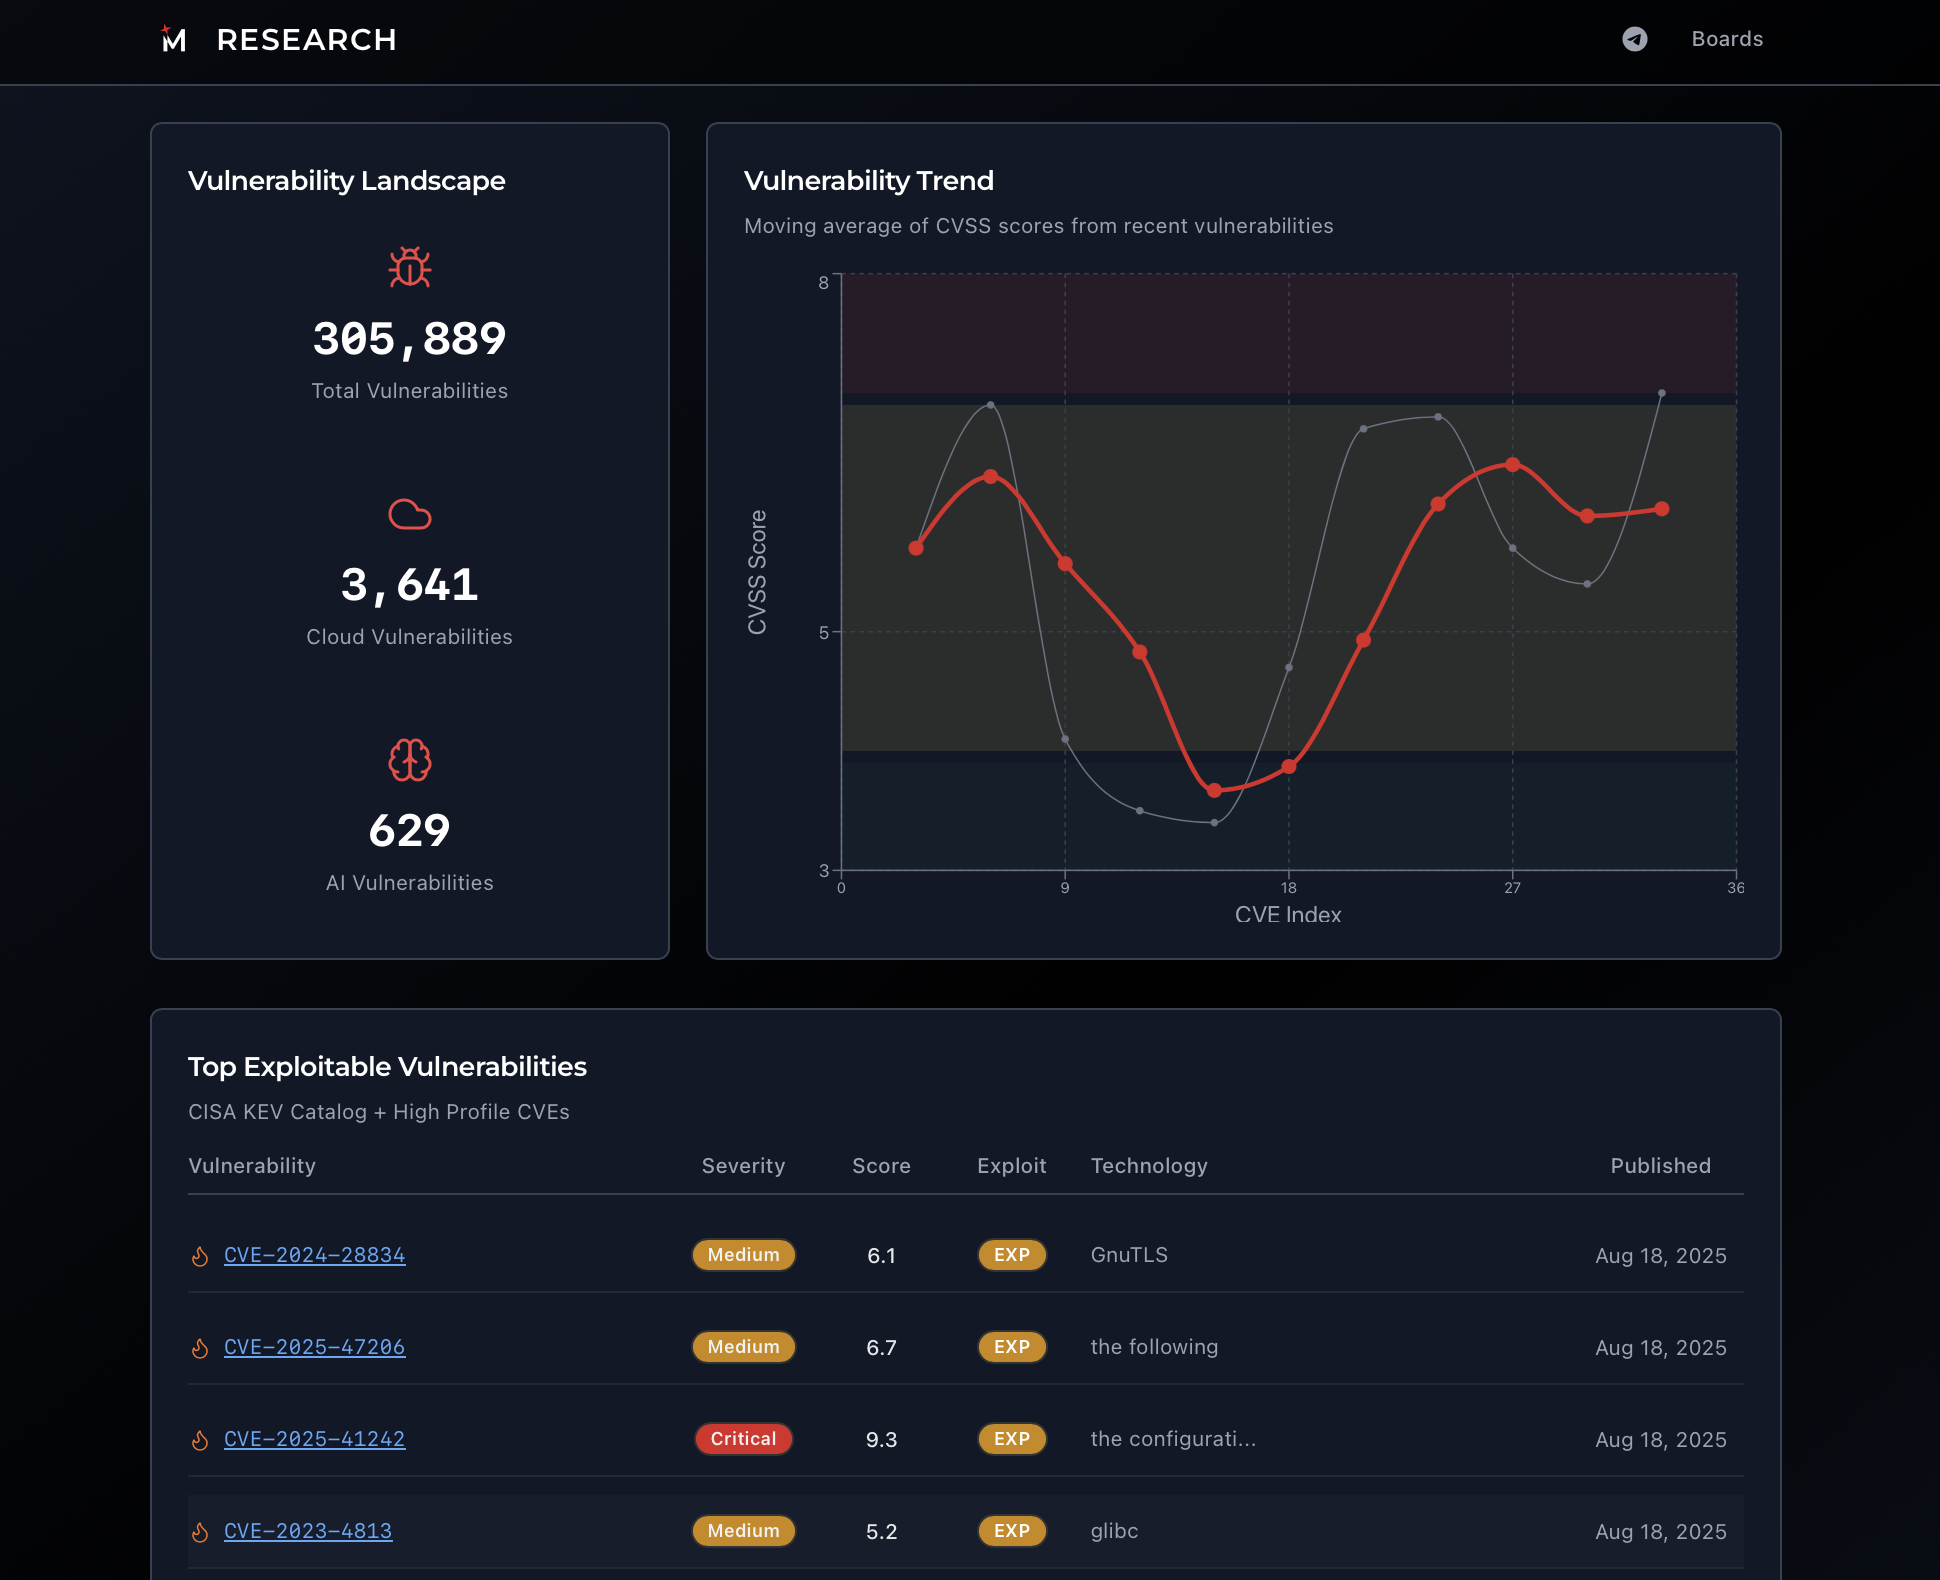
ИБ-инженеры, которые выстраивают процесс управления уязвимостями, могут использовать эту платформу для того, чтобы оперативно получать обновления об уязвимостях в нужном им ПО. Исследователи ИБ, могут отслеживать тренды. Кстати, подготовил для себя простой дашборд, который отслеживает обновления в базе OpenCVE и показывает мне простые, но полезные инсайты:
✨ общее количество известных уязвимостей и интересных для меня классов: облачные проблемы и баги в AI-инфраструктуре
✨ скользящее среднее по новым уязвимостям, которое позволяет отслеживать “вспышки” критических проблем
✨ топ-10 критических уязвимостей с эксплойтами за 24 часа.
До тех пор, пока CVE остается главным индексом известных уязвимостей, команды security-аналитиков и инженеров будут строить свои процессы отслеживания изменений в этой базе. И не только отслеживать, но и обогащать дополнительными данными, чтобы аккуратно выставлять приоритеты для исправления.
Встретил проект OpenCVE, который предоставляет платформу с открытым исходным кодом для мониторинга ключевых баз уязвимостей. Проект интересен тем, что помимо стандартного Severity и CVSS регулярно пополняет свою базу CVE дополнительными метриками:
ИБ-инженеры, которые выстраивают процесс управления уязвимостями, могут использовать эту платформу для того, чтобы оперативно получать обновления об уязвимостях в нужном им ПО. Исследователи ИБ, могут отслеживать тренды. Кстати, подготовил для себя простой дашборд, который отслеживает обновления в базе OpenCVE и показывает мне простые, но полезные инсайты:
Please open Telegram to view this post
VIEW IN TELEGRAM
1❤3
В программном комитете BSides Vizag
В 2015-м я сделал свой первый доклад на международной конференции в Индии — это был Nullcon. Активное сообщество и крутые эксперты. Уехал с мероприятия с сильным впечатлением и новыми индийскими друзьями.
Пять лет спустя новый опыт уже по другую сторону конференции — в программном комитете BSides Cairo.
Теперь два воспоминания сходятся в новом этапе: я присоединяюсь к программному комитету индийской конференции BSides Vizag, чтобы помочь вывести на сцену лучшие исследования.
Прием заявок открыт, а значит нужно отправить доклад по результатам своей исследовательской работы.
🔥8🏆5❤3👏1
Как вас не взломают
Критическое мышление в период развития ИИ – ключевой навык. Это утверждают отчеты консалтерских компаний и WEF, которые пробуют разобраться, какие скилы нужно качать сегодня. Но те, кто учился в вузе на факультете информационной безопасности, знают, что этот навык полезен и без контекста «нас заменит ИИ». Там на лекциях разбирали технологии ведения информационных войн и рассказывали, как развивать то самое критическое мышление.
В личные сообщения периодически прилетают запросы, чтобы прокомментировать какую-то атаку, утечку или инцидент. Кажется, что пора запускать адаптацию «Разрушителей легенд» для кибербеза. Что-то вроде сериала «Как вас не взломают». В первую серию сразу возьмем популярный сценарий про подключение к небезопасному Wi-Fi. И разобрав кучу возможных атак на wifi-пользователя, выведем мысль: ну не сможет атакующий в большинстве возможных сценариев массово собирать пользовательские секреты на сайтах. Просто потому, что типичный пользователь серфит сайты с мобильных устройств (где есть сертификат-пиннинг), а большинство сайтов с ценной информацией уже поддерживают https-соединения. Пусть и остаются технически реализуемые и более точечные атаки, в которых редиска может украсть какой-либо пользовательский секрет, используя невнимательность жертвы. Например, в связке rogue AP + фишинг, но даже в этом случае спасает повсеместная 2FA.
Для второй серии обязательно возьмем тему «слежки через мобильную камеру». Даже подходящий контекст есть: «приложение мессенджера MAX запрашивает доступ к камере пользователя» (ссылку на анализ приложения уже удалили, но архив помнит). Включаем критическое мышление и задаем вопросы: какой реальный сценарий атаки возможен при перечисленных включенных пермиссиях? Сам по себе список разрешений в файле AndroidManifest.xml для редиски ничего не дает – пользователь должен вручную выдать эти разрешения, чтобы получить возможности звонков. В случае реального несанкционированного доступа злодея через приложение к камере/микрофону в телефоне появится индикатор активности (конечно, если он есть), а функция захвата экрана вообще шумит при каждом действии и навязчиво уведомляет об этом пользователя. Из всего списка разрешений самым интересным для редиски будет фича оверлеев (SYSTEM_ALERT_WINDOW), но ее нужно включать вручную в системных настройках.
Даже в случае, если редиска получил все разрешения от пользователя и все же смог его записывать, то появляется следующий вопрос: а кто атакующий и в чем его мотив шпионить именно за мной? Тут я не буду писать про репутационные риски для авторов приложения – ответ на него лежит уже не в технической плоскости. Прямой положительный сигнал для пользователя о том, что автор приложения следит за своей репутацией и качеством продукта: наличие приложения в Bug Bounty программе (как в случае с объектом анализа), которая дает возможность любому желающему отправить информацию о проблемах в приложении и получить за это вознаграждение. Дополнительно к этому у авторов мессенджера есть дополнительные контроли безопасности при выпуске приложения: security-гейты и AppStore-гейты.
Заключительный вопрос: кто распространяет в информационном поле эту информацию и в чем его мотивация? Пожалуй, критическое и аналитическое мышление – это действительно гигиенический навык не только для ИБ-специалистов.
4👍6❤2✍2
Выпускной 2.0: инсайты пятой сессии на факультете стратегического управления
После завершения обучения на программе MBA, оставался еще один дополнительный семестр. Изучение нескольких фундаментальных дисциплин в области управления и подготовка магистерской диссертации. Этот период был посвящен исследованию, поэтому значительная часть идей была выведена из научных работ.
В основе магистерской работы поставил вопрос для исследования: что, если рассмотреть процесс создания продуктовой инновации как state-машину — набор состояний и правил перехода между ними? Тогда появляется гипотеза: для успешного внедрения инновации в продукт необходимо на каждой стадии ее жизненного цикла принять цепочку решений, подкрепленных нужными данными.
В исследовании отбирал методы, которые позволяют на конкретном шаге бизнес-конвейера получать данные для принятия решения о переходе на следующий шаг: Human-Centric Design для получения карты идей, модель Kano для определения их приоритетов, аксиоматическое проектирование для формирования четких бизнес-требований и TRIZ для разрешения в них противоречий. Если каждый из этих методов представить как API, который описывает, как можно получать данные и выполнять действия с ними, то полученную state-машину можно представить в виде MCP для управления продуктом. Но это уже тема для других исследований.
✨ На лекции модуля “Управление знаниями” поймал тезис: “энергия важнее интеллекта”. Интересная гипотеза для проверки. С Днем знаний всех, кто ее проверяет!
После завершения обучения на программе MBA, оставался еще один дополнительный семестр. Изучение нескольких фундаментальных дисциплин в области управления и подготовка магистерской диссертации. Этот период был посвящен исследованию, поэтому значительная часть идей была выведена из научных работ.
В основе магистерской работы поставил вопрос для исследования: что, если рассмотреть процесс создания продуктовой инновации как state-машину — набор состояний и правил перехода между ними? Тогда появляется гипотеза: для успешного внедрения инновации в продукт необходимо на каждой стадии ее жизненного цикла принять цепочку решений, подкрепленных нужными данными.
В исследовании отбирал методы, которые позволяют на конкретном шаге бизнес-конвейера получать данные для принятия решения о переходе на следующий шаг: Human-Centric Design для получения карты идей, модель Kano для определения их приоритетов, аксиоматическое проектирование для формирования четких бизнес-требований и TRIZ для разрешения в них противоречий. Если каждый из этих методов представить как API, который описывает, как можно получать данные и выполнять действия с ними, то полученную state-машину можно представить в виде MCP для управления продуктом. Но это уже тема для других исследований.
Please open Telegram to view this post
VIEW IN TELEGRAM
🔥12🤣5❤3🏆1
Supply Chain атака на пакет Nx: анализ вредоносного PR
В крупном инциденте с популярным пакетом, наиболее интересны два факта: внедрение вредоносного кода в репозиторий для кражи токена на первом этапе и применение встроенных ИИ-инструментов для поиска секретов в окружении разработчика на этапе пост-эксплуатации.
Первый этап наиболее интересен, потому что после его разбора можно сделать вывод, как не допустить повторения этого сценария в других репозиториях. Контекст: у владельцев проекта Nx был рабочий процесс (workflow), который запускался каждый раз, когда наступало событие
Вот тот самый PR, с которого злодеи началась атака: 32458. Его можно найти, если пройтись по всем PR, которые появились накануне инцидента (20-21 августа) и которые вносили изменения в рабочие процессы в каталоге
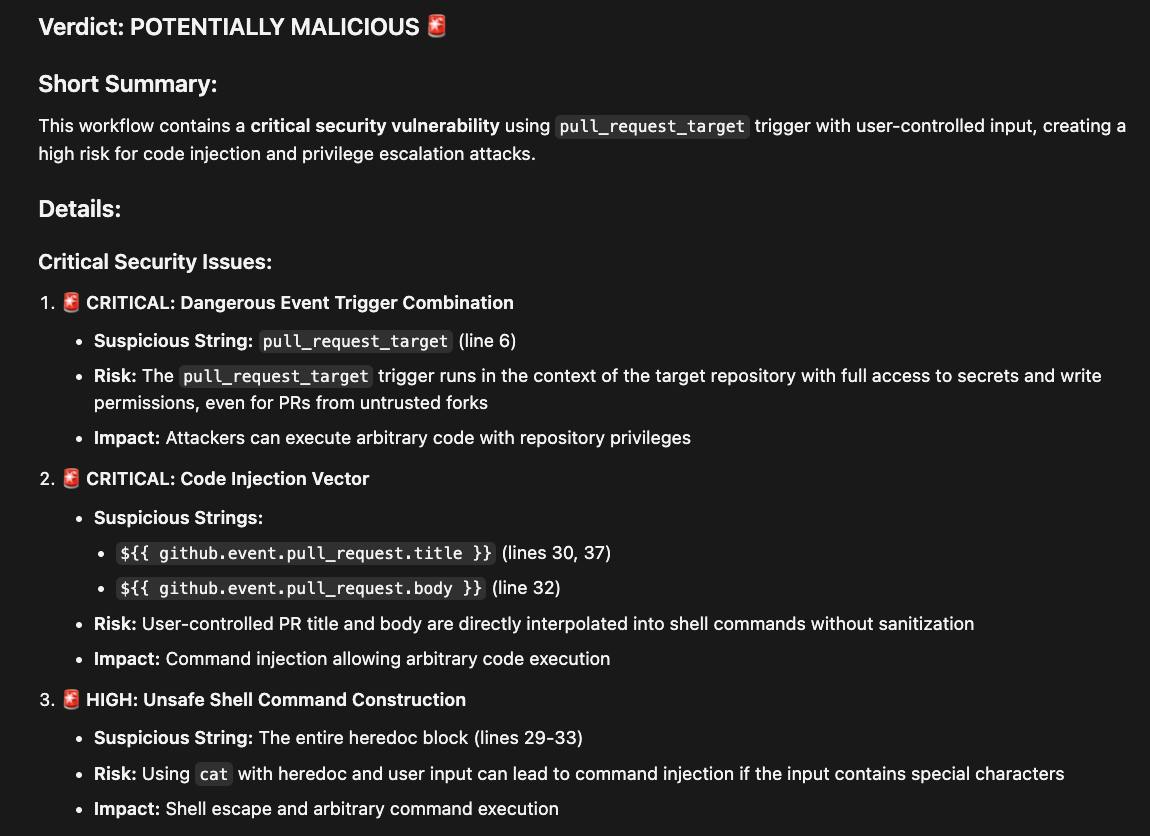
Проверим, смогла бы LLM обнаружить этот вредоносный PR. Для этого скопируем код из измененного yml-файла, добавим контекст (в каком каталоге проекта и какой файл изменен) и отправим запрос к модели Claude Sonnet 4. Получаем ответ, в котором вынесен четкий вердикт и описаны риски.
Вторая часть атаки не менее интересна, и мы разберем ее на выходных на мероприятии “Сезон кода” в Санкт-Петербурге.
В крупном инциденте с популярным пакетом, наиболее интересны два факта: внедрение вредоносного кода в репозиторий для кражи токена на первом этапе и применение встроенных ИИ-инструментов для поиска секретов в окружении разработчика на этапе пост-эксплуатации.
Первый этап наиболее интересен, потому что после его разбора можно сделать вывод, как не допустить повторения этого сценария в других репозиториях. Контекст: у владельцев проекта Nx был рабочий процесс (workflow), который запускался каждый раз, когда наступало событие
pull_request_target, то есть когда появлялся новый Pull Request (PR). Этот workflow проверял новый PR: записывал заголовок и тело PR во временный файл, и вызывал локальный скрипт проверки commit-lint.js. Этот скрипт уже выполнял внедренный код. В итоге злодеи смогли исполнить свой bash-скрипт в рабочем процессе и украсть секрет NODE_AUTH_TOKEN.Вот тот самый PR, с которого злодеи началась атака: 32458. Его можно найти, если пройтись по всем PR, которые появились накануне инцидента (20-21 августа) и которые вносили изменения в рабочие процессы в каталоге
.github/workflows. Проверим, смогла бы LLM обнаружить этот вредоносный PR. Для этого скопируем код из измененного yml-файла, добавим контекст (в каком каталоге проекта и какой файл изменен) и отправим запрос к модели Claude Sonnet 4. Получаем ответ, в котором вынесен четкий вердикт и описаны риски.
Вторая часть атаки не менее интересна, и мы разберем ее на выходных на мероприятии “Сезон кода” в Санкт-Петербурге.
1🔥5👍3🏆2
Моделирование угроз с помощью ИИ
Теперь самый ценный навык в создании продуктов - это не написание кода, а формулировка намерений. Ключевым артефактом становится спецификация. Каждый, кто пишет промпты для моделей, является автором спецификаций.
Смещение фокуса разработки в сторону спек поднимает значение этапов моделирования угроз и security design review, когда архитектор безопасности на основе документов проводит анализ архитектуры, определяет риски и контроли безопасности еще до того, как разработчик начнет писать код.
Еще один успешный сценарий, как можно моделировать угрозы с помощью LLM. Автор автоматически провел анализ документов и подготовил 1000 моделей угроз и в итоге разработал многоступенчатый процесс запросов. Архитектор ИБ найдет промпты и рекомендации по внедрению ИИ на этапе design review.

GitHub
ai-security-analyzer/images/demo.gif at main · xvnpw/ai-security-analyzer
A powerful tool that leverages AI to automatically generate comprehensive security documentation for your projects - xvnpw/ai-security-analyzer
1👍8🏆5🤣4