
Forwarded from [삼성 이영진] 글로벌 AI/SW
티보 소티오 × 매튜 버먼: AI 에이전트와 오픈AI의 미래
■ AI 에이전트의 병목은 모델 성능에서 시스템 전체로 이동
“Ultra Fast처럼 토큰 생성 속도가 10~14배 빨라지면 CPU, 툴콜, 네트워크 등 다른 부분이 병목이 된다.”
→ 모델 추론 속도가 충분히 빨라질수록 실제 에이전트 작업시간을 결정하는 요소는 토큰 생성 자체가 아니라 툴 호출, 네트워크, CPU, 애플리케이션 실행 등으로 이동
→ 실제로 코드 생성처럼 툴콜이 적은 작업은 Ultra Fast에서 약 10배 빨라질 수 있지만, 툴콜이 많은 에이전트 작업은 체감 개선폭이 3~4배에 그친다고 설명
→ 향후 AI 인프라 경쟁은 단순 GPU 및 tok/s 경쟁을 넘어 추론, CPU, 네트워크, 툴 실행, 오케스트레이션까지 포함한 전체 에이전트 스택 최적화로 확장될 가능성
■ 미래 에이전트는 노트북이 아닌 클라우드 컴퓨팅 환경에서 작동
“노트북은 인간이 처리할 수 있는 작업량에 맞춰 설계됐다. 모델은 같은 제약을 받지 않는다. 미래 모델은 노트북 이상의 자원에 접근해야 한다.”
→ 현재 컴퓨터는 인간의 입력 속도와 멀티태스킹 능력을 기준으로 설계됐지만, AI는 동시에 수십~수백 개 애플리케이션을 처리할 수 있음
→ 에이전트가 고도화될수록 로컬 PC를 대신 조작하는 구조보다 클라우드에서 독립적인 실행환경과 대규모 컴퓨팅 자원을 사용하는 Cloud Agent 구조로 이동할 가능성
→ AI가 직접 컴퓨트의 소비 주체가 되면서 GPU뿐 아니라 CPU, 메모리, 스토리지, 네트워크 등 클라우드 인프라 전반의 수요를 확대할 수 있는 구조
■ Personal Agent와 Full Automation을 서로 다른 두 축으로 개발
“한쪽은 사용자를 깊이 이해하는 Personal AGI이고, 다른 한쪽은 복잡한 프로세스의 완전 자동화다.”
→ Personal Agent는 사용자의 목표, 일상, 팀 상황까지 이해하고 선제적으로 도움을 제공하는 방향
→ Full Automation은 production log 분석, 성능 최적화, 회귀 수정, 보안 취약점 패치처럼 기존에는 사람이 개입해야 했던 복잡한 프로세스를 자동화하는 방향
→ 특히 보안 취약점의 경우 탐지 이후 패치까지 자동화해 사람이 고위험 행동만 승인하는 수준을 언급
→ AI 산업의 발전 경로를 단순 Copilot이 아니라 개인 생산성 향상과 기업 업무 프로세스의 완전 자동화라는 두 축으로 동시에 확장하는 것으로 보는 시각
■ ChatGPT와 Codex 통합, 범용 에이전트와 대규모 배포 전략
“미래 모델이 우리에게 ChatGPT와 Codex를 합치라고 요구한다. 결국 같은 기술, 같은 harness다.”
→ 오픈AI는 코딩용 AI와 일반 AI를 장기적으로 별도 제품으로 보지 않음. 하나의 고성능 멀티모달 에이전트가 코딩, 리서치, 디자인, 영업, 마케팅 등 다양한 작업을 수행하고 인터페이스가 사용자별로 최적화되는 구조를 지향
→ 인터뷰 시점 Codex 사용자는 2,000만 명까지 증가. 개발자 전용 제품을 별도로 키우기보다 ChatGPT와 통합해 PM, 디자이너, 영업, 마케팅 등 비개발자까지 에이전트 사용층을 확대
→ 장기적으로는 하나의 Personal AGI Interface가 사용자별 역할과 컨텍스트에 맞춰 변화하고, ChatGPT의 대규모 소비자 배포를 개발자 및 엔터프라이즈 에이전트 채택으로 연결하는 전략
■ 사용량 리셋은 마케팅이 아니라 사용자 보상 차원에서 시작
“제품이 제대로 작동하지 않거나 경험이 기대에 못 미치면 사용량을 리셋해 보상한다. 마케팅이나 재무팀과 협의해서 하는 것이 아니라 필요하다고 느끼면 내가 직접 버튼을 누를 수 있다.”
→ Codex 사용량 리셋은 초기 제품을 빠르게 개선하는 과정에서 장애나 설정 오류가 발생했을 때 사용자에게 추가 사용량을 제공하는 보상 차원에서 시작
→ 이후 새로운 기능 출시나 주요 순간을 기념할 때도 추가 사용량을 제공하며 사용자들이 신규 기능을 직접 경험하도록 유도
→ 리셋 결정에 마케팅이나 재무팀이 관여하지 않는다고 강조. 제품 완성도가 기대에 미치지 못하면 즉각 보상하고, 단기적인 사용 비용보다 사용자 경험과 신뢰를 우선하는 오픈AI의 제품 운영 문화를 보여주는 사례
■ 미래 AI 인터페이스는 Voice-first, Ambient, Multimodal
“미래에 우리가 만드는 것은 매우 ambient하고 자연스러운 형태다.”
→ 새로운 Voice 출시 이후 음성으로 ChatGPT를 사용하는 이용자가 빠르게 증가하고 있다고 설명
→ 사람은 입력 저항이 가장 낮은 방식을 선택하기 때문에 키보드와 프롬프트 중심 인터페이스가 AI의 최종 형태는 아닐 것으로 판단
→ 향후에는 음성뿐 아니라 사용자의 화이트보드, 화면, 주변 환경까지 이해하는 상시 존재형 멀티모달 에이전트로 발전할 가능성
■ Ultra Fast 수준의 추론 속도가 1~2년 내 사실상 기본값으로
“1~2년 정도면 지금의 속도가 기본이거나 기본에 매우 가까워질 수 있다.”
→ 현재 10~14배 빠른 Ultra Fast는 프리미엄 서비스지만, 추론 하드웨어 발전과 모델 자체의 토큰 효율성 개선이 동시에 진행되면서 현재의 초고속 추론이 빠르게 대중화될 것으로 전망
→ Sol은 Terra보다 훨씬 토큰 효율적이며 차세대 모델은 Sol보다도 크게 개선될 것이라고 언급. 동일한 작업에 필요한 토큰 수가 감소하면서 작업당 총 추론 비용도 하락할 가능성
→ 다만 항상 더 많은 하드웨어를 사용하는 상위 프리미엄 tier는 존재할 것으로 전망. 장기적으로 모델 성능뿐 아니라 latency, cost per task, time per task가 AI 경쟁의 핵심 지표로 부상할 가능성
■ 재귀적 자기개선은 이미 AI 인프라 영역에서 시작
“모델이 다른 모델을 만드는 것뿐 아니라 추론 스택, CUDA 커널, 인프라를 개선하는 것도 Recursive Self-Improvement다.”
→ 오픈AI가 현재 실제 성과를 내고 있다고 강조한 영역은 완전한 AI 연구 자동화보다 AI를 활용한 AI 인프라 개발과 최적화
→ 가장 강력한 프론티어 모델을 이용해 서빙 스택과 커널 등을 재설계하고 있으며, Ultra Fast를 제외한 일반 추론 속도도 최근 약 3개월 동안 60%가량 개선됐다고 설명
→ 더 강한 모델이 추론 인프라를 개선하고, 개선된 인프라가 다시 AI 활용과 연구 생산성을 높이는 자기강화 구조가 나타나기 시작했다는 시각
→ 과거 대규모 컴퓨트 선투자 역시 이러한 구조를 뒷받침. 단순 GPU 보유량보다 Compute × Frontier Model × Inference Optimization의 결합이 경쟁력으로 작용
■ 현재 Frontier Intelligence는 수개월 내 저가, 범용화될 수 있음
“Luna는 6개월 전이었다면 Frontier에 있었을 모델이다. 지금 Frontier인 것도 6개월 뒤에는 훨씬 저렴하게 운영될 것이다.”
→ AI 산업에서 나타나는 중요한 구조적 변화 중 하나는 지능의 빠른 Commoditization
→ 현재 최고급 모델의 성능이 불과 수개월 뒤 저가 모델이나 무료 tier로 확산될 수 있으며, 오픈AI는 효율성 개선에 따른 경제적 이익을 가격 인하 등을 통해 사용자와 공유하겠다는 방향을 강조
→ 장기적으로 모델 자체의 희소성이 빠르게 낮아질 경우 경쟁력은 단순 API 성능보다 Distribution, 에이전트, 개인화, 컨텍스트 활용, 인프라 효율성 등으로 이동할 가능성
https://youtu.be/4qjEgPojjzM
삼성전자 하이닉스 오늘 하루종일 우상향 중이네요
내리고나면 아저는사실메모리고점에다팔고구글샀습니다안좋아보여서요테더매수해서무위험수익올려볼게요
이런 사람들이 나오는데요 정말 투명하다못해 역겨운 인간들이죠
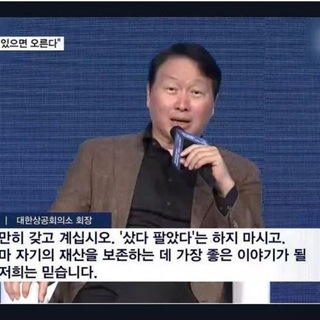
저 머니보틀은 거래세 아까워서 사팔사팔하지 않습니다
메모리혁명수비대 대장으로써 끝까지 가져갑니다
내리고나면 아저는사실메모리고점에다팔고구글샀습니다안좋아보여서요테더매수해서무위험수익올려볼게요
이런 사람들이 나오는데요 정말 투명하다못해 역겨운 인간들이죠
저 머니보틀은 거래세 아까워서 사팔사팔하지 않습니다
메모리혁명수비대 대장으로써 끝까지 가져갑니다
❤25👍4
머니보틀
드러켄밀러가 베센트에게 WSJ을 통해 기고문을 썼네요. 베센트의 장기금리누르기 정책을 비판하고 있습니다. 드러켄밀러는 베센트의 스승이기도 하죠 스탠리 드러켄밀러는 시장이 정상적으로 작동하고 있는 상황에서, 스콧 베센트 미 재무장관이 장기금리 상승을 막기 위해 국채 바이백을 활용하는 것에 대해 부정적인 견해를 내놓음. “나는 50년 동안 아주 단순한 전제를 바탕으로 트레이딩해왔다. 시장은 그 어떤 위원회도 가질 수 없는 정보를 집약하며, 가격은 그 정보가…
오늘 WSJ에 게재된 드러켄밀러의 글은 100% AI로 작성된 글
👍19🤨5❤2
Forwarded from 에테르의 일본&미국 리서치
BofA) Hot Chips: 메모리가 중심에 서다, 비트당 가치와 장비 강도의 상승 (26.08.24)
Hot Chips 2026의 핵심 메시지는 이제 AI 시스템의 결정적 제약이 컴퓨트가 아니라 메모리라는 점입니다. 컴퓨트 성능은 2년마다 약 3배씩 확장되는 반면 HBM 대역폭은 2배 미만으로 확장되는 '메모리 월'이 심화되고 있으며, 삼성과 하이닉스는 HBM4부터 베이스 다이를 수동적 라우팅 역할에서 SoC와 유사한 코프로세서로 진화시키는 첨단 로직 베이스 다이 기반의 '커스텀 HBM'으로 전환하고 있습니다(마이크론은 한 세대 늦은 HBM4e부터). BofA는 핵심 HBM 수요 논리가 유지되는 가운데 3D 적층 DRAM-on-logic 구조인 'zHBM'이 2030년대의 궁극적 아키텍처가 될 것으로 보며, HBF와 logic-on-memory는 중장기 HBM 보완재이자 TAM 확대 요인으로, 하이브리드 본딩과 TSV 등 첨단 패키징이 핵심 조력자가 될 것으로 전망합니다. 결론적으로 메모리(마이크론)는 비트당 가치 상승의 수혜를, 반도체 장비주는 장비 강도 상승의 수혜를 입을 것으로 판단합니다.
HBM 시장은 2026년 약 770억 달러에서 2030년 약 2,800억 달러로 연평균 38% 성장이 예상됩니다. HBM의 실리콘 소모량(트레이드 비율)은 동일 용량 DDR5 대비 HBM3/3e에서 약 3배였던 것이 HBM4e에서 4배로 확대되어 DRAM 공급을 구조적으로 타이트하게 유지하고, 메모리 월 확대로 세대마다 XPU당 HBM 탑재량이 늘어납니다. HBM5 이후(2031-32년 이후)에는 2.5D 인터포저와 SerDes를 제거한 zHBM 구조로 진화하며 HBM의 로드맵과 가치가 3D 시대로 연장될 것으로 봅니다. 삼성이 제시한 3단계 로드맵은 1단계에서 PHY를 컴팩트한 D2D 인터페이스로 교체하고 메모리 컨트롤러를 베이스 다이로 오프로드해 GPU 실리콘을 확보하고, 2단계(aHBM)에서 RAS 텔레메트리와 프로세싱 엘리먼트 등을 베이스 다이에 통합하며, 3단계(zHBM)에서 웨이퍼 온 웨이퍼와 하이브리드 커퍼 본딩으로 XPU와 코어 다이 스택을 수직 통합해 I/O 전력을 약 70% 절감하는 것입니다. 삼성은 zHBM으로 GPU 1개와 HBM 4개 구성 기준 I/O 전력 효율 약 70% 개선, DRAM 대역폭 130% 증가, 시스템 전력 약 100W 절감을 제시했으며, 유사 개념의 zNAND-O(로직 다이 위에 Z-NAND 4-8층을 웨이퍼 본딩으로 적층)도 발표했습니다.
'비욘드 HBM' 경로로는 두 가지가 제시되었습니다. 첫째, HBF(고대역폭 플래시)는 NAND를 HBM 방식 패키지로 적층한 것으로 유사한 비용에 HBM 대비 8-16배 용량을 제공하되 대역폭은 훨씬 낮아 MoE 가중치와 장문 컨텍스트 KV 캐시를 타깃으로 합니다. 샌디스크는 8월 13일 애널리스트 데이에서 첫 HBF 다이 테이프아웃 완료와 2027년 추론 샘플, 2028년 양산 가능성을 제시했습니다. 둘째, d-Matrix가 공개한 Raptor는 logic-on-DRAM 방식의 3D DRAM 추론 가속기로, HBM 에너지의 약 10% 수준에서 SRAM급 대역폭을 구현하며 36미크론 피치의 직접 본딩으로 인터포저를 제거해 비트당 0.37피코줄(HBM4의 2.4 대비 6-7배 에너지 우위)과 단일 메모리 레이어에서 100TB/s 대역폭을 달성한다고 주장합니다. BofA는 두 기술 모두 HBM의 대체재가 아닌 보완재로, 니치·테일 워크로드를 겨냥하며 훈련이나 고밀도 추론이라는 HBM의 영역을 위협하지 않는 옵션 성격이라고 평가합니다.
장비 관점에서는 아키텍처 방향과 무관하게 WFE 강도가 상승할 것으로 봅니다. 램리서치(LRCX)는 TSV 형성(실리콘 에칭)과 구리 전기도금 리더십으로 현 HBM 로드맵은 물론 HBF와 d-Matrix의 3D DRAM에서도 가장 큰 수혜가 예상됩니다. 어플라이드 머티어리얼즈(AMAT)는 20단 이상 스택에서 마이크로범프를 대체하는 하이브리드 본딩 국면에서 본딩 유전체 증착과 CMP 경쟁력, BESI와의 다이 투 웨이퍼 하이브리드 본더 공동 개발로 최적 포지션에 있으나, 삼성 방식의 웨이퍼 투 웨이퍼 본딩이 확산될 경우 별도 툴셋이 필요할 수 있습니다. KLA(KLAC)는 적층 단수 증가에 따른 수율 문제 복합화로 DRAM 공정 제어 강도가 높아지고, 과거 공정 제어 수요가 미미했던 NAND에서도 HBF로 레이어별 검사가 요구되면서 지갑 점유율 확대 기회를 얻을 것으로 전망됩니다.
❤7
머니보틀
8월이 이제 얼마 남지 않았네요 8월 내로 N% 성과급 제도 개선을 하겠다던 이재명 정부는 아직까지도 입을 꾹 닫고 있습니다 노란봉투법이 없었다면 파업을 무기로 회사를 압박할수도 없었을텐데 말이죠
성과급 증시부양 부동산 아무것도 못하는중
https://n.news.naver.com/article/666/0000120661
성과급: 8월 내로 해결하겠다고 함(8월 1주일도 안남음)
증시부양: 단일종목레버 상장으로 1달만에 대표종목 50% 떨어트림
부동산: 보유세도 안올리고 미적거리면서 여론 눈치만보니 집값도 오르고 전월세도 오름
https://n.news.naver.com/article/666/0000120661
Naver
이재명 대통령 지지율 38.9%…취임 후 첫 30%대 추락
이재명 대통령의 국정운영에 대한 긍정 지지율이 취임 후 처음으로 30%대로 떨어졌다는 여론조사 결과가 나왔다. 26일 여론조사업체 조원씨앤아이가 스트레이트뉴스 의뢰로 지난 22~24일 사흘간 전국 만 18세 이상 남
❤15👍3🍾3❤🔥1🐳1
자고일어나면 엔비디아 떡상으로 메모리까지 대폭등할것같은데…
혹시 모르니 안전벨트 하고 잡시다
너무 많이 올라서 뿅 날라갈수도 있어요
🚀🚀🚀
혹시 모르니 안전벨트 하고 잡시다
너무 많이 올라서 뿅 날라갈수도 있어요
🚀🚀🚀
❤25👍5😐4🤩3🤨2
*NVIDIA: 지난 분기 1,190억 달러에서 2,790억 달러로 구매 약정액 증가
*NVIDIA: 구매 약정액 증가의 주요 원인은 메모리 구매 증가
$NVDA
*NVIDIA: 구매 약정액 증가의 주요 원인은 메모리 구매 증가
$NVDA
❤9