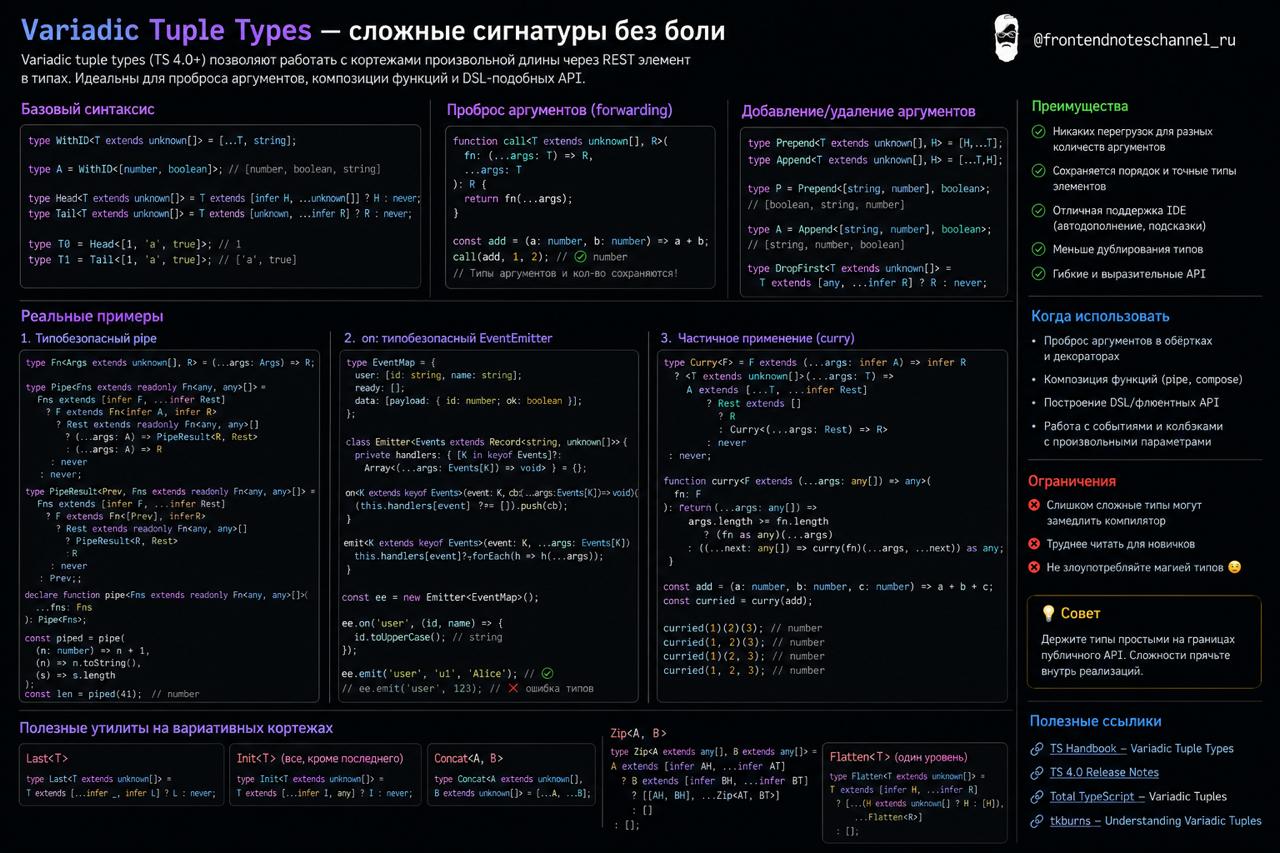
Variadic tuple types — сложные сигнатуры без боли
До variadic tuple types
многие сложные сигнатуры в TypeScript
выглядели как наказание.
Особенно:
👉 curry
👉 compose
👉 middleware
👉 typed event emitter
👉 любые функции с «прокинь аргументы дальше»
Как было раньше
Обычно появлялись:
👉 overload на overload
👉 ручные tuple-типы
👉 тонны дублирования
Типы быстро превращались
в нечитаемую простыню.
Что изменили variadic tuples
С их появлением стало намного проще
работать с остаточными аргументами на уровне типов.
Например:
Или собирать сигнатуры:
Почему это важно
На практике это одна из тех TS-фич,
которые реально упростили жизнь библиотекам.
Без variadic tuples:
👉 Redux middleware typings
👉 router APIs
👉 compose/curry utilities
были бы ещё страшнее.
Где начинается тёмная магия
Проблемы начинаются,
когда variadic tuples комбинируют с:
👉
👉 recursive types
👉 conditional types
IDE начинает тормозить,
ошибки становятся нечитаемыми,
а compile time — расти.
Главная мысль
Variadic tuple types —
это действительно мощная фича.
До variadic tuple types
многие сложные сигнатуры в TypeScript
выглядели как наказание.
Особенно:
👉 curry
👉 compose
👉 middleware
👉 typed event emitter
👉 любые функции с «прокинь аргументы дальше»
Приходилось писать overload на overload
и дублировать типы вручную.
Как было раньше
Обычно появлялись:
👉 overload на overload
👉 ручные tuple-типы
👉 тонны дублирования
Типы быстро превращались
в нечитаемую простыню.
Что изменили variadic tuples
С их появлением стало намного проще
работать с остаточными аргументами на уровне типов.
Например:
type Fn<T extends unknown[]> =
  (...args: [...T]) => void
Или собирать сигнатуры:
type Append<Args extends unknown[], Arg> =
  [...Args, Arg]
Типы наконец научились нормально работать
с «переменным количеством аргументов».
Почему это важно
На практике это одна из тех TS-фич,
которые реально упростили жизнь библиотекам.
Без variadic tuples:
👉 Redux middleware typings
👉 router APIs
👉 compose/curry utilities
были бы ещё страшнее.
Где начинается тёмная магия
Проблемы начинаются,
когда variadic tuples комбинируют с:
👉
infer 👉 recursive types
👉 conditional types
Типовая система очень быстро
превращается в тёмный лес.
IDE начинает тормозить,
ошибки становятся нечитаемыми,
а compile time — расти.
Главная мысль
Variadic tuple types —
это действительно мощная фича.
Главное —
вовремя остановиться
и не превратить типы в отдельный язык программирования.
❤4
AbortSignal.any() и AbortSignal.timeout(): единая отмена fetch, таймеров и async-операций в production
Собирайте отмену вокруг AbortSignal
Так в один контракт попадают:
* caller отменил операцию
* истек timeout
* клиент закрыл соединение
* сервис уходит в graceful shutdown
Типичная ошибка
Не останавливайтесь на
Практические нюансы
*
*
* смотрите на
* при обертках над
Вывод:
Отмена должна быть частью контракта async-функции, а не локальным
Promise.race([fetch(), timeout]) часто маскирует проблему: ждать перестали, но работа могла не остановиться. В SPA, SSR, Node.js-сервисах, SDK и API clients это приводит к висящим запросам, таймерам и retry/backoff ниже по стеку.Собирайте отмену вокруг AbortSignal
AbortSignal.timeout(ms) сам отменится по таймауту.AbortSignal.any([...signals]) отменится, когда отменится любой входной signal.Так в один контракт попадают:
* caller отменил операцию
* истек timeout
* клиент закрыл соединение
* сервис уходит в graceful shutdown
const shutdown = new AbortController();

async function loadUser(id: string, opts: { signal?: AbortSignal } = {}) {
  const signal = AbortSignal.any([
    AbortSignal.timeout(1500),
    shutdown.signal,
    ...(opts.signal ? [opts.signal] : []),
  ]);

  signal.throwIfAborted();

  const res = await fetch(`https://api.example.com/users/${id}`, { signal });

  await sleep(100, signal); // backoff тоже отменяем

  const data = await res.json();
  signal.throwIfAborted();

  return data;
}
Типичная ошибка
Не останавливайтесь на
fetch. Один и тот же signal стоит передавать в retry, polling, очереди, sleep/timer helpers и свои async-функции. Иначе верхний слой "отменился", а нижний продолжает держать ресурсы.Практические нюансы
*
AbortSignal одноразовый: если aborted === true, нужен новый controller или timeout*
AbortSignal.any() - это fan-in, а не fan-out: он не отменяет исходные контроллеры* смотрите на
reason: timeout часто дает TimeoutError, abort - AbortError или ваш reason* при обертках над
setTimeout, stream, listener или socket чистите ресурсы при abortВывод:
Отмена должна быть частью контракта async-функции, а не локальным
Promise.race на краю системы.❤5
Graceful shutdown в Node.js под Kubernetes: drain keep-alive соединений, SIGTERM и защита от 502 при rolling update
При rolling update старый Pod может уже получить
Что ломается в production
Особенно больно с
Правильный порядок:
* уронить readiness
* дать балансировке убрать Pod
* закрыть HTTP-сервер
* drain'ить idle keep-alive
* дождаться активных запросов
Node.js shutdown
Важная деталь: во время drain delay
Kubernetes-настройки
Практический совет: держите
Типичная ошибка
Вывод:
Graceful shutdown - это координация Node.js runtime, readiness, keep-alive и поведения балансировщика, а не один handler на
При rolling update старый Pod может уже получить
SIGTERM, но Ingress, kube-proxy или external LB еще слать в него трафик. Частая ошибка - сразу делать process.exit() и рвать активные запросы.Что ломается в production
Особенно больно с
keep-alive: балансировщик держит открытое TCP-соединение к Pod и переиспользует его, пока приложение уже закрывается. Итог - 502, 503, connection reset на деплое.Правильный порядок:
* уронить readiness
* дать балансировке убрать Pod
* закрыть HTTP-сервер
* drain'ить idle keep-alive
* дождаться активных запросов
Node.js shutdown
let shuttingDown = false;

app.get('/readyz', (req, res) => {
  res.sendStatus(shuttingDown ? 503 : 200);
});

async function shutdown(signal) {
  if (shuttingDown) return;
  shuttingDown = true;

  await new Promise(r => setTimeout(r, 10_000));

  server.close(err => {
    if (err) process.exit(1);
    process.exit(0);
  });

  server.closeIdleConnections?.();

  setTimeout(() => {
    server.closeAllConnections?.();
    process.exit(1);
  }, 25_000);
}

process.on('SIGTERM', () => shutdown('SIGTERM'));
Важная деталь: во время drain delay
/readyz уже отвечает 503, но обычные запросы еще обслуживаются.Kubernetes-настройки
terminationGracePeriodSeconds: 40
readinessProbe:
  httpGet:
    path: /readyz
    port: 3000
  periodSeconds: 5
  failureThreshold: 1
lifecycle:
  preStop:
    exec:
      command: ["sh", "-c", "sleep 10"]
Практический совет: держите
terminationGracePeriodSeconds больше, чем preStop + app drain delay + max request time + запас.Типичная ошибка
server.close() недостаточно как единственная мера. Он останавливает новые соединения, но idle keep-alive сокеты лучше закрывать явно через closeIdleConnections(). closeAllConnections() используйте только как аварийный fallback.Вывод:
Graceful shutdown - это координация Node.js runtime, readiness, keep-alive и поведения балансировщика, а не один handler на
SIGTERM.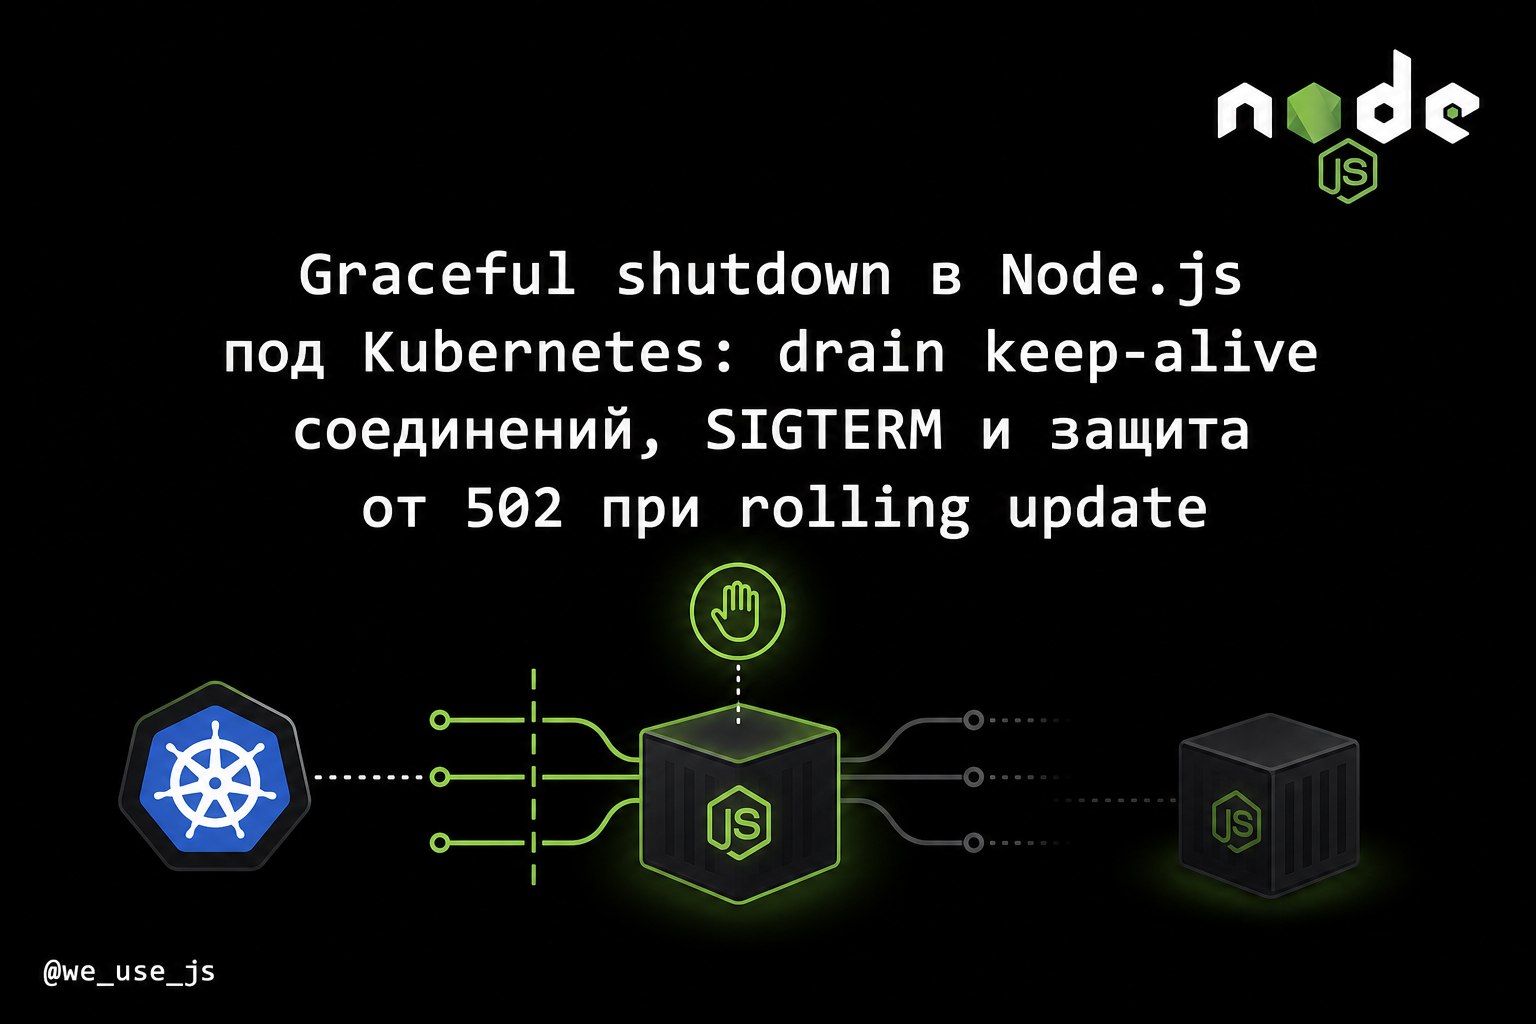
❤3
AsyncLocalStorage в Node.js: request-scoped контекст для логов, трассировки и транзакций без prop drilling
В production это нужно в Node.js-сервисах, SSR, API integration и backend-for-frontend слоях, где requestId, traceId, tenant или транзакция должны проходить через async-код. Частая ошибка - протаскивать
Как это выглядит
Теперь сервисный код не знает про HTTP middleware и
Транзакции без протаскивания tx
Для DB слоя можно делать
Где границы
* не заменяйте аргументы функции: бизнес-данные передавайте явно;
* не кладите в store
* context не пересекает process boundary: worker threads, очереди, cron jobs и другие сервисы требуют явной передачи ids;
* нестандартные callback-based библиотеки могут разорвать async chain.
Практическое правило: используйте
Вывод:
В production это нужно в Node.js-сервисах, SSR, API integration и backend-for-frontend слоях, где requestId, traceId, tenant или транзакция должны проходить через async-код. Частая ошибка - протаскивать
ctx через десятки методов или, наоборот, прятать в нём бизнес-состояние.Как это выглядит
AsyncLocalStorage использует async_hooks и привязывает store к async execution flow: promise, timeout, I/O callback и большинству стандартных API Node.js.type Ctx = { requestId: string; traceId?: string; tx?: unknown };
const als = new AsyncLocalStorage<Ctx>();
app.use((req, _res, next) => {
als.run({
requestId: req.headers['x-request-id']?.toString() ?? randomUUID(),
traceId: req.headers.traceparent?.toString(),
}, next);
});
const getCtx = () => als.getStore();
function logInfo(msg: string, meta = {}) {
const c = getCtx();
logger.info({
requestId: c?.requestId,
traceId: c?.traceId,
...meta,
}, msg);
}Теперь сервисный код не знает про HTTP middleware и
req, но логи автоматически получают correlation metadata.Транзакции без протаскивания tx
Для DB слоя можно делать
withTransaction(), который запускает als.run({ ...ctx, tx }, fn), а getDbExecutor() возвращает ctx.tx ?? db. Trade-off хороший: меньше шума в API сервисов, но граница ответственности остаётся инфраструктурной, а не бизнесовой.Где границы
* не заменяйте аргументы функции: бизнес-данные передавайте явно;
* не кладите в store
req, res, большие payload или ORM graph;* context не пересекает process boundary: worker threads, очереди, cron jobs и другие сервисы требуют явной передачи ids;
* нестандартные callback-based библиотеки могут разорвать async chain.
Практическое правило: используйте
AsyncLocalStorage для логов, tracing, tenant/user metadata, аудита и текущей транзакции, а не для скрытого глобального состояния.Вывод:
AsyncLocalStorage полезен, когда request-scoped инфраструктурный контекст улучшает observability и DX, но не размывает явные границы бизнес-логики.
❤6
Совет на ближайшие годы — изучайте ВАЙБ-КОДИНГ
ИИ уже пишет код, чинит баги, генерирует тесты, документацию и помогает запускать продукты быстрее, чем это делали классические команды разработки. И это уже не "будущее когда-нибудь", а реальность, которая меняет рынок уже сегодня
И те, кто научится вайбкодить сейчас, будут увереннее конкурировать на рынке и зарабатывать больше тех, кто по-прежнему делает всё вручную.
Стартовать с нуля поможет канал Вайб-кодинг. Там ребята круглосуточно мониторят более 320 российских и зарубежных источников и публикуют только главное: релизы, инструменты, гайды, курсы и практические кейсы.
Подписывайтесь, нас уже 45 тысяч: @vibecoding_tg
ИИ уже пишет код, чинит баги, генерирует тесты, документацию и помогает запускать продукты быстрее, чем это делали классические команды разработки. И это уже не "будущее когда-нибудь", а реальность, которая меняет рынок уже сегодня
И те, кто научится вайбкодить сейчас, будут увереннее конкурировать на рынке и зарабатывать больше тех, кто по-прежнему делает всё вручную.
Стартовать с нуля поможет канал Вайб-кодинг. Там ребята круглосуточно мониторят более 320 российских и зарубежных источников и публикуют только главное: релизы, инструменты, гайды, курсы и практические кейсы.
Подписывайтесь, нас уже 45 тысяч: @vibecoding_tg
👎7😁3
Диагностика event loop stalls в production через monitorEventLoopDelay и async_hooks без гадания по p99 latency
Event loop stall важен там, где Node.js обслуживает API, воркеры, очереди и webhooks. Типичная ошибка - видеть рост latency и сразу винить БД, не проверив, не заблокирован ли сам JS thread.
Первый сигнал - monitorEventLoopDelay
Если p99 delay внезапно стал 200-500ms+, процесс не успевает выполнять callbacks вовремя: CPU-bound JS, sync I/O, тяжелый
Контекст дает async_hooks
Практический пример: при stall логируйте route/job из ALS, а не только глобальный p99. Так можно увидеть, что задержки появляются рядом с
Что отправлять в метрики
*
* CPU user/system
* RSS и heap used
* active handles/requests
* route/job labels - осторожно, без высокой кардинальности
Предупреждение: request id кладите в логи или трейсы, но не в метрики.
Важный нюанс
Нормальный flow: постоянно держать дешевый delay histogram, при threshold писать структурированный лог, при повторении включать profiler на короткое окно.
Вывод:
Event loop stall надо диагностировать в два шага: сначала измерить задержку loop, затем привязать ее к бизнес-контексту и только после этого идти в CPU profiling.
Event loop stall важен там, где Node.js обслуживает API, воркеры, очереди и webhooks. Типичная ошибка - видеть рост latency и сразу винить БД, не проверив, не заблокирован ли сам JS thread.
Первый сигнал - monitorEventLoopDelay
perf_hooks.monitorEventLoopDelay() дает histogram задержек event loop и дешево работает как постоянная production-метрика.import { monitorEventLoopDelay } from 'node:perf_hooks';
const h = monitorEventLoopDelay({ resolution: 20 });
h.enable();
setInterval(() => {
const p99 = h.percentile(99) / 1e6;
if (p99 > 100) {
log.warn({
event: 'event_loop_stall',
p99Ms: p99.toFixed(1),
maxMs: (h.max / 1e6).toFixed(1),
ctx: als.getStore()
});
}
h.reset();
}, 10_000).unref();Если p99 delay внезапно стал 200-500ms+, процесс не успевает выполнять callbacks вовремя: CPU-bound JS, sync I/O, тяжелый
JSON.parse, regexp, crypto, zlib или GC pressure.Контекст дает async_hooks
monitorEventLoopDelay отвечает на вопрос "есть ли stall", но не говорит "кто виноват". Для production связывайте AsyncLocalStorage с request id, route, job name, tenant или queue message id.Практический пример: при stall логируйте route/job из ALS, а не только глобальный p99. Так можно увидеть, что задержки появляются рядом с
POST /reports или конкретным batch job.Что отправлять в метрики
*
event_loop_delay_p50/p95/p99/max* CPU user/system
* RSS и heap used
* active handles/requests
* route/job labels - осторожно, без высокой кардинальности
Предупреждение: request id кладите в логи или трейсы, но не в метрики.
Важный нюанс
AsyncLocalStorage не профилирует CPU и не покажет строку кода. Он сохраняет контекст. Для строки нужен sampling profiler: inspector, --cpu-prof, perf/eBPF, Clinic или APM profiler.Нормальный flow: постоянно держать дешевый delay histogram, при threshold писать структурированный лог, при повторении включать profiler на короткое окно.
Вывод:
Event loop stall надо диагностировать в два шага: сначала измерить задержку loop, затем привязать ее к бизнес-контексту и только после этого идти в CPU profiling.
👍4
AsyncLocalStorage в production: как не потерять traceId через очереди, таймеры и connection pooling
Базовый слой
Создавайте контекст на входе в систему: HTTP, consumer, cron tick. Не ждите, что ALS сам перенесет его через процесс или брокер.
Очереди
Для in-memory очереди сохраняйте
Для Kafka, RabbitMQ, BullMQ, SQS ALS не участвует. Практический совет: кладите
Таймеры и scheduler'ы
Таймер, созданный внутри контекста, обычно его сохранит. Опасность появляется, когда callback зарегистрирован в одном месте, а вызван позже из scheduler'а.
Для cron/background задач создавайте новый
Connection pooling
Типичная ошибка - записывать
Connection живет дольше запроса и переиспользуется другим request'ом. Логируйте query через текущий ALS-контекст, а trace в БД передавайте на уровне конкретной операции или транзакции, например через transaction-local setting.
Вывод:
AsyncLocalStorage надежно держит контекст внутри await, промисов и I/O. Но в production traceId чаще теряется на границах: очереди, scheduler'ы, worker'ы и connection pool.Базовый слой
Создавайте контекст на входе в систему: HTTP, consumer, cron tick. Не ждите, что ALS сам перенесет его через процесс или брокер.
const als = new AsyncLocalStorage();

const withTrace = (traceId, fn) =>
  als.run(Object.freeze({ traceId }), fn);

const getTraceId = () => als.getStore()?.traceId;
Очереди
Для in-memory очереди сохраняйте
store в момент enqueue и восстанавливайте при выполнении.function enqueue(payload) {
queue.push({ payload, store: als.getStore() });
}
function processJob(job) {
return job.store
? als.run(job.store, () => handleJob(job.payload))
: handleJob(job.payload);
}Для Kafka, RabbitMQ, BullMQ, SQS ALS не участвует. Практический совет: кладите
traceId в headers или payload и считайте это частью контракта сообщения.Таймеры и scheduler'ы
Таймер, созданный внутри контекста, обычно его сохранит. Опасность появляется, когда callback зарегистрирован в одном месте, а вызван позже из scheduler'а.
Для cron/background задач создавайте новый
traceId на каждый tick. Иначе получите "вечный" traceId процесса или случайный traceId старого запроса.Connection pooling
Типичная ошибка - записывать
traceId в client или connection object.client.traceId = getTraceId(); // плохо
Connection живет дольше запроса и переиспользуется другим request'ом. Логируйте query через текущий ALS-контекст, а trace в БД передавайте на уровне конкретной операции или транзакции, например через transaction-local setting.
Вывод:
AsyncLocalStorage работает хорошо только внутри async chain, а на production-границах traceId нужно явно фиксировать, передавать и восстанавливать.Graceful shutdown в Kubernetes: почему одного SIGTERM мало для keep-alive, HTTP/2 и фоновых задач
В production Pod редко умирает мгновенно: ingress, kube-proxy, LB и клиенты с keep-alive могут ещё слать трафик в terminating Pod. Частая ошибка - считать, что
Что реально нужно drain'ить
* HTTP/1.1 keep-alive соединения
* HTTP/2-сессии и активные stream'ы
* фоновые задачи: BullMQ, RabbitMQ, Kafka, cron, batch jobs
Иначе на rolling deploy получаются редкие 502/499, оборванные stream'ы и повторная обработка сообщений.
Staged shutdown для Node.js
Практический порядок:
* включить режим
*
* дать ingress/LB несколько секунд убрать Pod из ротации
* остановить новые TCP-соединения
* закрыть idle keep-alive
* дождаться активных запросов и задач в рамках бюджета
Важное предупреждение
HTTP/2 и фоновые задачи
Для HTTP/2 нельзя просто рубить socket: одна TCP-сессия содержит много stream'ов. Сначала отправляйте
Для workers на SIGTERM нужно остановить получение новых задач, не запускать новые cron-итерации, дождаться текущих и уметь отменять долгие операции через
Вывод:
Graceful shutdown - это не обработчик SIGTERM, а управляемый drain всего, что может продолжать работу после удаления Pod из ротации.
В production Pod редко умирает мгновенно: ingress, kube-proxy, LB и клиенты с keep-alive могут ещё слать трафик в terminating Pod. Частая ошибка - считать, что
server.close() уже дождался всех клиентов и задач.Что реально нужно drain'ить
* HTTP/1.1 keep-alive соединения
* HTTP/2-сессии и активные stream'ы
* фоновые задачи: BullMQ, RabbitMQ, Kafka, cron, batch jobs
Иначе на rolling deploy получаются редкие 502/499, оборванные stream'ы и повторная обработка сообщений.
Staged shutdown для Node.js
Практический порядок:
* включить режим
draining*
/readyz начинает отдавать 503* дать ingress/LB несколько секунд убрать Pod из ротации
* остановить новые TCP-соединения
* закрыть idle keep-alive
* дождаться активных запросов и задач в рамках бюджета
process.on('SIGTERM', async () => {
  draining = true;

  await sleep(5000);

  server.close();
  server.closeIdleConnections?.();

  h2sessions.forEach(s => s.goaway());

  await waitInFlight(25_000);

  workers.abort();

  server.closeAllConnections?.();
  process.exit(0);
});
Важное предупреждение
server.close() не означает "все клиенты ушли". Он только перестаёт принимать новые соединения. Уже открытые keep-alive соединения нужно отдельно закрывать через closeIdleConnections(), а в крайнем случае - через closeAllConnections().HTTP/2 и фоновые задачи
Для HTTP/2 нельзя просто рубить socket: одна TCP-сессия содержит много stream'ов. Сначала отправляйте
GOAWAY, чтобы запретить новые stream'ы, затем ждите завершения активных.Для workers на SIGTERM нужно остановить получение новых задач, не запускать новые cron-итерации, дождаться текущих и уметь отменять долгие операции через
AbortController.Вывод:
Graceful shutdown - это не обработчик SIGTERM, а управляемый drain всего, что может продолжать работу после удаления Pod из ротации.
🔥3
Undici в production: почему исходящие HTTP-запросы должны иметь пулы, deadline и собственный backpressure
Пул создаётся на уровне приложения
Не заводите клиент внутри handler'а. Для критичных интеграций держите
Важно: тело ответа нужно дочитать или корректно сбросить, даже если оно не нужно. Иначе socket может не вернуться в пул вовремя.
connections - это capacity, а не магическое ускорение
Маленький пул даёт очередь и рост latency. Слишком большой пул перегружает upstream, плодит открытые socket'ы, упирается в NAT / ephemeral ports и ухудшает tail latency.
Практический ориентир: если upstream отвечает за 100 ms, то 32 соединения дают примерно 320 RPS без pipelining. Но финальный размер выбирайте по SLO, payload size, TLS, сети и rate limits.
Таймауты должны быть разными
Один общий timeout скрывает причину деградации.
-
-
-
-
Предупреждение:
Backpressure делайте до Undici
Не запускайте
Ограничивайте concurrency явно, например
Вывод:
Надёжный исходящий HTTP в Node.js - это не просто
fetch() в Node.js использует Undici, но в production часто нужен явный контроль: сколько socket'ов держим, сколько ждём upstream и что делаем, если входящий трафик быстрее внешнего API. Типичная ошибка - создавать запросы без лимитов и надеяться, что пул всё спасёт.Пул создаётся на уровне приложения
Не заводите клиент внутри handler'а. Для критичных интеграций держите
Pool per-origin и переиспользуйте его:import { Pool } from 'undici'
const api = new Pool('https://api.example.com', {
connections: 32,
pipelining: 1,
connectTimeout: 2_000,
headersTimeout: 3_000,
bodyTimeout: 10_000
})
async function callApi(payload) {
const { statusCode, body } = await api.request({
method: 'POST',
path: '/v1/process',
headers: { 'content-type': 'application/json' },
body: JSON.stringify(payload),
signal: AbortSignal.timeout(12_000)
})
const text = await body.text()
if (statusCode >= 500) throw new Error(upstream ${statusCode})
return JSON.parse(text)
}Важно: тело ответа нужно дочитать или корректно сбросить, даже если оно не нужно. Иначе socket может не вернуться в пул вовремя.
connections - это capacity, а не магическое ускорение
Маленький пул даёт очередь и рост latency. Слишком большой пул перегружает upstream, плодит открытые socket'ы, упирается в NAT / ephemeral ports и ухудшает tail latency.
Практический ориентир: если upstream отвечает за 100 ms, то 32 соединения дают примерно 320 RPS без pipelining. Но финальный размер выбирайте по SLO, payload size, TLS, сети и rate limits.
Таймауты должны быть разными
Один общий timeout скрывает причину деградации.
-
connectTimeout - TCP/TLS connect-
headersTimeout - ожидание заголовков-
bodyTimeout - пауза между чанками body-
AbortSignal.timeout() - общий deadline операцииПредупреждение:
bodyTimeout не равен лимиту на весь response body.Backpressure делайте до Undici
Не запускайте
Promise.all(items.map(callApi)) на тысячи элементов. Undici поставит часть запросов в очередь, но память и давление на приложение уже выросли.Ограничивайте concurrency явно, например
MAX_IN_FLIGHT = 64. Он не обязан равняться connections: это лимит нагрузки на ваш сервис, а не только на socket pool.Вывод:
Надёжный исходящий HTTP в Node.js - это не просто
fetch(), а управляемые пулы, раздельные таймауты и backpressure до попадания запросов в Undici.👍4
Сатурация libuv thread pool в Node.js: как crypto, fs и dns.lookup ломают latency в production
В Node.js
Где возникает проблема
По умолчанию
Первые 4
Production-сценарий
Логин считает password hash, HTTP-клиент часто резолвит hostname, а hot path читает сертификат или metadata с диска. CPU может быть не 100%, event loop - "здоровым", но p99 растет из-за очереди к worker'ам.
DNS-нюанс
Что делать
* выносить тяжелый crypto в
* не читать файлы на hot path - грузить и кэшировать заранее;
* включать keep-alive, pooling и DNS cache;
* менять
Больше thread'ов - не silver bullet: CPU-bound задачи могут ухудшить p99 из-за context switching.
Вывод:
libuv thread pool - маленький общий ресурс процесса, поэтому latency-sensitive I/O нельзя смешивать с тяжелым crypto и частым
В Node.js
async не значит "без очередей": часть операций конкурирует за общий libuv thread pool. Частая ошибка в production - смотреть только на event loop lag и не видеть очередь внутри пула.Где возникает проблема
По умолчанию
UV_THREADPOOL_SIZE=4 на процесс. Туда попадают crypto.pbkdf2, scrypt, часть randomBytes, многие fs.*, dns.lookup, zlib.for (let i = 0; i < 8; i++)
crypto.pbkdf2(p, s, 500_000, 64, 'sha512', cb);
await fs.readFile('./config.json');
await dns.lookup('api.internal');
Первые 4
pbkdf2 занимают весь пул, остальные операции ждут. Маленький config-файл или DNS lookup внезапно дают сотни миллисекунд.Production-сценарий
Логин считает password hash, HTTP-клиент часто резолвит hostname, а hot path читает сертификат или metadata с диска. CPU может быть не 100%, event loop - "здоровым", но p99 растет из-за очереди к worker'ам.
DNS-нюанс
dns.lookup использует системный resolver через getaddrinfo и libuv pool. dns.resolve4/6/Mx используют c-ares и не конкурируют с fs/crypto так же. Предупреждение: массовый dns.lookup легко принять за "медленную сеть".Что делать
* выносить тяжелый crypto в
worker_threads, отдельный сервис, процессы или queue;* не читать файлы на hot path - грузить и кэшировать заранее;
* включать keep-alive, pooling и DNS cache;
* менять
UV_THREADPOOL_SIZE только после load test:UV_THREADPOOL_SIZE=32 node server.js
Больше thread'ов - не silver bullet: CPU-bound задачи могут ухудшить p99 из-за context switching.
Вывод:
libuv thread pool - маленький общий ресурс процесса, поэтому latency-sensitive I/O нельзя смешивать с тяжелым crypto и частым
dns.lookup без изоляции и измерений.❤1
AbortController в Node.js production: сквозные дедлайны, cleanup ресурсов и защита от «висящих» операций
AbortController важен не как таймаут для
Сквозной дедлайн
У HTTP-запроса, джобы или RPC должен быть один бюджет, который прокидывается вниз: handler - сервис - БД - внешний API - stream - timer.
Типичная ошибка
Не ставьте независимые
Abort кооперативен
Он работает только там, где API принимает
Cleanup обязателен
Вывод:
Сильный production-паттерн - один сквозной
AbortController важен не как таймаут для
fetch, а как контракт жизненного цикла операции. В production частая ошибка - клиент уже ушел, SLA истек, а сокеты, стримы и временные файлы продолжают жить.Сквозной дедлайн
У HTTP-запроса, джобы или RPC должен быть один бюджет, который прокидывается вниз: handler - сервис - БД - внешний API - stream - timer.
const client = new AbortController();

req.on('close', () => {
  client.abort(new Error('client disconnected'));
});

const signal = AbortSignal.any([
  client.signal,
  AbortSignal.timeout(1500)
]);

try {
  const r = await fetch(reportUrl, { signal });
  await pipeline(r.body, createWriteStream(file), { signal });
} finally {
  await rm(tmpDir, {
    recursive: true,
    force: true
  }).catch(() => {});
}
Типичная ошибка
Не ставьте независимые
timeout: 1000 в каждом слое. Так запрос легко живет 3+ секунды, хотя общий SLA был 1 секунда. Практический совет: передавайте сверху signal, а локальный меньший бюджет делайте через AbortSignal.any().Abort кооперативен
Он работает только там, где API принимает
signal: fetch, timers/promises, stream.pipeline, часть fs, http, child_process, клиенты БД. Предупреждение: Promise.race() с таймаутом не отменяет реальную работу, он только перестает ждать результат.Cleanup обязателен
abort() не удалит временные файлы, не вернет connection в pool и не снимет listeners. Освобождайте ресурсы в finally и прокидывайте внутрь signal, а не controller.Вывод:
Сильный production-паттерн - один сквозной
AbortSignal, понятный signal.reason и гарантированный cleanup каждой операции.
👍3
WeakRef, FinalizationRegistry и утечки в нативных коллбэках: ловушки памяти в V8
Node.js и GC V8 делают много работы за нас, но есть сценарии, где автоматическое управление памятью отключается. Особенно когда в дело входят нативные аддоны на C++ с N-API и коллбэки, которые живут дольше, чем само JS-окружение. WeakRef и FinalizationRegistry часто подают как спасение, но на практике это западня, если не понимать деталей.
WeakRef: иллюзия безопасности
WeakRef хранит слабую ссылку на объект и не мешает GC. Выглядит удобно для кэширования, но deref() может вернуть undefined в любой момент:
* Практический совет: никогда не рассчитывай на то, что объект жив после deref().
* Типичная ошибка: думать, что WeakRef продлевает жизнь объекту. Нет, GC может уничтожить его сразу.
FinalizationRegistry: не деструктор
FinalizationRegistry вызывает коллбэк после сборки мусора, но это не гарантированный cleanup:
* Подводный камень: время вызова не определено, и если процесс завершился, коллбэк может не случиться.
* Практический совет: используй FinalizationRegistry только для логирования или диагностики, а не как основной механизм освобождения ресурсов.
Утечки в нативных коллбэках: скрытый убийца
Нативные аддоны с N-API могут захватить JS-коллбэк через napi_ref и забыть его освободить. В результате объект зависает навсегда:
* Production-oriented пример: обработчик событий в long-running процессе, где каждый вызов on создает новую ссылку без очистки.
* Решение: в аддонах используй napi_create_reference с 0 — это слабая ссылка, и явно удаляй ссылку при завершении работы.
Вывод:
Утечки в нативных коллбэках проще предотвратить на этапе проектирования, чем отлавливать с помощью слабых ссылок — дисциплина и явные cleanup-паттерны остаются единственной надежной защитой.
Node.js и GC V8 делают много работы за нас, но есть сценарии, где автоматическое управление памятью отключается. Особенно когда в дело входят нативные аддоны на C++ с N-API и коллбэки, которые живут дольше, чем само JS-окружение. WeakRef и FinalizationRegistry часто подают как спасение, но на практике это западня, если не понимать деталей.
WeakRef: иллюзия безопасности
WeakRef хранит слабую ссылку на объект и не мешает GC. Выглядит удобно для кэширования, но deref() может вернуть undefined в любой момент:
const cache = new Map();
function cachedGet(key, factory) {
  let ref = cache.get(key);
  if (ref && ref.deref()) return ref.deref();
  const obj = factory();
  cache.set(key, new WeakRef(obj));
  return obj;
}
* Практический совет: никогда не рассчитывай на то, что объект жив после deref().
* Типичная ошибка: думать, что WeakRef продлевает жизнь объекту. Нет, GC может уничтожить его сразу.
FinalizationRegistry: не деструктор
FinalizationRegistry вызывает коллбэк после сборки мусора, но это не гарантированный cleanup:
const registry = new FinalizationRegistry((heldValue) => {
  console.log(Cleanup for ${heldValue});
});
registry.register(obj, 'some-id');
* Подводный камень: время вызова не определено, и если процесс завершился, коллбэк может не случиться.
* Практический совет: используй FinalizationRegistry только для логирования или диагностики, а не как основной механизм освобождения ресурсов.
Утечки в нативных коллбэках: скрытый убийца
Нативные аддоны с N-API могут захватить JS-коллбэк через napi_ref и забыть его освободить. В результате объект зависает навсегда:
nativeModule.on('data', (msg) => console.log(msg));
// В C++: napi_create_reference(env, callback, 1, &ref);
// И никогда не вызывается napi_delete_reference(ref);
* Production-oriented пример: обработчик событий в long-running процессе, где каждый вызов on создает новую ссылку без очистки.
* Решение: в аддонах используй napi_create_reference с 0 — это слабая ссылка, и явно удаляй ссылку при завершении работы.
Вывод:
Утечки в нативных коллбэках проще предотвратить на этапе проектирования, чем отлавливать с помощью слабых ссылок — дисциплина и явные cleanup-паттерны остаются единственной надежной защитой.

❤2
Стратегии борьбы с throttle в event loop при работе с Native Addons и FFI через worker_threads
Node.js живёт на одном потоке — это знают все. Но когда в дело вступают Native Addons (napi, C++ модули) и FFI (Foreign Function Interface), event loop может неожиданно "зависнуть". Даже если ты используешь
FFI тут особенно неприятен. Библиотеки типа
Что с этим делать?
1. Вынос в dedicated worker.
Создаёшь отдельный worker, грузишь туда аддон, общаешься через
Внутри worker:
2. Асинхронные API для аддонов.
Если пишешь аддон сам — используй n-api async work (
3. Пул worker'ов с очередью.
Задачи распределяются, и один тяжёлый вызов не может монополизировать все ресурсы. Стандартный паттерн — берёшь задачу из очереди, отдаёшь свободному воркеру.
4. Atomics и SharedArrayBuffer.
Блокировка без захвата event loop. Но требует поддержки
5. Мониторинг.
Замеряй время вызовов через
Коротко:
-
- Для своих аддонов — async n-api.
- Для FFI — пулы и очереди.
Вывод:
Изоляция нативных вызовов через worker_threads с асинхронными API и мониторингом — единственный способ избежать throttling event loop в production.
Node.js живёт на одном потоке — это знают все. Но когда в дело вступают Native Addons (napi, C++ модули) и FFI (Foreign Function Interface), event loop может неожиданно "зависнуть". Даже если ты используешь
worker_threads, throttle всё равно случается. Почему? Потому что нативные вызовы не всегда изолируются полностью. Блокирующий системный вызов в аддоне может зацепить libuv thread pool или V8, и основной поток начинает тормозить.FFI тут особенно неприятен. Библиотеки типа
ffi-napi или koffi вызывают shared library синхронно — event loop просто стоит и ждёт, пока вызов вернётся. Все остальные задачи замораживаются.Что с этим делать?
1. Вынос в dedicated worker.
Создаёшь отдельный worker, грузишь туда аддон, общаешься через
MessageChannel. Главное — не передавай shared memory без синхронизации, если аддон не thread-safe.const { Worker } = require('worker_threads');
const worker = new Worker('./native-worker.js', { workerData: {} });
worker.postMessage({ task: 'heavyCalc', data: [1, 2, 3] });
worker.on('message', result => console.log('Результат:', result));Внутри worker:
const { parentPort } = require('worker_threads');
const nativeAddon = require('native-addon');
parentPort.on('message', msg => {
  const result = nativeAddon.heavySync(msg.data);
  parentPort.postMessage(result);
});
2. Асинхронные API для аддонов.
Если пишешь аддон сам — используй n-api async work (
napi_create_async_work). Для FFI — заворачивай вызовы в setImmediate или setTimeout с нулевой задержкой. Это даёт event loop шанс обработать другие задачи.3. Пул worker'ов с очередью.
Задачи распределяются, и один тяжёлый вызов не может монополизировать все ресурсы. Стандартный паттерн — берёшь задачу из очереди, отдаёшь свободному воркеру.
4. Atomics и SharedArrayBuffer.
Блокировка без захвата event loop. Но требует поддержки
SharedArrayBuffer и аккуратной реализации.5. Мониторинг.
Замеряй время вызовов через
process.hrtime.bigint() или performance.now(). Если вызов длится дольше 50ms — это красный флаг. Логируй и переключай на worker.Коротко:
-
worker_threads — база, но не панацея.- Для своих аддонов — async n-api.
- Для FFI — пулы и очереди.
Вывод:
Изоляция нативных вызовов через worker_threads с асинхронными API и мониторингом — единственный способ избежать throttling event loop в production.

❤2
Diagnostics Channel: Загляни внутрь Node.js в production без console.log и перезаливок
Когда приложение падает в production, а логи пусты - начинается классика: залипаешь в терминал с
Что за зверь?
Модуль
Где выстрелит?
- Утечки HTTP-соединений - канал
- HTTP/2 сессии и их жизненный цикл
- Работа DNS-резолвера
- Создание и завершение Worker Threads
- Зависания событийного цикла - канал
Пример: ловим утечки HTTP-соединений
Кладёшь этот код в
Как тащить в production?
- Условный require:
- Или динамически подключай по
- Только помни: подписка - синхронная операция. Не делай внутри тяжёлых вычислений или блокирующих I/O, иначе забьёшь event loop и ухудшишь производительность
Вывод:
Diagnostics Channel позволяет заглянуть внутрь Node.js в реальном времени под нагрузкой, чтобы поймать утечки и задержки до того, как они уронят production, причём без единой правки кода приложения.
Когда приложение падает в production, а логи пусты - начинается классика: залипаешь в терминал с
console.log, комментируешь половину кода и перезаливаешь. Но у Node.js есть встроенный механизм для подписки на внутренние события движка и модулей без правки исходников. Называется diagnostics_channel.Что за зверь?
Модуль
diagnostics_channel даёт каналы, именуемые по схеме модуль.событие.подсобытие. Через них V8, libuv и сам Node.js эмитят структурированные данные о внутренних операциях. Подписаться можно без правки кода приложения - просто инициализируешь слушателя в отдельном файле и подключаешь через флаг --require.Где выстрелит?
- Утечки HTTP-соединений - канал
http.client.request.create- HTTP/2 сессии и их жизненный цикл
- Работа DNS-резолвера
dns- Создание и завершение Worker Threads
- Зависания событийного цикла - канал
tickПример: ловим утечки HTTP-соединений
const diagnosticsChannel = require('diagnostics_channel');

const clientRequestChannel = diagnosticsChannel.channel('http.client.request.create');
clientRequestChannel.subscribe(({ request, socket }) => {
  const startTime = Date.now();

  request.on('response', (res) => {
    console.log(Request to ${request.hostname} completed (${Date.now() - startTime}ms));
  });

  socket.on('close', () => {
    if (Date.now() - startTime > 5000) {
      console.warn(Long-lived socket detected: ${socket.remotePort});
    }
  });
});
Кладёшь этот код в
diagnostics.js, запускаешь с флагом node --require ./diagnostics.js app.js - и никаких изменений в исходниках приложения.Как тащить в production?
- Условный require:
NODE_DEBUG_DIAGNOSTICS=1 node app.js с проверкой в коде- Или динамически подключай по
process.env при старте, чтобы не плодить лишние подписки- Только помни: подписка - синхронная операция. Не делай внутри тяжёлых вычислений или блокирующих I/O, иначе забьёшь event loop и ухудшишь производительность
Вывод:
Diagnostics Channel позволяет заглянуть внутрь Node.js в реальном времени под нагрузкой, чтобы поймать утечки и задержки до того, как они уронят production, причём без единой правки кода приложения.

Event Loop Lag при тысячах setTimeout: как очередь таймеров убивает latency в production
Когда на сервере больше 1000 активных setTimeout или setInterval, latency неожиданно растет, I/O начинает тормозить, а пользователи жалуются на задержки. Многие разработчики считают, что таймеры безвредны, но на практике их перебор в одной фазе event loop блокирует весь tick.
Всё упирается в фазы цикла событий:
- timers — коллбеки от setTimeout и setInterval
- pending callbacks — I/O ошибки
- idle, prepare — внутренняя кухня libuv
- poll — новые I/O события
- check — очередь setImmediate
- close callbacks — закрытие соединений
Проблема: когда у вас 10 000 активных setTimeout, фаза timers отрабатывает десятки миллисекунд. Всё остальное стоит в очереди. I/O, новые запросы, ответы — всё ждёт, пока переберутся таймеры.
Реальный случай из практики
Был сервис с heartbeats для клиентов. Каждый клиент держал рекурсивный setTimeout:
Для 5000 клиентов каждый tick на фазе timers прогонял до 5000 коллбеков. Попутно лагали все остальные запросы — пользователи чувствовали задержки, мониторинг показывал event loop lag > 100ms.
Что с этим делать?
Во-первых, отлаживать. Берём профайлер Node.js:
Смотрим лог — находим, сколько времени уходит на фазу timers. Часто это открытие.
Во-вторых, оптимизировать.
- Ограничьте количество активных таймеров. Сгруппируйте несколько heartbeat-задач в один setInterval.
- Там, где возможна замена, используйте setImmediate. Он живёт на фазе check — не блокирует poll и timers.
- Мониторьте event loop lag через
Можно ещё раскидать тяжёлые таймерные задачи по worker_threads — чтобы они не тормозили главный поток.
Вывод:
Большое количество таймеров — тихий убийца производительности, который часто замечают слишком поздно, но своевременный профилинг и рефакторинг очередей могут снизить latency в разы.
Когда на сервере больше 1000 активных setTimeout или setInterval, latency неожиданно растет, I/O начинает тормозить, а пользователи жалуются на задержки. Многие разработчики считают, что таймеры безвредны, но на практике их перебор в одной фазе event loop блокирует весь tick.
Всё упирается в фазы цикла событий:
- timers — коллбеки от setTimeout и setInterval
- pending callbacks — I/O ошибки
- idle, prepare — внутренняя кухня libuv
- poll — новые I/O события
- check — очередь setImmediate
- close callbacks — закрытие соединений
Проблема: когда у вас 10 000 активных setTimeout, фаза timers отрабатывает десятки миллисекунд. Всё остальное стоит в очереди. I/O, новые запросы, ответы — всё ждёт, пока переберутся таймеры.
Реальный случай из практики
Был сервис с heartbeats для клиентов. Каждый клиент держал рекурсивный setTimeout:
function heartBeat(clientId) {
  setTimeout(() => {
    // Тяжёлая операция с БД + проверка состояния
    heartBeat(clientId);
  }, 1000);
}
Для 5000 клиентов каждый tick на фазе timers прогонял до 5000 коллбеков. Попутно лагали все остальные запросы — пользователи чувствовали задержки, мониторинг показывал event loop lag > 100ms.
Что с этим делать?
Во-первых, отлаживать. Берём профайлер Node.js:
node --prof app.js
Смотрим лог — находим, сколько времени уходит на фазу timers. Часто это открытие.
Во-вторых, оптимизировать.
- Ограничьте количество активных таймеров. Сгруппируйте несколько heartbeat-задач в один setInterval.
- Там, где возможна замена, используйте setImmediate. Он живёт на фазе check — не блокирует poll и timers.
- Мониторьте event loop lag через
process.hrtime или модуль event-loop-stats. Если lag > 50ms — это звоночек.Можно ещё раскидать тяжёлые таймерные задачи по worker_threads — чтобы они не тормозили главный поток.
Вывод:
Большое количество таймеров — тихий убийца производительности, который часто замечают слишком поздно, но своевременный профилинг и рефакторинг очередей могут снизить latency в разы.

❤2
process.nextTick в дебаунсерах: как сделать Event Loop неубиваемым?
Кажется, что
Почему nextTick опасен в дебаунсере?
*
* Это убивает производительность при частых событиях, например, в WebSocket или resize.
Что происходит под капотом?
Когда вы пишете:
То при каждом вызове кладется микрозадача. Если событие приходит каждую миллисекунду, Event Loop не успевает обработать I/O, таймеры или setImmediate. Это классический starvation.
Как диагностировать проблему?
* Используйте
* Clinic.js покажет, как микрозадачи занимают 100% цикла.
* Старый трюк — замер времени через
Правильный дебаунс — через setTimeout
Это макрозадача, которая не блокирует Event Loop.
Когда nextTick оправдан?
Только для синхронной обработки ошибок или действий, которые должны выполниться строго до следующей фазы. В дебаунсерах — никогда.
Если приложение тормозит на событиях, первым делом проверяйте дебаунсеры на наличие
Вывод:
Кажется, что
process.nextTick быстрее setTimeout(fn, 0), поэтому его часто используют в дебаунсерах. Но в production это может заблокировать Event Loop, превратив приложение в тормознутый монолит. Ошибка в том, что разработчики путают микрозадачи с макрозадачами и не видят последствий.Почему nextTick опасен в дебаунсере?
process.nextTick выполняется до всех фаз Event Loop, включая I/O и таймеры. Если дебаунсер вызывает nextTick рекурсивно или на каждое событие, микрозадачи забивают очередь, и Event Loop не может перейти к другим фазам. Результат: CPU 100%, запросы висят, приложение умирает.*
nextTick никогда не даст выполниться I/O, пока его очередь не опустеет.* Это убивает производительность при частых событиях, например, в WebSocket или resize.
Что происходит под капотом?
Когда вы пишете:
function badDebounce(fn) {
  let pending = false;
  return function() {
    if (!pending) {
      pending = true;
      process.nextTick(() => {
        pending = false;
        fn();
      });
    }
  };
}
То при каждом вызове кладется микрозадача. Если событие приходит каждую миллисекунду, Event Loop не успевает обработать I/O, таймеры или setImmediate. Это классический starvation.
Как диагностировать проблему?
* Используйте
node --inspect и CPU profiling: ищите много вызовов nextTick в стеке.* Clinic.js покажет, как микрозадачи занимают 100% цикла.
* Старый трюк — замер времени через
process.hrtime.bigint(): если setImmediate выполняется с большой задержкой, значит, nextTick блокирует.Правильный дебаунс — через setTimeout
function debounce(fn, delay) {
  let timer = null;
  return function() {
    clearTimeout(timer);
    timer = setTimeout(() => fn.apply(this, arguments), delay);
  };
}
Это макрозадача, которая не блокирует Event Loop.
setTimeout корректно обрабатывает события на I/O фазе и не вызывает starvation.Когда nextTick оправдан?
Только для синхронной обработки ошибок или действий, которые должны выполниться строго до следующей фазы. В дебаунсерах — никогда.
Если приложение тормозит на событиях, первым делом проверяйте дебаунсеры на наличие
process.nextTick. Это частая причина падения производительности в Node.js.Вывод:
process.nextTick в дебаунсере блокирует Event Loop и приводит к starvation I/O, используйте setTimeout как единственно правильный вариант, чтобы не убить производительность в production.
⚡1
Когда нет утечки, а OOM приходит: дефрагментация кучи V8
Внезапные Out of Memory в долгоживущих Node.js-процессах при работе с буферами и стримами — частая проблема в production, особенно при файловой обработке или проксировании данных. Разработчики ищут утечки, но код часто чист — настоящая причина скрыта в фрагментации Old Space кучи V8.
Как выглядит изнутри
Интенсивная работа с
Production-oriented пример
Рассмотрим типичный стрим для обработки данных:
Каждый вызов
Типичная ошибка
V8 не гарантирует дефрагментацию: GC двигает объекты только в Young Generation, а буферы как внешние ресурсы дополнительно блокируются в Old Space. Усложняет ситуацию objectMode в стримах — он генерирует тысячи мелких объектов, ускоряя фрагментацию.
Практические советы
* Используйте пулы буферов — переиспользуйте через
* Ограничьте
* Отключайте objectMode, если он не критичен — он создает избыточные объекты.
* Применяйте
* Мониторьте
Вывод:
Дефрагментация кучи V8 — редкая, но реальная причина OOM в долгоживущих процессах с интенсивным выделением буферов, которая лечится нормальными паттернами управления памятью и проектированием потоков.
Внезапные Out of Memory в долгоживущих Node.js-процессах при работе с буферами и стримами — частая проблема в production, особенно при файловой обработке или проксировании данных. Разработчики ищут утечки, но код часто чист — настоящая причина скрыта в фрагментации Old Space кучи V8.
Как выглядит изнутри
Интенсивная работа с
Buffer.alloc, Buffer.concat и стримами создает непрерывный цикл выделения и освобождения памяти. Со временем живые объекты оставляют мелкие "дыры" в Old Space. GC отлично собирает мусор, но не может дефрагментировать неподвижные объекты в старом пространстве. Результат — FATAL ERROR: Ineffective mark-compacts near heap limit Allocation failed, хотя суммарно свободной памяти ещё много.Production-oriented пример
Рассмотрим типичный стрим для обработки данных:
const { Readable } = require('stream');
let data = Buffer.alloc(0);
const stream = new Readable({
  read(size) {
    data = Buffer.concat([data, Buffer.alloc(1024)]);
    this.push(Buffer.alloc(1024));
  }
});
stream.on('data', () => {});
Каждый вызов
Buffer.concat создает новый буфер, старый закрепляется в памяти. Через часы работы — OOM при попытке выделить следующий буфер.Типичная ошибка
V8 не гарантирует дефрагментацию: GC двигает объекты только в Young Generation, а буферы как внешние ресурсы дополнительно блокируются в Old Space. Усложняет ситуацию objectMode в стримах — он генерирует тысячи мелких объектов, ускоряя фрагментацию.
Практические советы
* Используйте пулы буферов — переиспользуйте через
Buffer.allocUnsafe с ручным обнулением или свой pool.* Ограничьте
--max-old-space-size — это не панацея, но даёт запас до падения.* Отключайте objectMode, если он не критичен — он создает избыточные объекты.
* Применяйте
stream.pipeline вместо ручного управления для снижения накопления мусора.* Мониторьте
heapStats: стабильный рост malloced_memory с does_zap_garbage — явный признак фрагментации.Вывод:
Дефрагментация кучи V8 — редкая, но реальная причина OOM в долгоживущих процессах с интенсивным выделением буферов, которая лечится нормальными паттернами управления памятью и проектированием потоков.

Скрытые убийцы Event Loop: ICU и Regex в Unicode-строках
Многие знают, что JSON.parse или fs.readFileSync блокируют Event Loop. Но есть враги похитрее - синхронные вызовы ICU и регулярных выражений на unicode-строках. Типичная ошибка: разработчики не подозревают, что методы нормализации или unicode-регулярки могут висеть десятки миллисекунд, оставаясь незамеченными до production-нагрузки.
Где прячется ICU
ICU тихо сидит в методах:
*
*
*
Регулярки с флагами
Пример скрытой блокировки
Как профилировать
* Используй
* Разбрасывай логи с
* Clinic.js:
Как устранять
Для ICU:
* Выноси нормализацию в Worker Threads
* Режь на чанки по 1000 символов, обрабатывай порциями
* Предобрабатывай данные на этапе загрузки, а не в рантайме
Для RegExp:
* Типичная ошибка: паттерны с backtracking, например
* Попробуй
* Разбивай строку через
Практический совет
Используй
Вывод: ICU и unicode-регекспы выглядят безобидно, но регулярно просаживают производительность - профилируйте их отдельно под нагрузкой, а не только в изолированных тестах.
Многие знают, что JSON.parse или fs.readFileSync блокируют Event Loop. Но есть враги похитрее - синхронные вызовы ICU и регулярных выражений на unicode-строках. Типичная ошибка: разработчики не подозревают, что методы нормализации или unicode-регулярки могут висеть десятки миллисекунд, оставаясь незамеченными до production-нагрузки.
Где прячется ICU
ICU тихо сидит в методах:
*
String.prototype.normalize()*
String.prototype.toLocaleLowerCase()*
Intl APIРегулярки с флагами
/u или /s на больших строках (эмодзи, иероглифы) могут висеть синхронно десятки миллисекунд. И ты даже не сразу поймешь, почему твой сервер тупит.Пример скрытой блокировки
const hugeText = '🦄'.repeat(100000);
const start = performance.now();
hugeText.normalize('NFC'); // ICU молча обрабатывает 100к символов
console.log(Блокировка: ${performance.now() - start}ms);
Как профилировать
* Используй
--prof флаг Node.js, потом node --prof-process.* Разбрасывай логи с
performance.now() до и после подозрительных операций.* Clinic.js:
npx clinic doctor -- node app.jsКак устранять
Для ICU:
* Выноси нормализацию в Worker Threads
* Режь на чанки по 1000 символов, обрабатывай порциями
* Предобрабатывай данные на этапе загрузки, а не в рантайме
const { Worker } = require('worker_threads');
const worker = new Worker('./normalize-worker.js');
worker.postMessage(hugeText);
Для RegExp:
* Типичная ошибка: паттерны с backtracking, например
(a+)+b. Меняй на a+b.* Попробуй
re2 - без backtracking, работает предсказуемо* Разбивай строку через
string.slice, если можноconst safePattern = /^[a-z]+$/u;
Практический совет
Используй
monitorEventLoopDelay() из perf_hooks - он показывает задержки Event Loop в наносекундах. Запусти его в фоне и сравнивай с пиками нагрузки.Вывод: ICU и unicode-регекспы выглядят безобидно, но регулярно просаживают производительность - профилируйте их отдельно под нагрузкой, а не только в изолированных тестах.

❤2