Связка GSC и Gemini вскрывает промпты, которые триггерят цитаты в AI Overview и упоминания бренда
Отчет
Он не раскрывает, почему появляются эти страницы, какие промпты триггерят цитату и упоминает ли Google бренд в ответе или просто дает ссылку.
Эти данные нужно собирать вручную, так как базового экспорта показов по
Эту брешь закрывает этап извлечения.
Скрипт в консоли браузера подгружает отчет в скрытом
Дальше каждый найденный урл делится на информационный (цель — цитирование) или коммерческий (цель — рекомендация) по правилам структуры
Затем кастомная интеграция
На каждую страницу
Вся суть в запросах-кандидатах.
Этот шаг — поиск, а не железобетонная истина.
Когда одна модель читает страницу и угадывает, на какие вопросы она отвечает, на выходе получается гипотеза, а не подтвержденный триггер.
Вот почему каждый запрос-кандидат должен валидироваться на следующих этапах.
На этапе валидации каждый кандидат-промпт прогоняется через
Каждый ответ фиксируется по двум отдельным исходам: Цитирование (домен клиента падает в источники) и Упоминание (бренд появляется в тексте ответа).
Это абсолютно разные победы, и зазор между ними — это поле для стратегии.
Полевые тесты показывают: на коммерческом интенте доля цитирований и упоминаний бренда кардинально расходятся.
Разделение, которое меняет весь план: информационные страницы генерируют объем показов в
Ссылка и рекомендация требуют разных посадочных, поэтому цель оптимизации выбирается под интент, а не сваливается в одну метрику.
Если отслеживать соотношение цитирований к упоминаниям в динамике, а не разовым срезом, это само по себе становится мощным сигналом.
Любой дрейф в любую сторону показывает, как меняется машинное понимание страницы.
#AIOverviews #GSC #AI
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Отчет
Generative AI в GSC показывает, какие страницы собирают показы в AIO, и больше ничего.Он не раскрывает, почему появляются эти страницы, какие промпты триггерят цитату и упоминает ли Google бренд в ответе или просто дает ссылку.
Эти данные нужно собирать вручную, так как базового экспорта показов по
URL и датам просто не существует.Эту брешь закрывает этап извлечения.
Скрипт в консоли браузера подгружает отчет в скрытом
iframe, проходит по каждому из 30 дней, выставляя параметры даты за сутки, и парсит URL с показами прямо из таблицы.Дальше каждый найденный урл делится на информационный (цель — цитирование) или коммерческий (цель — рекомендация) по правилам структуры
URL, а спорные страницы проверяются руками.Затем кастомная интеграция
JavaScript в Screaming Frog прогоняет универсальный промпт через Claude Sonnet для каждого URL из отчета.На каждую страницу
Sonnet отдает фиксированную схему в JSON: тему, гео, сущности, цитируемые факты, FAQs, пять возможных запросов-кандидатов и главный контент-гэп страницы.Вся суть в запросах-кандидатах.
Этот шаг — поиск, а не железобетонная истина.
Когда одна модель читает страницу и угадывает, на какие вопросы она отвечает, на выходе получается гипотеза, а не подтвержденный триггер.
Вот почему каждый запрос-кандидат должен валидироваться на следующих этапах.
На этапе валидации каждый кандидат-промпт прогоняется через
Gemini с включенным Google Search grounding — моделью, которая как раз и работает под капотом AI Overviews.Каждый ответ фиксируется по двум отдельным исходам: Цитирование (домен клиента падает в источники) и Упоминание (бренд появляется в тексте ответа).
Это абсолютно разные победы, и зазор между ними — это поле для стратегии.
Полевые тесты показывают: на коммерческом интенте доля цитирований и упоминаний бренда кардинально расходятся.
Разделение, которое меняет весь план: информационные страницы генерируют объем показов в
AI Overview, но именно на коммерческих страницах компанию реально называют по имени.Ссылка и рекомендация требуют разных посадочных, поэтому цель оптимизации выбирается под интент, а не сваливается в одну метрику.
Если отслеживать соотношение цитирований к упоминаниям в динамике, а не разовым срезом, это само по себе становится мощным сигналом.
Любой дрейф в любую сторону показывает, как меняется машинное понимание страницы.
#AIOverviews #GSC #AI
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤2
AI Overviews забирают самый структурированный кусок с консенсусом — на качество текста им плевать
Снимаем мистику с
У него тот же базовый индекс, тот же перекос в сторону авторитета и та же механика консенсуса.
Алгоритм разбивает один запрос на веер подзапросов, а семплирование токенов заставляет каждую генерацию расставлять цитаты немного иначе.
Но этот рандом живет на этапе генерации, а не отбора.
Пул источников, на которые машина сошлется по запросу, остается стабильным — а стабильный пул можно отреверсить.
Метод сводится к объемам до анализа: собери ~30+ выдач по целевому запросу (в чистом профиле без логина, затем с логином, затем с мобилки) и логируй то, что повторяется — какие урлы цитируются и где они лежат в классическом серпе, как структурирован ответ, какие сущности выделены жирным, что всплывает при каждом рефреше, а что — только иногда.
Попасть в пул — не значит получить цитату: страница может висеть в пуле кандидатов каждый раз, но появиться лишь в половине твоих выдач, потому что финальный выбор включает встроенный рандом.
Когда
Затем отследи каждую страницу из
Это редко бывает одно чистое предложение, потому что синтез сшивает куски со всей страницы или из разных источников.
Единственный вопрос к каждому экстракту: почему этот кусок было легко забрать?
Он сразу давал ответ, был самодостаточным, лежал под заголовком, точно совпадающим с запросом, в нужном для
Машина не оценивает экспертность или качество письма.
Она цепляется за кусок, который проще всего спарсить и безопаснее всего привязать к источнику, потому что заземленный ответ спроектирован так, чтобы выдавать только то, что можно железобетонно подтвердить ссылками.
Сетевой трафик самого
Сборка идет по принципу "скопируй и добей", где есть два сценария провала.
Слишком уникальный контент ломает консенсус, и ты вообще не попадаешь в пул; полная копия не дает машине ни одной причины менять уже проверенного лидера.
Скопируй структуру, которую извлекает
Только после этого добавляй единственный дифференциатор: обновленную статистику, сущность, которую никто не покрыл, или таблицу, которая напрашивалась в ответе, но отсутствовала у конкурентов.
Та же механика работает в
Входной барьер — это не возраст домена и не четырнадцать лет наработки авторитета.
Страница с
Это окно возможностей из 2010 года, только сейчас на рынке крутятся рекордные корпоративные бюджеты, а большинство продавцов
И это окно будет закрываться по мере взросления моделей и коммодитизации тулзов.
Сейчас главный защитный ров — это скорость и объемы итераций.
Инсайты комьюнити
— Идеальная структура лишь заставляет алгоритм распарсить страницу; вход в пул решает консенсус — но он сверяется с запросом, а эти запросы разговорные. Страница может иметь идеальную разметку, но пролететь мимо, потому что дает ответ канцелярским языком спецификаций, тогда как люди спрашивают простыми словами.
#AIOverviews #GEO #SERPAnalysis
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Снимаем мистику с
GEO: AI Overview — это тот же серп, просто с текстовой надстройкой.У него тот же базовый индекс, тот же перекос в сторону авторитета и та же механика консенсуса.
Алгоритм разбивает один запрос на веер подзапросов, а семплирование токенов заставляет каждую генерацию расставлять цитаты немного иначе.
Но этот рандом живет на этапе генерации, а не отбора.
Пул источников, на которые машина сошлется по запросу, остается стабильным — а стабильный пул можно отреверсить.
Метод сводится к объемам до анализа: собери ~30+ выдач по целевому запросу (в чистом профиле без логина, затем с логином, затем с мобилки) и логируй то, что повторяется — какие урлы цитируются и где они лежат в классическом серпе, как структурирован ответ, какие сущности выделены жирным, что всплывает при каждом рефреше, а что — только иногда.
Stable Core — это то, что выпадает при каждом парсинге: источники, сущности и форматы, которые система считает обязательными.Попасть в пул — не значит получить цитату: страница может висеть в пуле кандидатов каждый раз, но появиться лишь в половине твоих выдач, потому что финальный выбор включает встроенный рандом.
Когда
Overview выделяет сущность жирным, он бесплатно отдает тебе карту значимости тех токенов, которым выдал максимальный вес.Затем отследи каждую страницу из
Stable Core до конкретного пассажа, который вытянул Overview.Это редко бывает одно чистое предложение, потому что синтез сшивает куски со всей страницы или из разных источников.
Единственный вопрос к каждому экстракту: почему этот кусок было легко забрать?
Он сразу давал ответ, был самодостаточным, лежал под заголовком, точно совпадающим с запросом, в нужном для
Overview формате и подтверждал данные других источников.Машина не оценивает экспертность или качество письма.
Она цепляется за кусок, который проще всего спарсить и безопаснее всего привязать к источнику, потому что заземленный ответ спроектирован так, чтобы выдавать только то, что можно железобетонно подтвердить ссылками.
Сетевой трафик самого
Gemini раскрывает эту механику: извлеченный пассаж передается в атрибуте, который буквально называется snippets.Сборка идет по принципу "скопируй и добей", где есть два сценария провала.
Слишком уникальный контент ломает консенсус, и ты вообще не попадаешь в пул; полная копия не дает машине ни одной причины менять уже проверенного лидера.
Скопируй структуру, которую извлекает
Overview, собери все сущности из Stable Core и правильно их свяжи (это дает тебе пропуск в пул), сверстай прямые ответы под заголовками из запросов и подтверди консенсусный ответ.Только после этого добавляй единственный дифференциатор: обновленную статистику, сущность, которую никто не покрыл, или таблицу, которая напрашивалась в ответе, но отсутствовала у конкурентов.
Та же механика работает в
ChatGPT, Claude, Gemini, Grok и Perplexity — трастовые источники меняются в зависимости от модели, но логика "извлечь и подтвердить" не меняется никогда.Входной барьер — это не возраст домена и не четырнадцать лет наработки авторитета.
Страница с
DR30, правильными сущностями, нужной структурой и одним куском реальной добавленной ценности может стоять в Overview рядом с брендами, сжигающими миллионы.Это окно возможностей из 2010 года, только сейчас на рынке крутятся рекордные корпоративные бюджеты, а большинство продавцов
GEO-услуг не могут объяснить саму механику.И это окно будет закрываться по мере взросления моделей и коммодитизации тулзов.
Сейчас главный защитный ров — это скорость и объемы итераций.
Инсайты комьюнити
— Идеальная структура лишь заставляет алгоритм распарсить страницу; вход в пул решает консенсус — но он сверяется с запросом, а эти запросы разговорные. Страница может иметь идеальную разметку, но пролететь мимо, потому что дает ответ канцелярским языком спецификаций, тогда как люди спрашивают простыми словами.
#AIOverviews #GEO #SERPAnalysis
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

👍2
13 281 fan-out запрос раскрывает 3.2x разрыв в поиске между известными и неизвестными брендами
Бренды, которые модель уже вытягивала из памяти в топ-10 для категории, появлялись в ее собственных
Это опирается на 1 416 наблюдений на уровне бренда — 274 из 492 брендов в памяти ушли в поиск, против 161 из 924 неизвестных.
Попадание в топ-5 при извлечении из памяти поднимало этот показатель до 67%.
Разрыв сохранился во всех девяти замерянных нишах: неизвестные бренды искались с частотой 9-23%, а бренды из памяти — 41-82%.
Извлечение из памяти (recall) стоит до сетевого поиска (fetch), что сдвигает рычаг влияния раньше, чем предполагает большинство
Лишь 31%
Из этих брендовых 31%, в 63% случаев модель тянулась к одному из топ-5 имен, которые уже держала в памяти.
Пул кандидатов формируется еще до того, как извлечена хотя бы одна страница.
Когорту делят два режима, они измеряются как доля брендовых запросов, называющих запомненный топ-5 бренд.
Автомобильная ниша сработала на 82%, а Финансы на 77%: в одном ответе по
Это ее топ-4 брендов из памяти, и каждый был обернут в один и тот же шаблон "
Фитнес и ЗОЖ показали 50% — там модель гораздо чаще ищет за пределами собственной памяти.
Впрочем, память тоже не гарантирует монополию: на вопрос, какого платежного провайдера выбрать стартапу, модель поискала
Выводы строятся на анализе боевых
Память и поиск замерялись на двух разных моделях (поиск — на Gemini 3.5 Flash).
Бренду нужно было пройти обе по отдельности, что делает этот разрыв минимальным порогом, а не багом одной конкретной модели.
Исследование называет это корреляцией в разведочных данных, а не доказанной причиной.
Главный фактор искажения — известность бренда: популярные бренды и лучше запоминаются, и чаще ищутся.
Нишевые срезы опираются на 6–12 промптов, поэтому они скорее ранжируют категории, чем замеряют точный размер эффекта.
Если паттерн подтверждается, именно над извлечением из памяти и предстоит работать.
А оно формируется на этапе обучения и зарабатывается через устойчивую ассоциацию с категорией:
— Упоминания у аналитиков и в прессе.
— Сигналы партнерств.
— Стабильная связка бренда и категории в сравнениях и листинг-контенте, на котором обучаются модели.
В категории, завязанной на память, попадание в сохраненный пул — это почти обязательное условие для того, чтобы бренд вообще начали искать.
В категории со слабой памятью живой контент все еще может затянуть неизвестный бренд в
https://geosurge.ai/posts/model-memory-predicts-which-brands-get-searched
#AgenticSEO #AIOverviews #LLM
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Бренды, которые модель уже вытягивала из памяти в топ-10 для категории, появлялись в ее собственных
fan-out запросах в 3.2 раза чаще, чем бренды, которых она не помнила: 17.4% → 55.7%.Это опирается на 1 416 наблюдений на уровне бренда — 274 из 492 брендов в памяти ушли в поиск, против 161 из 924 неизвестных.
Попадание в топ-5 при извлечении из памяти поднимало этот показатель до 67%.
Разрыв сохранился во всех девяти замерянных нишах: неизвестные бренды искались с частотой 9-23%, а бренды из памяти — 41-82%.
Извлечение из памяти (recall) стоит до сетевого поиска (fetch), что сдвигает рычаг влияния раньше, чем предполагает большинство
SEO-задач.Лишь 31%
fan-out запросов вообще называли конкретный бренд; остальные 69% были общими категорийными поисками.Из этих брендовых 31%, в 63% случаев модель тянулась к одному из топ-5 имен, которые уже держала в памяти.
Пул кандидатов формируется еще до того, как извлечена хотя бы одна страница.
Когорту делят два режима, они измеряются как доля брендовых запросов, называющих запомненный топ-5 бренд.
Автомобильная ниша сработала на 82%, а Финансы на 77%: в одном ответе по
BNPL-сервисам модель запустила шесть fan-out запросов, четыре из которых были чисто брендовыми — Affirm, Klarna, Afterpay, PayPal.Это ее топ-4 брендов из памяти, и каждый был обернут в один и тот же шаблон "
merchant fees US".Фитнес и ЗОЖ показали 50% — там модель гораздо чаще ищет за пределами собственной памяти.
Впрочем, память тоже не гарантирует монополию: на вопрос, какого платежного провайдера выбрать стартапу, модель поискала
Stripe, PayPal и Square из памяти, а затем назвала Lemon Squeezy, которого вообще не было в ее радаре.Выводы строятся на анализе боевых
fan-out запросов, а не текста ответов — 13 281 запрос в 3 960 ответах (66 коммерческих промптов для США прогонялись по 60 раз в течение 12 дней).Память и поиск замерялись на двух разных моделях (поиск — на Gemini 3.5 Flash).
Бренду нужно было пройти обе по отдельности, что делает этот разрыв минимальным порогом, а не багом одной конкретной модели.
Исследование называет это корреляцией в разведочных данных, а не доказанной причиной.
Главный фактор искажения — известность бренда: популярные бренды и лучше запоминаются, и чаще ищутся.
Нишевые срезы опираются на 6–12 промптов, поэтому они скорее ранжируют категории, чем замеряют точный размер эффекта.
Если паттерн подтверждается, именно над извлечением из памяти и предстоит работать.
А оно формируется на этапе обучения и зарабатывается через устойчивую ассоциацию с категорией:
— Упоминания у аналитиков и в прессе.
— Сигналы партнерств.
— Стабильная связка бренда и категории в сравнениях и листинг-контенте, на котором обучаются модели.
В категории, завязанной на память, попадание в сохраненный пул — это почти обязательное условие для того, чтобы бренд вообще начали искать.
В категории со слабой памятью живой контент все еще может затянуть неизвестный бренд в
fan-out, но это более слабая позиция, так как ее придется отвоевывать заново на каждом запросе.https://geosurge.ai/posts/model-memory-predicts-which-brands-get-searched
#AgenticSEO #AIOverviews #LLM
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

Гайды с самопиаром на первое место отдают рекомендации вашим конкурентам
Анализ
В запросах, активирующих
Такие подборки получили 323 цитирования; в 224 случаях бренд-автор так и не получил рекомендацию.
Цитирование и рекомендация — это независимые действия, которыми управляют разные критерии.
Цитирование означает, что страница оказалась удобной для парсинга информации.
Рекомендация отражает то, что более широкий веб (форумы, отзовики, пресса, аналитики) уже говорит об этом бренде, независимо от наличия гайда.
Тот факт, что вы поставили себя на первое место в собственном материале, никак не влияет на второй пункт.
Для нового бренда со слабым цифровым следом такой гайд бьет рикошетом и работает против вас: модель вытягивает со страницы названия конкурентов и их сравнение, рекомендует их, но оставляет автора за бортом.
Кейс по запросу "best AI data catalogs in 2026" доказывает это максимально чисто.
Определение для
Но в рекомендациях висят лидеры категории во главе с
Даже когда "
Но теперь побочный ущерб уже не ограничивается простым игнором.
В промптах с жесткими требованиями модели начали напрямую называть конкретные продукты, которых стоит избегать под конкретный юзкейс, и подтягивать под это источники.
Так что неподходящий бренд может всплыть как прямое исключение из правил.
Рекомендация — это то место, куда реально перетекает трафик.
Для пользователей, впервые столкнувшихся с брендом, она принесла примерно вдвое больше поисков, визитов и просмотров продуктов по сравнению со вскользь брошенным упоминанием — скачок на 117–185% в течение недели.
Рекомендованный бренд забрал примерно в 2.5 раза больше нового трафика, чем конкуренты за бортом списка.
При этом только около 9% этих визитов пришли напрямую из
Остальное — это брендовый поиск и
Рычаг для нового бренда лежит за пределами сайта.
Он жестко привязан к авторитетным сигналам, которые невозможно сфабриковать гайдом: стороннее подтверждение (G2, Gartner), сайты с отзывами, обсуждения в комьюнити (особенно Reddit, на который жестко опираются ИИ-ответы), заработанные медиа (earned media), попадание в чужие рейтинги, оригинальные исследования и обзоры аналитиков.
Собственный гайд по-прежнему формирует то, как
Инсайты комьюнити
— Цитаты и рекомендации лежат на разных слоях, а не на разных ступенях одной лестницы: цитата означает, что страница полезна прямо сейчас, тогда как рекомендация зависит от того, считает ли модель бренд трастовой сущностью в нише. Эту метрику нельзя прокачать простым он-пейдж контентом. Гайд бьет рикошетом по новому бренду, потому что упоминание конкурентов в сравнении алгоритм считывает как глубину категории именно для этих конкурентов, а не для площадки-издателя.
— Полевые данные из миллионов ИИ-ответов, которые трекаются ежемесячно, указывают на офф-пейдж стратегию: нужно составить карту экосистемы, смежных категорий покупок, критериев покупателей и юзкейсов, а затем выстраивать контент вокруг этих контекстных модификаторов, чтобы перехватить больше цитирований. Это критически важно в
#AIOverviews #ContentStrategy #B2B
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Анализ
100 B2B-запросов формата "best [category] software" прогнали этой весной по трем разным датам.В запросах, активирующих
AI Overviews, алгоритм в 69% случаев цитировал собственный саморекламный список бренда, но выкидывал этот же бренд из блока рекомендаций, отправляя покупателей прямиком к конкурентам.Такие подборки получили 323 цитирования; в 224 случаях бренд-автор так и не получил рекомендацию.
Цитирование и рекомендация — это независимые действия, которыми управляют разные критерии.
Цитирование означает, что страница оказалась удобной для парсинга информации.
Рекомендация отражает то, что более широкий веб (форумы, отзовики, пресса, аналитики) уже говорит об этом бренде, независимо от наличия гайда.
Тот факт, что вы поставили себя на первое место в собственном материале, никак не влияет на второй пункт.
Для нового бренда со слабым цифровым следом такой гайд бьет рикошетом и работает против вас: модель вытягивает со страницы названия конкурентов и их сравнение, рекомендует их, но оставляет автора за бортом.
Кейс по запросу "best AI data catalogs in 2026" доказывает это максимально чисто.
Определение для
AIO парсится с DQLabs — небольшого вендора, который поставил себя на первое место в рейтинге.Но в рекомендациях висят лидеры категории во главе с
Atlan.Atlan тоже публикует аналогичный список с самопиаром, но при этом получает и цитаты, и рекомендации, потому что Gartner и Forrester уже признали их лидерами.Даже когда "
best" сводится к входному порогу функций, бренд с трастом от внешнего веба всегда побеждает гайд, который сам же эту категорию описывает.Но теперь побочный ущерб уже не ограничивается простым игнором.
В промптах с жесткими требованиями модели начали напрямую называть конкретные продукты, которых стоит избегать под конкретный юзкейс, и подтягивать под это источники.
Так что неподходящий бренд может всплыть как прямое исключение из правил.
Рекомендация — это то место, куда реально перетекает трафик.
Для пользователей, впервые столкнувшихся с брендом, она принесла примерно вдвое больше поисков, визитов и просмотров продуктов по сравнению со вскользь брошенным упоминанием — скачок на 117–185% в течение недели.
Рекомендованный бренд забрал примерно в 2.5 раза больше нового трафика, чем конкуренты за бортом списка.
При этом только около 9% этих визитов пришли напрямую из
AI.Остальное — это брендовый поиск и
direct, которые атрибуция по последнему клику никогда не свяжет с ИИ.Рычаг для нового бренда лежит за пределами сайта.
Он жестко привязан к авторитетным сигналам, которые невозможно сфабриковать гайдом: стороннее подтверждение (G2, Gartner), сайты с отзывами, обсуждения в комьюнити (особенно Reddit, на который жестко опираются ИИ-ответы), заработанные медиа (earned media), попадание в чужие рейтинги, оригинальные исследования и обзоры аналитиков.
Собственный гайд по-прежнему формирует то, как
LLM воспринимает категорию — и это единственная выгода, которая остается бренду, пока модели не готовы его рекомендовать.Инсайты комьюнити
— Цитаты и рекомендации лежат на разных слоях, а не на разных ступенях одной лестницы: цитата означает, что страница полезна прямо сейчас, тогда как рекомендация зависит от того, считает ли модель бренд трастовой сущностью в нише. Эту метрику нельзя прокачать простым он-пейдж контентом. Гайд бьет рикошетом по новому бренду, потому что упоминание конкурентов в сравнении алгоритм считывает как глубину категории именно для этих конкурентов, а не для площадки-издателя.
— Полевые данные из миллионов ИИ-ответов, которые трекаются ежемесячно, указывают на офф-пейдж стратегию: нужно составить карту экосистемы, смежных категорий покупок, критериев покупателей и юзкейсов, а затем выстраивать контент вокруг этих контекстных модификаторов, чтобы перехватить больше цитирований. Это критически важно в
AI Mode. Тренировочные данные тоже жестко якорят эти ответы, особенно в Claude и ChatGPT.#AIOverviews #ContentStrategy #B2B
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤2
Тест 270 запросов доказывает: ИИ-поиск цементирует топ из 4-5 брендов — GEO-хаки не пробивают стену
Маркетологи оптимизируют под
Тест 270 запросов формата
По запросам
Для
Концентрация максимальна на первой позиции:
Тезис автора: бренды либо сидят внутри пузыря узнаваемости категории, либо вылетают из него.
Всё решают накопленные годами отзывы, листиклы, аналитика и статьи со сравнениями.
Паттерны извлечения зависят от платформы.
По источникам расхождения аналогичные:
—
—
—
Главный фильтр отсева — время.
Модели сходятся на брендах, которые выстраивали самую мощную инфраструктуру сигналов в конкурентной категории на протяжении 12–18 месяцев.
Бренду за бортом устоявшегося пула понадобится 18 месяцев непрерывной работы, чтобы просто там засветиться.
Гайды для покупателей дают слабый
В шестимесячном окне:
— Синхронизация категории на продуктовых страницах, сравнениях и решениях.
— Попадание в сторонние листиклы, которые цитирует каждый движок.
— Брифинги с аналитиками, дающие узнаваемость.
— Контент-сравнения на трастовых сайтах, где бренда пока нет.
Накопительный эффект (18–24 месяца):
— Программы оригинальных исследований.
— Глубина присутствия на агрегаторах отзывов
— Присутствие на
— Контент, задающий стандарты категории и становящийся каноничным.
Всё это не сдвинет квартальные метрики видимости — это слой, который определяет пул лидеров после того, как категория консолидировалась.
https://marketingadvice.substack.com/p/ai-search-rewards-category-leaders
#AI #AIOverviews #BrandSERP
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Маркетологи оптимизируют под
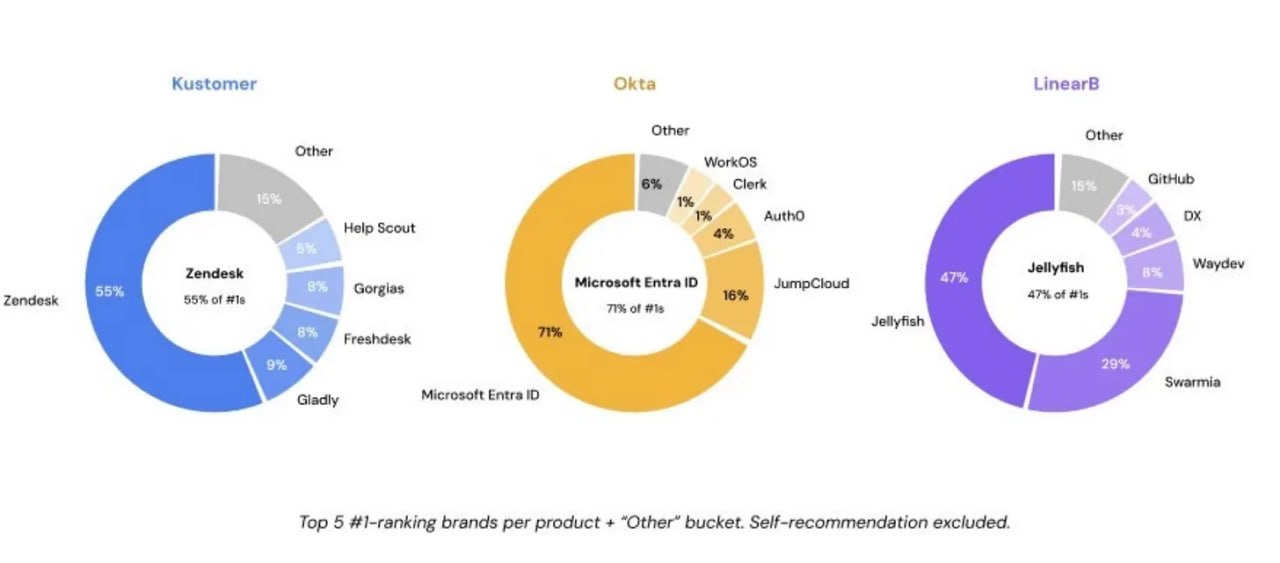
AI-выдачу так, будто это классический поиск.Тест 270 запросов формата
alternatives to (по 30+ вариаций на продукт, одним промптом в чистых чатах ChatGPT, Gemini и Perplexity) доказывает обратное: работает фильтр на включение.По запросам
Kustomer alternatives четыре бренда (Zendesk, Gorgias, Freshdesk, Intercom) заняли топ-5 почти в каждом ответе, а пятый по частоте бренд появлялся более чем в два раза реже.Для
Okta alternatives и LinearB alternatives картина та же — замкнутый пул из пяти брендов.Концентрация максимальна на первой позиции:
Microsoft Entra ID забирает топ-1 в 71% запросов Okta alternatives, а Zendesk — в 55% запросов по Kustomer.Тезис автора: бренды либо сидят внутри пузыря узнаваемости категории, либо вылетают из него.
Всё решают накопленные годами отзывы, листиклы, аналитика и статьи со сравнениями.
Паттерны извлечения зависят от платформы.
ChatGPT обращался к лайв-интернету только в 44% из 270 запросов — остальные 56% ответов брались чисто из обучающей выборки, поэтому устаревший слепок бренда может выживать без свежего извлечения.Gemini ходил в поиск в 74% запросов.Perplexity — во всех.По источникам расхождения аналогичные:
—
ChatGPT: около трети цитирований идёт на листиклы, плюс небольшая доля форумов, где почти всё забирает Reddit.—
Gemini: больше половины цитирований — это сайты вендоров (корпоративные блоги, страницы-сравнения и документация по продукту).—
Perplexity: страницы вендоров вперемешку с аналитикой и документацией, при этом плотность цитирования в 3–4 раза выше, чем у ChatGPT.Главный фильтр отсева — время.
Модели сходятся на брендах, которые выстраивали самую мощную инфраструктуру сигналов в конкурентной категории на протяжении 12–18 месяцев.
Бренду за бортом устоявшегося пула понадобится 18 месяцев непрерывной работы, чтобы просто там засветиться.
Гайды для покупателей дают слабый
ROI без стороннего подтверждения на уровне категории: две компании выкатили идентичные стратегии по гайдам, но сработала она только у одной.В шестимесячном окне:
— Синхронизация категории на продуктовых страницах, сравнениях и решениях.
— Попадание в сторонние листиклы, которые цитирует каждый движок.
— Брифинги с аналитиками, дающие узнаваемость.
— Контент-сравнения на трастовых сайтах, где бренда пока нет.
Накопительный эффект (18–24 месяца):
— Программы оригинальных исследований.
— Глубина присутствия на агрегаторах отзывов
G2 и Capterra.— Присутствие на
Reddit и в профильных комьюнити через реальное участие.— Контент, задающий стандарты категории и становящийся каноничным.
Всё это не сдвинет квартальные метрики видимости — это слой, который определяет пул лидеров после того, как категория консолидировалась.
https://marketingadvice.substack.com/p/ai-search-rewards-category-leaders
#AI #AIOverviews #BrandSERP
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
10
Утечка GSC: промпты AI Mode оседают как обычные запросы, остальное прячет анонимный пул
Остаточный след разговоров из
Джон Мюллер подтвердил, что эти данные всегда лежали в отчете.
Отчеты об эффективности
Повторная проверка на собственном сайте автора 11 августа 2026 года показала, что ни
Векторы, которые реально вытягивают эти запросы:
— Вытягивай весь пул запросов через
— Закидывай кастомную регулярку в настройку
— Разворачивай такой же детектор локально через собственные
Списки паттернов и ручная сортировка теряют пограничные классы — проверки позиций от ранк-трекеров, промпты агентских харнесов, вставленные куски текста, запросы "
Детерминированные правила забирают точные классы, тогда как обученная модель отвечает за серую зону между разговорными, длиннохвостыми и обычными запросами: модель
На выходе получаем 7 сегментов с оценкой уверенности по каждому запросу, до 100 000 запросов за прогон и без лимита на строки в экспорте; добавление отчета по генеративному ИИ маппит страницы к запросам через экспортированную колонку ИИ-страниц.
У всех методов есть один жесткий потолок.
Google анонимизирует редкие запросы, разговорные фразы встречаются редко, поэтому часть пула вообще никогда не всплывает — клики из
На собственной выгрузке автора из
Воспринимай любой извлеченный массив данных как жесткий недоучет.
https://suganthan.com/blog/how-to-track-ai-mode-traffic/
#GSC #AIOverviews #Keywords
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
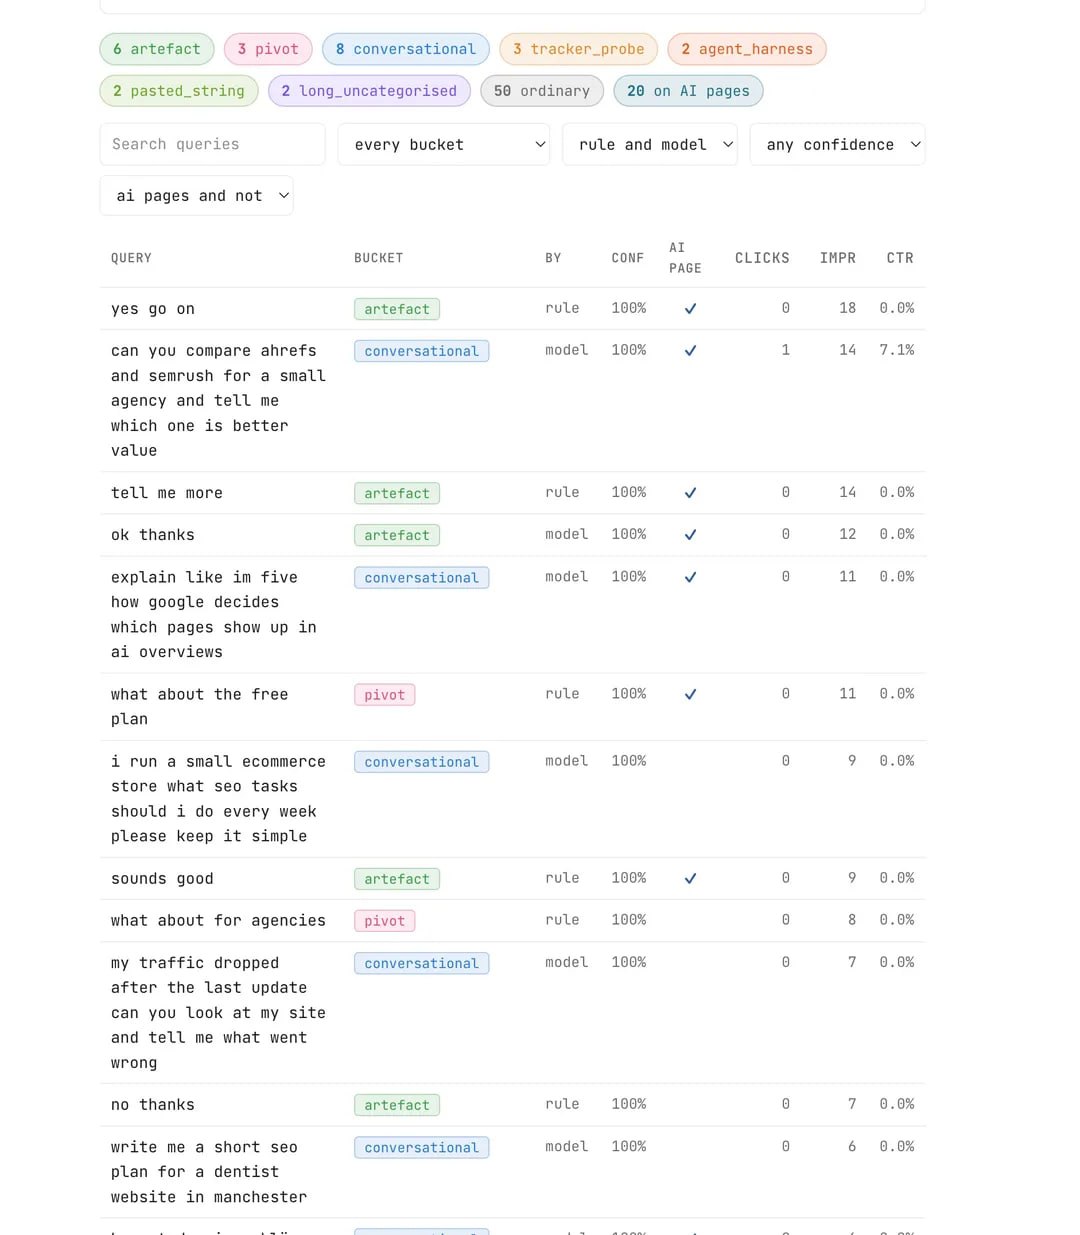
Остаточный след разговоров из
AI Mode и AI Overviews падает в отчет об эффективности GSC как обычные запросы: артефакты ответов типа "yes go on", уточняющие развороты и целиком скопированные промпты.Джон Мюллер подтвердил, что эти данные всегда лежали в отчете.
Отчеты об эффективности
Search Generative AI, которые Google выкатил 3 июня 2026 года, фиксируют только показы внутри фич генеративного ИИ и больше ничего — чисто UI, без привязки к запросам.Повторная проверка на собственном сайте автора 11 августа 2026 года показала, что ни
Search Analytics API, ни массовый экспорт BigQuery не отдают данные генеративного ИИ, поэтому официального пути для отслеживания AI Mode на уровне запросов нет.Векторы, которые реально вытягивают эти запросы:
— Вытягивай весь пул запросов через
Search Analytics API, так как интерфейс отчета режет любую таблицу на 1000 строк, а затем скорми список Claude, чтобы он разметил вероятные строки AI Mode.— Закидывай кастомную регулярку в настройку
Custom regex фильтра запросов: одно длинное перечисление, покрывающее глаголы промптов (write, draft, generate, summarize, explain, act as), приветствия, подтверждения (yes, ok, sounds good, yes go on), отказы и фоллоу-апы (more, continue, show me more, any other options) — собирается через сравнение дефолтных LLM-промптов со строками, которые редко мелькали в GSC до AI Overviews.— Разворачивай такой же детектор локально через собственные
MCP-серверы автора — GSC MCP отдает его как инструмент genaiconversationqueries, BigQuery MCP прогоняет его по массовому экспорту, где лежит анонимизированный пул — с разметкой уровня запроса на каждой строке.Списки паттернов и ручная сортировка теряют пограничные классы — проверки позиций от ранк-трекеров, промпты агентских харнесов, вставленные куски текста, запросы "
my location is" — а так как они собраны на английском, то пропускают тамильские реплаи или смесь хинглиша без разметки.Детерминированные правила забирают точные классы, тогда как обученная модель отвечает за серую зону между разговорными, длиннохвостыми и обычными запросами: модель
xlm-roberta-base, претрейненная на 100 языках, дообучена на размеченном выхлопе GSC плюс синтетике на 8 языках, включая Tanglish и Hinglish, отвалидирована на 120 000+ запросах и дважды переобучена на ошибках.На выходе получаем 7 сегментов с оценкой уверенности по каждому запросу, до 100 000 запросов за прогон и без лимита на строки в экспорте; добавление отчета по генеративному ИИ маппит страницы к запросам через экспортированную колонку ИИ-страниц.
У всех методов есть один жесткий потолок.
Google анонимизирует редкие запросы, разговорные фразы встречаются редко, поэтому часть пула вообще никогда не всплывает — клики из
AI Mode трекаются в GSC, при этом сами запросы за ними почти полностью анонимизируются.На собственной выгрузке автора из
BigQuery, замерянной 11 августа 2026 года, 57.7% показов сидели в анонимизированном пуле на отрезке в 59 дней.Воспринимай любой извлеченный массив данных как жесткий недоучет.
https://suganthan.com/blog/how-to-track-ai-mode-traffic/
#GSC #AIOverviews #Keywords
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤1
Zero-click убил только инфосайты под рекламу — это все потери со времен HCU
Пока что ровно одна бизнес-модель была фактически уничтожена интернетом с ИИ-ответами и зеро-клик выдачей: информационные контентники, монетизируемые через рекламу.
Это все потери со времен
Никто не заносит депозит в казино, не бронирует пересадку волос за $4k и не нанимает адвоката по травмам прямо из сниппета.
Коммерческие запросы с высоким интентом все еще кликают — забирай их и игнорируй остальное.
Статус бренда, который цитирует модель, окупается дважды: цитата сейчас, брендовый поиск потом.
А брендовый поиск скармливает поведенческие сигналы обратно в алгоритмы ранжирования.
Это смещает фокус с вылизывания страниц на фабрикацию консенсуса вокруг имени.
Модели
Выведи в топ один коммерческий ключ или добейся, чтобы сами контакты процитировали внутри
Заявленная математика автора: 50 звонков в месяц перевешивают 50k просмотров страниц за копейки с рекламы.
Когда клики пересохнут, уже собранная аудитория останется единственным активом, который никто не сможет деиндексировать.
Клик никогда не был продуктом.
Деньги лежат ниже по воронке интента, а то, что стер ИИ — это низкоинтентный трафик, который и так почти ничего не стоил вне масштабных доиишных схем.
По мере обвала кликов, ценность тех, что выжили, растет исключительно на законах спроса и предложения.
#AIOverviews #SearchIntent #ContentStrategy
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Пока что ровно одна бизнес-модель была фактически уничтожена интернетом с ИИ-ответами и зеро-клик выдачей: информационные контентники, монетизируемые через рекламу.
Это все потери со времен
HCU, что, впрочем, не гарантирует, что они останутся единственными.Zero-click бьет только по тем операторам, которые продавали клики на информацию.Ecommerce, SaaS, локальному SEO, лидгену, паразитам, видео, неанглоязычным сайтам и агентствам абсолютно плевать, что AI Overview ответил "что такое ипотека".Никто не заносит депозит в казино, не бронирует пересадку волос за $4k и не нанимает адвоката по травмам прямо из сниппета.
Коммерческие запросы с высоким интентом все еще кликают — забирай их и игнорируй остальное.
Статус бренда, который цитирует модель, окупается дважды: цитата сейчас, брендовый поиск потом.
А брендовый поиск скармливает поведенческие сигналы обратно в алгоритмы ранжирования.
Это смещает фокус с вылизывания страниц на фабрикацию консенсуса вокруг имени.
Модели
Pay-per-call и лидгена вообще игнорируют показы.Выведи в топ один коммерческий ключ или добейся, чтобы сами контакты процитировали внутри
AI Overview, перехватывай звонок, получай оплату за лид.Заявленная математика автора: 50 звонков в месяц перевешивают 50k просмотров страниц за копейки с рекламы.
Email-базы, комьюнити и подписчики — это та дистрибуция, которую не отзовет ни один алгоритм.Когда клики пересохнут, уже собранная аудитория останется единственным активом, который никто не сможет деиндексировать.
Клик никогда не был продуктом.
Деньги лежат ниже по воронке интента, а то, что стер ИИ — это низкоинтентный трафик, который и так почти ничего не стоил вне масштабных доиишных схем.
По мере обвала кликов, ценность тех, что выжили, растет исключительно на законах спроса и предложения.
#AIOverviews #SearchIntent #ContentStrategy
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
💯2👍1
Данные доказывают: упоминания на 4+ внешних площадках форсируют ИИ-цитирование в 2.8 раза — у лидеров меньше KG-сущностей
Модели отдают ответ, который видят повсюду.
Вот почему запись в
Данные доказывают обратное: часто цитируемые страницы в среднем содержат меньше верифицированных
Вместо этого модели цепляются за конкретные, нишевые сущности — названный метод, точную статистику, именное сравнение — а микроразметка остается лишь гигиеной идентификации, а не драйвером цитирования.
Извлечение также идет на уровне чанков, а не целых страниц.
ИИ-ответы подтягивают абзацы, а большинство сайтов не содержат ни одного чистого блока, который движок мог бы безопасно процитировать.
Открывай каждый ключевой раздел прямым утверждением "[X] — это [Y]" и вычищай хеджирование: никаких "если", "но" или "возможно".
Упоминания бренда коррелируют с попаданием в
Скорее всего, дело в том, что анкоры ссылок размываются, тогда как упоминание намертво привязывается к сущности самого бренда.
Упоминания без ссылок теперь засчитываются как голоса, а извлечение с 4+ сторонних площадок поднимает шансы на цитирование ~2.8x:
— Сайты-отзовики
— Листинг-статьи
— Транскрипты
—
Половина жалоб в духе "почему меня не цитируют" сводится к правилу
Лезь в логи файрвола и
Модели также дают перевес доменам, которым уже доверяют.
Плотный, похожий на ответ чанк на трастовом хосте влетает в ИИ-выдачу, пока свежий домен все еще сидит в песочнице.
Арендуй траст, засеивай сущность, перехватывай клик или брендовый поиск.
Консенсус — это вообще вся суть игры: модель выдает то, с чем согласны везде.
Единственная оставшаяся задача — стать этим ответом на каждой площадке, откуда парсятся данные.
#AIOverviews #BrandMentions #KnowledgeGraph
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Модели отдают ответ, который видят повсюду.
Вот почему запись в
Knowledge Graph, за которой все советовали гнаться, — это ложный вектор.Данные доказывают обратное: часто цитируемые страницы в среднем содержат меньше верифицированных
KG-сущностей, чем те, что цитируются редко.Вместо этого модели цепляются за конкретные, нишевые сущности — названный метод, точную статистику, именное сравнение — а микроразметка остается лишь гигиеной идентификации, а не драйвером цитирования.
Извлечение также идет на уровне чанков, а не целых страниц.
ИИ-ответы подтягивают абзацы, а большинство сайтов не содержат ни одного чистого блока, который движок мог бы безопасно процитировать.
Открывай каждый ключевой раздел прямым утверждением "[X] — это [Y]" и вычищай хеджирование: никаких "если", "но" или "возможно".
Упоминания бренда коррелируют с попаданием в
AI Overview примерно в 3 раза сильнее, чем бэклинки.Скорее всего, дело в том, что анкоры ссылок размываются, тогда как упоминание намертво привязывается к сущности самого бренда.
Упоминания без ссылок теперь засчитываются как голоса, а извлечение с 4+ сторонних площадок поднимает шансы на цитирование ~2.8x:
— Сайты-отзовики
— Листинг-статьи
— Транскрипты
YouTube—
PRПоловина жалоб в духе "почему меня не цитируют" сводится к правилу
Cloudflare или WAF, которое втихую блокирует GPTBot, ClaudeBot, PerplexityBot и Google-Extended.Лезь в логи файрвола и
robots.txt, прежде чем трогать хоть слово в контенте — страница, которую запрещено краулить, никогда не станет ответом.Модели также дают перевес доменам, которым уже доверяют.
Плотный, похожий на ответ чанк на трастовом хосте влетает в ИИ-выдачу, пока свежий домен все еще сидит в песочнице.
Арендуй траст, засеивай сущность, перехватывай клик или брендовый поиск.
Консенсус — это вообще вся суть игры: модель выдает то, с чем согласны везде.
Единственная оставшаяся задача — стать этим ответом на каждой площадке, откуда парсятся данные.
#AIOverviews #BrandMentions #KnowledgeGraph
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Патент Google Visual Citations раскрывает механику: совпадение по картинке перевешивает текст при выборе источника
Патент, поданный в 2023 году и опубликованный в апреле 2026-го, описывает флоу генерации ответа.
Алгоритм сначала выбирает источник по совпадению картинки, а уже потом подтягивает окружающий текст для формирования ответа.
Это лишь заявка, а не подтвержденная механика в проде.
Google регистрирует их тысячами, и многие никогда не выходят в прод в описанном виде.
Если рассматривать это как вектор развития, а не как факт, патент переворачивает все правила, на которых строилось
Картинка решает, какая страница попадет в ответ, а текст рядом с этой картинкой решает, что именно скажет ответ.
Операционное следствие — это плейсмент.
Факт, нужный покупателю, должен висеть прямо под картинкой в виде подписи или тега, а не в трех скроллах ниже по странице.
Распознавание не гарантировано.
На одном из рекламных кадров
То, что креативная команда пыталась донести, и то, что фиксирует алгоритм — это разные сущности.
И только вторая попадает в движок ответов.
Текст на картинке отваливается при измеримых условиях.
Пороги отказа, вытянутые из литературы
Сжатие, заточенное исключительно под скорость загрузки, вычищает текст с упаковки, который модель должна была спарсить.
Большую часть слоя измерений берет на себя
—
—
—
—
— Масштабирование проверки идет через
За этими цифрами стоят два вопроса.
Первый: правильно ли машина прочитала то, что в кадре?
И второй: правильный ли объект туда вообще засунули на старте?
Первое — это слой денотации, который можно чекнуть на уровне объектов.
Второе — слой коннотации: проблема брифинга, которую не закроет ни один
https://searchengineland.com/images-new-job-ai-search-485840
#AIOverviews #ImagePack #Patents
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Патент, поданный в 2023 году и опубликованный в апреле 2026-го, описывает флоу генерации ответа.
Алгоритм сначала выбирает источник по совпадению картинки, а уже потом подтягивает окружающий текст для формирования ответа.
Это лишь заявка, а не подтвержденная механика в проде.
Google регистрирует их тысячами, и многие никогда не выходят в прод в описанном виде.
Если рассматривать это как вектор развития, а не как факт, патент переворачивает все правила, на которых строилось
image SEO.Картинка решает, какая страница попадет в ответ, а текст рядом с этой картинкой решает, что именно скажет ответ.
Операционное следствие — это плейсмент.
Факт, нужный покупателю, должен висеть прямо под картинкой в виде подписи или тега, а не в трех скроллах ниже по странице.
Распознавание не гарантировано.
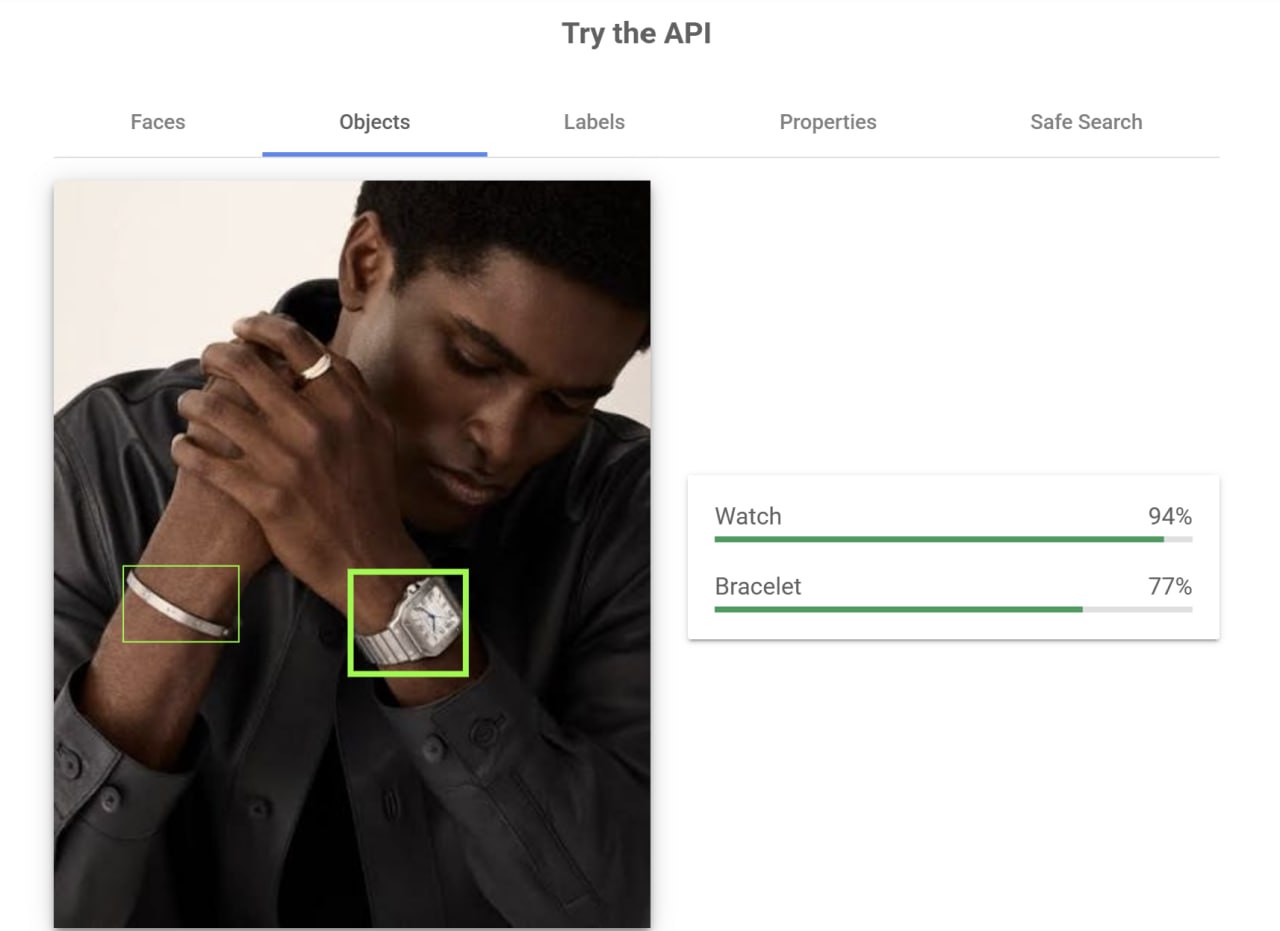
На одном из рекламных кадров
Cartier модель компьютерного зрения выдала браслет и часы, но в упор не заметила кольцо.То, что креативная команда пыталась донести, и то, что фиксирует алгоритм — это разные сущности.
И только вторая попадает в движок ответов.
Текст на картинке отваливается при измеримых условиях.
Пороги отказа, вытянутые из литературы
Cognex и arXiv, а не из спецификаций Google, показывают: OCR ломается при высоте символов ниже ~30px, контрасте менее ~40 оттенков серого, на стилизованных шрифтах и бликах от отражающей упаковки.Сжатие, заточенное исключительно под скорость загрузки, вычищает текст с упаковки, который модель должна была спарсить.
Большую часть слоя измерений берет на себя
Google Cloud Vision API:—
Web Detection отдает fullMatchingImages, partialMatchingImages, visuallySimilarImages и pagesWithMatchingImages. Это проверка на уникальность: реально ли hero image принадлежит вам, или это около-дубль, который юзает половина ниши.—
OBJECT_LOCALIZATION возвращает названия найденных объектов, mid-идентификаторы, скоринг уверенности алгоритма (confidence) и координаты (bounding boxes). Это дает список объектов-соседей в кадре, чтобы контролировать совместную встречаемость по бренд-гайдлайнам. Сам по себе API контекст не оценивает.—
TEXT_DETECTION прогоняет OCR-слой, отвечающий за метрику читаемости.—
FACE_DETECTION отдает faceAnnotations и классификаторы эмоций от UNKNOWN до VERY_UNLIKELY, UNLIKELY, POSSIBLE, LIKELY и VERY_LIKELY (где VERY_LIKELY — это таргет). Отсечка по confidence: 0.90 и выше — железобетонно, 0.70-0.89 — сойдет для второстепенных кадров, все, что ниже 0.60 — это мусор.— Масштабирование проверки идет через
Screaming Frog плюс OpenAI Vision API и остается качественным. Связка флагит запросы, которые страница уже могла бы забрать, если бы ее текст подтверждал то, что нарисовано на фото.За этими цифрами стоят два вопроса.
Первый: правильно ли машина прочитала то, что в кадре?
И второй: правильный ли объект туда вообще засунули на старте?
Первое — это слой денотации, который можно чекнуть на уровне объектов.
Второе — слой коннотации: проблема брифинга, которую не закроет ни один
API.https://searchengineland.com/images-new-job-ai-search-485840
#AIOverviews #ImagePack #Patents
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Ладно…. вот моя странная стратегия, раскрывает Адам Литтл.
Покупаю ссылки в описаниях
Вот и всё.
Поскольку я регулярно выкладываю ролики на
Они попадают в сводки
В некоторых случаях я добавлял текст перед ссылкой, и
Поэтому с тех пор я пишу ютуберам и плачу за ссылки в описаниях к их видео.
Это дешево, потому что:
1) им не нужно делать новое видео 2) больше никто так не делает (??!)
Обычно диалог выглядит так:
Я: привет, хочу купить ссылку на мое приложение в описании твоего видео.
Они: в смысле, снять видео про твое приложение?
Я: нет, от тебя никакой дополнительной работы, просто ссылка на мое приложение, вот и всё.
Они: странно, но.. ок
***
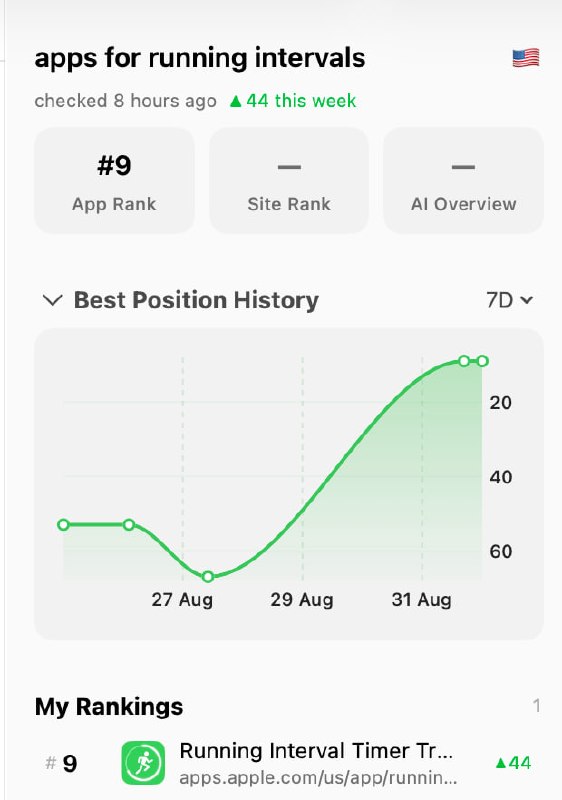
Похоже, моя странная
Приложение поднялось на 44 позиции в поиске Google по запросу "
SEO напрямую привело к росту скачиваний приложения на 27%.
Не самый популярный запрос: 1600 поисков в месяц.
Скачиваний тоже не то чтобы много.
Но это интересный тест того, как SEO генерирует трафик.
Инсайты комьюнити
— Атрибуция заявленного роста скачиваний требует разбивки на
— Базовый механизм — почти мгновенная индексация внешних ссылок в постах — не уникален для
— Окно возможностей ограничено по времени: сразу после публикации тактики авторы каналов начали сами предлагать платное размещение ссылок в описаниях — только ссылка, без нового видео. Гипотеза: ценовое преимущество исчезнет, как только предложение подстроится под спрос.
— Реальные цены опровергают тезис о дешевизне на верхнем пороге: один инфлюенсер выставил ценник в
#ParasiteSEO #LinkBuilding #AIOverviews
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Покупаю ссылки в описаниях
YouTube-видео, которые уже ранжируются по моим ключам.Вот и всё.
Поскольку я регулярно выкладываю ролики на
YouTube, я заметил, что Google индексирует ссылки прямо в описаниях видео.Они попадают в сводки
AI Overview, а сам сайт после этого быстро индексируется.В некоторых случаях я добавлял текст перед ссылкой, и
AI Overview повторял его слово в слово.Поэтому с тех пор я пишу ютуберам и плачу за ссылки в описаниях к их видео.
Это дешево, потому что:
1) им не нужно делать новое видео 2) больше никто так не делает (??!)
Обычно диалог выглядит так:
Я: привет, хочу купить ссылку на мое приложение в описании твоего видео.
Они: в смысле, снять видео про твое приложение?
Я: нет, от тебя никакой дополнительной работы, просто ссылка на мое приложение, вот и всё.
Они: странно, но.. ок
***
Похоже, моя странная
SEO-техника продолжает давать результаты.Приложение поднялось на 44 позиции в поиске Google по запросу "
apps for running intervals".SEO напрямую привело к росту скачиваний приложения на 27%.
Не самый популярный запрос: 1600 поисков в месяц.
Скачиваний тоже не то чтобы много.
Но это интересный тест того, как SEO генерирует трафик.
Инсайты комьюнити
— Атрибуция заявленного роста скачиваний требует разбивки на
Web Referrer и App Store Search: прыжок на 44 позиции по ключу с частоткой 1600 в месяц дает всего несколько кликов в день. Само по себе это редко объясняет рост скачиваний на 27% — причинно-следственная связь с SEO требует проверки, прежде чем считать ее подтвержденной.— Базовый механизм — почти мгновенная индексация внешних ссылок в постах — не уникален для
YouTube. То же самое работает для постов в Facebook, X, Instagram, Pinterest, на WordPress-блогах и бесплатных Shopify-блогах. В широком смысле это классифицируется как Parasite SEO.— Окно возможностей ограничено по времени: сразу после публикации тактики авторы каналов начали сами предлагать платное размещение ссылок в описаниях — только ссылка, без нового видео. Гипотеза: ценовое преимущество исчезнет, как только предложение подстроится под спрос.
— Реальные цены опровергают тезис о дешевизне на верхнем пороге: один инфлюенсер выставил ценник в
$1,000 за одну ссылку в описании. Судя по всему, ставка привязана к популярности канала, а не к затраченным усилиям, которых в любом случае минимум.#ParasiteSEO #LinkBuilding #AIOverviews
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤3
Выгрузки из GSC доказывают: показы Google AI концентрируются на 4–10 позициях, а не в топ-3
На выборке из
— позиции 1–3: 0.35%
— позиции 4–10: 69.2%
— позиции 11–20: 23.5%
— позиции 21+: 6.9%
Это распределение показов, а не частота цитирования по позициям.
В сегментах сидит разное количество
Датасет охватывает июнь-июль 2026 года, около 8 млн показов в органике и 1.06 млн генеративных показов, сматченных по двум выгрузкам из
Это пересечение данных из отчетов, а не полная перепись сайта.
Органика всё ещё служит входным фильтром: все топ-100 урлов по показам в
Но сама позиция внутри этой группы почти ничего не решает.
65% из топ-
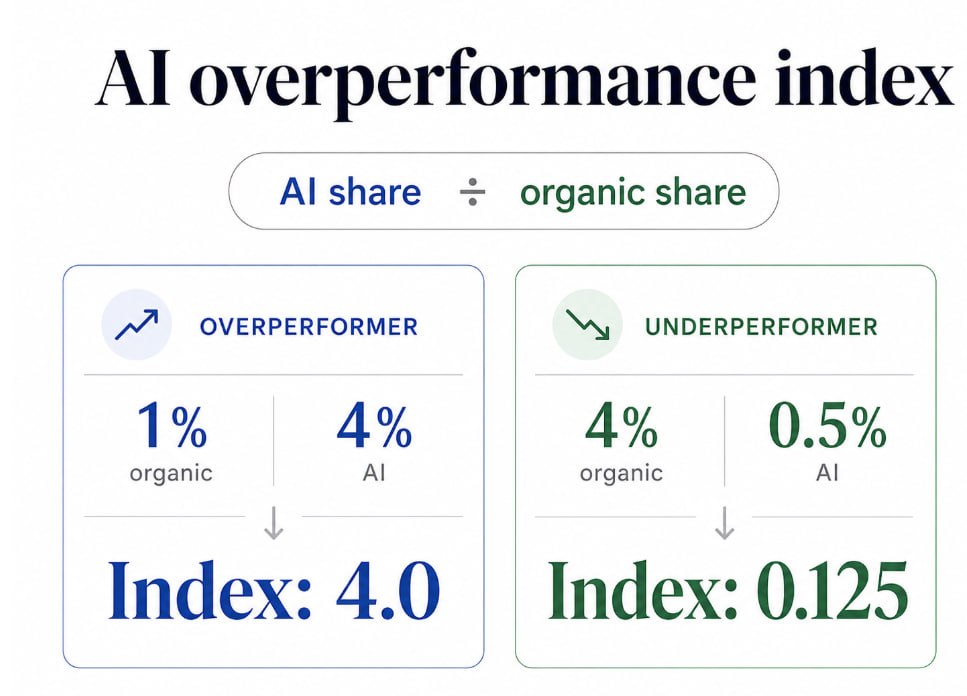
Чтобы отделить масштаб от поведенческих факторов, анализ вводит индекс перевеса
Индекс больше единицы значит, что страница забирает больше видимости в
Например, 1% показов в органике против 4% в
Крошечные знаменатели рисуют дикие коэффициенты на пустом месте, поэтому для качественного среза оставили только
Лидеры по перевесу не сводились к одному типу страниц: туда попали практические гайды, страницы направлений и программ, разборы продуктов, ответы на конкретные юзкейсы, причем некоторые ранжировались за пределами топ-10.
Их объединяла информация, которую легко найти на странице и сразу пустить в ответ: как это работает, какие есть ограничения, что делать дальше.
Блоки
В аутсайдерах оказались навигационные, корпоративные страницы, направления и программы с мощным спросом в органике и околонулевой генеративной видимостью.
Это объясняется интентом: далеко не каждый поиск выигрывает от сгенерированного ответа, который вклинивается между юзером и целевым сайтом.
Эти выводы зажаты двумя ограничениями.
К тому же концентрация видимости в
Одна лишь позиция в ранжировании не объясняет, куда приземляется видимость в
Получается, дотянуть страницу с шестого места до второго — это не тот рычаг для генеративной видимости, который подтверждается этими данными.
https://iamveru.com/google-ai-visibility-and-organic-ranking-data/
#AIOverviews #GSC #Rankings
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
На выборке из
891 URL, засветившихся одновременно в отчетах по органике и Generative AI крупного тревел-проекта, доля показов в AI распределилась так:— позиции 1–3: 0.35%
— позиции 4–10: 69.2%
— позиции 11–20: 23.5%
— позиции 21+: 6.9%
Это распределение показов, а не частота цитирования по позициям.
В сегментах сидит разное количество
URL, и общую долю формирует небольшая группа очень крупных страниц.Датасет охватывает июнь-июль 2026 года, около 8 млн показов в органике и 1.06 млн генеративных показов, сматченных по двум выгрузкам из
GSC на 1000 строк.Это пересечение данных из отчетов, а не полная перепись сайта.
Органика всё ещё служит входным фильтром: все топ-100 урлов по показам в
AI присутствовали в топ-1000 органической выгрузки.Но сама позиция внутри этой группы почти ничего не решает.
65% из топ-
20 URL с максимальной видимостью в AI в среднем болтались в топ-10 органики (медиана 8.57), среди топ-100 таких было 57% (медиана 9.05), а один урл из топ-20 по AI вообще имел среднюю позицию ниже 35.Чтобы отделить масштаб от поведенческих факторов, анализ вводит индекс перевеса
AI: доля показов страницы в AI делится на её долю показов в органике внутри сматченной выборки.Индекс больше единицы значит, что страница забирает больше видимости в
AI, чем в органике.Например, 1% показов в органике против 4% в
AI дает скор 4, тогда как 4% органики против 0.5% в AI дает 0.125.Крошечные знаменатели рисуют дикие коэффициенты на пустом месте, поэтому для качественного среза оставили только
URL с минимум 100 показами в AI и 1000 в органике — фильтр прошли 435 урлов из 891.Лидеры по перевесу не сводились к одному типу страниц: туда попали практические гайды, страницы направлений и программ, разборы продуктов, ответы на конкретные юзкейсы, причем некоторые ранжировались за пределами топ-10.
Их объединяла информация, которую легко найти на странице и сразу пустить в ответ: как это работает, какие есть ограничения, что делать дальше.
Блоки
FAQ, вопросительные заголовки и портянки на 2000 слов — это просто формат подачи, а не та самая выжимка.В аутсайдерах оказались навигационные, корпоративные страницы, направления и программы с мощным спросом в органике и околонулевой генеративной видимостью.
Это объясняется интентом: далеко не каждый поиск выигрывает от сгенерированного ответа, который вклинивается между юзером и целевым сайтом.
Эти выводы зажаты двумя ограничениями.
GSC не отдает запросы, стоящие за показами страницы в Generative AI, так что здесь нет причинно-следственной связи на уровне ключей.К тому же концентрация видимости в
AI вокруг продуктовой категории, с которой компания уже мощно ассоциировалась на внешнем рынке, — это лишь наблюдение: силу сущности никто не оцифровывал в привязке к показам в AI.Одна лишь позиция в ранжировании не объясняет, куда приземляется видимость в
AI.Получается, дотянуть страницу с шестого места до второго — это не тот рычаг для генеративной видимости, который подтверждается этими данными.
https://iamveru.com/google-ai-visibility-and-organic-ranking-data/
#AIOverviews #GSC #Rankings
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
👍1
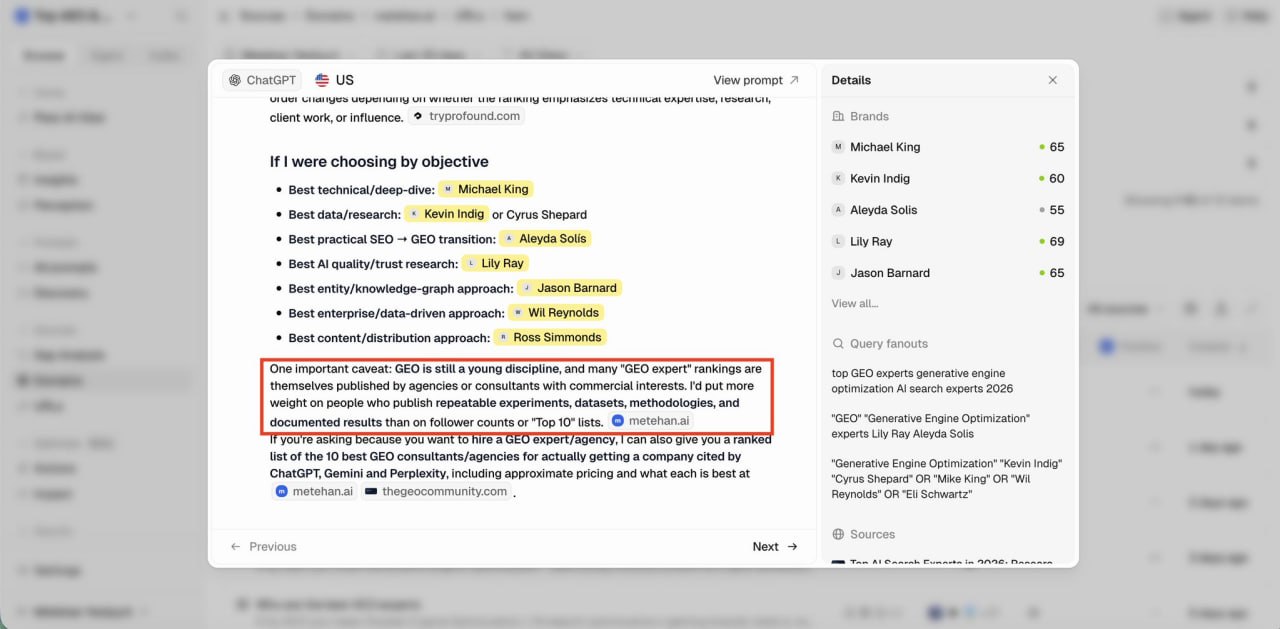
Это интересно; система подхватила дисклеймер и некоторые рекомендации из поста, но не саморекламу, отмечает Лили Рэй.
***
Пример ниже 👇
И вот почему я потерял цитирование, хотя сам поставил себя на первое место.
Пока видел немного такого, но кое-что меняется.
За последние 30 дней мы фиксируем кучу паттернов
После 5.6 теперь появилась еще и
Судя по всему, в
Инсайты комьюнити
— Быть процитированным вместе с плашкой о заинтересованности автора — не то же самое, что получить рекомендацию. Цитата может стоять рядом с предупреждением, а не среди реальных рекомендаций, так что сырой трекинг количества цитирований может ошибочно записать эту позицию как победу.
— Опубликованные авторами рейтинги формата "лучший X" — самое слабое доказательство, особенно для запросов типа "кто лучшие эксперты в [сфере]", где личный интерес страницы максимален. Дисконтирующий классификатор просто делает свою работу на этом классе запросов. Чтобы проверить, выходит ли эффект за рамки таких ангажированных топиков, нужно протестировать тот же паттерн самопубликации рейтингов на теме без личной выгоды.
— Сама валидность этого предупреждения не доказана: это может быть как реальный классификатор достоверности на уровне модели, так и простое копирование текста-дисклеймера, который уже висит на странице-источнике. Стоит сначала проверить текст самого исходника, прежде чем списывать этот флаг на новую проверку со стороны
— Чтобы отличить простое извлечение от рекомендации, нужны раздельные замеры: модель всё ещё может краулить страницу даже после того, как ее цитата пропадает из видимого ответа. Так что для отделения извлечения от рекомендации придется сверять серверные логи с реально сгенерированными ответами.
— Тот же паттерн с пометкой недостоверных упоминаний замечали и в
#ChatGPT #AIOverviews #AIContentDetection
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
***
ChatGPT начал добавлять пометки про "недостоверные упоминания" (inauthentic mentions) в контенте списочного формата.Пример ниже 👇
И вот почему я потерял цитирование, хотя сам поставил себя на первое место.
Пока видел немного такого, но кое-что меняется.
За последние 30 дней мы фиксируем кучу паттернов
A/B-тестирования.После 5.6 теперь появилась еще и
Astra 6.Судя по всему, в
Statsig обновили и некоторые мини-модели с классификаторами. ☠️Инсайты комьюнити
— Быть процитированным вместе с плашкой о заинтересованности автора — не то же самое, что получить рекомендацию. Цитата может стоять рядом с предупреждением, а не среди реальных рекомендаций, так что сырой трекинг количества цитирований может ошибочно записать эту позицию как победу.
— Опубликованные авторами рейтинги формата "лучший X" — самое слабое доказательство, особенно для запросов типа "кто лучшие эксперты в [сфере]", где личный интерес страницы максимален. Дисконтирующий классификатор просто делает свою работу на этом классе запросов. Чтобы проверить, выходит ли эффект за рамки таких ангажированных топиков, нужно протестировать тот же паттерн самопубликации рейтингов на теме без личной выгоды.
— Сама валидность этого предупреждения не доказана: это может быть как реальный классификатор достоверности на уровне модели, так и простое копирование текста-дисклеймера, который уже висит на странице-источнике. Стоит сначала проверить текст самого исходника, прежде чем списывать этот флаг на новую проверку со стороны
ChatGPT.— Чтобы отличить простое извлечение от рекомендации, нужны раздельные замеры: модель всё ещё может краулить страницу даже после того, как ее цитата пропадает из видимого ответа. Так что для отделения извлечения от рекомендации придется сверять серверные логи с реально сгенерированными ответами.
— Тот же паттерн с пометкой недостоверных упоминаний замечали и в
Perplexity, а не только в ChatGPT. Это доказывает, что проверка подлинности не изолирована на уровне ответов одной конкретной модели.#ChatGPT #AIOverviews #AIContentDetection
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤1
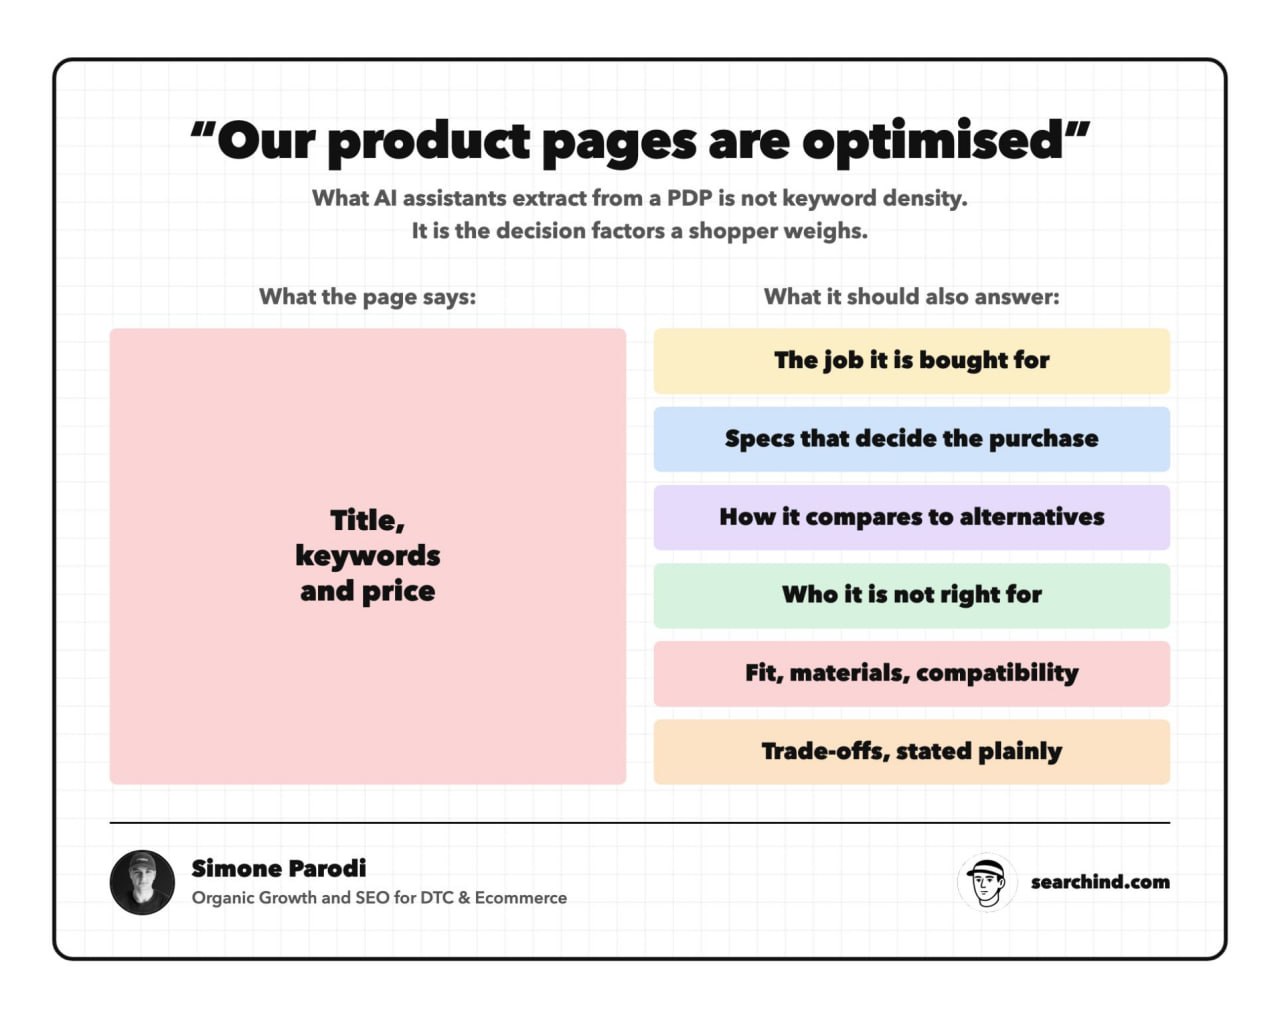
AI-ассистенты вытягивают из карточки товара ровно 6 факторов принятия решения
В большинстве аудитов "оптимизирована" означает, что тайтл содержит ключ, мета-дескрипшен заполнен, а
По факту страница отдает название товара, цену и абзац брендового текста.
Факторы, решающие исход покупки — те самые, что
Шесть вопросов, которые карточка товара закрывает помимо тайтла и цены:
1. Задача, ради которой покупают.
2. Спецификации, определяющие покупку. Наушники: автономность, быстрая зарядка, комфорт при долгом ношении, звуковой профиль. Мебель: габариты, сборка, максимальная нагрузка. Список меняется от категории к категории, и его нужно выкатить на странице в едином формате.
3. Сравнение с альтернативами в том же каталоге. Это удваивает потенциал внутренней перелинковки на страницы подборок и сравнений, на которые сейчас нет входов.
4. Кому товар не подходит. Указание нецелевого покупателя режет возвраты, качает траст и дает поисковикам с ассистентами повод связать страницу с узким запросом вместо общего.
5. Посадка, материалы и совместимость — вопросы, которые стопорят покупку, и те, на которые саппорт отвечает десять раз в неделю.
6. Компромиссы прямым текстом. Покупатель верит той странице, которая открыто признает недостатки.
Четыре источника вскрывают реальные факторы принятия решения без гадания:
— Запросы из
— Запросы во внутреннем поиске.
— Тексты отзывов и тикеты в саппорт, где повторяется один и тот же вопрос.
—
Затем структурируй это вместо того, чтобы заливать очередную простыню текста: спецификации — в табличку с едиными названиями атрибутов, короткий блок сравнения, блок
В итоге две вещи.
Страница становится более релевантной в классическом поиске, потому что закрывает реальные вопросы, и попадает в ответы, когда человек формулирует вопрос, а не просто вбивает ключ.
Инсайты комьюнити
— Указание, кому товар не подходит, сужает пул соответствий страницы. Это переворачивает стандартную оптимизацию, нацеленную на охват максимального числа запросов. Точная релевантность меньшему числу запросов — вот что заставляет систему назвать товар в ответе, а не просто рассматривать его как кандидата.
— Блок с дисквалификацией остается самым редким из шести, потому что фаундеры видят в отсеве покупателей потерю продаж — это организационный блокер, а не технический.
#ProductPages #AIOverviews #OnPage
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
В большинстве аудитов "оптимизирована" означает, что тайтл содержит ключ, мета-дескрипшен заполнен, а
H1 совпадает.По факту страница отдает название товара, цену и абзац брендового текста.
Факторы, решающие исход покупки — те самые, что
AI-ассистент вытягивает из PDP при выборе товаров для ответа — отсутствуют.Шесть вопросов, которые карточка товара закрывает помимо тайтла и цены:
1. Задача, ради которой покупают.
Wireless headphones — это категория; noise cancelling for long flights — это покупка.2. Спецификации, определяющие покупку. Наушники: автономность, быстрая зарядка, комфорт при долгом ношении, звуковой профиль. Мебель: габариты, сборка, максимальная нагрузка. Список меняется от категории к категории, и его нужно выкатить на странице в едином формате.
3. Сравнение с альтернативами в том же каталоге. Это удваивает потенциал внутренней перелинковки на страницы подборок и сравнений, на которые сейчас нет входов.
4. Кому товар не подходит. Указание нецелевого покупателя режет возвраты, качает траст и дает поисковикам с ассистентами повод связать страницу с узким запросом вместо общего.
5. Посадка, материалы и совместимость — вопросы, которые стопорят покупку, и те, на которые саппорт отвечает десять раз в неделю.
6. Компромиссы прямым текстом. Покупатель верит той странице, которая открыто признает недостатки.
Четыре источника вскрывают реальные факторы принятия решения без гадания:
— Запросы из
GSC, ведущие на PDP, с фокусом на длинные хвосты.— Запросы во внутреннем поиске.
— Тексты отзывов и тикеты в саппорт, где повторяется один и тот же вопрос.
—
ChatGPT или Claude с промптом от лица покупателя (what matters most when choosing X), после чего ответы сравниваются с текущим наполнением страницы.Затем структурируй это вместо того, чтобы заливать очередную простыню текста: спецификации — в табличку с едиными названиями атрибутов, короткий блок сравнения, блок
FAQ под регулярные возражения, и те же атрибуты, зашитые в микроразметку.В итоге две вещи.
Страница становится более релевантной в классическом поиске, потому что закрывает реальные вопросы, и попадает в ответы, когда человек формулирует вопрос, а не просто вбивает ключ.
Инсайты комьюнити
— Указание, кому товар не подходит, сужает пул соответствий страницы. Это переворачивает стандартную оптимизацию, нацеленную на охват максимального числа запросов. Точная релевантность меньшему числу запросов — вот что заставляет систему назвать товар в ответе, а не просто рассматривать его как кандидата.
— Блок с дисквалификацией остается самым редким из шести, потому что фаундеры видят в отсеве покупателей потерю продаж — это организационный блокер, а не технический.
#ProductPages #AIOverviews #OnPage
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤1
Две страницы ранжируются по одному запросу? Не склеивай их только потому, что SEO-инструмент называет это каннибализацией.
Такое пересечение может быть проблемой.
Но это также могут быть две полезные страницы, закрывающие разный интент и дающие больше поисковой видимости.
Проверяй, прежде чем что-то консолидировать.
Иди в
Теперь посмотри, что реально делают
Если обе страницы стабильно конкурируют по одним и тем же запросам, а приоритетному
Но если каждая страница собирает трафик по своему набору запросов, и они случайно пересекаются по одному-двум поискам, их слияние может убить полезный охват.
Я бы также был осторожен со скачками позиций, отмечает Артур Феррейра.
Если Google постоянно чередует два
Но одни лишь скачки не доказывают, что страницы "едят друг друга".
Позиции меняются по множеству причин.
Что действительно важно — это паттерн по всему пулу запросов.
Одна страница явно побеждает там, где должна?
Вероятно, никакой проблемы нет.
Две страницы постоянно пересекаются там, где служат по сути одной цели, и ни одна не может закрепиться?
Вот тут я бы внимательно присмотрелся к консолидации, внутренней перелинковке,
Дорогая ошибка — сначала клеить, а потом измерять.
Когда ты находишь два
#Cannibalization #AIOverviews #LLM
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Такое пересечение может быть проблемой.
Но это также могут быть две полезные страницы, закрывающие разный интент и дающие больше поисковой видимости.
Проверяй, прежде чем что-то консолидировать.
Иди в
GSC:Performance → фильтр по запросу → Pages.Теперь посмотри, что реально делают
URL.Если обе страницы стабильно конкурируют по одним и тем же запросам, а приоритетному
URL не удается закрепиться, возможно, у тебя реальная проблема с каннибализацией.Но если каждая страница собирает трафик по своему набору запросов, и они случайно пересекаются по одному-двум поискам, их слияние может убить полезный охват.
Я бы также был осторожен со скачками позиций, отмечает Артур Феррейра.
Если Google постоянно чередует два
URL по одному запросу, это полезный сигнал для изучения.Но одни лишь скачки не доказывают, что страницы "едят друг друга".
Позиции меняются по множеству причин.
Что действительно важно — это паттерн по всему пулу запросов.
Одна страница явно побеждает там, где должна?
Вероятно, никакой проблемы нет.
Две страницы постоянно пересекаются там, где служат по сути одной цели, и ни одна не может закрепиться?
Вот тут я бы внимательно присмотрелся к консолидации, внутренней перелинковке,
canonical и тому, нужны ли вообще обе страницы.Дорогая ошибка — сначала клеить, а потом измерять.
Когда ты находишь два
URL, ранжирующихся по одному ключу, каков твой первый шаг: консолидируешь их или проверяешь, реально ли они конкурируют?#Cannibalization #AIOverviews #LLM
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤4👍1
Мы только что опубликовали огромный бесплатный гайд от
Мы написали его, потому что большая часть того, что продается как
Поэтому мы привлекли почти 50 источников (AirOps, Semrush, Ahrefs, Similarweb, SparkToro, Ipsos, официальные заявления Гугла, Лили Рэй, Кевин Индиг, Рэнд Фишкин, наша внутренняя аналитика и многие другие!) и позволили фактам говорить за себя.
Несколько выводов, которые должны изменить твой подход к бюджетам:
— 85% упоминаний брендов в ответах ИИ приходят со сторонних сайтов, а не с собственного домена бренда. Паблишеры — крупнейший источник этих упоминаний.
— 99% покупателей, ищущих информацию через
— Две самые агрессивно продаваемые тактики не дают измеримого выхлопа. Внедрение микроразметки на 1885 страницах привело к падению цитируемости в
— Масштабирование ИИ-контента дает обратный эффект. Из 220+ сайтов, которые это сделали, 54% потеряли 30% или больше от своего пикового трафика.
И наша собственная неудобная цифра: ИИ-ассистенты дают 0,59% сессий
Полпроцента — это не канал.
Любой, кто продает тебе стратегию ИИ-трафика, продает статистическую погрешность.
Деньги лежат в цитировании, а не в кликах.
Большую часть того, что ИИ говорит о твоем бренде, написал не ты.
Это написали о тебе те паблишеры и обзорщики, которым модель научилась доверять.
Хорошее SEO было хорошим
Гайд завершается 23 прикладными советами, каждый из которых подкреплен исследованием, а также методикой проверки того, могут ли твои страницы извлекаться ИИ-системами, и инструкцией по сбору
Ссылка на полный гайд: https://mumbrella.com.au/man-of-many-releases-guide-to-generative-engine-optimisation-for-brands-938081
#GEO #AIOverviews #AI
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Man of Many на 65+ страниц по GEO — плейбук для маркетологов и агентств, чьи клиенты теперь спрашивают ИИ перед покупкой, пишет Скотт Пёрселл.Mumbrella любезно осветили эту новость.Мы написали его, потому что большая часть того, что продается как
Generative Engine Optimisation, не выдерживает проверки данными.Поэтому мы привлекли почти 50 источников (AirOps, Semrush, Ahrefs, Similarweb, SparkToro, Ipsos, официальные заявления Гугла, Лили Рэй, Кевин Индиг, Рэнд Фишкин, наша внутренняя аналитика и многие другие!) и позволили фактам говорить за себя.
Несколько выводов, которые должны изменить твой подход к бюджетам:
— 85% упоминаний брендов в ответах ИИ приходят со сторонних сайтов, а не с собственного домена бренда. Паблишеры — крупнейший источник этих упоминаний.
— 99% покупателей, ищущих информацию через
ChatGPT, по-прежнему гуглят перед принятием решения (собственный опрос Гугла через Ipsos, 12 038 пользователей, 25 стран).— Две самые агрессивно продаваемые тактики не дают измеримого выхлопа. Внедрение микроразметки на 1885 страницах привело к падению цитируемости в
AI Overviews на 4,6%. Файл llms.txt не показал никакой связи с цитированием на выборке из примерно 300 000 доменов.— Масштабирование ИИ-контента дает обратный эффект. Из 220+ сайтов, которые это сделали, 54% потеряли 30% или больше от своего пикового трафика.
И наша собственная неудобная цифра: ИИ-ассистенты дают 0,59% сессий
Man of Many.Полпроцента — это не канал.
Любой, кто продает тебе стратегию ИИ-трафика, продает статистическую погрешность.
Деньги лежат в цитировании, а не в кликах.
Большую часть того, что ИИ говорит о твоем бренде, написал не ты.
Это написали о тебе те паблишеры и обзорщики, которым модель научилась доверять.
Хорошее SEO было хорошим
GEO еще до появления ChatGPT.Гайд завершается 23 прикладными советами, каждый из которых подкреплен исследованием, а также методикой проверки того, могут ли твои страницы извлекаться ИИ-системами, и инструкцией по сбору
in-house панели для отслеживания промптов.Ссылка на полный гайд: https://mumbrella.com.au/man-of-many-releases-guide-to-generative-engine-optimisation-for-brands-938081
#GEO #AIOverviews #AI
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤4
Google заявляет, что
Нам прислали исследование, которое ясно показывает обратное, документирует Джейсон Кинт.
—
— и они не улучшили качество визитов
— они просто сократили клики на источники
Влияние на клики очевидно.
Убери
Так что да,
С
С
Без
Тот скандал с
А эти "цитаты" внутри
Они не решают проблему.
Я слышал анекдотичные данные о том, что, возможно, подписки конвертятся лучше, но никаких данных в подтверждение этого не представлено.
Атрибуция без значимого трафика или ценности — это не бизнес-модель.
суть: ИИ-поиск — это не просто твик продукта.
Он переписывает дискавери.
Контент стал инпутом.
Трафик исчезает.
Ценность утекает к Google, если только паблишеры не установят свои условия.
Незаконная монополия Google этого не допустит.
https://digitalcontentnext.org/blog/2026/09/15/research-casts-doubt-on-ai-search-value-for-sites-and-searchers/
***
Да, рандомизированный эксперимент Агарвала-Сена подтверждает:
Цитаты возвращают лишь малую часть потерянного трафика.
Эти независимые причинно-следственные данные опровергают заявления Google об улучшении удовлетворенности пользователей и более качественных кликах, независимо от любых агрегированных трендов частотки.
Инсайты комьюнити
— Один паблишер сообщил, что отключил
— Защита по брендовым запросам в платном поиске становится важнее, поскольку
— Отдельное августовское исследование показало: деградировавший опыт
#AIOverviews #ZeroClick #CTR
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
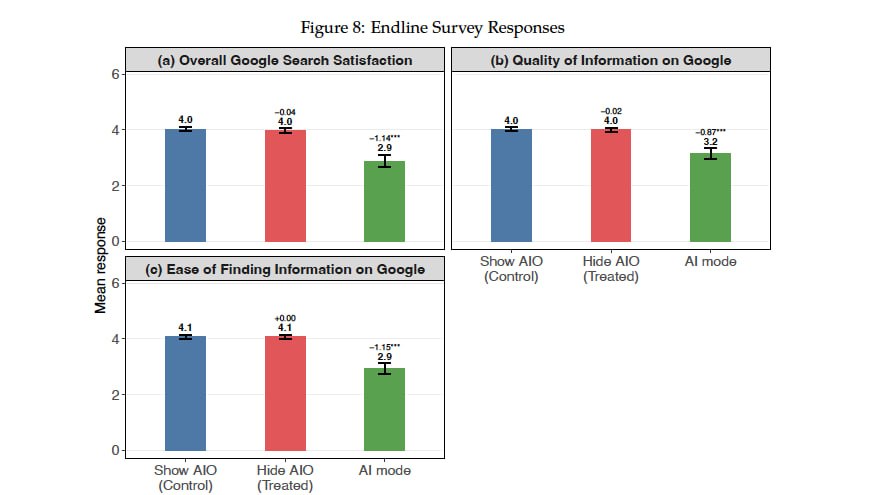
AI Overviews в поиске создают лучший пользовательский опыт и "более качественные" клики.Нам прислали исследование, которое ясно показывает обратное, документирует Джейсон Кинт.
—
AI Overviews не улучшили удовлетворенность— и они не улучшили качество визитов
— они просто сократили клики на источники
Влияние на клики очевидно.
Убери
AI Overviews, и исходящие органические клики из поиска подскочат на 68% с 0.37 до 0.62 на поиск.Так что да,
AI Overviews заменяют собой трафик на те источники, которые они парсят.С
AI Overviews нулевые поиски становятся гораздо хуже.С
AIOs: 73% поисков завершаются без клика на внешний сайт.Без
AIOs: 54%... уходят в Google Zero, @reckless.Тот скандал с
OpenAI и Microsoft в свете софитов — у Google та же проблема.А эти "цитаты" внутри
AI Overviews?Они не решают проблему.
Я слышал анекдотичные данные о том, что, возможно, подписки конвертятся лучше, но никаких данных в подтверждение этого не представлено.
Атрибуция без значимого трафика или ценности — это не бизнес-модель.
суть: ИИ-поиск — это не просто твик продукта.
Он переписывает дискавери.
Контент стал инпутом.
Трафик исчезает.
Ценность утекает к Google, если только паблишеры не установят свои условия.
Незаконная монополия Google этого не допустит.
https://digitalcontentnext.org/blog/2026/09/15/research-casts-doubt-on-ai-search-value-for-sites-and-searchers/
***
Да, рандомизированный эксперимент Агарвала-Сена подтверждает:
AI Overviews срезают исходящие клики на ~40% без какого-либо измеримого роста показателей удовлетворенности или метрик качества визита, таких как время на сайте и отказы.Цитаты возвращают лишь малую часть потерянного трафика.
Эти независимые причинно-следственные данные опровергают заявления Google об улучшении удовлетворенности пользователей и более качественных кликах, независимо от любых агрегированных трендов частотки.
Инсайты комьюнити
— Один паблишер сообщил, что отключил
Gen AI в GSC и после этого не заметил падения трафика, позиционируя этот отказ как способ заморить ИИ-фичи голодом, лишив их инпутов.— Защита по брендовым запросам в платном поиске становится важнее, поскольку
AI Overviews сжимают органический CTR: без выделенных ставок на бренд в поиске плюс Local Service Ads, блокирующих серп, конкуренты могут ставить на твои брендовые запросы и перехватывать их.— Отдельное августовское исследование показало: деградировавший опыт
AI Mode заставляет некоторых пользователей сбегать в другие поисковики — эффект оттока, выходящий за рамки простого подавления кликов.#AIOverviews #ZeroClick #CTR
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Это исследование показало, что блокировка "
https://arxiv.org/pdf/2604.27790
#BotBlocking #AIOverviews #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Google-Extended Bot" может привести к меньшему числу цитаций в AIO, вопреки заявлениям Google.https://arxiv.org/pdf/2604.27790
#BotBlocking #AIOverviews #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
🔥1
Тесты OtterlyAI фиксируют рост ИИ-цитирования на 31.5% при обновлении даты — но контрольная группа ломает вывод
Обновление даты "
Это опровергает опубликованное в июне заявление о том, что смена даты ничего не дает, при этом сама корректировка идет с жесткими граничными условиями.
Даты изменили 4 августа, замеры шли по двум равным 30-дневным окнам до и после:
— Обработанные страницы: 4,800 → 6,312 цитирований
— Контрольные страницы: 358 → 320 цитирований
— 7 из 10 страниц ушли в плюс
— Если исключить самую крупную страницу, остальные девять всё равно выросли на 30.4%
Именно 30.4% — та цифра, которой стоит верить.
Усредненный показатель может означать, что у одной страницы просто был удачный месяц.
Общая цифра скрывает разбивку по движкам:
—
—
—
—
—
—
Изначальная механика всё еще работает на уровне
Ошибка сидит на один этап раньше.
Извлечение решает, попадет ли страница в пул кандидатов вообще.
Страница, датированная 2024 годом, конкурирует с источниками за 2026 год по саб-запросу, требующему текущего года, а саб-запрос, который не извлек страницу, не сможет ее отранжировать.
Любое вмешательство в поле даты упирается в два ограничения.
Контрольная группа состоит всего из двух страниц, что не позволяет отделить эффект теста от естественного дрейфа сайта, к тому же
Механика извлечения звучит правдоподобно; но никто ее не доказал.
Июльский эксперимент самих
Добавление 2026 года в одиннадцать тайтлов в том же блоге показало +56% и +61%, пока не выяснилось, что нетронутая страница выросла на 63%.
Громкий заголовок рассыпался при контакте с контрольной группой.
Железобетонный ответ для любого сайта требует:
— Двадцать страниц с видимой датой 2024 или 2025 против десяти контрольных
— Фиксированный набор промптов, который парсится трижды в день в течение пяти дней до и тридцати дней после
— Минимум два движка
— Заранее прописанное правило остановки теста
Публикуйте распределение между тестовой и контрольной группой, а не просто процент для заголовка.
#Experiments #AIOverviews #ContentFreshness
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Обновление даты "
last updated" на десяти статьях блога OtterlyAI без единой правки текста спровоцировало рост ИИ-цитирований на 31.5%, тогда как две контрольные страницы просели на 10.6%.Это опровергает опубликованное в июне заявление о том, что смена даты ничего не дает, при этом сама корректировка идет с жесткими граничными условиями.
Даты изменили 4 августа, замеры шли по двум равным 30-дневным окнам до и после:
— Обработанные страницы: 4,800 → 6,312 цитирований
— Контрольные страницы: 358 → 320 цитирований
— 7 из 10 страниц ушли в плюс
— Если исключить самую крупную страницу, остальные девять всё равно выросли на 30.4%
Именно 30.4% — та цифра, которой стоит верить.
Усредненный показатель может означать, что у одной страницы просто был удачный месяц.
Общая цифра скрывает разбивку по движкам:
—
Claude: +983 цитирования (+87%)—
Perplexity: +217%—
ChatGPT: +692%, с базовой отметки в 37—
Google AI Overviews: +15%—
Google AI Mode: -20%—
Gemini: -37%Изначальная механика всё еще работает на уровне
passage ranking: ИИ-системы сравнивают текст, который они читают сейчас, с тем, что они видели раньше, и новая дата на старом тексте там ничего не дает.Ошибка сидит на один этап раньше.
Извлечение решает, попадет ли страница в пул кандидатов вообще.
Страница, датированная 2024 годом, конкурирует с источниками за 2026 год по саб-запросу, требующему текущего года, а саб-запрос, который не извлек страницу, не сможет ее отранжировать.
Любое вмешательство в поле даты упирается в два ограничения.
Контрольная группа состоит всего из двух страниц, что не позволяет отделить эффект теста от естественного дрейфа сайта, к тому же
OtterlyAI заявляет, что не отслеживал веерные запросы, стоящие за этими цитатами.Механика извлечения звучит правдоподобно; но никто ее не доказал.
Июльский эксперимент самих
OtterlyAI — отличный пример для осторожности.Добавление 2026 года в одиннадцать тайтлов в том же блоге показало +56% и +61%, пока не выяснилось, что нетронутая страница выросла на 63%.
Громкий заголовок рассыпался при контакте с контрольной группой.
Железобетонный ответ для любого сайта требует:
— Двадцать страниц с видимой датой 2024 или 2025 против десяти контрольных
— Фиксированный набор промптов, который парсится трижды в день в течение пяти дней до и тридцати дней после
— Минимум два движка
— Заранее прописанное правило остановки теста
Публикуйте распределение между тестовой и контрольной группой, а не просто процент для заголовка.
#Experiments #AIOverviews #ContentFreshness
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤1
Данные DerivateX подтверждают: 88.4% цитирований софта в ChatGPT ведут на сторонние площадки, а не на сайты брендов
Одни только бэклинки почти не предсказывают видимость в
Руководство Google по генеративному ИИ от июля 2026 года объясняет этот разрыв:
Задача ссылки делится надвое:
1. Извлечение (Retrieval) — ранжирование решает, какие страницы увидит модель; здесь ссылки выполняют свою классическую работу.
2. Чтение — как только страница извлечена, у модели остается только текст. Ссылка в подвале или платный гестпост с одной строчкой анкора не дают тексту никакой фактуры для ответа. А вот ревью с разбором ЦА продукта или листикл, честно объясняющий в трех предложениях, почему бренд попал в топ, в итоге уходят в ответы ИИ.
В майском исследовании
Сливать весь ссылочный бюджет на главную или мани-страницы — ошибка; часть ресурсов нужно пустить на сторонние обзоры, сравнения и листиклы, которые уже хорошо описывают бренд, чтобы они ранжировались по запросам, которые парсит ИИ.
Майский анализ
Это сходится, только если ценность лежит в самом факте обсуждения, а не в передаче
Все исследования строятся на корреляциях, большинство исходит от вендоров, продающих то, что они измеряют, цифры между ними не бьются, и выводы расходятся:
— Упоминания против авторитета: у
— Платформы отзывов:
Тот же гайд подтверждает, что ИИ-фичи могут агрегировать отзывы о продуктах из блогов, видео и форумов, а затем закрывает очевидную лазейку: охота за неаутентичными упоминаниями прямо названа
Проплаченное место в листикле "лучших инструментов" — это версия 2026 года для бартера продукта на ссылку, с теми же рисками.
Брендовый поиск ломается первым.
В сентябре
Теперь автор мониторит брендовые запросы по рынкам и советует трекать их через отчет
https://www.gscwizard.com/learn/seo-fundamentals/link-building-brand-building-2026.html
#GEO #AIOverviews #BrandMentions
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Одни только бэклинки почти не предсказывают видимость в
LLM, фиксируют данные Seer Interactive, тогда как позиции на первой странице Google коррелируют с упоминаниями на уровне 0.65.Руководство Google по генеративному ИИ от июля 2026 года объясняет этот разрыв:
AI Overviews и AI Mode используют RAG (retrieval-augmented generation) — основные системы ранжирования вытаскивают страницы из индекса, часто через веер связанных запросов, прежде чем модель прочитает их для генерации ответа.Задача ссылки делится надвое:
1. Извлечение (Retrieval) — ранжирование решает, какие страницы увидит модель; здесь ссылки выполняют свою классическую работу.
2. Чтение — как только страница извлечена, у модели остается только текст. Ссылка в подвале или платный гестпост с одной строчкой анкора не дают тексту никакой фактуры для ответа. А вот ревью с разбором ЦА продукта или листикл, честно объясняющий в трех предложениях, почему бренд попал в топ, в итоге уходят в ответы ИИ.
В майском исследовании
DerivateX за 2026 год на базе 233 рекомендаций софта в ChatGPT, 88.4% цитирований вели на сторонние площадки и только 11.6% — на сайты самих инструментов.Сливать весь ссылочный бюджет на главную или мани-страницы — ошибка; часть ресурсов нужно пустить на сторонние обзоры, сравнения и листиклы, которые уже хорошо описывают бренд, чтобы они ранжировались по запросам, которые парсит ИИ.
Майский анализ
Ahrefs за 2025 год (75 000 брендов в AI Overviews) оценил корреляцию брендовых веб-упоминаний с видимостью в ИИ на 0.664, брендовых анкоров на 0.527, брендовой частотки на 0.392, а обычных бэклинков на 0.218.Semrush (октябрь 2025, 1000 доменов) зафиксировал, что nofollow-ссылки коррелируют так же сильно, как и dofollow (0.340 против 0.334).Это сходится, только если ценность лежит в самом факте обсуждения, а не в передаче
PageRank: неупомянутые ссылки и nofollow засчитываются как плюс.Все исследования строятся на корреляциях, большинство исходит от вендоров, продающих то, что они измеряют, цифры между ними не бьются, и выводы расходятся:
— Упоминания против авторитета: у
Ahrefs упоминания бьют бэклинки 3 к 1, тогда как Seer назвал Domain Rank сильнейшим сигналом (0.25), а Semrush увидел привязку Authority Score к упоминаниям в ИИ на 0.65. Логика автора: крупные бренды одновременно собирают позиции, траст и упоминания, поэтому ни одно исследование не отделит их друг от друга.— Платформы отзывов:
SE Ranking (129 000 доменов) связывает профили на Trustpilot, G2 или Capterra с 4.6–6.3 цитатами в ChatGPT против 1.8 без них; DerivateX не зафиксировал ни одной цитаты G2 или Capterra на 233 ответа. Обе метрики верны, если сильный профиль просто помогает бренду попасть в те самые листиклы, которые ИИ в итоге цитирует. Профиль все равно нужно допиливать — нельзя держать одно и то же описание на главной, G2, Capterra и других площадках, так как авторы и модели дублируют этот текст, — но цитируют в итоге не эти страницы.Тот же гайд подтверждает, что ИИ-фичи могут агрегировать отзывы о продуктах из блогов, видео и форумов, а затем закрывает очевидную лазейку: охота за неаутентичными упоминаниями прямо названа
GEO-тактикой, которую нужно игнорировать, так как ИИ опирается на спам-фильтры самого поиска.Проплаченное место в листикле "лучших инструментов" — это версия 2026 года для бартера продукта на ссылку, с теми же рисками.
Брендовый поиск ломается первым.
В сентябре
gscwizard.com ненадолго потерял брендовый запрос в одном из европейских серпов, при этом AI Overview по-прежнему описывал продукт корректно.Теперь автор мониторит брендовые запросы по рынкам и советует трекать их через отчет
Generative AI в Google Search Console.https://www.gscwizard.com/learn/seo-fundamentals/link-building-brand-building-2026.html
#GEO #AIOverviews #BrandMentions
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
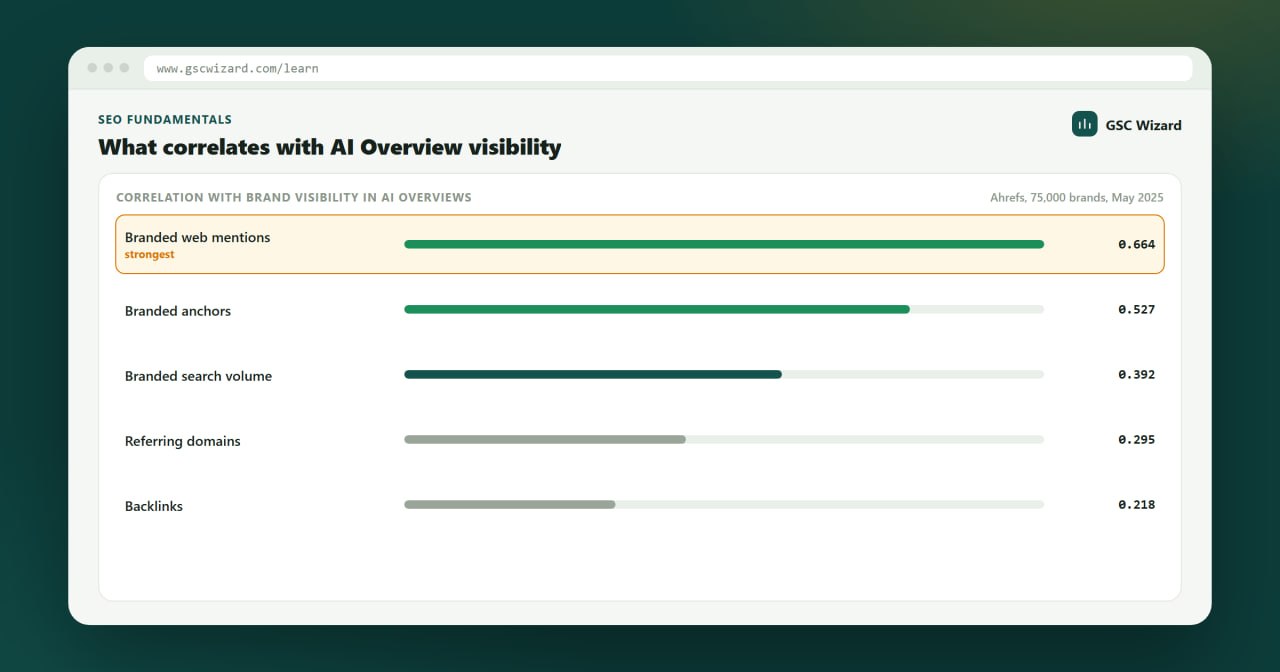
Генеративные и отравленные SERP ломают съём позиций — фейки вымывают органику, оставляя лишь 20.7% реальных сайтов
Генеративный
Под капотом работает всё тот же слой извлечения (retrieval layer), который питает
Страница, которую модель собирает под конкретный запрос и перестраивает под юзера, не имеет канонической версии для ранжирования.
Классическому съему позиций больше нельзя доверять оценку перформанса.
Исследование
Поиск обязателен для сущностей и фактов; уточняющие запросы триггерятся, когда результаты открывают новые вопросы, а каждое утверждение должно подтверждаться извлеченными данными.
Асессоры предпочитали сгенерированную страницу классическому топ-1 в 90% случаев на промптах
Ошибки вывода на промптах
Оговорка по охвату: исследование ни разу не использует слово
Исследование
Это полноценные, нормально выглядящие страницы, где большинство привычных сайтов по ключу подменены — без ошибок и капчи.
— Доля отравленных выдач: 0.17% → 8.0% с 13 сентября, достигнув пика примерно на четверти всех
— Сохранение органических сайтов (нормальная выдача vs отравленная): 88.5% → 20.7%; источники
— Выпадение собственного привычного сайта из десятки: 2.7% → 58.6%.
— В одни и те же дни, два маршрута сбора данных: от 1% до 7% отравленных выдач против 9–30%.
— Юридическая выдача достигла пика в 51.3%; брендовые запросы показали минимум в 5.3%.
— 80% отравлений длились ровно один
— В примере
Привязка к генеративному рендеру — это личный вывод автора (этого нет ни у Nozzle, ни в исследовании): когда страница собирается под запрос, отдать подозрительному парсеру правдоподобную, но фейковую сборку становится дешево и почти незаметно.
Рекомендуемый план действий рассматривает каждый съем позиций как одну выборку из распределения:
— Делай несколько срезов в день, сравнивай каждый с последним верифицированным парсингом и отбрасывай как отравленные те, где заменилась большая часть сайтов с первой страницы.
— Фиксируй видимость как процент извлечения (retrieval rate) и частоту цитирования с доверительными интервалами по дням и локациям; среднюю позицию читай только как тренд.
— Прогоняй каждый запрос несколько раз на генеративных поверхностях и репорти долю запусков, которые извлекают или цитируют бренд.
— Сегментируй по гео и персонам, воспринимая разброс между сегментами как инсайт, а не шум.
— Привязывай каждый трекер к
https://ipullrank.com/generative-serps
#RankTracking #SERPAnalysis #AIOverviews
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Генеративный
SERP меняет подачу результатов, а не их отбор.Под капотом работает всё тот же слой извлечения (retrieval layer), который питает
AI Overviews и AI Mode — поэтому ломается именно метрика.Страница, которую модель собирает под конкретный запрос и перестраивает под юзера, не имеет канонической версии для ранжирования.
Классическому съему позиций больше нельзя доверять оценку перформанса.
Исследование
Google Research о Generative UI описывает модель, которая пишет всю страницу на HTML, CSS и JavaScript с нуля под каждый запрос, вызывая поиск Google как инструмент.Поиск обязателен для сущностей и фактов; уточняющие запросы триггерятся, когда результаты открывают новые вопросы, а каждое утверждение должно подтверждаться извлеченными данными.
Асессоры предпочитали сгенерированную страницу классическому топ-1 в 90% случаев на промптах
LMArena и в 73.5% — на информационных запросах (это промпты и асессоры самих авторов, а не боевой трафик).Ошибки вывода на промптах
LMArena упали с 60% у Gemini 2.0 Flash-Lite до 0% у Gemini 3.Оговорка по охвату: исследование ни разу не использует слово
SERP и не упоминает AI Mode; привязка к выдаче базируется на анонсе Google о запуске Generative UI в AI Mode и выводах самого автора.Исследование
Nozzle по отравленным SERP на базе 27.5 млн результатов (с 20 августа по 9 октября 2026 года) доказывает, что проблема с метриками уже в проде.Это полноценные, нормально выглядящие страницы, где большинство привычных сайтов по ключу подменены — без ошибок и капчи.
— Доля отравленных выдач: 0.17% → 8.0% с 13 сентября, достигнув пика примерно на четверти всех
SERP 27–29 сентября.— Сохранение органических сайтов (нормальная выдача vs отравленная): 88.5% → 20.7%; источники
AI Overview просели: 68.8% → 42.3%; реклама выросла: 70.6% → 83.7%.— Выпадение собственного привычного сайта из десятки: 2.7% → 58.6%.
— В одни и те же дни, два маршрута сбора данных: от 1% до 7% отравленных выдач против 9–30%.
— Юридическая выдача достигла пика в 51.3%; брендовые запросы показали минимум в 5.3%.
— 80% отравлений длились ровно один
SERP; привычные сайты возвращались в течение трех дней в 77.9% случаев.— В примере
Nozzle по запросу "white label local seo" вес HTML почти не изменился (720 КБ → 728 КБ) — вот почему визуально всё казалось в норме.Nozzle связывает отравление с реакцией Google на массовый парсинг ответов AI.Привязка к генеративному рендеру — это личный вывод автора (этого нет ни у Nozzle, ни в исследовании): когда страница собирается под запрос, отдать подозрительному парсеру правдоподобную, но фейковую сборку становится дешево и почти незаметно.
Рекомендуемый план действий рассматривает каждый съем позиций как одну выборку из распределения:
— Делай несколько срезов в день, сравнивай каждый с последним верифицированным парсингом и отбрасывай как отравленные те, где заменилась большая часть сайтов с первой страницы.
— Фиксируй видимость как процент извлечения (retrieval rate) и частоту цитирования с доверительными интервалами по дням и локациям; среднюю позицию читай только как тренд.
— Прогоняй каждый запрос несколько раз на генеративных поверхностях и репорти долю запусков, которые извлекают или цитируют бренд.
— Сегментируй по гео и персонам, воспринимая разброс между сегментами как инсайт, а не шум.
— Привязывай каждый трекер к
Search Console и реферальному трафику: если показы и клики держатся, пока трекер рисует обвал — сомневайся в трекере, поскольку реальное изменение позиций имеет свойство сохраняться.https://ipullrank.com/generative-serps
#RankTracking #SERPAnalysis #AIOverviews
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO