
http://analysisacademy.com/wp-content/uploads/2017/01/ordinal.jpg
@analysisacademy
www.analysisacademy.com
رگرسیون ترتیبی
در دورههای آکادمی تحلیل آماری ایران با انواع رگرسیون و مدلهای آن آشنا شدیم و در روز چهارم کلاس spss با کلیهی پیشفرضهای لازم جهت استفاده از رگرسیونهای ساده خطی و چندگانه آشنا شدیم. از طرفی بیان کردیم که چگونه از شاخصهایی مثل تورش واریانس و تلورانس و …… در بررسی این شروط استفاده کنید.
اما میدانیم که در برخی از پژوهشها و بهخصوص پژوهشهای پیمایشی، ممکن است که متغیر وابسته در سطح سنجش ترتیبی باشد. یعنی شرط اول اجرای رگرسیونهای چندگانه که همانا کمی بودن(فاصلهای یا نسبی بودن) است را نداشته باشد. یعنی ما میتوانیم که به طبقات این متغیر رتبه دهیم اما هرگز نمیتوانیم فاصلهی بین رتبهها را مشخص نماییم.
@analysisacademy
مثلاً متغیر رضایت بجای اینکه توسط یکسری شاخص و سؤال در پرسشنامه سنجیده شده باشد که در انتها بتوان این سؤالات را با فرایندcompute به سمت یک متغیر کمی پیوسته حرکت داد، خود شامل یک طیف سه گزینهای رضایت بالا، متوسط یا پایین جهت سنجش است.
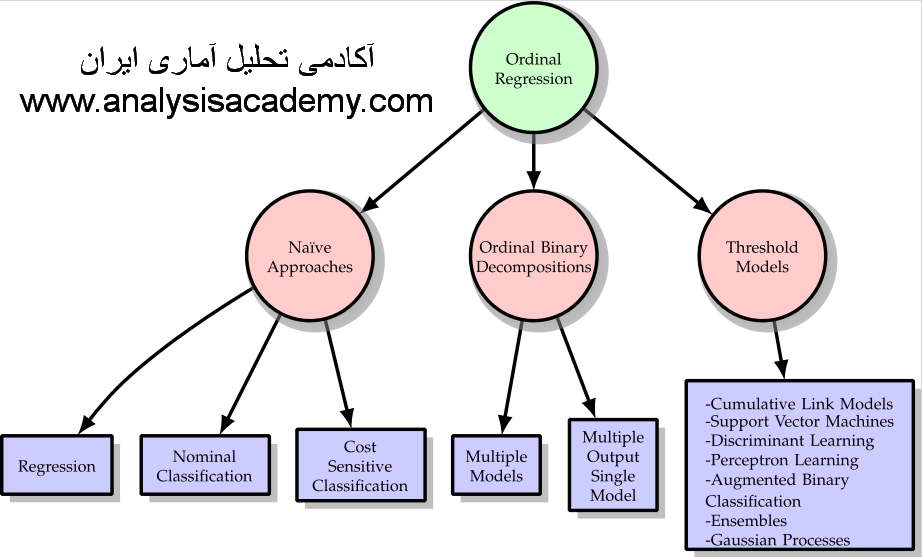
در اینجا روش بدیل رگرسیون ترتیبی است که ممکن است محققان عزیز در زبان دستوری یا همان پنجره syntax آن را با عبارت PLUM مشاهده کرده باشند. در حقیقت رگرسیون ترتیبی روش بسط یافته مدل خطی عمومی هست که در مورد دادههای ترتیبی مورداستفاده قرار میگیرد.
براین در کتاب خود به نقلقول از مک کولاگ ۱۹۹۸ بیان میکند که در حقیقت این شرایط نوعی رگرسیون لجستیک است یعنی متغیر وابسته بجای اینکه در سطح سنجش اسمی باشد در سطح سنجش یا مقیاس رتبهای قرار دارد. بنابراین این نوع رگرسیون لجستیک ترتیبی که بهاختصار OLR نیز خوانده میشود در تحقیقات پیمایشی اهمیت بسیاری دارد. چراکه ما میتوانیم مدلی را تدوین نماییم که در آن یکسری متغیر مستقل رفتار یک متغیر وابسته ترتیبی را پیشبینی نمایند.
روش تخمین ضرایب رگرسیونی در این روش حداقل مربعات وزنی است یعنی محاسبات بهگونهای است که مجموع مجذورات بین یک متغیر وابسته ترتیبی وزن دادهشده از متغیرهای مستقل به حداقل میزان خود کاهش یابد(مرادی، ۱۳۹۵)
@analysisacademy
برای انجام این تحلیل در نرمافزارهای آماری باید توابع پیوند را بشناسیم. در کلاسهای آکادمی تحلیل آماری ایران بارها و بارها از برازش مدلهای رگرسیونی صحبت شده و بیانشده این مدلهای به دو دلیل به قول هایر راهی سطل زباله میشوند. دلی اول ضریب تعیین ضعیف و دلیلی دوم شاخص برازش است. پس اکنون برای محققان عزیز بیان میکنیم که این توابع برای ایجاد برازش مناسب برای مدل است. یعنی انتخاب تابع پیوند مناسب برای ایجاد برازش مناسب مدل رگرسیون ترتیبی است(مرادی، ۱۳۹۵)
اگر توزیع دادههای طبقات نرمال باشد و شکل توزیع نرمال باشد از تابع پیوند probit استفاده میشود. در صورت یک توزیع تصادفی تابع logit. اگر متغیر وابسته ما دو مقدار ابتدایی و انتهایی آن زیاد باشد یعنی دو حد آن دارای فراوانی بالایی باشد تابع پیوند cauchit است. حال هر چه طبقات بالاتر باشد احتمال بیشتر است و تابع پیوند complementary log-log است و درنهایت هر چه طبقات پایینتر باشد احتمال بیشتر است و تابع آنnegative log-log است.
خوب اکنون تصور کنید عنوان تحقیق شما این است:
عوامل مؤثر بر تبلیغات شفاهی کلاسهای آکادمی تحلیل آماری ایران
اما در این تحقیق پرسشنامهای وجود دارد که بعد از سنجش متغیرهای پنهان مستقل از طریق سؤالات متناظرشان، متغیر وابسته تحقیق یعنی تبلیغات شفاهی را اینگونه سنجیده است.
سؤال: من بعد از شرکت در دورههای آکادمی تحلیل آماری ایران برای آن تبلیغات شفاهی انجام میدهم الف)کم ب)متوسط ج)زیاد
این نکته را در نظر داشته باشید که برای متغیر تبلیغات شفاهی پرسشنامههای چند شاخصی متنوعی وجود دارد اما محقق موردنظر با فرض اینکه پاسخدهندگان کاملاً این متغیر را میشناسند و نیازی به سنجش آن از زوایای مختلف نیست آن را اینگونه اندازهگیری کرده است.
خوب بعد از جمعآوری دادهها و ورود آن به spss باید پیشپردازشهای گفتهشده در کلاس را روی سؤالات و متغیرها انجام داد و سپس برای انجام تحلیل رگرسیون ترتیبی به آدرس زیر مراجعه نمود.
Analyze > Regression > ordinal
خوب اکنون یک پنجرهای دیالوگ باز میشود. متغیر وابسته رتبهای را وارد بخش متغیر وابسته میکنیم. دو پنجرهی دیگر وجود دارد که میتوان متغیرهای مستقل خود را وارد آنها کرد. باید دقت نمود که factor یا عاملها باید حتماً کیفی(اسمی یا ترتیبی) باشند و covariate یا کوریت ها حتماً باید کمی(scale) باشند.(مرادی، ۱۳۹۵)
در مقالات آینده نحوه تفسیر جداول خروجی و چگونگی بیان آن در تحقیقات بحث خواهد شد.
محسن مرادی
@analysisacademy
www.analysisacademy.com
رگرسیون ترتیبی
در دورههای آکادمی تحلیل آماری ایران با انواع رگرسیون و مدلهای آن آشنا شدیم و در روز چهارم کلاس spss با کلیهی پیشفرضهای لازم جهت استفاده از رگرسیونهای ساده خطی و چندگانه آشنا شدیم. از طرفی بیان کردیم که چگونه از شاخصهایی مثل تورش واریانس و تلورانس و …… در بررسی این شروط استفاده کنید.
اما میدانیم که در برخی از پژوهشها و بهخصوص پژوهشهای پیمایشی، ممکن است که متغیر وابسته در سطح سنجش ترتیبی باشد. یعنی شرط اول اجرای رگرسیونهای چندگانه که همانا کمی بودن(فاصلهای یا نسبی بودن) است را نداشته باشد. یعنی ما میتوانیم که به طبقات این متغیر رتبه دهیم اما هرگز نمیتوانیم فاصلهی بین رتبهها را مشخص نماییم.
@analysisacademy
مثلاً متغیر رضایت بجای اینکه توسط یکسری شاخص و سؤال در پرسشنامه سنجیده شده باشد که در انتها بتوان این سؤالات را با فرایندcompute به سمت یک متغیر کمی پیوسته حرکت داد، خود شامل یک طیف سه گزینهای رضایت بالا، متوسط یا پایین جهت سنجش است.
در اینجا روش بدیل رگرسیون ترتیبی است که ممکن است محققان عزیز در زبان دستوری یا همان پنجره syntax آن را با عبارت PLUM مشاهده کرده باشند. در حقیقت رگرسیون ترتیبی روش بسط یافته مدل خطی عمومی هست که در مورد دادههای ترتیبی مورداستفاده قرار میگیرد.
براین در کتاب خود به نقلقول از مک کولاگ ۱۹۹۸ بیان میکند که در حقیقت این شرایط نوعی رگرسیون لجستیک است یعنی متغیر وابسته بجای اینکه در سطح سنجش اسمی باشد در سطح سنجش یا مقیاس رتبهای قرار دارد. بنابراین این نوع رگرسیون لجستیک ترتیبی که بهاختصار OLR نیز خوانده میشود در تحقیقات پیمایشی اهمیت بسیاری دارد. چراکه ما میتوانیم مدلی را تدوین نماییم که در آن یکسری متغیر مستقل رفتار یک متغیر وابسته ترتیبی را پیشبینی نمایند.
روش تخمین ضرایب رگرسیونی در این روش حداقل مربعات وزنی است یعنی محاسبات بهگونهای است که مجموع مجذورات بین یک متغیر وابسته ترتیبی وزن دادهشده از متغیرهای مستقل به حداقل میزان خود کاهش یابد(مرادی، ۱۳۹۵)
@analysisacademy
برای انجام این تحلیل در نرمافزارهای آماری باید توابع پیوند را بشناسیم. در کلاسهای آکادمی تحلیل آماری ایران بارها و بارها از برازش مدلهای رگرسیونی صحبت شده و بیانشده این مدلهای به دو دلیل به قول هایر راهی سطل زباله میشوند. دلی اول ضریب تعیین ضعیف و دلیلی دوم شاخص برازش است. پس اکنون برای محققان عزیز بیان میکنیم که این توابع برای ایجاد برازش مناسب برای مدل است. یعنی انتخاب تابع پیوند مناسب برای ایجاد برازش مناسب مدل رگرسیون ترتیبی است(مرادی، ۱۳۹۵)
اگر توزیع دادههای طبقات نرمال باشد و شکل توزیع نرمال باشد از تابع پیوند probit استفاده میشود. در صورت یک توزیع تصادفی تابع logit. اگر متغیر وابسته ما دو مقدار ابتدایی و انتهایی آن زیاد باشد یعنی دو حد آن دارای فراوانی بالایی باشد تابع پیوند cauchit است. حال هر چه طبقات بالاتر باشد احتمال بیشتر است و تابع پیوند complementary log-log است و درنهایت هر چه طبقات پایینتر باشد احتمال بیشتر است و تابع آنnegative log-log است.
خوب اکنون تصور کنید عنوان تحقیق شما این است:
عوامل مؤثر بر تبلیغات شفاهی کلاسهای آکادمی تحلیل آماری ایران
اما در این تحقیق پرسشنامهای وجود دارد که بعد از سنجش متغیرهای پنهان مستقل از طریق سؤالات متناظرشان، متغیر وابسته تحقیق یعنی تبلیغات شفاهی را اینگونه سنجیده است.
سؤال: من بعد از شرکت در دورههای آکادمی تحلیل آماری ایران برای آن تبلیغات شفاهی انجام میدهم الف)کم ب)متوسط ج)زیاد
این نکته را در نظر داشته باشید که برای متغیر تبلیغات شفاهی پرسشنامههای چند شاخصی متنوعی وجود دارد اما محقق موردنظر با فرض اینکه پاسخدهندگان کاملاً این متغیر را میشناسند و نیازی به سنجش آن از زوایای مختلف نیست آن را اینگونه اندازهگیری کرده است.
خوب بعد از جمعآوری دادهها و ورود آن به spss باید پیشپردازشهای گفتهشده در کلاس را روی سؤالات و متغیرها انجام داد و سپس برای انجام تحلیل رگرسیون ترتیبی به آدرس زیر مراجعه نمود.
Analyze > Regression > ordinal
خوب اکنون یک پنجرهای دیالوگ باز میشود. متغیر وابسته رتبهای را وارد بخش متغیر وابسته میکنیم. دو پنجرهی دیگر وجود دارد که میتوان متغیرهای مستقل خود را وارد آنها کرد. باید دقت نمود که factor یا عاملها باید حتماً کیفی(اسمی یا ترتیبی) باشند و covariate یا کوریت ها حتماً باید کمی(scale) باشند.(مرادی، ۱۳۹۵)
در مقالات آینده نحوه تفسیر جداول خروجی و چگونگی بیان آن در تحقیقات بحث خواهد شد.
محسن مرادی
http://analysisacademy.com/wp-content/uploads/2017/01/icon_23477.png
@analysisacademy
www.analysisacademy.com
ویژگیهای محقق کیفی
در مقالات گذشته سایت آکادمی تحلیل آماری ایران همواره به ویژگیهای تحقیق کیفی و پارادایمهای آن پرداختهشده است. اما تاکنون این سؤال را از خود پرسیدهایم که با توجه به تب کاذب و ناآگاهانهای از انجام تحقیق کیفی و یا حتی تحقیق آمیخته که در فضای دانشگاهی کشورمان پدید آمده است، آیا ما بهعنوان یک محقق ویژگیهای خاص لازم برای انجام یک پژوهش کیفی راداریم یا خیر؟ در این مقاله سعی بر آن است که این ویژگیها برشمرده شود و ما عنوان یک محقق از خود سؤال کنیم که آیا مرد این میدان هستیم یا خیر.
حوزه تحقیق کیفی همواره دارای خصوصیات تنوع و مناقشه بوده است و این خصوصیات پایدارترین سنتهای آن بودهاند.بهعنوان وارث این تاریخ پیـچیده و متناقض،محقق باید اخلاقیات و دیپلماسی تحقیق را نیز در نظر بگیرد (لینکلن،ص۲۵، ۱۹۹۵).
تحقیق کیفی دارای تمرکز چند روشی و دربرگیرنده رویکردی تفسیری،طبیعی به موضوع موردمطالعه است.میتوان به متدولوژیهای گوناگون تحقیق کیفی بهصورت"بریکولاژ" و به محقق بهعنوان "بریکولور"نظاره کرد.بریکولور فردی آشنا به بسیاری از روشها یا بهنوعی فرد حرفهای باکیفیت بالا در نظریهپردازی است،که بریکولاژ تولید میکند. یـعنی، مـجموعه اقدامات جفتوجور و متناسب برای حل یک مسئله در شرایط واقعی را ابداع و پیشنهاد میکند (لینکلن،ص۳، ۱۹۹۵).
محقق کیفی بهعنوان بـریکولور از ابزارهای متدولوژیکی خود استفاده مـیکند و از هـرگونه استراتژی، روش یا داده تجربی در دسترس بهره میجوید. اگر ابزار جدیدی باید ایجاد شود یا سرهم شود، محقق این کار را انجام خواهد داد. نوع ابزار و چـگونگی فعالیتهای تحقیقی، از ابتدا چندان مـعلوم نـیست.
انتخاب فعالیتهای تحقیق به پرسشها، پاسخها و مسیر پیشرفت تحقیق بستگی دارد. تحقیق کیفی ذاتاً دارای تمرکز چند روشی است. اما استفاده از روشهای مختلف، یا کثرتگرایی، منعکسکننده سعی برای درک عمیق پدیده موردنظر اسـت (لینکلن،ص۴، ۱۹۹۵).
مـحقق کیفی باید در اجرای کارهای متنوعی از مصاحبه تا مشاهده، تفسیر اسناد تاریخی، تأمل عمیق و درک پدیده موردنظر مهارت داشته و نسبت به پارادایمهای تفسیری متعددی آگاه باشد. محقق بهعنوان نظریهپرداز در درون و بـین دیـدگاهها و پارادایمهای مـختلف کار میکند. ازنظر او تحقیق فرایندی تفسیری است که توسط سابقه فردی، سرگذشت، جنس، طبقه اجتماعی، نژاد و قـومیت وی، سوژهها و سایر ویژگیها محیطی، شکل میگیرد. او میداند که علم قدرت اسـت بـنابراین تـمام یافتههای علمی تبعات سیاسی دارند. به گمان او علم عاری از ارزش وجود ندارد. همچنین میداند محققان داستانهایی درباره دنـیای موردمطالعه خود ارائه میکنند. این روایتها در سنتهای داستانسرایی، که اغلب پارادایم تعریف مـیشوند، فـرموله مـیشوند (لینکلن،ص۴، ۱۹۹۵).
در همین زمینه،برخی از مؤلفان به "حساسیت نظری" محقق اشاره دارند. حساسیت نظری مفهومی مفید بـرای ارزیابی مهارت و آمادگی محقق برای انجام یک تحقیق کیفی است. هاپفل در سال ۱۹۹۷ با نقلقول نزدیک به مضمون از کوربین(1990) مـیگوید: حـساسیت نظری نشاندهنده آگاهی از معانی دادهها، بینش و توانایی معنا بخشیدن به دادهها، ظرفیت درک و توانایی مجزا نمودن موارد مرتبط از نامربوط است. حساسیت نظری از منابع متفاوتی شامل ادبیات حرفهای، تجارب حرفهای و تجارب شخصی نشئت میگیرد.
اعتبار یک گزارش تحقیق کیفی بستگی به اطمینان خوانندگان از توانایی محقق در حساسیت نسبت به دادهها و اتخاذ تصمیمات مناسب در میدان تحقیق،دارد(هاپفل، ص۵۰، ۱۹۹۷)
محقق کیفی باید فردی ممتاز در قلمرو تحقیق، دارای شجاعت و زمـینههای خـلاقیت و نوآوری باشد.
محسن مرادی
@analysisacademy
www.analysisacademy.com
ویژگیهای محقق کیفی
در مقالات گذشته سایت آکادمی تحلیل آماری ایران همواره به ویژگیهای تحقیق کیفی و پارادایمهای آن پرداختهشده است. اما تاکنون این سؤال را از خود پرسیدهایم که با توجه به تب کاذب و ناآگاهانهای از انجام تحقیق کیفی و یا حتی تحقیق آمیخته که در فضای دانشگاهی کشورمان پدید آمده است، آیا ما بهعنوان یک محقق ویژگیهای خاص لازم برای انجام یک پژوهش کیفی راداریم یا خیر؟ در این مقاله سعی بر آن است که این ویژگیها برشمرده شود و ما عنوان یک محقق از خود سؤال کنیم که آیا مرد این میدان هستیم یا خیر.
حوزه تحقیق کیفی همواره دارای خصوصیات تنوع و مناقشه بوده است و این خصوصیات پایدارترین سنتهای آن بودهاند.بهعنوان وارث این تاریخ پیـچیده و متناقض،محقق باید اخلاقیات و دیپلماسی تحقیق را نیز در نظر بگیرد (لینکلن،ص۲۵، ۱۹۹۵).
تحقیق کیفی دارای تمرکز چند روشی و دربرگیرنده رویکردی تفسیری،طبیعی به موضوع موردمطالعه است.میتوان به متدولوژیهای گوناگون تحقیق کیفی بهصورت"بریکولاژ" و به محقق بهعنوان "بریکولور"نظاره کرد.بریکولور فردی آشنا به بسیاری از روشها یا بهنوعی فرد حرفهای باکیفیت بالا در نظریهپردازی است،که بریکولاژ تولید میکند. یـعنی، مـجموعه اقدامات جفتوجور و متناسب برای حل یک مسئله در شرایط واقعی را ابداع و پیشنهاد میکند (لینکلن،ص۳، ۱۹۹۵).
محقق کیفی بهعنوان بـریکولور از ابزارهای متدولوژیکی خود استفاده مـیکند و از هـرگونه استراتژی، روش یا داده تجربی در دسترس بهره میجوید. اگر ابزار جدیدی باید ایجاد شود یا سرهم شود، محقق این کار را انجام خواهد داد. نوع ابزار و چـگونگی فعالیتهای تحقیقی، از ابتدا چندان مـعلوم نـیست.
انتخاب فعالیتهای تحقیق به پرسشها، پاسخها و مسیر پیشرفت تحقیق بستگی دارد. تحقیق کیفی ذاتاً دارای تمرکز چند روشی است. اما استفاده از روشهای مختلف، یا کثرتگرایی، منعکسکننده سعی برای درک عمیق پدیده موردنظر اسـت (لینکلن،ص۴، ۱۹۹۵).
مـحقق کیفی باید در اجرای کارهای متنوعی از مصاحبه تا مشاهده، تفسیر اسناد تاریخی، تأمل عمیق و درک پدیده موردنظر مهارت داشته و نسبت به پارادایمهای تفسیری متعددی آگاه باشد. محقق بهعنوان نظریهپرداز در درون و بـین دیـدگاهها و پارادایمهای مـختلف کار میکند. ازنظر او تحقیق فرایندی تفسیری است که توسط سابقه فردی، سرگذشت، جنس، طبقه اجتماعی، نژاد و قـومیت وی، سوژهها و سایر ویژگیها محیطی، شکل میگیرد. او میداند که علم قدرت اسـت بـنابراین تـمام یافتههای علمی تبعات سیاسی دارند. به گمان او علم عاری از ارزش وجود ندارد. همچنین میداند محققان داستانهایی درباره دنـیای موردمطالعه خود ارائه میکنند. این روایتها در سنتهای داستانسرایی، که اغلب پارادایم تعریف مـیشوند، فـرموله مـیشوند (لینکلن،ص۴، ۱۹۹۵).
در همین زمینه،برخی از مؤلفان به "حساسیت نظری" محقق اشاره دارند. حساسیت نظری مفهومی مفید بـرای ارزیابی مهارت و آمادگی محقق برای انجام یک تحقیق کیفی است. هاپفل در سال ۱۹۹۷ با نقلقول نزدیک به مضمون از کوربین(1990) مـیگوید: حـساسیت نظری نشاندهنده آگاهی از معانی دادهها، بینش و توانایی معنا بخشیدن به دادهها، ظرفیت درک و توانایی مجزا نمودن موارد مرتبط از نامربوط است. حساسیت نظری از منابع متفاوتی شامل ادبیات حرفهای، تجارب حرفهای و تجارب شخصی نشئت میگیرد.
اعتبار یک گزارش تحقیق کیفی بستگی به اطمینان خوانندگان از توانایی محقق در حساسیت نسبت به دادهها و اتخاذ تصمیمات مناسب در میدان تحقیق،دارد(هاپفل، ص۵۰، ۱۹۹۷)
محقق کیفی باید فردی ممتاز در قلمرو تحقیق، دارای شجاعت و زمـینههای خـلاقیت و نوآوری باشد.
محسن مرادی

http://analysisacademy.com/wp-content/uploads/2017/01/Panel-Data.jpg
@analysisacademy
www.analysisacademy.com
مدل پانل دیتا
اطلاعات آماری مورد استفاده در مباحث اقتصاد سنجی به سه دسته تقسیم میشود که عبارتند از:
الف-اطلاعات سری زمانی که مربوط به اندازه گیری یک متغیر در یک دوره از زمان است نظیر آمار حسابهای ملی
ب-اطلاعات مقطعی که مربوط به اندازه گیری یک متغیر در یک زمان معین برای واحدهای مختلف است. همانند آمار بودجه خانوار که در هر سال از خانوارهای نمونه مناطق مختلف کشور تهیه میشود.
ج-اطلاعات تلفیقی سری زمانی و مقطعی، بسیاری از مطالعات اخیر که در زمینه اقتصاد صورت گرفته از مجموعه دادهای تلفیقی استفاده کرده اند. روش پانل دیتا ترکیبی از داده های سری زمانی و مقطعی است در این گونه اطلاعات چندین بنگاه، خانوار، کشور و … از لحاظ کمی و کیفی در طول زمان مورد بررسی و تجزیه و تحلیل قرار میگیرند. در بسیاری از موارد، محقق میتواند از پانلدیتا برای مواردی که مسائل را نمیتوان به صورت سری زمانی و یا مقطعی بررسی کرد استفاده کند. مثلا در بررسیهای تابع تولید مسئله این است که بتوان تغییرات تکنولوژیکی را از صرفههای ناشی از مقیاس تفکیک کنیم. در ذیل به مزایا و محدودیتهای این مدل میپردازیم.
@analysisacademy
محاسن استفاده از مدل پانلدیتا
• به دلیل افزودن مشاهدات، درجه آزادی زیاد میشود لذا استنتاج آماری قویتر میشود. استنتاج براساس ۲۰ مشاهده ضعیفتر از ۱۰۰ مشاهده است. تغییرات مشاهدات را زیاد میکند که باعث کاهش Var برآوردگر میشود.
لذا به یافتن نتایج معنادار کمک میکندزیرا:
1. با افزایش درجه آزادی، مقدار جدول توابع آزمون کم شود، مقدار بحرانی t,F کم میشود.
2. با افزایش تغییرات مشاهدات، و لذا کاهش Var برآوردگرها، t محاسباتی زیاد میشود.
دو نیروی بالا باعث معنادار شدن بسیاری از نتایج میشود که با دادههای سری زمانی یا مقطعی صرف، غیرمعنا دارند.یعنی به طور خلاصه باید گفت که تعداد مشاهدات و داده ها زیاد بوده و اعتماد به برآوردها بیشتر است.
پس مدل پنل دیتا علاج بسیار مناسبی برای مشکل همخطی است. زیرا هم خطی زمانی است که نتایج را (براساس کمیتt) غیر معنادار باشد که این تکنیکها یکی از بهترین روشهای درمان هم خطی است.
• بسیاری روشهای اقتصاد سنجی که نیازمند اطلاعات بیرونی نسبت به پارامترها هست و بر دادههای صرف مقطعی و سری زمانی باید از بیرون مدل داده شوند.اما در Panel Data امکان اعمال روش GLS یا WLS بدون وزن دهی از بیرون توسط خود نرم افزار اجرا میشود. یعنی به محققان اجازه می دهد مدل های پیشرفته تری را تبیین کرده و آزمون کنند.(گجراتی، ۱۳۸۸)
• با این مجموعه داده ها می توان اثراتی را شناسایی یا اندازه گیری کرد که در داده های مقطعی محض یا سری زمانی خالص قابل شناسایی نیست.
• استفاده از داده های پانل تورش برآورد را از بین برده یا کم می کند.
محدودیت های پانلدیتا
• داده های پانلدیتا هزینه بر است یعنی هزینه های جمعآوری داده ها از جمله مسائل طراحی و گردآوری این نوع داده ها که البته ممکن است همه آنچه لازم است پوشش داده نشود.
• تحریفات خطاهای اندازه گیری مثلاً اگر در پرسشنامه سؤالات شفاف نباشد.
• مسائل گزینشی که شامل خود گزینشی (معمولا اطلاعاتی ارائه میشود که به صورت شاخص است نه واقعی)، یا مسئله بدون پایه است یعنی مشاهدات بدون پاسخ بماند و یا مسئله اصطکاک است یعنی اگر اشکال در مشاهدات ایجادشود موجی را ایجاد میکند که دامنه آن به مشاهدات دیگر کشیده میشود. به طور کلی نرخ اصطکاک از یک موج به موج دیگر افزایش مییابد، اما این موج افزایشی طی زمان کاهش مییابد.
• بعد سری زمانی ممکن است خیلی کوتاه باشد.
در پایان باید اشاره کرد که به داده های حاصل از پانل دیتا، داده های ترکیبی، داده های آمیخته گفته می شود.
محسن مرادی
از کپی برداری مطالب سایت و کانال بدون ذکر سایت منبع جدا خوداری شود
@analysisacademy
www.analysisacademy.com
مدل پانل دیتا
اطلاعات آماری مورد استفاده در مباحث اقتصاد سنجی به سه دسته تقسیم میشود که عبارتند از:
الف-اطلاعات سری زمانی که مربوط به اندازه گیری یک متغیر در یک دوره از زمان است نظیر آمار حسابهای ملی
ب-اطلاعات مقطعی که مربوط به اندازه گیری یک متغیر در یک زمان معین برای واحدهای مختلف است. همانند آمار بودجه خانوار که در هر سال از خانوارهای نمونه مناطق مختلف کشور تهیه میشود.
ج-اطلاعات تلفیقی سری زمانی و مقطعی، بسیاری از مطالعات اخیر که در زمینه اقتصاد صورت گرفته از مجموعه دادهای تلفیقی استفاده کرده اند. روش پانل دیتا ترکیبی از داده های سری زمانی و مقطعی است در این گونه اطلاعات چندین بنگاه، خانوار، کشور و … از لحاظ کمی و کیفی در طول زمان مورد بررسی و تجزیه و تحلیل قرار میگیرند. در بسیاری از موارد، محقق میتواند از پانلدیتا برای مواردی که مسائل را نمیتوان به صورت سری زمانی و یا مقطعی بررسی کرد استفاده کند. مثلا در بررسیهای تابع تولید مسئله این است که بتوان تغییرات تکنولوژیکی را از صرفههای ناشی از مقیاس تفکیک کنیم. در ذیل به مزایا و محدودیتهای این مدل میپردازیم.
@analysisacademy
محاسن استفاده از مدل پانلدیتا
• به دلیل افزودن مشاهدات، درجه آزادی زیاد میشود لذا استنتاج آماری قویتر میشود. استنتاج براساس ۲۰ مشاهده ضعیفتر از ۱۰۰ مشاهده است. تغییرات مشاهدات را زیاد میکند که باعث کاهش Var برآوردگر میشود.
لذا به یافتن نتایج معنادار کمک میکندزیرا:
1. با افزایش درجه آزادی، مقدار جدول توابع آزمون کم شود، مقدار بحرانی t,F کم میشود.
2. با افزایش تغییرات مشاهدات، و لذا کاهش Var برآوردگرها، t محاسباتی زیاد میشود.
دو نیروی بالا باعث معنادار شدن بسیاری از نتایج میشود که با دادههای سری زمانی یا مقطعی صرف، غیرمعنا دارند.یعنی به طور خلاصه باید گفت که تعداد مشاهدات و داده ها زیاد بوده و اعتماد به برآوردها بیشتر است.
پس مدل پنل دیتا علاج بسیار مناسبی برای مشکل همخطی است. زیرا هم خطی زمانی است که نتایج را (براساس کمیتt) غیر معنادار باشد که این تکنیکها یکی از بهترین روشهای درمان هم خطی است.
• بسیاری روشهای اقتصاد سنجی که نیازمند اطلاعات بیرونی نسبت به پارامترها هست و بر دادههای صرف مقطعی و سری زمانی باید از بیرون مدل داده شوند.اما در Panel Data امکان اعمال روش GLS یا WLS بدون وزن دهی از بیرون توسط خود نرم افزار اجرا میشود. یعنی به محققان اجازه می دهد مدل های پیشرفته تری را تبیین کرده و آزمون کنند.(گجراتی، ۱۳۸۸)
• با این مجموعه داده ها می توان اثراتی را شناسایی یا اندازه گیری کرد که در داده های مقطعی محض یا سری زمانی خالص قابل شناسایی نیست.
• استفاده از داده های پانل تورش برآورد را از بین برده یا کم می کند.
محدودیت های پانلدیتا
• داده های پانلدیتا هزینه بر است یعنی هزینه های جمعآوری داده ها از جمله مسائل طراحی و گردآوری این نوع داده ها که البته ممکن است همه آنچه لازم است پوشش داده نشود.
• تحریفات خطاهای اندازه گیری مثلاً اگر در پرسشنامه سؤالات شفاف نباشد.
• مسائل گزینشی که شامل خود گزینشی (معمولا اطلاعاتی ارائه میشود که به صورت شاخص است نه واقعی)، یا مسئله بدون پایه است یعنی مشاهدات بدون پاسخ بماند و یا مسئله اصطکاک است یعنی اگر اشکال در مشاهدات ایجادشود موجی را ایجاد میکند که دامنه آن به مشاهدات دیگر کشیده میشود. به طور کلی نرخ اصطکاک از یک موج به موج دیگر افزایش مییابد، اما این موج افزایشی طی زمان کاهش مییابد.
• بعد سری زمانی ممکن است خیلی کوتاه باشد.
در پایان باید اشاره کرد که به داده های حاصل از پانل دیتا، داده های ترکیبی، داده های آمیخته گفته می شود.
محسن مرادی
از کپی برداری مطالب سایت و کانال بدون ذکر سایت منبع جدا خوداری شود

http://analysisacademy.com/wp-content/uploads/2017/01/تعریف-عملیاتی.jpg
@analysisacademy
www.analysisacademy.com
نحوه نوشتن تعریف عملیاتی در پروپزال
به طور کلی هر لفظ، اصطلاح یا واژه ای که در فرضیه یا چارچوب نظری تحقیق بکار می رود باید به طور دقیق، به گونه ای تعریف شود که هر خواننده ای بدون ابهام بتواند دریافت درستی از پژوهش و گزاره های علمی شما داشته باشد.
با توجه به اهمیت فوق العاده مسائل اندازه گیری متغیر های تحقیق، برای پژوهشگران این موضوع بسیار اهمیت دارد که مطالعه خود را بر حسب روشی که متغیر مزبور بر پایه ی آن اندازه گیری می شود دقیقا تعریف کنند. به بیان دیگر، پژوهشگر باید بتواند از متغیر مورد مطالعه خود در گزاره های تحقیق یک تعریف عملیاتی ارائه نماید. تعریف عملیاتی به خواننده پژوهش شما این امکان را می دهد که درباره اعتبار و روایی متغیر مورد نظر شما داوری کند. یعنی داوری کند که آیا روش اندازه گیری شما دقیقا متغیر مورد نظر را می سنجد یا خیر؟(مرادی، ۱۳۹۵)
@analysisacademy
دانشجویان نباید تعریف عملیاتی را با تعریف مفهومی یا همان نهادی اشتباه بگیرند. در تعریف نهادی مفاهیم را با استفاده از مفاهیم دیگر تعریف می کنند.. این نوع تعریف تقریبا همان کار فرهنگ لغات را انجام می دهند. مثلا تعریف مفهومی یا نهادی هوش به صورت ذکاوت و تیزی ذهن و یا توانایی تفکر انتزاعی تعریف می شود. می بینیم که واژه های دیگر مفهومی این مفهوم را مورد تعریف قرار می دهند. تعاریف مفهومی شامل اصطلاحات ابتدایی و استنتاجی است که نه درست و نه نادرست است.(هومن، ۱۳۸۹)
اما در تعریف عملیاتی یک مفهوم یا همان متغیر را به صورت اعمال و اموری تعریف می کنیم که در مطالعه به عنوان معرف و معادل آن مشخص می شوند. این گونه تعاریف می گوید، برای آن که متغیر را اندازه بگیریم ابتدا باید چه کاری را انجام بدهیم و چه چیزی را مشاهده بکنیم. یعنی معنای یک مفهوم به گونه کامل و جامع از طریق تعریف عملی آن مشخص می شود. مثلا همان مفهوم هوش را در نظر بگیریم که بر پایه این تعریف باید مشخص کنیم که اساسا چه رفتار هایی معرف عمل هوشمندانه و چه رفتار هایی معرف عمل غیر هوشمندانه است.
@analysisacademy
مسلما این نوع تعریف دربرگیرنده یکسری تست برای هوش و نتایج حاصل از آن برای نمره دهی آن است. همچنین باید بیان شود که این تست با چه دستورالعملی باید اجرا شود.
پس از دانشجویان و محققین عزیز درخواست می شود به تمام نکات گفته شده در تعریف عملیاتی دقت کرده و تنها درگیر این اشتباه رایج نباشند که بسیاری در پژوهش خود تعریف عملیاتی را با منبع دادن به پرسشنامه ای که از آن استفاده می کنند محدود می نمایند. همچنین باید بیان کرد که یک تعریف عملیاتی منحصر به فرد برای یک متغیر وجود ندارد و موضوع پژوهش، جامعه و نمونه آماری و حتی مدل پژوهش می تواند تعریف عملیاتی متفاوت و متناسب با آن را به دنبال داشته باشد. زیرا تعاریف عملی تنها جنبه ها و معانی محدودی را برای سازه ها به دست می دهد و بیانگر همه معنای آن متغیر ها نیستند(مرادی، ۱۳۹۵)
@analysisacademy
www.analysisacademy.com
نحوه نوشتن تعریف عملیاتی در پروپزال
به طور کلی هر لفظ، اصطلاح یا واژه ای که در فرضیه یا چارچوب نظری تحقیق بکار می رود باید به طور دقیق، به گونه ای تعریف شود که هر خواننده ای بدون ابهام بتواند دریافت درستی از پژوهش و گزاره های علمی شما داشته باشد.
با توجه به اهمیت فوق العاده مسائل اندازه گیری متغیر های تحقیق، برای پژوهشگران این موضوع بسیار اهمیت دارد که مطالعه خود را بر حسب روشی که متغیر مزبور بر پایه ی آن اندازه گیری می شود دقیقا تعریف کنند. به بیان دیگر، پژوهشگر باید بتواند از متغیر مورد مطالعه خود در گزاره های تحقیق یک تعریف عملیاتی ارائه نماید. تعریف عملیاتی به خواننده پژوهش شما این امکان را می دهد که درباره اعتبار و روایی متغیر مورد نظر شما داوری کند. یعنی داوری کند که آیا روش اندازه گیری شما دقیقا متغیر مورد نظر را می سنجد یا خیر؟(مرادی، ۱۳۹۵)
@analysisacademy
دانشجویان نباید تعریف عملیاتی را با تعریف مفهومی یا همان نهادی اشتباه بگیرند. در تعریف نهادی مفاهیم را با استفاده از مفاهیم دیگر تعریف می کنند.. این نوع تعریف تقریبا همان کار فرهنگ لغات را انجام می دهند. مثلا تعریف مفهومی یا نهادی هوش به صورت ذکاوت و تیزی ذهن و یا توانایی تفکر انتزاعی تعریف می شود. می بینیم که واژه های دیگر مفهومی این مفهوم را مورد تعریف قرار می دهند. تعاریف مفهومی شامل اصطلاحات ابتدایی و استنتاجی است که نه درست و نه نادرست است.(هومن، ۱۳۸۹)
اما در تعریف عملیاتی یک مفهوم یا همان متغیر را به صورت اعمال و اموری تعریف می کنیم که در مطالعه به عنوان معرف و معادل آن مشخص می شوند. این گونه تعاریف می گوید، برای آن که متغیر را اندازه بگیریم ابتدا باید چه کاری را انجام بدهیم و چه چیزی را مشاهده بکنیم. یعنی معنای یک مفهوم به گونه کامل و جامع از طریق تعریف عملی آن مشخص می شود. مثلا همان مفهوم هوش را در نظر بگیریم که بر پایه این تعریف باید مشخص کنیم که اساسا چه رفتار هایی معرف عمل هوشمندانه و چه رفتار هایی معرف عمل غیر هوشمندانه است.
@analysisacademy
مسلما این نوع تعریف دربرگیرنده یکسری تست برای هوش و نتایج حاصل از آن برای نمره دهی آن است. همچنین باید بیان شود که این تست با چه دستورالعملی باید اجرا شود.
پس از دانشجویان و محققین عزیز درخواست می شود به تمام نکات گفته شده در تعریف عملیاتی دقت کرده و تنها درگیر این اشتباه رایج نباشند که بسیاری در پژوهش خود تعریف عملیاتی را با منبع دادن به پرسشنامه ای که از آن استفاده می کنند محدود می نمایند. همچنین باید بیان کرد که یک تعریف عملیاتی منحصر به فرد برای یک متغیر وجود ندارد و موضوع پژوهش، جامعه و نمونه آماری و حتی مدل پژوهش می تواند تعریف عملیاتی متفاوت و متناسب با آن را به دنبال داشته باشد. زیرا تعاریف عملی تنها جنبه ها و معانی محدودی را برای سازه ها به دست می دهد و بیانگر همه معنای آن متغیر ها نیستند(مرادی، ۱۳۹۵)
http://analysisacademy.com/wp-content/uploads/2017/01/bootstrapping.gif
@analysisacademy
Bootstrapping (بوت استراپینگ) چیست؟
محققین عزیز که بصورت جدی تری درگیر نرم افزار های آماری مثل spss، amos، smart pls، lisrel و …..هستند صد در صد در صفحات مختلف با گزینه ای به نام Bootstrap برخورد کرده اند. دانشجویان کلاس های آکادمی تحلیل آماری ایران که در در دوره های smart pls عملا با آن درگیر بوده و آن را مورد بحث قرار داده اند. اما براستی Bootstrapping (بوت استراپینگ) چیست؟
ترجمه ای که برای آن در ادبیات آماری صورت گرفته است دستور خودگردان یا خودکار و یا خودگردان سازی بوده است. اما خودگردان سازی چیست؟ خودگردان سازی یا Bootstrap را می توان انجام نمونه گیری با جایگذاری از یک نمونه اصلی به دفعات زیاد دانست. یعنی ما از یک نمونه ثابت با حجم محدود به دفعات زیاد نمونه گیری مجدد البته با جایگذاری انجام می دهیم تا در نهایت بتوان با استفاده از نتایج کلیه ی دفعات نمونه گیری، در مجموع به یک توزیع نمونه ای دست یافت. دقت شود که هدف از نمونه گیری با جایگذاری این است که اقلام نمونه گیری شده پس از انتخاب به جامعه بازگردند تا بتوانند شانس حضور در نمونه های دیگر را پیدا کنند. در نهایت توزیع نمونه ای ایجاد شده مبنایی برای انجام تخمین ها، بویژه تخمین خطای معیار برای پارامتر های مختلف است.
در خودگردان سازی به جای آن که بر مبنای یک نمونه(نمونه اصلی) به تخمین خطای معیار دست بزنیم با انجام نمونه گیری های فرعی متعدد که اغلب بیشتر از ۲۰۰ بار است به یک توزیع نمونه ای تجربی دست میابیم که مبنای محاسبه خطای معیار قرار داده می شود. به این توزیع نمونه ای تجربی ، توزیع نمونه ای خودگردان یا Bootstrap گفته می شود(ژو، ۱۹۹۷)
مهمترین تفاوتی که باید گفته شود این است که در روش بدون Bootstrap شرط نرمال بودن توزیع داده ها وجود دارد اما در استنباط از طریق نمونه گیری خودگردان یا Bootstrap چنین شرطی وجود ندارد. یعنی اگر توزیع داده های ما نرمال نبود می توانیم از این روش برای استنباط و بررسی معناداری ضرایب آماری خود بهره ببریم(مرادی، ۱۳۹۵)
فراموش نشود که براین در مقاله خود در سال ۲۰۱۴ پیرامون مقایسه روش های مختلف با روش خودگردان سازی بحث نموده است و بیان کرده در نرم افزار های کواریانس محور مثل لیزرل و ایموس علی رغم وجود روش های خودگردان سازی بهتر است از قلب تپنده روش های کواریانس محور یعنی حداکثر درست نمایی که نیاز به حجم نمونه بالا و توزیع داده های نرمال است استفاده شود و روش خودگردان سازی را برای تحقیقات خاص با حجم نمونه کم و توزیع غیر نرمال و در جهت رویکرد های واریانس محور پیشنهاد می نماید(مرادی، ۱۳۹۵)
@analysisacademy
Bootstrapping (بوت استراپینگ) چیست؟
محققین عزیز که بصورت جدی تری درگیر نرم افزار های آماری مثل spss، amos، smart pls، lisrel و …..هستند صد در صد در صفحات مختلف با گزینه ای به نام Bootstrap برخورد کرده اند. دانشجویان کلاس های آکادمی تحلیل آماری ایران که در در دوره های smart pls عملا با آن درگیر بوده و آن را مورد بحث قرار داده اند. اما براستی Bootstrapping (بوت استراپینگ) چیست؟
ترجمه ای که برای آن در ادبیات آماری صورت گرفته است دستور خودگردان یا خودکار و یا خودگردان سازی بوده است. اما خودگردان سازی چیست؟ خودگردان سازی یا Bootstrap را می توان انجام نمونه گیری با جایگذاری از یک نمونه اصلی به دفعات زیاد دانست. یعنی ما از یک نمونه ثابت با حجم محدود به دفعات زیاد نمونه گیری مجدد البته با جایگذاری انجام می دهیم تا در نهایت بتوان با استفاده از نتایج کلیه ی دفعات نمونه گیری، در مجموع به یک توزیع نمونه ای دست یافت. دقت شود که هدف از نمونه گیری با جایگذاری این است که اقلام نمونه گیری شده پس از انتخاب به جامعه بازگردند تا بتوانند شانس حضور در نمونه های دیگر را پیدا کنند. در نهایت توزیع نمونه ای ایجاد شده مبنایی برای انجام تخمین ها، بویژه تخمین خطای معیار برای پارامتر های مختلف است.
در خودگردان سازی به جای آن که بر مبنای یک نمونه(نمونه اصلی) به تخمین خطای معیار دست بزنیم با انجام نمونه گیری های فرعی متعدد که اغلب بیشتر از ۲۰۰ بار است به یک توزیع نمونه ای تجربی دست میابیم که مبنای محاسبه خطای معیار قرار داده می شود. به این توزیع نمونه ای تجربی ، توزیع نمونه ای خودگردان یا Bootstrap گفته می شود(ژو، ۱۹۹۷)
مهمترین تفاوتی که باید گفته شود این است که در روش بدون Bootstrap شرط نرمال بودن توزیع داده ها وجود دارد اما در استنباط از طریق نمونه گیری خودگردان یا Bootstrap چنین شرطی وجود ندارد. یعنی اگر توزیع داده های ما نرمال نبود می توانیم از این روش برای استنباط و بررسی معناداری ضرایب آماری خود بهره ببریم(مرادی، ۱۳۹۵)
فراموش نشود که براین در مقاله خود در سال ۲۰۱۴ پیرامون مقایسه روش های مختلف با روش خودگردان سازی بحث نموده است و بیان کرده در نرم افزار های کواریانس محور مثل لیزرل و ایموس علی رغم وجود روش های خودگردان سازی بهتر است از قلب تپنده روش های کواریانس محور یعنی حداکثر درست نمایی که نیاز به حجم نمونه بالا و توزیع داده های نرمال است استفاده شود و روش خودگردان سازی را برای تحقیقات خاص با حجم نمونه کم و توزیع غیر نرمال و در جهت رویکرد های واریانس محور پیشنهاد می نماید(مرادی، ۱۳۹۵)

کارگاه های اسفندماه اکادمی تحلیل اماری ایران
۱.دوره ۴۰ ساعته مقدماتی تا پیشرفته اس پی اس اس با رویکرد نگارش پایان نامه تاریخهای ۵ و ۶و ۱۱و۱۲و ۱۳ اسفند از ساعت۱۳ تا ۲۱ به مبلغ ۴۵۰ هزارتومان ثبت نام دانشجویی و ۵۵۰ هزار تومان ثبت نام ازاد
۲.دوره ۲۴ ساعته لیزرل و ایموس با رویکرد نگارش پایان نامه روزهای ۱۸ و ۱۹ و ۲۰ اسفند از ساعت ۱۳ تا ۲۱ به مبلغ دانشجویی ۳۵۰ هزار تومان و مبلع ازاد ۴۰۰ هزار تومان
لطفا جهت رزرو نام و نام خانوادگی و نام دوره مدنظرتون به شماره ۰۹۱۰۰۰۷۱۸۰۴ ارسال فرمایید.
۱.دوره ۴۰ ساعته مقدماتی تا پیشرفته اس پی اس اس با رویکرد نگارش پایان نامه تاریخهای ۵ و ۶و ۱۱و۱۲و ۱۳ اسفند از ساعت۱۳ تا ۲۱ به مبلغ ۴۵۰ هزارتومان ثبت نام دانشجویی و ۵۵۰ هزار تومان ثبت نام ازاد
۲.دوره ۲۴ ساعته لیزرل و ایموس با رویکرد نگارش پایان نامه روزهای ۱۸ و ۱۹ و ۲۰ اسفند از ساعت ۱۳ تا ۲۱ به مبلغ دانشجویی ۳۵۰ هزار تومان و مبلع ازاد ۴۰۰ هزار تومان
لطفا جهت رزرو نام و نام خانوادگی و نام دوره مدنظرتون به شماره ۰۹۱۰۰۰۷۱۸۰۴ ارسال فرمایید.
مژده
بالاخره تاریخ دوره کیفی دکتر مرادی برای دوستانی که دوره های کمی بودند به شرح زیر اعلام شد
۱۹،۲۰،۲۱،۲۲اردیبهشت۹۶
۳۲ ساعت با هزینه ۵۰۰ هزارتومان
ظرفیت محدود و بر اساس اولویت واریز
بالاخره تاریخ دوره کیفی دکتر مرادی برای دوستانی که دوره های کمی بودند به شرح زیر اعلام شد
۱۹،۲۰،۲۱،۲۲اردیبهشت۹۶
۳۲ ساعت با هزینه ۵۰۰ هزارتومان
ظرفیت محدود و بر اساس اولویت واریز
@analysisacademy
http://analysisacademy.com/wp-content/uploads/2017/02/MAN1.png
تحلیل واریانس چند متغیره یا Manova(1)
با توجه به تقاضای بسیاری از محققین عزیز بر آن شدم که یکی از پیچیده ترین آزمون های آماری یعنی آزمون تحلیل واریانس چند متغیره MANOVA را در این مقاله مورد بحث قرار دهیم و تلاش کنیم که به زبان ساده آن را باز کرده و مفاهیم، نحوه اجرای آن در نرم افزار و از همه مهمتر تفسیر نتایج مهم آن را به عزیزانم آموزش دهیم.
نکته ی اولی که بیان می کنم این است که عزیزان حتما پیش از مطالعه این مقاله به مقاله آزمون F تحلیل واریانس یک طرفه یا ANOVA رجوع نمایند و با دقت آن را مطالعه کنند زیرا در غیر این صورت جان مطلب این مقاله را دریافت نخواهند کرد یا لااقل کاملا دریافت نخواهند کرد. در آن مقاله بیان شد که تحلیل واریانس یک طرفه ANOVA برای آزمون مقایسه میانگین یک متغیر کمی در بین بیش از دو گروه مستقل استفاده می شود. در حقیقت این آزمون تعمیم یافته همان آزمون T دو نمونه مستقل است و دارای همان پیش فرض ها می باشد و تنها تفاوت این است که میانگین متغیر های کمی در بیش از دو گروه مستقل با هم مقایسه می شوند(مرادی، ۱۳۹۵).
در آزمون MANOVA باید ذکر نمایم که اگر زمانی قصد داشتیم بجای مقایسه میانگین یک متغیر کمی، بیاییم و میانگین بیش از یک متغیر کمی را در بین بیش از دو گروه مستقل مقایسه نماییم می توانیم از MANOVA یا تحلیل واریانس چند متغیره استفاده نماییم. یعنی در حقیقت این آزمون تعمیم یافته آزمون ANOVA است.
ابتدا به دقت پیش فرض های این آزمون را بررسی نماییم.
1. اولا وقتی بیان می شود ما می توانیم میانگین چند متغیر کمی(SCALE) را در گروه ها مقایسه کنیم عمدتا این چند متغیر مولفه های یک سازه اصلی هستند. مثلا به فرضیه ی زیر دقت کنید:
تعهد سازمانی در بین کارکنان بخش مالی، بازاریابی و تولید با تحصیلات مختلف تفاوت دارد.
خوب اولا این فرضیه و آزمون MANOVA همانطور که در کلاس های آکادمی تحلیل آماری ایران بیان شد، فرضیه ای تفاوتی است. این نکته را برای آن ذکر کردم که بعضا دانشجویانی سوال می کنند من فرضیه ای به این شکل دارم آیا باید از روش های رگرسیونی(مدل سازی معادلات ساختاری استفاده کنم). فرضیه آن ها بدین صورت است:
تحصیلات کارکنان بخش های مالی، بازاریابی و تولید بر تعهد سازمانی تاثیر می گذارد.
بعد بیان می کنند که چون کلمه تاثیر در فرضیه آمده پس فرضیه علی است و باید از تجزیه و تحلیل فرضیات علی را بکار برد. در صورتی که با کمب دقت مشخص است که فرضیه بدین صورت است که قرار است به مقایسه میانگین تعهد سازمانی در گروه های مالی، بازاریابی و تولید و نیز در گروه های لیسانس، فوق لیسانس و دکتری پرداخت. همانطور که میبینیم در این آزمون حداقل باید دو متغیر کیفی(کارکنان بخش ها، تحصیلات) که اسمی یا رتبه ای هستند برای اینکه مقایسه میانگین در آن ها انجام شود وجود داشته باشد.
از طرفی همانطور که اول پیش فرض بیان شد یکی از مهمترین موضوعات این است که وقتی بیان می کنیم چند متغیر کمی در این متغیر ها کیفی مورد مقایسه میانگین قرار می گیرند، این چند متغیر خود مولفه های یک سازه هستند. در فرضیه ما نیز این گونه است.(مرادی، ۱۳۹۵)
یعنی تعهد سازمانی خود شامل سه مولفه یا خرده مقیاس:
۱)تعهد عاطفی
۲)تعهد هنجاری
۳)تعهد مستمر
است. یعنی در این آزمون همزمان میانگین متغیرهای کمی تعهد عاطفی و تعهد هنجاری و تعهد مستمر در دو متغیر کیفی(کارکنان بخش ها، تحصیلات) که یکی اسمی و دیگری ترتیبی است مقایسه می شوند.
2. پیش فرض دوم این است که این متغیر های کمی دارای توزیع نرمال باشند ( توجه شود که پیش تست نرمال بودن توزیع داده های متغیرهای کمی تعهد عاطفی ، تعهد هنجاری و تعهد مستمر باید حتما توسط آزمون چولگی و کشیدگی سنجیده شود. پیرامون این موضوع در مقالات گذشته و کتاب های قرار داده شده در سایت بحث های کاملی انجام شده است).
3. متغیر هایی که در گروه های مستقل آن ها مقایسه انجام می شود باید در سطح سنجش اسمی یا رتبه ای باشند. یعنی کیفی باشند.
4. مقایسه میانگین متغیر های کمی باید در بیش از یک متغیر کیفی انجام شود. اگر در آزمون ANOVA به خاطر داشته باشد مقایسه میانگین در یک متغیر کیفی با چند گروه مستقل انجام می شد. اما در این آزمون همانطور که می بینید بیش از یک متغیر کیفی داریم و همزمان میانگین متغیرهای کمی تعهد عاطفی، تعهد هنجاری و تعهد مستمر در دو متغیر کیفی(کارکنان بخش ها، تحصیلات) که یکی اسمی و دیگری ترتیبی است مقایسه می شوند. این متغیر های کیفی در نرم افزار SPSS عامل یا FACTOR خوانده می شود.
http://analysisacademy.com/wp-content/uploads/2017/02/MAN1.png
تحلیل واریانس چند متغیره یا Manova(1)
با توجه به تقاضای بسیاری از محققین عزیز بر آن شدم که یکی از پیچیده ترین آزمون های آماری یعنی آزمون تحلیل واریانس چند متغیره MANOVA را در این مقاله مورد بحث قرار دهیم و تلاش کنیم که به زبان ساده آن را باز کرده و مفاهیم، نحوه اجرای آن در نرم افزار و از همه مهمتر تفسیر نتایج مهم آن را به عزیزانم آموزش دهیم.
نکته ی اولی که بیان می کنم این است که عزیزان حتما پیش از مطالعه این مقاله به مقاله آزمون F تحلیل واریانس یک طرفه یا ANOVA رجوع نمایند و با دقت آن را مطالعه کنند زیرا در غیر این صورت جان مطلب این مقاله را دریافت نخواهند کرد یا لااقل کاملا دریافت نخواهند کرد. در آن مقاله بیان شد که تحلیل واریانس یک طرفه ANOVA برای آزمون مقایسه میانگین یک متغیر کمی در بین بیش از دو گروه مستقل استفاده می شود. در حقیقت این آزمون تعمیم یافته همان آزمون T دو نمونه مستقل است و دارای همان پیش فرض ها می باشد و تنها تفاوت این است که میانگین متغیر های کمی در بیش از دو گروه مستقل با هم مقایسه می شوند(مرادی، ۱۳۹۵).
در آزمون MANOVA باید ذکر نمایم که اگر زمانی قصد داشتیم بجای مقایسه میانگین یک متغیر کمی، بیاییم و میانگین بیش از یک متغیر کمی را در بین بیش از دو گروه مستقل مقایسه نماییم می توانیم از MANOVA یا تحلیل واریانس چند متغیره استفاده نماییم. یعنی در حقیقت این آزمون تعمیم یافته آزمون ANOVA است.
ابتدا به دقت پیش فرض های این آزمون را بررسی نماییم.
1. اولا وقتی بیان می شود ما می توانیم میانگین چند متغیر کمی(SCALE) را در گروه ها مقایسه کنیم عمدتا این چند متغیر مولفه های یک سازه اصلی هستند. مثلا به فرضیه ی زیر دقت کنید:
تعهد سازمانی در بین کارکنان بخش مالی، بازاریابی و تولید با تحصیلات مختلف تفاوت دارد.
خوب اولا این فرضیه و آزمون MANOVA همانطور که در کلاس های آکادمی تحلیل آماری ایران بیان شد، فرضیه ای تفاوتی است. این نکته را برای آن ذکر کردم که بعضا دانشجویانی سوال می کنند من فرضیه ای به این شکل دارم آیا باید از روش های رگرسیونی(مدل سازی معادلات ساختاری استفاده کنم). فرضیه آن ها بدین صورت است:
تحصیلات کارکنان بخش های مالی، بازاریابی و تولید بر تعهد سازمانی تاثیر می گذارد.
بعد بیان می کنند که چون کلمه تاثیر در فرضیه آمده پس فرضیه علی است و باید از تجزیه و تحلیل فرضیات علی را بکار برد. در صورتی که با کمب دقت مشخص است که فرضیه بدین صورت است که قرار است به مقایسه میانگین تعهد سازمانی در گروه های مالی، بازاریابی و تولید و نیز در گروه های لیسانس، فوق لیسانس و دکتری پرداخت. همانطور که میبینیم در این آزمون حداقل باید دو متغیر کیفی(کارکنان بخش ها، تحصیلات) که اسمی یا رتبه ای هستند برای اینکه مقایسه میانگین در آن ها انجام شود وجود داشته باشد.
از طرفی همانطور که اول پیش فرض بیان شد یکی از مهمترین موضوعات این است که وقتی بیان می کنیم چند متغیر کمی در این متغیر ها کیفی مورد مقایسه میانگین قرار می گیرند، این چند متغیر خود مولفه های یک سازه هستند. در فرضیه ما نیز این گونه است.(مرادی، ۱۳۹۵)
یعنی تعهد سازمانی خود شامل سه مولفه یا خرده مقیاس:
۱)تعهد عاطفی
۲)تعهد هنجاری
۳)تعهد مستمر
است. یعنی در این آزمون همزمان میانگین متغیرهای کمی تعهد عاطفی و تعهد هنجاری و تعهد مستمر در دو متغیر کیفی(کارکنان بخش ها، تحصیلات) که یکی اسمی و دیگری ترتیبی است مقایسه می شوند.
2. پیش فرض دوم این است که این متغیر های کمی دارای توزیع نرمال باشند ( توجه شود که پیش تست نرمال بودن توزیع داده های متغیرهای کمی تعهد عاطفی ، تعهد هنجاری و تعهد مستمر باید حتما توسط آزمون چولگی و کشیدگی سنجیده شود. پیرامون این موضوع در مقالات گذشته و کتاب های قرار داده شده در سایت بحث های کاملی انجام شده است).
3. متغیر هایی که در گروه های مستقل آن ها مقایسه انجام می شود باید در سطح سنجش اسمی یا رتبه ای باشند. یعنی کیفی باشند.
4. مقایسه میانگین متغیر های کمی باید در بیش از یک متغیر کیفی انجام شود. اگر در آزمون ANOVA به خاطر داشته باشد مقایسه میانگین در یک متغیر کیفی با چند گروه مستقل انجام می شد. اما در این آزمون همانطور که می بینید بیش از یک متغیر کیفی داریم و همزمان میانگین متغیرهای کمی تعهد عاطفی، تعهد هنجاری و تعهد مستمر در دو متغیر کیفی(کارکنان بخش ها، تحصیلات) که یکی اسمی و دیگری ترتیبی است مقایسه می شوند. این متغیر های کیفی در نرم افزار SPSS عامل یا FACTOR خوانده می شود.
@analysisacademy
http://analysisacademy.com/wp-content/uploads/2017/02/MAN1.png
تحلیل واریانس چند متغیره یا Manova(2)
بعد از بیان پیش فرض ها باید بیان کنیم که گاه محققین سوال می کنند که چرا بجای استفاده از MANOVA که آزمون دشواری می باشد، به طور جداگانه چند بار از تحلیل واریانس یک طرفه یا ANOVA برای یک یک متغیرها نمی کنیم. جواب دوستان در این است که آزمون MANOVA دو کار اصلی را انجام می دهد:
1. یکی از وظایف این آزمون این است که درست مثل ANOVA هر متغیر کمی(هر یک از مولفه های تعهد سازمانی) را بطور جداگانه در هر یک از گروه های متغیر های کیفی مقایسه میانگین کند.
2. اما وظیفه اصلی این آزمون این است که بطور همزمان بیان کند که کل این سه مولفه که مجموعا سازه تعهد سازمانی را می سازند بصورت یکجا آیا در بین گروه های مستقل متغیر های کیفی تفاوت میانگین دارد یا خیر؟ این سوال پاسخی می خواهد که توان آن را آزمونANOVA ندارد.بنابراین پاسخ به فرضیات اصلی که در ذیل آورده شده وظیفه اصلی آزمون MANOVA است.
پس در این آزمون این فرضیات تست می شود:
• تعهد سازمانی در بین کارکنان مالی، بازاریابی و تولید شرکت تفاوت دارد.(فرضیه اصلی)
• تعهد سازمانی در بین کارکنان لیسانس، فوق لیسانس و دکتری بخش های سه گانه شرکت تفاوت دارد.(فرضیه اصلی)
• تعهد عاطفی در بین کارکنان مالی، بازاریابی و تولید شرکت تفاوت دارد.
• تعهد عاطفی در بین کارکنان لیسانس، فوق لیسانس و دکتری بخش های سه گانه شرکت تفاوت دارد.
• تعهد هنجاری در بین کارکنان مالی، بازاریابی و تولید شرکت تفاوت دارد.
• تعهد هنجاری در بین کارکنان لیسانس، فوق لیسانس و دکتری بخش های سه گانه شرکت تفاوت دارد.
• تعهد مستمر در بین کارکنان مالی، بازاریابی و تولید شرکت تفاوت دارد.
• تعهد مستمر در بین کارکنان لیسانس، فوق لیسانس و دکتری بخش های سه گانه شرکت تفاوت دارد.
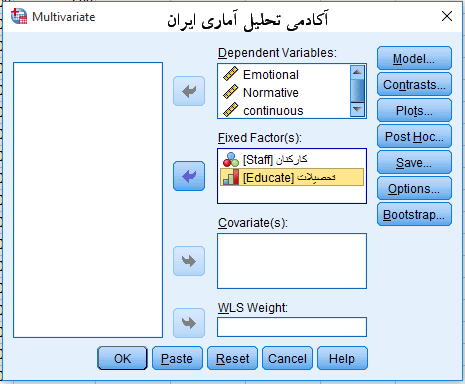
همانطور که در شکل زیر می بینید داده های سه مولفه ی کمی تعهد سازمانی و دو متغیر کیفی کارکنان بخش ها و تحصیلات کارکنان در فایلSPSS وارد شده است. نحوه اجرای دستور آزمون MANOVA در نرم افزار SPSS به صورت زیر است:
برای مطالعه ادامه مطلب روی لینک زیر کلیک کنید:
http://analysisacademy.com/5154/manova.html
http://analysisacademy.com/wp-content/uploads/2017/02/MAN1.png
تحلیل واریانس چند متغیره یا Manova(2)
بعد از بیان پیش فرض ها باید بیان کنیم که گاه محققین سوال می کنند که چرا بجای استفاده از MANOVA که آزمون دشواری می باشد، به طور جداگانه چند بار از تحلیل واریانس یک طرفه یا ANOVA برای یک یک متغیرها نمی کنیم. جواب دوستان در این است که آزمون MANOVA دو کار اصلی را انجام می دهد:
1. یکی از وظایف این آزمون این است که درست مثل ANOVA هر متغیر کمی(هر یک از مولفه های تعهد سازمانی) را بطور جداگانه در هر یک از گروه های متغیر های کیفی مقایسه میانگین کند.
2. اما وظیفه اصلی این آزمون این است که بطور همزمان بیان کند که کل این سه مولفه که مجموعا سازه تعهد سازمانی را می سازند بصورت یکجا آیا در بین گروه های مستقل متغیر های کیفی تفاوت میانگین دارد یا خیر؟ این سوال پاسخی می خواهد که توان آن را آزمونANOVA ندارد.بنابراین پاسخ به فرضیات اصلی که در ذیل آورده شده وظیفه اصلی آزمون MANOVA است.
پس در این آزمون این فرضیات تست می شود:
• تعهد سازمانی در بین کارکنان مالی، بازاریابی و تولید شرکت تفاوت دارد.(فرضیه اصلی)
• تعهد سازمانی در بین کارکنان لیسانس، فوق لیسانس و دکتری بخش های سه گانه شرکت تفاوت دارد.(فرضیه اصلی)
• تعهد عاطفی در بین کارکنان مالی، بازاریابی و تولید شرکت تفاوت دارد.
• تعهد عاطفی در بین کارکنان لیسانس، فوق لیسانس و دکتری بخش های سه گانه شرکت تفاوت دارد.
• تعهد هنجاری در بین کارکنان مالی، بازاریابی و تولید شرکت تفاوت دارد.
• تعهد هنجاری در بین کارکنان لیسانس، فوق لیسانس و دکتری بخش های سه گانه شرکت تفاوت دارد.
• تعهد مستمر در بین کارکنان مالی، بازاریابی و تولید شرکت تفاوت دارد.
• تعهد مستمر در بین کارکنان لیسانس، فوق لیسانس و دکتری بخش های سه گانه شرکت تفاوت دارد.
همانطور که در شکل زیر می بینید داده های سه مولفه ی کمی تعهد سازمانی و دو متغیر کیفی کارکنان بخش ها و تحصیلات کارکنان در فایلSPSS وارد شده است. نحوه اجرای دستور آزمون MANOVA در نرم افزار SPSS به صورت زیر است:
برای مطالعه ادامه مطلب روی لینک زیر کلیک کنید:
http://analysisacademy.com/5154/manova.html
http://analysisacademy.com/wp-content/uploads/2017/02/photofeb2017.jpg
@analysisacademy
کارگاه های صفرتا صد لیزرل، ایموس، اسمارت پی ال اس و اس پی اس اس آکادمی تحلیل آماری ایران در بهمن و اسفند ۱۳۹۵:
کارگاه آموزشی: کارگاه آموزشی ۴۰ساعته مقدماتی تا پیشرفته spss(اس پی اس اس) با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی ازانگلستان
زمان: پنجشنبه و جمعه مصادف با ۵ و ۶ اسفند ماه ۱۳۹۵ و چهارشنبه، پنجشنبه و جمعه مصادف با ۱۱ و ۱۲ و ۱۳ اسفندماه ۱۳۹۵ از ساعت ۱۳ تا ۲۱
هزینه ثبت نام شرکت کنندگان آزاد :550 هزار تومان
هزینه ثبت نام دانشجویی 450هزار تومان
مدرس:دکتر محسن مرادی
محل تشکیل:آکادمی تحلیل آماری ایران
کارگاه آموزشی کاربردی مهارتی و تضمینی می باشد و نحوه نوشتن فصل سوم و چهارم و نیز تحلیل آماری مقالات به صورت کامل آموزش داده می شود.
رزرو و مشاوره رایگان توسط خانم دکتر میرالماسی: 09100071804
فرم ثبت نام کارگاه
کارگاه آموزشی: کارگاه آموزشی ۲۴ساعته صفر تا صد لیزرل(LISREL) و ایموس(AMOS)با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی ازانگلستان
زمان:چهارشنبه ،پنجشنبه وجمعه مصادف با ۱۸ و ۱۹ و ۲۰اسفند ماه ۱۳۹۵ از ساعت ۱۳ تا ۲۱
هزینه ثبت نام شرکت کنندگان آزاد 350 هزار تومان
هزینه ثبت نام دانشجویی 300هزار تومان
مدرس:دکتر محسن مرادی
محل تشکیل:آکادمی تحلیل آماری ایران
کارگاه آموزشی کاربردی مهارتی و تضمینی می باشد و نحوه نوشتن فصل سوم و چهارم و نیز تحلیل آماری مقالات به صورت کامل آموزش داده می شود.
رزرو و مشاوره رایگان توسط خانم دکتر میرالماسی: 09100071804
فرم ثبت نام کارگاه
سرفصل های دوره های معادلات ساختاری(لیزرل، ایموس و اسمارت پی ال اس):
–نحوه نوشتن پروپوزال یا طرح تحقیق برای پایان نامه ها و مقالات علمی و پژوهشی مبتنی بر SEM
–آشنایی کامل با مدلسازی معادلات ساختاری
–جمع آوری داده ها و نحوه پیش پردازش داده ها به صورت عملیاتی
–نحوه ایجاد Path Diagrams در محیط نرم افزارها
–تحلیل عاملی تاییدی CFAو سنجش برازش CFA
–بررسی پایایی و روایی سازه
–اجرای مدل ساختاری و ارزیابی و تحلیل نتایج
–اجرای تحلیل عاملی مرتبه دوم پیرامون متغییرهایی با مولفه های مختلف
–اجرا و تحلیل مدلهای ساختاری با متغییرهای میانجی
–اجرا و تحلیل مدلهایی با متغییرهای تعدیل گر در روش های مختلف
–نحوه تهیه گزارش نهایی و تفسیر آن برای پایان نامه ها و مقالات علمی و پژوهشی و ISI
و…
سرفصل های spss:
دوره spssاز معرفی نرم افزار و نحوه کار با آن آغاز می شود، سپس نحوه پیش پردازش داده ها تدریس می شود. بعد از آن کلیه مباحث آمار توصیفی و رسم انواع نمودارهای مختلف گفته می شود، پس از آن در آمار استنباطی با بیان روش تحقیق هر یک از انواع فرضیات مقایسه ایی، رابطه ایی و علی وارد آزمونهای پارامتریک و ناپارامتریک آنها می شویم. قابل ذکر است که دوره spssاین موسسه شامل مطالب و عناوینی است که در هیچ یک از دوره های آموزشی و کتابهای فارسی موجود نمی باشد و در نهایت در این دوره مبحث ویژه ای تحت عنوان ارائه مدل از مصاحبه ها و روشهای کیفی دیگر بیان می شود که تمامی دانشجویان ارشد و دکتری هیچ منبع نوشتاری و شفاهی برای آن ندارند و یکی از مشکلات فضای تحقیقاتی کشور همین مورد محسوب می شود.
در نهایت دوره spssتوانایی انجام تحلیل آماری همه تحقیقاتی را که با این نرم افزار انجام می شود را به دانشجویان و محققین عزیز می دهد.
مدرس: دکتر محسن مرادی
رزرو و مشاوره رایگان توسط خانم دکتر میرالماسی: ۰۹۱۰۰۰۷۱۸۰۴
جهت مشاوره رایگان کارگاه با شماره بالا تماس گیرید
http://analysisacademy.com
@analysisacademy
کارگاه های صفرتا صد لیزرل، ایموس، اسمارت پی ال اس و اس پی اس اس آکادمی تحلیل آماری ایران در بهمن و اسفند ۱۳۹۵:
کارگاه آموزشی: کارگاه آموزشی ۴۰ساعته مقدماتی تا پیشرفته spss(اس پی اس اس) با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی ازانگلستان
زمان: پنجشنبه و جمعه مصادف با ۵ و ۶ اسفند ماه ۱۳۹۵ و چهارشنبه، پنجشنبه و جمعه مصادف با ۱۱ و ۱۲ و ۱۳ اسفندماه ۱۳۹۵ از ساعت ۱۳ تا ۲۱
هزینه ثبت نام شرکت کنندگان آزاد :550 هزار تومان
هزینه ثبت نام دانشجویی 450هزار تومان
مدرس:دکتر محسن مرادی
محل تشکیل:آکادمی تحلیل آماری ایران
کارگاه آموزشی کاربردی مهارتی و تضمینی می باشد و نحوه نوشتن فصل سوم و چهارم و نیز تحلیل آماری مقالات به صورت کامل آموزش داده می شود.
رزرو و مشاوره رایگان توسط خانم دکتر میرالماسی: 09100071804
فرم ثبت نام کارگاه
کارگاه آموزشی: کارگاه آموزشی ۲۴ساعته صفر تا صد لیزرل(LISREL) و ایموس(AMOS)با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی ازانگلستان
زمان:چهارشنبه ،پنجشنبه وجمعه مصادف با ۱۸ و ۱۹ و ۲۰اسفند ماه ۱۳۹۵ از ساعت ۱۳ تا ۲۱
هزینه ثبت نام شرکت کنندگان آزاد 350 هزار تومان
هزینه ثبت نام دانشجویی 300هزار تومان
مدرس:دکتر محسن مرادی
محل تشکیل:آکادمی تحلیل آماری ایران
کارگاه آموزشی کاربردی مهارتی و تضمینی می باشد و نحوه نوشتن فصل سوم و چهارم و نیز تحلیل آماری مقالات به صورت کامل آموزش داده می شود.
رزرو و مشاوره رایگان توسط خانم دکتر میرالماسی: 09100071804
فرم ثبت نام کارگاه
سرفصل های دوره های معادلات ساختاری(لیزرل، ایموس و اسمارت پی ال اس):
–نحوه نوشتن پروپوزال یا طرح تحقیق برای پایان نامه ها و مقالات علمی و پژوهشی مبتنی بر SEM
–آشنایی کامل با مدلسازی معادلات ساختاری
–جمع آوری داده ها و نحوه پیش پردازش داده ها به صورت عملیاتی
–نحوه ایجاد Path Diagrams در محیط نرم افزارها
–تحلیل عاملی تاییدی CFAو سنجش برازش CFA
–بررسی پایایی و روایی سازه
–اجرای مدل ساختاری و ارزیابی و تحلیل نتایج
–اجرای تحلیل عاملی مرتبه دوم پیرامون متغییرهایی با مولفه های مختلف
–اجرا و تحلیل مدلهای ساختاری با متغییرهای میانجی
–اجرا و تحلیل مدلهایی با متغییرهای تعدیل گر در روش های مختلف
–نحوه تهیه گزارش نهایی و تفسیر آن برای پایان نامه ها و مقالات علمی و پژوهشی و ISI
و…
سرفصل های spss:
دوره spssاز معرفی نرم افزار و نحوه کار با آن آغاز می شود، سپس نحوه پیش پردازش داده ها تدریس می شود. بعد از آن کلیه مباحث آمار توصیفی و رسم انواع نمودارهای مختلف گفته می شود، پس از آن در آمار استنباطی با بیان روش تحقیق هر یک از انواع فرضیات مقایسه ایی، رابطه ایی و علی وارد آزمونهای پارامتریک و ناپارامتریک آنها می شویم. قابل ذکر است که دوره spssاین موسسه شامل مطالب و عناوینی است که در هیچ یک از دوره های آموزشی و کتابهای فارسی موجود نمی باشد و در نهایت در این دوره مبحث ویژه ای تحت عنوان ارائه مدل از مصاحبه ها و روشهای کیفی دیگر بیان می شود که تمامی دانشجویان ارشد و دکتری هیچ منبع نوشتاری و شفاهی برای آن ندارند و یکی از مشکلات فضای تحقیقاتی کشور همین مورد محسوب می شود.
در نهایت دوره spssتوانایی انجام تحلیل آماری همه تحقیقاتی را که با این نرم افزار انجام می شود را به دانشجویان و محققین عزیز می دهد.
مدرس: دکتر محسن مرادی
رزرو و مشاوره رایگان توسط خانم دکتر میرالماسی: ۰۹۱۰۰۰۷۱۸۰۴
جهت مشاوره رایگان کارگاه با شماره بالا تماس گیرید
http://analysisacademy.com

This media is not supported in your browser
VIEW IN TELEGRAM
کارگاه اسمارت پی ال اس ۲۱ بهمن ۱۳۹۵
آکادمی تحلیل آماری ایران
آکادمی تحلیل آماری ایران
کارگاه های اسفندماه اکادمی تحلیل اماری ایران
۱.دوره ۴۰ ساعته مقدماتی تا پیشرفته اس پی اس اس با رویکرد نگارش پایان نامه تاریخهای ۵ و ۶و ۱۱و۱۲و ۱۳ اسفند از ساعت۱۳ تا ۲۱ به مبلغ ۴۵۰ هزارتومان ثبت نام دانشجویی و ۵۵۰ هزار تومان ثبت نام ازاد
۲.دوره ۲۴ ساعته لیزرل و ایموس با رویکرد نگارش پایان نامه روزهای ۱۸ و ۱۹ و ۲۰ اسفند از ساعت ۱۳ تا ۲۱ به مبلغ دانشجویی ۳۵۰ هزار تومان و مبلع ازاد ۴۰۰ هزار تومان
لطفا جهت رزرو نام و نام خانوادگی و نام دوره نظرتون به ۰۹۱۰۰۰۷۱۸۰۴ ارسال فرمایید
۱.دوره ۴۰ ساعته مقدماتی تا پیشرفته اس پی اس اس با رویکرد نگارش پایان نامه تاریخهای ۵ و ۶و ۱۱و۱۲و ۱۳ اسفند از ساعت۱۳ تا ۲۱ به مبلغ ۴۵۰ هزارتومان ثبت نام دانشجویی و ۵۵۰ هزار تومان ثبت نام ازاد
۲.دوره ۲۴ ساعته لیزرل و ایموس با رویکرد نگارش پایان نامه روزهای ۱۸ و ۱۹ و ۲۰ اسفند از ساعت ۱۳ تا ۲۱ به مبلغ دانشجویی ۳۵۰ هزار تومان و مبلع ازاد ۴۰۰ هزار تومان
لطفا جهت رزرو نام و نام خانوادگی و نام دوره نظرتون به ۰۹۱۰۰۰۷۱۸۰۴ ارسال فرمایید
http://analysisacademy.com/wp-content/uploads/2017/02/4.png
@analysisacademy
قدرت پیش بینی کننده مدل معادلات ساختاری بر اساس حجم نمونه
از آنجا كه روش شناسي مدليابي معادلات ساختاري، تا حدود زيادي با برخي از جنبه هاي رگرسيون چند متغيري شباهت دارد، مي توان از اصول تعيين حجم نمونه در تحليل رگرسيون چند متغيري براي تعيين حجم نمونه در مدليابي معادلات ساختاري استفاده نمود( هومن، ۱۳۸۴، ۲۲).در تحليل رگرسيون چند متغيري نسبت تعداد نمونه ( مشاهدات) به متغيرهاي مستقل نبايد از ۵ كمتر باشد. در غير اينصورت نتايج حاصل از معادله رگرسيون چندان تعميم پذير نخواهد بود (هيرو و همكاران ،۱۹۹۵، ۱۰۵). نسبت محافظه كارانه تر ۱۰ مشاهده به ازاي هر متغير مستقل را هالينسكي و فلورت( ۱۹۷۰) و ميلر و كانس(۱۹۷۳) پيشنهاد نموده اند. از ديدگاه جيمز استيونس حتي در نظر گرفتن ۱۵ مشاهده به ازاي هر متغير پيش بين در تحليل رگرسيون چند گانه با روش معمولي كمترين مجذورات استاندارد ، يك قاعده سر انگشتي خوب به حساب ميآيد ( هومن، ۱۳۸۴، ۲۲).
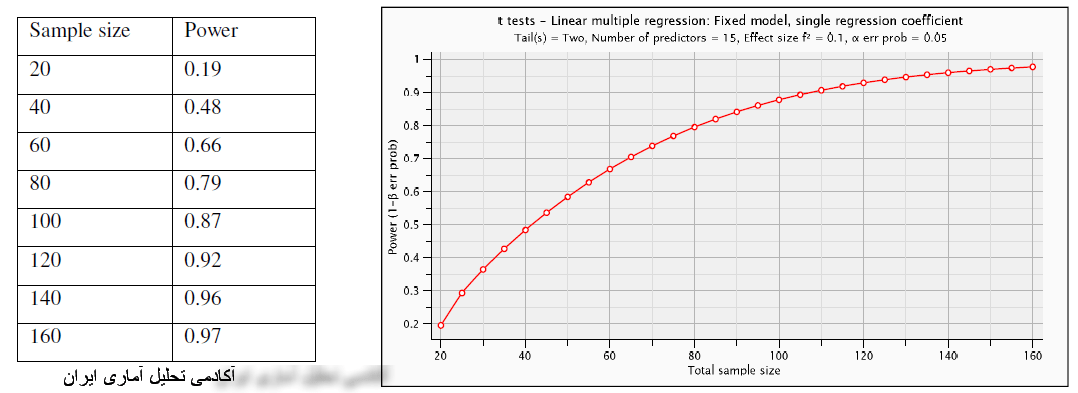
در هر حال قدرت پیش بینی مدل بر اساس حجم نمونه متفاوت است. با توجه به نمودار زیر و جدول مقابل آن ، می توان قدرت پیش بینی کنند گی مدل را در مدل سازی معادلات ساختاری، خصوصا رویکرد واریانس محور را دریافت.
@analysisacademy
قدرت پیش بینی کننده مدل معادلات ساختاری بر اساس حجم نمونه
از آنجا كه روش شناسي مدليابي معادلات ساختاري، تا حدود زيادي با برخي از جنبه هاي رگرسيون چند متغيري شباهت دارد، مي توان از اصول تعيين حجم نمونه در تحليل رگرسيون چند متغيري براي تعيين حجم نمونه در مدليابي معادلات ساختاري استفاده نمود( هومن، ۱۳۸۴، ۲۲).در تحليل رگرسيون چند متغيري نسبت تعداد نمونه ( مشاهدات) به متغيرهاي مستقل نبايد از ۵ كمتر باشد. در غير اينصورت نتايج حاصل از معادله رگرسيون چندان تعميم پذير نخواهد بود (هيرو و همكاران ،۱۹۹۵، ۱۰۵). نسبت محافظه كارانه تر ۱۰ مشاهده به ازاي هر متغير مستقل را هالينسكي و فلورت( ۱۹۷۰) و ميلر و كانس(۱۹۷۳) پيشنهاد نموده اند. از ديدگاه جيمز استيونس حتي در نظر گرفتن ۱۵ مشاهده به ازاي هر متغير پيش بين در تحليل رگرسيون چند گانه با روش معمولي كمترين مجذورات استاندارد ، يك قاعده سر انگشتي خوب به حساب ميآيد ( هومن، ۱۳۸۴، ۲۲).
در هر حال قدرت پیش بینی مدل بر اساس حجم نمونه متفاوت است. با توجه به نمودار زیر و جدول مقابل آن ، می توان قدرت پیش بینی کنند گی مدل را در مدل سازی معادلات ساختاری، خصوصا رویکرد واریانس محور را دریافت.
http://analysisacademy.com/wp-content/uploads/2017/02/NON.png
@analysisacademy
مدل های بازگشتی یا دارای تاثیر متقابل در ایموس
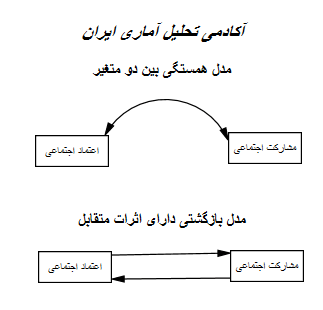
بارها این سوال در کلاس های آکادمی تحلیل آماری پرسیده شده است که آیا در یک مدل ساختاری دو متغیر میتوانند بر یکدیگر تاثیر متقابل بگذارند. به دو شکل زیر توجه شود که مبادا این دو مدل با یکدیگر اشتباه گرفته شود.
مدل اول یک همبستگی ساده را بین دو متغیر نشان می دهد اما مدل دوم کاملا وضعیتی متفاوت است و می بینیم که دو متغیر اعتماد اجتماعی و مشارکت اجتماعی مدلی را تدوین کرده اند که در آن هم اعتماد اجتماعی بر مشارکت اجتماعی تاثیر می گذارد و هم در سوی دیگر مشارکت اجتماعی بر اعتماد اجتماعی تاثیر می گذارد. هرگز این پدیده با شکا اول که یک رابطه ی هم بستگی است نباید اشتباه گرفته شود. در حقیقت در اینجا ما بر خلاف شکل اول یک تاثیر متقابل داریم و به گونه ای یک حلقه ایجاد شده است. چنین مدل های ساختاری با این شکل تدوین مدل را مدل های بازگشتی (recursive model) می خوانند.
در واقع در مدل های ساختاری گاهی ما شاهد اثرات متقابل یا دو سویه هستیم و محققین نشان داده اند که چنین مفروضه هایی به لحاظ روش پژوهش امکان پذیر است.
اما باید دید از لحاظ نرم افزاری دوستانی که در کلاس های ایموس آکادمی شرکت نموده اند در مواجهه با چنین روابط بازگشتی چگونه باید عمل کنند.
اولا باید بدانند که در رسم شکل این نوع مدل ها در ایموس باید دو پیکان رسم نمایند. یعنی یک پیکان یک طرفه از سمت متغیر اول به دوم و بعد یک پیکان یک طرفه هم از سمت متغیر دوم به اول. خوب تا اینجای کار بدون ایراد جلو می رود اما نکته مهم اینجاست که در مدل های بازگشتی با این تاثیر های متقابل، به طور ضمنی خطاهای هر متغیر(هر متغیر وابسته یک خطای باقی مانده دارد. پس در اینگونه مدل ها، هر دو متغیر دارای خطا هستند زیرا هر دو هم زمان هم مستقل و هم وابسته هستند) با یکدیگر همبسته هستند. چرا که وقتی دو متغیر بر هم تاثیر متقابل گذارند بدیهی است که متغیر های باقی مانده ی در نظر گرفته نشده در مدل، که در کلاس ها خطای باقی مانده خوانده می شد باید با هم همبستگی داشته باشند. بنابراین مدل را بدرستی ترسیم و اجرا می کنیم.(مرادی، ۱۳۹۵)
تکته نهایی اینکه در کتاب کلاین ۲۰۰۵ که در سایت برای دانلود قرار داده شده و یکی از کتاب های مرجه مدل سازی معادلات ساختاری است بیان شده است که اتفاقا مدل های بازگشتی به جهان واقعی نزدیک تر هستند چرا که بسیاری از متغیر های جهان بر یکدیگر تاثیر متقابل و دو سویه دارند اما در نهایت به دلیل اینکه اطلاعات و مشاهدات چنین مدل هایی را باید از مطالعات پیمایشی طولی بدست آورد و همچنین بدلیل اینکه ممکن است تعداد مجهولات معادله ساختاری از تعداد معادلات آن بیشتر باشد و این باعث غیر مشخص شدن پارامتر های مدل شود محققین تمایلی به استفاده از چنین مدل هایی را ندارند(کلاین، ۲۰۰۵).
محسن مرادی
از استفاده مطالب بدون ذکر منبع سایت خودداری شود.
@analysisacademy
مدل های بازگشتی یا دارای تاثیر متقابل در ایموس
بارها این سوال در کلاس های آکادمی تحلیل آماری پرسیده شده است که آیا در یک مدل ساختاری دو متغیر میتوانند بر یکدیگر تاثیر متقابل بگذارند. به دو شکل زیر توجه شود که مبادا این دو مدل با یکدیگر اشتباه گرفته شود.
مدل اول یک همبستگی ساده را بین دو متغیر نشان می دهد اما مدل دوم کاملا وضعیتی متفاوت است و می بینیم که دو متغیر اعتماد اجتماعی و مشارکت اجتماعی مدلی را تدوین کرده اند که در آن هم اعتماد اجتماعی بر مشارکت اجتماعی تاثیر می گذارد و هم در سوی دیگر مشارکت اجتماعی بر اعتماد اجتماعی تاثیر می گذارد. هرگز این پدیده با شکا اول که یک رابطه ی هم بستگی است نباید اشتباه گرفته شود. در حقیقت در اینجا ما بر خلاف شکل اول یک تاثیر متقابل داریم و به گونه ای یک حلقه ایجاد شده است. چنین مدل های ساختاری با این شکل تدوین مدل را مدل های بازگشتی (recursive model) می خوانند.
در واقع در مدل های ساختاری گاهی ما شاهد اثرات متقابل یا دو سویه هستیم و محققین نشان داده اند که چنین مفروضه هایی به لحاظ روش پژوهش امکان پذیر است.
اما باید دید از لحاظ نرم افزاری دوستانی که در کلاس های ایموس آکادمی شرکت نموده اند در مواجهه با چنین روابط بازگشتی چگونه باید عمل کنند.
اولا باید بدانند که در رسم شکل این نوع مدل ها در ایموس باید دو پیکان رسم نمایند. یعنی یک پیکان یک طرفه از سمت متغیر اول به دوم و بعد یک پیکان یک طرفه هم از سمت متغیر دوم به اول. خوب تا اینجای کار بدون ایراد جلو می رود اما نکته مهم اینجاست که در مدل های بازگشتی با این تاثیر های متقابل، به طور ضمنی خطاهای هر متغیر(هر متغیر وابسته یک خطای باقی مانده دارد. پس در اینگونه مدل ها، هر دو متغیر دارای خطا هستند زیرا هر دو هم زمان هم مستقل و هم وابسته هستند) با یکدیگر همبسته هستند. چرا که وقتی دو متغیر بر هم تاثیر متقابل گذارند بدیهی است که متغیر های باقی مانده ی در نظر گرفته نشده در مدل، که در کلاس ها خطای باقی مانده خوانده می شد باید با هم همبستگی داشته باشند. بنابراین مدل را بدرستی ترسیم و اجرا می کنیم.(مرادی، ۱۳۹۵)
تکته نهایی اینکه در کتاب کلاین ۲۰۰۵ که در سایت برای دانلود قرار داده شده و یکی از کتاب های مرجه مدل سازی معادلات ساختاری است بیان شده است که اتفاقا مدل های بازگشتی به جهان واقعی نزدیک تر هستند چرا که بسیاری از متغیر های جهان بر یکدیگر تاثیر متقابل و دو سویه دارند اما در نهایت به دلیل اینکه اطلاعات و مشاهدات چنین مدل هایی را باید از مطالعات پیمایشی طولی بدست آورد و همچنین بدلیل اینکه ممکن است تعداد مجهولات معادله ساختاری از تعداد معادلات آن بیشتر باشد و این باعث غیر مشخص شدن پارامتر های مدل شود محققین تمایلی به استفاده از چنین مدل هایی را ندارند(کلاین، ۲۰۰۵).
محسن مرادی
از استفاده مطالب بدون ذکر منبع سایت خودداری شود.
http://analysisacademy.com/wp-content/uploads/2017/02/database-isi.jpg
@analysisacademy
معرفی چند پایگاه علمی جهت جستجوی مقاله بیس:
اکثر افرادی که در کلاسهای آکادمی تحلیل آماری ایران حضور می یابند پس از درک اهمیت مقاله های بیس دارای ویژگیهای مورد تاکید دکتر مرادی همواره این سوال را داشته اند که با توجه به رشته های تحصیلی خود در کدام پایگاههای علمی به جستجو مقاله بیس مناسب برای پایان نامه ارشد یا دکتری خود بپردازند لذا در این بخش به توصیف برخی از این پایگاههای علمی به شکل خلاصه پرداختیم:
• پایگاه Elsevier الزویر برای کلیه رشته ها
پایگاه بزرگ Elsevier یکی از مهمترین پایگاه های نشر منابع دیجیتالی در حوزه های مختلف علوم است. دفتر اصلی این ناشر در کشور هلند قرار دارد. در پایگاه الزوير حدود 2200 مجله علمی در شاخه های مختلف علوم نمایه شده است. همچنین بیش از 25000 عنوان کتاب در این پایگاه قرار دارد. این پایگاه سرویس های مبتنی بر وب متنوعی را ارائه می دهد که مهمترین آنها عبارتند از Scopus (اسکوپوس) و Science Direct ساینس دایرکت.
• پایگاه Springer اشپرینگر برای کلیه رشته ها
این پایگاه پس از Elsevier بزرگترین پایگاه علمی در جهان است که دفتر مرکزی آن در کشور آلمان قرار دارد. این پایگاه نیز دارای 1900 مجله علمی نمایه شده و 110000 عنوان کتاب در 26 شاخه مختلف علمی است.
• پایگاه Wiley وایلی برای علوم پایه
دفتر مرکزی این پایگاه در کشور ایالات متحده و در ایالت نیوجرسی واقع است. انتشارات Wiley در سال 2010 میلادی با راه اندازی سرویس مبتنی بر وب خود با عنوان Online Library تعداد 1500 عنوان مجله علمی را نمایه نموده است. همچنین حدود 14000 عنوان کتاب نیز از منابع الکترونیکی و آنلاین این پایگاه به شمار می رود. منابع این پایگاه شاخه های مختلف علوم (فنی، پزشکی و...) را شامل می شود.
• پایگاه Cabi کابی برای کشاورزی
دفتر مرکزی این موسسه در کشور انگلستان و در شهر آکسفور قرار دارد. این پایگاه معتبرترین پایگاه علمی در موضوع علوم کشاورزی (مهندسی کشاورزی و اقتصاد کشاورزی)، علوم دامی، بیوتکنولوژی و بهداشت و سلامت جهانی است. در این پایگاه حدود 187000 مقاله در زمینه های یاد شده نمایه شده است. همچنین این پایگاه امکان دسترسی به 10 میلیون چکیده مقاله را در موضوعات گفته شده فراهم می سازد.
• پایگاه Ebsco ابسکو برای کلیه رشته ها
پايگاه اطلاعاتي ابسكو دسترسي به اطلاعات بيش از 10000 هزار نشريه تمام متن به همراه خلاصه و نمايه بيش از 40000 هزار نشريه مختلف علمي را در حوزههاي علوم اجتماعي، علوم انساني، آموزش و پرورش، کامپيوتر، مهندسي، تجارت، مديريت، اقتصاد، مالي، حسابداري، تجارت بينالملل، هوش مصنوعي، کشاورزي، و ... را مهيا ساخته است.
• پایگاه ACS آ سی اس برای رشته شیمی
انجمن شیمی ایالات متحده یکی از معتبرترین انجمن های علمی در علم شیمی است که 64 مجله علمی را نمایه می کند. 163 هزار محقق در علم شیمی از سراسر جهان عضو این انجمن هستند.
• پایگاه IEEE آی تریپل ای برای رشته های برق،الکترونیک، کامپیوتر
این موسسه در سال 1884 میلادی در ایالات متحده بوجود آمد. موسسه مهندسان برق و الکترونیک (IEEE) دارای سرویس مبتنی بر وب به نام "Xplore" است که در آن 160 مجله علمی در حوزه برق، الکترونیک و کامپیوتر نمایه می شود. در این پایگاه همچنین مقالات بیش از 1200 کنفرانس بین المللی نمایه می شود. ماهیانه حدود 25000 مقاله به مقالات این پایگاه اضافه می شود.
• پایگاه اطلاعاتی اریک ( ERIC)مرکز اطلاعات منابع آموزشی
اریک مركز منابع اطلاعات علمي و آموزش و پروش مي باشد و نيز يك كتابخانه ديجيتالي آنلاين با اطلاعات گسترده علمي و پژوهشي اين پايگاه امكان دستيابي به اطلاعات را جهت پشتيباني و استفاده از پژوهش ها و در آموزش، تدريس و پژوهش را فراهم مي كند.
@analysisacademy
معرفی چند پایگاه علمی جهت جستجوی مقاله بیس:
اکثر افرادی که در کلاسهای آکادمی تحلیل آماری ایران حضور می یابند پس از درک اهمیت مقاله های بیس دارای ویژگیهای مورد تاکید دکتر مرادی همواره این سوال را داشته اند که با توجه به رشته های تحصیلی خود در کدام پایگاههای علمی به جستجو مقاله بیس مناسب برای پایان نامه ارشد یا دکتری خود بپردازند لذا در این بخش به توصیف برخی از این پایگاههای علمی به شکل خلاصه پرداختیم:
• پایگاه Elsevier الزویر برای کلیه رشته ها
پایگاه بزرگ Elsevier یکی از مهمترین پایگاه های نشر منابع دیجیتالی در حوزه های مختلف علوم است. دفتر اصلی این ناشر در کشور هلند قرار دارد. در پایگاه الزوير حدود 2200 مجله علمی در شاخه های مختلف علوم نمایه شده است. همچنین بیش از 25000 عنوان کتاب در این پایگاه قرار دارد. این پایگاه سرویس های مبتنی بر وب متنوعی را ارائه می دهد که مهمترین آنها عبارتند از Scopus (اسکوپوس) و Science Direct ساینس دایرکت.
• پایگاه Springer اشپرینگر برای کلیه رشته ها
این پایگاه پس از Elsevier بزرگترین پایگاه علمی در جهان است که دفتر مرکزی آن در کشور آلمان قرار دارد. این پایگاه نیز دارای 1900 مجله علمی نمایه شده و 110000 عنوان کتاب در 26 شاخه مختلف علمی است.
• پایگاه Wiley وایلی برای علوم پایه
دفتر مرکزی این پایگاه در کشور ایالات متحده و در ایالت نیوجرسی واقع است. انتشارات Wiley در سال 2010 میلادی با راه اندازی سرویس مبتنی بر وب خود با عنوان Online Library تعداد 1500 عنوان مجله علمی را نمایه نموده است. همچنین حدود 14000 عنوان کتاب نیز از منابع الکترونیکی و آنلاین این پایگاه به شمار می رود. منابع این پایگاه شاخه های مختلف علوم (فنی، پزشکی و...) را شامل می شود.
• پایگاه Cabi کابی برای کشاورزی
دفتر مرکزی این موسسه در کشور انگلستان و در شهر آکسفور قرار دارد. این پایگاه معتبرترین پایگاه علمی در موضوع علوم کشاورزی (مهندسی کشاورزی و اقتصاد کشاورزی)، علوم دامی، بیوتکنولوژی و بهداشت و سلامت جهانی است. در این پایگاه حدود 187000 مقاله در زمینه های یاد شده نمایه شده است. همچنین این پایگاه امکان دسترسی به 10 میلیون چکیده مقاله را در موضوعات گفته شده فراهم می سازد.
• پایگاه Ebsco ابسکو برای کلیه رشته ها
پايگاه اطلاعاتي ابسكو دسترسي به اطلاعات بيش از 10000 هزار نشريه تمام متن به همراه خلاصه و نمايه بيش از 40000 هزار نشريه مختلف علمي را در حوزههاي علوم اجتماعي، علوم انساني، آموزش و پرورش، کامپيوتر، مهندسي، تجارت، مديريت، اقتصاد، مالي، حسابداري، تجارت بينالملل، هوش مصنوعي، کشاورزي، و ... را مهيا ساخته است.
• پایگاه ACS آ سی اس برای رشته شیمی
انجمن شیمی ایالات متحده یکی از معتبرترین انجمن های علمی در علم شیمی است که 64 مجله علمی را نمایه می کند. 163 هزار محقق در علم شیمی از سراسر جهان عضو این انجمن هستند.
• پایگاه IEEE آی تریپل ای برای رشته های برق،الکترونیک، کامپیوتر
این موسسه در سال 1884 میلادی در ایالات متحده بوجود آمد. موسسه مهندسان برق و الکترونیک (IEEE) دارای سرویس مبتنی بر وب به نام "Xplore" است که در آن 160 مجله علمی در حوزه برق، الکترونیک و کامپیوتر نمایه می شود. در این پایگاه همچنین مقالات بیش از 1200 کنفرانس بین المللی نمایه می شود. ماهیانه حدود 25000 مقاله به مقالات این پایگاه اضافه می شود.
• پایگاه اطلاعاتی اریک ( ERIC)مرکز اطلاعات منابع آموزشی
اریک مركز منابع اطلاعات علمي و آموزش و پروش مي باشد و نيز يك كتابخانه ديجيتالي آنلاين با اطلاعات گسترده علمي و پژوهشي اين پايگاه امكان دستيابي به اطلاعات را جهت پشتيباني و استفاده از پژوهش ها و در آموزش، تدريس و پژوهش را فراهم مي كند.

Forwarded from آکادمی تحلیل آماری ایران
کارگاه های اسفندماه اکادمی تحلیل اماری ایران
۱.دوره ۴۰ ساعته مقدماتی تا پیشرفته اس پی اس اس با رویکرد نگارش پایان نامه تاریخهای ۵ و ۶و ۱۱و۱۲و ۱۳ اسفند از ساعت۱۳ تا ۲۱ به مبلغ ۴۵۰ هزارتومان ثبت نام دانشجویی و ۵۵۰ هزار تومان ثبت نام ازاد
۲.دوره ۲۴ ساعته لیزرل و ایموس با رویکرد نگارش پایان نامه روزهای ۱۸ و ۱۹ و ۲۰ اسفند از ساعت ۱۳ تا ۲۱ به مبلغ دانشجویی ۳۵۰ هزار تومان و مبلع ازاد ۴۰۰ هزار تومان
لطفا جهت رزرو نام و نام خانوادگی و نام دوره نظرتون به ۰۹۱۰۰۰۷۱۸۰۴ ارسال فرمایید
۱.دوره ۴۰ ساعته مقدماتی تا پیشرفته اس پی اس اس با رویکرد نگارش پایان نامه تاریخهای ۵ و ۶و ۱۱و۱۲و ۱۳ اسفند از ساعت۱۳ تا ۲۱ به مبلغ ۴۵۰ هزارتومان ثبت نام دانشجویی و ۵۵۰ هزار تومان ثبت نام ازاد
۲.دوره ۲۴ ساعته لیزرل و ایموس با رویکرد نگارش پایان نامه روزهای ۱۸ و ۱۹ و ۲۰ اسفند از ساعت ۱۳ تا ۲۱ به مبلغ دانشجویی ۳۵۰ هزار تومان و مبلع ازاد ۴۰۰ هزار تومان
لطفا جهت رزرو نام و نام خانوادگی و نام دوره نظرتون به ۰۹۱۰۰۰۷۱۸۰۴ ارسال فرمایید
اکادمی تحلیل اماری ایران برگزار می کند دوره های ویژه پایان نامه نویسی فروردین ماه:
دوره صفر تا صد لیزرل ۶و ۷ فروردین هزینه دانشجویی ۲۰۰ هزار تومان
دوره صفر تا صد ایموس ۹ و ۱۰ فروردین هزینه دانشجویی ۲۰۰ هزار تومان ظرفیت محدود با اولویت واریز از امروز
رزروبا ارسال نام خانوادگی به ۰۹۱۰۰۰۷۱۸۰۴
دوره صفر تا صد لیزرل ۶و ۷ فروردین هزینه دانشجویی ۲۰۰ هزار تومان
دوره صفر تا صد ایموس ۹ و ۱۰ فروردین هزینه دانشجویی ۲۰۰ هزار تومان ظرفیت محدود با اولویت واریز از امروز
رزروبا ارسال نام خانوادگی به ۰۹۱۰۰۰۷۱۸۰۴