
http://analysisacademy.com/wp-content/uploads/2016/12/download2.jpg
@analysisacademy
طرح های تحقیق آمیخته اکتشافی
در دو دهه ی گذشته علاوه بر پارادایم مرسوم تحقیق (مبتنی بر اصالت تحصلی یا اثبات گرایی) استفاده از پارادایم های دیگری مورد توجه قرار گرفته است. به طوری که در حال حاضر برای شناسایی مسائل و مشکلات سیستم های اجتماعی-رفتاری به طور اعم، و محیط های آموزشی به طور اخص، استفاده از روش های مبتنی بر ترکیب پارادایم های تحقیق از اهمیت برخوردار شده است. زیرا به رغم ماهیت پیچیده این سیستم ها و محیط ها، نمی توان فقط به استفاده از یک روش (کمی یا کیفی) اکتفا کرد و به شناخت کافی نسبت به موقعیت های معین دست یافت. با توجه به این امر، برای پی بردن به مسایل نظام های آموزشی و کوشش در جهت حل آنها استفاده ترکیبی از روش های کمی و کیفی ضرورت یافته است. در راستای برآوردن این نیاز، در دهه ی اخیر استفاده از ترکیب روش های کمی و کیفی، تحت عنوان روش های تحقیق آمیخته، رایج شده است.
طرح های تحقیق آمیخته به سه بخش زیر دسته بندی می شوند:
الف-طرح های تحقیق آمیخته بهم تنیده
ب-طرح های تحقیق آمیخته تشریحی
ج-طرح های تحقیق آمیخته اکتشافی
در این بخش به بررسی طرح های تحقیق آمیخته اکتشافی می پردازیم:
در طرح های تحقیق آمیخته اکتشافی، پژوهشگر درصدد زمینه یابی"موقعیت نامعین" می باشد.برای این منظور ابتدا به گردآوری داده های کیفی می پردازد. انجام این مرحله او را به توصیف جنبه های بی شماری از پدیده هدایت می کند. با استفاده از این شناسایی اولیه امکان صورت بندی فرضیه هایی درباره بروز پدیده مورد مطالعه فراهم می شود. پس از آن در مرحله بعدی،پژوهشگر می تواند از طریق گردآوری داده های کمی، فرضیه ها را مورد آزمون قرار دهد.
بنابراین در این نوع طرح های تحقیق آمیخته، به داده های کیفی اهمیت بیشتری داده می شود. علاوه بر آن در توالی گردآوری داده ها ابتدا داده های کیفی و سپس داده های کمی گردآوری می شوند.بالاخره پژوهشگر بر مبنای یافته های حاصل از داده های کیفی سعی بر آن دارد که داده های کمی راگردآوری کند تا تعمیم پذیری یافته را میسر سازد.
به عنوان مثالی از کاربرد طرح تحقیق آمیخته اکتشافی می توان بررسی فرآیند اجرایی و عملکرد شوراهای تحقیقات آموزش و پرورش را موردنظر قرار داد. برای انجام این طرح در مرحله اول پژوهشگر می تواند با استفاده از روش تحقیق نظریه برخاسته از داده ها از میان شوراهای استانی، با نمونه گیری نظری تعدادی مناسب برای مثال ۱۰ شورا انتخاب کند و در هر شورا با سه نفر عضو و مجموعا با ۳۰ نفر عضو شورا به مصاحبه بپردازد. با تحلیل داده های گردآوری شده پژوهشگر می تواند فرآیند اجرایی و عملکرد شوراها را در رابطه با بافت سازمانی، جریان امور و تصمیم گیری نسبت به طرح های تحقیق تبیین کند.
پژوهشگر در مرحله دوم به گردآوری داده های کمی از اعضای شورا می پردازد. در این مرحله ضمن تعیین متغییرهای اصلی و تدوین ابزار گردآوری داده های کمی(پرسشنامه) و انتخاب نمونه ای تصادفی از میان شوراهای استانی تحقیقات آموزش و پرورش به گردآوری و تحلیل داده ها می پردازد. پس از آن پژوهشگر بر اساس نتایج به دست آمده امکان تعمیم یافته ها را فراهم می آورد.
@analysisacademy
طرح های تحقیق آمیخته اکتشافی
در دو دهه ی گذشته علاوه بر پارادایم مرسوم تحقیق (مبتنی بر اصالت تحصلی یا اثبات گرایی) استفاده از پارادایم های دیگری مورد توجه قرار گرفته است. به طوری که در حال حاضر برای شناسایی مسائل و مشکلات سیستم های اجتماعی-رفتاری به طور اعم، و محیط های آموزشی به طور اخص، استفاده از روش های مبتنی بر ترکیب پارادایم های تحقیق از اهمیت برخوردار شده است. زیرا به رغم ماهیت پیچیده این سیستم ها و محیط ها، نمی توان فقط به استفاده از یک روش (کمی یا کیفی) اکتفا کرد و به شناخت کافی نسبت به موقعیت های معین دست یافت. با توجه به این امر، برای پی بردن به مسایل نظام های آموزشی و کوشش در جهت حل آنها استفاده ترکیبی از روش های کمی و کیفی ضرورت یافته است. در راستای برآوردن این نیاز، در دهه ی اخیر استفاده از ترکیب روش های کمی و کیفی، تحت عنوان روش های تحقیق آمیخته، رایج شده است.
طرح های تحقیق آمیخته به سه بخش زیر دسته بندی می شوند:
الف-طرح های تحقیق آمیخته بهم تنیده
ب-طرح های تحقیق آمیخته تشریحی
ج-طرح های تحقیق آمیخته اکتشافی
در این بخش به بررسی طرح های تحقیق آمیخته اکتشافی می پردازیم:
در طرح های تحقیق آمیخته اکتشافی، پژوهشگر درصدد زمینه یابی"موقعیت نامعین" می باشد.برای این منظور ابتدا به گردآوری داده های کیفی می پردازد. انجام این مرحله او را به توصیف جنبه های بی شماری از پدیده هدایت می کند. با استفاده از این شناسایی اولیه امکان صورت بندی فرضیه هایی درباره بروز پدیده مورد مطالعه فراهم می شود. پس از آن در مرحله بعدی،پژوهشگر می تواند از طریق گردآوری داده های کمی، فرضیه ها را مورد آزمون قرار دهد.
بنابراین در این نوع طرح های تحقیق آمیخته، به داده های کیفی اهمیت بیشتری داده می شود. علاوه بر آن در توالی گردآوری داده ها ابتدا داده های کیفی و سپس داده های کمی گردآوری می شوند.بالاخره پژوهشگر بر مبنای یافته های حاصل از داده های کیفی سعی بر آن دارد که داده های کمی راگردآوری کند تا تعمیم پذیری یافته را میسر سازد.
به عنوان مثالی از کاربرد طرح تحقیق آمیخته اکتشافی می توان بررسی فرآیند اجرایی و عملکرد شوراهای تحقیقات آموزش و پرورش را موردنظر قرار داد. برای انجام این طرح در مرحله اول پژوهشگر می تواند با استفاده از روش تحقیق نظریه برخاسته از داده ها از میان شوراهای استانی، با نمونه گیری نظری تعدادی مناسب برای مثال ۱۰ شورا انتخاب کند و در هر شورا با سه نفر عضو و مجموعا با ۳۰ نفر عضو شورا به مصاحبه بپردازد. با تحلیل داده های گردآوری شده پژوهشگر می تواند فرآیند اجرایی و عملکرد شوراها را در رابطه با بافت سازمانی، جریان امور و تصمیم گیری نسبت به طرح های تحقیق تبیین کند.
پژوهشگر در مرحله دوم به گردآوری داده های کمی از اعضای شورا می پردازد. در این مرحله ضمن تعیین متغییرهای اصلی و تدوین ابزار گردآوری داده های کمی(پرسشنامه) و انتخاب نمونه ای تصادفی از میان شوراهای استانی تحقیقات آموزش و پرورش به گردآوری و تحلیل داده ها می پردازد. پس از آن پژوهشگر بر اساس نتایج به دست آمده امکان تعمیم یافته ها را فراهم می آورد.
http://analysisacademy.com/wp-content/uploads/2016/08/Search-Engine-Marketing-SEM.jpg
@analysisacademy
لزوم استفاده از مدلسازی معادلات ساختاری
استفاده از مدلسازی معادلات ساختاری در پژوهش های سالهای اخیر رو به افزایش بوده است. از دلایل تمایل دانشمندان در استفاده از این روش می توان به موارد زیر اشاره کرد:
شاید نخستین دلیل گرایش اندیشمندان در سالهای اخیر را بتوان سهولت استفاده از این ابزار دانست. تا دهه نود استفاده از این روش در یک پژوهش مستلزم مهارت بالایی در برنامه نویسی بود که خود هم استفاده از این روش را محدود می ساخت و هم مستلزم صرف وقت زیادی بود. در دو ذهه اخیر با ابداع برنامه های رایانه ای که به هیچ وجه پیچیدگی های گذشته را ندارند و همه آنها در محیط ویندوز قابل اجرا هستند استفاده از مدلسازی معادلات ساختاری گسترش زیادی یافته است.
@analysisacademy
دلیل دیگر استفاده از مدلسازی معادلات ساختاری به توانایی منحصر به فرد این روش در مقایسه با سایر روش های آماری برمی گردد. این روش توانایی آزمون یک مدل و نه تنها فرضیه های پژوهشی را دارد که با رویکرهای مرسوم آماری قابل انجام نیست. روش تحلیل مسیر، رگرسیون و تحلیل عاملی به دلیل محدودیتهای ذاتی شان ابزاری مناسب برای آزمون مدلهای علی و معلولی محسوب نمی شوند. به همین منظور مدلسازی معادلات ساختاری جایگزین مناسبی برای روش های مورد اشاره است.
@analysisacademy
دلیل دیگر استفاده از مدلسازی معادلات ساختاری در سالهای اخیر به توان این روش در آزمون نمونه های متفاوت پژوهشی برمی گردد. این روش توانایی آن را دارد که برای گروه های متفاوت آزمون های آماری را به مورد اجرا بگذارد. پژوهشی را درنظر آورید که در آن دو نمونه آماری مربوط به مردان و زنان مورد استفاده قرار گرفته است آزمون مدل پژوهشی برای هر یک از این گروهها قابلیتی است که مدلسازی معادلات ساختاری را از سایر روش های آماری متمایز می کند.
@analysisacademy
دلیل دیگر استفاده از مدلسازی معادلات ساختاری به واسطه اهمیت روزافزون اعتبار داده ها و اجتناب از خطاهای اندازه گیری در سالهای اخیر می باشد. همانطور که در کلاس های آموزشی آکادمی تحلیل آماری ایران همواره اشاره می گردد روش های مرسوم آماری که مستلزم میانگین گیری از شاخص ها هستند عملا خطاهای اندازه گیری هر یک از شاخص ها را نادیده می گیرند. مدلسازی معادلات ساختاری با معرفی مفهوم متغییر پنهان در مدل از این لحاظ در جایگاه ممتازی قرار دارد.
@analysisacademy
توانایی مدلسازی معادلات ساختاری در ترسیم شرایط و روابط پیچیده بین متغییرها یکی دیگر از علل تمایل پژوهشگران به این روش است. شرایط پیچیده امروزی فراتر ازآن است که در قالب یک همبستگی ساده بین دو متغییر تحت عنوان یک فرضیه پژوهشی به تصویر کشیده شود. یک متغییر در عین حال که خود وابسته به متغییری است برای متغییرهای دیگر می تواند نقش یک متغییر مستقل را ایفا نماید. طبیعی است که این روش برای پژوهشگران دارای کاربرد بیشتری بوده و با شرایط پیچیده تر نیز سازگار است.
@analysisacademy
لزوم استفاده از مدلسازی معادلات ساختاری
استفاده از مدلسازی معادلات ساختاری در پژوهش های سالهای اخیر رو به افزایش بوده است. از دلایل تمایل دانشمندان در استفاده از این روش می توان به موارد زیر اشاره کرد:
شاید نخستین دلیل گرایش اندیشمندان در سالهای اخیر را بتوان سهولت استفاده از این ابزار دانست. تا دهه نود استفاده از این روش در یک پژوهش مستلزم مهارت بالایی در برنامه نویسی بود که خود هم استفاده از این روش را محدود می ساخت و هم مستلزم صرف وقت زیادی بود. در دو ذهه اخیر با ابداع برنامه های رایانه ای که به هیچ وجه پیچیدگی های گذشته را ندارند و همه آنها در محیط ویندوز قابل اجرا هستند استفاده از مدلسازی معادلات ساختاری گسترش زیادی یافته است.
@analysisacademy
دلیل دیگر استفاده از مدلسازی معادلات ساختاری به توانایی منحصر به فرد این روش در مقایسه با سایر روش های آماری برمی گردد. این روش توانایی آزمون یک مدل و نه تنها فرضیه های پژوهشی را دارد که با رویکرهای مرسوم آماری قابل انجام نیست. روش تحلیل مسیر، رگرسیون و تحلیل عاملی به دلیل محدودیتهای ذاتی شان ابزاری مناسب برای آزمون مدلهای علی و معلولی محسوب نمی شوند. به همین منظور مدلسازی معادلات ساختاری جایگزین مناسبی برای روش های مورد اشاره است.
@analysisacademy
دلیل دیگر استفاده از مدلسازی معادلات ساختاری در سالهای اخیر به توان این روش در آزمون نمونه های متفاوت پژوهشی برمی گردد. این روش توانایی آن را دارد که برای گروه های متفاوت آزمون های آماری را به مورد اجرا بگذارد. پژوهشی را درنظر آورید که در آن دو نمونه آماری مربوط به مردان و زنان مورد استفاده قرار گرفته است آزمون مدل پژوهشی برای هر یک از این گروهها قابلیتی است که مدلسازی معادلات ساختاری را از سایر روش های آماری متمایز می کند.
@analysisacademy
دلیل دیگر استفاده از مدلسازی معادلات ساختاری به واسطه اهمیت روزافزون اعتبار داده ها و اجتناب از خطاهای اندازه گیری در سالهای اخیر می باشد. همانطور که در کلاس های آموزشی آکادمی تحلیل آماری ایران همواره اشاره می گردد روش های مرسوم آماری که مستلزم میانگین گیری از شاخص ها هستند عملا خطاهای اندازه گیری هر یک از شاخص ها را نادیده می گیرند. مدلسازی معادلات ساختاری با معرفی مفهوم متغییر پنهان در مدل از این لحاظ در جایگاه ممتازی قرار دارد.
@analysisacademy
توانایی مدلسازی معادلات ساختاری در ترسیم شرایط و روابط پیچیده بین متغییرها یکی دیگر از علل تمایل پژوهشگران به این روش است. شرایط پیچیده امروزی فراتر ازآن است که در قالب یک همبستگی ساده بین دو متغییر تحت عنوان یک فرضیه پژوهشی به تصویر کشیده شود. یک متغییر در عین حال که خود وابسته به متغییری است برای متغییرهای دیگر می تواند نقش یک متغییر مستقل را ایفا نماید. طبیعی است که این روش برای پژوهشگران دارای کاربرد بیشتری بوده و با شرایط پیچیده تر نیز سازگار است.
http://analysisacademy.com/wp-content/uploads/2015/10/sem-adwords.jpg
تکنیکهای تخمین پارامترها در مدلسازی معادلات ساختاری
ازآنجاییکه مدلسازی معادلات ساختاری تأکید بر روابط علی خطی متغیرهای مکنون با یکدیگر و قبلتر از آن رابطه متغیرهای مکنون با متغیرهای مشاهدهپذیر دارد. یعنی مدلسازی معادلات ساختاري بر پايه فرضیههایی درباره وجود روابط علي در بين متغيرها، مدلهای علي را با دستگاه معادلات خطي آزمون میکند . بدين ترتيب، SEM روابط ساختاري بين شرايط ساختاري معين و مفروض را ميآزمايد و برآورد روابط علي ميان متغيرهاي مکنون (مشاهده نشده) و نيز روابط بين متغيرهاي اندازهگيري شده (مشاهدهشده) را امکانپذیر میسازد .
در تحلیل مدلسازی معادلات ساختاری از تکنیک های زیر جهت برآورد پارامترها استفاده میکند:
@analysisacademy
1. متغیرهای ابزاری(IV)
2. کمترین مجذورات دومرحلهای(TSLS)
3. کمترین مجذورات بدون وزن(ULS)
4. کمترین مجذورات تأمین یافته(GLS)
5. حداکثر درستنمایی(ML)
6. کمترین مجذورات وزندار کلی(WLS)
7. کمترین مجذورات وزندار قطری(DWLS)
8. گزینه برجسته(OR)
هر یک از روش های بالا در تخمین پارامتر های مدل دارای پیش فرض هایی است که تنها در صورت برقراری آن ها می توان از آن روش مربوطه استفاده کرد. پیش فرض هایی مربوط به حجم نمونه یا نرمال بودن توزیع داده ها و ……….
@analysisacademy
روش پیشفرض نرمافزار لیزرل و ایموس در مدل سازی معادلات ساختاری، روش حداکثر درستنمایی یا بیشینه احتمال است. این روش مطابق با نظر دکتر هیر ۲۰۰۶ که در دورههای آکادمی تحلیل آماری ایران از آن بسیار صحبت شده است ، قلب تپنده و موتور مدلسازی معادلات ساختاری کواریانس محور است.
در این روش مجموعهای از پارامترها تخمین زده میشود که این پارامترها و تخمین آنها بر مبنای روابط حاصل از شانس نیست. یک فرایند ازسرگیری دارد که در آن مجموعهای از پارامترها تخمین زده میشود. بر پایهی مقادیر اولیهی برآورد شده، تابع برازندگی محاسبه میشود. این تابع ضریبی است که برازندگی پارامترها را با دادههای پژوهش توصیف مینماید.
در این روش، دومین تخمین بر مبنای تخمین اولیه محاسبه میشود تا بتوان به تابعی با برازندگی کوچکتر دستیافت. این فرایند تا جایی ادامه مییابد تا به کوچکترین تابع برازندگی دستیابیم.
محسن مرادی
مطالب سایت و کانال بدون ذکر سایت منبع استفاده نشود
تکنیکهای تخمین پارامترها در مدلسازی معادلات ساختاری
ازآنجاییکه مدلسازی معادلات ساختاری تأکید بر روابط علی خطی متغیرهای مکنون با یکدیگر و قبلتر از آن رابطه متغیرهای مکنون با متغیرهای مشاهدهپذیر دارد. یعنی مدلسازی معادلات ساختاري بر پايه فرضیههایی درباره وجود روابط علي در بين متغيرها، مدلهای علي را با دستگاه معادلات خطي آزمون میکند . بدين ترتيب، SEM روابط ساختاري بين شرايط ساختاري معين و مفروض را ميآزمايد و برآورد روابط علي ميان متغيرهاي مکنون (مشاهده نشده) و نيز روابط بين متغيرهاي اندازهگيري شده (مشاهدهشده) را امکانپذیر میسازد .
در تحلیل مدلسازی معادلات ساختاری از تکنیک های زیر جهت برآورد پارامترها استفاده میکند:
@analysisacademy
1. متغیرهای ابزاری(IV)
2. کمترین مجذورات دومرحلهای(TSLS)
3. کمترین مجذورات بدون وزن(ULS)
4. کمترین مجذورات تأمین یافته(GLS)
5. حداکثر درستنمایی(ML)
6. کمترین مجذورات وزندار کلی(WLS)
7. کمترین مجذورات وزندار قطری(DWLS)
8. گزینه برجسته(OR)
هر یک از روش های بالا در تخمین پارامتر های مدل دارای پیش فرض هایی است که تنها در صورت برقراری آن ها می توان از آن روش مربوطه استفاده کرد. پیش فرض هایی مربوط به حجم نمونه یا نرمال بودن توزیع داده ها و ……….
@analysisacademy
روش پیشفرض نرمافزار لیزرل و ایموس در مدل سازی معادلات ساختاری، روش حداکثر درستنمایی یا بیشینه احتمال است. این روش مطابق با نظر دکتر هیر ۲۰۰۶ که در دورههای آکادمی تحلیل آماری ایران از آن بسیار صحبت شده است ، قلب تپنده و موتور مدلسازی معادلات ساختاری کواریانس محور است.
در این روش مجموعهای از پارامترها تخمین زده میشود که این پارامترها و تخمین آنها بر مبنای روابط حاصل از شانس نیست. یک فرایند ازسرگیری دارد که در آن مجموعهای از پارامترها تخمین زده میشود. بر پایهی مقادیر اولیهی برآورد شده، تابع برازندگی محاسبه میشود. این تابع ضریبی است که برازندگی پارامترها را با دادههای پژوهش توصیف مینماید.
در این روش، دومین تخمین بر مبنای تخمین اولیه محاسبه میشود تا بتوان به تابعی با برازندگی کوچکتر دستیافت. این فرایند تا جایی ادامه مییابد تا به کوچکترین تابع برازندگی دستیابیم.
محسن مرادی
مطالب سایت و کانال بدون ذکر سایت منبع استفاده نشود
http://analysisacademy.com/wp-content/uploads/2016/12/SuggestionBox.jpg
@analysisacademy
روش ارائه پیشنهادات تحقیق
این واقعیت را نمیتوان انکار نمود كه ماحصل انجام تحقيق در قسمت ارائه پیشنهادات ارائه میگردد. لذا محققين محترم میبایست در اين قسمت از کلیگوییهای برگرفته از ادبيات و ارائه پيشنهادات کلیشهای بپرهيزند و پيشنهادات خود را دقيقاً مطابق نتايج یافتههای تحقيق ارائه نمايند. اين پيشنهادات بايد بهطور مستقيم با یافتهها و نتايج بهدستآمده از تحقيق مرتبط باشند.
بر اساس آنها به ذینفعان توصيه میشود كه نتايج حاصل از تحقيق در موقعیتهای عملي و براي حل مسائل و مشكلات موجود به كار گرفته شوند. یعنی باید مساله پژوهش که همان فاصله بین وضع موجود و وضع مطلوب است را حل نماید متأسفانه این موضوع در کلاسهای آکادمی تحلیل آماری ایران بارها موردبحث قرارگرفته که بررسي پروژههای تحقيقاتي و دانشگاهي نشان میدهد كه ارائه پيشنهادات بدون توجه به یافتههای تحقيق است و بررسي دقیقتر و مقايسه چند پروژه مرتبط بيان میدارد كه برخي از پيشنهادات در پروژههای مختلف بدون توجه به یافتهها، عيناً تكرار و كپي میشوند. محققين میتوانند با اجراي فرآيند ارائهشده فوق، بر اين مشكل فائق آيند.
@analysisacademy
همچنین اختصاصاً در بخش ارائه پیشنهادات به محققین آینده باید این خواهش را بهعنوان یک محقق از محققین دیگر داشته باشم که پيشنهاداتي مفيد و مؤثر براي محققين آينده كه علاقهمند به انجام تحقيق در اين زمینهاند ارائه شود . ارائه پيشنهادات ازایندست که مثلاً از مدل های دیگر استفاده شود و یا جامعه آماری عوض شود و یا در نمونهای بزرگتر تکرار شود واقعاً در شأن فضای علمی ما نیست. اگر نگاهی به پایاننامهها و مقالات بیندازید به درصد وحشتناک این دست پیشنهادات بهصورت حدودی در فضای تحقیق ایران خواهید رسید.
اين قسمت میبایست دربرگيرنده پرسشهای پژوهشي مرتبط با موضوع تحقيق باشد كه در فرآيند پژوهش براي پژوهشگر بهعنوان پرسشها يا موضوعهای پژوهشي جديد مطرحشدهاند. اين دسته از پيشنهادات، پژوهشگران آينده را به انجام برخي پژوهشهای علمي برمیانگیزاند. دورویهی مشخص براي ارائه پيشنهادات تحقيقاتي آينده به شرح زير میباشند:
۱. پيشنهادات بر مبناي محدودیتهای به وجود آمده در فرآيند تحقيق. همانگونه كه دربند محدودیتهای تحقيق گفته شد، اين محدودیتها میتواند ناشي از عدم كنترل تأثير برخي متغيرهاي مزاحم باشد و يا میتواند ناشي از عدم سنجش برخي متغيرهاي مهم در موضوع باشد، و نيز میتواند ناشي از خطاهاي آزمون و يا مشاهده نتايج غيرواقعي باشد.
۲. دسته ديگر پيشنهادات از مقايسه نتايج تحقيق با ساير تحقيقات مشابه مشخص میشوند. در بخش بحث و مقايسه بيان شد كه محقق در پايان پروژه نتايج و فرآيند اجراي تحقيق خود را با تحقيقات مشابه موجود در پيشينه تحقيق مقايسه میکند . از انجام اين مقايسه وجوه تشابه و افتراقهای مختلفي به دست میآید كه يكي از مهمترین منابع ارائه پيشنهادات تحقيقاتي است. مثلاً با مقايسه مشاهده میشود كه در ساير تحقيقات، آزمون فرضيه اي خاص مورد تأييد قرارگرفته، ولي تنها در پروژه شما رد شده است. يا اينكه مقايسه نشان میدهد رابطه خاصي ميان نتايج بهدستآمده از چند تحقيق وجود دارد. مثلاً رابطه بر اساس نتايج مشابه در فرضيات با يكي از ویژگیهای جمعيت شناختي (مانند جنسيت، موقعيت جغرافياي، سطح تحصيلات و…)، لذا میتوانید محققين آينده را به آن موضوع جديد سوق دهيد.
@analysisacademy
@analysisacademy
روش ارائه پیشنهادات تحقیق
این واقعیت را نمیتوان انکار نمود كه ماحصل انجام تحقيق در قسمت ارائه پیشنهادات ارائه میگردد. لذا محققين محترم میبایست در اين قسمت از کلیگوییهای برگرفته از ادبيات و ارائه پيشنهادات کلیشهای بپرهيزند و پيشنهادات خود را دقيقاً مطابق نتايج یافتههای تحقيق ارائه نمايند. اين پيشنهادات بايد بهطور مستقيم با یافتهها و نتايج بهدستآمده از تحقيق مرتبط باشند.
بر اساس آنها به ذینفعان توصيه میشود كه نتايج حاصل از تحقيق در موقعیتهای عملي و براي حل مسائل و مشكلات موجود به كار گرفته شوند. یعنی باید مساله پژوهش که همان فاصله بین وضع موجود و وضع مطلوب است را حل نماید متأسفانه این موضوع در کلاسهای آکادمی تحلیل آماری ایران بارها موردبحث قرارگرفته که بررسي پروژههای تحقيقاتي و دانشگاهي نشان میدهد كه ارائه پيشنهادات بدون توجه به یافتههای تحقيق است و بررسي دقیقتر و مقايسه چند پروژه مرتبط بيان میدارد كه برخي از پيشنهادات در پروژههای مختلف بدون توجه به یافتهها، عيناً تكرار و كپي میشوند. محققين میتوانند با اجراي فرآيند ارائهشده فوق، بر اين مشكل فائق آيند.
@analysisacademy
همچنین اختصاصاً در بخش ارائه پیشنهادات به محققین آینده باید این خواهش را بهعنوان یک محقق از محققین دیگر داشته باشم که پيشنهاداتي مفيد و مؤثر براي محققين آينده كه علاقهمند به انجام تحقيق در اين زمینهاند ارائه شود . ارائه پيشنهادات ازایندست که مثلاً از مدل های دیگر استفاده شود و یا جامعه آماری عوض شود و یا در نمونهای بزرگتر تکرار شود واقعاً در شأن فضای علمی ما نیست. اگر نگاهی به پایاننامهها و مقالات بیندازید به درصد وحشتناک این دست پیشنهادات بهصورت حدودی در فضای تحقیق ایران خواهید رسید.
اين قسمت میبایست دربرگيرنده پرسشهای پژوهشي مرتبط با موضوع تحقيق باشد كه در فرآيند پژوهش براي پژوهشگر بهعنوان پرسشها يا موضوعهای پژوهشي جديد مطرحشدهاند. اين دسته از پيشنهادات، پژوهشگران آينده را به انجام برخي پژوهشهای علمي برمیانگیزاند. دورویهی مشخص براي ارائه پيشنهادات تحقيقاتي آينده به شرح زير میباشند:
۱. پيشنهادات بر مبناي محدودیتهای به وجود آمده در فرآيند تحقيق. همانگونه كه دربند محدودیتهای تحقيق گفته شد، اين محدودیتها میتواند ناشي از عدم كنترل تأثير برخي متغيرهاي مزاحم باشد و يا میتواند ناشي از عدم سنجش برخي متغيرهاي مهم در موضوع باشد، و نيز میتواند ناشي از خطاهاي آزمون و يا مشاهده نتايج غيرواقعي باشد.
۲. دسته ديگر پيشنهادات از مقايسه نتايج تحقيق با ساير تحقيقات مشابه مشخص میشوند. در بخش بحث و مقايسه بيان شد كه محقق در پايان پروژه نتايج و فرآيند اجراي تحقيق خود را با تحقيقات مشابه موجود در پيشينه تحقيق مقايسه میکند . از انجام اين مقايسه وجوه تشابه و افتراقهای مختلفي به دست میآید كه يكي از مهمترین منابع ارائه پيشنهادات تحقيقاتي است. مثلاً با مقايسه مشاهده میشود كه در ساير تحقيقات، آزمون فرضيه اي خاص مورد تأييد قرارگرفته، ولي تنها در پروژه شما رد شده است. يا اينكه مقايسه نشان میدهد رابطه خاصي ميان نتايج بهدستآمده از چند تحقيق وجود دارد. مثلاً رابطه بر اساس نتايج مشابه در فرضيات با يكي از ویژگیهای جمعيت شناختي (مانند جنسيت، موقعيت جغرافياي، سطح تحصيلات و…)، لذا میتوانید محققين آينده را به آن موضوع جديد سوق دهيد.
@analysisacademy

@analysisacademy
http://analysisacademy.com/wp-content/uploads/2016/12/sampling.jpg
دلایل استفاده از نمونهگیری در تحقیقات
هدف همه نمونهبرداریها در پژوهش علمي، تهيه گزارههای دقيق و بامعنا درباره يك گروه، بر پايه مطالعه زیرمجموعهای از آن گروه است . اين گروه ممكن است مجموعهای از افراد يا چيزها باشد. دسترسي به ویژگیهای گروه كلي موردمطالعه ، در صورتي امکانپذیر است كه حالتهای گوناگون يا موارد مختلف پديده موردمطالعه را(از راه مشاهده يا آزمايش) بارها آزموده باشيم. روشن است كه تنها با يك نوبت آزمايش يا آزمايش در مورد معدود و خاص نمیتوان به نتايج پژوهش علمي دستیافت.
در پژوهش، اين شرط مهم است كه آزمايش موردنظر بهاندازه كافي تكرار شود تا امر تعميم و استنباط امکانپذیر باشد. بنابراين ضمن تعيينمسئله موردپژوهش ، لازم است مواردي كه پژوهش در آن صورت میگیرد و همچنین فراواني موارد آزمايش و چگونگي انتخاب اين موارد را مشخص كرد.
دلايل استفاده از گروه نمونه بهجای جمعآوری دادهها از كل جامعه آماري، كاملاً آشكار است. در بررسیهای پژوهشي كه شامل چند صد و حتي چند هزار عضو جامعه آماري میشود، عملاً غيرممكن است كه اطلاعات را از هر عضو جمعآوری كنيم يا او را آزمون كنيم يا او را مورد آزمايش قرار دهيم. حتي اگر امکانپذیر هم باشد، به لحاظ زمان، هزينه و ساير مسائل منابع انساني، مقدور نيست. كيش معتقد است كه نمونهگیری در مقايسه با شمارش كامل، از چند جنبه برتري دارد . ازجملهی اين جنبهها میتوان موارد زير را برشمرد: باصرفهتر بودن، سرعت عمل بيشتر و کوتاهتر بودن زمان موردنیاز، كيفيت بالاتر دادهها از طريق دقت بيشتر در گردآوري و استخراج آنها . بهطورکلی، ازنظر تحليل آماري، حتي اگر دادهها از طريق شمارش كامل گردآوریشده باشد، میتوانیم افراد مورد مشاهده را بهعنوان نمونهای از جامعه منظور نماييم. اين حالت در مواردي رخ میدهد كه تعداد افراد جامعهی موردمطالعه چندان زياد نبوده و نمونهگیری ضرورت نداشته باشد(کیش، ۱۹۹۷)
بهطور خلاصه میتوان دلايل نمونهگیری را اینگونه بيان نمود:
۱. مطالعهی يك گروه نمونه بهجای كل جامعه آماري، گاهي ممكن است منجر به نتايج معتبرتري شود، بيشتر به خاطر اینکه خستگي كمتري وجود خواهد داشت و ازاینرو خطاهاي كمتري در جمعآوری اطلاعات پديد میآورد، مخصوصاً موقع كه اعضاي جامعه آماري بسيار وسيع باشد.
۲. نمونهبرداری موجب تسهيل و تسريع كار پژوهش، صرفهجویی در وقت، هزينه و نيروي پژوهش میشود. معمولاً ازلحاظ اقتصادي بهصرفه نزدیکتر است كه زیرمجموعهای از يك گروه، و نه كل گروه، مطالعه شود.براي مثال، نمونه لامپهای الكتريكي را در نظر بگيريد. اگر بخواهيم براي آزمون طول عمر يك دسته لامپ، همه لامپهای تولیدشده را بسوزانيم، هیچچیزی براي فروش وجود نخواهد داشت.
۳. در برخي آزمایشها، خود آزمايش يا مشاهده به شكلي در پدیدهی موردمطالعه تأثير میکند و حتي سبب ضايع شدن آن مورد بهخصوص میشود، بنابراين ناچار خواهيم بود پژوهش را روي نمونهای از آن فرآورده و نه كل فرآورده، انجام دهيم.
۴. بهطورکلی، بررسي يك گروه نمونه، مؤثرتر و كارآمدتر از بررسي يك گروه بزرگتر است (به سبب كنترل بيشتر). اغلب آزمونهای آماري معنادار بودن تا حدود زيادي تابع حجم نمونه است و شايد به همين دليل نمونههای خيلي بزرگ (مثلاً ۱۰۰ نفري يا بيشتر) اصولاً براي پژوهش نامطلوب است، زيرا احتمال آنكه همبستگیهای بسيار ضعيف و تفاوتهای ناچيز هم در اینگونه نمونهها ازلحاظ آماري معنادار شود، زياد است.
به لحاظ روششناسی علمي ، موقع میتوان بهجای پژوهش نامحدود، قواعد و قوانين علمي را بر پايه بررسي موارد معدود و معين بنا كرد كه : ۱) در انتخاب موارد آزمايش، قواعد نمونهبرداری رعايت شده باشد و ميان اين موارد خاص(گروه نمونه ) و گروه كلي(جامعه) شباهت دقيق موجود باشد، و ۲) مقادير توصيفي كه از موارد آزمايشي استخراج میشود، با روشهای آماري مناسب بررسي شود تا معلوم گردد كه تا چه حد میتوان به نتايج حاصله كليت داد . نمونهبرداری يكي از مباحث اساسي روششناسی علمي است و در طرحریزی و اجراي پژوه مای تجربي و در بهرهبرداری از نتايج آن، اهميت فراوان دارد. اطلاع از مفاهيم اساسي آمار، پیشنیاز مطالعهی طرح نمونهبرداری است و براي درك روشهای نمونهبرداری نيز آشنايي با برخي اصطلاحات، امري ضروري محسوب میشود. با توجه به اين مطلب، ابتدا اصطلاحات فني متداول در نمونهبرداری، سپس انواع نمونه و روشهای مختلف نمونهبرداری و چگونگي انتخاب گروه نمونه را بررسي میکنیم(هومن، ۱۳۸۶ ، ۲۶۴ – ۲۶۶ ).
http://analysisacademy.com/wp-content/uploads/2016/12/sampling.jpg
دلایل استفاده از نمونهگیری در تحقیقات
هدف همه نمونهبرداریها در پژوهش علمي، تهيه گزارههای دقيق و بامعنا درباره يك گروه، بر پايه مطالعه زیرمجموعهای از آن گروه است . اين گروه ممكن است مجموعهای از افراد يا چيزها باشد. دسترسي به ویژگیهای گروه كلي موردمطالعه ، در صورتي امکانپذیر است كه حالتهای گوناگون يا موارد مختلف پديده موردمطالعه را(از راه مشاهده يا آزمايش) بارها آزموده باشيم. روشن است كه تنها با يك نوبت آزمايش يا آزمايش در مورد معدود و خاص نمیتوان به نتايج پژوهش علمي دستیافت.
در پژوهش، اين شرط مهم است كه آزمايش موردنظر بهاندازه كافي تكرار شود تا امر تعميم و استنباط امکانپذیر باشد. بنابراين ضمن تعيينمسئله موردپژوهش ، لازم است مواردي كه پژوهش در آن صورت میگیرد و همچنین فراواني موارد آزمايش و چگونگي انتخاب اين موارد را مشخص كرد.
دلايل استفاده از گروه نمونه بهجای جمعآوری دادهها از كل جامعه آماري، كاملاً آشكار است. در بررسیهای پژوهشي كه شامل چند صد و حتي چند هزار عضو جامعه آماري میشود، عملاً غيرممكن است كه اطلاعات را از هر عضو جمعآوری كنيم يا او را آزمون كنيم يا او را مورد آزمايش قرار دهيم. حتي اگر امکانپذیر هم باشد، به لحاظ زمان، هزينه و ساير مسائل منابع انساني، مقدور نيست. كيش معتقد است كه نمونهگیری در مقايسه با شمارش كامل، از چند جنبه برتري دارد . ازجملهی اين جنبهها میتوان موارد زير را برشمرد: باصرفهتر بودن، سرعت عمل بيشتر و کوتاهتر بودن زمان موردنیاز، كيفيت بالاتر دادهها از طريق دقت بيشتر در گردآوري و استخراج آنها . بهطورکلی، ازنظر تحليل آماري، حتي اگر دادهها از طريق شمارش كامل گردآوریشده باشد، میتوانیم افراد مورد مشاهده را بهعنوان نمونهای از جامعه منظور نماييم. اين حالت در مواردي رخ میدهد كه تعداد افراد جامعهی موردمطالعه چندان زياد نبوده و نمونهگیری ضرورت نداشته باشد(کیش، ۱۹۹۷)
بهطور خلاصه میتوان دلايل نمونهگیری را اینگونه بيان نمود:
۱. مطالعهی يك گروه نمونه بهجای كل جامعه آماري، گاهي ممكن است منجر به نتايج معتبرتري شود، بيشتر به خاطر اینکه خستگي كمتري وجود خواهد داشت و ازاینرو خطاهاي كمتري در جمعآوری اطلاعات پديد میآورد، مخصوصاً موقع كه اعضاي جامعه آماري بسيار وسيع باشد.
۲. نمونهبرداری موجب تسهيل و تسريع كار پژوهش، صرفهجویی در وقت، هزينه و نيروي پژوهش میشود. معمولاً ازلحاظ اقتصادي بهصرفه نزدیکتر است كه زیرمجموعهای از يك گروه، و نه كل گروه، مطالعه شود.براي مثال، نمونه لامپهای الكتريكي را در نظر بگيريد. اگر بخواهيم براي آزمون طول عمر يك دسته لامپ، همه لامپهای تولیدشده را بسوزانيم، هیچچیزی براي فروش وجود نخواهد داشت.
۳. در برخي آزمایشها، خود آزمايش يا مشاهده به شكلي در پدیدهی موردمطالعه تأثير میکند و حتي سبب ضايع شدن آن مورد بهخصوص میشود، بنابراين ناچار خواهيم بود پژوهش را روي نمونهای از آن فرآورده و نه كل فرآورده، انجام دهيم.
۴. بهطورکلی، بررسي يك گروه نمونه، مؤثرتر و كارآمدتر از بررسي يك گروه بزرگتر است (به سبب كنترل بيشتر). اغلب آزمونهای آماري معنادار بودن تا حدود زيادي تابع حجم نمونه است و شايد به همين دليل نمونههای خيلي بزرگ (مثلاً ۱۰۰ نفري يا بيشتر) اصولاً براي پژوهش نامطلوب است، زيرا احتمال آنكه همبستگیهای بسيار ضعيف و تفاوتهای ناچيز هم در اینگونه نمونهها ازلحاظ آماري معنادار شود، زياد است.
به لحاظ روششناسی علمي ، موقع میتوان بهجای پژوهش نامحدود، قواعد و قوانين علمي را بر پايه بررسي موارد معدود و معين بنا كرد كه : ۱) در انتخاب موارد آزمايش، قواعد نمونهبرداری رعايت شده باشد و ميان اين موارد خاص(گروه نمونه ) و گروه كلي(جامعه) شباهت دقيق موجود باشد، و ۲) مقادير توصيفي كه از موارد آزمايشي استخراج میشود، با روشهای آماري مناسب بررسي شود تا معلوم گردد كه تا چه حد میتوان به نتايج حاصله كليت داد . نمونهبرداری يكي از مباحث اساسي روششناسی علمي است و در طرحریزی و اجراي پژوه مای تجربي و در بهرهبرداری از نتايج آن، اهميت فراوان دارد. اطلاع از مفاهيم اساسي آمار، پیشنیاز مطالعهی طرح نمونهبرداری است و براي درك روشهای نمونهبرداری نيز آشنايي با برخي اصطلاحات، امري ضروري محسوب میشود. با توجه به اين مطلب، ابتدا اصطلاحات فني متداول در نمونهبرداری، سپس انواع نمونه و روشهای مختلف نمونهبرداری و چگونگي انتخاب گروه نمونه را بررسي میکنیم(هومن، ۱۳۸۶ ، ۲۶۴ – ۲۶۶ ).

http://analysisacademy.com/wp-content/uploads/2016/12/validity-criteria.jpg
@analysisacademy
روايي وابسته به معيار
روايي وابسته به معيار وقتي ايجاد میشود كه سنجهی موردنظر، افراد را بر اساس معياري كه انتظار پیشبینی آن میرود، متمايز سازد. اين امر میتواند بهوسیلهی ايجاد «روایی همزمان » يا «روايي پیشبین » آنطور كه ذيلاً تشريح میگردد، انجام شود. روايي همزمان موقع ايجاد میگردد كه مقياس، افرادي كه مشخص است نسبت به یکدیگر متفاوتاند را از هم متمايز میکند؛ يعني بايد در آزمون، نمرات متفاوتي بگيرند .براي مثال، اگر يك سنجه در مورد اخلاقِ كار تدوين میشود و در مورد گروهي از دریافتکنندگان خدمات رفاهي اجرا میگردد، مقياس بايد افرادي كه مایلاند شغلي را بپذيرند و از زير چتر خدمات رفاهي بيرون آيند را از كساني كه میخواهند تحت پوشش خدمات رفاهي باقي بمانند و خواهان شغلي نباشد، متمايز گرداند، زیراکسانی كه براي اخلاق كار ارزش زياد قائلاند، نمیخواهند تحت پوشش خدمات رفاهي باشند و خواهان و مشتاق پذيرش شغل هستند.
از طرف دیگرکسانی كه براي اخلاق كار ارزش كمي قائلاند، ممكن است تمايل داشته باشند كماكان از خدمات رفاهي برخوردار باشند ولي اشتغال به كاري نداشته باشند. اگر هر دو نوع از افراد، نمره يكساني بر اساس مقياس اخلاق كاري بگيرند، آنگاه آزمون نتوانسته است سنجهای از اخلاق كار باشد، بلكه سنجهای از چيز ديگري بوده است.
@analysisacademy
روايي پیشبین، توانايي آزمون سنجه براي ايجاد تفكيكي بين افراد، در خصوص يك سنجه است كه در آينده رخ میدهد. براي مثال، اگر نوعي آزمون استعداد يا توانايي، از كاركنان در زمان استخدام به عمل میآید، انتظار میرود افراد را بر اساس عملكرد مورد انتظار آیندهی آنها تفكيك كند، آنگاه افرادي كه نمرات ضعيفي دريافت میکنند، بايد كاركنان ضعيفي باشند و افرادي كه نمرات بالا از روي مقياس به دست میآورند بايد كاركنان خوبي باشند. آزمونها ممكن است از روایی پیشبینی کنندگی بالا، متوسط و يا پاييني برخوردار باشند.
@analysisacademy
روايي وابسته به معيار
روايي وابسته به معيار وقتي ايجاد میشود كه سنجهی موردنظر، افراد را بر اساس معياري كه انتظار پیشبینی آن میرود، متمايز سازد. اين امر میتواند بهوسیلهی ايجاد «روایی همزمان » يا «روايي پیشبین » آنطور كه ذيلاً تشريح میگردد، انجام شود. روايي همزمان موقع ايجاد میگردد كه مقياس، افرادي كه مشخص است نسبت به یکدیگر متفاوتاند را از هم متمايز میکند؛ يعني بايد در آزمون، نمرات متفاوتي بگيرند .براي مثال، اگر يك سنجه در مورد اخلاقِ كار تدوين میشود و در مورد گروهي از دریافتکنندگان خدمات رفاهي اجرا میگردد، مقياس بايد افرادي كه مایلاند شغلي را بپذيرند و از زير چتر خدمات رفاهي بيرون آيند را از كساني كه میخواهند تحت پوشش خدمات رفاهي باقي بمانند و خواهان شغلي نباشد، متمايز گرداند، زیراکسانی كه براي اخلاق كار ارزش زياد قائلاند، نمیخواهند تحت پوشش خدمات رفاهي باشند و خواهان و مشتاق پذيرش شغل هستند.
از طرف دیگرکسانی كه براي اخلاق كار ارزش كمي قائلاند، ممكن است تمايل داشته باشند كماكان از خدمات رفاهي برخوردار باشند ولي اشتغال به كاري نداشته باشند. اگر هر دو نوع از افراد، نمره يكساني بر اساس مقياس اخلاق كاري بگيرند، آنگاه آزمون نتوانسته است سنجهای از اخلاق كار باشد، بلكه سنجهای از چيز ديگري بوده است.
@analysisacademy
روايي پیشبین، توانايي آزمون سنجه براي ايجاد تفكيكي بين افراد، در خصوص يك سنجه است كه در آينده رخ میدهد. براي مثال، اگر نوعي آزمون استعداد يا توانايي، از كاركنان در زمان استخدام به عمل میآید، انتظار میرود افراد را بر اساس عملكرد مورد انتظار آیندهی آنها تفكيك كند، آنگاه افرادي كه نمرات ضعيفي دريافت میکنند، بايد كاركنان ضعيفي باشند و افرادي كه نمرات بالا از روي مقياس به دست میآورند بايد كاركنان خوبي باشند. آزمونها ممكن است از روایی پیشبینی کنندگی بالا، متوسط و يا پاييني برخوردار باشند.

http://analysisacademy.com/wp-content/uploads/2016/12/research_icon.png
@analysisacademy
روش نوشتن قلمرو تحقیق
متأسفانه در نوشتن این بخش در پروپوزالها و پایاننامهها و مقالات ایرادات فاحشی دیده میشود که بعضاً از عدم درک صحیح محقق نسبت به این مفاهیم نشاءت میگیرد. قلمرو تحقيق همانند مرز سازمان يا شركت است كه بهعنوان يك عامل محدودکننده هست. قلمرو، محدوده و چارچوب تحقيق را مشخص مینماید و خود شامل سه بخش هست:
@analysisacademy
قلمرو موضوعي : در اين قسمت موضوع تحقيق محدود میشود. مثلاً وقتي تحقيقي با عنوان « ارائه مدل عوامل مؤثر بر ارزش ویژه برند سامسونگ در گوشیهای هوشمند» هست بنابراین قلمرو موضوعی باید ارائه مدل برای ارزش ویژه برند سامسونگ آنهم تنها در بخش گوشیهای هوشمند سامسونگ باشد و شخص مثلاً نمیتواند در این بخش ارائه راهکار یا طبقهبندی عوامل و یا موضوعاتی مشابه را که در قلمرو این تحقیق نیست را وارد نماید.
@analysisacademy
قلمرو مكاني: اين بخش بهعنوان عامل محدودكننده جمعيت جامعه در بعد جغرافيايي و مكاني هست. در حقيقت قلمرو مكاني به محقق اعلان مینماید در چه نمونه آماری میتواند به تحليل و بررسي بپردازد و نتايج تحقيق را به چه جامعهای میتواند تعميم دهد. مثلاً در عنوان تحقیقی که ذکر شد باید مشخص شود که میخواهیم چه جامعه و چه نمونهای از آن را بررسی نماییم. مثلاً جامعه مشتریان گوشیهای هوشمند سامسونگ در شهر تهران هستند. خوب حالا که جامعه آماری و محدوده مکانی مشخصشده است باید نمونهای از همین جامعه انتخاب شود و درنهایت نتایج آزمونهای آماری استنباطی برای دادههای این نمونه، تنها به همین جامعه آماری قابلتعمیم است. متأسفانه اینیک ایراد بسیار بزرگ در بسیاری از پژوهشهای کشورمان است که افراد نتایج را به جامعه و بعد مکانی فراتر از جامعه و بعد مکانی تحقیق خود تعمیم میدهند. مثلاً نتایج این تحقیق را به مشتریان گوشیهای هوشمند سامسونگ در کل کشور تعمیم میدهند.بنابراین در اینجا شهر تهران بهعنوان محدوده مكاني پذیرفتهشده و محقق میبایست تحقيق خود را روي افراد همين جامعه صورت دهد.
@analysisacademy
قلمرو زماني: اين قلمرو، محدوده زماني را پوشش میدهد. البته توجه شود كه منظور از قلمرو زماني، دوره زماني است كه اطلاعات تحقیق در آن دوره جمعآوری و طبقهبندی و مورد تجزیهوتحلیل قرار میگیرند. یعنی فرد باید در این محدوده زمانی این عملیات را انجام دهد. متأسفانه بازهم در این بخش اشتباهات بزرگی انجام میشود که اعتبار نتایج تحقیق را کاهش میدهد و آن این است که محقق در پایان کار هرچقدر زمان تحقیق طول کشیده آن را بهعنوان محدوده زمانی وارد کار پایاننامه میکند. این در حالی است که آن محدوده زمانی است که باید مشخص کند برای عملیات میدانی چقدر زمان هست.
محسن مرادی
مطالب سایت و کانال بدون ذکر سایت منبع استفاده نشود.
@analysisacademy
روش نوشتن قلمرو تحقیق
متأسفانه در نوشتن این بخش در پروپوزالها و پایاننامهها و مقالات ایرادات فاحشی دیده میشود که بعضاً از عدم درک صحیح محقق نسبت به این مفاهیم نشاءت میگیرد. قلمرو تحقيق همانند مرز سازمان يا شركت است كه بهعنوان يك عامل محدودکننده هست. قلمرو، محدوده و چارچوب تحقيق را مشخص مینماید و خود شامل سه بخش هست:
@analysisacademy
قلمرو موضوعي : در اين قسمت موضوع تحقيق محدود میشود. مثلاً وقتي تحقيقي با عنوان « ارائه مدل عوامل مؤثر بر ارزش ویژه برند سامسونگ در گوشیهای هوشمند» هست بنابراین قلمرو موضوعی باید ارائه مدل برای ارزش ویژه برند سامسونگ آنهم تنها در بخش گوشیهای هوشمند سامسونگ باشد و شخص مثلاً نمیتواند در این بخش ارائه راهکار یا طبقهبندی عوامل و یا موضوعاتی مشابه را که در قلمرو این تحقیق نیست را وارد نماید.
@analysisacademy
قلمرو مكاني: اين بخش بهعنوان عامل محدودكننده جمعيت جامعه در بعد جغرافيايي و مكاني هست. در حقيقت قلمرو مكاني به محقق اعلان مینماید در چه نمونه آماری میتواند به تحليل و بررسي بپردازد و نتايج تحقيق را به چه جامعهای میتواند تعميم دهد. مثلاً در عنوان تحقیقی که ذکر شد باید مشخص شود که میخواهیم چه جامعه و چه نمونهای از آن را بررسی نماییم. مثلاً جامعه مشتریان گوشیهای هوشمند سامسونگ در شهر تهران هستند. خوب حالا که جامعه آماری و محدوده مکانی مشخصشده است باید نمونهای از همین جامعه انتخاب شود و درنهایت نتایج آزمونهای آماری استنباطی برای دادههای این نمونه، تنها به همین جامعه آماری قابلتعمیم است. متأسفانه اینیک ایراد بسیار بزرگ در بسیاری از پژوهشهای کشورمان است که افراد نتایج را به جامعه و بعد مکانی فراتر از جامعه و بعد مکانی تحقیق خود تعمیم میدهند. مثلاً نتایج این تحقیق را به مشتریان گوشیهای هوشمند سامسونگ در کل کشور تعمیم میدهند.بنابراین در اینجا شهر تهران بهعنوان محدوده مكاني پذیرفتهشده و محقق میبایست تحقيق خود را روي افراد همين جامعه صورت دهد.
@analysisacademy
قلمرو زماني: اين قلمرو، محدوده زماني را پوشش میدهد. البته توجه شود كه منظور از قلمرو زماني، دوره زماني است كه اطلاعات تحقیق در آن دوره جمعآوری و طبقهبندی و مورد تجزیهوتحلیل قرار میگیرند. یعنی فرد باید در این محدوده زمانی این عملیات را انجام دهد. متأسفانه بازهم در این بخش اشتباهات بزرگی انجام میشود که اعتبار نتایج تحقیق را کاهش میدهد و آن این است که محقق در پایان کار هرچقدر زمان تحقیق طول کشیده آن را بهعنوان محدوده زمانی وارد کار پایاننامه میکند. این در حالی است که آن محدوده زمانی است که باید مشخص کند برای عملیات میدانی چقدر زمان هست.
محسن مرادی
مطالب سایت و کانال بدون ذکر سایت منبع استفاده نشود.

http://analysisacademy.com/wp-content/uploads/2016/12/مدل-سازی-معادلات-ساختاری.png
@analysisacademy
استراتژیهای مدلسازی معادلات ساختاری
به مجموعهی راهبردهایی اشاره دارد که پژوهشگر را به مقصد خود یعنی ساخت مدل برای تخمین روابط بین متغیرهای مکنون و نیز پیش از آن تخمین روابط برای متغیر مکنون و متغیرهای آشکار است. درواقع هدف نهایی پژوهشگر این است که روابط مدل خویش را بر اساس دادههای جمعآوریشده از جامعه آماری تخمین زده و روابط برآمده از ادبیات پیشین پژوهش را تائید کند.
در این مقاله به سه دسته از این استراتژیهای مدلسازی معادلات ساختاری اشاره مینماییم:
@analysisacademy
استراتژی تائید مدل:
در این استراتژی محقق یک مدل شامل سازهها و روابط بین آنها را تدوین کرده و با استفاده از مدلسازی معادلات ساختاری بررسی میکند که چقدر مدل مورد انتظار در جامعه با مدلی که برآمده از دادههای جمعآوریشده از نمونه آماری است متناسب است. یعنی چقدر برازش مدل مناسب است.
@analysisacademy
استراتژی مقایسه مدل:
این استراتژی از طریق مقایسه مدل تخمین زدهشده با مدلهای جانشین دیگر صورت میپذیرد. در مدلسازی معادلات ساختاری همواره مدلهای جانشینی وجود دارند که میتوانند جای مدل فعلی قرار گیرند و محقق از طریق مقایسه مدل حاضر با مدلهای جانشین دیگر به بررسی برازش مدل میپردازد.
بحث مدلهای همارز که در کلاسهای آکادمی تحلیل آماری ایران موردبحث قرار میگیرد در همین دسته قرار دارد. اگر دوستان به خاطر داشته باشند مثلاً در نرمافزار لیزر، مدلهایی وجود دارد که متغیرها، همان متغیرهای مدل اصلی هست. اما روابط موجود بین متغیرها در مدلهای همارز متفاوت است و در حقیقت محقق باید با مقایسه مدل تدوینشده با سایر مدلهای همارز، بهترین مدل ازنظر برازش بهتر را انتخاب کند.
@analysisacademy
استراتژی توسعه مدل:
در این استراتژی به دنبال بهبود مدل اصلی تدوینشده توسط محقق هستیم. چون دوستان محقق در دورهها مشاهده کردند که وقتی مدلی را میخواهیم اجرا کنیم و روابط آن را تخمین بزنیم، ابتدا مدل اندازهگیری اولیه آن را تدوین و اجرا میکنیم. سپس اشکالات این مدل هم در بحثروایی و هم برازش ظاهر میشود که محقق در مرحله بعد باید آن را بهبود بخشد و مدل را اصلاح نماید. نکته ضروری اینجا این است که اصلاحات در مدل تنها باید بر مبنای ادبیات . پیشینه پژوهشی باشد.
محسن مرادی
مطالب سایت و کانال بدون ذکر سایت منبع استفاده نشود.
@analysisacademy
استراتژیهای مدلسازی معادلات ساختاری
به مجموعهی راهبردهایی اشاره دارد که پژوهشگر را به مقصد خود یعنی ساخت مدل برای تخمین روابط بین متغیرهای مکنون و نیز پیش از آن تخمین روابط برای متغیر مکنون و متغیرهای آشکار است. درواقع هدف نهایی پژوهشگر این است که روابط مدل خویش را بر اساس دادههای جمعآوریشده از جامعه آماری تخمین زده و روابط برآمده از ادبیات پیشین پژوهش را تائید کند.
در این مقاله به سه دسته از این استراتژیهای مدلسازی معادلات ساختاری اشاره مینماییم:
@analysisacademy
استراتژی تائید مدل:
در این استراتژی محقق یک مدل شامل سازهها و روابط بین آنها را تدوین کرده و با استفاده از مدلسازی معادلات ساختاری بررسی میکند که چقدر مدل مورد انتظار در جامعه با مدلی که برآمده از دادههای جمعآوریشده از نمونه آماری است متناسب است. یعنی چقدر برازش مدل مناسب است.
@analysisacademy
استراتژی مقایسه مدل:
این استراتژی از طریق مقایسه مدل تخمین زدهشده با مدلهای جانشین دیگر صورت میپذیرد. در مدلسازی معادلات ساختاری همواره مدلهای جانشینی وجود دارند که میتوانند جای مدل فعلی قرار گیرند و محقق از طریق مقایسه مدل حاضر با مدلهای جانشین دیگر به بررسی برازش مدل میپردازد.
بحث مدلهای همارز که در کلاسهای آکادمی تحلیل آماری ایران موردبحث قرار میگیرد در همین دسته قرار دارد. اگر دوستان به خاطر داشته باشند مثلاً در نرمافزار لیزر، مدلهایی وجود دارد که متغیرها، همان متغیرهای مدل اصلی هست. اما روابط موجود بین متغیرها در مدلهای همارز متفاوت است و در حقیقت محقق باید با مقایسه مدل تدوینشده با سایر مدلهای همارز، بهترین مدل ازنظر برازش بهتر را انتخاب کند.
@analysisacademy
استراتژی توسعه مدل:
در این استراتژی به دنبال بهبود مدل اصلی تدوینشده توسط محقق هستیم. چون دوستان محقق در دورهها مشاهده کردند که وقتی مدلی را میخواهیم اجرا کنیم و روابط آن را تخمین بزنیم، ابتدا مدل اندازهگیری اولیه آن را تدوین و اجرا میکنیم. سپس اشکالات این مدل هم در بحثروایی و هم برازش ظاهر میشود که محقق در مرحله بعد باید آن را بهبود بخشد و مدل را اصلاح نماید. نکته ضروری اینجا این است که اصلاحات در مدل تنها باید بر مبنای ادبیات . پیشینه پژوهشی باشد.
محسن مرادی
مطالب سایت و کانال بدون ذکر سایت منبع استفاده نشود.
http://analysisacademy.com/wp-content/uploads/2017/01/748-3538-1-PB.jpeg
@analysisacademy
تحلیل عاملی تاییدی چیست؟
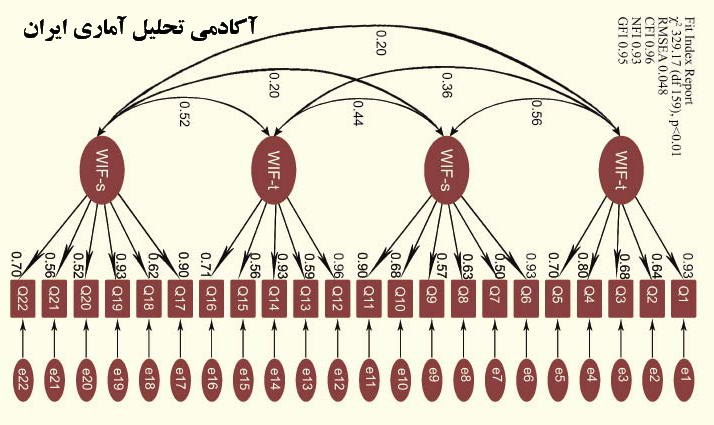
مهم ترین هدف تحلیل عاملی تاییدی تعیین میزان توان مدل عامل از قبل تعریف شده با مجموعه ای از داده های مشاهده شده است. به عبارتی تحلیل عاملی تاییدی درصدد تعیین این مساله است که آیا تعداد عامل ها و بارهای متغییرهایی که روی این عامل ها اندازه گیری شده اند با آنچه بر اساس تئوری و مدل نظری انتظار می رفت انطباق دارد. به عبارتی، این نوع تحلیل عاملی به آزمون میزان انطباق و همنوایی بین سازه نظری و سازه تجربی تحقیق می پردازد. در این روش ابتدا متغییرها و شاخص های مربوطه بر اساس تئوری اولیه انتخاب می شوند و سپس ازتحلیل عاملی استفاده می شود تا ببینیم که آیا این متغییرها و شاخص ها آن طوری که پیش بینی می شد روی عامل های پیش بینی شده بار(لود) شده اند یا این که ترکیب آنها عوض شده و روی عامل های دیگری بار شده اند؟
@analysisacademy
در این نوع تحلیل عاملی پیش فرض اساسی محقق این است که هر عاملی با زیرمجموعه خاصی از شاخص ها ارتباط دارد. حداقل شرط لازم برای تحلیل عاملی تاییدی این است که محقق قبل از هر چیزی تعداد عامل های مدل را فرض کند اما در عین حال معمولا این محقق انتظارات خود را مبنی بر این که کدام عامل ها بار خواهند شد دخیل می کند. برای مثال محقق سعی می کند تا تعیین کند که آیا متغییرهایی که برای ساخت و نمایش یک متغییر پنهان به کار می روند واقعا متعلق به هم هستند یا خیر؟ کاربردهای دیگری هم برای تحلیل عاملی تاییدی قابل ترسیم است که عبارتند از:
1-تعیین اعتبار یک مدل عاملی
2-مقایسه توان دو مدل متفاوت که مسئول مجموعه مشابهی از داده ها هستند.
3-آزمون معنی داری یک بار عاملی خاص
4-آزمون رابطه بین دو یا چند بار عاملی
5-آزمون این که آیا مجموعه عاملها با یکدیگر همبستگی دارند یا خیر؟
6-ارزیابی میزان اعتبار هم گرای مجموعه ای از متغییرها(میزان تجانس داخلی بین آنها)
7-سنجش اعتبار یک مقیاس یا شاخص از طریق نمایش این موضوع که گویه های همساز بر روی یک عامل بار می شوند. بنابراین به کمک این روش می توان گویه های ناهمساز مقیاس را که بر روی چندین عامل بار بسیار بالا یا پایینی دارند از مقیاس حذف کرد.چون این متغییرها را نمی توان به یک عامل مشخص انتساب داد.
@analysisacademy
نکته 1: بسیاری از روان شناسان بر این عقیده اند که تحلیل عامل تاییدی بر تحلیل عامل اکتشافی برتری دارد زیرا روش تحلیل تاییدی، فرضیه ها را مورد آزمون قرار می دهد و این آزمون فرضیه برای هر روش علمی امری اساسی است.
نکته 2: دستور تحلیل عامل تاییدی بر خلاف تحلیل عامل اکتشافی در نرم افزار spss وجود ندارد و انجام آن توسط نرم افزارهایی مانند لیزرل، ایموس و ...انجام می شود که دوستان می توانند با شرکت در دوره های آکادمی تحلیل آماری ایران به تمامی این نرم افزارها و تحلیل های آماری مربوطه تسلط پیدا کنند.
@analysisacademy
تحلیل عاملی تاییدی چیست؟
مهم ترین هدف تحلیل عاملی تاییدی تعیین میزان توان مدل عامل از قبل تعریف شده با مجموعه ای از داده های مشاهده شده است. به عبارتی تحلیل عاملی تاییدی درصدد تعیین این مساله است که آیا تعداد عامل ها و بارهای متغییرهایی که روی این عامل ها اندازه گیری شده اند با آنچه بر اساس تئوری و مدل نظری انتظار می رفت انطباق دارد. به عبارتی، این نوع تحلیل عاملی به آزمون میزان انطباق و همنوایی بین سازه نظری و سازه تجربی تحقیق می پردازد. در این روش ابتدا متغییرها و شاخص های مربوطه بر اساس تئوری اولیه انتخاب می شوند و سپس ازتحلیل عاملی استفاده می شود تا ببینیم که آیا این متغییرها و شاخص ها آن طوری که پیش بینی می شد روی عامل های پیش بینی شده بار(لود) شده اند یا این که ترکیب آنها عوض شده و روی عامل های دیگری بار شده اند؟
@analysisacademy
در این نوع تحلیل عاملی پیش فرض اساسی محقق این است که هر عاملی با زیرمجموعه خاصی از شاخص ها ارتباط دارد. حداقل شرط لازم برای تحلیل عاملی تاییدی این است که محقق قبل از هر چیزی تعداد عامل های مدل را فرض کند اما در عین حال معمولا این محقق انتظارات خود را مبنی بر این که کدام عامل ها بار خواهند شد دخیل می کند. برای مثال محقق سعی می کند تا تعیین کند که آیا متغییرهایی که برای ساخت و نمایش یک متغییر پنهان به کار می روند واقعا متعلق به هم هستند یا خیر؟ کاربردهای دیگری هم برای تحلیل عاملی تاییدی قابل ترسیم است که عبارتند از:
1-تعیین اعتبار یک مدل عاملی
2-مقایسه توان دو مدل متفاوت که مسئول مجموعه مشابهی از داده ها هستند.
3-آزمون معنی داری یک بار عاملی خاص
4-آزمون رابطه بین دو یا چند بار عاملی
5-آزمون این که آیا مجموعه عاملها با یکدیگر همبستگی دارند یا خیر؟
6-ارزیابی میزان اعتبار هم گرای مجموعه ای از متغییرها(میزان تجانس داخلی بین آنها)
7-سنجش اعتبار یک مقیاس یا شاخص از طریق نمایش این موضوع که گویه های همساز بر روی یک عامل بار می شوند. بنابراین به کمک این روش می توان گویه های ناهمساز مقیاس را که بر روی چندین عامل بار بسیار بالا یا پایینی دارند از مقیاس حذف کرد.چون این متغییرها را نمی توان به یک عامل مشخص انتساب داد.
@analysisacademy
نکته 1: بسیاری از روان شناسان بر این عقیده اند که تحلیل عامل تاییدی بر تحلیل عامل اکتشافی برتری دارد زیرا روش تحلیل تاییدی، فرضیه ها را مورد آزمون قرار می دهد و این آزمون فرضیه برای هر روش علمی امری اساسی است.
نکته 2: دستور تحلیل عامل تاییدی بر خلاف تحلیل عامل اکتشافی در نرم افزار spss وجود ندارد و انجام آن توسط نرم افزارهایی مانند لیزرل، ایموس و ...انجام می شود که دوستان می توانند با شرکت در دوره های آکادمی تحلیل آماری ایران به تمامی این نرم افزارها و تحلیل های آماری مربوطه تسلط پیدا کنند.
http://analysisacademy.com/wp-content/uploads/2016/08/fimix.png
@analysisacademy
دوره آموزشی: دوره آموزشی 24ساعته صفر تا صد لیزرل(LISREL) و ایموس(AMOS)با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی
زمان:چهارشنبه ،پنجشنبه وجمعه مصادف با 13 و 14 و 15 بهمن ماه 1395 از ساعت 13 تا 21
هزینه ثبت نام شرکت کنندگان آزاد 350 هزار تومان
هزینه ثبت نام دانشجویی 300هزار تومان
مدرس:دکتر محسن مرادی
محل تشکیل:آکادمی تحلیل آماری ایران
دوره آموزشی کاربردی مهارتی و تضمینی می باشد
رزرو با 09100071804
فرم ثبت نام کارگاه
دوره آموزشی: دوره آموزشی 16ساعته صفر تا صد اسمارت پی ال اس(SMART PLS) با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی
زمان: پنجشنبه وجمعه مصادف با 21 و 22 بهمن ماه 1395 از ساعت 13 تا 21
هزینه ثبت نام شرکت کنندگان آزاد 250 هزار تومان
هزینه ثبت نام دانشجویی 200هزار تومان
مدرس:دکتر محسن مرادی
محل تشکیل:آکادمی تحلیل آماری ایران
دوره آموزشی کاربردی مهارتی و تضمینی می باشد
رزرو با 09100071804
فرم ثبت نام کارگاه
مزیتها:
• آموزش نیمه خصوصی، عملیاتی و تضمینی است.
• این دوره ها نیاز به هیچ گونه پیش زمینه آموزشی ندارد و آموزشها از مقدماتی تا پیشرفته صورت می پذیرد.
• در پایان گواهینامه بین المللی معتبر از انگلستان به مدعوین اعطا خواهد شد که در جهت ارتقای رزومه محققین در داخل و خارج از کشور نقش بسزایی ایفا می کند.
• برای هر یک از مدعوین تضمین تسلط کامل و ۱۰۰درصد بر نرم افزار با متد نوین آموزش صورت میپذیرد.
• پس از دوره رفع اشکال به صورت تماس تلفنی و پاسخ به ایمیل مقدور می باشد.
• مهم ترین مزیت این دوره ها در مقایسه با دوره های دیگر این است که شما بر خلاف دوره های مشابه دیگر که صحبت از یادگیری با تعداد ساعت های کم یا تضمینی یاد گرفتن نرم افزار ها را می شنوید، در اینجا RUN کردن مدل ها و یادگیری نرم افزار ها تنها ده درصد مطالب کلاس را تشکیل می دهد. در واقع مدل ها های آزمون شده در نرم افزار اگر اغراق نباشد تنها یک نقاشی کم ارزش است و کار محقق تازه در کلاس از آن به بعد آغاز می شود. اینکه چطور فصل 3 و 4 پایان نامه خود را بنویسد یا چطور از این نرم افزار ها در نوشتن مقالات خود استفاده کند و یا چطور با توجه به استاندارد های روز دنیا این مطالب پیچیده آماری را به سادگی تفسیر و تحلیل کند وظیفه اصلی این دوره ها است که در دوره های موسسات یا اشخاص دیگر به گواهی شرکت کنندگان وجود ندارد. این موضوع دلیل اقبال محققین و دانشجویان عزیز در طی این چهار سال اخیر از دوره های آکادمی تحلیل آماری ایران است.
سخنی بسیار مهم با شما محقق عزیز:
پیش از اینکه به سرفصلهای دوره ها پرداخته شود باید چند نکته کوتاه اما بسیار پراهمیت را با شما در میان گذاریم:
این آکادمی، با برگزاری بیش از ۳۸۰ دوره آموزشی در تهران، شیراز، اصفهان، کرمان، مشهد،گیلان و مازندران، تبریز، ارس ، دوبی و دوحه قطر و … در حوزه پایان نامه نویسی، مقاله نویسی و تحلیل آماری کارهای پژوهشی صادقانه بیان می کند که شما با آموزش صحیح این مباحث قادر خواهید بود که کار فصل سوم، چهارم و به طور کلی آزمونهای آماری و پیشبرد سایر مراحل تحقیق خود را شخصا به عهده گیرید؛ متاسفانه افراد سودجو در موسسات غیرقانونی در میدان انقلاب و همین طور برگزارکننده های دوره های مجازی و فروشندگان بسته های آموزشی اکثرا سعی در اتلاف وقت و هزینه شما دارند. به گواهی کلیه اساتید و فراگیرانی که در این دوره ها شرکت کرده اند و به صورت موفقیت آمیز کار پژوهش خود را از ابتدا تا انتهای کار انجام داده اند و به این تخصص به عنوان یک حرفه کاملا درآمدزا نگریسته اند شما را به پرهیز از اعتماد به دیگران به جای اعتماد به خودتان دعوت می کنیم.
فراموش نکنید شما به جای صرف هزینه یک تا دو میلیون تومانی به طور مستقیم و هزینه های غیرمستقیم و بار روانی سنگین، با شرکت در دوره های کاملا کاربردی و تضمینی آکادمی که با شیوه نوین جهانی در ایران تنها و تنها توسط اساتید زبده و متخصص ما برگزار می گردد می توانید به انجام صفر تا صد تحلیل پایان نامه و مقالات خود پرداخته و همانند بسیاری از شرکت کنندگان این دوره ها علاوه بر اخذ یک گواهینامه بین المللی و تخصص در این حوزه مقالات معتبری را برای ادامه مسیر علمی تان در داخل و خارج از کشور به چاپ رسانید؛ حال انتخاب با شماست.
@analysisacademy
دوره آموزشی: دوره آموزشی 24ساعته صفر تا صد لیزرل(LISREL) و ایموس(AMOS)با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی
زمان:چهارشنبه ،پنجشنبه وجمعه مصادف با 13 و 14 و 15 بهمن ماه 1395 از ساعت 13 تا 21
هزینه ثبت نام شرکت کنندگان آزاد 350 هزار تومان
هزینه ثبت نام دانشجویی 300هزار تومان
مدرس:دکتر محسن مرادی
محل تشکیل:آکادمی تحلیل آماری ایران
دوره آموزشی کاربردی مهارتی و تضمینی می باشد
رزرو با 09100071804
فرم ثبت نام کارگاه
دوره آموزشی: دوره آموزشی 16ساعته صفر تا صد اسمارت پی ال اس(SMART PLS) با رویکرد نگارش مقالات علمی پژوهشی و پایان نامه ها" با اعطای گواهی نامه بین المللی
زمان: پنجشنبه وجمعه مصادف با 21 و 22 بهمن ماه 1395 از ساعت 13 تا 21
هزینه ثبت نام شرکت کنندگان آزاد 250 هزار تومان
هزینه ثبت نام دانشجویی 200هزار تومان
مدرس:دکتر محسن مرادی
محل تشکیل:آکادمی تحلیل آماری ایران
دوره آموزشی کاربردی مهارتی و تضمینی می باشد
رزرو با 09100071804
فرم ثبت نام کارگاه
مزیتها:
• آموزش نیمه خصوصی، عملیاتی و تضمینی است.
• این دوره ها نیاز به هیچ گونه پیش زمینه آموزشی ندارد و آموزشها از مقدماتی تا پیشرفته صورت می پذیرد.
• در پایان گواهینامه بین المللی معتبر از انگلستان به مدعوین اعطا خواهد شد که در جهت ارتقای رزومه محققین در داخل و خارج از کشور نقش بسزایی ایفا می کند.
• برای هر یک از مدعوین تضمین تسلط کامل و ۱۰۰درصد بر نرم افزار با متد نوین آموزش صورت میپذیرد.
• پس از دوره رفع اشکال به صورت تماس تلفنی و پاسخ به ایمیل مقدور می باشد.
• مهم ترین مزیت این دوره ها در مقایسه با دوره های دیگر این است که شما بر خلاف دوره های مشابه دیگر که صحبت از یادگیری با تعداد ساعت های کم یا تضمینی یاد گرفتن نرم افزار ها را می شنوید، در اینجا RUN کردن مدل ها و یادگیری نرم افزار ها تنها ده درصد مطالب کلاس را تشکیل می دهد. در واقع مدل ها های آزمون شده در نرم افزار اگر اغراق نباشد تنها یک نقاشی کم ارزش است و کار محقق تازه در کلاس از آن به بعد آغاز می شود. اینکه چطور فصل 3 و 4 پایان نامه خود را بنویسد یا چطور از این نرم افزار ها در نوشتن مقالات خود استفاده کند و یا چطور با توجه به استاندارد های روز دنیا این مطالب پیچیده آماری را به سادگی تفسیر و تحلیل کند وظیفه اصلی این دوره ها است که در دوره های موسسات یا اشخاص دیگر به گواهی شرکت کنندگان وجود ندارد. این موضوع دلیل اقبال محققین و دانشجویان عزیز در طی این چهار سال اخیر از دوره های آکادمی تحلیل آماری ایران است.
سخنی بسیار مهم با شما محقق عزیز:
پیش از اینکه به سرفصلهای دوره ها پرداخته شود باید چند نکته کوتاه اما بسیار پراهمیت را با شما در میان گذاریم:
این آکادمی، با برگزاری بیش از ۳۸۰ دوره آموزشی در تهران، شیراز، اصفهان، کرمان، مشهد،گیلان و مازندران، تبریز، ارس ، دوبی و دوحه قطر و … در حوزه پایان نامه نویسی، مقاله نویسی و تحلیل آماری کارهای پژوهشی صادقانه بیان می کند که شما با آموزش صحیح این مباحث قادر خواهید بود که کار فصل سوم، چهارم و به طور کلی آزمونهای آماری و پیشبرد سایر مراحل تحقیق خود را شخصا به عهده گیرید؛ متاسفانه افراد سودجو در موسسات غیرقانونی در میدان انقلاب و همین طور برگزارکننده های دوره های مجازی و فروشندگان بسته های آموزشی اکثرا سعی در اتلاف وقت و هزینه شما دارند. به گواهی کلیه اساتید و فراگیرانی که در این دوره ها شرکت کرده اند و به صورت موفقیت آمیز کار پژوهش خود را از ابتدا تا انتهای کار انجام داده اند و به این تخصص به عنوان یک حرفه کاملا درآمدزا نگریسته اند شما را به پرهیز از اعتماد به دیگران به جای اعتماد به خودتان دعوت می کنیم.
فراموش نکنید شما به جای صرف هزینه یک تا دو میلیون تومانی به طور مستقیم و هزینه های غیرمستقیم و بار روانی سنگین، با شرکت در دوره های کاملا کاربردی و تضمینی آکادمی که با شیوه نوین جهانی در ایران تنها و تنها توسط اساتید زبده و متخصص ما برگزار می گردد می توانید به انجام صفر تا صد تحلیل پایان نامه و مقالات خود پرداخته و همانند بسیاری از شرکت کنندگان این دوره ها علاوه بر اخذ یک گواهینامه بین المللی و تخصص در این حوزه مقالات معتبری را برای ادامه مسیر علمی تان در داخل و خارج از کشور به چاپ رسانید؛ حال انتخاب با شماست.
سرفصل ها:
–نحوه نوشتن پروپوزال یا طرح تحقیق برای پایان نامه ها و مقالات علمی و پژوهشی مبتنی بر SEM
–آشنایی کامل با مدلسازی معادلات ساختاری
–جمع آوری داده ها و نحوه پیش پردازش داده ها به صورت عملیاتی
–نحوه ایجاد Path Diagrams در محیط نرم افزارها
–تحلیل عاملی تاییدی CFAو سنجش برازش CFA
–بررسی پایایی و روایی سازه
–اجرای مدل ساختاری و ارزیابی و تحلیل نتایج
–اجرای تحلیل عاملی مرتبه دوم پیرامون متغییرهایی با مولفه های مختلف
–اجرا و تحلیل مدلهای ساختاری با متغییرهای میانجی
–اجرا و تحلیل مدلهایی با متغییرهای تعدیل گر در روش های مختلف
–نحوه تهیه گزارش نهایی و تفسیر آن برای پایان نامه ها و مقالات علمی و پژوهشی و ISI
و…
مدرس: دکتر محسن مرادی
دکتری مدیریت بازرگانی
تحلیل گر بیش از 500 پروژه تخصصی
مشاور تحقیقات بازار ۱۵ شرکت اقتصادی در تهران و شهرستانها
مدرس دوره های تحقیقات کمی و کیفی بین المللی
و مدرس همایش های بین المللی
رزرو با : ۰۹۱۰۰۰۷۱۸۰۴
جهت مشاوره رایگان دوره با شماره بالا تماس گیرید
"تخفیف ویژه برای دانشجویان تحصیلات تکمیلی ارشد و دکتری"
جهت کسب اطلاعات روزانه در مورد دوره های کمی و کیفی هفته های آتی آکادمی تحلیل آماری ایران پیج ما در اینستاگرام را فالو نمایید:
https://www.instagram.com/ analysisacademy
توجه:کسانی که فرصت حضور در کلاسهای آکادمی را ندارند به تعداد محدود می توانند از شرایط ویژه مشاوره و انجام تحلیل آماری فصل سوم و چهارم پایان نامه یا مقاله خود توسط تیم مجرب آکادمی زیر نظر دکتر مرادی بهره مند شوند. جهت اعمال نظر تیم مذکور درخواست خود را به ایمیلanalysisacademy1@gmail. com ارسال فرمایید.
آدرس: تهران، خیابان مطهری،بین میرعماد و مفتح، جنب ایستگاه مترو مفتح، پلاک ۲۴۰، طبقه دوم، آکادمی تحلیل آماری ایران
شماره تماس جهت مشاوره: ۰۹۱۰۰۰۷۱۸۰۴
فرم ثبت نام کارگاه
http://analysisacademy.com
کانال تلگرام آکادمی تحلیل آماری ایران جهت استفاده از مطالب مفید و تاریخ دوره ها
https://telegram.me/analysisacademy
–نحوه نوشتن پروپوزال یا طرح تحقیق برای پایان نامه ها و مقالات علمی و پژوهشی مبتنی بر SEM
–آشنایی کامل با مدلسازی معادلات ساختاری
–جمع آوری داده ها و نحوه پیش پردازش داده ها به صورت عملیاتی
–نحوه ایجاد Path Diagrams در محیط نرم افزارها
–تحلیل عاملی تاییدی CFAو سنجش برازش CFA
–بررسی پایایی و روایی سازه
–اجرای مدل ساختاری و ارزیابی و تحلیل نتایج
–اجرای تحلیل عاملی مرتبه دوم پیرامون متغییرهایی با مولفه های مختلف
–اجرا و تحلیل مدلهای ساختاری با متغییرهای میانجی
–اجرا و تحلیل مدلهایی با متغییرهای تعدیل گر در روش های مختلف
–نحوه تهیه گزارش نهایی و تفسیر آن برای پایان نامه ها و مقالات علمی و پژوهشی و ISI
و…
مدرس: دکتر محسن مرادی
دکتری مدیریت بازرگانی
تحلیل گر بیش از 500 پروژه تخصصی
مشاور تحقیقات بازار ۱۵ شرکت اقتصادی در تهران و شهرستانها
مدرس دوره های تحقیقات کمی و کیفی بین المللی
و مدرس همایش های بین المللی
رزرو با : ۰۹۱۰۰۰۷۱۸۰۴
جهت مشاوره رایگان دوره با شماره بالا تماس گیرید
"تخفیف ویژه برای دانشجویان تحصیلات تکمیلی ارشد و دکتری"
جهت کسب اطلاعات روزانه در مورد دوره های کمی و کیفی هفته های آتی آکادمی تحلیل آماری ایران پیج ما در اینستاگرام را فالو نمایید:
https://www.instagram.com/ analysisacademy
توجه:کسانی که فرصت حضور در کلاسهای آکادمی را ندارند به تعداد محدود می توانند از شرایط ویژه مشاوره و انجام تحلیل آماری فصل سوم و چهارم پایان نامه یا مقاله خود توسط تیم مجرب آکادمی زیر نظر دکتر مرادی بهره مند شوند. جهت اعمال نظر تیم مذکور درخواست خود را به ایمیلanalysisacademy1@gmail. com ارسال فرمایید.
آدرس: تهران، خیابان مطهری،بین میرعماد و مفتح، جنب ایستگاه مترو مفتح، پلاک ۲۴۰، طبقه دوم، آکادمی تحلیل آماری ایران
شماره تماس جهت مشاوره: ۰۹۱۰۰۰۷۱۸۰۴
فرم ثبت نام کارگاه
http://analysisacademy.com
کانال تلگرام آکادمی تحلیل آماری ایران جهت استفاده از مطالب مفید و تاریخ دوره ها
https://telegram.me/analysisacademy
آکادمی تحلیل آماری ایران
آکادمی تحلیل آماری ایران | مدرسه پژوهش کمی و کیفی
معتبرترین مرکز تربیت پژوهشگر در رویکردهای کمی، کیفی، آمیخته و مروری. با مجوز رسمی آموزش فنیوحرفهای و اعطای گواهینامه معتبر بینالمللی به دانشپذیران
http://analysisacademy.com/wp-content/uploads/2017/01/Formative.Reflective.jpg
@analysisacademy
متغیرهای پنهان که غالباً در علوم اجتماعی نمایانگر سازه ها Construct هستند به دو صورت می توانند طراحی شوند: انعکاسی (Reflective) یا ترکیبی ( Formative) . نشانگرهای )سوالات( متغیرهای انعکاسی شبیه به هم و قابل معاوضه هستند و رابطه ی قوی بین آنها برقرار است .بنابراین اگر یکی از نشانگرها را حذف کنیم معنی متغیر پنهان تغییر نمی کند. در متغیرهای پنهان انعکاسی جهت علیت Causality از متغیر پنهان به سمت نشانگرهاست. به عبارت دیگر متغیر پنهان علت و نشانگر ها معلول هستند.در مقابل نشانگرهای متغیرهای پنهان ترکیبی جنبه های مختلف یک سازه(Construct) را اندازه گیری می کنند و قابل معاوضه نیستند و با حذف حتی یکی از نشانگر ها،معنیِ متغیر پنهان ناقص شده و به نوعی تغییر خواهد کرد. در متغیرهای پنهان ترکیبی فرضی مبنی بر رابطه ی مثبتِ قوی بین نشانگرها وجود ندارد و هر نشانگر یا به عبارتی سوال به بعد جداگانه ای از سازه ی مورد نظر اشاره می کند. در این حالت مسیر علیت هم از نشانگرها به متغیر پنهان است و این نشانگرها هستند که متغیر پنهان را فرم و شکل می دهند.
@analysisacademy
در شکل ۱ رضایتمندی خوانندگان از این کتاب به صورت انعکاسی اندازه گیری شده است و همانطور که می بینید انتظار می رود رابطه ی مثبت قوی بین نشانگر های متغیر پنهان وجود داشته باشد. به این معنی که اگر شما از مطالعه ی این کتاب لذت ببرید (نشانگر اول) دوست دارید باز هم این کتاب را مطالعه کنید (نشانگر دوم) و احتمالاً خواندن این کتاب را به دوستانتان هم توصیه می کنید (نشانگر سوم). ضمناً با حذف یکی از نشانگر ها معنی متغیر پنهان تغییر نخواهد کرد. به عنوان مثال رضایتمندی می تواند به تنهایی با استفاده از دو سوال از سه سوال طراحی شده اندازه گیری شود. در واقع هر سوال به تنهایی رضایتمندی شما از این کتاب را تا حدی اندازه گیری می کند. از طرف دیگر همانطور که در شکل می بینید علّیت از رضایتمندی به سمت نشانگرهاست. به این دلیل که اگر شما از مطالعه ی این کتاب رضایت داشته باشید از آن لذت می برید و احتمالاً دوباره آنرا مطالعه کرده و به دوستانتان معرفی می کنید. برای روشن تر شدن مطلب عکس این حالت را در نظر بگیرید. آیا چون این کتاب را به دوستانتان توصیه خواهید کرد از این کتاب رضایت دارید؟! خیر! پس علّیت از متغیر پنهان به نشانگرها جریان دارد ؛به جهت فلش ها از متغیر پنهان به نشانگرها توجه کنید
@analysisacademy
در مدل ترکیبی )شکل ۲) همانطور که در شکل می بینید رضایتمندی توسط جنبه های مختلف آن اندازه گیری شده است. فونت کتاب، صفحه بندی و قیمت فروش جنبه های مختلفی هستند که اگر خاطر شما را فراهم کنند در مجموع شما از این کتاب رضایت خواهید داشت. بنابراین نشانگرها قابل معاوضه نیستند و با حذف یک نشکانگر معنی متغیر پنهان ناقص خواهد بود. برای مثال با حذف سوال "فونت این کتاب مناسب است" و تنها با در نظر گرفتن صفحه بندی و قیمت پشت جلد نمی توان رضایتمندی نسبت به کتاب را به طور کامل ارزیابی کرد. ضمناً نمی توان ادعا کرد که لزوماً رابطه ی مثبت قوی بین نشانگر ها برقرار است. برای مثال ممکن است شما از فونت کتاب خشنود و راضی باشید ولی صفحه بندی باب میل شما نباشد. یا امکان دارد صفحه بندی از نظر شما مناسب باشد ولی قیمت فروش کتاب از نظر شما منصفانه نباشد. در آخر اینکه علیت از نشانگرها به متغیر پنهان در جریان است.اگر شما فونت کتاب، صفحه بندی و قیمت را بپسندید در مجموع از این کتاب راضی هستید . به عبارت دیگر میزان رضایتمندی شما از این کتاب موجب تغییر فونت کتاب، صفحه بندی یا قیمت کتاب نمی شود )فلشها از نشانگرها به متغیر پنهان کشیده شده اند(.تحلیل این مدلها به تفضیل در دوره های آکادمی تحلیل آماری ایران آموزش داده می شوند.
@analysisacademy
متغیرهای پنهان که غالباً در علوم اجتماعی نمایانگر سازه ها Construct هستند به دو صورت می توانند طراحی شوند: انعکاسی (Reflective) یا ترکیبی ( Formative) . نشانگرهای )سوالات( متغیرهای انعکاسی شبیه به هم و قابل معاوضه هستند و رابطه ی قوی بین آنها برقرار است .بنابراین اگر یکی از نشانگرها را حذف کنیم معنی متغیر پنهان تغییر نمی کند. در متغیرهای پنهان انعکاسی جهت علیت Causality از متغیر پنهان به سمت نشانگرهاست. به عبارت دیگر متغیر پنهان علت و نشانگر ها معلول هستند.در مقابل نشانگرهای متغیرهای پنهان ترکیبی جنبه های مختلف یک سازه(Construct) را اندازه گیری می کنند و قابل معاوضه نیستند و با حذف حتی یکی از نشانگر ها،معنیِ متغیر پنهان ناقص شده و به نوعی تغییر خواهد کرد. در متغیرهای پنهان ترکیبی فرضی مبنی بر رابطه ی مثبتِ قوی بین نشانگرها وجود ندارد و هر نشانگر یا به عبارتی سوال به بعد جداگانه ای از سازه ی مورد نظر اشاره می کند. در این حالت مسیر علیت هم از نشانگرها به متغیر پنهان است و این نشانگرها هستند که متغیر پنهان را فرم و شکل می دهند.
@analysisacademy
در شکل ۱ رضایتمندی خوانندگان از این کتاب به صورت انعکاسی اندازه گیری شده است و همانطور که می بینید انتظار می رود رابطه ی مثبت قوی بین نشانگر های متغیر پنهان وجود داشته باشد. به این معنی که اگر شما از مطالعه ی این کتاب لذت ببرید (نشانگر اول) دوست دارید باز هم این کتاب را مطالعه کنید (نشانگر دوم) و احتمالاً خواندن این کتاب را به دوستانتان هم توصیه می کنید (نشانگر سوم). ضمناً با حذف یکی از نشانگر ها معنی متغیر پنهان تغییر نخواهد کرد. به عنوان مثال رضایتمندی می تواند به تنهایی با استفاده از دو سوال از سه سوال طراحی شده اندازه گیری شود. در واقع هر سوال به تنهایی رضایتمندی شما از این کتاب را تا حدی اندازه گیری می کند. از طرف دیگر همانطور که در شکل می بینید علّیت از رضایتمندی به سمت نشانگرهاست. به این دلیل که اگر شما از مطالعه ی این کتاب رضایت داشته باشید از آن لذت می برید و احتمالاً دوباره آنرا مطالعه کرده و به دوستانتان معرفی می کنید. برای روشن تر شدن مطلب عکس این حالت را در نظر بگیرید. آیا چون این کتاب را به دوستانتان توصیه خواهید کرد از این کتاب رضایت دارید؟! خیر! پس علّیت از متغیر پنهان به نشانگرها جریان دارد ؛به جهت فلش ها از متغیر پنهان به نشانگرها توجه کنید
@analysisacademy
در مدل ترکیبی )شکل ۲) همانطور که در شکل می بینید رضایتمندی توسط جنبه های مختلف آن اندازه گیری شده است. فونت کتاب، صفحه بندی و قیمت فروش جنبه های مختلفی هستند که اگر خاطر شما را فراهم کنند در مجموع شما از این کتاب رضایت خواهید داشت. بنابراین نشانگرها قابل معاوضه نیستند و با حذف یک نشکانگر معنی متغیر پنهان ناقص خواهد بود. برای مثال با حذف سوال "فونت این کتاب مناسب است" و تنها با در نظر گرفتن صفحه بندی و قیمت پشت جلد نمی توان رضایتمندی نسبت به کتاب را به طور کامل ارزیابی کرد. ضمناً نمی توان ادعا کرد که لزوماً رابطه ی مثبت قوی بین نشانگر ها برقرار است. برای مثال ممکن است شما از فونت کتاب خشنود و راضی باشید ولی صفحه بندی باب میل شما نباشد. یا امکان دارد صفحه بندی از نظر شما مناسب باشد ولی قیمت فروش کتاب از نظر شما منصفانه نباشد. در آخر اینکه علیت از نشانگرها به متغیر پنهان در جریان است.اگر شما فونت کتاب، صفحه بندی و قیمت را بپسندید در مجموع از این کتاب راضی هستید . به عبارت دیگر میزان رضایتمندی شما از این کتاب موجب تغییر فونت کتاب، صفحه بندی یا قیمت کتاب نمی شود )فلشها از نشانگرها به متغیر پنهان کشیده شده اند(.تحلیل این مدلها به تفضیل در دوره های آکادمی تحلیل آماری ایران آموزش داده می شوند.

http://analysisacademy.com/wp-content/uploads/2017/01/PLS.SEM_.png
@analysisacademy
(Partial least squares structural equation modeling (PLS-SEM
این مقاله یکی از مقالات مرجع در حوزه مدل سازی معادلات ساختاری با رویکرد حداقل مربعات جزیی است که در آن علاوه بر بحث پیرامون استفاده از این ابزار در کسب و کار و مدیریت کسب و کار، به مقایسه ی دو رویکرد کواریانس محور و واریانس محور و پیش فرض های آن ها پرداخته شده است. سپس بحث مدل های اندازه گیری(بیرونی) ترکیبی و انعکاسی مطرح شده و این دو مدل با هم مقایسه گردیده اند. سپس به سراغ مدل درونی یا همان مدل ساختاری رفته و شاخص های مختلف بررسی پیش بینی متغیر های وابسته مثل R square و f square و Q square ….. مورد بررسی قرار گرفته است. سرانجام مقاله با بحثی کوتاه پیرامون مدل هایی با متغیر میانجی و نیز متغیر تعدیلگر به پایان رسیده است. در هر حال همه این مطالب به صورت مفصل در کلاس های آکادمی تحلیل آماری ایران مورد بحث کامل نظری و عملیاتی قرار گرفته است. اما دوستان محقق آکادمی و نیز سایر عزیزان از آن برای رفرنس مطالب و کنکاش عمیق تر در بحث مدل سازی معادلات ساختاری واریانس محور می توانند بهره ببرند. این مقاله از مقالات دکتر هایر و همکارانش در سال ۲۰۱۴ است که از آن در دوره ها نکان بسیاری گفته شده است. این مقاله را شما میتوانید با عضویت در سایت دریافت کنید. عضویت کمتر از ۳۰ ثانیه زمان میخواهد و شما تنها با وارد کردن ایمیل خود و نام کاربری برای خودتان که در پنجره سمت راست سایت می بینید میتوانید لینک دانلود مقاله را ملاحظه کنید.
@analysisacademy
Partial least squares structural equation modeling (PLS-SEM)
An emerging tool in business research
Joe F. Hair Jr
Department of Marketing & Professional Sales, Kennesaw State University, Kennesaw, Georgia, USA
Marko Sarstedt
Otto-von-Guericke-University Magdeburg, Magdeburg, Germany and University of Newcastle, Newcastle, Australia
Lucas Hopkins
Middle Georgia State College, Macon, Georgia, USA, and
Volker G. Kuppelwieser
NEOMA Business School, Mont-Saint-Aignan, France
@analysisacademy
(Partial least squares structural equation modeling (PLS-SEM
این مقاله یکی از مقالات مرجع در حوزه مدل سازی معادلات ساختاری با رویکرد حداقل مربعات جزیی است که در آن علاوه بر بحث پیرامون استفاده از این ابزار در کسب و کار و مدیریت کسب و کار، به مقایسه ی دو رویکرد کواریانس محور و واریانس محور و پیش فرض های آن ها پرداخته شده است. سپس بحث مدل های اندازه گیری(بیرونی) ترکیبی و انعکاسی مطرح شده و این دو مدل با هم مقایسه گردیده اند. سپس به سراغ مدل درونی یا همان مدل ساختاری رفته و شاخص های مختلف بررسی پیش بینی متغیر های وابسته مثل R square و f square و Q square ….. مورد بررسی قرار گرفته است. سرانجام مقاله با بحثی کوتاه پیرامون مدل هایی با متغیر میانجی و نیز متغیر تعدیلگر به پایان رسیده است. در هر حال همه این مطالب به صورت مفصل در کلاس های آکادمی تحلیل آماری ایران مورد بحث کامل نظری و عملیاتی قرار گرفته است. اما دوستان محقق آکادمی و نیز سایر عزیزان از آن برای رفرنس مطالب و کنکاش عمیق تر در بحث مدل سازی معادلات ساختاری واریانس محور می توانند بهره ببرند. این مقاله از مقالات دکتر هایر و همکارانش در سال ۲۰۱۴ است که از آن در دوره ها نکان بسیاری گفته شده است. این مقاله را شما میتوانید با عضویت در سایت دریافت کنید. عضویت کمتر از ۳۰ ثانیه زمان میخواهد و شما تنها با وارد کردن ایمیل خود و نام کاربری برای خودتان که در پنجره سمت راست سایت می بینید میتوانید لینک دانلود مقاله را ملاحظه کنید.
@analysisacademy
Partial least squares structural equation modeling (PLS-SEM)
An emerging tool in business research
Joe F. Hair Jr
Department of Marketing & Professional Sales, Kennesaw State University, Kennesaw, Georgia, USA
Marko Sarstedt
Otto-von-Guericke-University Magdeburg, Magdeburg, Germany and University of Newcastle, Newcastle, Australia
Lucas Hopkins
Middle Georgia State College, Macon, Georgia, USA, and
Volker G. Kuppelwieser
NEOMA Business School, Mont-Saint-Aignan, France
http://analysisacademy.com/wp-content/uploads/2017/01/validity.qualitative.jpg
@analysisacademy
روایی در تحقیق کیفی
با وجود اینکه معیار روایی ریشه در پارادایم اثـبات گـرایی و کـمّی دارد محققان کیفی میتوانند با تعریف مجدد این معیار بر مبنای هستی شناسی و روش شناسی تـفسیری از آن در جهت ارتقاء باورپذیری و قابل دفاع بودن تحقیق خود بهره بگیرند.
محققان کیفی در رابطه با بحث روایی موضع گـیریهای مـختلفی داشتهاند، برخی معتقدند که روایی بعنوان یک معیار سنتی کمّی هیچ ارتباطی با تحقیق کیفی ندارد و چون فرضیات شناخت شناسی و هستی شناسی پارادایمهای کمّی و کیفی متفاوتند لذا باید مفهوم روایی نـیز در تـحقیقات کیفی کـنار گذاشته شود.
البته بیشتر محققان کیفی نگرش متعادلتری نسبت به بحث روایی دارند و معتقدند که برخی مـطالعات کیفی بهتر از برخی دیگر هستند و اغلب واژه روایی را برای اشاره به ایـن تـفاوت ذکـر مینمایند. این محققان کیفی هنگامی که از روایی تحقیق صحبت میکنند معمولاً به واژههایی همچون باورپذیری، قابل دفـاع و امـانت دار بودن اشاره میکنند.
بر خلاف تحقیقات کمّی، در میان تحقیقات کیفی هیچ آزمون اسـتانداردی برای روایی وجود ندارد و غالباً ماهیت تحقیق توسط خود محقق تعیین و جرح و تـعدیل میشود و حتی ممکن اسـت هـیچ فرضیه اولیهای وجود نداشته باشد. برخی محققان (بویژه محققان کیفی) بیان داشته انـد کـه روایـی صرفاً آزمونی واحد برای فـرآیند تـحقیق بـعنوان یک کل نیست، بلکه میتوان معیار روایی را با توجه به عقاید محقق بصورت متفاوت برای هر یک از مراحل فرآیند، در صورت نـیاز بـکار بـرد (وینتر, ۲۰۰۰, ص ۴).
با این نگرش، ماکسول انواع مختلفی از روایـی را در ارتـباط بامراحل مختلف تحقیق تعریف کرده است. در ادامه این مقاله، نوع شناسی انجام شده توسط ماکسول و برخی استراتژیهای ارتـقاء روایـی تـحقیقات کیفی ارائه میگردد.
روایی توصیفی(Descriptive Validity)
روایی توصیفی به صـحت دادهـای مـوضوع گزارش شده توسط محقق اشاره مینماید (ماکسول, ۱۹۹۲, ص ۲۸۲) پرسشهای کلیدی در روایی توصیفی عبارتند از: آیا رویدادی کـه تـوسط مـحقق گزارش شده است، واقعاً در گروه مورد مطالعه اتفاق افتاده است؟ و آیا محققان دقـیقاً آنـچه را که دیده و شنیدهاند، گزارش کردهاند؟ بعبارت دیگر روایی توصیفی به صحت در گزارش اطلاعات توصیفی (مانند توصیف حـوادث، اشـیاء، رفتارها، افراد، مجموعهها، زمانها و مکانها) اشاره دارد. این نوع از رواییبدین جهت مـهم مـیباشد که یکی از اهداف عمده در همه تحقیقات کـیفی، تـوصیف اسـت.
استراتژی مؤثر برای کسب روایی توصیفی، تـکثر مـشاهده گران میباشد. در روایی توصیفی، تکثر مشاهدهگران به معنی استفاده از چندین مشاهدهگر برای ثـبت و تـوصیف رفتار مشارکت کنندهها و زمینهای کـه در آن قـرار دارند مـیباشد. بـهرهگیری از چـندین مشاهده گر امکان کنترل چندگانه مـشاهدات بـرای اطمینان از توافق مشاهدهگران در مورد آنچه اتفاق افتاده را بوجود میآورد. زمانی که مـشاهدات تـوسط چندین مشاهدهگر تأیید شود، امکان کـمتری وجود دارد که ناظران خـارجی تـحقیق، صحت مشاهدات گزارش شده را مـورد شـک قرار دهند (جانسون, ۱۹۷۷, ص۲۸۵).
روایی تفسیری(Interpretative validity)
محققان کیفی صرفاً به ارائه یک توصیف بهتر از اشـیاء فـیزیکی، حوادث و رفتارها در مجموعه مورد تـحقیق اکـتفا نـمیکنند بلکه به مـعانی کـه افراد مورد مطالعه بـه ایـن اشیاء، حوادث و رفتارها میدهند نیز توجه میکنند (ماکسول, ۱۹۹۲, ص ۲۸۸). در حالیکه روایی توصیفی به صحت در گـزارش کـردن دادهها اشاره مینماید، روایی تفسیری نـیاز بـه ایجاد پنـجرهای بـه درون اذهـان افراد مورد مطالعه دارد. روایـی تفسیری به بازنمایی دقیق مفهومی که مشارکت کننده به موضوع مورد مطالعه داده است اشاره مـی کـند. بطور مشخص تر، روایی تفسیری بـه درجـهای کـه نـگرش، افـکار، احساسات، نیات و تـجربیات مـشارکت کننده بطور دقیق توسط محقق درک و گزارش میشود ارتباط دارد.
یک بخش مهم تحقیق کیفی درک جهان درونی مـشارکت کـنندگان اسـت و روایی تفسیری بیانگر درجه دقت در ارائه این جـهان درونـی اسـت. دقـت روایـی تـفسیری نیازمند این است که محقق اذهان و تفکرات مشارکت کنندگان را درک نماید و از نگاه آنها به موضوع بنگرد و آنچه را که آنها احساس میکنند، احساس کند و در نهایت بیانی معتبر از این دیـدگاهها ارائه کند.
@analysisacademy
روایی در تحقیق کیفی
با وجود اینکه معیار روایی ریشه در پارادایم اثـبات گـرایی و کـمّی دارد محققان کیفی میتوانند با تعریف مجدد این معیار بر مبنای هستی شناسی و روش شناسی تـفسیری از آن در جهت ارتقاء باورپذیری و قابل دفاع بودن تحقیق خود بهره بگیرند.
محققان کیفی در رابطه با بحث روایی موضع گـیریهای مـختلفی داشتهاند، برخی معتقدند که روایی بعنوان یک معیار سنتی کمّی هیچ ارتباطی با تحقیق کیفی ندارد و چون فرضیات شناخت شناسی و هستی شناسی پارادایمهای کمّی و کیفی متفاوتند لذا باید مفهوم روایی نـیز در تـحقیقات کیفی کـنار گذاشته شود.
البته بیشتر محققان کیفی نگرش متعادلتری نسبت به بحث روایی دارند و معتقدند که برخی مـطالعات کیفی بهتر از برخی دیگر هستند و اغلب واژه روایی را برای اشاره به ایـن تـفاوت ذکـر مینمایند. این محققان کیفی هنگامی که از روایی تحقیق صحبت میکنند معمولاً به واژههایی همچون باورپذیری، قابل دفـاع و امـانت دار بودن اشاره میکنند.
بر خلاف تحقیقات کمّی، در میان تحقیقات کیفی هیچ آزمون اسـتانداردی برای روایی وجود ندارد و غالباً ماهیت تحقیق توسط خود محقق تعیین و جرح و تـعدیل میشود و حتی ممکن اسـت هـیچ فرضیه اولیهای وجود نداشته باشد. برخی محققان (بویژه محققان کیفی) بیان داشته انـد کـه روایـی صرفاً آزمونی واحد برای فـرآیند تـحقیق بـعنوان یک کل نیست، بلکه میتوان معیار روایی را با توجه به عقاید محقق بصورت متفاوت برای هر یک از مراحل فرآیند، در صورت نـیاز بـکار بـرد (وینتر, ۲۰۰۰, ص ۴).
با این نگرش، ماکسول انواع مختلفی از روایـی را در ارتـباط بامراحل مختلف تحقیق تعریف کرده است. در ادامه این مقاله، نوع شناسی انجام شده توسط ماکسول و برخی استراتژیهای ارتـقاء روایـی تـحقیقات کیفی ارائه میگردد.
روایی توصیفی(Descriptive Validity)
روایی توصیفی به صـحت دادهـای مـوضوع گزارش شده توسط محقق اشاره مینماید (ماکسول, ۱۹۹۲, ص ۲۸۲) پرسشهای کلیدی در روایی توصیفی عبارتند از: آیا رویدادی کـه تـوسط مـحقق گزارش شده است، واقعاً در گروه مورد مطالعه اتفاق افتاده است؟ و آیا محققان دقـیقاً آنـچه را که دیده و شنیدهاند، گزارش کردهاند؟ بعبارت دیگر روایی توصیفی به صحت در گزارش اطلاعات توصیفی (مانند توصیف حـوادث، اشـیاء، رفتارها، افراد، مجموعهها، زمانها و مکانها) اشاره دارد. این نوع از رواییبدین جهت مـهم مـیباشد که یکی از اهداف عمده در همه تحقیقات کـیفی، تـوصیف اسـت.
استراتژی مؤثر برای کسب روایی توصیفی، تـکثر مـشاهده گران میباشد. در روایی توصیفی، تکثر مشاهدهگران به معنی استفاده از چندین مشاهدهگر برای ثـبت و تـوصیف رفتار مشارکت کنندهها و زمینهای کـه در آن قـرار دارند مـیباشد. بـهرهگیری از چـندین مشاهده گر امکان کنترل چندگانه مـشاهدات بـرای اطمینان از توافق مشاهدهگران در مورد آنچه اتفاق افتاده را بوجود میآورد. زمانی که مـشاهدات تـوسط چندین مشاهدهگر تأیید شود، امکان کـمتری وجود دارد که ناظران خـارجی تـحقیق، صحت مشاهدات گزارش شده را مـورد شـک قرار دهند (جانسون, ۱۹۷۷, ص۲۸۵).
روایی تفسیری(Interpretative validity)
محققان کیفی صرفاً به ارائه یک توصیف بهتر از اشـیاء فـیزیکی، حوادث و رفتارها در مجموعه مورد تـحقیق اکـتفا نـمیکنند بلکه به مـعانی کـه افراد مورد مطالعه بـه ایـن اشیاء، حوادث و رفتارها میدهند نیز توجه میکنند (ماکسول, ۱۹۹۲, ص ۲۸۸). در حالیکه روایی توصیفی به صحت در گـزارش کـردن دادهها اشاره مینماید، روایی تفسیری نـیاز بـه ایجاد پنـجرهای بـه درون اذهـان افراد مورد مطالعه دارد. روایـی تفسیری به بازنمایی دقیق مفهومی که مشارکت کننده به موضوع مورد مطالعه داده است اشاره مـی کـند. بطور مشخص تر، روایی تفسیری بـه درجـهای کـه نـگرش، افـکار، احساسات، نیات و تـجربیات مـشارکت کننده بطور دقیق توسط محقق درک و گزارش میشود ارتباط دارد.
یک بخش مهم تحقیق کیفی درک جهان درونی مـشارکت کـنندگان اسـت و روایی تفسیری بیانگر درجه دقت در ارائه این جـهان درونـی اسـت. دقـت روایـی تـفسیری نیازمند این است که محقق اذهان و تفکرات مشارکت کنندگان را درک نماید و از نگاه آنها به موضوع بنگرد و آنچه را که آنها احساس میکنند، احساس کند و در نهایت بیانی معتبر از این دیـدگاهها ارائه کند.

مهمترین استراتژی برای کسب روایی تفسیری، بازخور مشارکت کننده است. در این استراتژی، محقق تفسیرهای خود را به مشارکت کنندگان ارائه نموده و زمینه های بد درک شده را مشخص و اصلاح میکند، بعبارتی آیا افـراد مـورد مطالعه با آنچه محقق در مورد آنها گفته است، موافقند؟ البته این استراتژی بی نقص نیست و در مواردی امکان دارد مشارکتکنندگان سعی نمایند که چهره خوبی را از خود ارائه کنند.
استراتژی دیگر، استفاده از برخی تـوصیف کـنندهها هنگام نوشتن گزارش تحقیق است، بطوریکه خواننده بتواند زبان، لهجه و معانی خاص مشارکت کنندگان را حس کند. بعنوان مثال، یک نقل قول مستقیم کـه در آن دقـیقاً واژه های بیان شده توسط مـشارکت کـننده در داخل گیومه ذکر گردیده، می تواند توصیف کننده مناسبی باشد (جانسون, ۱۹۹۷, ص ۲۸۵).
روایی تئوریکی(Theoretical Validity)
سومین نوع روایی در تحقیق کیفی، روایی تئوریک است و به میزان سـازگاری بـین تبیین تئوریکی تحقیق کـیفی بـا داده ها ارتباط دارد. تئوری به مباحث چگونگی و چرایی عمل یک پدیده اشاره می نماید و معمولاً انتزاعی تر از توصیف و تفسیر بوده و تبیینی از پدیده ارائه میکند. هر تئوری دو جزء دارد: مفاهیم یا دسته بندیهایی کـه تـئوری بکار میگیرد، و روابطی که تصور میشود میان این مفاهیم وجود دارد. در ارتباط با این دو جنبه تئوری، روایی تئوری نیز دارای دو جنبه میباشد: روایی مفاهیم بکار رفته برای پدیده و روایی روابط فرض شـده مـیان مفاهیم (مـاکسول, ۱۹۹۲, ص۲۹۱).
در تحقیق کیفی شکل گیری مفهوم یک بخش اصلی از تحلیل دادهها است و در طی جمعآوری دادهها شروع میشود، بـنابراین مفهوم سازی روشی است که محقق کیفی، دادهها را سازماندهی و درک میکند. یـکی از تـفاوتهای عـمده میان تحلیلهای کمّی و کیفی در این است که محققان کمّی، تحلیل دادهها را تا موقعی که همه دادهها جـمعآوری و بـصورت اعداد تبدیل نشوند شروع نمیکنند، آنها سپس بمنظور مشاهده الگوها و روابط، این اعـداد را دسـتکاری مـینمایند.
محققان کیفی نیز بدنبال یافتن الگوها و روابط میباشند اما آنها تحلیل را در حالیکه هنوز در حال جـمع آوری دادهها هستند شروع میکنند، بگونهای که نتایج تحلیلهای اولیه مراحل بعدی جـمعآوری داده را هدایت میکند. به عـبارتی دیـگر تئوری و اطلاعات بموازات هم حرکت میکنند و مکمل یکدیگرند (فقیهی، ۱۳۷۶ صص46- 39).
روایی ارزیابی(Evaluative Validity)
تمایز این جنبه از روایی با انواع ذکر شـده در ایـن است که شامل مباحثی در مورد کـاربرد چـارچوبهای اخـلاقی یـا هـنجاری و قضاوتهایی در مورد مـوضوع مـیباشد (نوریس, ۱۹۹۷, ص ۱۷۵).
مطالب کانال و سایت بدون ذکر سایت منبع استفاده نگردد.
استراتژی دیگر، استفاده از برخی تـوصیف کـنندهها هنگام نوشتن گزارش تحقیق است، بطوریکه خواننده بتواند زبان، لهجه و معانی خاص مشارکت کنندگان را حس کند. بعنوان مثال، یک نقل قول مستقیم کـه در آن دقـیقاً واژه های بیان شده توسط مـشارکت کـننده در داخل گیومه ذکر گردیده، می تواند توصیف کننده مناسبی باشد (جانسون, ۱۹۹۷, ص ۲۸۵).
روایی تئوریکی(Theoretical Validity)
سومین نوع روایی در تحقیق کیفی، روایی تئوریک است و به میزان سـازگاری بـین تبیین تئوریکی تحقیق کـیفی بـا داده ها ارتباط دارد. تئوری به مباحث چگونگی و چرایی عمل یک پدیده اشاره می نماید و معمولاً انتزاعی تر از توصیف و تفسیر بوده و تبیینی از پدیده ارائه میکند. هر تئوری دو جزء دارد: مفاهیم یا دسته بندیهایی کـه تـئوری بکار میگیرد، و روابطی که تصور میشود میان این مفاهیم وجود دارد. در ارتباط با این دو جنبه تئوری، روایی تئوری نیز دارای دو جنبه میباشد: روایی مفاهیم بکار رفته برای پدیده و روایی روابط فرض شـده مـیان مفاهیم (مـاکسول, ۱۹۹۲, ص۲۹۱).
در تحقیق کیفی شکل گیری مفهوم یک بخش اصلی از تحلیل دادهها است و در طی جمعآوری دادهها شروع میشود، بـنابراین مفهوم سازی روشی است که محقق کیفی، دادهها را سازماندهی و درک میکند. یـکی از تـفاوتهای عـمده میان تحلیلهای کمّی و کیفی در این است که محققان کمّی، تحلیل دادهها را تا موقعی که همه دادهها جـمعآوری و بـصورت اعداد تبدیل نشوند شروع نمیکنند، آنها سپس بمنظور مشاهده الگوها و روابط، این اعـداد را دسـتکاری مـینمایند.
محققان کیفی نیز بدنبال یافتن الگوها و روابط میباشند اما آنها تحلیل را در حالیکه هنوز در حال جـمع آوری دادهها هستند شروع میکنند، بگونهای که نتایج تحلیلهای اولیه مراحل بعدی جـمعآوری داده را هدایت میکند. به عـبارتی دیـگر تئوری و اطلاعات بموازات هم حرکت میکنند و مکمل یکدیگرند (فقیهی، ۱۳۷۶ صص46- 39).
روایی ارزیابی(Evaluative Validity)
تمایز این جنبه از روایی با انواع ذکر شـده در ایـن است که شامل مباحثی در مورد کـاربرد چـارچوبهای اخـلاقی یـا هـنجاری و قضاوتهایی در مورد مـوضوع مـیباشد (نوریس, ۱۹۹۷, ص ۱۷۵).
مطالب کانال و سایت بدون ذکر سایت منبع استفاده نگردد.
http://analysisacademy.com/wp-content/uploads/2017/01/Fig-1-Canonical-correlation-of-perceived-travel-constraints-and-destination-image.png
@analysisacademy
همبستگی کانونی(همبستگی بنیادی)
تاکنون در کلاسهای آکادمی تحلیل آماری ایران با انواع ضرایب همبستگی مثل وی کرامرز و دی سامرز و کاپای کوهن و ….. که متأسفانه در فضای علمی و پژوهشی کشور کمتر استفاده میشود آشنا شده ایم و بیان کردیم هنگامیکه دو متغیر با انواع سطح سنجش nominal و ordinal و scale داریم چگونه میتوانیم رابطه و همبستگی بین آنها را بررسی نماییم. اما در بسیاری از مواقع متغیرها خود شامل مؤلفههای چندگانه هستند. مثلاً تعهد سازمانی خود شامل سه مؤلفهی تعهد عاطفی و تعهد مستمر و تعهد هنجاری است. حال اگر بخواهیم رابطهی این سازه را با سازههای دیگری که خود دارای مؤلفههای مختلف هستند چه راهکاری را باید در پیش گیریم. و یا با تحقیقاتی مواجه هستیم که گروهی از متغیرها در یک سمت و گروهی از متغیرها در سمت دیگر قرار دارند و ما قصد داریم همبستگی بین این دو مجموعه را به دست آوریم.
خوب مسلماً ضرایب همبستگی معمول و حتی تحلیلهای علی مثل رگرسیونهای چندگانه از انجام آن ناتوان هستند. در اینجاست که تحلیل همبستگی کانونی یا همان همبستگی بنیادی انجام این هدف را ممکن میسازد(گرین، ۱۹۷۸)
همبستگی کانونی یا همبستگی بنیادی برخلاف دیگر روشها که تنها به بررسی همتغییری دو متغیر میپردازد قادر است رابطه بین چند مجموعه از متغیرها را باهم بررسی نماید. علاوه بر این اگر بین مجموعه متغیرها دو یا سه رابطه وجود داشته باشد تکنیک همبستگی کانونی قادر به تشخیص و نشان دادن آنها است(شری، ۲۰۰۵).
تحلیل همبستگی کانونی(همبستگی بنیادی) بهعنوان درون داد اساسی خود با دو مجموعه متغیر که به هر یک از آنها میتوان یک معنای نظری داد سروکار دارد. استراتژیهای اساسی آن عبارت است از استنتاج یک ترکیب خطی از مجموعهای از متغیرها بهگونهای که همبستگی بین دو ترکیب خطی بیشینه شود(هومن، ۱۳۸۰).
مفاهیم اصلی تحلیل همبستگی کانونی(همبستگی بنیادی)
متغیرهای کانونی( Canonical variable)
درواقع شبیه به همان متغیرهای مکنون(پنهان) در مدلسازی معادلات ساختاری هستند و شامل نماینده جمع بهینهشدهی دو یا چند متغیر هست.
ضریب همبستگی کانونی( Canonical Correlation Coefficient)
ضریب همبستگی بین دو متغیر کانونی را ضریب همبستگی کانونی(همبستگی بنیادی) میگویند. همانطور که قبلاً گفته شد هر متغیر کانونی شامل ترکیب خطی یا نماینده جمع بهینهشده دو یا چند متغیر است(هایر و همکاران، ۲۰۰۶).
تابع کانونی Canonical Function))
خوب تا اینجا آموختیم که هر متغیر کانونی شامل ترکیب خطی یا نماینده جمع بهینهشده دو یا چند متغیر است. حال همبستگی بین دو متغیر کانونی تشکیل تابعی به نام تابع کانونی میدهد(مرادی، ۱۳۹۵). مثلا متغیر کانونی مثل X از ترکیب خطی چند متغیر اصلی تشکیل می شود.
وزنهای کانونی (Weight Canonical)
وزن کانونی درواقع سهم هر یک از متغیرهای اصلی در ضریب همبستگی کانونی یا بنیادی است. این وزنها دقیقه مثل ضرایب رگرسیونی و ضرایب مسیر تفسیر میشوند.
بارهای کانونی (Canonical Loading)
همبستگی ساده خطی میان متغیرهای اصلی و متغیرهای کانونی متناظر آنها است که همبستگی ساختاری نیز گفته میشود. درواقع میتوان گفت متغیرهای کانونی شبیه همان متغیرهای مکنون و متغیرهای اصلی شبیه همان سؤالات و شاخصها در تحلیل عاملی تأییدی است.
ریشه کانونی(Canonical roots)
این شاخص در حقیقت مجذور ضریب همبستگی کانونی(همبستگی بنیادی) هست. یعنی نشان میدهد که چقدر یک مجموعه از متغیرها میتوانند رفتار مجموعهای دیگر از متغیرها را پیشبینی و تبیین نمایند. این شاخص را مقدار ویژه نیز معرفی میکنند. اگر میخواهیم فهم دقیقی نسبت به آن داشته باشیم باید بدانیم که با ضریب تعیین در رگرسیون قابلمقایسه است.
در شکل زیر با تمامی مفاهیم گفته شده آشنا می شویم. در شکل زیر دو متغیر کانونی وجود دارند که خود از ترکیب خطی متغیر های متناظرشان تشکیل شده اند. همانطور که مشخص است متغیر کانونی محدودیت های سفر خود شامل مجموعه ای ۴ تایی از متغیر های اصلی است و متغیر کانونی تصویر مقصد نیز خود شامل مجموعه ای ۳ تایی از متغیر های اصلی است. وظیفه تکنیک همبستگی کانونی(همبستگی بنیادی) این است که رابطه ی این دو مجموعه را بدست آورد.
اگر به شکل دقت شود ضریب همبستگی کانونی ۰٫۲۷۳ است و اگر آن را به توان ۲ برسانیم در حقیقت ریشه کانونی را بدست آورده ایم. همچنین این مدل شامل ۷ ضریب بار کانونی است که در حقیقت ضریب همبستگی هر متغیر اصلی را با متغیر کانونی متناظرش بدست می آورد.(مرادی، ۱۳۹۵).
این تحلیل از طریق نرم افزار های مختلفی قابل انجام است. در این مقاله به مسیر آن در نرم افزار spss اشاره می شود.
@analysisacademy
همبستگی کانونی(همبستگی بنیادی)
تاکنون در کلاسهای آکادمی تحلیل آماری ایران با انواع ضرایب همبستگی مثل وی کرامرز و دی سامرز و کاپای کوهن و ….. که متأسفانه در فضای علمی و پژوهشی کشور کمتر استفاده میشود آشنا شده ایم و بیان کردیم هنگامیکه دو متغیر با انواع سطح سنجش nominal و ordinal و scale داریم چگونه میتوانیم رابطه و همبستگی بین آنها را بررسی نماییم. اما در بسیاری از مواقع متغیرها خود شامل مؤلفههای چندگانه هستند. مثلاً تعهد سازمانی خود شامل سه مؤلفهی تعهد عاطفی و تعهد مستمر و تعهد هنجاری است. حال اگر بخواهیم رابطهی این سازه را با سازههای دیگری که خود دارای مؤلفههای مختلف هستند چه راهکاری را باید در پیش گیریم. و یا با تحقیقاتی مواجه هستیم که گروهی از متغیرها در یک سمت و گروهی از متغیرها در سمت دیگر قرار دارند و ما قصد داریم همبستگی بین این دو مجموعه را به دست آوریم.
خوب مسلماً ضرایب همبستگی معمول و حتی تحلیلهای علی مثل رگرسیونهای چندگانه از انجام آن ناتوان هستند. در اینجاست که تحلیل همبستگی کانونی یا همان همبستگی بنیادی انجام این هدف را ممکن میسازد(گرین، ۱۹۷۸)
همبستگی کانونی یا همبستگی بنیادی برخلاف دیگر روشها که تنها به بررسی همتغییری دو متغیر میپردازد قادر است رابطه بین چند مجموعه از متغیرها را باهم بررسی نماید. علاوه بر این اگر بین مجموعه متغیرها دو یا سه رابطه وجود داشته باشد تکنیک همبستگی کانونی قادر به تشخیص و نشان دادن آنها است(شری، ۲۰۰۵).
تحلیل همبستگی کانونی(همبستگی بنیادی) بهعنوان درون داد اساسی خود با دو مجموعه متغیر که به هر یک از آنها میتوان یک معنای نظری داد سروکار دارد. استراتژیهای اساسی آن عبارت است از استنتاج یک ترکیب خطی از مجموعهای از متغیرها بهگونهای که همبستگی بین دو ترکیب خطی بیشینه شود(هومن، ۱۳۸۰).
مفاهیم اصلی تحلیل همبستگی کانونی(همبستگی بنیادی)
متغیرهای کانونی( Canonical variable)
درواقع شبیه به همان متغیرهای مکنون(پنهان) در مدلسازی معادلات ساختاری هستند و شامل نماینده جمع بهینهشدهی دو یا چند متغیر هست.
ضریب همبستگی کانونی( Canonical Correlation Coefficient)
ضریب همبستگی بین دو متغیر کانونی را ضریب همبستگی کانونی(همبستگی بنیادی) میگویند. همانطور که قبلاً گفته شد هر متغیر کانونی شامل ترکیب خطی یا نماینده جمع بهینهشده دو یا چند متغیر است(هایر و همکاران، ۲۰۰۶).
تابع کانونی Canonical Function))
خوب تا اینجا آموختیم که هر متغیر کانونی شامل ترکیب خطی یا نماینده جمع بهینهشده دو یا چند متغیر است. حال همبستگی بین دو متغیر کانونی تشکیل تابعی به نام تابع کانونی میدهد(مرادی، ۱۳۹۵). مثلا متغیر کانونی مثل X از ترکیب خطی چند متغیر اصلی تشکیل می شود.
وزنهای کانونی (Weight Canonical)
وزن کانونی درواقع سهم هر یک از متغیرهای اصلی در ضریب همبستگی کانونی یا بنیادی است. این وزنها دقیقه مثل ضرایب رگرسیونی و ضرایب مسیر تفسیر میشوند.
بارهای کانونی (Canonical Loading)
همبستگی ساده خطی میان متغیرهای اصلی و متغیرهای کانونی متناظر آنها است که همبستگی ساختاری نیز گفته میشود. درواقع میتوان گفت متغیرهای کانونی شبیه همان متغیرهای مکنون و متغیرهای اصلی شبیه همان سؤالات و شاخصها در تحلیل عاملی تأییدی است.
ریشه کانونی(Canonical roots)
این شاخص در حقیقت مجذور ضریب همبستگی کانونی(همبستگی بنیادی) هست. یعنی نشان میدهد که چقدر یک مجموعه از متغیرها میتوانند رفتار مجموعهای دیگر از متغیرها را پیشبینی و تبیین نمایند. این شاخص را مقدار ویژه نیز معرفی میکنند. اگر میخواهیم فهم دقیقی نسبت به آن داشته باشیم باید بدانیم که با ضریب تعیین در رگرسیون قابلمقایسه است.
در شکل زیر با تمامی مفاهیم گفته شده آشنا می شویم. در شکل زیر دو متغیر کانونی وجود دارند که خود از ترکیب خطی متغیر های متناظرشان تشکیل شده اند. همانطور که مشخص است متغیر کانونی محدودیت های سفر خود شامل مجموعه ای ۴ تایی از متغیر های اصلی است و متغیر کانونی تصویر مقصد نیز خود شامل مجموعه ای ۳ تایی از متغیر های اصلی است. وظیفه تکنیک همبستگی کانونی(همبستگی بنیادی) این است که رابطه ی این دو مجموعه را بدست آورد.
اگر به شکل دقت شود ضریب همبستگی کانونی ۰٫۲۷۳ است و اگر آن را به توان ۲ برسانیم در حقیقت ریشه کانونی را بدست آورده ایم. همچنین این مدل شامل ۷ ضریب بار کانونی است که در حقیقت ضریب همبستگی هر متغیر اصلی را با متغیر کانونی متناظرش بدست می آورد.(مرادی، ۱۳۹۵).
این تحلیل از طریق نرم افزار های مختلفی قابل انجام است. در این مقاله به مسیر آن در نرم افزار spss اشاره می شود.
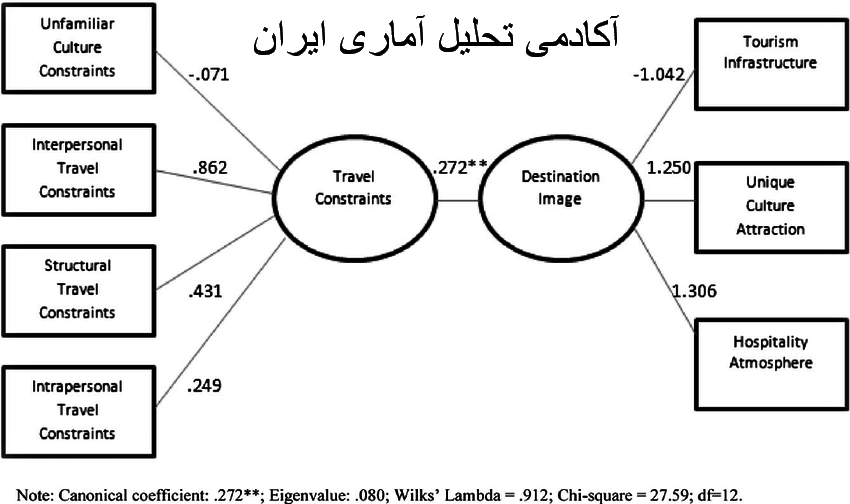
آدرس اجرای دستور در spss :
analyze……correlate……..canonical correlation
سپس در صفحه دیالوگ باز شونده در نرم افزار دو پنجره set1 و set2 را مشاهده می کنیم. متغیر های هر مجموعه را در پنجره خود وارد کرده و کلید ok را می زنیم. در نهایت نباید فراموش کرد که در مدل سازی معادلات ساختاری برای زمانی که تاثیر یک سازه مولفه دار را بر سازه ای مولفه دار دیگر می سنجیم در حقیقت با تکنیکی کامل تر همین کار را انجام می دهیم و ضریب مسیر بین دو سازه همان همبستگی کانونی بین دو سازه است. از دانشجویان آکادمی تحلیل آماری خواستارم کمی با دقت بیشتر به شیاهت ها و تفاوت های این دو تکنیک آماری توجه نمایند.
محسن مرادی
مطالب سایت و کانال بدون ذکر منبع سایت آکادمی در جای دیگر استفاده نشود.
analyze……correlate……..canonical correlation
سپس در صفحه دیالوگ باز شونده در نرم افزار دو پنجره set1 و set2 را مشاهده می کنیم. متغیر های هر مجموعه را در پنجره خود وارد کرده و کلید ok را می زنیم. در نهایت نباید فراموش کرد که در مدل سازی معادلات ساختاری برای زمانی که تاثیر یک سازه مولفه دار را بر سازه ای مولفه دار دیگر می سنجیم در حقیقت با تکنیکی کامل تر همین کار را انجام می دهیم و ضریب مسیر بین دو سازه همان همبستگی کانونی بین دو سازه است. از دانشجویان آکادمی تحلیل آماری خواستارم کمی با دقت بیشتر به شیاهت ها و تفاوت های این دو تکنیک آماری توجه نمایند.
محسن مرادی
مطالب سایت و کانال بدون ذکر منبع سایت آکادمی در جای دیگر استفاده نشود.