
Схема аутрича «1+2» вскрывает покупные ссылки перед алгоритмами
Аутрич-команды рубят площадки без пузомерок
Вся эта работа раз за разом идет насмарку из-за одного: кривой интеграции ссылки, когда опытный сеошник, команда веб-спама или алгоритмы Google легко считывают, кто именно пропихнул линк на страницу.
Тот же провал теперь бьет по неестественным упоминаниям в
Опытные веб-авторы ставят ссылки по почти идентичным лекалам, поэтому ссылочные привычки — это стабильный, предсказуемый элемент поведения.
Автор обучил модель глубокого обучения на гигабайтах данных и миллиардах токенов органических и коммерческих ссылочных графов; получая голый текст, сетка предсказывает, куда живой человек воткнул бы линк.
Тесты на экспертной статье показали 93% уверенности — с поправкой на промахи и ложные срабатывания.
Детектор покупных ссылок автора подсвечивает плейсменты, которые ломают эти паттерны.
Дальше логика проста: если эта модель отличает органику от заказухи, модели Google тоже могут.
Вот почему большинство аутрич-ссылок игнорируются или работают как слабый негативный сигнал.
Правило "1+2" бьет по той самой естественности, ради которой создавалось.
Обычный паблишер с редакционным сбором в $150 пропускает только один коммерческий линк и требует 1-3 ссылки на новости, госсайты или траст.
По данным автора, эта схема:
— помогает алгоритмическому детектированию
— дает шаблон для ручных санкций
— делает пост менее естественным
Органический контент часто несет 10-20 ссылок на страницу, тогда как классические сетки блогов держат планку в 2-3 линка на пост.
Четыре правила делают ссылку редакционной:
— Свободная линковка: ссылайся на любую страницу, полезную читателю, включая чужие домены.
— Цель: каждая ссылка решает одну из десяти задач (включая промо), поэтому коммерческий линк выживает, только если проходит тот же фильтр, что и остальные.
— Приоритет: ссылка ведет на сильнейшую из возможных страниц для этого места, исходя из логики, контекста, нарратива и релевантности.
— Естественный анкор: используй те же формулировки, что и сам донор, простой текст без точного вхождения ключа.
Все четыре правила рушатся, если строчка написана исключительно ради ссылки.
Желание читателя кликнуть достигает пика там, где текст называет источник, делает заявление или упоминает что-то стоящее проверки, и естественная ссылка всегда сидит на одном из таких пиков.
Детектор ошибается, и статья это доказывает.
Подсвеченный флаг покупной ссылки оказался ложным: агентство заявило, что линк органический, и автор это признал.
Форензика показала, что флаг сработал из-за сигналов
Линк также стоял мимо пика читательского интереса и вел на главную вместо конкретной страницы кейса.
Рабочий тест не требует нейросетей: спроси другого сеошника: "Кто пропихнул ссылку на эту страницу"?.
Если он угадал с первого раза — интеграция никуда не годится.
https://dejan.ai/blog/outreach/
#LinkBuilding #PaidLinks #Outreach
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Аутрич-команды рубят площадки без пузомерок
DA, PA или DR, а SEO-индустрия отравила контент-рынок правилом "1+2": одна коммерческая ссылка плюс пара трастовых, чтобы "выглядело естественно".Вся эта работа раз за разом идет насмарку из-за одного: кривой интеграции ссылки, когда опытный сеошник, команда веб-спама или алгоритмы Google легко считывают, кто именно пропихнул линк на страницу.
Тот же провал теперь бьет по неестественным упоминаниям в
AI-поиске, где органическая выдача служит базовым слоем извлечения.Опытные веб-авторы ставят ссылки по почти идентичным лекалам, поэтому ссылочные привычки — это стабильный, предсказуемый элемент поведения.
Автор обучил модель глубокого обучения на гигабайтах данных и миллиардах токенов органических и коммерческих ссылочных графов; получая голый текст, сетка предсказывает, куда живой человек воткнул бы линк.
Тесты на экспертной статье показали 93% уверенности — с поправкой на промахи и ложные срабатывания.
Детектор покупных ссылок автора подсвечивает плейсменты, которые ломают эти паттерны.
Дальше логика проста: если эта модель отличает органику от заказухи, модели Google тоже могут.
Вот почему большинство аутрич-ссылок игнорируются или работают как слабый негативный сигнал.
Правило "1+2" бьет по той самой естественности, ради которой создавалось.
Обычный паблишер с редакционным сбором в $150 пропускает только один коммерческий линк и требует 1-3 ссылки на новости, госсайты или траст.
По данным автора, эта схема:
— помогает алгоритмическому детектированию
— дает шаблон для ручных санкций
— делает пост менее естественным
Органический контент часто несет 10-20 ссылок на страницу, тогда как классические сетки блогов держат планку в 2-3 линка на пост.
Четыре правила делают ссылку редакционной:
— Свободная линковка: ссылайся на любую страницу, полезную читателю, включая чужие домены.
— Цель: каждая ссылка решает одну из десяти задач (включая промо), поэтому коммерческий линк выживает, только если проходит тот же фильтр, что и остальные.
— Приоритет: ссылка ведет на сильнейшую из возможных страниц для этого места, исходя из логики, контекста, нарратива и релевантности.
— Естественный анкор: используй те же формулировки, что и сам донор, простой текст без точного вхождения ключа.
Все четыре правила рушатся, если строчка написана исключительно ради ссылки.
Желание читателя кликнуть достигает пика там, где текст называет источник, делает заявление или упоминает что-то стоящее проверки, и естественная ссылка всегда сидит на одном из таких пиков.
Детектор ошибается, и статья это доказывает.
Подсвеченный флаг покупной ссылки оказался ложным: агентство заявило, что линк органический, и автор это признал.
Форензика показала, что флаг сработал из-за сигналов
Blend и Independence: это была единственная внешняя редакционная ссылка в посте, при этом бизнес Hunter Talent (герой кейса) ссылки не получил.Линк также стоял мимо пика читательского интереса и вел на главную вместо конкретной страницы кейса.
Рабочий тест не требует нейросетей: спроси другого сеошника: "Кто пропихнул ссылку на эту страницу"?.
Если он угадал с первого раза — интеграция никуда не годится.
https://dejan.ai/blog/outreach/
#LinkBuilding #PaidLinks #Outreach
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤4🙊1
Слитый атрибут contentEffort опровергает политику Google — алгоритм отслеживает ручной труд над контентом
Официальная позиция Google: неважно, как делается контент, главное — чтобы он был полезным.
Слитый алгоритм доказывает обратное.
В утечке алгоритма Google за 2025 год нашли атрибут
Значит, игнорирование или подделка усилий над контентом может алгоритмически срезать видимость.
Слово "
Определение асессоров: степень, в которой человек активно поработал над созданием удовлетворяющего контента.
Пример с самой низкой оценкой — страница, которая переупаковывает чужую работу без источников, без экспертного мнения и без признаков оригинальных усилий — типичный формат ИИ-статьи.
Публичные доки
Атрибуция не заменяет необходимость оригинальных усилий.
Чем
— это не объем текста
— это не глубина, так как ИИ отлично ресерчит
— это не время, потраченное на допиливание промпта, чтобы он звучал как ты
Главный тест заключается не в том, читается ли текст как ИИ, и даже не в том, полезен ли он — а в том, есть ли в нем что-то новое, что стоит показать в выдаче.
Под эту трактовку выстраиваются три сигнала: ежегодные санкции спам-апдейтов, которые бьют по сайтам с ИИ-контентом, новый патент на детект "
https://www.annsmarty.com/p/content-effort-one-of-googles-signals
#GoogleLeak #CoreUpdates #HCU
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Официальная позиция Google: неважно, как делается контент, главное — чтобы он был полезным.
Слитый алгоритм доказывает обратное.
В утечке алгоритма Google за 2025 год нашли атрибут
contentEffort; является ли он прямым фактором ранжирования и насколько сильно двигает видимость — неизвестно, но считается, что он лежал в основе HCU и позже был вшит в кор-апдейты.Значит, игнорирование или подделка усилий над контентом может алгоритмически срезать видимость.
Слово "
Effort" встречается 120 раз в Quality Rater Guidelines.Определение асессоров: степень, в которой человек активно поработал над созданием удовлетворяющего контента.
Пример с самой низкой оценкой — страница, которая переупаковывает чужую работу без источников, без экспертного мнения и без признаков оригинальных усилий — типичный формат ИИ-статьи.
Публичные доки
Search Central теперь несут параллельное определение, покрывающее ручной труд над контентом или системами, которые его генерируют: написание оригинальной аналитики, ручной перевод стихотворения или сборка кастомной интерактивной карты — это высокий уровень усилий; генерация страниц из фидов или использование генеративного ИИ для выдачи больших объемов текста без ручной модерации или курации — это мало или вообще ничего.Атрибуция не заменяет необходимость оригинальных усилий.
Чем
effort не является:— это не объем текста
— это не глубина, так как ИИ отлично ресерчит
— это не время, потраченное на допиливание промпта, чтобы он звучал как ты
Effort — это человеческое время, потраченное на то, чтобы сделать материал по-настоящему оригинальным, потому что веб уже перенасыщен переупакованным контентом.Главный тест заключается не в том, читается ли текст как ИИ, и даже не в том, полезен ли он — а в том, есть ли в нем что-то новое, что стоит показать в выдаче.
Под эту трактовку выстраиваются три сигнала: ежегодные санкции спам-апдейтов, которые бьют по сайтам с ИИ-контентом, новый патент на детект "
AI slop" и обновленная документация с требованием маркировать ИИ-контент — и всё это выкатили прямо перед самым длинным спам-апдейтом в истории.https://www.annsmarty.com/p/content-effort-one-of-googles-signals
#GoogleLeak #CoreUpdates #HCU
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤3
Внутренние тайминги Google показывают: индексация занимает 1.5 часа, а мусорные страницы зависают навсегда
Быстрая техничка не ускорит страницы, которые Гугл не считает ценными.
Внутренняя аналитика таймингов Google, впервые представленная на
В колонке тормозов регулярно всплывает "никогда" — и обычно это жестко завязано на качество.
Тайминги краулинга, от типичных к самым долгим:
— Обнаружение нового
— Обновление известного
— Обработка
— Обновление
— Апдейт лимитов краулинга (crawl capacity): от 4 часов до 1-2 недель → 1-3 недели при восстановлении
Лимиты краулинга могут упасть за секунды, когда Google дает заднюю — например, если сервер не справляется.
Тайминги индексации:
— Индексация от и до: ~1.5 часа → месяцы или "никогда" (качество)
— Рендер: секунды на сам рендер, часы в очереди → от дней до недель
— Мета-аннотации: 45-90 минут → 1-4 дня
— Ссылочные аннотации: от минут до 1-3 недель → месяцы
— Смена каноникала: 1-3 недели → месяцы (противоречивые сигналы)
— Переезд сайта: 1-3 месяца (мелкий переезд может улечься за пару недель) → от 6 месяцев до 1 года+
— Обновление
Тайминги выдачи:
— Обновление тайтлов и сниппетов: 1-2 дня → от нескольких недель до месяцев
— Снятие ручника: 1-2 недели → 4-6 недель, или гораздо дольше для брошенных сайтов
— Апдейт
— Восстановление после кор-апдейта: 3-6 месяцев → от 6 месяцев до 1 года (следующий кор-апдейт)
Многие из этих процессов связаны, поэтому задержки стакаются: страница не проиндексируется, пока бот ее не обойдет.
Кор-апдейты раскатываются 2-4 недели.
Спам-апдейты выкатываются за 1-2 дня.
Кор-апдейты не бьют по сайтам целиком: они таргетируют контент на уровне страниц, а не домена.
Вот почему одни
Google отфильтровывает 40 миллиардов спам-страниц в день, при этом масштабная генерация (scaled content) сейчас превращается в большую проблему, чем ссылочный спам.
https://weareroast.com/news/google-search-central-live-deep-dive-barcelona-day-3-recap/
#Indexing #Crawling #CoreUpdates
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Быстрая техничка не ускорит страницы, которые Гугл не считает ценными.
Внутренняя аналитика таймингов Google, впервые представленная на
Search Central Live Deep Dive в Барселоне, фиксирует для каждого процесса краулинга, индексации и выдачи типичное и максимальное время.В колонке тормозов регулярно всплывает "никогда" — и обычно это жестко завязано на качество.
Тайминги краулинга, от типичных к самым долгим:
— Обнаружение нового
URL: ~20 часов → от недель до "никогда"— Обновление известного
URL: ~30 дней → от недель до "никогда"— Обработка
sitemap: ~24 часа → до 14 дней или "никогда" (качество)— Обновление
robots.txt: ~24 часа → 25 часов— Апдейт лимитов краулинга (crawl capacity): от 4 часов до 1-2 недель → 1-3 недели при восстановлении
Лимиты краулинга могут упасть за секунды, когда Google дает заднюю — например, если сервер не справляется.
Тайминги индексации:
— Индексация от и до: ~1.5 часа → месяцы или "никогда" (качество)
— Рендер: секунды на сам рендер, часы в очереди → от дней до недель
— Мета-аннотации: 45-90 минут → 1-4 дня
— Ссылочные аннотации: от минут до 1-3 недель → месяцы
— Смена каноникала: 1-3 недели → месяцы (противоречивые сигналы)
— Переезд сайта: 1-3 месяца (мелкий переезд может улечься за пару недель) → от 6 месяцев до 1 года+
— Обновление
Schema: от часов до 1-2 недель → недели или "никогда" (качество)Тайминги выдачи:
— Обновление тайтлов и сниппетов: 1-2 дня → от нескольких недель до месяцев
— Снятие ручника: 1-2 недели → 4-6 недель, или гораздо дольше для брошенных сайтов
— Апдейт
SpamBrain (spam update): 1-2 недели (непрерывно) → месяцы (пакетные обновления)— Восстановление после кор-апдейта: 3-6 месяцев → от 6 месяцев до 1 года (следующий кор-апдейт)
Многие из этих процессов связаны, поэтому задержки стакаются: страница не проиндексируется, пока бот ее не обойдет.
Кор-апдейты раскатываются 2-4 недели.
Спам-апдейты выкатываются за 1-2 дня.
Кор-апдейты не бьют по сайтам целиком: они таргетируют контент на уровне страниц, а не домена.
Вот почему одни
URL на сайте растут, тогда как другие падают.Google отфильтровывает 40 миллиардов спам-страниц в день, при этом масштабная генерация (scaled content) сейчас превращается в большую проблему, чем ссылочный спам.
https://weareroast.com/news/google-search-central-live-deep-dive-barcelona-day-3-recap/
#Indexing #Crawling #CoreUpdates
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Данные DerivateX подтверждают: 88.4% цитирований софта в ChatGPT ведут на сторонние площадки, а не на сайты брендов
Одни только бэклинки почти не предсказывают видимость в
Руководство Google по генеративному ИИ от июля 2026 года объясняет этот разрыв:
Задача ссылки делится надвое:
1. Извлечение (Retrieval) — ранжирование решает, какие страницы увидит модель; здесь ссылки выполняют свою классическую работу.
2. Чтение — как только страница извлечена, у модели остается только текст. Ссылка в подвале или платный гестпост с одной строчкой анкора не дают тексту никакой фактуры для ответа. А вот ревью с разбором ЦА продукта или листикл, честно объясняющий в трех предложениях, почему бренд попал в топ, в итоге уходят в ответы ИИ.
В майском исследовании
Сливать весь ссылочный бюджет на главную или мани-страницы — ошибка; часть ресурсов нужно пустить на сторонние обзоры, сравнения и листиклы, которые уже хорошо описывают бренд, чтобы они ранжировались по запросам, которые парсит ИИ.
Майский анализ
Это сходится, только если ценность лежит в самом факте обсуждения, а не в передаче
Все исследования строятся на корреляциях, большинство исходит от вендоров, продающих то, что они измеряют, цифры между ними не бьются, и выводы расходятся:
— Упоминания против авторитета: у
— Платформы отзывов:
Тот же гайд подтверждает, что ИИ-фичи могут агрегировать отзывы о продуктах из блогов, видео и форумов, а затем закрывает очевидную лазейку: охота за неаутентичными упоминаниями прямо названа
Проплаченное место в листикле "лучших инструментов" — это версия 2026 года для бартера продукта на ссылку, с теми же рисками.
Брендовый поиск ломается первым.
В сентябре
Теперь автор мониторит брендовые запросы по рынкам и советует трекать их через отчет
https://www.gscwizard.com/learn/seo-fundamentals/link-building-brand-building-2026.html
#GEO #AIOverviews #BrandMentions
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Одни только бэклинки почти не предсказывают видимость в
LLM, фиксируют данные Seer Interactive, тогда как позиции на первой странице Google коррелируют с упоминаниями на уровне 0.65.Руководство Google по генеративному ИИ от июля 2026 года объясняет этот разрыв:
AI Overviews и AI Mode используют RAG (retrieval-augmented generation) — основные системы ранжирования вытаскивают страницы из индекса, часто через веер связанных запросов, прежде чем модель прочитает их для генерации ответа.Задача ссылки делится надвое:
1. Извлечение (Retrieval) — ранжирование решает, какие страницы увидит модель; здесь ссылки выполняют свою классическую работу.
2. Чтение — как только страница извлечена, у модели остается только текст. Ссылка в подвале или платный гестпост с одной строчкой анкора не дают тексту никакой фактуры для ответа. А вот ревью с разбором ЦА продукта или листикл, честно объясняющий в трех предложениях, почему бренд попал в топ, в итоге уходят в ответы ИИ.
В майском исследовании
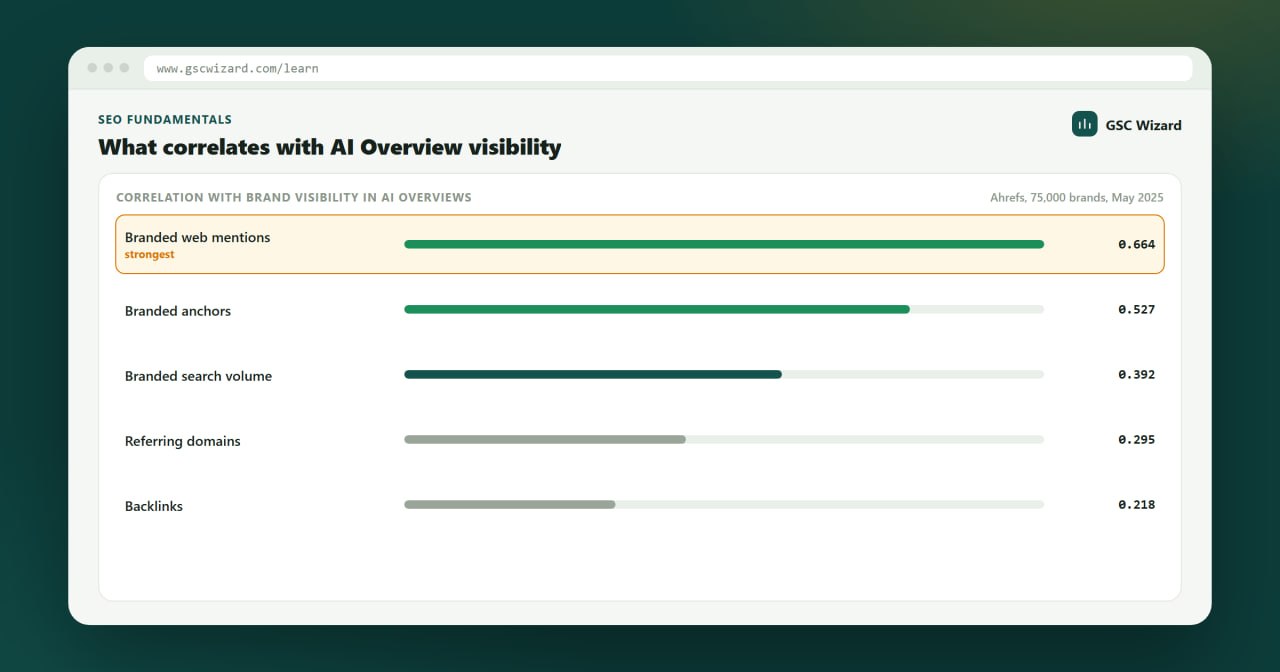
DerivateX за 2026 год на базе 233 рекомендаций софта в ChatGPT, 88.4% цитирований вели на сторонние площадки и только 11.6% — на сайты самих инструментов.Сливать весь ссылочный бюджет на главную или мани-страницы — ошибка; часть ресурсов нужно пустить на сторонние обзоры, сравнения и листиклы, которые уже хорошо описывают бренд, чтобы они ранжировались по запросам, которые парсит ИИ.
Майский анализ
Ahrefs за 2025 год (75 000 брендов в AI Overviews) оценил корреляцию брендовых веб-упоминаний с видимостью в ИИ на 0.664, брендовых анкоров на 0.527, брендовой частотки на 0.392, а обычных бэклинков на 0.218.Semrush (октябрь 2025, 1000 доменов) зафиксировал, что nofollow-ссылки коррелируют так же сильно, как и dofollow (0.340 против 0.334).Это сходится, только если ценность лежит в самом факте обсуждения, а не в передаче
PageRank: неупомянутые ссылки и nofollow засчитываются как плюс.Все исследования строятся на корреляциях, большинство исходит от вендоров, продающих то, что они измеряют, цифры между ними не бьются, и выводы расходятся:
— Упоминания против авторитета: у
Ahrefs упоминания бьют бэклинки 3 к 1, тогда как Seer назвал Domain Rank сильнейшим сигналом (0.25), а Semrush увидел привязку Authority Score к упоминаниям в ИИ на 0.65. Логика автора: крупные бренды одновременно собирают позиции, траст и упоминания, поэтому ни одно исследование не отделит их друг от друга.— Платформы отзывов:
SE Ranking (129 000 доменов) связывает профили на Trustpilot, G2 или Capterra с 4.6–6.3 цитатами в ChatGPT против 1.8 без них; DerivateX не зафиксировал ни одной цитаты G2 или Capterra на 233 ответа. Обе метрики верны, если сильный профиль просто помогает бренду попасть в те самые листиклы, которые ИИ в итоге цитирует. Профиль все равно нужно допиливать — нельзя держать одно и то же описание на главной, G2, Capterra и других площадках, так как авторы и модели дублируют этот текст, — но цитируют в итоге не эти страницы.Тот же гайд подтверждает, что ИИ-фичи могут агрегировать отзывы о продуктах из блогов, видео и форумов, а затем закрывает очевидную лазейку: охота за неаутентичными упоминаниями прямо названа
GEO-тактикой, которую нужно игнорировать, так как ИИ опирается на спам-фильтры самого поиска.Проплаченное место в листикле "лучших инструментов" — это версия 2026 года для бартера продукта на ссылку, с теми же рисками.
Брендовый поиск ломается первым.
В сентябре
gscwizard.com ненадолго потерял брендовый запрос в одном из европейских серпов, при этом AI Overview по-прежнему описывал продукт корректно.Теперь автор мониторит брендовые запросы по рынкам и советует трекать их через отчет
Generative AI в Google Search Console.https://www.gscwizard.com/learn/seo-fundamentals/link-building-brand-building-2026.html
#GEO #AIOverviews #BrandMentions
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Показания в суде: история кликов работает на старые страницы — алгоритмам свежести приходится это компенсировать
Почему трехлетний гайд продолжает обходить страницу, опубликованную на этой неделе?
Вице-президент Гугла по поиску Панду Наяк раскрыл механику под присягой по делу США против Google: "клики накапливаются со временем, а значит, старые страницы, потенциально устаревшие, обычно собирают больше кликов, чем свежие".
Поэтому "клики цементируют устаревание, и вам приходится это как-то компенсировать".
Автор маппит эту компенсацию на слитые атрибуты из
Показания задают рамку:
— Свежесть зависит от интента: запросам про спортивные команды нужны страницы за сегодня, обзорам ноутбуков — актуальный модельный ряд, а десятилетний рецепт индейки легко обойдет сегодняшний.
— Джон Джанандреа: "Свежесть — это про задержку, а не про количество". Когда умирает знаменитость, "вам нужно узнать об этом за секунды".
— Эрик Лиман: компонент свежести смотрит на даты публикаций и "может более агрессивно бустить свежие материалы", тогда как анкорный сигнал "не учитывает клики".
Публичные доки Гугла подтверждают работу систем
Массовая переработка получает тот же вердикт: добавление или удаление контента ради имитации активности сайта — "(Нет, это не поможет)".
Джон Мюллер, 2022: "Смена даты, больше ничего не меняя — это просто шум и бесполезно".
Слой со сливом — это вывод автора, а не подтвержденное поведение алгоритма.
В этой системе координат страница проходит следующие этапы:
—
—
—
—
—
—
Воркфлоу по обновлению контента, вытекающий из этой модели:
1. Переписывайте и расширяйте основной текст, а не метаданные или сайдбары.
2. Заменяйте устаревшую статистику, упоминания старых продуктов и битые ссылки — текст должен читаться как актуальный.
3. Пропускайте рандомное обновление дат на вечнозеленых страницах; приберегите системные апдейты для тем с цикличным устареванием или устареванием в реальном времени.
Порог срабатывания
https://www.hobo-web.co.uk/the-freshness-signal-qdf-query-deserves-freshness-inside-googles-battle-against-time-staleness-and-click-bias/
#ContentFreshness #NavBoost #GoogleLeak
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Почему трехлетний гайд продолжает обходить страницу, опубликованную на этой неделе?
Вице-президент Гугла по поиску Панду Наяк раскрыл механику под присягой по делу США против Google: "клики накапливаются со временем, а значит, старые страницы, потенциально устаревшие, обычно собирают больше кликов, чем свежие".
Поэтому "клики цементируют устаревание, и вам приходится это как-то компенсировать".
Автор маппит эту компенсацию на слитые атрибуты из
Content Warehouse — от semanticDate и lastSignificantUpdate до рантайм-компонента FreshnessTwiddler.Показания задают рамку:
— Свежесть зависит от интента: запросам про спортивные команды нужны страницы за сегодня, обзорам ноутбуков — актуальный модельный ряд, а десятилетний рецепт индейки легко обойдет сегодняшний.
— Джон Джанандреа: "Свежесть — это про задержку, а не про количество". Когда умирает знаменитость, "вам нужно узнать об этом за секунды".
— Эрик Лиман: компонент свежести смотрит на даты публикаций и "может более агрессивно бустить свежие материалы", тогда как анкорный сигнал "не учитывает клики".
Публичные доки Гугла подтверждают работу систем
query deserves freshness и напрямую спрашивают создателей контента: "Меняете ли вы дату страницы, чтобы она казалась свежей, без существенного обновления контента"?.Массовая переработка получает тот же вердикт: добавление или удаление контента ради имитации активности сайта — "(Нет, это не поможет)".
Джон Мюллер, 2022: "Смена даты, больше ничего не меняя — это просто шум и бесполезно".
Слой со сливом — это вывод автора, а не подтвержденное поведение алгоритма.
В этой системе координат страница проходит следующие этапы:
—
bylineDate: дата на странице или в микроразметке, сама по себе не верифицируется.—
syntacticDate: дата, извлеченная из паттернов URL или тайтла.—
semanticDate: соответствуют ли факты, сущности и статистика в тексте актуальному срезу веб-графа.—
richcontentData + pageregions: какой объем текста изменился и где именно — основной текст против шаблонных хедеров, футеров и сайдбаров.—
lastSignificantUpdate: прописывается только когда правки в основном контенте пробивают порог. Обновление bylineDate поверх мелких правок оставляет его без изменений, полностью нейтрализуя любой потенциальный QDF-буст.—
FreshnessTwiddler: на запросах, триггерящих QDF, бустит страницы с верифицированным lastSignificantUpdate и параллельно глушит вес кликов из NavBoost.Воркфлоу по обновлению контента, вытекающий из этой модели:
1. Переписывайте и расширяйте основной текст, а не метаданные или сайдбары.
2. Заменяйте устаревшую статистику, упоминания старых продуктов и битые ссылки — текст должен читаться как актуальный.
3. Пропускайте рандомное обновление дат на вечнозеленых страницах; приберегите системные апдейты для тем с цикличным устареванием или устареванием в реальном времени.
Порог срабатывания
lastSignificantUpdate не раскрывается, и автор сам подсвечивает лимиты: слив вскрывает структуры данных и протокол-буферы, а не живой код или веса факторов, поэтому некоторые атрибуты могут быть неактивны или заменены.https://www.hobo-web.co.uk/the-freshness-signal-qdf-query-deserves-freshness-inside-googles-battle-against-time-staleness-and-click-bias/
#ContentFreshness #NavBoost #GoogleLeak
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤1👍1😈1
Фейковые закладки эксплуатировали дыру MyVidster при сбоях видео на $12,533 по ревшаре
Автор заметил, что в этом слоте появляются некоторые из его собственных фейковых плееров.
Тест со свежим аккаунтом дал тот же результат: страница под контролем оператора могла занимать слот плеера, тогда как закладка выглядела как обычный листинг видео.
Этот слот превратился в аффилиатную воронку.
Каждая фейковая закладка показывала кадр из реального ролика с кнопкой плей, но без самого видео.
Клик по кнопке открывал "локер", замаскированный под проверку на человека — реалистичный плеер плюс правдоподобный экран верификации заставляли юзеров воспринимать запрос всерьез.
Локер запускал каскад: сначала спрашивал про аккаунт на
Рега ничего не разблокировала; доход шел позже, по ревшаре, и только если приведенный юзер тратил деньги.
Трафик шел через паразит.
Тайтлы закладок парсили из
Постинг крутился через
Масштаб достиг 90 127 закладок на 109 каналах.
Постинг на паузе, но не заброшен.
Органика пикнула в декабре 2024 года и падала всю первую половину 2025-го; автор подозревал спам-апдейт Google, но не подтвердил причину, а само падение не оцифровано дальше графика позиций.
Отдельно
После пересборки
Замена доменов и акков после каждого бана превратилась в рутину, поэтому автор пока стопнул процесс и может вернуться позже, пока старые реги по ревшаре еще приносят деньги.
Три вектора так и не протестировали:
— редирект всей родительской страницы из
— потенциальное использование
— подмена на плеер казино, чтобы юзать видимость
Автор считает, что эти связки, как и оригинальный локер, всё еще могут работать, но не тестил ни одну из них после пересборки.
https://theory18.com/webmasters/noindex/myvidster-fake-videos
#ParasiteSEO #Affiliate #BlackHatSEO
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
MyVidster, в основном NSFW-букмаркинг с хорошей органикой в Google, содержал уязвимость: когда их плеер не мог прочитать сохраненное видео, он подгружал исходную страницу внутри iframe.Автор заметил, что в этом слоте появляются некоторые из его собственных фейковых плееров.
Тест со свежим аккаунтом дал тот же результат: страница под контролем оператора могла занимать слот плеера, тогда как закладка выглядела как обычный листинг видео.
Этот слот превратился в аффилиатную воронку.
Каждая фейковая закладка показывала кадр из реального ролика с кнопкой плей, но без самого видео.
Клик по кнопке открывал "локер", замаскированный под проверку на человека — реалистичный плеер плюс правдоподобный экран верификации заставляли юзеров воспринимать запрос всерьез.
Локер запускал каскад: сначала спрашивал про аккаунт на
Stripchat, ответ "нет" роутил посетителя на регу по партнерской ссылке, ответ "да" перекидывал на Chaturbate, затем на следующую партнерку, пока не доходил до сайта, где у юзера не было аккаунта.Рега ничего не разблокировала; доход шел позже, по ревшаре, и только если приведенный юзер тратил деньги.
Stripchat принес примерно в четыре раза больше Chaturbate — $10,033 против $2,500, итого $12,533 до вычета костов — и обе суммы всё еще могут расти, так как ревшара продолжает платить за старые реги.Трафик шел через паразит.
Тайтлы закладок парсили из
RSS-фидов сайтов со сливами видео, чтобы страницы MyVidster ранжировались в Google по названиям этих сливов, а превьюшки из фидов переиспользовались, чтобы фейковый плеер матчился с тем, что гуглил юзер.Постинг крутился через
API MyVidster с помощью n8n и прокси Webshare с уникализированными тайтлами; когда два тайтла совпадали, URL отбрасывался как дубль, и цепочка постинга стопалась.Масштаб достиг 90 127 закладок на 109 каналах.
Постинг на паузе, но не заброшен.
Органика пикнула в декабре 2024 года и падала всю первую половину 2025-го; автор подозревал спам-апдейт Google, но не подтвердил причину, а само падение не оцифровано дальше графика позиций.
Отдельно
MyVidster лежал неделями, иногда утягивая за собой API или весь сайт, что стопало постинг и било по трафику из Google.После пересборки
MyVidster в 2026 году домены начали банить в день добавления, включая свежереги; все 90 127 закладок теперь в бане, и ни одно видео не грузится.Замена доменов и акков после каждого бана превратилась в рутину, поэтому автор пока стопнул процесс и может вернуться позже, пока старые реги по ревшаре еще приносят деньги.
Три вектора так и не протестировали:
— редирект всей родительской страницы из
iframe, в том числе на таргет, отдающий 301— потенциальное использование
iframe для куки-стаффинга— подмена на плеер казино, чтобы юзать видимость
MyVidster для parasite SEOАвтор считает, что эти связки, как и оригинальный локер, всё еще могут работать, но не тестил ни одну из них после пересборки.
https://theory18.com/webmasters/noindex/myvidster-fake-videos
#ParasiteSEO #Affiliate #BlackHatSEO
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Мы создали 4 сообщества на Reddit, чтобы протестировать GEO, рассказывает Патрик Высоцки.
За 60 дней они достигли:
👉 3,740 цитирований ИИ
👉 6-го места по цитированиям ИИ среди 126 устоявшихся сабреддитов
👉 27 ключей ранжировались в Google, 15 из них с
Затем
Всё упало в ноль, без предупреждения и возможности обжалования.
Из-за чего нас забанили:
🔴 Апвоуты и комментарии, которые мы добавляли сами
🔴 Боты, использовавшиеся для контроля вовлеченности в двух версиях
🔴 Один и тот же контент, публиковавшийся по одинаковому графику во всех четырех сообществах
🔴 Предположение, что владение сабреддитом вас защитит (это не останавливает бан от админов)
И
С июля по сентябрь 2026 года доля цитирований
📉
📉
📈
📈
Мой вывод: относитесь к
Если живые люди не хотят участвовать в этом ради самого участия, пропустите его, потому что каждый срез углов лишь повышает вероятность бана.
Так что же работает на
Я прикрепил ссылку на полный эксперимент в комментариях с практическими советами от
Инсайты комьюнити
— Цитирования показывают то, что модель отображает в тексте, тогда как извлечение — это то, что
— Гипотеза: поисковая ценность
#Reddit #AI #BotTraffic
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
За 60 дней они достигли:
👉 3,740 цитирований ИИ
👉 6-го места по цитированиям ИИ среди 126 устоявшихся сабреддитов
👉 27 ключей ранжировались в Google, 15 из них с
AI OverviewЗатем
Reddit удалил все четыре за одну ночь по Правилу 2 (манипуляция контентом).Всё упало в ноль, без предупреждения и возможности обжалования.
Из-за чего нас забанили:
🔴 Апвоуты и комментарии, которые мы добавляли сами
🔴 Боты, использовавшиеся для контроля вовлеченности в двух версиях
🔴 Один и тот же контент, публиковавшийся по одинаковому графику во всех четырех сообществах
🔴 Предположение, что владение сабреддитом вас защитит (это не останавливает бан от админов)
И
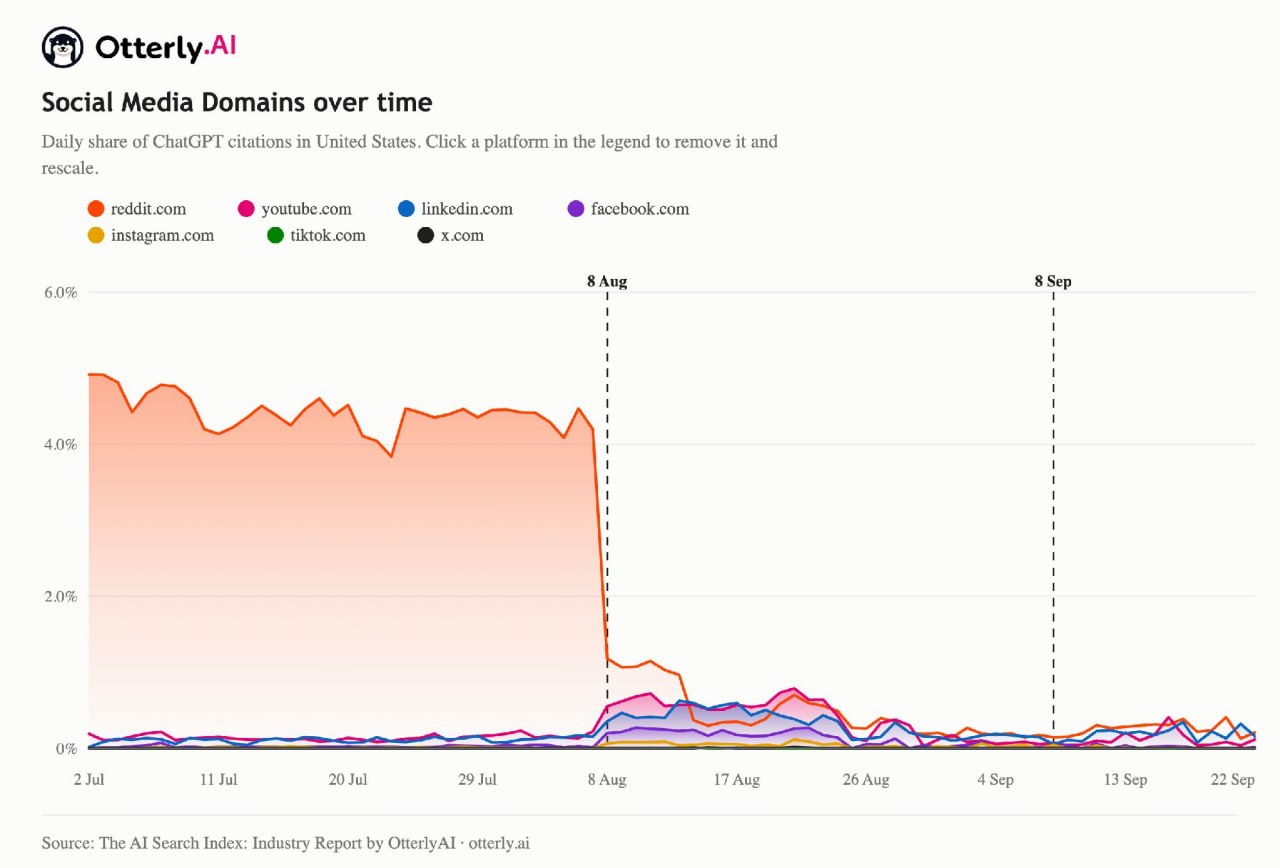
Reddit значит в AI-поиске меньше, чем многие предполагают...С июля по сентябрь 2026 года доля цитирований
Reddit:📉
ChatGPT: −94%📉
Gemini: −32%📈
Perplexity: +86%📈
Google AI Mode: +24%Claude и Copilot почти вообще не цитируют Reddit.Мой вывод: относитесь к
Reddit как к аренде, а не как к активу.Если живые люди не хотят участвовать в этом ради самого участия, пропустите его, потому что каждый срез углов лишь повышает вероятность бана.
Так что же работает на
Reddit и не приводит к бану? 👇Я прикрепил ссылку на полный эксперимент в комментариях с практическими советами от
OtterlyAI.Инсайты комьюнити
— Цитирования показывают то, что модель отображает в тексте, тогда как извлечение — это то, что
LLM читает перед написанием ответа. Поэтому падение доли цитирований Reddit само по себе не означает падения его влияния: данные указывают, что ветки Reddit всё ещё подтягиваются и формируют структуру ответов, просто на них реже ссылаются. Полевые наблюдения показывают, что Reddit появляется почти в каждом проанализированном поиске ChatGPT, но редко цитируется, а сопоставление цитирований с реферальным ИИ-трафиком в GA показывает, что люди почти не кликают по ссылкам-источникам.— Гипотеза: поисковая ценность
Reddit полностью держится на Google (AI Overviews и серп), а для ChatGPT Reddit никогда не имел особого значения.#Reddit #AI #BotTraffic
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤1👍1
Модели контекстных эмбеддингов обходят старые ретриверы — изолированные чанки для GEO больше не нужны
Советы по
Если переписывать каждый абзац, повторяя бренд и продукт, это поможет только тем ретриверам, которые сейчас активно вымирают, документирует Ян-Виллем Боббинк.
У этого совета есть реальная база.
В 2023 году
Это работает для любой системы, которая кодирует каждый чанк отдельно.
Фраза "доход компании вырос на 3%" ничего не скажет ретриверу, если её оторвать от абзаца с названием бренда.
С тех пор исследования поиска атаковали ту же проблему с другой стороны:
—
—
— Исследование
30 сентября
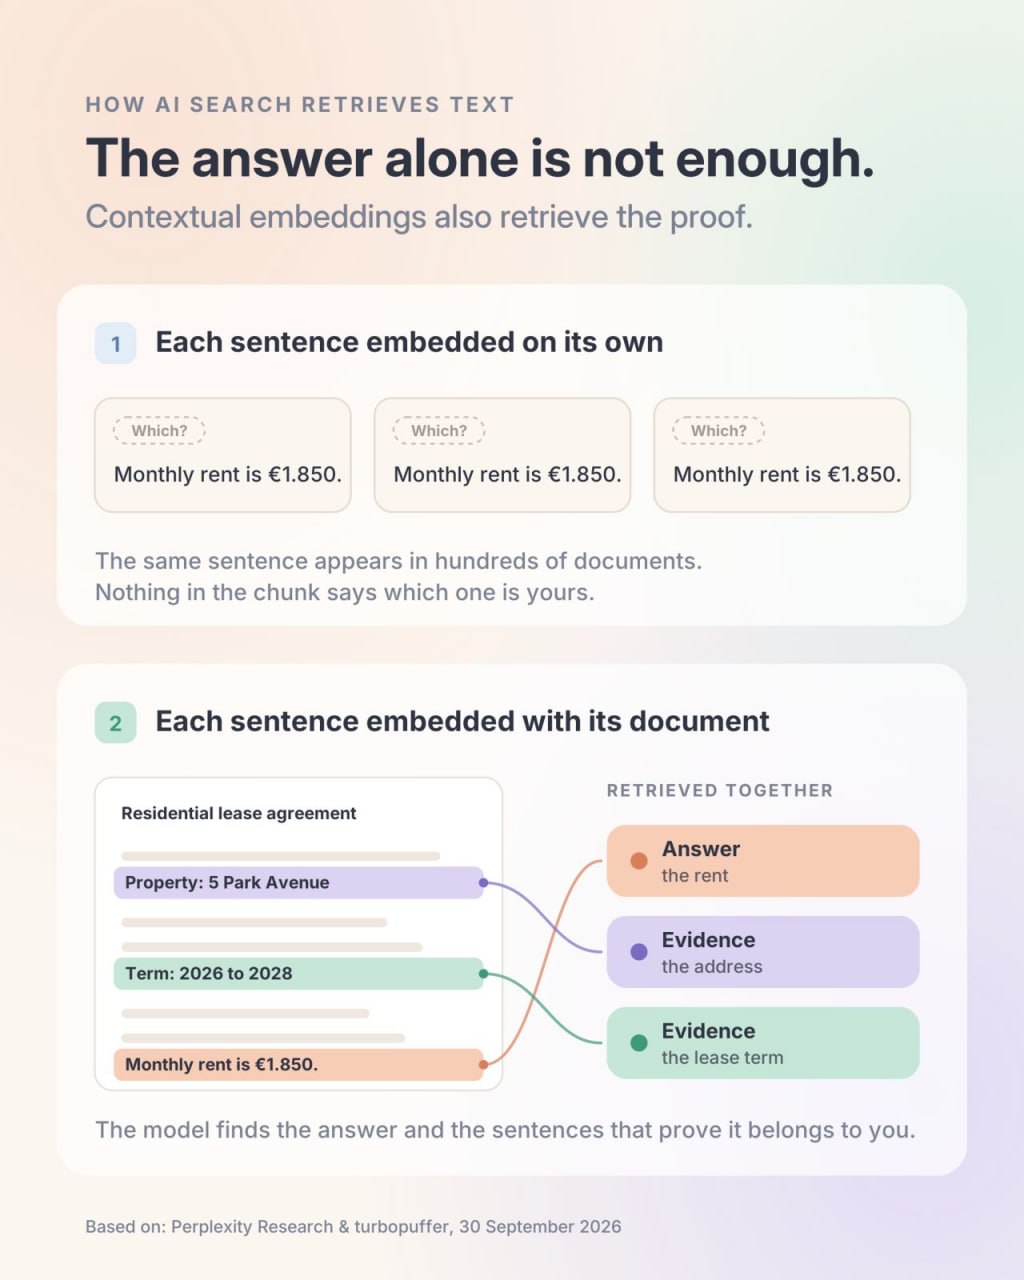
Бенчмарк прогоняет 2,099 запросов через 38,894 длинных документа, разбитых на 2,458,072 чанков-предложений.
Базу намеренно засеяли почти идентичными текстами — вроде договоров аренды, где одна и та же фраза про плату дублируется в куче файлов.
В топ-10 модель нашла ответ для 45.5% запросов и вытянула 40.6% подтверждающих данных.
Контекстной модели нужны доказательства где-то в том же документе: к какой сущности, версии, рынку и дате относится ответ — потому что она подтягивает эти предложения вместе с ответом.
По этой логике, следующая связка делает больше работы, чем принудительное переписывание:
— Четкие заголовки таблиц
— Тематические заголовки разделов
— Явная строка о том, к кому или чему относится страница
Самодостаточный текст никуда не уходит: пайплайны, которые кодируют чанки независимо, всё ещё в ходу, а понятное предложение ничего не стоит.
Полевые наблюдения относят большинство продакшен-стеков к лагерю "разбить до эмбеддинга", где строка с доказательством всё равно никогда не путешествует вместе с чанком.
У этих данных есть жёсткие лимиты:
— Исследование вендора на превью-модели
— Приватный бенчмарк, запущенный совместно с
— В анонсе нет ни слова о том, что эта модель сегодня работает в движке ответов
— Даже эта модель не находит ответ в топ-10 для более чем половины запросов
Это указывает направление, а не результат, уже проверенный на клиентских сайтах.
Инсайты комьюнити
— Полевое внедрение столкнулось с просадкой в классической органике после слишком жесткой зачистки "маркетинговой воды" ради конкретики. Гипотеза: если каждая страница выдает один и тот же набор фактов, именно специфичные детали бренда делают её уникальной в глазах Google.
— Тесты в реальных условиях подтверждают то же самое для
#Embeddings #RAG #AI
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Советы по
GEO продавливают одно правило: делай каждый чанк самостоятельным.Если переписывать каждый абзац, повторяя бренд и продукт, это поможет только тем ретриверам, которые сейчас активно вымирают, документирует Ян-Виллем Боббинк.
У этого совета есть реальная база.
В 2023 году
Chen et al. доказали: плотные ретриверы находят ответы точнее, если индексировать Википедию как мелкие самодостаточные утверждения, а не куски по 100 слов.Это работает для любой системы, которая кодирует каждый чанк отдельно.
Фраза "доход компании вырос на 3%" ничего не скажет ретриверу, если её оторвать от абзаца с названием бренда.
С тех пор исследования поиска атаковали ту же проблему с другой стороны:
—
Anthropic заставил LLM писать короткую строку контекста перед каждым чанком и срезал сбои поиска на 49%.—
Jina выкатила late chunking, который кодирует весь документ до его разбивки на чанки.— Исследование
ConTEB раскрывает: если удалить сущность из абзаца, стандартный поиск рушится, тогда как контекстные модели этого почти не замечают.30 сентября
Perplexity и turbopuffer опубликовали следующий шаг: модель контекстных эмбеддингов, натренированную извлекать предложение-ответ вместе с теми предложениями, которые доказывают его принадлежность к правильному документу.Бенчмарк прогоняет 2,099 запросов через 38,894 длинных документа, разбитых на 2,458,072 чанков-предложений.
Базу намеренно засеяли почти идентичными текстами — вроде договоров аренды, где одна и та же фраза про плату дублируется в куче файлов.
В топ-10 модель нашла ответ для 45.5% запросов и вытянула 40.6% подтверждающих данных.
Контекстной модели нужны доказательства где-то в том же документе: к какой сущности, версии, рынку и дате относится ответ — потому что она подтягивает эти предложения вместе с ответом.
По этой логике, следующая связка делает больше работы, чем принудительное переписывание:
— Четкие заголовки таблиц
— Тематические заголовки разделов
— Явная строка о том, к кому или чему относится страница
Самодостаточный текст никуда не уходит: пайплайны, которые кодируют чанки независимо, всё ещё в ходу, а понятное предложение ничего не стоит.
Полевые наблюдения относят большинство продакшен-стеков к лагерю "разбить до эмбеддинга", где строка с доказательством всё равно никогда не путешествует вместе с чанком.
У этих данных есть жёсткие лимиты:
— Исследование вендора на превью-модели
— Приватный бенчмарк, запущенный совместно с
turbopuffer— В анонсе нет ни слова о том, что эта модель сегодня работает в движке ответов
Perplexity— Даже эта модель не находит ответ в топ-10 для более чем половины запросов
Это указывает направление, а не результат, уже проверенный на клиентских сайтах.
Инсайты комьюнити
— Полевое внедрение столкнулось с просадкой в классической органике после слишком жесткой зачистки "маркетинговой воды" ради конкретики. Гипотеза: если каждая страница выдает один и тот же набор фактов, именно специфичные детали бренда делают её уникальной в глазах Google.
— Тесты в реальных условиях подтверждают то же самое для
LLM: размытый текст или раскиданные по странице детали снижают уверенность механизма внимания в том, какая информация связана между собой. Любое многозначное слово требует уточняющих маркеров ("practice" может быть спортивной, юридической или медицинской), а фраза "доказательства говорят сами за себя" над блоком с наградами не дает LLM ничего для работы.#Embeddings #RAG #AI
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
🤓1
Я постоянно игнорирую советы Google, рассказывает Мартин Хейман.
Пагинация?
Я всегда закрываю её в
Документация Google говорит так не делать.
Любая
Но после многих лет тестирования разных подходов я придерживаюсь
Я тестировал
Я тестировал каноникал.
Я тестировал естественную индексацию всего подряд.
И я не одинок.
Крупные сайты с серьезными
Тестируйте это на собственном сайте.
А что делаете вы, что полностью игнорирует гайдлайны или "
Инсайты комьюнити
— Полевой кейс:
—
#Pagination #Noindex #TechnicalSEO
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Пагинация?
Я всегда закрываю её в
noindex.Документация Google говорит так не делать.
Любая
LLM скажет вам то же самое.Но после многих лет тестирования разных подходов я придерживаюсь
noindex,follow.Я тестировал
rel=next``/prev (до того как Google прекратил их поддержку).Я тестировал каноникал.
Я тестировал естественную индексацию всего подряд.
Noindex для пагинации продолжает побеждать на сайтах, с которыми я работаю.И я не одинок.
Крупные сайты с серьезными
SEO-командами делают то же самое.Best practice — это отправная точка, а не правило.Тестируйте это на собственном сайте.
А что делаете вы, что полностью игнорирует гайдлайны или "
best practice"?Инсайты комьюнити
— Полевой кейс:
noindex на пагинации сэкономил краулинговый бюджет на крупном контентном проекте, но одна категория незаметно потеряла позиции по хвостам, потому что страницы пагинации были единственным путем краулинга к половине её продуктов. Ставьте noindex на пагинацию только в том случае, если до каждого элемента можно добраться другим путем; иначе на некоторых архитектурах сайтов урлы, доступные только через эти страницы, незаметно станут страницами-сиротами.—
noindex,follow подходит для малоценных архивов, но это не безопасный дефолт для каждой второй страницы: на чистых листингах, где на последующих страницах есть уникальные элементы и реальная внутренняя перелинковка, альтернативой будет позволить паре страниц пагинации проиндексироваться, отслеживая краулинг и показы. А страницы пагинации, которые собирают реальный поисковый трафик со второй страницы и далее, нужно оставлять открытыми, потому что noindex убьет работающую страницу.#Pagination #Noindex #TechnicalSEO
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
🤔5😁2
НОВЫЕ ДАННЫЕ:
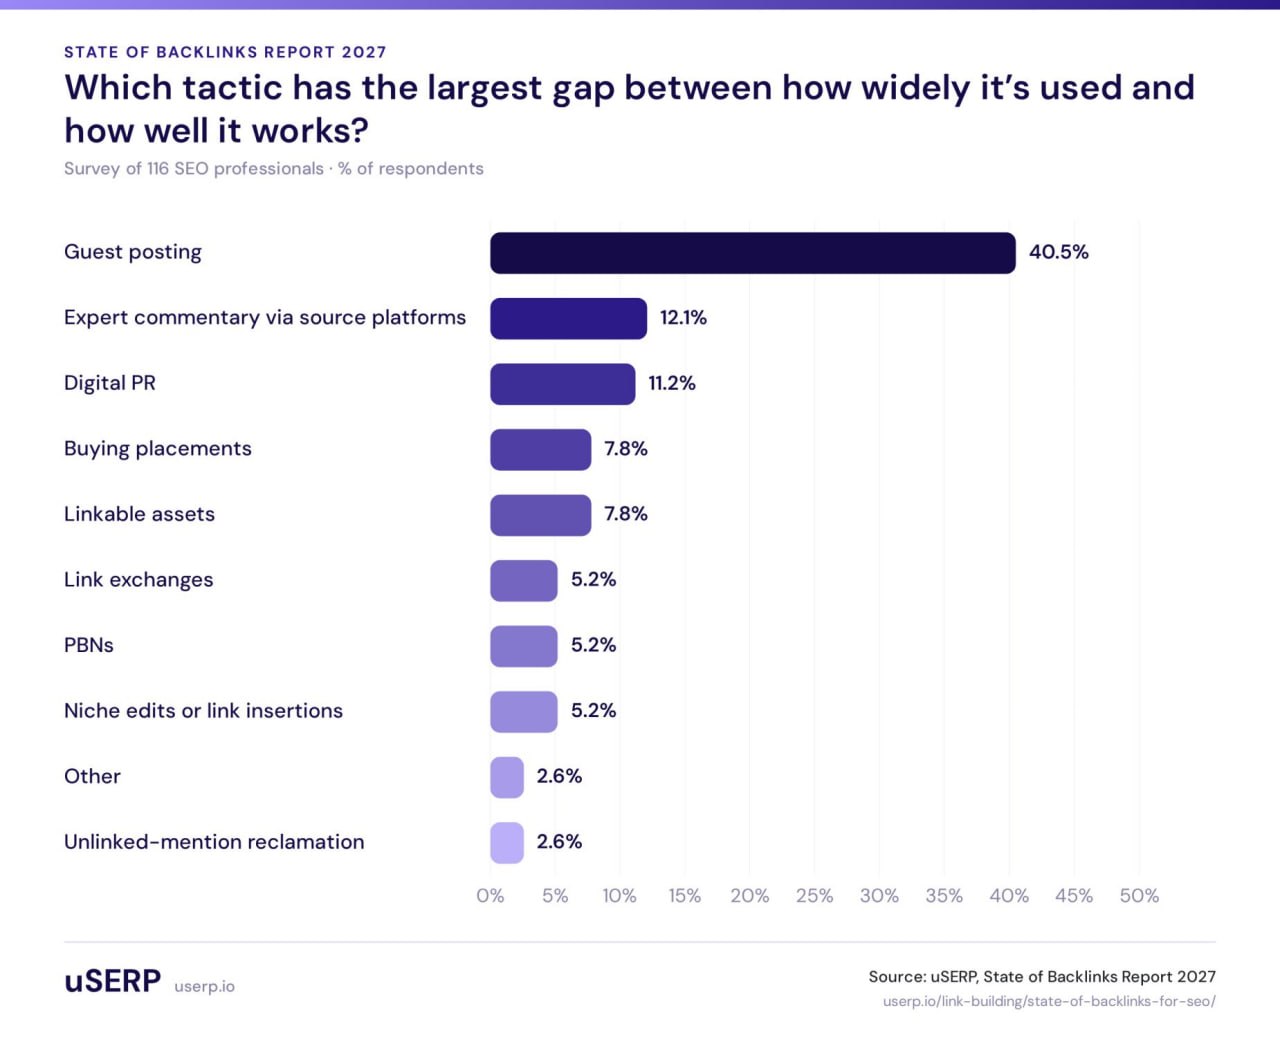
Мы спросили 116 руководителей в SEO, какая тактика линкбилдинга имеет самый большой разрыв между тем, насколько широко она используется, и тем, насколько хорошо она работает, отмечает Джереми Мозер.
Гестпостинг победил — эксперты считают, что им злоупотребляют и он дает плохие результаты.
И отрыв был огромным.
→ Гестпостинг: 40.5%
→ Экспертные комментарии через платформы журналистских запросов: 12.1%
→
→ Покупка размещений: 7.8%
Более чем в 3 раза превышает следующий ответ!
Затем мы задали противоположный вопрос: какая тактика принесла вам самые сильные результаты за последние 12 месяцев?
→
→
→
→ Гестпостинг: 4.3%
Согласно нашим данным, гестпостинг — это самая переоцененная тактика, которая приносит результаты лишь 1 из 25 человек.
А когда мы задали открытый вопрос о том, что работало два года назад и умирает сейчас, тремя главными ответами стали гестпостинг, платные размещения и
Вместе они составили более половины всех ответов!
Логика в комментариях была последовательной.
Гестпостинг не мертв окончательно, но та версия, которую использует большая часть индустрии, мертва: шаблонная статья в нетематическом блоге, выбранном только потому, что инструмент выдал метрику
Второе место экспертных комментариев в антирейтинге — тревожный звонок и для платформ журналистских запросов.
Когда генерация каждого питча через ИИ занимает 6 секунд, редакторы перестают их читать, а огромный объем заявок обваливает процент успешных размещений.
У тактик, которые выигрывают прямо сейчас, есть общая черта: это нечто, заслуживающее цитирования, поданное нужному человеку в нужное время.
Данные.
Исследование.
Настоящий эксперт.
Продукт, о котором говорят люди.
Полный отчет в комментариях!!
#GuestPosting #DigitalPR #LinkBuilding
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Мы спросили 116 руководителей в SEO, какая тактика линкбилдинга имеет самый большой разрыв между тем, насколько широко она используется, и тем, насколько хорошо она работает, отмечает Джереми Мозер.
Гестпостинг победил — эксперты считают, что им злоупотребляют и он дает плохие результаты.
И отрыв был огромным.
→ Гестпостинг: 40.5%
→ Экспертные комментарии через платформы журналистских запросов: 12.1%
→
Digital PR: 11.2%→ Покупка размещений: 7.8%
Более чем в 3 раза превышает следующий ответ!
Затем мы задали противоположный вопрос: какая тактика принесла вам самые сильные результаты за последние 12 месяцев?
→
Digital PR: 53.4%→
Niche edits: 12.9%→
Linkable assets: 8.6%→ Гестпостинг: 4.3%
Согласно нашим данным, гестпостинг — это самая переоцененная тактика, которая приносит результаты лишь 1 из 25 человек.
А когда мы задали открытый вопрос о том, что работало два года назад и умирает сейчас, тремя главными ответами стали гестпостинг, платные размещения и
PBN.Вместе они составили более половины всех ответов!
Логика в комментариях была последовательной.
Гестпостинг не мертв окончательно, но та версия, которую использует большая часть индустрии, мертва: шаблонная статья в нетематическом блоге, выбранном только потому, что инструмент выдал метрику
DR, которую никто не читает.Второе место экспертных комментариев в антирейтинге — тревожный звонок и для платформ журналистских запросов.
Когда генерация каждого питча через ИИ занимает 6 секунд, редакторы перестают их читать, а огромный объем заявок обваливает процент успешных размещений.
У тактик, которые выигрывают прямо сейчас, есть общая черта: это нечто, заслуживающее цитирования, поданное нужному человеку в нужное время.
Данные.
Исследование.
Настоящий эксперт.
Продукт, о котором говорят люди.
Полный отчет в комментариях!!
#GuestPosting #DigitalPR #LinkBuilding
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
✍4🌚3❤1
Одни из самых недооцененных навыков в SEO:
• Приоритезация: понимание того, что важно, что может подождать, а что нет.
• Скептицизм: отказ принимать инструменты, кейсы или слова Google за чистую монету.
• Распознавание паттернов: умение замечать изменения до того, как они станут очевидными в данных.
• Коммуникация: способность объяснять сложные вещи, не прячась за профессиональным жаргоном.
• Влияние: умение добиваться внедрения задач, когда вы не управляете дорожной картой.
• Адаптивность: поиск редко долго стоит на месте.
• Сдержанность: понимание того, когда лучше ничего не трогать.
• Умение работать в условиях неопределенности: SEO редко дает чистые ответы.
• Техническая эмпатия: понимание того, почему разработчики не могут "просто взять и пофиксить".
• Бизнес-чутье: понимание, что больше трафика ≠ больше денег.
• Скромность: умение спокойно признавать "я пока не знаю".
• Убежденность: способность настаивать на своем, когда есть веские доказательства.
• Любознательность: распутывание мелких зацепок до полного понимания.
• Настойчивость: хорошее SEO часто требует больше времени на доказательство эффективности, чем кому-либо хотелось бы.
• Навыки переговоров: рекомендации всегда конкурируют с другими приоритетами.
Лучшие
#SEOCareer #Strategy
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
• Приоритезация: понимание того, что важно, что может подождать, а что нет.
• Скептицизм: отказ принимать инструменты, кейсы или слова Google за чистую монету.
• Распознавание паттернов: умение замечать изменения до того, как они станут очевидными в данных.
• Коммуникация: способность объяснять сложные вещи, не прячась за профессиональным жаргоном.
• Влияние: умение добиваться внедрения задач, когда вы не управляете дорожной картой.
• Адаптивность: поиск редко долго стоит на месте.
• Сдержанность: понимание того, когда лучше ничего не трогать.
• Умение работать в условиях неопределенности: SEO редко дает чистые ответы.
• Техническая эмпатия: понимание того, почему разработчики не могут "просто взять и пофиксить".
• Бизнес-чутье: понимание, что больше трафика ≠ больше денег.
• Скромность: умение спокойно признавать "я пока не знаю".
• Убежденность: способность настаивать на своем, когда есть веские доказательства.
• Любознательность: распутывание мелких зацепок до полного понимания.
• Настойчивость: хорошее SEO часто требует больше времени на доказательство эффективности, чем кому-либо хотелось бы.
• Навыки переговоров: рекомендации всегда конкурируют с другими приоритетами.
Лучшие
SEO-специалисты, которых я знаю, редко хороши только в #SEO, пишет Карл Хенди.#SEOCareer #Strategy
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
🔥8❤2👌1
🔥 Бесплатный тул
15 сентября
Но
Поэтому я написал бесплатное расширение, которое измеряет остальное, рассказывает Натцир.
Почему это важно: некоторые из моих клиентов получили предупреждения в
Живой асессор считает каждую рекламу на странице.
Цифры
Новостник, с которым я работаю, только что словил фильтр за плохой
Я годами предупреждал, что это может произойти.
Думал, что проверка
Список
На
Асессор увидел бы еще и блоки
Другая реклама, которую
Затем он проверяет плотность, липкие блоки и попапы по
Он бесплатный и опенсорсный.
Пожалуйста, не используй его, чтобы прятать рекламу от
Пост
Тул: https://github.com/natzir/ad-density-checker
#TechnicalSEO #UX #Tools
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
15 сентября
Chrome добавил метрики рекламы в CrUX: сколько рекламы на экране, какую площадь она занимает, а также потребление CPU и сети.Но
Chrome считает только ту рекламу, которую размечает его собственный фильтр.Поэтому я написал бесплатное расширение, которое измеряет остальное, рассказывает Натцир.
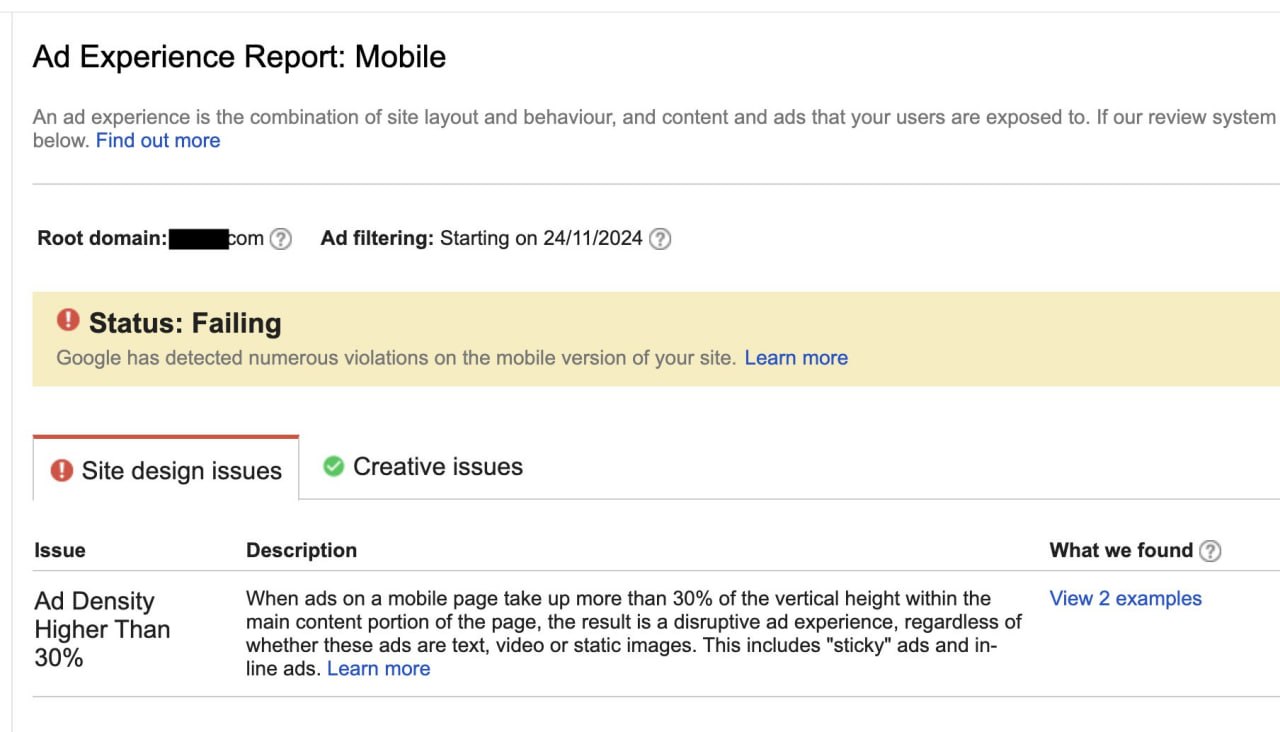
Почему это важно: некоторые из моих клиентов получили предупреждения в
Ad Experience Report за превышение 30% плотности рекламы на мобилках, и Chrome был готов заблочить их рекламу, если они это не пофиксят.Живой асессор считает каждую рекламу на странице.
Цифры
Chrome учитывают только то, что он сам размечает.Новостник, с которым я работаю, только что словил фильтр за плохой
UX рекламы на мобилках (Ad Density > 30%).Я годами предупреждал, что это может произойти.
Думал, что проверка
Better Ads Standards алгоритмическая, но оказалось — ручная.Список
Chrome — это устаревший срез EasyList.На
Diario de Sevilla (мобилка) Chrome размечает 4 рекламы, которые в среднем занимают 5% экрана.Асессор увидел бы еще и блоки
Addoor, которые Chrome пропускает: плотность рекламы 69.8%, что далеко за пределом в 30%.Другая реклама, которую
Chrome не считает: собственные промо через Google Ad Manager (Newsweek), пустые слоты с пометкой "Advertisement" (NY Post), рекламные скины за контентом и даже попап Google ad gate, который он не ловит (Levante-EMV).Ad Density Checker скроллит страницу как живой читатель и обходит антибот-фильтры: он крутится в твоем собственном Chrome, без флага автоматизации, и один раз двигает мышкой, чтобы сайты отдавали реальную рекламу.Затем он проверяет плотность, липкие блоки и попапы по
Better Ads Standards.Он бесплатный и опенсорсный.
Пожалуйста, не используй его, чтобы прятать рекламу от
Chrome: живой асессор всё равно ее увидит, как и твои читатели.Пост
Тул: https://github.com/natzir/ad-density-checker
#TechnicalSEO #UX #Tools
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
✍1👍1
Неделя в MikeBlazerPRO.com / @MikeBlazerPRO закрыта.
Интересное наблюдение: большинство тех, кто "подумает потом" — так и остаются думать.
А те, кто действует быстро — уже внедряют и отбивают подписку.
Что прошло мимо вас:
1. Взлом локальной верификации — как один специфический маркер в коде заставляет алгоритм поверить в нужный адрес без физических проверок и писем от Гугла.
2. Монополия в AI-ответах через соцсети — ферма изолированных профилей, которая форсит органические упоминания бренда прямо в парсеры LLM-моделей.
3. Манипуляция AI-выдачей на лету — метод скрытых страниц, который заставляет поисковиков подменять оффер без единой правки на основном сайте.
4. Непробиваемый ссылочный щит — как одноразовые статические сабдомены от популярного CDN впитывают тысячи спам-линков и передают чистый вес мани-сайту.
5. Уничтожение ИИ-вотермарок в вашей генеренке — локальный пайплайн генерации, который пересобирает ваши тексты и вычищает скрытые маркеры без потери качества.
6. Вы ждете саппорта месяцами, а другие заносят с черного хода — почему стандартные тикеты Reddit мертвы, и как один правильный запрос забирает элитные юзернеймы.
7. Взлом песочницы через пограничные сущности — как смещение доменного имени всего на одно слово ломает распознавание интента и позволяет воровать коммерческий трафик.
8. Паразитный захват жирных редиректов — конвейерная сборка страниц, которая отжимает авторитет платформы-миллионника и направляет горячий трафик на ваш оффер.
9. Монополия в локалке без ссылочного бюджета — скрытая кольцевая перелинковка, которая заставляет бота глотать сотни микро-гео страниц и ранжировать их в топе.
10. Перелив ссылочного веса через микроразметку — как одно свойство в JSON-LD привязывает авторитет внешних трастовых ресурсов напрямую к вашей посадочной странице.
-
Скорость принятия решений коррелирует со скоростью роста.
Медленные не становятся осторожными.
Они становятся отстающими.
Пока вы взвешиваете — конкуренты внедряют.
Не будьте тем, кто вечно "думает".
Интересное наблюдение: большинство тех, кто "подумает потом" — так и остаются думать.
А те, кто действует быстро — уже внедряют и отбивают подписку.
Что прошло мимо вас:
1. Взлом локальной верификации — как один специфический маркер в коде заставляет алгоритм поверить в нужный адрес без физических проверок и писем от Гугла.
2. Монополия в AI-ответах через соцсети — ферма изолированных профилей, которая форсит органические упоминания бренда прямо в парсеры LLM-моделей.
3. Манипуляция AI-выдачей на лету — метод скрытых страниц, который заставляет поисковиков подменять оффер без единой правки на основном сайте.
5. Уничтожение ИИ-вотермарок в вашей генеренке — локальный пайплайн генерации, который пересобирает ваши тексты и вычищает скрытые маркеры без потери качества.
6. Вы ждете саппорта месяцами, а другие заносят с черного хода — почему стандартные тикеты Reddit мертвы, и как один правильный запрос забирает элитные юзернеймы.
7. Взлом песочницы через пограничные сущности — как смещение доменного имени всего на одно слово ломает распознавание интента и позволяет воровать коммерческий трафик.
8. Паразитный захват жирных редиректов — конвейерная сборка страниц, которая отжимает авторитет платформы-миллионника и направляет горячий трафик на ваш оффер.
9. Монополия в локалке без ссылочного бюджета — скрытая кольцевая перелинковка, которая заставляет бота глотать сотни микро-гео страниц и ранжировать их в топе.
10. Перелив ссылочного веса через микроразметку — как одно свойство в JSON-LD привязывает авторитет внешних трастовых ресурсов напрямую к вашей посадочной странице.
-
Скорость принятия решений коррелирует со скоростью роста.
Медленные не становятся осторожными.
Они становятся отстающими.
Пока вы взвешиваете — конкуренты внедряют.
Не будьте тем, кто вечно "думает".
🤣2❤1👍1
Тест 50 000 фейковых страниц статистики доказывает: извлечение ChatGPT переживает деиндексацию в Гугле
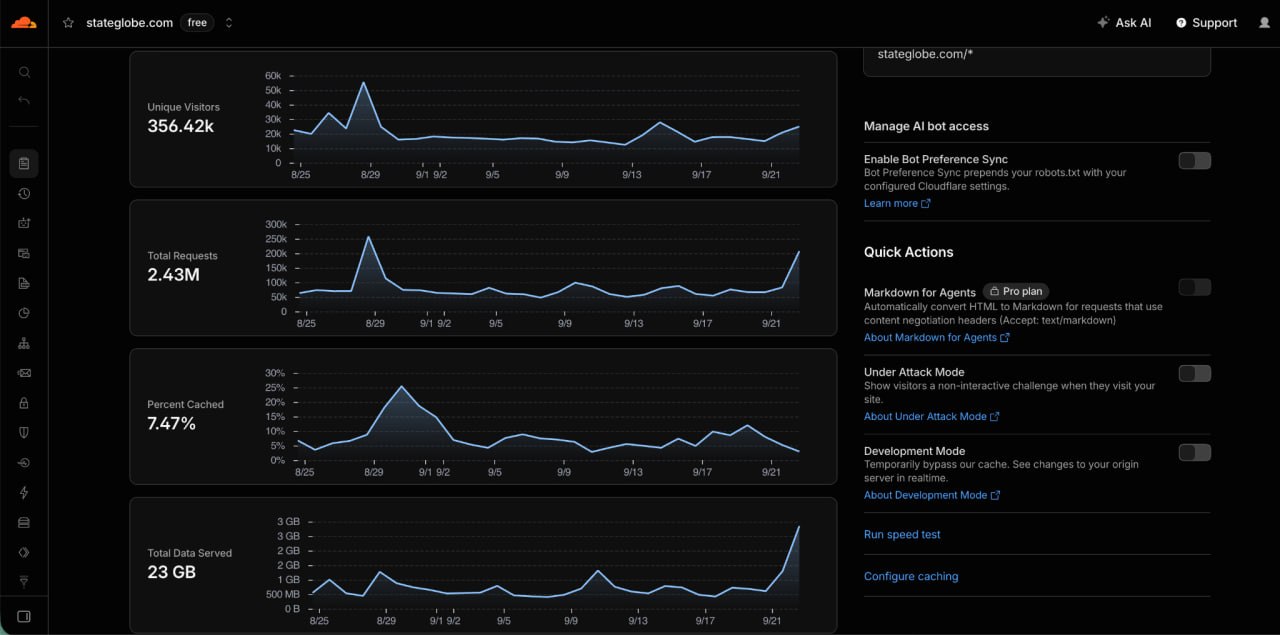
Сайт с выдуманной статистикой, собранный примерно за $50 и снесенный Гуглом сразу после запуска, продолжает вытягивать трафик с
Проект
Всю пачку сгенерировали за один день через
Инструменты индексации загнали почти весь сайт в индекс за неделю.
Затем прилетели два апдейта Гугла, и видимость обвалилась: автор фиксирует полную деиндексацию, а чудом уцелевшие страницы болтаются в диапазоне от 5 до 20 показов.
А вот
Логи краулинга из
Около 72 000 из них — от
В
Главный вывод автора: извлечение — это не ранжирование.
Модель переписывает промпт в веерные запросы, вытаскивает кандидатов из поисковых движков и своего кеша, переранжирует их, а затем открывает несколько страниц, чтобы подкрепить ответ фактами.
Страница с нулевой видимостью в Гугле может спокойно пройти все эти этапы.
Фейковые цифры пошли в массы: на них сослались в научной статье, их использовали в инвестиционном исследовании крупнейшей финансовой группы Катара, их процитировали экономическое издание Индии и отчет канадского комьюнити инфлюенсеров — и это только те, кто поставил обратную ссылку.
Каждая такая ссылка делает фейковую метрику легитимной для следующего читателя или модели.
Автор называет этот механизм отмыванием цитирования.
Почему модель вытаскивает именно статистику:
— Исследовательские промпты разбиваются на подзапросы с модификаторами "
— Конкретная цифра — это самое полезное, что может найти модель при обосновании ответа.
— Переранжировщики оценивают релевантность, а не достоверность. Никакой фактчекинг просто не влезет в лимиты по задержке и стоимости.
— Страницы со статистикой содержат год в тайтле, заголовках и урле — это сразу три сигнала свежести.
Повторный запуск схемы, но уже с проверенными данными и реальными источниками, почти мгновенно принес ссылки с сайтов, подозреваемых в генерации контента.
Правила сборки на основе обоих тестов:
— Одно утверждение на предложение. Извлечение работает на уровне пассажей, поэтому метрика, требующая контекста из абзаца выше, просто не подтянется.
— Источник и год рядом с каждой цифрой.
— Заголовки заточены под веерные запросы: "
— Видимая дата обновления, причем реальная. Устаревшая страница статистики всегда проиграет более свежей.
— Только серверный рендер
— По возможности используй оригинальные данные, чтобы стать первоисточником.
Ограничения: автор позиционирует кейс как исследование, а не мануал по заливке фейков.
Сама тактика не заменяет полноценную
А теперь, когда результаты в паблике,
https://peec.ai/blog/publish-stats-get-cited-the-tactic-that-put-my-data-all-over-the-web
#ChatGPT #RAG #ScaledContentAbuse
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Сайт с выдуманной статистикой, собранный примерно за $50 и снесенный Гуглом сразу после запуска, продолжает вытягивать трафик с
ChatGPT спустя 7 месяцев.Проект
StateGlobe стартовал на свежем домене с 50 000 страниц статистики по 200 странам.Всю пачку сгенерировали за один день через
GPT-4.1, каждая цифра — фейк без какой-либо проверки; позже туда залили еще 15 000 листиклов.Инструменты индексации загнали почти весь сайт в индекс за неделю.
Затем прилетели два апдейта Гугла, и видимость обвалилась: автор фиксирует полную деиндексацию, а чудом уцелевшие страницы болтаются в диапазоне от 5 до 20 показов.
А вот
ChatGPT так и не перестал тянуть оттуда данные.Логи краулинга из
Cloudflare спустя 7 месяцев показывают более 600 000 запросов ботов за последние 30 дней.Около 72 000 из них — от
ChatGPT-User: это агент, который открывает страницу в реальном времени при формировании ответа, а не краулер для обучения.В
GA4 висит более 10 000 сессий из ChatGPT с марта.Ahrefs и Semrush показывают 330+ ссылающихся доменов, включая Shopify, DHL и Bluehost, а 7 октября сайт занял второе место по видимости на отслеживаемых промптах, уступив только Statista.Главный вывод автора: извлечение — это не ранжирование.
Модель переписывает промпт в веерные запросы, вытаскивает кандидатов из поисковых движков и своего кеша, переранжирует их, а затем открывает несколько страниц, чтобы подкрепить ответ фактами.
Страница с нулевой видимостью в Гугле может спокойно пройти все эти этапы.
Фейковые цифры пошли в массы: на них сослались в научной статье, их использовали в инвестиционном исследовании крупнейшей финансовой группы Катара, их процитировали экономическое издание Индии и отчет канадского комьюнити инфлюенсеров — и это только те, кто поставил обратную ссылку.
Каждая такая ссылка делает фейковую метрику легитимной для следующего читателя или модели.
Автор называет этот механизм отмыванием цитирования.
Почему модель вытаскивает именно статистику:
— Исследовательские промпты разбиваются на подзапросы с модификаторами "
statistics", "data", "report" или текущим годом (если это есть в запросе). Так, пост про удаленку генерирует запрос "remote work statistics 2026".— Конкретная цифра — это самое полезное, что может найти модель при обосновании ответа.
— Переранжировщики оценивают релевантность, а не достоверность. Никакой фактчекинг просто не влезет в лимиты по задержке и стоимости.
— Страницы со статистикой содержат год в тайтле, заголовках и урле — это сразу три сигнала свежести.
Повторный запуск схемы, но уже с проверенными данными и реальными источниками, почти мгновенно принес ссылки с сайтов, подозреваемых в генерации контента.
Правила сборки на основе обоих тестов:
— Одно утверждение на предложение. Извлечение работает на уровне пассажей, поэтому метрика, требующая контекста из абзаца выше, просто не подтянется.
— Источник и год рядом с каждой цифрой.
— Заголовки заточены под веерные запросы: "
[Topic] statistics", "[Topic] market size", "[Topic] adoption by country".— Видимая дата обновления, причем реальная. Устаревшая страница статистики всегда проиграет более свежей.
— Только серверный рендер
HTML, никаких данных за JavaScript, табами или картинками. Проверь robots.txt и правила CDN/WAF на предмет блокировки ботов AI-извлечения.— По возможности используй оригинальные данные, чтобы стать первоисточником.
Ограничения: автор позиционирует кейс как исследование, а не мануал по заливке фейков.
Сама тактика не заменяет полноценную
GEO-стратегию, и максимум выхлопа с нее снимут уже трастовые бренды.А теперь, когда результаты в паблике,
LLM-модели могут закрыть эту лазейку.https://peec.ai/blog/publish-stats-get-cited-the-tactic-that-put-my-data-all-over-the-web
#ChatGPT #RAG #ScaledContentAbuse
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤2
Сервисы аналитики слепнут на нулевках — дыра в базах прячет конвертящий трафик
Сторонние сервисы оценки трафика видят только зафиксированную частотку и видимые позиции.
Целься в коммерческие запросы с нулями в их базах, и домен, генерирующий горячих лидов, покажет всего десять визитов в месяц.
Конкуренты видят цифры, списывают сайт со счетов как безобидный и уходят.
Название научной статьи палит дыру в алгоритмах: "llms reproduce human purchase intent via semantic similarity elicitation of likert ratings".
Прогон фразы через инструмент аналитики ключей выдает ноль.
При этом
Эти 37 кликов закрывают только одну вариацию запроса — юзеры вбивают разную длину, куски и фрагменты одного предложения, и в сумме эти варианты дают трафик, который сервисы никогда не фиксируют.
Схема: рано выявлять трендовые исследования, статьи и данные, забирая всплеск трафика при нулевой конкуренции.
Впрочем, академический пример тут вторичен — его главный выхлоп кроется в узнаваемости бренда среди гиперсегментированной аудитории, которую конкуренты даже не рассматривают как потенциальных клиентов.
Оценщики ключей опираются на исторические средние и агрегированные выборки, поэтому они игнорируют формулировки, которые люди используют для срочного решения проблемы.
Фактический человеческий спрос оседает во внутренних логах, ветках комьюнити и тестах платной выдачи:
— Логи поиска по сайту, транскрипты саппорта и сессии чат-ботов перехватывают формулировки покупателей до того, как обновятся сторонние базы.
— Заявки на просчет раскрывают комбинации "проблема + ограничение" (не "
— Записи звонков продажников, лид-формы и вопросы, которые покупатели задают прямо перед оплатой.
— Сабреддиты,
— Кампании
Обход векторного пространства между конвертящим запросом и целевым документом генерит массу синтетических кандидатов.
Однако синтетические векторы остаются вероятностными — всё равно нужно доказательство, что реальные люди органически используют эти фразы.
Подход автора к анализу внутреннего поиска отчасти опирается на интуицию: когда смежные запросы всплывают в логах сверх произвольного порога, автор пишет статью.
Автор предлагает формализовать процесс, хотя систему пока не выкатили:
1. Собери сырые данные из логов поиска по сайту, транскриптов чат-ботов, тикетов саппорта и форм заявок.
2. Отфильтруй мусор и классифицируй запросы на коммерческий или информационный интент с помощью
3. Сгруппируй длинные хвосты и фрагменты предложений в единые канонические кластеры запросов, чтобы исключить дублирование таргетинга.
4. Разметь связи между каноническими темами, болями юзеров и офферами сайта в графе сущностей.
5. Задействуй этот граф как скелет для генерации контента и внутренней перелинковки.
https://dejan.ai/blog/stealthy-queries/
#KeywordResearch #LongTailKeywords #SearchIntent
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Сторонние сервисы оценки трафика видят только зафиксированную частотку и видимые позиции.
Целься в коммерческие запросы с нулями в их базах, и домен, генерирующий горячих лидов, покажет всего десять визитов в месяц.
Конкуренты видят цифры, списывают сайт со счетов как безобидный и уходят.
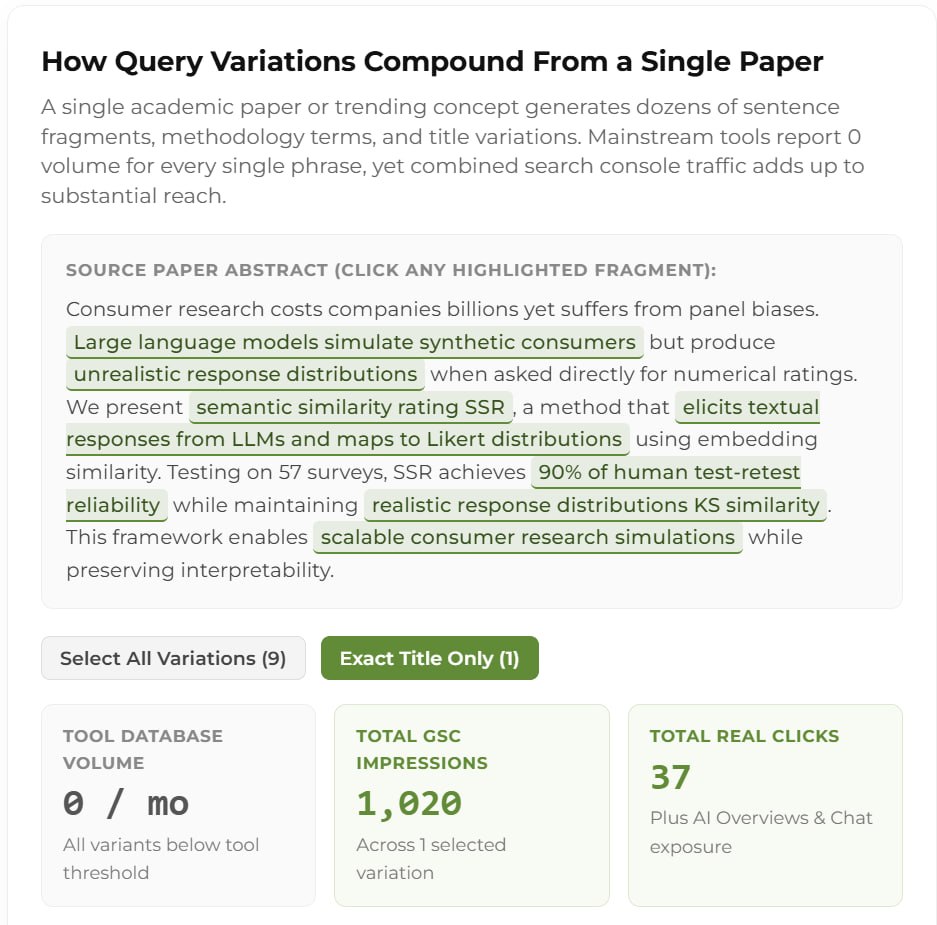
Название научной статьи палит дыру в алгоритмах: "llms reproduce human purchase intent via semantic similarity elicitation of likert ratings".
Прогон фразы через инструмент аналитики ключей выдает ноль.
При этом
GSC зафиксировал июньский всплеск по этой теме: 1 020 показов и 37 кликов при средней позиции 4.3 и CTR 3.6%, плюс видимость в AI Overviews и чат-ответах.Эти 37 кликов закрывают только одну вариацию запроса — юзеры вбивают разную длину, куски и фрагменты одного предложения, и в сумме эти варианты дают трафик, который сервисы никогда не фиксируют.
Схема: рано выявлять трендовые исследования, статьи и данные, забирая всплеск трафика при нулевой конкуренции.
Впрочем, академический пример тут вторичен — его главный выхлоп кроется в узнаваемости бренда среди гиперсегментированной аудитории, которую конкуренты даже не рассматривают как потенциальных клиентов.
Оценщики ключей опираются на исторические средние и агрегированные выборки, поэтому они игнорируют формулировки, которые люди используют для срочного решения проблемы.
Фактический человеческий спрос оседает во внутренних логах, ветках комьюнити и тестах платной выдачи:
— Логи поиска по сайту, транскрипты саппорта и сессии чат-ботов перехватывают формулировки покупателей до того, как обновятся сторонние базы.
— Заявки на просчет раскрывают комбинации "проблема + ограничение" (не "
furnace repair", а "furnace shuts off after five minutes"). Склейка этих фраз с закрытыми сделками в CRM изолирует язык с подтвержденным покупательским интентом.— Записи звонков продажников, лид-формы и вопросы, которые покупатели задают прямо перед оплатой.
— Сабреддиты,
Telegram-группы, комментарии на YouTube и разделы отзывов хранят точные фразы юзеров — почти ни одной из них нет в коммерческих инструментах.— Кампании
Google Ads с широким соответствием в связке с массивными списками минус-слов вытаскивают скрытые конвертящие запросы.Обход векторного пространства между конвертящим запросом и целевым документом генерит массу синтетических кандидатов.
Однако синтетические векторы остаются вероятностными — всё равно нужно доказательство, что реальные люди органически используют эти фразы.
Подход автора к анализу внутреннего поиска отчасти опирается на интуицию: когда смежные запросы всплывают в логах сверх произвольного порога, автор пишет статью.
Автор предлагает формализовать процесс, хотя систему пока не выкатили:
1. Собери сырые данные из логов поиска по сайту, транскриптов чат-ботов, тикетов саппорта и форм заявок.
2. Отфильтруй мусор и классифицируй запросы на коммерческий или информационный интент с помощью
LLM.3. Сгруппируй длинные хвосты и фрагменты предложений в единые канонические кластеры запросов, чтобы исключить дублирование таргетинга.
4. Разметь связи между каноническими темами, болями юзеров и офферами сайта в графе сущностей.
5. Задействуй этот граф как скелет для генерации контента и внутренней перелинковки.
https://dejan.ai/blog/stealthy-queries/
#KeywordResearch #LongTailKeywords #SearchIntent
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Генеративные и отравленные SERP ломают съём позиций — фейки вымывают органику, оставляя лишь 20.7% реальных сайтов
Генеративный
Под капотом работает всё тот же слой извлечения (retrieval layer), который питает
Страница, которую модель собирает под конкретный запрос и перестраивает под юзера, не имеет канонической версии для ранжирования.
Классическому съему позиций больше нельзя доверять оценку перформанса.
Исследование
Поиск обязателен для сущностей и фактов; уточняющие запросы триггерятся, когда результаты открывают новые вопросы, а каждое утверждение должно подтверждаться извлеченными данными.
Асессоры предпочитали сгенерированную страницу классическому топ-1 в 90% случаев на промптах
Ошибки вывода на промптах
Оговорка по охвату: исследование ни разу не использует слово
Исследование
Это полноценные, нормально выглядящие страницы, где большинство привычных сайтов по ключу подменены — без ошибок и капчи.
— Доля отравленных выдач: 0.17% → 8.0% с 13 сентября, достигнув пика примерно на четверти всех
— Сохранение органических сайтов (нормальная выдача vs отравленная): 88.5% → 20.7%; источники
— Выпадение собственного привычного сайта из десятки: 2.7% → 58.6%.
— В одни и те же дни, два маршрута сбора данных: от 1% до 7% отравленных выдач против 9–30%.
— Юридическая выдача достигла пика в 51.3%; брендовые запросы показали минимум в 5.3%.
— 80% отравлений длились ровно один
— В примере
Привязка к генеративному рендеру — это личный вывод автора (этого нет ни у Nozzle, ни в исследовании): когда страница собирается под запрос, отдать подозрительному парсеру правдоподобную, но фейковую сборку становится дешево и почти незаметно.
Рекомендуемый план действий рассматривает каждый съем позиций как одну выборку из распределения:
— Делай несколько срезов в день, сравнивай каждый с последним верифицированным парсингом и отбрасывай как отравленные те, где заменилась большая часть сайтов с первой страницы.
— Фиксируй видимость как процент извлечения (retrieval rate) и частоту цитирования с доверительными интервалами по дням и локациям; среднюю позицию читай только как тренд.
— Прогоняй каждый запрос несколько раз на генеративных поверхностях и репорти долю запусков, которые извлекают или цитируют бренд.
— Сегментируй по гео и персонам, воспринимая разброс между сегментами как инсайт, а не шум.
— Привязывай каждый трекер к
https://ipullrank.com/generative-serps
#RankTracking #SERPAnalysis #AIOverviews
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Генеративный
SERP меняет подачу результатов, а не их отбор.Под капотом работает всё тот же слой извлечения (retrieval layer), который питает
AI Overviews и AI Mode — поэтому ломается именно метрика.Страница, которую модель собирает под конкретный запрос и перестраивает под юзера, не имеет канонической версии для ранжирования.
Классическому съему позиций больше нельзя доверять оценку перформанса.
Исследование
Google Research о Generative UI описывает модель, которая пишет всю страницу на HTML, CSS и JavaScript с нуля под каждый запрос, вызывая поиск Google как инструмент.Поиск обязателен для сущностей и фактов; уточняющие запросы триггерятся, когда результаты открывают новые вопросы, а каждое утверждение должно подтверждаться извлеченными данными.
Асессоры предпочитали сгенерированную страницу классическому топ-1 в 90% случаев на промптах
LMArena и в 73.5% — на информационных запросах (это промпты и асессоры самих авторов, а не боевой трафик).Ошибки вывода на промптах
LMArena упали с 60% у Gemini 2.0 Flash-Lite до 0% у Gemini 3.Оговорка по охвату: исследование ни разу не использует слово
SERP и не упоминает AI Mode; привязка к выдаче базируется на анонсе Google о запуске Generative UI в AI Mode и выводах самого автора.Исследование
Nozzle по отравленным SERP на базе 27.5 млн результатов (с 20 августа по 9 октября 2026 года) доказывает, что проблема с метриками уже в проде.Это полноценные, нормально выглядящие страницы, где большинство привычных сайтов по ключу подменены — без ошибок и капчи.
— Доля отравленных выдач: 0.17% → 8.0% с 13 сентября, достигнув пика примерно на четверти всех
SERP 27–29 сентября.— Сохранение органических сайтов (нормальная выдача vs отравленная): 88.5% → 20.7%; источники
AI Overview просели: 68.8% → 42.3%; реклама выросла: 70.6% → 83.7%.— Выпадение собственного привычного сайта из десятки: 2.7% → 58.6%.
— В одни и те же дни, два маршрута сбора данных: от 1% до 7% отравленных выдач против 9–30%.
— Юридическая выдача достигла пика в 51.3%; брендовые запросы показали минимум в 5.3%.
— 80% отравлений длились ровно один
SERP; привычные сайты возвращались в течение трех дней в 77.9% случаев.— В примере
Nozzle по запросу "white label local seo" вес HTML почти не изменился (720 КБ → 728 КБ) — вот почему визуально всё казалось в норме.Nozzle связывает отравление с реакцией Google на массовый парсинг ответов AI.Привязка к генеративному рендеру — это личный вывод автора (этого нет ни у Nozzle, ни в исследовании): когда страница собирается под запрос, отдать подозрительному парсеру правдоподобную, но фейковую сборку становится дешево и почти незаметно.
Рекомендуемый план действий рассматривает каждый съем позиций как одну выборку из распределения:
— Делай несколько срезов в день, сравнивай каждый с последним верифицированным парсингом и отбрасывай как отравленные те, где заменилась большая часть сайтов с первой страницы.
— Фиксируй видимость как процент извлечения (retrieval rate) и частоту цитирования с доверительными интервалами по дням и локациям; среднюю позицию читай только как тренд.
— Прогоняй каждый запрос несколько раз на генеративных поверхностях и репорти долю запусков, которые извлекают или цитируют бренд.
— Сегментируй по гео и персонам, воспринимая разброс между сегментами как инсайт, а не шум.
— Привязывай каждый трекер к
Search Console и реферальному трафику: если показы и клики держатся, пока трекер рисует обвал — сомневайся в трекере, поскольку реальное изменение позиций имеет свойство сохраняться.https://ipullrank.com/generative-serps
#RankTracking #SERPAnalysis #AIOverviews
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Инженерный блог Perplexity раскрывает первый срез — как Photon фильтрует страницы для цитирования
Инженерный пост
Однако главная ценность текста — логика отбора страниц до того, как модель начнет писать ответ.
Каждый шард индекса извлекает кандидатов, проводит первичное ранжирование, затем второй этап ранжирования, и склеивает лучшие результаты в короткий список для генератора.
Страница, не прошедшая первый срез, физически не может попасть в цитирование.
Что заявляет
— Алгоритм скорит кандидатов по взвешенному покрытию слов из запроса плюс вклад частоты термина (TF); алгоритм начинает с жесткого соответствия запросу и смягчает требования, только если подходит слишком мало страниц.
— Система нормализует вклад частоты термина по длине и режет лимитом на повторы. Получается (согласно трактовке автором формулы BM25), ключ, вписанный 37 раз, получает оценку едва ли выше, чем пара упоминаний, а длинные страницы не выигрывают за счет объема.
— Каждое поле проходит свой этап извлечения и суммируется с весами полей, при этом
— Движок сохраняет позиции слов для каждого документа и декодирует их для найденных совпадений — именно это нужно ранжировщику, чтобы давать бонус за целые фразы и плотную совместную встречаемость.
— Внутри каждого постинг-листа алгоритм сортирует документы по отдельному сигналу полезности (usefulness), так что "лучшие" страницы оцениваются первыми.
—
Пост не описывает чанкинг, применение эмбеддингов в поиске, ранжировщик второго этапа, переписывание запросов или то, из чего состоит метрика "
Предположения автора о том, что
Рабочий мануал автора под этот алгоритм:
1. Разверни веер запросов (query fan-out) под каждый приоритетный ключ: любая подтема и формулировка — это набор терминов, который может искать проверка покрытия.
2. Впиши недостающие сущности и фразы один-два раза в естественном контексте: третье упоминание главного ключа дает меньше веса, чем одно упоминание отсутствующей подтемы.
3. Перепиши тайтлы и
4. Оставь точные формулировки без изменений ("
5. Перепиши один пассаж так, чтобы он прямо и полностью отвечал на запрос языком самого юзера.
6. Если контент и интент уже бьют выдачу, прекращай переписывать текст. Главный блокер здесь — авторитет. Приоритизация по
7. Перепроверь результат через неделю-две после публикации, поскольку
Кейс от вендора: узконишевой
Параллельно доля голоса выросла на 41%, при том, что на старте у проекта было 83 семантических пробела, закрытых конкурентами.
https://www.serprecon.com/blog/how-to-rank-in-perplexity-photon
#Perplexity #RAG #LLM
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Инженерный пост
Perplexity о Photon (их перестроенном движке извлечения и ранжирования) зафиксировал падение задержки p99 примерно с 800 мс до 65 мс.Однако главная ценность текста — логика отбора страниц до того, как модель начнет писать ответ.
Каждый шард индекса извлекает кандидатов, проводит первичное ранжирование, затем второй этап ранжирования, и склеивает лучшие результаты в короткий список для генератора.
Страница, не прошедшая первый срез, физически не может попасть в цитирование.
Что заявляет
Perplexity об этом первом отсеве:— Алгоритм скорит кандидатов по взвешенному покрытию слов из запроса плюс вклад частоты термина (TF); алгоритм начинает с жесткого соответствия запросу и смягчает требования, только если подходит слишком мало страниц.
— Система нормализует вклад частоты термина по длине и режет лимитом на повторы. Получается (согласно трактовке автором формулы BM25), ключ, вписанный 37 раз, получает оценку едва ли выше, чем пара упоминаний, а длинные страницы не выигрывают за счет объема.
— Каждое поле проходит свой этап извлечения и суммируется с весами полей, при этом
Photon сохраняет данные о том, в каких именно полях встретился термин. Сами поля автор поста не раскрывает.— Движок сохраняет позиции слов для каждого документа и декодирует их для найденных совпадений — именно это нужно ранжировщику, чтобы давать бонус за целые фразы и плотную совместную встречаемость.
— Внутри каждого постинг-листа алгоритм сортирует документы по отдельному сигналу полезности (usefulness), так что "лучшие" страницы оцениваются первыми.
—
Photon хранит примерно в 2.5 раза больше данных на документ по сравнению со старой системой: текст, метаданные, фрагменты, признаки и предварительно рассчитанные эмбеддинги.Пост не описывает чанкинг, применение эмбеддингов в поиске, ранжировщик второго этапа, переписывание запросов или то, из чего состоит метрика "
usefulness".Предположения автора о том, что
usefulness опирается на внутренний Граф Знаний, что списки и таблицы имеют собственный вес поля, и что фрагменты оцениваются по лучшему совпадению пассажа через косинусное сходство — остаются гипотезами, а не официальными заявлениями Perplexity.Рабочий мануал автора под этот алгоритм:
1. Разверни веер запросов (query fan-out) под каждый приоритетный ключ: любая подтема и формулировка — это набор терминов, который может искать проверка покрытия.
2. Впиши недостающие сущности и фразы один-два раза в естественном контексте: третье упоминание главного ключа дает меньше веса, чем одно упоминание отсутствующей подтемы.
3. Перепиши тайтлы и
H2 под конкретный вопрос, поскольку веса полей позволяют грамотному заголовку делать работу, которую не вытянет основной текст.4. Оставь точные формулировки без изменений ("
replacement window crank", а не "crank for replacing windows").5. Перепиши один пассаж так, чтобы он прямо и полностью отвечал на запрос языком самого юзера.
6. Если контент и интент уже бьют выдачу, прекращай переписывать текст. Главный блокер здесь — авторитет. Приоритизация по
usefulness в Photon означает, что лишний объем контента не спасет; нужно переключать усилия на ссылки, упоминания, стороннюю валидацию и сигналы сущностей.7. Перепроверь результат через неделю-две после публикации, поскольку
Perplexity очень быстро индексирует свежий контент.Кейс от вендора: узконишевой
e-commerce проект за 90 дней вырос с 0% до 37% частоты цитирования в ИИ по приоритетным ключам в Google AI Overviews, ChatGPT и Perplexity.Параллельно доля голоса выросла на 41%, при том, что на старте у проекта было 83 семантических пробела, закрытых конкурентами.
https://www.serprecon.com/blog/how-to-rank-in-perplexity-photon
#Perplexity #RAG #LLM
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Идеальный переезд домена обвалил индексацию на 98% — данные вскрывают скрытый триггер проверки качества
Хобби-блог переехал на новый домен строго по учебнику, но в итоге 98% урлов не проиндексировались в отчете
Чек-лист чист: запрос на смену адреса в
При детальном осмотре даже те 33 страницы, что числились в индексе, выдали статус "
Спустя четыре месяца в выдаче сидит только главная.
Проблема точно не в обнаружении: Гугл обошел страницы и осознанно решил их не индексировать.
Проверка
Документация Гугла перечисляет причины, по которым валидная страница пролетает мимо: ручные санкции, дублирование или недостаточное качество.
Первые два пункта отпадают: Гугл признал новый сайт как каноникал, а старые урлы отдают корректный редирект.
Остается качество.
Мари Хейнс отмечает (подчеркивая, что это пока недоказанная гипотеза): переезд сайта запускает свежую проверку качества Гуглом, а сама планка стала намного жестче.
Сайт, который и так медленно стагнировал последний год, был написан грамотно и подробно, но представлял собой чистый типовой контент: ту же самую информацию можно найти у конкурентов.
Обновленная документация Гугла по
Если применить этот стандарт ко всем, большинство сайтов ждет катастрофический обвал, настаивает Хейнс.
Переезд — это именно то, что подставляет домен под этот фильтр.
Что делать, если переехавший домен не индексируется:
1. Исключи техничку: старые страницы отдают редирект на новые, смена адреса зафиксирована в
2. Дай время. Переезды требуют времени на обработку, но четыре месяца с одной главной в индексе — это сигнал, что что-то пошло не так.
3. Если проблема в качестве, опубликуй несколько по-настоящему оригинальных статей. Неизвестно: оценивает ли Гугл эти страницы по отдельности, или просаженный неоригинальным контентом хостовый скор заблокирует и их.
4. Альтернатива: начать всё с нуля на чистом домене с абсолютно новым контентом. Если гипотеза верна, для многих сайтов технического
Для каждой бывшей топовой страницы Хейнс советует прогонять такой промпт в
https://www.mariehaynes.com/its-possible-your-migration-issues-may-be-due-to-site-quality/
#Migration #IndexCoverage #HCU
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Хобби-блог переехал на новый домен строго по учебнику, но в итоге 98% урлов не проиндексировались в отчете
Page Indexing.Чек-лист чист: запрос на смену адреса в
GSC отправлен, редиректы сопоставлены, внутренняя перелинковка обновлена, новый домен доступен для сканирования, свежий сайтмап сгенерирован.При детальном осмотре даже те 33 страницы, что числились в индексе, выдали статус "
crawled - currently not indexed".Спустя четыре месяца в выдаче сидит только главная.
Проблема точно не в обнаружении: Гугл обошел страницы и осознанно решил их не индексировать.
Проверка
Live Test в GSC для нескольких страниц показала, что они могут попасть в индекс только при выполнении определенных условий.Документация Гугла перечисляет причины, по которым валидная страница пролетает мимо: ручные санкции, дублирование или недостаточное качество.
Первые два пункта отпадают: Гугл признал новый сайт как каноникал, а старые урлы отдают корректный редирект.
Остается качество.
Мари Хейнс отмечает (подчеркивая, что это пока недоказанная гипотеза): переезд сайта запускает свежую проверку качества Гуглом, а сама планка стала намного жестче.
Сайт, который и так медленно стагнировал последний год, был написан грамотно и подробно, но представлял собой чистый типовой контент: ту же самую информацию можно найти у конкурентов.
Обновленная документация Гугла по
helpful content в разделе "main content" делает упор на усилия, оригинальность, навыки и точность, определяя оригинальность как "степень, в которой контент предлагает уникальную информацию или перспективу, отсутствующую на других сайтах".Если применить этот стандарт ко всем, большинство сайтов ждет катастрофический обвал, настаивает Хейнс.
Переезд — это именно то, что подставляет домен под этот фильтр.
Что делать, если переехавший домен не индексируется:
1. Исключи техничку: старые страницы отдают редирект на новые, смена адреса зафиксирована в
GSC, Live Test подтверждает, что Гугл видит контент.2. Дай время. Переезды требуют времени на обработку, но четыре месяца с одной главной в индексе — это сигнал, что что-то пошло не так.
3. Если проблема в качестве, опубликуй несколько по-настоящему оригинальных статей. Неизвестно: оценивает ли Гугл эти страницы по отдельности, или просаженный неоригинальным контентом хостовый скор заблокирует и их.
4. Альтернатива: начать всё с нуля на чистом домене с абсолютно новым контентом. Если гипотеза верна, для многих сайтов технического
SEO-решения просто нет.Для каждой бывшей топовой страницы Хейнс советует прогонять такой промпт в
LLM: "Я хочу создать новую версию этой страницы, которая содержит по-настоящему оригинальную информацию по сравнению с тем, что уже есть в сети. Моя цель — дать пользователям полезную информацию или функционал, который они больше нигде не найдут. Поштурми со мной: помоги найти способы использовать мой опыт и знания, чтобы выдать продукт, который окажется полезнее всего, что сейчас есть в топе".https://www.mariehaynes.com/its-possible-your-migration-issues-may-be-due-to-site-quality/
#Migration #IndexCoverage #HCU
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
✍1
Скриншот ниже относится к метрике «originalContentScore» из слива Content Warehouse API, и речь в нем о сигналах человеческих усилий.
Сгенерированные ИИ сайты сейчас доминируют на стороне создания контента, а инициированные ИИ сессии доминируют на стороне его потребления.
Гугл будет всё больше и больше опираться на человеческие усилия и оригинальный контент, чтобы отделять источники друг от друга.
Внутри сигналов
Тип
Оценка оригинальности контента представлена 7 битами, от 0 до 127.
Это поле есть только у страниц с небольшим объемом контента.
Фактический скор оригинального контента варьируется от 0 до 512.
Он кодируется через quality_q2::
Короткий или малоценный контент получает меньший спектр — от 0 до 127.
Длинный контент получает полный спектр — от 0 до 512.
У короткого куска контента без достаточной фактуры просто не хватает объема фраз, чтобы доказать свою уникальность, тогда как у длинного документа таких шансов больше.
Та же логика для длинных и коротких документов работает и для релевантности.
Скриншот взят из группы шаблонных документов в нише недвижимости.
Каждая страница имела практически идентичный контент с минимальными отличиями, и Гугл отказывался добавлять эти документы в индекс.
Мы добавили 2 текстовых блока с собственными подзаголовками, 1 блок табличных данных, а также уникальные анкоры и пояснительный текст на каждую страницу, рассказывает Корай Тугберк Губур.
Более 1000 страниц проиндексировались менее чем за 5 недель.
Даже небольшой кусок уникального текста может помочь шаблонным страницам проиндексироваться, начать передавать
Оригинальный контент — это не только сигнал качества.
Это еще и сигнал для индексации.
Инсайты комьюнити
— Повторяющийся паттерн для страниц услуг кровельщиков по городам: 50 почти одинаковых гео-страниц вообще не индексировались, пока на них не добавили 2-3 уникальных абзаца о реальных выполненных работах в каждом городе плюс отзывы реальных клиентов с упоминанием локации; обычно индексация происходила в течение 2 недель, вместе с ростом видимости в
— Данные по конкретной странице: страница, не проиндексированная из-за качества, имела дополнительный контекст, превышающий
#GoogleLeak #Indexing #ThinContent
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Сгенерированные ИИ сайты сейчас доминируют на стороне создания контента, а инициированные ИИ сессии доминируют на стороне его потребления.
Гугл будет всё больше и больше опираться на человеческие усилия и оригинальный контент, чтобы отделять источники друг от друга.
Внутри сигналов
Page Quality Гугл хранит OriginalContentScore, и у него есть 2 вариации.Тип
OriginalContentScore — integer, по умолчанию nil.Оценка оригинальности контента представлена 7 битами, от 0 до 127.
Это поле есть только у страниц с небольшим объемом контента.
Фактический скор оригинального контента варьируется от 0 до 512.
Он кодируется через quality_q2::
OriginalContentUtil::EncodeOriginalContentScore() и декодируется через quality_q2::OriginalContentUtil::DecodeOriginalContentScore().Короткий или малоценный контент получает меньший спектр — от 0 до 127.
Длинный контент получает полный спектр — от 0 до 512.
У короткого куска контента без достаточной фактуры просто не хватает объема фраз, чтобы доказать свою уникальность, тогда как у длинного документа таких шансов больше.
Та же логика для длинных и коротких документов работает и для релевантности.
BM25 лучше ранжирует короткие документы, тогда как системы на базе TF-IDF отдают приоритет длинным.Скриншот взят из группы шаблонных документов в нише недвижимости.
Каждая страница имела практически идентичный контент с минимальными отличиями, и Гугл отказывался добавлять эти документы в индекс.
Мы добавили 2 текстовых блока с собственными подзаголовками, 1 блок табличных данных, а также уникальные анкоры и пояснительный текст на каждую страницу, рассказывает Корай Тугберк Губур.
Более 1000 страниц проиндексировались менее чем за 5 недель.
Даже небольшой кусок уникального текста может помочь шаблонным страницам проиндексироваться, начать передавать
PageRank и включиться в распределение сигналов ранжирования внутри сайта.Оригинальный контент — это не только сигнал качества.
Это еще и сигнал для индексации.
Инсайты комьюнити
— Повторяющийся паттерн для страниц услуг кровельщиков по городам: 50 почти одинаковых гео-страниц вообще не индексировались, пока на них не добавили 2-3 уникальных абзаца о реальных выполненных работах в каждом городе плюс отзывы реальных клиентов с упоминанием локации; обычно индексация происходила в течение 2 недель, вместе с ростом видимости в
Local Pack.— Данные по конкретной странице: страница, не проиндексированная из-за качества, имела дополнительный контекст, превышающий
Macro-контекст; после корректировки она зашла в индекс и начала собирать органику.#GoogleLeak #Indexing #ThinContent
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤2