
"Образцовые" издатели Google были уничтожены апдейтами
Анализ 190 доменов, которых Google ранее приводил в пример в своих историях успеха, показывает сокрушительный чистый негативный эффект после волны апдейтов с августа 2022 года.
Сайты, которые потеряли трафик, показали среднее падение на -58.92%, в то время как сайты, которые выросли, показали средний рост всего на +37.3%.
Эти данные указывают на то, что подражание отобранным Google "образцовым гражданам" не дает никакого иммунитета от алгоритмического разгрома.
Трафик этих высококачественных издателей не был просто перетасован, а перераспределен в собственную экосистему Google и к его партнерам, включая
Это представляет собой системный сдвиг, где предвзятость к авторитету — определяемая масштабом и консенсусом — теперь превосходит нишевую экспертизу.
Вывод: договор о доверии с Google разорван; их публичные рекомендации следует рассматривать как пропаганду.
Ваш стратегический план действий должен теперь исходить из того, что система играет против нас.
Фокусируйтесь на агрессивной диверсификации источников трафика, используйте временные лазейки вроде
https://presswhizz.com/blog/google-publisher-case-studies/
#CoreUpdates #ParasiteSEO #SERPAnalysis
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
Анализ 190 доменов, которых Google ранее приводил в пример в своих историях успеха, показывает сокрушительный чистый негативный эффект после волны апдейтов с августа 2022 года.
Сайты, которые потеряли трафик, показали среднее падение на -58.92%, в то время как сайты, которые выросли, показали средний рост всего на +37.3%.
Эти данные указывают на то, что подражание отобранным Google "образцовым гражданам" не дает никакого иммунитета от алгоритмического разгрома.
Трафик этих высококачественных издателей не был просто перетасован, а перераспределен в собственную экосистему Google и к его партнерам, включая
YouTube, AI Overviews, Reddit и Quora.Это представляет собой системный сдвиг, где предвзятость к авторитету — определяемая масштабом и консенсусом — теперь превосходит нишевую экспертизу.
Вывод: договор о доверии с Google разорван; их публичные рекомендации следует рассматривать как пропаганду.
Ваш стратегический план действий должен теперь исходить из того, что система играет против нас.
Фокусируйтесь на агрессивной диверсификации источников трафика, используйте временные лазейки вроде
Parasite SEO для генерации кэшфлоу, атакуйте неохваченные рынки, такие как неанглоязычные SERPs, и используйте сам SERP — а не документацию Google — как единственный источник правды.https://presswhizz.com/blog/google-publisher-case-studies/
#CoreUpdates #ParasiteSEO #SERPAnalysis
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
❤5✍2👍2
Сопоставление апдейтов алгоритма Google с атрибутами из утечек данных
Логические выводы в скриншоте.
#CoreUpdates #AlgorithmPenalties #SERPAnalysis
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
content warehouse api.Логические выводы в скриншоте.
#CoreUpdates #AlgorithmPenalties #SERPAnalysis
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
🤝2
Почему 10-кратный всплеск трафика может сигнализировать о скором коллапсе
Получить массивный скачок трафика — кажется, что это главная победа, но это может быть обманчивым и опасным сигналом.
У нас однажды был проект, который подскочил с 50 000 до 600 000 кликов в месяц после роста позиций, но это идеальный пример феномена, который я называю
Такой взрывной рост крайне нестабилен; трафик часто держится всего три недели или месяц, а затем обваливается — жестко и болезненно.
Вместо погони за этими волатильными всплесками, вам стоит целиться в более надежную траекторию роста.
Я гораздо больше предпочитаю постепенный рост, который поддерживается со временем, доказывая свою стабильность через несколько апдейтов алгоритма.
Например, в другом проекте мы опубликовали 200 статей и терпеливо ждали
Когда апдейт наконец случился, наш трафик начал стабильно расти и продолжает это делать.
В этом и есть ключевая разница: рост, который заслужен и подтвержден алгоритмическими процессами, долговечен.
Массивный, однодневный успех события
Настоящий успех вдолгую — это не самый большой разовый скачок, а построение фундамента, который каждый новый апдейт только укрепляет.
#SERPVolatility #Rankings #CoreUpdates
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
Получить массивный скачок трафика — кажется, что это главная победа, но это может быть обманчивым и опасным сигналом.
У нас однажды был проект, который подскочил с 50 000 до 600 000 кликов в месяц после роста позиций, но это идеальный пример феномена, который я называю
Sinister Search, предостерегает Корай Тугберк Губюр.Такой взрывной рост крайне нестабилен; трафик часто держится всего три недели или месяц, а затем обваливается — жестко и болезненно.
Вместо погони за этими волатильными всплесками, вам стоит целиться в более надежную траекторию роста.
Я гораздо больше предпочитаю постепенный рост, который поддерживается со временем, доказывая свою стабильность через несколько апдейтов алгоритма.
Например, в другом проекте мы опубликовали 200 статей и терпеливо ждали
core-апдейта, зная, что он необходим для роста наших позиций.Когда апдейт наконец случился, наш трафик начал стабильно расти и продолжает это делать.
В этом и есть ключевая разница: рост, который заслужен и подтвержден алгоритмическими процессами, долговечен.
Массивный, однодневный успех события
Sinister Search часто является предвестником столь же драматичного провала.Настоящий успех вдолгую — это не самый большой разовый скачок, а построение фундамента, который каждый новый апдейт только укрепляет.
#SERPVolatility #Rankings #CoreUpdates
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
❤3
Уникальные активы и закрытие задач бьют широкую семантику в ранжировании Google
Анализ более 400 сайтов-победителей и проигравших в кор-апдейте за декабрь 2025 года раскрывает четкий паттерн ранжирования.
Пять фичей показывают максимальную корреляцию Спирмена с ростом трафика:
Offers Product/Service (0.391),
Allows Task Completion (0.381),
Proprietary Assets (0.357),
Tight Topical Focus (0.250),
Strong Brand (0.206).
Эта механика опровергает классические догмы SEO.
Гугл шагнул дальше метрики "хороший контент" и теперь награждает то, что ИИ скопировать не может: собственные датасеты, реальный инвентарь или юзерский контент.
Сила бренда, показавшая самую низкую корреляцию из пяти факторов, раскрывает критический инсайт: брендовый объем поиска имеет значение, только если он отражает навигационный интент.
Аддитивный эффект мультиплицирует давление отбора.
Наличие только одной фичи дает винрейт 13.5%–15.4%.
Четыре фичи в связке форсируют результат до 68.1%.
Пять фичей: 69.7%.
Каждый столп наслаивается на предыдущий — закрытие задачи без собственных активов или узкого фокуса проваливается.
Узкий тематический фокус вынес широкую авторитетность в декабрьском анализе 2025 года.
Гугл закрутил алгоритм отбора — широкие ресурсы теряют позиции независимо от качества контента.
Специфичность напрямую предсказывает победителей.
Барьер внедрения остается структурным: переделать новостник в поставщика услуг или собрать уникальные датасеты с нуля — это задача вне рамок быстрых фиксов.
Тревел-блоги не превращаются в туроператоров за одну ночь.
Но данные четко подсвечивают цель:
— строй уникальный продукт,
— закрывай задачу юзера прямо на сайте,
— держи нишу,
— владей исходниками и стань финальной точкой поиска,
— а не очередным контент-паблишером.
https://signal.zyppy.com/p/winning-google
#CoreUpdates #Rankings #ContentStrategy
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Анализ более 400 сайтов-победителей и проигравших в кор-апдейте за декабрь 2025 года раскрывает четкий паттерн ранжирования.
Пять фичей показывают максимальную корреляцию Спирмена с ростом трафика:
Offers Product/Service (0.391),
Allows Task Completion (0.381),
Proprietary Assets (0.357),
Tight Topical Focus (0.250),
Strong Brand (0.206).
Эта механика опровергает классические догмы SEO.
Гугл шагнул дальше метрики "хороший контент" и теперь награждает то, что ИИ скопировать не может: собственные датасеты, реальный инвентарь или юзерский контент.
BudgetBytes обходит стандартные сайты рецептов, потому что продает планы питания.MathIsFun выигрывает у образовательных паблишеров, потому что юзеры решают интерактивные задачи и проходят квизы прямо на сайте.WalletHub генерирует таблицы сравнений, но проигрывает — пользователи уходят оформлять карты на другие ресурсы, закрытие задачи равно нулю.Сила бренда, показавшая самую низкую корреляцию из пяти факторов, раскрывает критический инсайт: брендовый объем поиска имеет значение, только если он отражает навигационный интент.
Lifewire остается крайне узнаваемым брендом, но теряет позиции, поскольку его трафик строится на запросах из long-tail, а не на брендовой навигации.Zoom, напротив, сформировал навигационный спрос — именно этот механизм удерживает динамику ранжирования.Аддитивный эффект мультиплицирует давление отбора.
Наличие только одной фичи дает винрейт 13.5%–15.4%.
Четыре фичи в связке форсируют результат до 68.1%.
Пять фичей: 69.7%.
Каждый столп наслаивается на предыдущий — закрытие задачи без собственных активов или узкого фокуса проваливается.
Узкий тематический фокус вынес широкую авторитетность в декабрьском анализе 2025 года.
Minecraft.wiki и HappiestBaby.com бьют строго в одну тему и обходят паблишеров, которые пишут обо всем подряд: от развлечений и культуры до воспитания детей.Гугл закрутил алгоритм отбора — широкие ресурсы теряют позиции независимо от качества контента.
Специфичность напрямую предсказывает победителей.
Барьер внедрения остается структурным: переделать новостник в поставщика услуг или собрать уникальные датасеты с нуля — это задача вне рамок быстрых фиксов.
Тревел-блоги не превращаются в туроператоров за одну ночь.
Но данные четко подсвечивают цель:
— строй уникальный продукт,
— закрывай задачу юзера прямо на сайте,
— держи нишу,
— владей исходниками и стань финальной точкой поиска,
— а не очередным контент-паблишером.
https://signal.zyppy.com/p/winning-google
#CoreUpdates #Rankings #ContentStrategy
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

❤4
Bing-страницы с YouTube-эмбедами перехватывают выдачу Гугла после кор-апдейта
Эмбеды
Если льешь через
Инструкция: Собери паттерны
Закинь в индекс через
Пингани
Тайминг после кор-апдейта решает.
С марта
Техника работает на эмбедах
Временное окно закрывается: политика
Яндекс использовал этот же вектор до фильтров.
Инсайты SEO-комьюнити
— После кор-апдейта щедрое ранжирование эмбедов в
#ParasiteSEO #CoreUpdates #Bing
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Эмбеды
YouTube-видео на riverview страницах Bing ранжируются в Гугле после кор-апдейта.Если льешь через
YouTube-паразитов, проиндексируй страницы с эмбедами в Bing, и они всплывут в серпе Гугла.Инструкция: Собери паттерны
URL в видеопоиске Bing.Закинь в индекс через
rapid-indexer.com.Пингани
IndexNow на хост-странице Bing — он подхватит ссылку за несколько часов.Тайминг после кор-апдейта решает.
С марта
Bing раздает эмбедам траст щедрее Гугла.Техника работает на эмбедах
Reddit и Medium.Временное окно закрывается: политика
Bing ужесточится, когда эксплойт пойдет в массы.Яндекс использовал этот же вектор до фильтров.
Инсайты SEO-комьюнити
— После кор-апдейта щедрое ранжирование эмбедов в
Bing выходит за пределы YouTube: эмбеды Reddit и Medium выходят в топ Гугла через тот же механизм. Ожидаются параллельные патчи — закрывай окно возможностей, пока платформы не закрутили гайки.#ParasiteSEO #CoreUpdates #Bing
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

❤2
Анализ серпа доказывает: спам-санкции лишают 82% доменов шанса на откат в кор-апдейт
Анализ серпа по 100 000 запросов доказывает: мартовские апдейты Гугла радикально перекроили пороги оценки траста.
Более 24% страниц из топ-10 вылетели за пределы топ-100 — это почти в два раза выше показателя смещения в 15%, который фиксировался во время декабрьской выкатки.
Алгоритм отдал эти потерянные позиции глубоко зарытому инвентарю, закинув страницы из-за пределов топ-20 сразу на 30% текущих мест в топ-3.
Чтобы стабилизировать этот экстремальный шторм выдачи, алгоритм откатился к возрасту домена как к базовому сигналу траста.
Ассеты старше 15 лет теперь забирают более 57% позиций в топ-10, тогда как домены младше года выскребли микроскопическую маржу роста в 0.7%.
Механически эти данные вскрывают жесткое архитектурное разделение между циклами пессимизации у Гугла.
Система полностью изолирует детект спама от оценки качества в рамках кор-апдейта.
Домены, словившие фильтр за спам, не восстанавливаются в ходе последующего кор-апдейта.
В частности, после завершения кор-апдейта алгоритм наглухо заблокировал 82% доменов, которые улетели за топ-100 во время спам-чистки.
На уровне
Старые контентные кластера — конкретно статьи возрастом два-три года — попали под точечную зачистку при использовании двоеточия (:) в строке тайтла.
Около 20% старых
Получается, при переоценке стареющей инфраструктуры алгоритм триггерит новые фильтры форматирования или качества.
https://www.reddit.com/r/seogrowth/comments/1sqn7tm/googles_march_2026_update_was_more_volatile_than/
#CoreUpdates #SpamUpdate #SERPVolatility
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Анализ серпа по 100 000 запросов доказывает: мартовские апдейты Гугла радикально перекроили пороги оценки траста.
Более 24% страниц из топ-10 вылетели за пределы топ-100 — это почти в два раза выше показателя смещения в 15%, который фиксировался во время декабрьской выкатки.
Алгоритм отдал эти потерянные позиции глубоко зарытому инвентарю, закинув страницы из-за пределов топ-20 сразу на 30% текущих мест в топ-3.
Чтобы стабилизировать этот экстремальный шторм выдачи, алгоритм откатился к возрасту домена как к базовому сигналу траста.
Ассеты старше 15 лет теперь забирают более 57% позиций в топ-10, тогда как домены младше года выскребли микроскопическую маржу роста в 0.7%.
Механически эти данные вскрывают жесткое архитектурное разделение между циклами пессимизации у Гугла.
Система полностью изолирует детект спама от оценки качества в рамках кор-апдейта.
Домены, словившие фильтр за спам, не восстанавливаются в ходе последующего кор-апдейта.
В частности, после завершения кор-апдейта алгоритм наглухо заблокировал 82% доменов, которые улетели за топ-100 во время спам-чистки.
На уровне
URL практики отслеживают локальные аномалии деиндексации, напрямую завязанные на синтаксис тега title.Старые контентные кластера — конкретно статьи возрастом два-три года — попали под точечную зачистку при использовании двоеточия (:) в строке тайтла.
Около 20% старых
URL с таким синтаксисом полностью вылетели из индекса.Получается, при переоценке стареющей инфраструктуры алгоритм триггерит новые фильтры форматирования или качества.
https://www.reddit.com/r/seogrowth/comments/1sqn7tm/googles_march_2026_update_was_more_volatile_than/
#CoreUpdates #SpamUpdate #SERPVolatility
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Смена User-Agent в логах сервера палит начало Core Update за неделю до анонса
Вы должны быть предельно осторожны с официальными датами анонсов
Мы видели значительные сдвиги в позициях за неделю до того, как апдейт вообще анонсировали, а волатильность может продолжаться до месяца после того, как Google заявляет о завершении выкатки, так что вас может зацепить уже после того, как они отрапортовали об окончании, предупреждает Тед Кубайтис.
Более надежный опережающий индикатор можно найти в ваших серверных логах.
Резкое изменение в паттерне краулинга Гуглобота — это сильный сигнал о том, что развертывание крупного апдейта неизбежно, часто опережающий официальный анонс на 7-10 дней.
С нашей точки зрения, процессинг начинается задолго до того, как об этом сообщают публике, раскрывает Ли Уитчер.
Мы даже наблюдали повторяющийся
Новые версии Гуглобота часто выкатываются по четвергам около 4
Как только апдейт начался, вы можете отслеживать его ход, мониторя самих ботов, отмечает Ли Уитчер.
Типичный паттерн — это первоначальная выкатка "бота-анонсера", за которым следует совершенно другая версия бота примерно через неделю-10 дней.
Помимо серверных логов, мы используем подход "канарейки в угольной шахте", чтобы получить раннее предупреждение о конкретных алгоритмических изменениях, объясняет Тед Кубайтис.
Это включает в себя создание и отслеживание позиций страниц, которые намеренно используют черные или спамные тактики, которые Google, в теории, должен штрафовать.
У нас есть целая когорта таких "канареечных" страниц, созданных с переспамом ключевыми словами, скрытым текстом в
Если группа таких страниц внезапно вылетает из индекса, это дает сильный, ранний сигнал о том, что Google наконец-то выкатил алгоритмическое обновление, нацеленное на эту конкретную тактику.
#CoreUpdates #LogFileAnalysis #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Вы должны быть предельно осторожны с официальными датами анонсов
core-апдейтов от Google, так как они являются ненадежными индикаторами того, когда на самом деле прилетит эффект.Мы видели значительные сдвиги в позициях за неделю до того, как апдейт вообще анонсировали, а волатильность может продолжаться до месяца после того, как Google заявляет о завершении выкатки, так что вас может зацепить уже после того, как они отрапортовали об окончании, предупреждает Тед Кубайтис.
Более надежный опережающий индикатор можно найти в ваших серверных логах.
Резкое изменение в паттерне краулинга Гуглобота — это сильный сигнал о том, что развертывание крупного апдейта неизбежно, часто опережающий официальный анонс на 7-10 дней.
С нашей точки зрения, процессинг начинается задолго до того, как об этом сообщают публике, раскрывает Ли Уитчер.
Мы даже наблюдали повторяющийся
DevOps-паттерн, который может помочь вам предвидеть эти изменения.Новые версии Гуглобота часто выкатываются по четвергам около 4
PM по восточному времени (ET), что дает еще один потенциальный сигнал, за которым стоит следить, добавляет Чарльз Тейлор.Как только апдейт начался, вы можете отслеживать его ход, мониторя самих ботов, отмечает Ли Уитчер.
Типичный паттерн — это первоначальная выкатка "бота-анонсера", за которым следует совершенно другая версия бота примерно через неделю-10 дней.
Помимо серверных логов, мы используем подход "канарейки в угольной шахте", чтобы получить раннее предупреждение о конкретных алгоритмических изменениях, объясняет Тед Кубайтис.
Это включает в себя создание и отслеживание позиций страниц, которые намеренно используют черные или спамные тактики, которые Google, в теории, должен штрафовать.
У нас есть целая когорта таких "канареечных" страниц, созданных с переспамом ключевыми словами, скрытым текстом в
div'ах, белым текстом на белом фоне и даже lorem ipsum, заточенным под ключи.Если группа таких страниц внезапно вылетает из индекса, это дает сильный, ранний сигнал о том, что Google наконец-то выкатил алгоритмическое обновление, нацеленное на эту конкретную тактику.
#CoreUpdates #LogFileAnalysis #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Джон Мюллер, Google, 2018
Подробнее здесь: How To Get Google To Crawl And Index Your Site Quickly;.
***
Как я и говорил, ты реально можешь ТОЧНО ПРЕДСКАЗАТЬ показатели трафика после апдейтов Гугла, отмечает Шон Андерсон.
Алгоритмический стеклянный потолок РЕАЛЕН, и он определяется ТРАСТОМ и АВТОРИТЕТОМ.
Траст — это рычаг, который перебивает Авторитет.
Короче говоря, ты можешь добавить еще 100 страниц и получить тот же объем трафика, если тебя алгоритмически пессимизировали из-за проблем с ТРАСТОМ.
Или эта красная линия, за которой я слежу годами, — просто галлюцинация.
#CoreUpdates #CrawlBudget #LinkEquity
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Обычно нельзя просто произвольно расширить сайт и ожидать, что старые страницы будут ранжироваться так же, как и новые. При прочих равных, добавляя страницы, ты размазываешь ценность по всему набору, и каждая из них получает чуть меньше. Конечно, если ты развиваешь бизнес, то больше твоих страниц могут привлекать больше внимания, и ты сможешь продавать больше, так что обычно 'прочие равные' не остаются равными.
Джон Мюллер, Google, 2018
Подробнее здесь: How To Get Google To Crawl And Index Your Site Quickly;.
***
Как я и говорил, ты реально можешь ТОЧНО ПРЕДСКАЗАТЬ показатели трафика после апдейтов Гугла, отмечает Шон Андерсон.
Алгоритмический стеклянный потолок РЕАЛЕН, и он определяется ТРАСТОМ и АВТОРИТЕТОМ.
Траст — это рычаг, который перебивает Авторитет.
Короче говоря, ты можешь добавить еще 100 страниц и получить тот же объем трафика, если тебя алгоритмически пессимизировали из-за проблем с ТРАСТОМ.
Или эта красная линия, за которой я слежу годами, — просто галлюцинация.
#CoreUpdates #CrawlBudget #LinkEquity
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤7
Собственные рейтинги продуктов приносят цитирование, но в 69% случаев ИИ рекомендует конкурентов
Самая популярная тактика
Полевые данные по
Из 100 отслеживаемых промптов 74 выдали
(Нюанс: примерно 1 из 5 запросов на лучший софт вообще не триггерил AI Overview; цифра в 69% высчитана из тех 80, где ответ был).
Обратный эффект бьет максимально жестко.
Ваша подборка обязана называть конкурентов, чтобы выглядеть трастово — и именно эти упоминания скармливают конкурентам их рекомендации.
В отслеживаемых примерах (Oasis LMS, Kredo Learning, Pylon, TMetric, Pollfish) ИИ цитировал сайт автора, но советовал тех конкурентов, которых этот автор перечислил у себя.
По сути, цитата работает как голос за всех в вашем списке, кроме вас самих.
Аналитика Лили Рэй: похоже, Google разорвал связь между тем, кого он берет в качестве источника, и тем, кого рекомендует в ответе.
Цитату можно получить за счет отлично оптимизированной страницы; а вот рекомендация теперь опирается на внешние сигналы (ссылающиеся домены, упоминания бренда в AI Overview, упоминания в ChatGPT), а не на самовосхваление.
Исключенные бренды часто имели сильные, прокачанные страницы (поэтому они ранжировались и получали ссылку-цитату); просто о рекомендованных брендах больше говорили в сети.
Признанные лидеры рынка всё ещё забирают и цитату, и рекомендацию, так что механика теперь работает исключительно как производная от того авторитета, который у вас уже есть.
Под
Примерно 20 января 2026 года Google, судя по всему, выкатил алгоритмическую корректировку, которая срезала органическую видимость сайтов, плотно сидящих на этой тактике.
Сначала удар пришелся по директориям с подборками, затем санкции расползлись на весь домен, а во время майского кор-апдейта 2026 года падение ускорилось (проанализировано 40+ пострадавших сайтов).
Попытка прощупать границу дозволенного на одной папке подставляла под удар весь домен.
Метрика, про которую пора забыть: погоня за цитированием в ИИ как сигнал успеха.
Исследование
В разрыве между цитатой и рекомендацией именно рекомендация качает бизнес, и покупается она за счет внешнего авторитета, а не похвалы самому себе.
https://lilyraynyc.substack.com/p/why-calling-yourself-the-best-could
#AIOverviews #GEO #CoreUpdates
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Самая популярная тактика
GEO — выкатить подборку "лучший [продукт]" и поставить свой бренд на первое место — тихо развернулась против большинства сайтов.Полевые данные по
100 B2B-запросам best [category] software из Google AI Overviews на трех чекпоинтах (15 апреля, 15 мая, 8 июня 2026 года) фиксируют: когда ИИ брал собственную саморекламную статью бренда как источник, этот бренд вылетал из итоговой рекомендации в 69% случаев (224 из 323 процитированных статей).Из 100 отслеживаемых промптов 74 выдали
AI Overview, который сослался на статью автора, но исключил сам бренд из списка победителей.(Нюанс: примерно 1 из 5 запросов на лучший софт вообще не триггерил AI Overview; цифра в 69% высчитана из тех 80, где ответ был).
Обратный эффект бьет максимально жестко.
Ваша подборка обязана называть конкурентов, чтобы выглядеть трастово — и именно эти упоминания скармливают конкурентам их рекомендации.
В отслеживаемых примерах (Oasis LMS, Kredo Learning, Pylon, TMetric, Pollfish) ИИ цитировал сайт автора, но советовал тех конкурентов, которых этот автор перечислил у себя.
По сути, цитата работает как голос за всех в вашем списке, кроме вас самих.
Аналитика Лили Рэй: похоже, Google разорвал связь между тем, кого он берет в качестве источника, и тем, кого рекомендует в ответе.
Цитату можно получить за счет отлично оптимизированной страницы; а вот рекомендация теперь опирается на внешние сигналы (ссылающиеся домены, упоминания бренда в AI Overview, упоминания в ChatGPT), а не на самовосхваление.
Исключенные бренды часто имели сильные, прокачанные страницы (поэтому они ранжировались и получали ссылку-цитату); просто о рекомендованных брендах больше говорили в сети.
Признанные лидеры рынка всё ещё забирают и цитату, и рекомендацию, так что механика теперь работает исключительно как производная от того авторитета, который у вас уже есть.
Monday (траст домена за 90, 75K ссылающихся доменов) стали редким исключением, когда самореклама всё же попала в рекомендацию; бренды с низким трастом, такие как Kylas, проседали по всем метрикам с нулевыми упоминаниями в AI Overview или ChatGPT.Под
GEO-риском скрывается накопительная SEO-проблема.Примерно 20 января 2026 года Google, судя по всему, выкатил алгоритмическую корректировку, которая срезала органическую видимость сайтов, плотно сидящих на этой тактике.
Сначала удар пришелся по директориям с подборками, затем санкции расползлись на весь домен, а во время майского кор-апдейта 2026 года падение ускорилось (проанализировано 40+ пострадавших сайтов).
Попытка прощупать границу дозволенного на одной папке подставляла под удар весь домен.
Метрика, про которую пора забыть: погоня за цитированием в ИИ как сигнал успеха.
Исследование
Pew за 2025 год доказывает: юзеры кликают на ссылку внутри ИИ-сводки лишь в 1% сессий — цитата почти не приносить трафик, а для автора подборки она ещё и активно рекомендует конкурентов.В разрыве между цитатой и рекомендацией именно рекомендация качает бизнес, и покупается она за счет внешнего авторитета, а не похвалы самому себе.
https://lilyraynyc.substack.com/p/why-calling-yourself-the-best-could
#AIOverviews #GEO #CoreUpdates
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤2👍1
Аудит логов GSC раскрывает связь с апдейтами — 13 из 26 падений консоли ударили прямо во время выкатки алгоритмов
Каждый кор-апдейт — один и тот же ритуал: клики замирают, показы зависают с задержкой в три дня, а отчет по ссылкам заявляет, что 90% бэклинков испарились за ночь.
Официальная линия Google тоже не меняется — Джон Мюллер назвал задержку отчета об эффективности на 60+ часов "абсолютно не признаком апдейта выдачи".
Однако аудит 26 задокументированных падений
Отрицания всегда конкретны.
Когда отчет по ссылкам отвалился во время
Текущая 14-дневная заморозка индексации страниц, идущая параллельно с
Реальная польза здесь — уметь отличать инфраструктурный сбой от реального фильтра.
Заморозка останавливает время: клики и показы фиксируются на одной дате в прошлом, тогда как подлинный алгоритмический удар продолжает генерировать свежие дата-поинты по нисходящей кривой.
Валидируй это внешними данными: во время каждого зафиксированного блэкаута
Это локализует сбой на уровне внутренних обработчиков логов Google, а не на стороне сайта.
С конца 2025 года интерфейс сам отдает маркер — баннер "Due to internal issues, this report has not been updated" сигнализирует об инфраструктурном затыке, а не о падении проекта.
Предложенный механизм остается гипотезой: Google отрицает связь, а аудит подтверждает корреляцию, а не каузацию.
Аргумент следующий: крупный апдейт заставляет Google перебрасывать вычислительные мощности на
Это оставляет без ресурсов асинхронный пайплайн
Получается две разные кодовые базы для ранжирования и отчетности, но один конечный пул процессоров.
https://vijaychauhanseo.substack.com/p/search-console-data-always-breaks
#GSC #CoreUpdates #Audits
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Каждый кор-апдейт — один и тот же ритуал: клики замирают, показы зависают с задержкой в три дня, а отчет по ссылкам заявляет, что 90% бэклинков испарились за ночь.
Официальная линия Google тоже не меняется — Джон Мюллер назвал задержку отчета об эффективности на 60+ часов "абсолютно не признаком апдейта выдачи".
Однако аудит 26 задокументированных падений
Google Search Console с середины 2023 по июнь 2026 года в сравнении с календарем апдейтов доказывает: 13 из них — ровно половина — легли точно на периоды активной выкатки алгоритмов.Отрицания всегда конкретны.
Когда отчет по ссылкам отвалился во время
May 2026 Core Update, Google зафиксировал это как баг базы данных и отдавал недельные данные до фикса.Текущая 14-дневная заморозка индексации страниц, идущая параллельно с
June 2026 Spam Update, числится как внутренняя задержка без связи с выкаткой.Реальная польза здесь — уметь отличать инфраструктурный сбой от реального фильтра.
Заморозка останавливает время: клики и показы фиксируются на одной дате в прошлом, тогда как подлинный алгоритмический удар продолжает генерировать свежие дата-поинты по нисходящей кривой.
Валидируй это внешними данными: во время каждого зафиксированного блэкаута
GSC сессии в ГА4, логи сервера и независимые трекеры позиций продолжали идти.Это локализует сбой на уровне внутренних обработчиков логов Google, а не на стороне сайта.
С конца 2025 года интерфейс сам отдает маркер — баннер "Due to internal issues, this report has not been updated" сигнализирует об инфраструктурном затыке, а не о падении проекта.
Предложенный механизм остается гипотезой: Google отрицает связь, а аудит подтверждает корреляцию, а не каузацию.
Аргумент следующий: крупный апдейт заставляет Google перебрасывать вычислительные мощности на
Serving Layer для перерасчета живых факторов ранжирования.Это оставляет без ресурсов асинхронный пайплайн
Log Processing Pipeline, который кормит консоль.Получается две разные кодовые базы для ранжирования и отчетности, но один конечный пул процессоров.
https://vijaychauhanseo.substack.com/p/search-console-data-always-breaks
#GSC #CoreUpdates #Audits
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤1
Собственные /g/ ноды вытаскивают трафик в core-апдейте — сила бренда не предсказывает рост
В контролируемом сравнении по смежным нишам 34% сайтов, завязанных на персональную сущность, показали рост (n=95), тогда как из 29 крупных брендов в тех же нишах не вырос никто, и только 3 бренда хоть как-то сдвинулись вверх.
Затем автор собрал 159 верифицированных авторских сайтов, оставил 128 с читаемой историей трафика и зафиксировал: 46% из них выросли в июньском
Мое внимание привлек один сайт, ранжирующийся по ВЧ-запросу в
Инструмент скоринга — это как раз то, что можно перенести на другие проекты.
Известность не предсказывала ничего.
Люди, имеющие только собственную
Энциклопедические ноды по нишевым авторам также привязываются не к тем людям — 18 из 40 оказались коллизией имен, а один сайт по деревообработке совпал с сыном Арнольда Шварценеггера.
Разброс по 54 победителям узкий: медианный возраст домена около 16 лет, 45 из 54 — в хобби-нишах, а стартовый диапазон трафика от 10К до 100К рос в 63% случаев, что стало лучшим результатом.
Сайты до 1К подросли на 11%, причем часть этой группы дала всплеск во время апдейта, только чтобы слить прирост в течение пары месяцев.
Пять
Все цифры трафика — это оценки органики по
https://usewhistle.co/research/personal-entity-correlation
#EntitySEO #CoreUpdates #KnowledgeGraph
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
В контролируемом сравнении по смежным нишам 34% сайтов, завязанных на персональную сущность, показали рост (n=95), тогда как из 29 крупных брендов в тех же нишах не вырос никто, и только 3 бренда хоть как-то сдвинулись вверх.
Затем автор собрал 159 верифицированных авторских сайтов, оставил 128 с читаемой историей трафика и зафиксировал: 46% из них выросли в июньском
core-апдейте 2025 года при типичной базовой ставке около 18%.Мое внимание привлек один сайт, ранжирующийся по ВЧ-запросу в
email-маркетинге, за которым не стояло никакого бренда: emailvendorselection.com, управляемый одним человеком, Джорди ван Рейном, с ростом с 21 399 до 458 618 визитов в месяц.Инструмент скоринга — это как раз то, что можно перенести на другие проекты.
Wikidata провалилась как прокси для персональной сущности: из 119 проверенных людей у 48% вообще не было сущности, 24% выдали коллизию полных тезок, 23% оказались неверифицированными однофамильцами, и только 3 вернулись как подтвержденное совпадение со своим сайтом.Wikipedia измеряла известность.Google Knowledge Graph API измеряет нечто иное — у 137 из 149 человек была /g/ нода, тип, который Google собирает сам из футпринта человека: сайта, профилей sameAs и упоминаний в сети, без энциклопедической статьи за спиной.Известность не предсказывала ничего.
Люди, имеющие только собственную
/g/ ноду, росли в 51% случаев (36 из 71); те, у кого была и /g/, и старая /m/ нода уровня Freebase, выросли на 38% — это самый низкий показатель среди всех групп.Энциклопедические ноды по нишевым авторам также привязываются не к тем людям — 18 из 40 оказались коллизией имен, а один сайт по деревообработке совпал с сыном Арнольда Шварценеггера.
Разброс по 54 победителям узкий: медианный возраст домена около 16 лет, 45 из 54 — в хобби-нишах, а стартовый диапазон трафика от 10К до 100К рос в 63% случаев, что стало лучшим результатом.
Сайты до 1К подросли на 11%, причем часть этой группы дала всплеск во время апдейта, только чтобы слить прирост в течение пары месяцев.
Пять
YMYL-сайтов по финансам и здоровью вообще не выросли.Все цифры трафика — это оценки органики по
Ahrefs (база — май 2025, после апдейта — апрель 2026, перепроверка — июнь 2026), а вывод о том, что персональная сущность теперь несет вес, который раньше был у бренда, подается как рабочая теория, а не доказанный механизм.https://usewhistle.co/research/personal-entity-correlation
#EntitySEO #CoreUpdates #KnowledgeGraph
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤1
Фейковые факторы ранжирования вскрывают порог шума, который игнорирует большинство анализов апдейтов Google
Запусти анализ апдейта без плацебо — и он найдет сигналы в спам-апдейте августа 2026 года.
Он с таким же успехом найдет их на неделе, когда Google вообще ничего не делал, и в результатах не будет ничего, что отличало бы эти два сценария.
Контрольная группа — это набор намеренно фейковых атрибутов, прогнанных через скоринг: они звучат правдоподобно, структурно идентичны реальным, но за ними нет никакого механизма.
Частота, с которой система "обнаруживает" их движение — это и есть порог шума.
Каждая реальная находка дисконтируется на эту величину.
Второй контрольный механизм — парное сравнение страниц.
Внутри каждого кластера запросов система сталкивает победителя с проигравшим, конкурента с конкурентом и анализирует полезные аномалии: две страницы на одном домене (с AI-проверкой на каннибализацию), где одна просела или выросла, а другая — нет.
Все доменные факторы взаимоуничтожаются, поэтому то, что остается в дельте — это чисто страничные сигналы по определению.
У такого подхода есть цена.
Траст сайта внутри пар на одном домене остается почти константой еще до поступления данных, поэтому нулевое влияние авторитета может оказаться следствием самого дизайна пар, а не реальным открытием.
Прежде чем делать выводы из нулей, доверительный интервал нужно дробить по типам пар.
Скоринг сворачивает отдельные атрибуты в семейства, потому что шум на уровне одного сигнала бьет по статистике слишком жестко.
Колебание одного атрибута — это шум; когда целое семейство кренится в одном направлении на тысячах парных сравнений — это уже апдейт.
База запросов подчиняется той же дисциплине: сгруппированные кластеры с языковыми вариантами.
В итоге тип интента и рынок фиксируются как управляемые переменные, а не как случайности.
Сравни транзакционный
Два дня чистого времени в терминале на сборку.
Первый прогон: 15 тысяч запросов, 7 языков с упором на английский, около $5,000 на токены и
Всё это скорится по слитому корпусу атрибутов
Категории
Отдельные глубокие аудиты связывают львиную долю этих просадок с переспамленными
Семейства атрибутов, которые отделили победителей от проигравших:
— Насколько точно страница попадает в запрос
— Общая релевантность
— Ссылки, ведущие непосредственно на страницу
— Тип страницы
— Текст анкоров
Семейства, которые не пробили порог шума:
— Траст сайта
— Структура и форматирование страницы
— Свежесть контента
— Динамика ссылочного
— Язык
Это не финальный вердикт по факторам ранжирования.
Конкретно в этом датасете и во время этого апдейта данные семейства не смогли отделить растущие страницы от падающих настолько сильно, чтобы пробить скорректированный на плацебо порог.
Датасет еще сырой: базу запросов нужно увеличить в 30 раз, прежде чем несколько семейств выйдут из доверительного интервала С-класса, а некоторые колебания почти наверняка всё еще сидят в зоне плацебо.
Методология опубликована полностью.
Главный барьер для входа — это слитая карта атрибутов, историческая глубина
Инсайты комьюнити
— Гипотеза: на фоне этого же апдейта выбор цитаций для
#CoreUpdates #Experiments #Analytics
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Запусти анализ апдейта без плацебо — и он найдет сигналы в спам-апдейте августа 2026 года.
Он с таким же успехом найдет их на неделе, когда Google вообще ничего не делал, и в результатах не будет ничего, что отличало бы эти два сценария.
Контрольная группа — это набор намеренно фейковых атрибутов, прогнанных через скоринг: они звучат правдоподобно, структурно идентичны реальным, но за ними нет никакого механизма.
Частота, с которой система "обнаруживает" их движение — это и есть порог шума.
Каждая реальная находка дисконтируется на эту величину.
Второй контрольный механизм — парное сравнение страниц.
Внутри каждого кластера запросов система сталкивает победителя с проигравшим, конкурента с конкурентом и анализирует полезные аномалии: две страницы на одном домене (с AI-проверкой на каннибализацию), где одна просела или выросла, а другая — нет.
Все доменные факторы взаимоуничтожаются, поэтому то, что остается в дельте — это чисто страничные сигналы по определению.
У такого подхода есть цена.
Траст сайта внутри пар на одном домене остается почти константой еще до поступления данных, поэтому нулевое влияние авторитета может оказаться следствием самого дизайна пар, а не реальным открытием.
Прежде чем делать выводы из нулей, доверительный интервал нужно дробить по типам пар.
Скоринг сворачивает отдельные атрибуты в семейства, потому что шум на уровне одного сигнала бьет по статистике слишком жестко.
Колебание одного атрибута — это шум; когда целое семейство кренится в одном направлении на тысячах парных сравнений — это уже апдейт.
База запросов подчиняется той же дисциплине: сгруппированные кластеры с языковыми вариантами.
В итоге тип интента и рынок фиксируются как управляемые переменные, а не как случайности.
Сравни транзакционный
SERP казино с информационным SERP по рецептам — и ты замеришь разницу в интенте, а не алгоритм.Два дня чистого времени в терминале на сборку.
Первый прогон: 15 тысяч запросов, 7 языков с упором на английский, около $5,000 на токены и
API-запросы.Всё это скорится по слитому корпусу атрибутов
Content Warehouse, разбитому на сотни конкретных сигналов.Категории
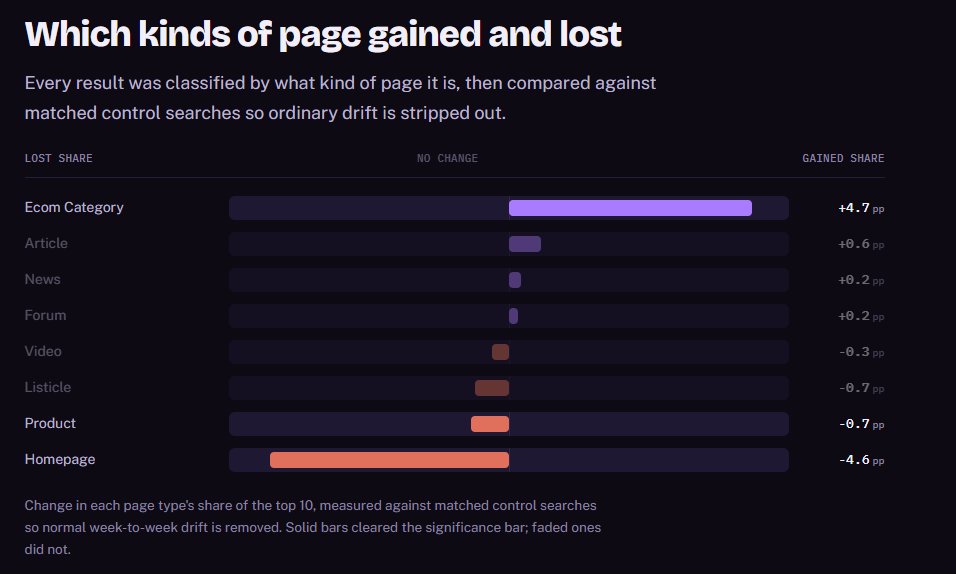
e-commerce подросли, тогда как главные страницы и листиклы просели, а объем бэклинков и сырой DR потеряли в весе — такая переоценка ссылочного происходит почти каждый апдейт, хотя на этот раз падение оказалось аномальным.Отдельные глубокие аудиты связывают львиную долю этих просадок с переспамленными
exact-match анкорами, ведущими прямо на мани-страницы.Семейства атрибутов, которые отделили победителей от проигравших:
— Насколько точно страница попадает в запрос
— Общая релевантность
— Ссылки, ведущие непосредственно на страницу
— Тип страницы
— Текст анкоров
Семейства, которые не пробили порог шума:
— Траст сайта
— Структура и форматирование страницы
— Свежесть контента
— Динамика ссылочного
— Язык
Это не финальный вердикт по факторам ранжирования.
Конкретно в этом датасете и во время этого апдейта данные семейства не смогли отделить растущие страницы от падающих настолько сильно, чтобы пробить скорректированный на плацебо порог.
Датасет еще сырой: базу запросов нужно увеличить в 30 раз, прежде чем несколько семейств выйдут из доверительного интервала С-класса, а некоторые колебания почти наверняка всё еще сидят в зоне плацебо.
Методология опубликована полностью.
Главный барьер для входа — это слитая карта атрибутов, историческая глубина
SERP и готовность сжигать минимум пять тысяч баксов каждый апдейт просто ради того, чтобы выяснить, где ты ошибся.Инсайты комьюнити
— Гипотеза: на фоне этого же апдейта выбор цитаций для
AI Overviews сместился в сторону сайтов с высоким DR за счет более тесной привязки к Gemini — по сути, получилась pay-to-play модель цитирования.#CoreUpdates #Experiments #Analytics
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
👎2
Логи серверов на четырех доменах вскрывают синхронизированную выкатку кор-апдейта, которую Google не анонсировал
Был ли этот гэп задержкой индексации, багом выдачи или чем-то локальным — оставалось загадкой.
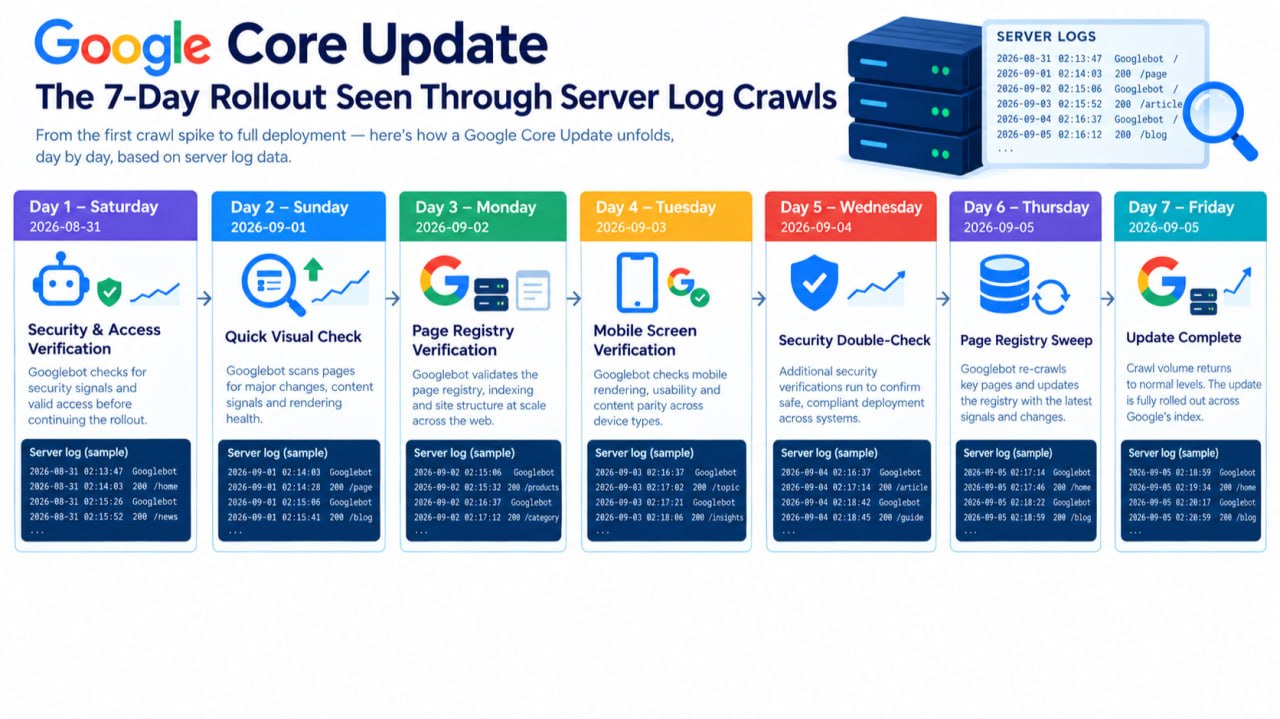
Сырые данные логов серверов с четырех доменов из одного портфеля задокументировали пошаговую хронологию, которую дашборд не показал.
На фоне этой заморозки краулинг с рендером систематически пробивал каждый домен в портфеле, и таймлайн логов по всем четырем сайтам совпадает на 100% — ежедневные этапы синхронны, несмотря на абсолютно разные профили и архитектуру площадок.
Эта идентичность доказывает автоматизированную, централизованную выкатку, а не четыре независимых алгоритмических всплеска; она опровергает привычную установку, что кор-апдейт — это непредсказуемое событие, заметное только постфактум.
Что реально отличалось между четырьмя сайтами, так это вычислительный налог: мощности сервера, затраченные на парсинг контента, радикально разнились в зависимости от архитектуры, хотя анализ не дает точных цифр этого разброса.
3 сентября стал пиком.
Предлагаемое объяснение этого рассинхрона — физическая задержка при миграции гугловских конвейеров данных на фоне лайв-выкатки кор-апдейта; логи фиксируют совпадение по времени, но не подтверждают саму механику.
К 4 сентября логи зафиксировали возобновление нормального краулинга и снятие заморозки.
Один артефакт выбивается из этого таймлайна.
30 августа
Синхронизированный таймлайн логов, снятый с разнородного портфеля, а не с одного сайта — вот что сделало теневую выкатку читаемой прямо в процессе её исполнения.
#CoreUpdates #LogFileAnalysis #Crawling
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Google Search Status Dashboard показывал "Нет инцидентов", пока паблишеры фиксировали проблему с индексацией, начавшуюся примерно 1 сентября 2026 года.Был ли этот гэп задержкой индексации, багом выдачи или чем-то локальным — оставалось загадкой.
Сырые данные логов серверов с четырех доменов из одного портфеля задокументировали пошаговую хронологию, которую дашборд не показал.
Google Web Rendering Service был заморожен с 25 августа 2026 года.На фоне этой заморозки краулинг с рендером систематически пробивал каждый домен в портфеле, и таймлайн логов по всем четырем сайтам совпадает на 100% — ежедневные этапы синхронны, несмотря на абсолютно разные профили и архитектуру площадок.
Эта идентичность доказывает автоматизированную, централизованную выкатку, а не четыре независимых алгоритмических всплеска; она опровергает привычную установку, что кор-апдейт — это непредсказуемое событие, заметное только постфактум.
Что реально отличалось между четырьмя сайтами, так это вычислительный налог: мощности сервера, затраченные на парсинг контента, радикально разнились в зависимости от архитектуры, хотя анализ не дает точных цифр этого разброса.
3 сентября стал пиком.
Page Registry Sweeps и Live Layout/Deep Code Audits достигли максимума по всему портфелю в тот же день, когда паблишеры рапортовали, что свежие статьи всплывают во вкладке новостей, исчезают, а затем возвращаются около 16:00 ET, тогда как веб-поиск всё это время отдавал их без сбоев.Предлагаемое объяснение этого рассинхрона — физическая задержка при миграции гугловских конвейеров данных на фоне лайв-выкатки кор-апдейта; логи фиксируют совпадение по времени, но не подтверждают саму механику.
К 4 сентября логи зафиксировали возобновление нормального краулинга и снятие заморозки.
Один артефакт выбивается из этого таймлайна.
30 августа
Googlebot Mobile и GoogleOther с разницей в несколько часов обновили сборку Chrome до Chrome/151.0.7922.173, и оба сидели на этом билде по состоянию на 7 сентября 2026 года, 16:00 CDT.Синхронизированный таймлайн логов, снятый с разнородного портфеля, а не с одного сайта — вот что сделало теневую выкатку читаемой прямо в процессе её исполнения.
#CoreUpdates #LogFileAnalysis #Crawling
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
🎄1
Слив Гугла вскрывает New Site Rank: это офлайн-потолок, который нельзя сдвинуть он-пейджем
В сливе
Кэш презентаций
А устаревшее поле
Индустриальные названия — результат ранней догадки, которую повторяли вплоть до статуса факта.
Эта расшифровка меняет прицел.
Он высчитывается в пайплайне
Обучение крутится в
Затем скоринги морозятся в офлайн-песочнице и раскатываются глобально во время
Между выкатками база зафиксирована — вот почему видимость меняется ступенчато, а не плавно дрейфует, и почему локальные правки он-пейджа не дают восстановления, пока не выкатят следующий батч.
Силу давления этого потолка определяют два демпфера.
А низкая уверенность глушит агрессивность, с которой
Скоринг также оценивается по
Система изолирует поддомены, директории и хабы юзерского контента, поэтому один мусорный кусок не тянет за собой базовый уровень авторитетных разделов.
Там, где чанку не хватает данных трафика или краулинга,
Ссылочный вес, питающий эту базу, может быть обнулен без ручника.
Модели
Никаких уведомлений при этом не прилетает.
В обратную сторону работает
Значение выше
Это резервный рычаг для восстановления крупных новостных брендов или ресурсов общественной безопасности, если автоматическая выкатка дает сбой.
Рычаги, которые двигают офлайн-оценку всего сайта — макроуровневые, а не постраничные.
Это кампании, генерирующие прямые брендовые навигационные запросы для усиления векторов предпочтений
Пропорции веса, сглаживания и точная кривая компонентов
https://www.hobo-web.co.uk/new-site-rank-nsr-googles-site-wide-quality-engine/
#GoogleLeak #AlgorithmPenalties #CoreUpdates
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
В сливе
Content Warehouse за 2024 год NSR — это ни Normalized, ни Neural Site Rank.Кэш презентаций
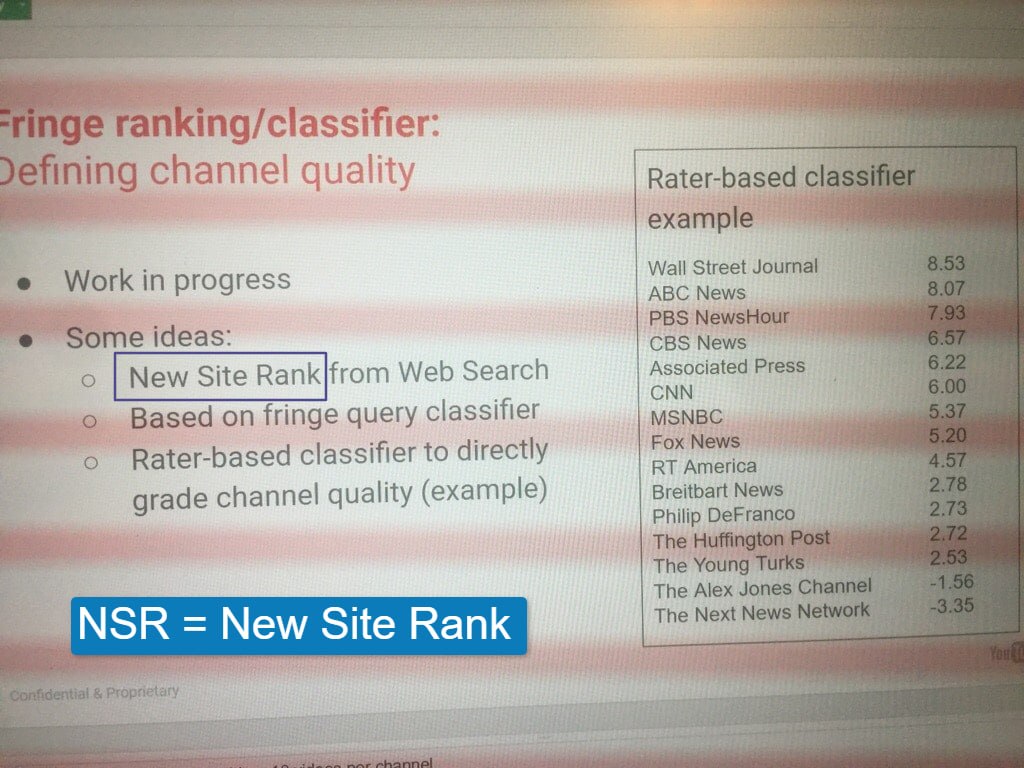
Project Veritas 2019 года, не связанный со сливом API, содержит внутренний слайд Google под названием "Fringe ranking/classifier: Defining channel quality", где упоминается "New Site Rank from Web Search".А устаревшее поле
hostNsr в схеме 2024 года несет собственное описание в коде: "This value encodes nsr, site_pr and new_nsr".Индустриальные названия — результат ранней догадки, которую повторяли вплоть до статуса факта.
Эта расшифровка меняет прицел.
NSR — не динамическая оценка на уровне страницы, а офлайн макро-классификатор, который задает базовый потолок траста домена.Он высчитывается в пайплайне
Goldmine и отдается на живые шарды Mustang как урезанный векторный контейнер (nsrDataProto).Обучение крутится в
RankLab на кликстримах, показах, трафике Chrome и фидбеке асессоров.Затем скоринги морозятся в офлайн-песочнице и раскатываются глобально во время
Broad Core Updates.Между выкатками база зафиксирована — вот почему видимость меняется ступенчато, а не плавно дрейфует, и почему локальные правки он-пейджа не дают восстановления, пока не выкатят следующий батч.
Силу давления этого потолка определяют два демпфера.
nsrConfidence и nsrVariance снижают уверенность алгоритма при скудных поведенческих сигналах.А низкая уверенность глушит агрессивность, с которой
NSR меняет базовую позицию страницы: на сайте с низким трафиком NSR слабее сдвигает базу в любую из сторон, что страхует от жестких ошибочных санкций.Скоринг также оценивается по
sitechunks, а не по целым доменам.Система изолирует поддомены, директории и хабы юзерского контента, поэтому один мусорный кусок не тянет за собой базовый уровень авторитетных разделов.
Там, где чанку не хватает данных трафика или краулинга,
nsrdataFromFallbackPatternKey подставляет среднее структурное значение родственных чанков хоста.Ссылочный вес, питающий эту базу, может быть обнулен без ручника.
Модели
SpamBrain нейтрализуют ссылочное: они обнуляют PageRank, идущий через искусственные ссылочные графы и PBN, тогда как spambrainLavcScore замеряет долю мусорных линков, приклеенных к домену.Никаких уведомлений при этом не прилетает.
В обратную сторону работает
nsrOverrideBid (задокументирован по адресу go/nsr-override-bid) — это ручной переключатель.Значение выше
0.001 безусловно перебивает рассчитанную базу NSR домена внутри движка Q (Quality Score).Это резервный рычаг для восстановления крупных новостных брендов или ресурсов общественной безопасности, если автоматическая выкатка дает сбой.
Рычаги, которые двигают офлайн-оценку всего сайта — макроуровневые, а не постраничные.
Это кампании, генерирующие прямые брендовые навигационные запросы для усиления векторов предпочтений
NavBoost; прунинг нетематического и малоценного контента для снижения siteRadius при проверках согласованности Site2Vec; и прямой трафик, переходы из рассылок и закладок для разгона chromeInTotal, а вместе с ним и nsrConfidence.Пропорции веса, сглаживания и точная кривая компонентов
NSR остаются нераскрытыми, а сама модель пайплайна — это логический вывод, собранный по кускам из слитого кода, а не из документации Google.https://www.hobo-web.co.uk/new-site-rank-nsr-googles-site-wide-quality-engine/
#GoogleLeak #AlgorithmPenalties #CoreUpdates
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
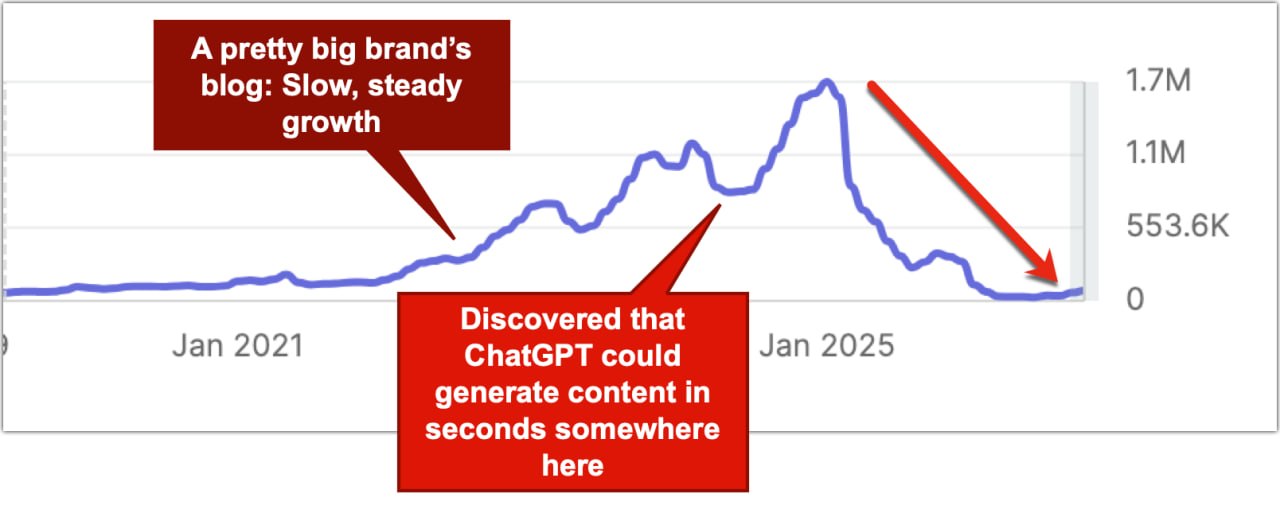
Агрессивная индексация дает взлет на 1 100%, но дистанция в 12 месяцев обнуляет видимость
Июньский кор-апдейт 2021 года не тронул старый
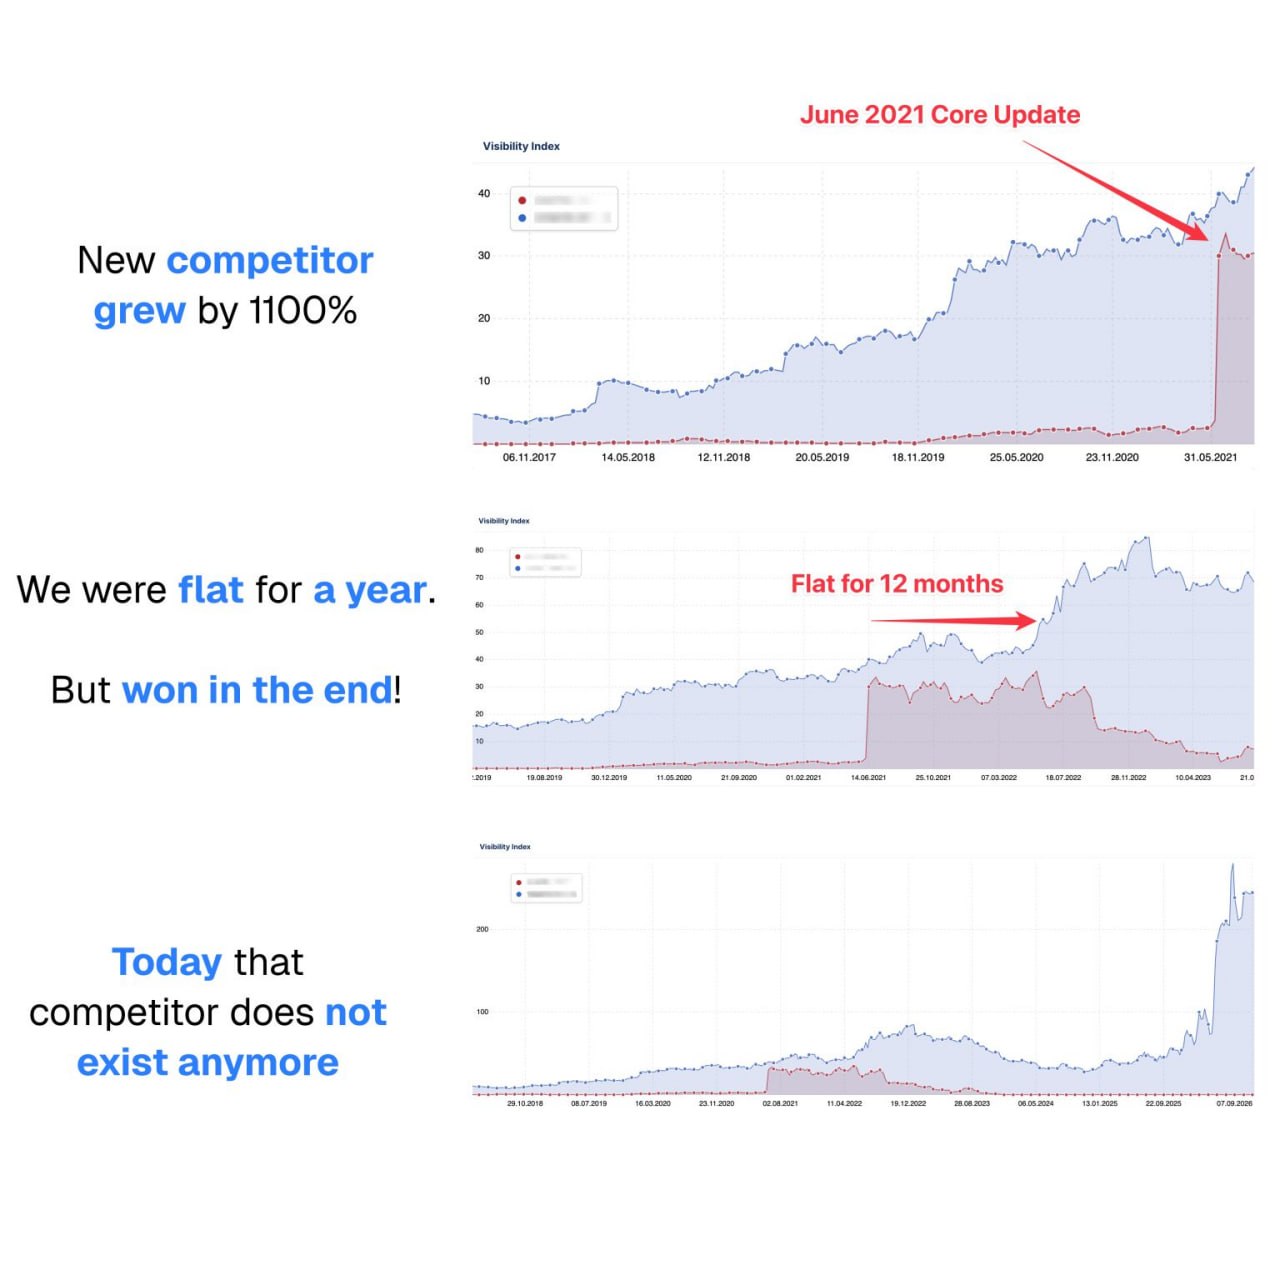
Зато конкуренту он отсыпал 1 100% роста.
Тот старый сайт управлял миллионами урлов и намеренно держал большинство из них вне индекса Гугла.
Схема опиралась на ПФ, качество контента и жесткую чистку мусорных страниц — и это работало: органика выросла на 15% за шесть месяцев.
У конкурента была команда меньше, бюджет скромнее, инвентаря меньше, бренд слабее — зато куда более агрессивная стратегия индексации.
К тому же он был в 15 раз меньше, и его никогда не считали угрозой.
После апдейта отрыв сократился до 20%.
Стейкхолдеры запаниковали.
Очевидный вывод: сдержанная индексация оказалась ошибкой.
Следующие 12 месяцев оба сайта стояли на месте.
Никаких оправданий не появилось: на каждой встрече стратегию команды ставили под сомнение, и на каждой встрече звучал один и тот же ответ.
Кривые разошлись только спустя эти 12 месяцев: органика старого сайта выросла на 75%, тогда как конкурент пошел на спад.
Сегодня этот сайт в восемь раз больше, чем в момент паники, а видимость конкурента упала почти до нуля и застряла на дне.
Краткосрочный перформанс не подтверждает долгосрочную стратегию, а обратное обходится дороже, чем кажется: надежный подход может выглядеть ошибочным целый год, пока хрупкая схема печатает результат.
Задача лидов — научить стейкхолдеров отделять данные от шума и рисков, потому что графики показывают только то, кто впереди прямо сейчас.
Тот же паттерн формируется в
Первыми должны сломаться массовый ИИ-контент и селф-промо листинги, причем масштабированный ИИ-контент — уже самый частый пример.
Перед тем как копировать тактику, проведи простой тест: если это работает сегодня, что должно оставаться неизменным, чтобы это работало и завтра?
Инсайты комьюнити
— Для долговечности нужен план фальсификации до начала паники: держи контрольную когорту страниц, логируй, какие ключи или упоминания отваливаются после каждого кор-апдейта или обновления модели, и заранее определяй правило отключения. Без этого "долгосрочный траст" — просто сказка, которой команды успокаивают себя, пока теряют воронку.
— Последовательность не значит причинность: рост конкурента на агрессивной индексации и последующий крах устанавливают хронологию, а не то, что именно индексация убила сайт. В случае с
— Локальный поиск крутит тот же цикл, но быстрее: 500 дорвеев или спамные точные вхождения в названиях ранжируются пару месяцев, а затем сносятся в ноль на следующем кор-апдейте, тогда как правильная структура страницы под реальный интент почти никогда не попадает под раздачу.
#Strategy #Indexing #CoreUpdates
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Июньский кор-апдейт 2021 года не тронул старый
SEO-зависимый сайт.Зато конкуренту он отсыпал 1 100% роста.
Тот старый сайт управлял миллионами урлов и намеренно держал большинство из них вне индекса Гугла.
Схема опиралась на ПФ, качество контента и жесткую чистку мусорных страниц — и это работало: органика выросла на 15% за шесть месяцев.
У конкурента была команда меньше, бюджет скромнее, инвентаря меньше, бренд слабее — зато куда более агрессивная стратегия индексации.
К тому же он был в 15 раз меньше, и его никогда не считали угрозой.
После апдейта отрыв сократился до 20%.
Стейкхолдеры запаниковали.
Очевидный вывод: сдержанная индексация оказалась ошибкой.
Следующие 12 месяцев оба сайта стояли на месте.
Никаких оправданий не появилось: на каждой встрече стратегию команды ставили под сомнение, и на каждой встрече звучал один и тот же ответ.
Кривые разошлись только спустя эти 12 месяцев: органика старого сайта выросла на 75%, тогда как конкурент пошел на спад.
Сегодня этот сайт в восемь раз больше, чем в момент паники, а видимость конкурента упала почти до нуля и застряла на дне.
Краткосрочный перформанс не подтверждает долгосрочную стратегию, а обратное обходится дороже, чем кажется: надежный подход может выглядеть ошибочным целый год, пока хрупкая схема печатает результат.
Задача лидов — научить стейкхолдеров отделять данные от шума и рисков, потому что графики показывают только то, кто впереди прямо сейчас.
Тот же паттерн формируется в
GEO, где высокорисковые тактики продаются на ранних результатах.Первыми должны сломаться массовый ИИ-контент и селф-промо листинги, причем масштабированный ИИ-контент — уже самый частый пример.
Перед тем как копировать тактику, проведи простой тест: если это работает сегодня, что должно оставаться неизменным, чтобы это работало и завтра?
Инсайты комьюнити
— Для долговечности нужен план фальсификации до начала паники: держи контрольную когорту страниц, логируй, какие ключи или упоминания отваливаются после каждого кор-апдейта или обновления модели, и заранее определяй правило отключения. Без этого "долгосрочный траст" — просто сказка, которой команды успокаивают себя, пока теряют воронку.
— Последовательность не значит причинность: рост конкурента на агрессивной индексации и последующий крах устанавливают хронологию, а не то, что именно индексация убила сайт. В случае с
GEO тактика, генерирующая больше упоминаний или цитаций, требует ответа на четыре вопроса до внедрения: что именно дало результат, принесло ли это целевой трафик или коммерческую выгоду, насколько это завязано на алгоритм одной платформы и что будет, когда этот алгоритм изменится.— Локальный поиск крутит тот же цикл, но быстрее: 500 дорвеев или спамные точные вхождения в названиях ранжируются пару месяцев, а затем сносятся в ноль на следующем кор-апдейте, тогда как правильная структура страницы под реальный интент почти никогда не попадает под раздачу.
#Strategy #Indexing #CoreUpdates
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
😁1
Слитый атрибут contentEffort опровергает политику Google — алгоритм отслеживает ручной труд над контентом
Официальная позиция Google: неважно, как делается контент, главное — чтобы он был полезным.
Слитый алгоритм доказывает обратное.
В утечке алгоритма Google за 2025 год нашли атрибут
Значит, игнорирование или подделка усилий над контентом может алгоритмически срезать видимость.
Слово "
Определение асессоров: степень, в которой человек активно поработал над созданием удовлетворяющего контента.
Пример с самой низкой оценкой — страница, которая переупаковывает чужую работу без источников, без экспертного мнения и без признаков оригинальных усилий — типичный формат ИИ-статьи.
Публичные доки
Атрибуция не заменяет необходимость оригинальных усилий.
Чем
— это не объем текста
— это не глубина, так как ИИ отлично ресерчит
— это не время, потраченное на допиливание промпта, чтобы он звучал как ты
Главный тест заключается не в том, читается ли текст как ИИ, и даже не в том, полезен ли он — а в том, есть ли в нем что-то новое, что стоит показать в выдаче.
Под эту трактовку выстраиваются три сигнала: ежегодные санкции спам-апдейтов, которые бьют по сайтам с ИИ-контентом, новый патент на детект "
https://www.annsmarty.com/p/content-effort-one-of-googles-signals
#GoogleLeak #CoreUpdates #HCU
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Официальная позиция Google: неважно, как делается контент, главное — чтобы он был полезным.
Слитый алгоритм доказывает обратное.
В утечке алгоритма Google за 2025 год нашли атрибут
contentEffort; является ли он прямым фактором ранжирования и насколько сильно двигает видимость — неизвестно, но считается, что он лежал в основе HCU и позже был вшит в кор-апдейты.Значит, игнорирование или подделка усилий над контентом может алгоритмически срезать видимость.
Слово "
Effort" встречается 120 раз в Quality Rater Guidelines.Определение асессоров: степень, в которой человек активно поработал над созданием удовлетворяющего контента.
Пример с самой низкой оценкой — страница, которая переупаковывает чужую работу без источников, без экспертного мнения и без признаков оригинальных усилий — типичный формат ИИ-статьи.
Публичные доки
Search Central теперь несут параллельное определение, покрывающее ручной труд над контентом или системами, которые его генерируют: написание оригинальной аналитики, ручной перевод стихотворения или сборка кастомной интерактивной карты — это высокий уровень усилий; генерация страниц из фидов или использование генеративного ИИ для выдачи больших объемов текста без ручной модерации или курации — это мало или вообще ничего.Атрибуция не заменяет необходимость оригинальных усилий.
Чем
effort не является:— это не объем текста
— это не глубина, так как ИИ отлично ресерчит
— это не время, потраченное на допиливание промпта, чтобы он звучал как ты
Effort — это человеческое время, потраченное на то, чтобы сделать материал по-настоящему оригинальным, потому что веб уже перенасыщен переупакованным контентом.Главный тест заключается не в том, читается ли текст как ИИ, и даже не в том, полезен ли он — а в том, есть ли в нем что-то новое, что стоит показать в выдаче.
Под эту трактовку выстраиваются три сигнала: ежегодные санкции спам-апдейтов, которые бьют по сайтам с ИИ-контентом, новый патент на детект "
AI slop" и обновленная документация с требованием маркировать ИИ-контент — и всё это выкатили прямо перед самым длинным спам-апдейтом в истории.https://www.annsmarty.com/p/content-effort-one-of-googles-signals
#GoogleLeak #CoreUpdates #HCU
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤3
Внутренние тайминги Google показывают: индексация занимает 1.5 часа, а мусорные страницы зависают навсегда
Быстрая техничка не ускорит страницы, которые Гугл не считает ценными.
Внутренняя аналитика таймингов Google, впервые представленная на
В колонке тормозов регулярно всплывает "никогда" — и обычно это жестко завязано на качество.
Тайминги краулинга, от типичных к самым долгим:
— Обнаружение нового
— Обновление известного
— Обработка
— Обновление
— Апдейт лимитов краулинга (crawl capacity): от 4 часов до 1-2 недель → 1-3 недели при восстановлении
Лимиты краулинга могут упасть за секунды, когда Google дает заднюю — например, если сервер не справляется.
Тайминги индексации:
— Индексация от и до: ~1.5 часа → месяцы или "никогда" (качество)
— Рендер: секунды на сам рендер, часы в очереди → от дней до недель
— Мета-аннотации: 45-90 минут → 1-4 дня
— Ссылочные аннотации: от минут до 1-3 недель → месяцы
— Смена каноникала: 1-3 недели → месяцы (противоречивые сигналы)
— Переезд сайта: 1-3 месяца (мелкий переезд может улечься за пару недель) → от 6 месяцев до 1 года+
— Обновление
Тайминги выдачи:
— Обновление тайтлов и сниппетов: 1-2 дня → от нескольких недель до месяцев
— Снятие ручника: 1-2 недели → 4-6 недель, или гораздо дольше для брошенных сайтов
— Апдейт
— Восстановление после кор-апдейта: 3-6 месяцев → от 6 месяцев до 1 года (следующий кор-апдейт)
Многие из этих процессов связаны, поэтому задержки стакаются: страница не проиндексируется, пока бот ее не обойдет.
Кор-апдейты раскатываются 2-4 недели.
Спам-апдейты выкатываются за 1-2 дня.
Кор-апдейты не бьют по сайтам целиком: они таргетируют контент на уровне страниц, а не домена.
Вот почему одни
Google отфильтровывает 40 миллиардов спам-страниц в день, при этом масштабная генерация (scaled content) сейчас превращается в большую проблему, чем ссылочный спам.
https://weareroast.com/news/google-search-central-live-deep-dive-barcelona-day-3-recap/
#Indexing #Crawling #CoreUpdates
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Быстрая техничка не ускорит страницы, которые Гугл не считает ценными.
Внутренняя аналитика таймингов Google, впервые представленная на
Search Central Live Deep Dive в Барселоне, фиксирует для каждого процесса краулинга, индексации и выдачи типичное и максимальное время.В колонке тормозов регулярно всплывает "никогда" — и обычно это жестко завязано на качество.
Тайминги краулинга, от типичных к самым долгим:
— Обнаружение нового
URL: ~20 часов → от недель до "никогда"— Обновление известного
URL: ~30 дней → от недель до "никогда"— Обработка
sitemap: ~24 часа → до 14 дней или "никогда" (качество)— Обновление
robots.txt: ~24 часа → 25 часов— Апдейт лимитов краулинга (crawl capacity): от 4 часов до 1-2 недель → 1-3 недели при восстановлении
Лимиты краулинга могут упасть за секунды, когда Google дает заднюю — например, если сервер не справляется.
Тайминги индексации:
— Индексация от и до: ~1.5 часа → месяцы или "никогда" (качество)
— Рендер: секунды на сам рендер, часы в очереди → от дней до недель
— Мета-аннотации: 45-90 минут → 1-4 дня
— Ссылочные аннотации: от минут до 1-3 недель → месяцы
— Смена каноникала: 1-3 недели → месяцы (противоречивые сигналы)
— Переезд сайта: 1-3 месяца (мелкий переезд может улечься за пару недель) → от 6 месяцев до 1 года+
— Обновление
Schema: от часов до 1-2 недель → недели или "никогда" (качество)Тайминги выдачи:
— Обновление тайтлов и сниппетов: 1-2 дня → от нескольких недель до месяцев
— Снятие ручника: 1-2 недели → 4-6 недель, или гораздо дольше для брошенных сайтов
— Апдейт
SpamBrain (spam update): 1-2 недели (непрерывно) → месяцы (пакетные обновления)— Восстановление после кор-апдейта: 3-6 месяцев → от 6 месяцев до 1 года (следующий кор-апдейт)
Многие из этих процессов связаны, поэтому задержки стакаются: страница не проиндексируется, пока бот ее не обойдет.
Кор-апдейты раскатываются 2-4 недели.
Спам-апдейты выкатываются за 1-2 дня.
Кор-апдейты не бьют по сайтам целиком: они таргетируют контент на уровне страниц, а не домена.
Вот почему одни
URL на сайте растут, тогда как другие падают.Google отфильтровывает 40 миллиардов спам-страниц в день, при этом масштабная генерация (scaled content) сейчас превращается в большую проблему, чем ссылочный спам.
https://weareroast.com/news/google-search-central-live-deep-dive-barcelona-day-3-recap/
#Indexing #Crawling #CoreUpdates
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO