
Постинг в соцсетях и на сайтах для паразитного SEO может влиять на сущности Google.
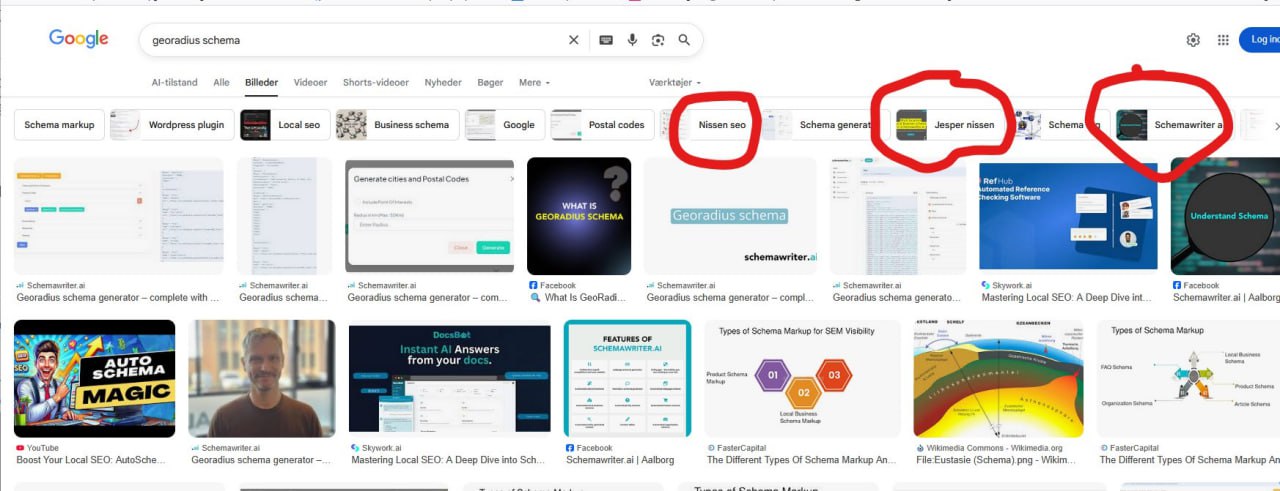
Сегодня я искал "
Когда я кликаю на вкладку "Картинки", то вижу, что повлиял на сущности Google.
Мое имя теперь ассоциируется с "
См. скрин...
Постинг в соцсетях и использование сайтов для паразитного SEO дает выхлоп, если делать это постоянно...
#EntitySEO #KnowledgeGraph #ParasiteSEO
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
Сегодня я искал "
georadius schema" и заметил кое-что, — пишет Йеспер Ниссен.Когда я кликаю на вкладку "Картинки", то вижу, что повлиял на сущности Google.
Мое имя теперь ассоциируется с "
georadius schema" в графе знаний Google.См. скрин...
Постинг в соцсетях и использование сайтов для паразитного SEO дает выхлоп, если делать это постоянно...
#EntitySEO #KnowledgeGraph #ParasiteSEO
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
❤1
Новая тулза
Проверяйте свое присутствие, ищите сущности сектора, рекурсивно изучайте темы, вытаскивайте данные
Критически важно для видимости в ИИ 🚀
https://i-l-i.com/wikidata-search/
#Tools #KnowledgeGraph #Entities
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
Wikidata для сеошников!Проверяйте свое присутствие, ищите сущности сектора, рекурсивно изучайте темы, вытаскивайте данные
Wiki/KG...Критически важно для видимости в ИИ 🚀
https://i-l-i.com/wikidata-search/
#Tools #KnowledgeGraph #Entities
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
🤣9😁3
Таргетинг на "ключевые" домены перекрывает авторитет Википедии
Анализ 25 миллиардов дата-поинтов изолирует специфический тир из примерно 62,000 "ключевых" доменов, которые обучают основной Граф Знаний Google, раскрывает Джейсон Барнард.
Пока индустрия одержима Википедией, эти 62,000 специфических источников имеют непропорционально большое влияние на понимание сущностей, потому что они предоставляют гранулярные, структурированные данные, которых нет на платформах общего профиля.
Математика диктует стратегию: Википедия сейчас представляет лишь 0.012% общей базы знаний Google.
По мере того как
Следовательно, получение упоминаний на гипер-нишевых или гео-специфичных сайтах ассоциаций (например, торговая ассоциация конкретного города) сигнализирует Графу Знаний о значительно более высоком авторитете, чем запись в Википедии общего профиля.
Касательно оптимизации сущностей: инвертируйте традиционную воронку, сначала бетонируя "дно воронки".
Четко определяйте Кто я, Что я делаю и Кому служу на странице "О нас", затем расширяйтесь до Категорий (Consideration), гарантируя, что сущность находится в "Топе алгоритмического разума" (Top of Algorithmic Mind) перед тем, как гнаться за широким трафиком осведомленности.
#EntitySEO #KnowledgeGraph #LinkBuilding
@MikeBlazerX
☠️ Black Hat — в @MikeBlazerPRO
Анализ 25 миллиардов дата-поинтов изолирует специфический тир из примерно 62,000 "ключевых" доменов, которые обучают основной Граф Знаний Google, раскрывает Джейсон Барнард.
Пока индустрия одержима Википедией, эти 62,000 специфических источников имеют непропорционально большое влияние на понимание сущностей, потому что они предоставляют гранулярные, структурированные данные, которых нет на платформах общего профиля.
Математика диктует стратегию: Википедия сейчас представляет лишь 0.012% общей базы знаний Google.
По мере того как
LLM поглощают всё более специализированные данные, эта доля, по прогнозам, рухнет до 0.00001%.Следовательно, получение упоминаний на гипер-нишевых или гео-специфичных сайтах ассоциаций (например, торговая ассоциация конкретного города) сигнализирует Графу Знаний о значительно более высоком авторитете, чем запись в Википедии общего профиля.
Касательно оптимизации сущностей: инвертируйте традиционную воронку, сначала бетонируя "дно воронки".
Четко определяйте Кто я, Что я делаю и Кому служу на странице "О нас", затем расширяйтесь до Категорий (Consideration), гарантируя, что сущность находится в "Топе алгоритмического разума" (Top of Algorithmic Mind) перед тем, как гнаться за широким трафиком осведомленности.
#EntitySEO #KnowledgeGraph #LinkBuilding
@MikeBlazerX
☠️ Black Hat — в @MikeBlazerPRO
👍2
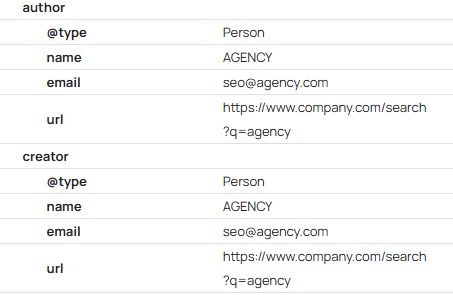
В последнее время я проводила аудит микроразметки на некоторых сайтах и заметила очень грязную тактику, которой брендам стоит остерегаться, пишет Бет Вудкок.
Некоторые агентства вшивают себя в
Вместо того чтобы автором выступал профильный эксперт от бренда, микроразметка говорит Google: "Это SEO-агентство — эксперт в данной теме".
Микроразметка кормит Граф Знаний, и, атрибутируя контент агентству, вы говорите Google, что у вашей компании на самом деле нет внутренней экспертизы, чтобы вещать о своей же индустрии.
Что еще хуже, недавно я видела эту разметку в посте блога с советами по питанию — жесткая
По сути, агентство использует прокачанный сайт, чтобы нарастить собственный
➡️ Агентства должны быть гострайтерами, но авторитетом должна быть ваша команда.
➡️ Каждый пост в блоге должен ссылаться на #person
➡️ Страницы авторов не должны быть просто списком постов. Они обязаны линковать на профили в
➡️ Агентства, пишущие технический контент (здоровье, финансы, право, любая YMYL-ниша), должны отдавать свою работу на проверку и подпись квалифицированному специалисту.
Пока Google удваивает ставки на
Не позволяйте агентству его угнать...
#KnowledgeGraph #SchemaOrg #EEAT
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Некоторые агентства вшивают себя в
schema контента, который они пишут для клиентов.Вместо того чтобы автором выступал профильный эксперт от бренда, микроразметка говорит Google: "Это SEO-агентство — эксперт в данной теме".
Микроразметка кормит Граф Знаний, и, атрибутируя контент агентству, вы говорите Google, что у вашей компании на самом деле нет внутренней экспертизы, чтобы вещать о своей же индустрии.
Что еще хуже, недавно я видела эту разметку в посте блога с советами по питанию — жесткая
YMYL-тематика, где должен быть корректно атрибутированный автор.По сути, агентство использует прокачанный сайт, чтобы нарастить собственный
footprint сущностей в Графе Знаний за счет клиента.➡️ Агентства должны быть гострайтерами, но авторитетом должна быть ваша команда.
➡️ Каждый пост в блоге должен ссылаться на #person
@id реального человека-эксперта внутри вашей компании или верифицированного консультанта.➡️ Страницы авторов не должны быть просто списком постов. Они обязаны линковать на профили в
LinkedIn, показывать сертификаты и доказывать, почему этот чел имеет право давать советы.➡️ Агентства, пишущие технический контент (здоровье, финансы, право, любая YMYL-ниша), должны отдавать свою работу на проверку и подпись квалифицированному специалисту.
Пока Google удваивает ставки на
E-E-A-T, ваш Граф Знаний — это ваш самый ценный актив.Не позволяйте агентству его угнать...
#KnowledgeGraph #SchemaOrg #EEAT
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
👍2🔥2
Кросс-доменная агрегация товарного графа перезаписывает локальные рейтинги магазинов
Классическая сеошка
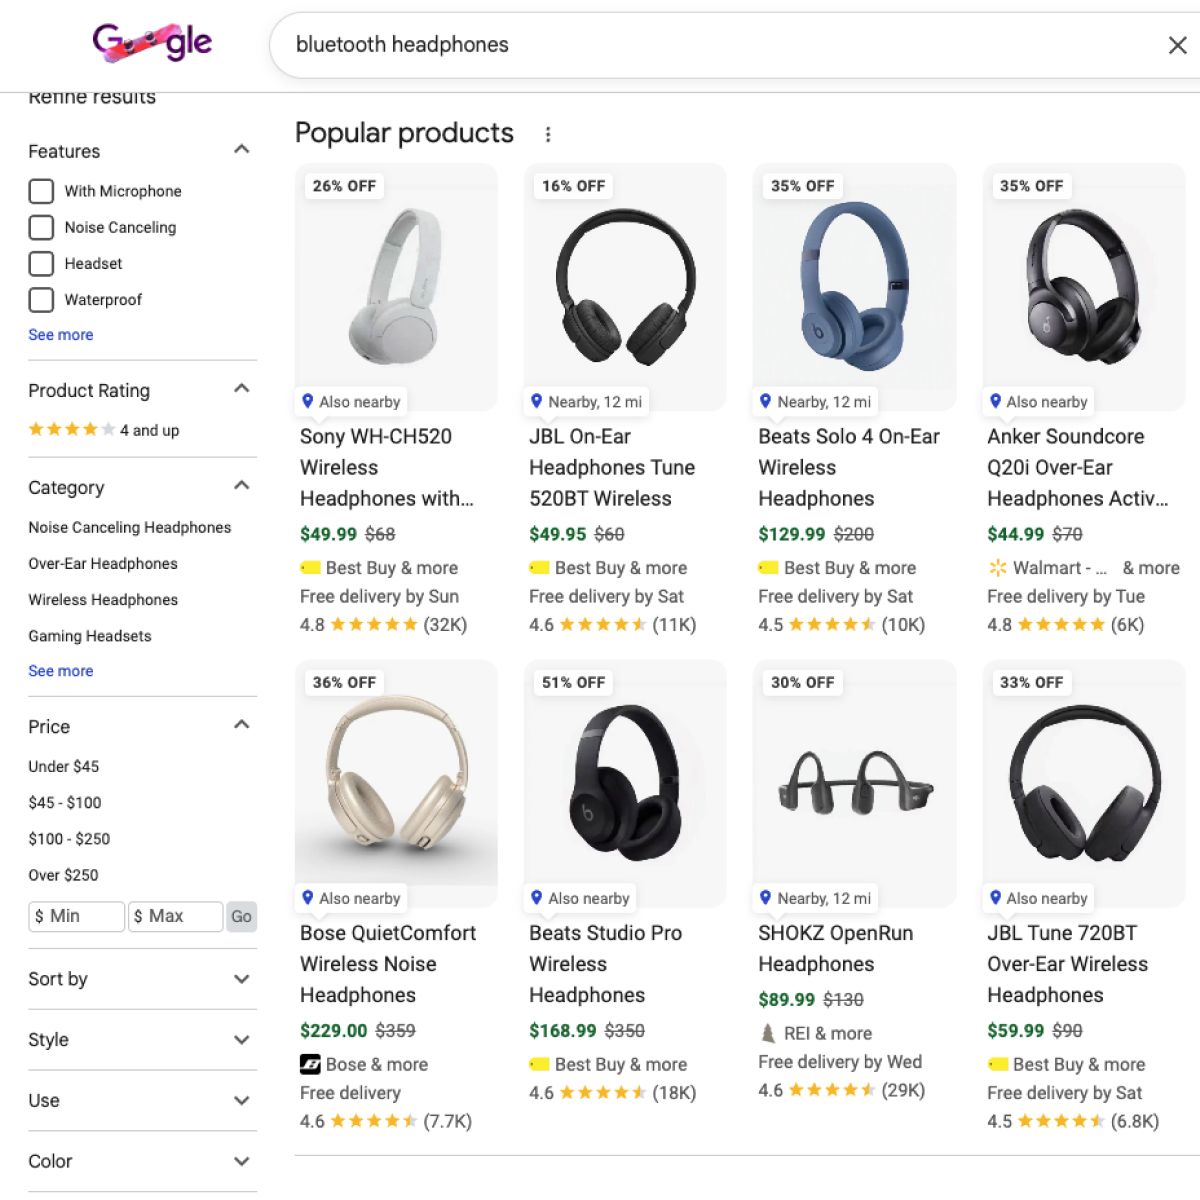
Анализ 115,582 товаров в 11,369 органических сетках выдачи разоблачает иную реальность классификатора: алгоритм форсирует жесткие пороги видимости на основе общевебного Графа Знаний о товаре, переопределяя изолированные метрики конкретной витрины.
Концентрация абсолютная: 79% товаров в органических сетках имеют рейтинг 4 звезды и выше, а 96% удерживают 3+ звезды.
Товары, падающие ниже порога в 3 звезды, отбрасываются бороться за оставшиеся 4% слотов в сетке.
Этот макро-рейтинг диктует видимость, потому что Google агрегирует сентимент, спарсенный с сайтов конкурентов, видосов с обзорами на
Эта коллективная веб-репутация нативно перезаписывает локальные данные.
Логи раскрывают конкретные случаи, когда товары с рейтингом 4.7 звезд на своем хост-домене понижаются до классификации 3.8 звезд в системе Google из-за более слабых отзывов на
Поскольку данные конкурентов и сентимент с внешних платформ напрямую перетекают в алгоритмический рейтинг, управления локальной воронкой отзывов недостаточно для попадания в сетку.
Для обеспечения органической видимости требуется аудит совокупного товарного графа, чтобы выявить точные расхождения в рейтингах, которые Google присваивает сущности во всей своей широкой экосистеме.
#Ecommerce #KnowledgeGraph #ShoppingAds
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Классическая сеошка
e-commerce предполагает, что оптимизация отзывов на самом сайте диктует перформанс в Google Shopping.Анализ 115,582 товаров в 11,369 органических сетках выдачи разоблачает иную реальность классификатора: алгоритм форсирует жесткие пороги видимости на основе общевебного Графа Знаний о товаре, переопределяя изолированные метрики конкретной витрины.
Концентрация абсолютная: 79% товаров в органических сетках имеют рейтинг 4 звезды и выше, а 96% удерживают 3+ звезды.
Товары, падающие ниже порога в 3 звезды, отбрасываются бороться за оставшиеся 4% слотов в сетке.
Этот макро-рейтинг диктует видимость, потому что Google агрегирует сентимент, спарсенный с сайтов конкурентов, видосов с обзорами на
YouTube и TikTok, таблиц спецификаций товаров и тредов на Reddit.Эта коллективная веб-репутация нативно перезаписывает локальные данные.
Логи раскрывают конкретные случаи, когда товары с рейтингом 4.7 звезд на своем хост-домене понижаются до классификации 3.8 звезд в системе Google из-за более слабых отзывов на
Amazon или негативного сентимента во внешних видосах.Поскольку данные конкурентов и сентимент с внешних платформ напрямую перетекают в алгоритмический рейтинг, управления локальной воронкой отзывов недостаточно для попадания в сетку.
Для обеспечения органической видимости требуется аудит совокупного товарного графа, чтобы выявить точные расхождения в рейтингах, которые Google присваивает сущности во всей своей широкой экосистеме.
#Ecommerce #KnowledgeGraph #ShoppingAds
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Сигналы сущности контролируют уверенность нейросетей — архитектура обучающих данных конфигурирует траст для ИИ
ИИ-модели генерируют описания брендов с разным уровнем уверенности.
Слабая уверенность проявляется через обтекаемые формулировки ("Некоторые пользователи отмечают, что [бренд] предлагает..."), сильная уверенность дает безапелляционные утверждения ("[Бренд] — ведущий провайдер...").
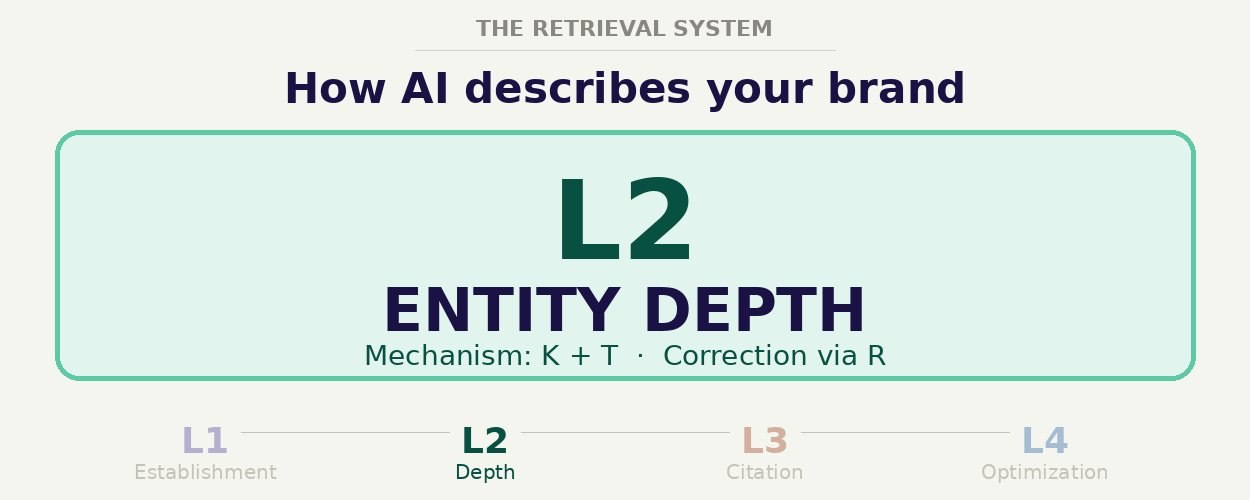
Этот разрыв в тональности — слой
Он показывает объем данных о твоей компании в обучающей выборке модели.
Слой
Если тренировочных данных мало, ИИ сомневается.
Если датасет плотный и разнообразный, нейросеть описывает бренд с авторитетом.
Базовый аудит идентичен для компаний на любой стадии.
Открой
и "Как [бренд] соотносится с [конкурент]"?.
Зафиксируй точные ответы каждой платформы.
Оценивай выдачу по трем критериям.
Точность: верны ли позиционирование, продукты, гео и цены, или модель выдает устаревшие данные и галлюцинации?
Уверенность: ИИ дает железобетонные стейтменты или сыпет предположениями ("является" против "вероятно предлагает")?
Согласованность: все три платформы описывают тебя одинаково, или сигналы сущности разбиты вдребезги?
Этот срез вскрывает текущее состояние
Если проседает точность, обучающие данные устарели или привязаны криво.
Если плавает уверенность, значит параметрическая база слишком тонкая.
Если нет согласованности, сигналы сущности фрагментированы.
Развертывание системы зависит от зрелости бизнеса.
Молодые компании должны сначала сконфигурировать точность: данные уже есть, но они разрознены.
Приоритет — плотность сигналов (единая микроразметка, жесткое позиционирование на своих площадках, фокус на Графе Знаний).
Крупные игроки часто имеют точную базу, но низкую уверенность, потому что инфа устарела или раскидана по сети.
Приоритет — углубить сигнал (апдейт контента, обновление микроразметки, трастовые цитации).
Корпорации часто видят точный и уверенный слой
Приоритет — единая архитектура сущностей (перелинковка продуктов через микроразметку, ссылочная масса на уровне портфеля, общий граф по всем площадкам).
Правки на уровне извлечения (новые промпты для парсинга свежих данных) отрабатывают за дни.
Изменения на уровне обучения (фундаментальные знания модели) требуют новых релизов нейронок.
Видимые ежедневные колебания — это работа слоя извлечения, но медленный фундамент
Инсайты SEO-комьюнити
— Стандарт
— Уверенность обучающего слоя и сомнения слоя извлечения разделяются простым тестом: задай один вопрос с разных устройств в свежих сессиях с отключенным поиском в сети. Размытые фразы ("кажется, предлагает") выдают работу слоя извлечения, а жесткие утверждения ("является лидером") доказывают укорененность в обучающей выборке.
#LLM #EntitySEO #KnowledgeGraph
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
ИИ-модели генерируют описания брендов с разным уровнем уверенности.
Слабая уверенность проявляется через обтекаемые формулировки ("Некоторые пользователи отмечают, что [бренд] предлагает..."), сильная уверенность дает безапелляционные утверждения ("[Бренд] — ведущий провайдер...").
Этот разрыв в тональности — слой
L2.Он показывает объем данных о твоей компании в обучающей выборке модели.
Слой
L2 опирается на механизм K (факты, вшитые в обучающие данные) и механизм T (как эти данные формируют репрезентацию сущности внутри алгоритма).Если тренировочных данных мало, ИИ сомневается.
Если датасет плотный и разнообразный, нейросеть описывает бренд с авторитетом.
Базовый аудит идентичен для компаний на любой стадии.
Открой
ChatGPT, Gemini и Perplexity и вбей промпты: "Что такое [бренд]"?, "Расскажи о [бренд]", "Чем занимается [бренд]"?, "Чем известен [бренд]"?и "Как [бренд] соотносится с [конкурент]"?.
Зафиксируй точные ответы каждой платформы.
Оценивай выдачу по трем критериям.
Точность: верны ли позиционирование, продукты, гео и цены, или модель выдает устаревшие данные и галлюцинации?
Уверенность: ИИ дает железобетонные стейтменты или сыпет предположениями ("является" против "вероятно предлагает")?
Согласованность: все три платформы описывают тебя одинаково, или сигналы сущности разбиты вдребезги?
Этот срез вскрывает текущее состояние
L2.Если проседает точность, обучающие данные устарели или привязаны криво.
Если плавает уверенность, значит параметрическая база слишком тонкая.
Если нет согласованности, сигналы сущности фрагментированы.
Развертывание системы зависит от зрелости бизнеса.
Молодые компании должны сначала сконфигурировать точность: данные уже есть, но они разрознены.
Приоритет — плотность сигналов (единая микроразметка, жесткое позиционирование на своих площадках, фокус на Графе Знаний).
Крупные игроки часто имеют точную базу, но низкую уверенность, потому что инфа устарела или раскидана по сети.
Приоритет — углубить сигнал (апдейт контента, обновление микроразметки, трастовые цитации).
Корпорации часто видят точный и уверенный слой
L2, но с рассинхроном по вертикалям (ChatGPT знает Продукт А, Gemini знает Продукт Б).Приоритет — единая архитектура сущностей (перелинковка продуктов через микроразметку, ссылочная масса на уровне портфеля, общий граф по всем площадкам).
Правки на уровне извлечения (новые промпты для парсинга свежих данных) отрабатывают за дни.
Изменения на уровне обучения (фундаментальные знания модели) требуют новых релизов нейронок.
Видимые ежедневные колебания — это работа слоя извлечения, но медленный фундамент
L2 решает, есть ли у модели данные для уверенного ответа вообще.Инсайты SEO-комьюнити
— Стандарт
citemap.json расширяет глубину сущности за пределы schema.org. Он добавляет происхождение данных, уровень траста и защиту от неверной атрибуции как слой борьбы с галлюцинациями. Это напрямую контролирует уверенность ИИ в каждом источнике.— Уверенность обучающего слоя и сомнения слоя извлечения разделяются простым тестом: задай один вопрос с разных устройств в свежих сессиях с отключенным поиском в сети. Размытые фразы ("кажется, предлагает") выдают работу слоя извлечения, а жесткие утверждения ("является лидером") доказывают укорененность в обучающей выборке.
#LLM #EntitySEO #KnowledgeGraph
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
❤1
LLM-модели вырезают бренды из ответов: данные раскрывают разрыв в логике цитирования
Анализ 541,213 ответов
Твой домен проходит порог извлечения.
Имя конкурента выживает при выборе бренда.
Данные железобетонно подтверждают
Цитации здесь выступают библиографией, а не исходным брейнштормом.
Когда бренд упоминается в ответе ИИ, частота его цитирования взлетает до 53.1%.
Когда НЕ упоминается, цифра падает до 10.6% — перевернутая разница в 5 раз.
Если бы рекомендации строились на базе поиска источников, эти метрики были бы сопоставимы.
Они не сопоставимы.
Механика: покупатель спрашивает "лучшие решения для [категория]"?
→
Честная оговорка: без логов генерации токенов это мощное поведенческое доказательство, а не стопроцентно подтвержденная архитектура.
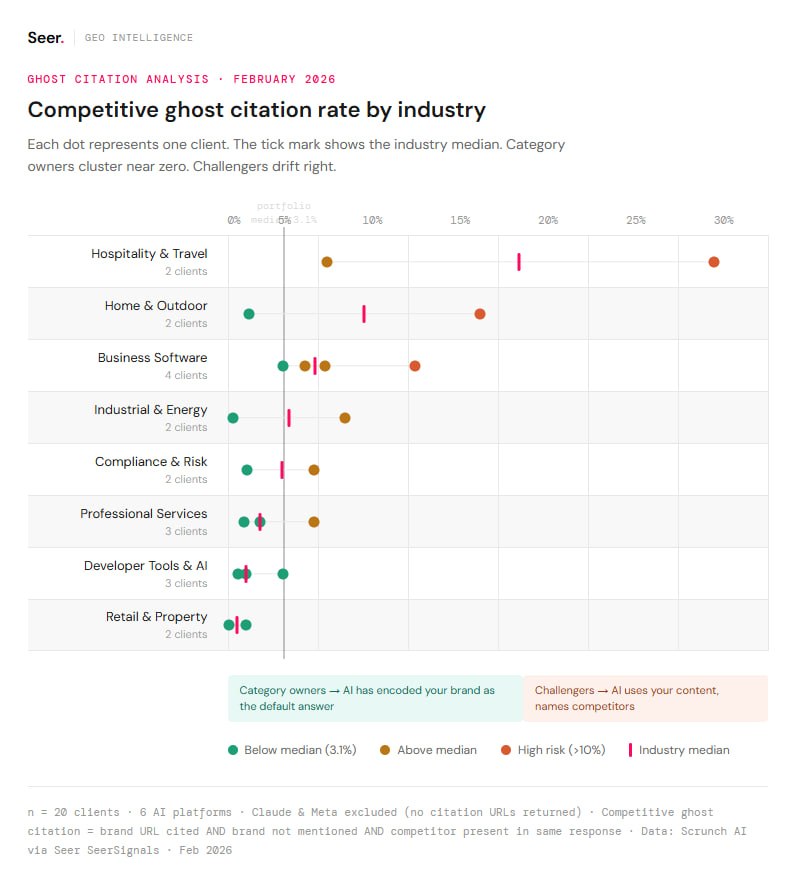
Частота призрачных цитаций (когда источник указан, а бренд нет) сильно скачет по нишам.
В
Ключевой фактор: сила сигнала сущности бренда в Графе Знаний ИИ.
Лидеры категорий (те, чье имя стало синонимом ниши в сети) сводят призрачные цитации практически к нулю.
Все эти компании достигли такого статуса через годы прокачки бренда еще до появления ИИ.
Максимальный урон прилетает на этапе
Осведомительные промпты формируют восприятие категории у покупателей, которые еще не слышали ни о тебе, ни о твоих конкурентах.
Твой контент формирует этот диалог.
Твое имя в нем не фигурирует.
Слой 1: Делай имя бренда грамматическим подлежащим в инсайтах, которые извлекает ИИ. Не "пять подходов к комплаенс-обучению", а "В [Бренд] наш подход к комплаенсу начинается с…". Извлечь этот текст без твоего имени становится невозможно. Слой 2: Строй сигналы графа сущностей, которые ИИ считывает при выборе бренда — записи в
Трекай показатель
Если график идет вниз — прокачка сущности работает.
Если ползет вверх — инвестиции в контент обгоняют вложения в бренд, и разрыв растет.
Ни одно из этих действий не дает результатов за ночь; модели переиндексируют данные по собственному графику.
Закладывай от нескольких недель до месяцев до появления измеримой динамики.
https://www.seerinteractive.com/insights/llm-ghost-citations-why-your-content-is-working-and-your-brand-isnt
#LLM #EntitySEO #KnowledgeGraph
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Анализ 541,213 ответов
LLM по 20 брендам и 6 ИИ-платформам раскрывает структурную дыру в логике рекомендаций: алгоритм цитирует контент, но игнорирует бренды.Твой домен проходит порог извлечения.
Имя конкурента выживает при выборе бренда.
Данные железобетонно подтверждают
post-hoc модель: LLM сначала генерируют ответ — вытягивая названия брендов из параметрической памяти, — а затем ищут источники для подкрепления этого выбора.Цитации здесь выступают библиографией, а не исходным брейнштормом.
Когда бренд упоминается в ответе ИИ, частота его цитирования взлетает до 53.1%.
Когда НЕ упоминается, цифра падает до 10.6% — перевернутая разница в 5 раз.
Если бы рекомендации строились на базе поиска источников, эти метрики были бы сопоставимы.
Они не сопоставимы.
Seer прогнали тесты на 362,188 ответах LLM.Механика: покупатель спрашивает "лучшие решения для [категория]"?
→
LLM достает имена конкурентов из памяти обучения → алгоритм поиска находит твой релевантный контент → твой урл прикручивается как источник-подтверждение → конкуренты получают прямую рекомендацию, твой бренд остается за бортом.Честная оговорка: без логов генерации токенов это мощное поведенческое доказательство, а не стопроцентно подтвержденная архитектура.
Частота призрачных цитаций (когда источник указан, а бренд нет) сильно скачет по нишам.
В
Hospitality & Travel разрыв между лидерами и аутсайдерами превышает 20 процентных пунктов — хотя обе стороны представляют крупные бренды.Ключевой фактор: сила сигнала сущности бренда в Графе Знаний ИИ.
Лидеры категорий (те, чье имя стало синонимом ниши в сети) сводят призрачные цитации практически к нулю.
Industrial Services выдает 0.3%; Financial Services и HR Technology — ниже 2%.Все эти компании достигли такого статуса через годы прокачки бренда еще до появления ИИ.
Максимальный урон прилетает на этапе
Awareness: конкурентная частота призрачных цитаций составляет 5.0%.Осведомительные промпты формируют восприятие категории у покупателей, которые еще не слышали ни о тебе, ни о твоих конкурентах.
Твой контент формирует этот диалог.
Твое имя в нем не фигурирует.
Слой 1: Делай имя бренда грамматическим подлежащим в инсайтах, которые извлекает ИИ. Не "пять подходов к комплаенс-обучению", а "В [Бренд] наш подход к комплаенсу начинается с…". Извлечь этот текст без твоего имени становится невозможно. Слой 2: Строй сигналы графа сущностей, которые ИИ считывает при выборе бренда — записи в
Wikidata, присутствие в Wikipedia, микроразметка Organization с тегом sameAs, единое каноническое имя бренда на всех ресурсах, микроразметка автора, связывающая экспертов с компанией, FAQ-разметка с именем бренда в ответах. Маленькие конкуренты с чистыми графами сущностей выносят здесь крупных игроков. Слой 3: Получай упоминания бренда на сторонних площадках именно в контексте рекомендаций — в отчетах аналитиков, пресс-релизах, агрегаторах отзывов, на партнерских страницах. Упоминание канонического имени бренда в H1 на страницах Gartner или TechCrunch учит модель, что твое имя должно всплывать, когда юзер спрашивает про категорию.Трекай показатель
Competitive Ghost Citation Rate ежемесячно с разбивкой по платформам и этапам воронки.Если график идет вниз — прокачка сущности работает.
Если ползет вверх — инвестиции в контент обгоняют вложения в бренд, и разрыв растет.
Ни одно из этих действий не дает результатов за ночь; модели переиндексируют данные по собственному графику.
Закладывай от нескольких недель до месяцев до появления измеримой динамики.
https://www.seerinteractive.com/insights/llm-ghost-citations-why-your-content-is-working-and-your-brand-isnt
#LLM #EntitySEO #KnowledgeGraph
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
❤5
Инъекция в Wikidata открывает бэкдор в Граф Знаний без упоминаний в национальной прессе
Google активно делегирует свой алгоритмический траст внешним базам-"гейткиперам".
Пока страница в Википедии остается золотым стандартом для получения
Я обхожу это трение, абузя
Она функционирует как репозиторий структурированных данных, которому Google сильно доверяет.
Получая запись в
Это создает критический мост; как только сущность установлена здесь, мы можем усилить сигнал, триангулируя его с другими доверенными источниками, на которые полагается Google для верификации, такими как
Экономика этого подхода асимметрична.
Пока сервис создания управляемой Википедии может стоить свыше $850 без гарантии выживания, услуги по внесению в
Однако это не эксплойт типа "настроил и забыл".
Платформа все еще модерирует на предмет значимости — мою собственную страницу снесли через 24 часа из-за недостаточного внешнего ссылочного — поэтому жизненно важно стакать это с реальными сигналами вроде отзывов на
#KnowledgeGraph #EntitySEO #OffPage
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Google активно делегирует свой алгоритмический траст внешним базам-"гейткиперам".
Пока страница в Википедии остается золотым стандартом для получения
Knowledge Panel, порог входа — требующий освещения в национальной прессе и жесткой модерации — часто непреодолим для новых сущностей.Я обхожу это трение, абузя
Wikidata, которая служит бэкдором в граф сущностей Google, раскрывает Лео Пуатевин.Wikidata обладает примерно "половиной авторитета" полноценной страницы Википедии, но оперирует со значительно более низким порогом модерации, так как это не публичная энциклопедия.Она функционирует как репозиторий структурированных данных, которому Google сильно доверяет.
Получая запись в
Wikidata, вы эффективно валидируете существование сущности для алгоритма без необходимости массивного медийного футпринта, требуемого для Википедии.Это создает критический мост; как только сущность установлена здесь, мы можем усилить сигнал, триангулируя его с другими доверенными источниками, на которые полагается Google для верификации, такими как
Crunchbase, IMDB и верифицированные соцпрофили в LinkedIn и X.Экономика этого подхода асимметрична.
Пока сервис создания управляемой Википедии может стоить свыше $850 без гарантии выживания, услуги по внесению в
Wikidata можно найти на платформах типа Legit всего за $30.Однако это не эксплойт типа "настроил и забыл".
Платформа все еще модерирует на предмет значимости — мою собственную страницу снесли через 24 часа из-за недостаточного внешнего ссылочного — поэтому жизненно важно стакать это с реальными сигналами вроде отзывов на
Trustpilot и консистентными данными NAP по всей экосистеме, чтобы запись закрепилась.#KnowledgeGraph #EntitySEO #OffPage
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤2
Собственные /g/ ноды вытаскивают трафик в core-апдейте — сила бренда не предсказывает рост
В контролируемом сравнении по смежным нишам 34% сайтов, завязанных на персональную сущность, показали рост (n=95), тогда как из 29 крупных брендов в тех же нишах не вырос никто, и только 3 бренда хоть как-то сдвинулись вверх.
Затем автор собрал 159 верифицированных авторских сайтов, оставил 128 с читаемой историей трафика и зафиксировал: 46% из них выросли в июньском
Мое внимание привлек один сайт, ранжирующийся по ВЧ-запросу в
Инструмент скоринга — это как раз то, что можно перенести на другие проекты.
Известность не предсказывала ничего.
Люди, имеющие только собственную
Энциклопедические ноды по нишевым авторам также привязываются не к тем людям — 18 из 40 оказались коллизией имен, а один сайт по деревообработке совпал с сыном Арнольда Шварценеггера.
Разброс по 54 победителям узкий: медианный возраст домена около 16 лет, 45 из 54 — в хобби-нишах, а стартовый диапазон трафика от 10К до 100К рос в 63% случаев, что стало лучшим результатом.
Сайты до 1К подросли на 11%, причем часть этой группы дала всплеск во время апдейта, только чтобы слить прирост в течение пары месяцев.
Пять
Все цифры трафика — это оценки органики по
https://usewhistle.co/research/personal-entity-correlation
#EntitySEO #CoreUpdates #KnowledgeGraph
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
В контролируемом сравнении по смежным нишам 34% сайтов, завязанных на персональную сущность, показали рост (n=95), тогда как из 29 крупных брендов в тех же нишах не вырос никто, и только 3 бренда хоть как-то сдвинулись вверх.
Затем автор собрал 159 верифицированных авторских сайтов, оставил 128 с читаемой историей трафика и зафиксировал: 46% из них выросли в июньском
core-апдейте 2025 года при типичной базовой ставке около 18%.Мое внимание привлек один сайт, ранжирующийся по ВЧ-запросу в
email-маркетинге, за которым не стояло никакого бренда: emailvendorselection.com, управляемый одним человеком, Джорди ван Рейном, с ростом с 21 399 до 458 618 визитов в месяц.Инструмент скоринга — это как раз то, что можно перенести на другие проекты.
Wikidata провалилась как прокси для персональной сущности: из 119 проверенных людей у 48% вообще не было сущности, 24% выдали коллизию полных тезок, 23% оказались неверифицированными однофамильцами, и только 3 вернулись как подтвержденное совпадение со своим сайтом.Wikipedia измеряла известность.Google Knowledge Graph API измеряет нечто иное — у 137 из 149 человек была /g/ нода, тип, который Google собирает сам из футпринта человека: сайта, профилей sameAs и упоминаний в сети, без энциклопедической статьи за спиной.Известность не предсказывала ничего.
Люди, имеющие только собственную
/g/ ноду, росли в 51% случаев (36 из 71); те, у кого была и /g/, и старая /m/ нода уровня Freebase, выросли на 38% — это самый низкий показатель среди всех групп.Энциклопедические ноды по нишевым авторам также привязываются не к тем людям — 18 из 40 оказались коллизией имен, а один сайт по деревообработке совпал с сыном Арнольда Шварценеггера.
Разброс по 54 победителям узкий: медианный возраст домена около 16 лет, 45 из 54 — в хобби-нишах, а стартовый диапазон трафика от 10К до 100К рос в 63% случаев, что стало лучшим результатом.
Сайты до 1К подросли на 11%, причем часть этой группы дала всплеск во время апдейта, только чтобы слить прирост в течение пары месяцев.
Пять
YMYL-сайтов по финансам и здоровью вообще не выросли.Все цифры трафика — это оценки органики по
Ahrefs (база — май 2025, после апдейта — апрель 2026, перепроверка — июнь 2026), а вывод о том, что персональная сущность теперь несет вес, который раньше был у бренда, подается как рабочая теория, а не доказанный механизм.https://usewhistle.co/research/personal-entity-correlation
#EntitySEO #CoreUpdates #KnowledgeGraph
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤1
Упоминания без связи не работают: 30 одинаковых источников формируют факт для Графа Знаний
Всё на собственном домене — это лишь заявление (claim).
Микроразметка, страница "О нас", идеально сформированный триплет
Самодекларирование никогда не попадает в Граф Знаний.
Достоверность факта оценивается по тому, сколько независимых источников утверждают одно и то же и насколько они надежны (согласно собственным исследованиям Google).
Бренд и ключ на одной странице — это совместное упоминание (co-occurrence); соединенные четкой связью, они становятся триплетом.
500 источников, описывающих бренд 50 разными способами, выдают 500 слабых заявлений; 30 источников с идентичным описанием цементируют один сильный факт.
Оценка строится на независимости: 50 размещений с одной сетки по одному брифу за неделю читаются как один источник, повторяющий себя 50 раз.
Это футпринты на уровне сущностей, а не ссылок.
Ценность не в упоминании, а в утверждении: упоминание без четкой связи близко к мусору, и именно это продает большинство
Окружение бьет авторитет.
Размещение на
Форматирование и структура предложений решают, что выживет как триплет:
— Подлежащее на первом месте, никаких местоимений. Страдательный залог ломает порядок, а все "он", "они", "компания" плодят осиротевшие факты — разрешение кореференции работает криво и не бесплатно, поэтому повторяй название бренда идентично в каждом абзаце.
— Оговорки убивают достоверность факта. "Один из", "возможно", "вероятно", "помогает" сносят триплет до нуля.
— Отрицание остается локальным. "X произошло. Это ложь". оставляет заявление и сохраняет связь; "X НЕ происходило" — фиксируется. Опровержения в формате "заявление-затем-опровержение" могут цементировать то, что должны были стереть.
— Дистанция размывает. Субъект и объект, разделенные 40 словами придаточных предложений, дают слабую связь, тогда как соседние — сильную.
— Утверждение и доказательство должны лежать в одном блоке. Контент бьется на чанки, и слой извлечения часто тянет один чанк без следующего — половина факта никогда не цитируется.
— Заголовки — это строки запросов.
Консенсус накапливается, а не включается по достижении порога, и распадается без постоянного подкрепления; шестинедельная кампания по сущностям держится лишь ограниченное время.
Негативное подтверждение реверсит механизм: нежелательная ассоциация, растиражированная по сети источников, наследуется, и страница на собственном домене обычно не может это оспорить.
Диагностика бесплатна.
Скорми
То, что они цитируют, уже сидит в трастовом наборе.
Определение того, какие утверждения пушить, в каком порядке и с какой динамикой, требует реверс-инжиниринга ниши.
Инсайты комьюнити
— Базовый сет подтверждения: идентичное имя и дескрипторы в
— Живой парсер все равно ломается на этих цепочках, когда один предлог проскальзывает за границу чанка; в проде правила грамматики деградируют.
#EntitySEO #KnowledgeGraph #DigitalPR
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Всё на собственном домене — это лишь заявление (claim).
Микроразметка, страница "О нас", идеально сформированный триплет
subject → predicate → object — это утверждение, а не доказательство.Самодекларирование никогда не попадает в Граф Знаний.
Достоверность факта оценивается по тому, сколько независимых источников утверждают одно и то же и насколько они надежны (согласно собственным исследованиям Google).
Бренд и ключ на одной странице — это совместное упоминание (co-occurrence); соединенные четкой связью, они становятся триплетом.
500 источников, описывающих бренд 50 разными способами, выдают 500 слабых заявлений; 30 источников с идентичным описанием цементируют один сильный факт.
Оценка строится на независимости: 50 размещений с одной сетки по одному брифу за неделю читаются как один источник, повторяющий себя 50 раз.
Это футпринты на уровне сущностей, а не ссылок.
Ценность не в упоминании, а в утверждении: упоминание без четкой связи близко к мусору, и именно это продает большинство
digital PR-агентств.Окружение бьет авторитет.
Размещение на
DR 85 в неверном семантическом кластере учит граф привязывать бренд к неправильной ноде, либо вообще ни к какой: получается несовпадающая строка, которую LLM не рискнет рекомендовать.Форматирование и структура предложений решают, что выживет как триплет:
— Подлежащее на первом месте, никаких местоимений. Страдательный залог ломает порядок, а все "он", "они", "компания" плодят осиротевшие факты — разрешение кореференции работает криво и не бесплатно, поэтому повторяй название бренда идентично в каждом абзаце.
— Оговорки убивают достоверность факта. "Один из", "возможно", "вероятно", "помогает" сносят триплет до нуля.
— Отрицание остается локальным. "X произошло. Это ложь". оставляет заявление и сохраняет связь; "X НЕ происходило" — фиксируется. Опровержения в формате "заявление-затем-опровержение" могут цементировать то, что должны были стереть.
— Дистанция размывает. Субъект и объект, разделенные 40 словами придаточных предложений, дают слабую связь, тогда как соседние — сильную.
— Утверждение и доказательство должны лежать в одном блоке. Контент бьется на чанки, и слой извлечения часто тянет один чанк без следующего — половина факта никогда не цитируется.
— Заголовки — это строки запросов.
"What Is Entity SEO" матчится; "The Hidden Architecture of Modern Search in 2026" уходит в пустоту.Консенсус накапливается, а не включается по достижении порога, и распадается без постоянного подкрепления; шестинедельная кампания по сущностям держится лишь ограниченное время.
Негативное подтверждение реверсит механизм: нежелательная ассоциация, растиражированная по сети источников, наследуется, и страница на собственном домене обычно не может это оспорить.
Диагностика бесплатна.
Скорми
ChatGPT, Claude, Gemini и Perplexity один и тот же вопрос о бренде в разных сессиях: согласие фиксирует подтвержденный факт, противоречие вскрывает неоднозначность, тишина означает несовпадающую строку.То, что они цитируют, уже сидит в трастовом наборе.
Определение того, какие утверждения пушить, в каком порядке и с какой динамикой, требует реверс-инжиниринга ниши.
Инсайты комьюнити
— Базовый сет подтверждения: идентичное имя и дескрипторы в
Wikipedia, Crunchbase, LinkedIn и Reddit — Wikipedia до сих пор засеивает большинство Графов Знаний.— Живой парсер все равно ломается на этих цепочках, когда один предлог проскальзывает за границу чанка; в проде правила грамматики деградируют.
#EntitySEO #KnowledgeGraph #DigitalPR
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
✍4
Данные доказывают: упоминания на 4+ внешних площадках форсируют ИИ-цитирование в 2.8 раза — у лидеров меньше KG-сущностей
Модели отдают ответ, который видят повсюду.
Вот почему запись в
Данные доказывают обратное: часто цитируемые страницы в среднем содержат меньше верифицированных
Вместо этого модели цепляются за конкретные, нишевые сущности — названный метод, точную статистику, именное сравнение — а микроразметка остается лишь гигиеной идентификации, а не драйвером цитирования.
Извлечение также идет на уровне чанков, а не целых страниц.
ИИ-ответы подтягивают абзацы, а большинство сайтов не содержат ни одного чистого блока, который движок мог бы безопасно процитировать.
Открывай каждый ключевой раздел прямым утверждением "[X] — это [Y]" и вычищай хеджирование: никаких "если", "но" или "возможно".
Упоминания бренда коррелируют с попаданием в
Скорее всего, дело в том, что анкоры ссылок размываются, тогда как упоминание намертво привязывается к сущности самого бренда.
Упоминания без ссылок теперь засчитываются как голоса, а извлечение с 4+ сторонних площадок поднимает шансы на цитирование ~2.8x:
— Сайты-отзовики
— Листинг-статьи
— Транскрипты
—
Половина жалоб в духе "почему меня не цитируют" сводится к правилу
Лезь в логи файрвола и
Модели также дают перевес доменам, которым уже доверяют.
Плотный, похожий на ответ чанк на трастовом хосте влетает в ИИ-выдачу, пока свежий домен все еще сидит в песочнице.
Арендуй траст, засеивай сущность, перехватывай клик или брендовый поиск.
Консенсус — это вообще вся суть игры: модель выдает то, с чем согласны везде.
Единственная оставшаяся задача — стать этим ответом на каждой площадке, откуда парсятся данные.
#AIOverviews #BrandMentions #KnowledgeGraph
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Модели отдают ответ, который видят повсюду.
Вот почему запись в
Knowledge Graph, за которой все советовали гнаться, — это ложный вектор.Данные доказывают обратное: часто цитируемые страницы в среднем содержат меньше верифицированных
KG-сущностей, чем те, что цитируются редко.Вместо этого модели цепляются за конкретные, нишевые сущности — названный метод, точную статистику, именное сравнение — а микроразметка остается лишь гигиеной идентификации, а не драйвером цитирования.
Извлечение также идет на уровне чанков, а не целых страниц.
ИИ-ответы подтягивают абзацы, а большинство сайтов не содержат ни одного чистого блока, который движок мог бы безопасно процитировать.
Открывай каждый ключевой раздел прямым утверждением "[X] — это [Y]" и вычищай хеджирование: никаких "если", "но" или "возможно".
Упоминания бренда коррелируют с попаданием в
AI Overview примерно в 3 раза сильнее, чем бэклинки.Скорее всего, дело в том, что анкоры ссылок размываются, тогда как упоминание намертво привязывается к сущности самого бренда.
Упоминания без ссылок теперь засчитываются как голоса, а извлечение с 4+ сторонних площадок поднимает шансы на цитирование ~2.8x:
— Сайты-отзовики
— Листинг-статьи
— Транскрипты
YouTube—
PRПоловина жалоб в духе "почему меня не цитируют" сводится к правилу
Cloudflare или WAF, которое втихую блокирует GPTBot, ClaudeBot, PerplexityBot и Google-Extended.Лезь в логи файрвола и
robots.txt, прежде чем трогать хоть слово в контенте — страница, которую запрещено краулить, никогда не станет ответом.Модели также дают перевес доменам, которым уже доверяют.
Плотный, похожий на ответ чанк на трастовом хосте влетает в ИИ-выдачу, пока свежий домен все еще сидит в песочнице.
Арендуй траст, засеивай сущность, перехватывай клик или брендовый поиск.
Консенсус — это вообще вся суть игры: модель выдает то, с чем согласны везде.
Единственная оставшаяся задача — стать этим ответом на каждой площадке, откуда парсятся данные.
#AIOverviews #BrandMentions #KnowledgeGraph
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO