Markdown-клоакинг обходит корпоративную бюрократию и ускоряет тесты контента
Забудьте про миф, что отдача упрощенной
Реальный, "недокументированный" эксплойт для клоакинга на основе юзер-агента — это обход внутренней корпоративной политики на страницах с высокими ставками, где любое изменение превращается в политический ад.
В крупных организациях продуктовый маркетинг, бренд и другие команды могут заблокировать любую попытку быстрой итерации контента.
Эта тактика создает стратегическую лазейку.
Используя
Политически заряженная, видимая пользователям
Эта "теневая" версия становится вашим частным полигоном, позволяя быстро итерировать изменения контента и тестировать гипотезы до успешных вариантов без единого митинга.
Как только у вас будут данные, доказывающие, что ваши изменения работают, вы можете использовать их как рычаг, чтобы продавить внедрение выигрышных модификаций на живую страницу, вооружившись доказательствами, а не мнениями.
Однако это не лишено риска.
Как только вы создаете расходящиеся пути для контента, вы закладываете потенциальные мины.
Хотя это и не определено явно для данного кейса, вы работаете в серой зоне, которая напоминает традиционный клоакинг и обманные практики.
Что еще важнее, вы рискуете серьезно запутать пользователя, если
Это нужно менеджить как плотный, краткосрочный цикл тестирования, а не как постоянное разветвление контента.
#Cloaking #Experiments #Enterprise
@MikeBlazerX
Пушки — в @MikeBlazerPRO
Забудьте про миф, что отдача упрощенной
markdown-версии страницы AI-краулерам улучшает позиции; это пустая трата ресурсов, так как современные RAG-пайплайны и так эффективно парсят хорошо структурированный HTML, утверждает Алекс Халлидей.Реальный, "недокументированный" эксплойт для клоакинга на основе юзер-агента — это обход внутренней корпоративной политики на страницах с высокими ставками, где любое изменение превращается в политический ад.
В крупных организациях продуктовый маркетинг, бренд и другие команды могут заблокировать любую попытку быстрой итерации контента.
Эта тактика создает стратегическую лазейку.
Используя
Cloudflare worker или Vercel middleware, вы отдаете измененную markdown-версию страницы исключительно ботам с юзер-агентами типа GPTbot.Политически заряженная, видимая пользователям
HTML-страница остается нетронутой.Эта "теневая" версия становится вашим частным полигоном, позволяя быстро итерировать изменения контента и тестировать гипотезы до успешных вариантов без единого митинга.
Как только у вас будут данные, доказывающие, что ваши изменения работают, вы можете использовать их как рычаг, чтобы продавить внедрение выигрышных модификаций на живую страницу, вооружившись доказательствами, а не мнениями.
Однако это не лишено риска.
Как только вы создаете расходящиеся пути для контента, вы закладываете потенциальные мины.
Хотя это и не определено явно для данного кейса, вы работаете в серой зоне, которая напоминает традиционный клоакинг и обманные практики.
Что еще важнее, вы рискуете серьезно запутать пользователя, если
LLM процитирует текст из вашей версии только для ботов, а пользователь перейдет на страницу, где этого текста и в помине нет.Это нужно менеджить как плотный, краткосрочный цикл тестирования, а не как постоянное разветвление контента.
#Cloaking #Experiments #Enterprise
@MikeBlazerX
Пушки — в @MikeBlazerPRO
❤2👌2🤝1
Метод «Чистой комнаты» точно замеряет передаваемый вес одного бэклинка
После дохрена провальных тестов, зашумленных кривыми данными, я разработал финальную методологию, как изолировать и замерить реальный выхлоп от одного-единственного бэклинка, детализирует эксперт.
Весь протокол заточен под создание "чистой комнаты", где можно отследить одну переменную без всяких помех.
Для этого придется железно соблюдать ряд условий.
Во-первых, моя базовая гипотеза для эффективной ссылки требует выполнения трех условий: домен-донор должен передавать вес, ссылающаяся страница — не быть сиротой, и страница должна быть в индексе Google.
Чтобы это протестировать, надо выбрать целевой
Это гарантирует, что есть огромный потенциал для роста, и не придется бодаться в волатильном топ-20.
Критически важные ограничения для тестовой среды следующие:
1. Целевой
2. Ключевой момент: надо прочекать через
Такой сетап гарантирует, что вы работаете в выдаче с низкой конкуренцией по бэклинкам, где появление одной новой ссылки дает чистый и измеримый сигнал.
Любое отклонение от этих правил херит весь тест, потому что вносит слишком много переменных.
#Backlinks #Experiments #LinkEquity
@MikeBlazerX
Пушки — в @MikeBlazerPRO
После дохрена провальных тестов, зашумленных кривыми данными, я разработал финальную методологию, как изолировать и замерить реальный выхлоп от одного-единственного бэклинка, детализирует эксперт.
Весь протокол заточен под создание "чистой комнаты", где можно отследить одну переменную без всяких помех.
Для этого придется железно соблюдать ряд условий.
Во-первых, моя базовая гипотеза для эффективной ссылки требует выполнения трех условий: домен-донор должен передавать вес, ссылающаяся страница — не быть сиротой, и страница должна быть в индексе Google.
Чтобы это протестировать, надо выбрать целевой
URL, где один-единственный ключ ранжируется между 50-й и 100-й позицией.Это гарантирует, что есть огромный потенциал для роста, и не придется бодаться в волатильном топ-20.
Критически важные ограничения для тестовой среды следующие:
1. Целевой
URL должен иметь ноль существующих бэклинков.2. Ключевой момент: надо прочекать через
Ahrefs, что как минимум у 50% урлов, ранжирующихся выше вашего целевого, тоже нет бэклинков.Такой сетап гарантирует, что вы работаете в выдаче с низкой конкуренцией по бэклинкам, где появление одной новой ссылки дает чистый и измеримый сигнал.
Любое отклонение от этих правил херит весь тест, потому что вносит слишком много переменных.
#Backlinks #Experiments #LinkEquity
@MikeBlazerX
Пушки — в @MikeBlazerPRO
😁10❤1👌1
Мы 6 месяцев тестировали
В апреле этого года мы начали инвестировать в SEO и
На старте: ноль посетителей, нет блога, нет органики.
С тех пор мы проводили довольно прямолинейный тест:
— Мы написали 28 лонгридов "ручками", заточенных под очень специфические запросы нижнего этапа воронки (bottom-of-the-funnel).
— Мы также опубликовали 192 сгенерированных ИИ поста для верхнего этапа воронки (top-of-the-funnel), используя одну тулзу (имен называть не будем).
Разница в результатах... мягко говоря, шокирует.
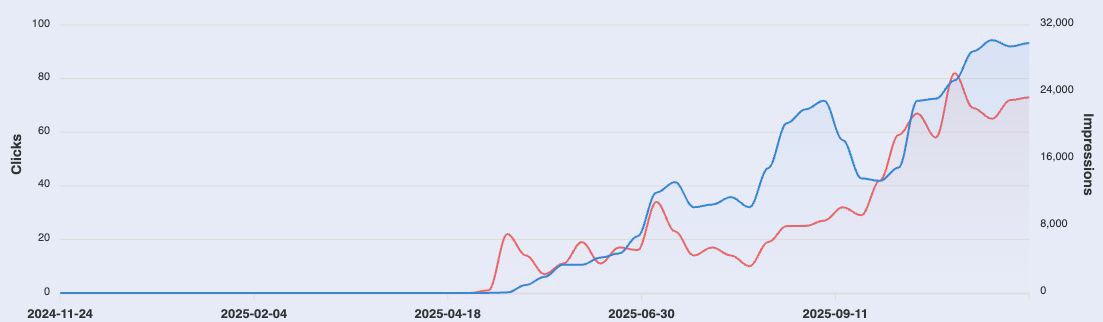
— Посты, написанные людьми: 722 клика и 300,154 показов.
—
Люди, которые в итоге бронируют у нас встречи (1-3 в неделю), часто говорят, что нашли нас через
Мы не уверены на 100%, что именно дает такую разницу.
— Может, качество.
— Может, то, как Гугл относится к
— Может,
— А может, наши рукописные статьи просто топчик.
В любом случае, ясно одно: качество все еще бьет количество.
Но хотелось бы докопаться до точной причины.
#AIContent #ContentStrategy #Experiments
@MikeBlazerX
Пушки — в @MikeBlazerPRO
AI-контент против написанного людьми (SEO и GEO) — и результаты реально шокирующие, пишет Эндрю ван Россенберг.В апреле этого года мы начали инвестировать в SEO и
GEO.На старте: ноль посетителей, нет блога, нет органики.
С тех пор мы проводили довольно прямолинейный тест:
— Мы написали 28 лонгридов "ручками", заточенных под очень специфические запросы нижнего этапа воронки (bottom-of-the-funnel).
— Мы также опубликовали 192 сгенерированных ИИ поста для верхнего этапа воронки (top-of-the-funnel), используя одну тулзу (имен называть не будем).
Разница в результатах... мягко говоря, шокирует.
— Посты, написанные людьми: 722 клика и 300,154 показов.
—
AI-контент? 9 кликов и 9,682 показов.Люди, которые в итоге бронируют у нас встречи (1-3 в неделю), часто говорят, что нашли нас через
LLM, и каждый раз упоминают конкретную статью — одну из тех, что написаны вручную.Мы не уверены на 100%, что именно дает такую разницу.
— Может, качество.
— Может, то, как Гугл относится к
AI-контенту.— Может,
AI-посты слишком общие (top-of-funnel).— А может, наши рукописные статьи просто топчик.
В любом случае, ясно одно: качество все еще бьет количество.
Но хотелось бы докопаться до точной причины.
#AIContent #ContentStrategy #Experiments
@MikeBlazerX
Пушки — в @MikeBlazerPRO
😁8👍6❤2🤝1
Похоже, это самый безумный трюк в локальном SEO, что только можно представить.
Холли Старкс реально запарилась (в прямом смысле — намотала километры), чтобы доказать: следование по маршруту
Она загрузила 100 телефонов в тачку, настроила маршруты к точке на
Результат — отвал башки:
Ранжирование бизнеса улетело с 20-х позиций сразу в топ-1!
Так что, если хотите поддать газу в позициях, поощряйте людей (сотрудников, друзей, например) кликать на кнопку "проложить маршрут", когда они едут к вашему бизнесу, даже если они знают дорогу 😉
#LocalSEO #Maps #Experiments
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
Холли Старкс реально запарилась (в прямом смысле — намотала километры), чтобы доказать: следование по маршруту
Google Maps к бизнесу бустит его ранжирование.Она загрузила 100 телефонов в тачку, настроила маршруты к точке на
Google Maps и поехала.Результат — отвал башки:
Ранжирование бизнеса улетело с 20-х позиций сразу в топ-1!
Так что, если хотите поддать газу в позициях, поощряйте людей (сотрудников, друзей, например) кликать на кнопку "проложить маршрут", когда они едут к вашему бизнесу, даже если они знают дорогу 😉
#LocalSEO #Maps #Experiments
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO

❤🔥17✍15👍7😁2❤1⚡1
Удаление бэклинков не убивает рост позиций: тесты это подтверждают
"Ссылочное эхо" — это не просто теория; это устойчивый артефакт алгоритма, который Рэнд Фишкин наблюдал в каждом проведенном им ссылочном тесте, раскрывает Эдвард Штурм.
В восьми отдельных экспериментах, где мы могли изолировать переменные, выхлоп был один и тот же: мы направляли ссылки на цель, позиции росли, мы удаляли ссылки, а позиции оставались в топе.
Это не был краткосрочный эффект-призрак; высокие позиции держались много месяцев, в одном случае — более 4,5 месяцев после удаления.
В фундаментальном тесте
Когда все 22 ссылки были удалены, сайт остался на 1-й позиции.
Ни в одном тесте позиции никогда не откатывались к своему первоначальному состоянию до получения ссылок.
Это доказывает, что ссылочный граф Гугла обладает долгосрочной памятью; как только голос отдан, его эхо продолжает давать вес еще долгое время после того, как источник исчез.
Этот механизм — палка о двух концах, и его нужно использовать для защиты.
Та же самая устойчивость относится и к токсичным или нелегитимным ссылкам.
Негативный футпринт из плохого ссылочного окружения может оставаться месяцами или даже годами, играя против вашего домена еще долго после того, как ссылки были удалены или дизавуированы.
Вы должны исходить из того, что любой ссылочный сигнал, положительный или отрицательный, является практически вечным.
#LinkEquity #ToxicLinks #Experiments
@MikeBlazerX
☠️ Black Hat — в @MikeBlazerPRO
"Ссылочное эхо" — это не просто теория; это устойчивый артефакт алгоритма, который Рэнд Фишкин наблюдал в каждом проведенном им ссылочном тесте, раскрывает Эдвард Штурм.
В восьми отдельных экспериментах, где мы могли изолировать переменные, выхлоп был один и тот же: мы направляли ссылки на цель, позиции росли, мы удаляли ссылки, а позиции оставались в топе.
Это не был краткосрочный эффект-призрак; высокие позиции держались много месяцев, в одном случае — более 4,5 месяцев после удаления.
В фундаментальном тесте
Moz один сайт взлетел с 31-й на 1-ю позицию после получения 22 ссылок.Когда все 22 ссылки были удалены, сайт остался на 1-й позиции.
Ни в одном тесте позиции никогда не откатывались к своему первоначальному состоянию до получения ссылок.
Это доказывает, что ссылочный граф Гугла обладает долгосрочной памятью; как только голос отдан, его эхо продолжает давать вес еще долгое время после того, как источник исчез.
Этот механизм — палка о двух концах, и его нужно использовать для защиты.
Та же самая устойчивость относится и к токсичным или нелегитимным ссылкам.
Негативный футпринт из плохого ссылочного окружения может оставаться месяцами или даже годами, играя против вашего домена еще долго после того, как ссылки были удалены или дизавуированы.
Вы должны исходить из того, что любой ссылочный сигнал, положительный или отрицательный, является практически вечным.
#LinkEquity #ToxicLinks #Experiments
@MikeBlazerX
☠️ Black Hat — в @MikeBlazerPRO
❤8😁8🆒1
Данные экспериментов: текст в параграфах важнее для ранжирования, чем заголовки H2-H3
На основе данных из более чем 400 контролируемых экспериментов была выстроена иерархия он-пейдж факторов ранжирования на основе чисто математического подхода.
Эта
Самые весомые он-пейдж элементы (HTML теги), в порядке убывания важности:
1.
2.
3.
4.
5.
Ключевой и часто упускаемый из виду инсайт — это высокая ценность контента в тегах
Это говорит о том, что, хотя подзаголовки и задают структуру, основной текст является более значимым сигналом.
Практическое применение: сначала создавайте мощную структуру с четкими тайтлами и подзаголовками.
Это даст хорошо структурированный контент, который потом потребует лишь незначительных правок для оптимизации.
Сообщается, что эта модель оптимизации, основанная на данных, работает еще эффективнее в текущем AI-ландшафте поисковых систем.
https://seobymarta.com/blog/math-behind-rankings-interview-with-kyle-roof/
#OnPage #Experiments #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
На основе данных из более чем 400 контролируемых экспериментов была выстроена иерархия он-пейдж факторов ранжирования на основе чисто математического подхода.
Эта
data-driven модель бросает вызов популярному мифу "контент — король", утверждая, что сначала нужно удовлетворить математические требования алгоритма, чтобы у контента вообще был шанс ранжироваться.Самые весомые он-пейдж элементы (HTML теги), в порядке убывания важности:
1.
title2.
H13.
p4.
H2-H35.
URLКлючевой и часто упускаемый из виду инсайт — это высокая ценность контента в тегах
p, который, как показывают данные, имеет больший вес, чем подзаголовки H2-H3.Это говорит о том, что, хотя подзаголовки и задают структуру, основной текст является более значимым сигналом.
Практическое применение: сначала создавайте мощную структуру с четкими тайтлами и подзаголовками.
Это даст хорошо структурированный контент, который потом потребует лишь незначительных правок для оптимизации.
Сообщается, что эта модель оптимизации, основанная на данных, работает еще эффективнее в текущем AI-ландшафте поисковых систем.
https://seobymarta.com/blog/math-behind-rankings-interview-with-kyle-roof/
#OnPage #Experiments #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
😁5🤷♂4❤2
Генеришь контент через ИИ → получаешь траф → вылетаешь из выдачи через три месяца.
Мы видели это в собственном эксперименте:
— 20 свежих сайтов
— 2000 сгенерированных ИИ статей
— ноль редактуры человеком
всего за 36 дней:
— 71% страниц зашли в индекс
— 8 сайтов ранжировались по 1000+ ключам каждый
—
— 5 сайтов зашли в топ-30 по 30% своих ключей
Итог: ни траста, ни
И все равно контент ранжировался и приносил траф.
Что произошло через три месяца?
Ни одна статья не осталась в топ-100.
Они исчезли, будто их никогда не было.
Почему?
Ты уже знаешь ответ: ноль траста, ноль
Мы не делали SEO.
Это был просто паблишинг контента.
И в этом проблема большинства тулзов для "автоматизации SEO".
Тулзы, которые обещают автоматизировать твое SEO — это просто генераторы контента.
Да, некоторые умеют в аутрич, некоторые могут обновить пост в блоге.
Но я сильно сомневаюсь в их способности выстроить реальную стратегию вдолгую, адаптировать ее и эффективно внедрить, пишет Богдан Бабяк.
#AIContent #Experiments #EEAT
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Мы видели это в собственном эксперименте:
— 20 свежих сайтов
— 2000 сгенерированных ИИ статей
— ноль редактуры человеком
всего за 36 дней:
— 71% страниц зашли в индекс
— 8 сайтов ранжировались по 1000+ ключам каждый
—
122K показов и более 240 кликов в сумме— 5 сайтов зашли в топ-30 по 30% своих ключей
Итог: ни траста, ни
E-E-A-T, ни одного сигнала, который Гугл называет важным.И все равно контент ранжировался и приносил траф.
Что произошло через три месяца?
Ни одна статья не осталась в топ-100.
Они исчезли, будто их никогда не было.
Почему?
Ты уже знаешь ответ: ноль траста, ноль
E-E-A-T, ноль реального SEO-фундамента.Мы не делали SEO.
Это был просто паблишинг контента.
И в этом проблема большинства тулзов для "автоматизации SEO".
Тулзы, которые обещают автоматизировать твое SEO — это просто генераторы контента.
Да, некоторые умеют в аутрич, некоторые могут обновить пост в блоге.
Но я сильно сомневаюсь в их способности выстроить реальную стратегию вдолгую, адаптировать ее и эффективно внедрить, пишет Богдан Бабяк.
#AIContent #Experiments #EEAT
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

🤣9❤4💯3🌚2
SEO-сплит-тесты выносят интуицию и доказывают рост трафика
"Добавь ключи в тайтлы", "пиши длинные тексты", "ставь внутренние ссылки" — все повторяют это без пруфов под конкретный сайт.
Сплит-тесты показывают, что реально двигает метрику.
Фреймворк включает точные шаги по шести направлениям:
Определи гипотезы для теста: структура
Сегментируй страницы для теста — критическое условие: урлы должны совпадать по структуре, трафику и типу.
Нормальная сегментация: 100 карточек товаров на одном шаблоне.
Мусорная сегментация: микс товаров, блоговых статей и категорий.
Внедряй строго ОДНО контролируемое изменение.
Перепишешь сразу тайтлы и мета-дески — не поймешь, что именно дало выхлоп.
Измеряй статзначимость через жесткие рамки: минимум 4 недели, от 50 страниц на группу (лучше 100+), уровень доверия 95%, делай поправку на сезонность, мониторь внешние факторы типа кор-апдейтов.
Раскатывай победителей на весь сайт: документируй успешный вариант, применяй к похожим пулам страниц, зашивай в шаблоны для нового контента.
Стакай тесты последовательно, чтобы генерить сложный процент роста.
Тест тайтлов показывает механику.
Гипотеза: добавление года "2026" в тайтлы повышает
Контрольная группа: 250 статей со старыми тайтлами.
Тестовая группа: 250 статей с припиской "2026".
Обе группы имели схожий траф, один тип контента, опубликованы в один период.
Тест шел 4 недели.
Результаты: контрольная группа +2.3% органики (естественные колебания); тестовая группа +34.7% органики.
Статзначимость: 98.5%.
Победитель: добавление "2026".
Выкатили на 1500+ похожих страниц — получили +28% трафика по всему сайту.
Инструменты:
Процесс всегда важнее тулзов.
Сконфигурируй последовательные тесты для кратного роста:
Месяц 1 — оптимизация тайтлов (+34%),
Месяц 2 — смена схемы перелинковки (+18%),
Месяц 3 — внедрение микроразметки (+12%),
Месяц 4 — реструктуризация контента (+22%) = экспоненциальный рост, а не линейный.
Успешные тесты на сегодня:
— длина тайтла (55 символов против 70),
— тайтлы-вопросы против утверждений,
— цифры в листиклах (10 против 15 против 20),
— глубина контента (1500 против 3000 слов),
— внутренние ссылки на страницу (3 против 7),
— размещение ключей в
Ошибки тестирования, которые нужно вычистить: выборка меньше 30 страниц, длительность меньше 3 недель, тест нескольких переменных разом, игнор сезонности, отказ от валидации статзначимости, подгонка результатов, выкатка до финальной проверки.
Внешние факторы несут реальный риск — любой тест во время апдейта алгоритма летит в мусор из-за искажений.
Колебания позиций из-за смены тайтлов могут быть просто штормом выдачи.
Некоторые внедрения не поддаются сплит-тестам: прокачка траста домена, ускорение всего сайта, миграция, жесткие апдейты алгоритма — тут юзай анализ "до/после" по бенчмаркам контрольной группы.
Инсайты SEO-комьюнити
— Сплит-тесты во время апдейтов алгоритма ловят искажения. Изменение позиций, приписанное смене тайтла, может отражать перетасовку выдачи Гуглом, а не влияние твоей переменной. Контрольные группы решают в шумной среде — они изолируют твои внедрения от платформенной волатильности.
#ABTesting #Experiments #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
"Добавь ключи в тайтлы", "пиши длинные тексты", "ставь внутренние ссылки" — все повторяют это без пруфов под конкретный сайт.
Сплит-тесты показывают, что реально двигает метрику.
Фреймворк включает точные шаги по шести направлениям:
Определи гипотезы для теста: структура
title tag, мета-дески, длина контента, схемы перелинковки, иерархия заголовков, внедрение микроразметки, скорость загрузки.Сегментируй страницы для теста — критическое условие: урлы должны совпадать по структуре, трафику и типу.
Нормальная сегментация: 100 карточек товаров на одном шаблоне.
Мусорная сегментация: микс товаров, блоговых статей и категорий.
Внедряй строго ОДНО контролируемое изменение.
Перепишешь сразу тайтлы и мета-дески — не поймешь, что именно дало выхлоп.
Измеряй статзначимость через жесткие рамки: минимум 4 недели, от 50 страниц на группу (лучше 100+), уровень доверия 95%, делай поправку на сезонность, мониторь внешние факторы типа кор-апдейтов.
Раскатывай победителей на весь сайт: документируй успешный вариант, применяй к похожим пулам страниц, зашивай в шаблоны для нового контента.
Стакай тесты последовательно, чтобы генерить сложный процент роста.
Тест тайтлов показывает механику.
Гипотеза: добавление года "2026" в тайтлы повышает
CTR.Контрольная группа: 250 статей со старыми тайтлами.
Тестовая группа: 250 статей с припиской "2026".
Обе группы имели схожий траф, один тип контента, опубликованы в один период.
Тест шел 4 недели.
Результаты: контрольная группа +2.3% органики (естественные колебания); тестовая группа +34.7% органики.
Статзначимость: 98.5%.
Победитель: добавление "2026".
Выкатили на 1500+ похожих страниц — получили +28% трафика по всему сайту.
Инструменты:
Google Optimize для он-пейдж тестов, SearchPilot для SEO-сплит-тестов, SplitSignal для инфраструктуры.Процесс всегда важнее тулзов.
Сконфигурируй последовательные тесты для кратного роста:
Месяц 1 — оптимизация тайтлов (+34%),
Месяц 2 — смена схемы перелинковки (+18%),
Месяц 3 — внедрение микроразметки (+12%),
Месяц 4 — реструктуризация контента (+22%) = экспоненциальный рост, а не линейный.
Успешные тесты на сегодня:
— длина тайтла (55 символов против 70),
— тайтлы-вопросы против утверждений,
— цифры в листиклах (10 против 15 против 20),
— глубина контента (1500 против 3000 слов),
— внутренние ссылки на страницу (3 против 7),
— размещение ключей в
H2, влияние разметки FAQ.Ошибки тестирования, которые нужно вычистить: выборка меньше 30 страниц, длительность меньше 3 недель, тест нескольких переменных разом, игнор сезонности, отказ от валидации статзначимости, подгонка результатов, выкатка до финальной проверки.
Внешние факторы несут реальный риск — любой тест во время апдейта алгоритма летит в мусор из-за искажений.
Колебания позиций из-за смены тайтлов могут быть просто штормом выдачи.
Некоторые внедрения не поддаются сплит-тестам: прокачка траста домена, ускорение всего сайта, миграция, жесткие апдейты алгоритма — тут юзай анализ "до/после" по бенчмаркам контрольной группы.
Инсайты SEO-комьюнити
— Сплит-тесты во время апдейтов алгоритма ловят искажения. Изменение позиций, приписанное смене тайтла, может отражать перетасовку выдачи Гуглом, а не влияние твоей переменной. Контрольные группы решают в шумной среде — они изолируют твои внедрения от платформенной волатильности.
#ABTesting #Experiments #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
🤣6❤2
Мы начали отдавать
Мы протестировали один сабфолдер и взяли под контроль максимум переменных.
Мы просто переформатировали страницы в структурированный
• Видимость в
• Органика на тестовых страницах дала +4.5% кликов (остальной сайт показал -1.1% за тот же период)
• 122 ключа поднялись с нулевого присутствия в
• Раздел с самым большим приростом выстрелил от почти нулевой видимости до почти
Показатели остального сайта остались на месте, а общее количество
Выборка пока не огромная, но ранний сигнал предельно ясен.
Инсайты SEO-комьюнити
— Стратегия с
#AIOverviews #LLM #Experiments
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
markdown-страницы LLM-кам и поисковикам 3 апреля, делится Глен МакМюррей.Мы протестировали один сабфолдер и взяли под контроль максимум переменных.
Мы просто переформатировали страницы в структурированный
Markdown и отдали их известным ИИ-ботам.• Видимость в
AIO выросла на +34%• Органика на тестовых страницах дала +4.5% кликов (остальной сайт показал -1.1% за тот же период)
• 122 ключа поднялись с нулевого присутствия в
AIO до получения ранжирующегося урла• Раздел с самым большим приростом выстрелил от почти нулевой видимости до почти
8x в AIOПоказатели остального сайта остались на месте, а общее количество
AIO-ответов по нашим ключам почти не изменилось.Выборка пока не огромная, но ранний сигнал предельно ясен.
Инсайты SEO-комьюнити
— Стратегия с
markdown-эндпоинтами привносит неопределенность с дублями контента: заявленные правила Google запрещают дубли между HTML и markdown-вариантами; внедряющие спорят, нужно ли закрывать пути .md в robots.txt или же разницы форматов достаточно для разделения эндпоинтов. Требуется верификация краулинга — после выкатки рекомендуется проверять логи сервера на предмет того, как краулер обходит markdown-страницы.#AIOverviews #LLM #Experiments
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

🤔6😁4❤1
Я попросила ИИ предсказать, какой из 48 тестов выиграет или проиграет, ... и сравнила с реальными результатами, рассказывает Люсия ван ден Бринк.
1) Промпт, который я использовала:
2) Я выгрузила данные из
Просто первая попытка ради интереса.
В подкасте с 15+ млн подписчиков сказали, что ИИ "хорошо предсказывает эксперименты", поэтому я захотела проверить.
Жаль, что с дизайнами не вышло.
Впереди новые попытки.
Инсайты комьюнити
— Прогнозы результатов тестов от ИИ на малых выборках находятся в пределах статистического шума: точность 48-62.5% попадает в доверительный интервал 35.9-64.1%. Это означает, что предсказательную силу ограничивает размер выборки, а не возможности модели.
#AI #ABTesting #Experiments
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Claude ⬩Угадал на 62.5% -- не смог посмотреть скриншоты/дизайны по ссылкамChatGPT ⬩Угадал на 58% -- не смог посмотреть скриншоты/дизайны по ссылкамGemini ⬩Угадал на 48% -- не смог посмотреть скриншоты/дизайны по ссылкам1) Промпт, который я использовала:
I want to see how good you are with guessing which test won and which test lost. Analyze the 48 tests here, and their data. Look at the designs (control) and (variant), and all the fields like hypothesis, research and priotization - let me know if you can follow those links and see the images. Then add a colom to this Google Sheet saying if you think it was a win or a loss.
2) Я выгрузила данные из
Airtable для одного сайта, скриншоты были добавлены ссылками.Просто первая попытка ради интереса.
В подкасте с 15+ млн подписчиков сказали, что ИИ "хорошо предсказывает эксперименты", поэтому я захотела проверить.
Жаль, что с дизайнами не вышло.
Впереди новые попытки.
Инсайты комьюнити
— Прогнозы результатов тестов от ИИ на малых выборках находятся в пределах статистического шума: точность 48-62.5% попадает в доверительный интервал 35.9-64.1%. Это означает, что предсказательную силу ограничивает размер выборки, а не возможности модели.
#AI #ABTesting #Experiments
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

🤣2
Фейковые факторы ранжирования вскрывают порог шума, который игнорирует большинство анализов апдейтов Google
Запусти анализ апдейта без плацебо — и он найдет сигналы в спам-апдейте августа 2026 года.
Он с таким же успехом найдет их на неделе, когда Google вообще ничего не делал, и в результатах не будет ничего, что отличало бы эти два сценария.
Контрольная группа — это набор намеренно фейковых атрибутов, прогнанных через скоринг: они звучат правдоподобно, структурно идентичны реальным, но за ними нет никакого механизма.
Частота, с которой система "обнаруживает" их движение — это и есть порог шума.
Каждая реальная находка дисконтируется на эту величину.
Второй контрольный механизм — парное сравнение страниц.
Внутри каждого кластера запросов система сталкивает победителя с проигравшим, конкурента с конкурентом и анализирует полезные аномалии: две страницы на одном домене (с AI-проверкой на каннибализацию), где одна просела или выросла, а другая — нет.
Все доменные факторы взаимоуничтожаются, поэтому то, что остается в дельте — это чисто страничные сигналы по определению.
У такого подхода есть цена.
Траст сайта внутри пар на одном домене остается почти константой еще до поступления данных, поэтому нулевое влияние авторитета может оказаться следствием самого дизайна пар, а не реальным открытием.
Прежде чем делать выводы из нулей, доверительный интервал нужно дробить по типам пар.
Скоринг сворачивает отдельные атрибуты в семейства, потому что шум на уровне одного сигнала бьет по статистике слишком жестко.
Колебание одного атрибута — это шум; когда целое семейство кренится в одном направлении на тысячах парных сравнений — это уже апдейт.
База запросов подчиняется той же дисциплине: сгруппированные кластеры с языковыми вариантами.
В итоге тип интента и рынок фиксируются как управляемые переменные, а не как случайности.
Сравни транзакционный
Два дня чистого времени в терминале на сборку.
Первый прогон: 15 тысяч запросов, 7 языков с упором на английский, около $5,000 на токены и
Всё это скорится по слитому корпусу атрибутов
Категории
Отдельные глубокие аудиты связывают львиную долю этих просадок с переспамленными
Семейства атрибутов, которые отделили победителей от проигравших:
— Насколько точно страница попадает в запрос
— Общая релевантность
— Ссылки, ведущие непосредственно на страницу
— Тип страницы
— Текст анкоров
Семейства, которые не пробили порог шума:
— Траст сайта
— Структура и форматирование страницы
— Свежесть контента
— Динамика ссылочного
— Язык
Это не финальный вердикт по факторам ранжирования.
Конкретно в этом датасете и во время этого апдейта данные семейства не смогли отделить растущие страницы от падающих настолько сильно, чтобы пробить скорректированный на плацебо порог.
Датасет еще сырой: базу запросов нужно увеличить в 30 раз, прежде чем несколько семейств выйдут из доверительного интервала С-класса, а некоторые колебания почти наверняка всё еще сидят в зоне плацебо.
Методология опубликована полностью.
Главный барьер для входа — это слитая карта атрибутов, историческая глубина
Инсайты комьюнити
— Гипотеза: на фоне этого же апдейта выбор цитаций для
#CoreUpdates #Experiments #Analytics
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Запусти анализ апдейта без плацебо — и он найдет сигналы в спам-апдейте августа 2026 года.
Он с таким же успехом найдет их на неделе, когда Google вообще ничего не делал, и в результатах не будет ничего, что отличало бы эти два сценария.
Контрольная группа — это набор намеренно фейковых атрибутов, прогнанных через скоринг: они звучат правдоподобно, структурно идентичны реальным, но за ними нет никакого механизма.
Частота, с которой система "обнаруживает" их движение — это и есть порог шума.
Каждая реальная находка дисконтируется на эту величину.
Второй контрольный механизм — парное сравнение страниц.
Внутри каждого кластера запросов система сталкивает победителя с проигравшим, конкурента с конкурентом и анализирует полезные аномалии: две страницы на одном домене (с AI-проверкой на каннибализацию), где одна просела или выросла, а другая — нет.
Все доменные факторы взаимоуничтожаются, поэтому то, что остается в дельте — это чисто страничные сигналы по определению.
У такого подхода есть цена.
Траст сайта внутри пар на одном домене остается почти константой еще до поступления данных, поэтому нулевое влияние авторитета может оказаться следствием самого дизайна пар, а не реальным открытием.
Прежде чем делать выводы из нулей, доверительный интервал нужно дробить по типам пар.
Скоринг сворачивает отдельные атрибуты в семейства, потому что шум на уровне одного сигнала бьет по статистике слишком жестко.
Колебание одного атрибута — это шум; когда целое семейство кренится в одном направлении на тысячах парных сравнений — это уже апдейт.
База запросов подчиняется той же дисциплине: сгруппированные кластеры с языковыми вариантами.
В итоге тип интента и рынок фиксируются как управляемые переменные, а не как случайности.
Сравни транзакционный
SERP казино с информационным SERP по рецептам — и ты замеришь разницу в интенте, а не алгоритм.Два дня чистого времени в терминале на сборку.
Первый прогон: 15 тысяч запросов, 7 языков с упором на английский, около $5,000 на токены и
API-запросы.Всё это скорится по слитому корпусу атрибутов
Content Warehouse, разбитому на сотни конкретных сигналов.Категории
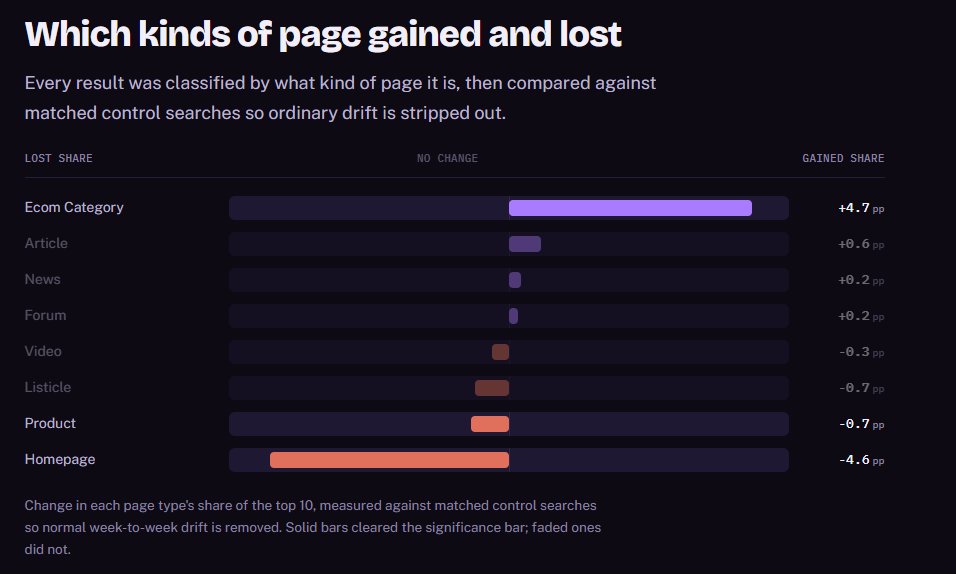
e-commerce подросли, тогда как главные страницы и листиклы просели, а объем бэклинков и сырой DR потеряли в весе — такая переоценка ссылочного происходит почти каждый апдейт, хотя на этот раз падение оказалось аномальным.Отдельные глубокие аудиты связывают львиную долю этих просадок с переспамленными
exact-match анкорами, ведущими прямо на мани-страницы.Семейства атрибутов, которые отделили победителей от проигравших:
— Насколько точно страница попадает в запрос
— Общая релевантность
— Ссылки, ведущие непосредственно на страницу
— Тип страницы
— Текст анкоров
Семейства, которые не пробили порог шума:
— Траст сайта
— Структура и форматирование страницы
— Свежесть контента
— Динамика ссылочного
— Язык
Это не финальный вердикт по факторам ранжирования.
Конкретно в этом датасете и во время этого апдейта данные семейства не смогли отделить растущие страницы от падающих настолько сильно, чтобы пробить скорректированный на плацебо порог.
Датасет еще сырой: базу запросов нужно увеличить в 30 раз, прежде чем несколько семейств выйдут из доверительного интервала С-класса, а некоторые колебания почти наверняка всё еще сидят в зоне плацебо.
Методология опубликована полностью.
Главный барьер для входа — это слитая карта атрибутов, историческая глубина
SERP и готовность сжигать минимум пять тысяч баксов каждый апдейт просто ради того, чтобы выяснить, где ты ошибся.Инсайты комьюнити
— Гипотеза: на фоне этого же апдейта выбор цитаций для
AI Overviews сместился в сторону сайтов с высоким DR за счет более тесной привязки к Gemini — по сути, получилась pay-to-play модель цитирования.#CoreUpdates #Experiments #Analytics
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
👎2
Тесты OtterlyAI фиксируют рост ИИ-цитирования на 31.5% при обновлении даты — но контрольная группа ломает вывод
Обновление даты "
Это опровергает опубликованное в июне заявление о том, что смена даты ничего не дает, при этом сама корректировка идет с жесткими граничными условиями.
Даты изменили 4 августа, замеры шли по двум равным 30-дневным окнам до и после:
— Обработанные страницы: 4,800 → 6,312 цитирований
— Контрольные страницы: 358 → 320 цитирований
— 7 из 10 страниц ушли в плюс
— Если исключить самую крупную страницу, остальные девять всё равно выросли на 30.4%
Именно 30.4% — та цифра, которой стоит верить.
Усредненный показатель может означать, что у одной страницы просто был удачный месяц.
Общая цифра скрывает разбивку по движкам:
—
—
—
—
—
—
Изначальная механика всё еще работает на уровне
Ошибка сидит на один этап раньше.
Извлечение решает, попадет ли страница в пул кандидатов вообще.
Страница, датированная 2024 годом, конкурирует с источниками за 2026 год по саб-запросу, требующему текущего года, а саб-запрос, который не извлек страницу, не сможет ее отранжировать.
Любое вмешательство в поле даты упирается в два ограничения.
Контрольная группа состоит всего из двух страниц, что не позволяет отделить эффект теста от естественного дрейфа сайта, к тому же
Механика извлечения звучит правдоподобно; но никто ее не доказал.
Июльский эксперимент самих
Добавление 2026 года в одиннадцать тайтлов в том же блоге показало +56% и +61%, пока не выяснилось, что нетронутая страница выросла на 63%.
Громкий заголовок рассыпался при контакте с контрольной группой.
Железобетонный ответ для любого сайта требует:
— Двадцать страниц с видимой датой 2024 или 2025 против десяти контрольных
— Фиксированный набор промптов, который парсится трижды в день в течение пяти дней до и тридцати дней после
— Минимум два движка
— Заранее прописанное правило остановки теста
Публикуйте распределение между тестовой и контрольной группой, а не просто процент для заголовка.
#Experiments #AIOverviews #ContentFreshness
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Обновление даты "
last updated" на десяти статьях блога OtterlyAI без единой правки текста спровоцировало рост ИИ-цитирований на 31.5%, тогда как две контрольные страницы просели на 10.6%.Это опровергает опубликованное в июне заявление о том, что смена даты ничего не дает, при этом сама корректировка идет с жесткими граничными условиями.
Даты изменили 4 августа, замеры шли по двум равным 30-дневным окнам до и после:
— Обработанные страницы: 4,800 → 6,312 цитирований
— Контрольные страницы: 358 → 320 цитирований
— 7 из 10 страниц ушли в плюс
— Если исключить самую крупную страницу, остальные девять всё равно выросли на 30.4%
Именно 30.4% — та цифра, которой стоит верить.
Усредненный показатель может означать, что у одной страницы просто был удачный месяц.
Общая цифра скрывает разбивку по движкам:
—
Claude: +983 цитирования (+87%)—
Perplexity: +217%—
ChatGPT: +692%, с базовой отметки в 37—
Google AI Overviews: +15%—
Google AI Mode: -20%—
Gemini: -37%Изначальная механика всё еще работает на уровне
passage ranking: ИИ-системы сравнивают текст, который они читают сейчас, с тем, что они видели раньше, и новая дата на старом тексте там ничего не дает.Ошибка сидит на один этап раньше.
Извлечение решает, попадет ли страница в пул кандидатов вообще.
Страница, датированная 2024 годом, конкурирует с источниками за 2026 год по саб-запросу, требующему текущего года, а саб-запрос, который не извлек страницу, не сможет ее отранжировать.
Любое вмешательство в поле даты упирается в два ограничения.
Контрольная группа состоит всего из двух страниц, что не позволяет отделить эффект теста от естественного дрейфа сайта, к тому же
OtterlyAI заявляет, что не отслеживал веерные запросы, стоящие за этими цитатами.Механика извлечения звучит правдоподобно; но никто ее не доказал.
Июльский эксперимент самих
OtterlyAI — отличный пример для осторожности.Добавление 2026 года в одиннадцать тайтлов в том же блоге показало +56% и +61%, пока не выяснилось, что нетронутая страница выросла на 63%.
Громкий заголовок рассыпался при контакте с контрольной группой.
Железобетонный ответ для любого сайта требует:
— Двадцать страниц с видимой датой 2024 или 2025 против десяти контрольных
— Фиксированный набор промптов, который парсится трижды в день в течение пяти дней до и тридцати дней после
— Минимум два движка
— Заранее прописанное правило остановки теста
Публикуйте распределение между тестовой и контрольной группой, а не просто процент для заголовка.
#Experiments #AIOverviews #ContentFreshness
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤1
Слепой тест ИИ-гуманизаторов фиксирует от 18 до 120 искажений смысла — тулзы переписывают бизнес-обязательства
Базовый промпт "
Тулзы для гуманизации текста выдумывают факты, добавляют или выкидывают обязательства, и в клиентских коммуникациях это несет юридические риски.
Еще два провала из тех же тестов:
—
—
Он переписывает текст простым человеческим языком, жестко сохраняя все заложенные обязательства.
Если не хватает факта, который знает только автор, он переспрашивает, а не придумывает отсебятину.
Для установки вбейте
Все результаты скоринга, вердикты и фактчеки лежат в репозитории.
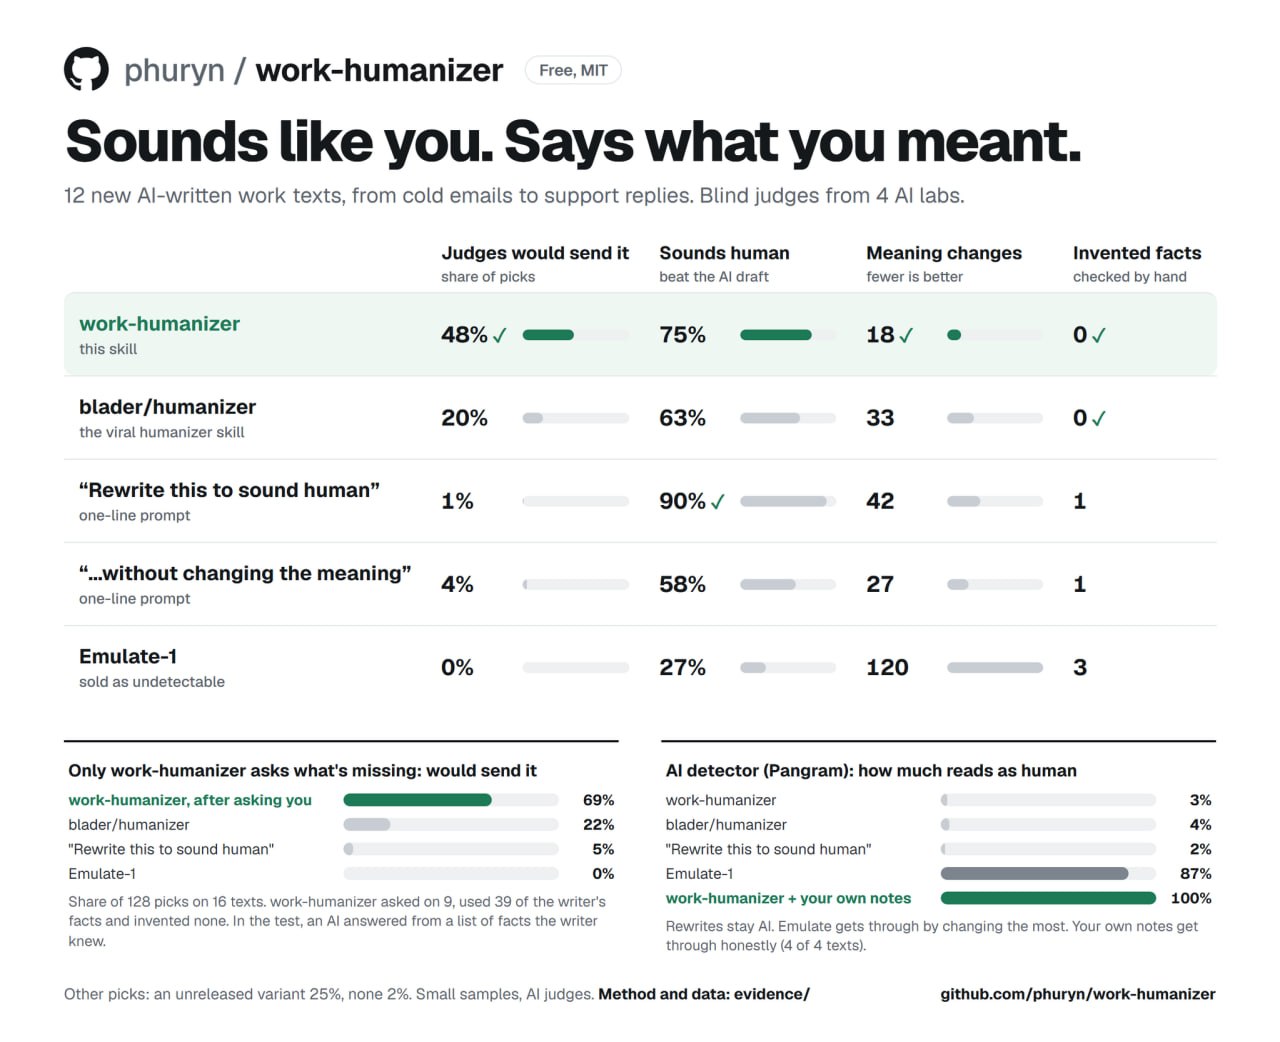
Слепой бенчмарк прогнал 12 новых рабочих текстов через 4 ИИ-судей от 4 разных лабораторий.
Судьи видели исходный интент автора и выбирали ту версию, которую отправили бы сами.
Процент выбора и количество искажений смысла:
—
—
— "Rewrite this to sound human, without changing the meaning": 4%, 27
— "
—
Поскольку автор сам написал скилл и спроектировал тест, судей тоже проверили.
Двое судей, использованных при разработке, выбрали его в 23 из 48 случаев, и оставшиеся двое — тоже 23 из 48.
Все цифры получены на прогонах
Результат детектора показывает реальную цену обещания "
В
На бенчмарках единственным гуманизатором, обошедшим детектор, оказался тот, который больше всего ломал суть.
Когда я загрузил в
#AI #PromptEngineering #Experiments
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Базовый промпт "
rewrite this to sound human" сообщил клиенту, что его возврат на £45 уже прошел — хотя в оригинале было "we're refunding".Тулзы для гуманизации текста выдумывают факты, добавляют или выкидывают обязательства, и в клиентских коммуникациях это несет юридические риски.
Еще два провала из тех же тестов:
—
Emulate-1, который продается как "undetectable", снес дедлайн для отмены подписки до автопродления.—
blader/humanizer, собравший 55K звезд, извинился перед клиентом за удержание депозита, хотя компания считала это правомерным. В спорной ситуации такое извинение читается как признание вины.work-humanizer — скилл под MIT-лицензией, вышедший уже в шестой итерации.Он переписывает текст простым человеческим языком, жестко сохраняя все заложенные обязательства.
Если не хватает факта, который знает только автор, он переспрашивает, а не придумывает отсебятину.
Для установки вбейте
npx skills add phuryn/work-humanizer, а затем промпт: Use work-humanizer on this: <paste text>.Все результаты скоринга, вердикты и фактчеки лежат в репозитории.
Слепой бенчмарк прогнал 12 новых рабочих текстов через 4 ИИ-судей от 4 разных лабораторий.
Судьи видели исходный интент автора и выбирали ту версию, которую отправили бы сами.
Процент выбора и количество искажений смысла:
—
work-humanizer: 48%, 18—
blader/humanizer: 20%, 33— "Rewrite this to sound human, without changing the meaning": 4%, 27
— "
Rewrite this to sound human": 1%, 42—
Emulate-1: 0%, 120Поскольку автор сам написал скилл и спроектировал тест, судей тоже проверили.
Двое судей, использованных при разработке, выбрали его в 23 из 48 случаев, и оставшиеся двое — тоже 23 из 48.
Все цифры получены на прогонах
Opus 5.5; другие агенты заявлены как совместимые, но бенчмарков по ним нет.Результат детектора показывает реальную цену обещания "
undetectable".В
Pangram проскочил только Emulate-1, и он исказил смысл сильнее всех.На бенчмарках единственным гуманизатором, обошедшим детектор, оказался тот, который больше всего ломал суть.
Pangram оценивает структуру логики, а не выбор слов.Когда я загрузил в
work-humanizer собственные наработки как вводные данные, 4 из 4 текстов набрали 100% human-score, фиксирует Павел Хурин.#AI #PromptEngineering #Experiments
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO