📊 Как Google AI Mode структурирует свои ответы?
Вот что я нарыл, пишет Адриан Скоурон.
Все говорят об оптимизации под
Но прежде чем оптимизировать, вы вообще знаете, как выглядит выхлоп
Я разобрал реальные аутпуты
Вот как
— Жирный текст — 99.2% ответов.
— Цитаты — 99.1% ответов (в среднем 23.7 на ответ).
— Маркированные списки (Bullets) — 97.3% ответов.
— Нумерованные списки — 30.5% ответов.
— Таблицы — 24.1% ответов.
— Изображения — 17.9% ответов.
— Товарные карточки (Shopping): 17.2% ответов. Это интересно, особенно в контексте нового протокола
Что бросается в глаза:
—
— Жестко юзает жирный шрифт — почти 18 раз за ответ в среднем.
— А цитаты? Более 23 на ответ. Это не игра "победитель получает все". Подтягивается куча источников.
Вопрос, который стоит задать:
— Ваш контент органично ложится в эти паттерны?
— Если
Стоит потестить.
Я пилю тулзу, которая анализирует, насколько ваш контент мэтчится с форматами
Хотите стать ранним тестером?
Стучите в личку или в комменты.
#AIOverviews #SERPAnalysis #ContentOptimization
@MikeBlazerX
Но "мясо" только в @MikeBlazerPRO
Вот что я нарыл, пишет Адриан Скоурон.
Все говорят об оптимизации под
AI Mode.Но прежде чем оптимизировать, вы вообще знаете, как выглядит выхлоп
AI Mode? 🤔Я разобрал реальные аутпуты
AI Mode, чтобы понять паттерны форматирования.Вот как
AI Mode структурирует ответы:— Жирный текст — 99.2% ответов.
— Цитаты — 99.1% ответов (в среднем 23.7 на ответ).
— Маркированные списки (Bullets) — 97.3% ответов.
— Нумерованные списки — 30.5% ответов.
— Таблицы — 24.1% ответов.
— Изображения — 17.9% ответов.
— Товарные карточки (Shopping): 17.2% ответов. Это интересно, особенно в контексте нового протокола
UCP.Что бросается в глаза:
—
AI Mode обожает буллеты, а не цифры (97% против 31%).— Жестко юзает жирный шрифт — почти 18 раз за ответ в среднем.
— А цитаты? Более 23 на ответ. Это не игра "победитель получает все". Подтягивается куча источников.
Вопрос, который стоит задать:
— Ваш контент органично ложится в эти паттерны?
— Если
AI отвечает буллетами, сравнениями и жирными ключевыми поинтами, ваша структура позволяет легко это экстрактить?Стоит потестить.
Я пилю тулзу, которая анализирует, насколько ваш контент мэтчится с форматами
AI Mode и других AI-поисковиков.Хотите стать ранним тестером?
Стучите в личку или в комменты.
#AIOverviews #SERPAnalysis #ContentOptimization
@MikeBlazerX
Но "мясо" только в @MikeBlazerPRO

😁6❤3
Утроение времени на правки человеком двигает AI-контент с 28 на 11 позицию
Я провел аудит 240 статей, сгенерированных ИИ (Claude и GPT-4), которые не ранжировались, пишет Ноэль Сета.
Базовые метрики были четкими: несмотря на среднюю длину 1,800 слов и 20-30 минут человеческой редактуры на материал, контент застрял в среднем на 28-й позиции.
Только 7.5% статей пробились на первую страницу, давая стагнирующие 3,200 сессий/месяц.
Я инициировал систематическую оценку качества, оценивая каждый
Порог <60/80 пометил 187 статей (78%) для немедленного исправления.
Форензик-анализ паттернов вскрыл четыре критических точки отказа в стандартном
— Слабый `E-E-A-T` (82%): Отсутствие ссылок на источники, оригинальных данных или продемонстрированной экспертности автора.
— Слабые примеры (71%): Опора на общие гипотезы ("представьте компанию...") вместо конкретных кейсов.
— Дженерик инфа (68%): Пересказ общеизвестных знаний, неотличимый от конкурентов.
— Отсутствие глубины (64%): Поверхностное покрытие, которое не отвечало на ключевые вопросы юзера.
Чтобы это пофиксить, я развернул фазовый протокол исправления на 12 недель, радикально увеличив инвестиции до 90-120 минут редактуры на статью.
— Инъекция авторитетности: Я обязал ставить 3-5 ссылок на авторитетные источники (исследования, госданные) для каждого утверждения.
— Апгрейд специфичности: Размытые фразы заменили на твердые данные (например, смена "
— Расширение глубины: Я добавил 300-500 слов на статью, включая визуализацию оригинальных данных, отраслевые инсайты и
— Сигналы `E-E-A-T`: Анонимный контент обновили био авторов и контекстом регалий (например, "Based on analysis of 50+ client implementations").
Результаты трекались против контрольной группы из 53 неизменных статей.
Пока контрольная группа стагнировала (Позиция 29 → 27), улучшенная когорта достигла 67% улучшения ранжирования (Позиция 28 → 11) за 5 месяцев.
Органика взорвалась на 288% (с 3,200 до 12,400 сессий/месяц), а ранжирование на первой странице выросло с 18 до 89 статей.
Данные подтверждают, что пока ИИ масштабирует объем, конкурентный перформанс требует 4-кратного увеличения времени на правки человеком.
#AIContent #ContentOptimization #EEAT
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Я провел аудит 240 статей, сгенерированных ИИ (Claude и GPT-4), которые не ранжировались, пишет Ноэль Сета.
Базовые метрики были четкими: несмотря на среднюю длину 1,800 слов и 20-30 минут человеческой редактуры на материал, контент застрял в среднем на 28-й позиции.
Только 7.5% статей пробились на первую страницу, давая стагнирующие 3,200 сессий/месяц.
Я инициировал систематическую оценку качества, оценивая каждый
URL по 8-балльной шкале (0-10), покрывающей Factual Accuracy, Content Depth, Unique Value, User Intent, Structure, E-E-A-T, Technical SEO и Engagement.Порог <60/80 пометил 187 статей (78%) для немедленного исправления.
Форензик-анализ паттернов вскрыл четыре критических точки отказа в стандартном
AI-контенте:— Слабый `E-E-A-T` (82%): Отсутствие ссылок на источники, оригинальных данных или продемонстрированной экспертности автора.
— Слабые примеры (71%): Опора на общие гипотезы ("представьте компанию...") вместо конкретных кейсов.
— Дженерик инфа (68%): Пересказ общеизвестных знаний, неотличимый от конкурентов.
— Отсутствие глубины (64%): Поверхностное покрытие, которое не отвечало на ключевые вопросы юзера.
Чтобы это пофиксить, я развернул фазовый протокол исправления на 12 недель, радикально увеличив инвестиции до 90-120 минут редактуры на статью.
— Инъекция авторитетности: Я обязал ставить 3-5 ссылок на авторитетные источники (исследования, госданные) для каждого утверждения.
— Апгрейд специфичности: Размытые фразы заменили на твердые данные (например, смена "
Many companies struggle" на "According to Gartner's 2024 survey of 500 enterprises...").— Расширение глубины: Я добавил 300-500 слов на статью, включая визуализацию оригинальных данных, отраслевые инсайты и
FAQ схемы.— Сигналы `E-E-A-T`: Анонимный контент обновили био авторов и контекстом регалий (например, "Based on analysis of 50+ client implementations").
Результаты трекались против контрольной группы из 53 неизменных статей.
Пока контрольная группа стагнировала (Позиция 29 → 27), улучшенная когорта достигла 67% улучшения ранжирования (Позиция 28 → 11) за 5 месяцев.
Органика взорвалась на 288% (с 3,200 до 12,400 сессий/месяц), а ранжирование на первой странице выросло с 18 до 89 статей.
Данные подтверждают, что пока ИИ масштабирует объем, конкурентный перформанс требует 4-кратного увеличения времени на правки человеком.
#AIContent #ContentOptimization #EEAT
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
👍8❤2🙈1
Данные экспериментов: текст в параграфах важнее для ранжирования, чем заголовки H2-H3
На основе данных из более чем 400 контролируемых экспериментов была выстроена иерархия он-пейдж факторов ранжирования на основе чисто математического подхода.
Эта
Самые весомые он-пейдж элементы (HTML теги), в порядке убывания важности:
1.
2.
3.
4.
5.
Ключевой и часто упускаемый из виду инсайт — это высокая ценность контента в тегах
Это говорит о том, что, хотя подзаголовки и задают структуру, основной текст является более значимым сигналом.
Практическое применение: сначала создавайте мощную структуру с четкими тайтлами и подзаголовками.
Это даст хорошо структурированный контент, который потом потребует лишь незначительных правок для оптимизации.
Сообщается, что эта модель оптимизации, основанная на данных, работает еще эффективнее в текущем AI-ландшафте поисковых систем.
https://seobymarta.com/blog/math-behind-rankings-interview-with-kyle-roof/
#OnPage #Experiments #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
На основе данных из более чем 400 контролируемых экспериментов была выстроена иерархия он-пейдж факторов ранжирования на основе чисто математического подхода.
Эта
data-driven модель бросает вызов популярному мифу "контент — король", утверждая, что сначала нужно удовлетворить математические требования алгоритма, чтобы у контента вообще был шанс ранжироваться.Самые весомые он-пейдж элементы (HTML теги), в порядке убывания важности:
1.
title2.
H13.
p4.
H2-H35.
URLКлючевой и часто упускаемый из виду инсайт — это высокая ценность контента в тегах
p, который, как показывают данные, имеет больший вес, чем подзаголовки H2-H3.Это говорит о том, что, хотя подзаголовки и задают структуру, основной текст является более значимым сигналом.
Практическое применение: сначала создавайте мощную структуру с четкими тайтлами и подзаголовками.
Это даст хорошо структурированный контент, который потом потребует лишь незначительных правок для оптимизации.
Сообщается, что эта модель оптимизации, основанная на данных, работает еще эффективнее в текущем AI-ландшафте поисковых систем.
https://seobymarta.com/blog/math-behind-rankings-interview-with-kyle-roof/
#OnPage #Experiments #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
😁5🤷♂4❤2
Инъекция сигнала выгоды в тайтл-теги форсирует индексацию
Статус "
Алгоритм успешно обработал
Чтобы форсировать индексацию, дифференцируйте тег
Протокол заменяет стандартные структуры
Этот синтаксис программирует юзера на конкретный результат, сигнализируя алгоритму об уникальной ценности и увеличивая терпение и время на сайте (dwell time) после клика.
Для реализации я скармливаю
— Верх воронки (ToF): Ввод "
— Инфо-запросы: Ввод "
— Низ воронки (BoF): Ввод "Software to reduce patient no-shows" становится
Для
#OnPage #Indexing #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Статус "
Crawled - currently not indexed" — это редко техническая ошибка, это Фильтр Уникальной Ценности.Алгоритм успешно обработал
URL, но отказался хранить его, так как тайтл слишком общий или дублирует текущий инвентарь SERP.Чтобы форсировать индексацию, дифференцируйте тег
title, внедряя явные выгоды для юзера с помощью специального синтаксиса, разделенного вертикальной чертой, советует Эдвард Штурм.Протокол заменяет стандартные структуры
[Ключ] - [Бренд] на трехчастный сигнал ценности: [Целевой Ключ] | [Явная выгода или Цель поиска] | [Бренд].Этот синтаксис программирует юзера на конкретный результат, сигнализируя алгоритму об уникальной ценности и увеличивая терпение и время на сайте (dwell time) после клика.
Для реализации я скармливаю
ChatGPT формулу для генерации конкретных инъекций выгоды.— Верх воронки (ToF): Ввод "
Home renovation ideas" превращается в Home Renovation Ideas | Modern Budget Friendly Inspiration | Havenry. Квалификаторы "Modern" и "Budget Friendly" отстраивают страницу от дженерик-листингов.— Инфо-запросы: Ввод "
Are organic protein bars healthy" трансформируется в Are Organic Protein Bars Healthy | What Nutritionists Recommend | Green Bite. Это задействует авторитет ("Nutritionists Recommend"), чтобы отделить контент от мнений юзеров.— Низ воронки (BoF): Ввод "Software to reduce patient no-shows" становится
Software to Reduce Patient No-Shows | Automated Reminders That Work | Scheduleula.Для
BoF-ключей прямое обращение к болям (напр., "Reminders That Work") выстраивает защитный ров против конкурентов, сразу устанавливая более высокую планку релевантности.#OnPage #Indexing #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
❤2😁2
У Google есть БЕСПЛАТНЫЙ инструмент, который ТОЧНО показывает, как он читает ваш текст.
Эта тулза появилась еще до
Зайдите на https://cloud.google.com/natural-language, проскролльте до блока "
Google покажет:
— Каждую обнаруженную сущность (люди, места, бренды, концепции).
— Показатель
— Категорию, которую он присвоил контенту.
Теперь проделайте то же самое со страницей, которая ранжируется в топ-1 по вашему ключу...
Сравните результаты.
Вы увидите:
— Сущности, которые упоминают они, а вы нет (добавьте их).
— У их главной сущности показатель
— Как Google категоризирует страницы (например, мой текст отнесен к SEO, HowTo/Expert Content, Marketing и Web Design/Dev, а я хочу, чтобы категоризация совпадала с другими страницами из топа).
Можно просто сохранить оба отчета (в HTML или PDF) и скормить ИИ, чтобы он сравнил их и выдал рекомендации!
Здесь Google буквально говорит вам, о чем, по его мнению, ваша страница, и о чем — страница конкурента, который вас обходит.
Разрыв между этими двумя отчетами — это и есть ваш чек-лист для оптимизации контента.
Вам не нужны дорогие подписки, процесс занимает пару минут на страницу, и это максимально близко к тому, чтобы посмотреть на свой контент глазами алгоритма, потому что это И ЕСТЬ собственная
#ContentOptimization #Keywords #NLP
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Эта тулза появилась еще до
ChatGPT, но большинство сеошников даже не открывали ее.Зайдите на https://cloud.google.com/natural-language, проскролльте до блока "
Try the API", вставьте контент страницы и нажмите "Analyze".Google покажет:
— Каждую обнаруженную сущность (люди, места, бренды, концепции).
— Показатель
SALIENCE для каждой (насколько важной Google считает эту сущность для страницы).— Категорию, которую он присвоил контенту.
Теперь проделайте то же самое со страницей, которая ранжируется в топ-1 по вашему ключу...
Сравните результаты.
Вы увидите:
— Сущности, которые упоминают они, а вы нет (добавьте их).
— У их главной сущности показатель
salience равен 0.85, а у вашей 0.3 — нужно упоминать главную тему чаще и ближе к началу текста.— Как Google категоризирует страницы (например, мой текст отнесен к SEO, HowTo/Expert Content, Marketing и Web Design/Dev, а я хочу, чтобы категоризация совпадала с другими страницами из топа).
Можно просто сохранить оба отчета (в HTML или PDF) и скормить ИИ, чтобы он сравнил их и выдал рекомендации!
Здесь Google буквально говорит вам, о чем, по его мнению, ваша страница, и о чем — страница конкурента, который вас обходит.
Разрыв между этими двумя отчетами — это и есть ваш чек-лист для оптимизации контента.
Вам не нужны дорогие подписки, процесс занимает пару минут на страницу, и это максимально близко к тому, чтобы посмотреть на свой контент глазами алгоритма, потому что это И ЕСТЬ собственная
NLP-модель Google.#ContentOptimization #Keywords #NLP
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

1❤20👍4
Схема "Alien-User": сущности в первом абзаце пробивают потолок CTR в Discover до 39%
Для попадания в граф интересов система требует высокой плотности сущностей в заголовке и начале текста.
Телеметрия показывает: загрузка сущностей из Графа Знаний прямо в эти зоны дает точный показатель уверенности для заброса в ленту, отмечает Метехан Ешилюрт.
Короткие кликбейтные тайтлы проваливают фазу мэтчинга.
В них тупо нет сигналов сущностей.
И наоборот, вшивание нескольких явных сущностей в длинные заголовки заставляет алгоритм связывать темы.
Этот структурный сетап пушит предиктивный
Отдельно по мэтчингу локации: семантика текста перебивает физическое расположение сервера.
Алгоритм отдает приоритет сущностям локации, которые стоят прямо в первом предложении.
Чтобы заабузить это, внедряй контекст alien-user.
Относись к читателям как к иностранцам с нулевым знанием географии.
Указывай точный город и штат сразу в первом абзаце.
Эта семантическая привязка пушит локальные истории в международные ленты, когда локация масштабируется до национальных интересов.
#GoogleDiscover #EntitySEO #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Google Discover работает как предиктивный движок без поисковых запросов.Для попадания в граф интересов система требует высокой плотности сущностей в заголовке и начале текста.
Телеметрия показывает: загрузка сущностей из Графа Знаний прямо в эти зоны дает точный показатель уверенности для заброса в ленту, отмечает Метехан Ешилюрт.
Короткие кликбейтные тайтлы проваливают фазу мэтчинга.
В них тупо нет сигналов сущностей.
И наоборот, вшивание нескольких явных сущностей в длинные заголовки заставляет алгоритм связывать темы.
Этот структурный сетап пушит предиктивный
CTR к потолку в 39%, сообщает Джон Шехата.Отдельно по мэтчингу локации: семантика текста перебивает физическое расположение сервера.
Алгоритм отдает приоритет сущностям локации, которые стоят прямо в первом предложении.
Чтобы заабузить это, внедряй контекст alien-user.
Относись к читателям как к иностранцам с нулевым знанием географии.
Указывай точный город и штат сразу в первом абзаце.
Эта семантическая привязка пушит локальные истории в международные ленты, когда локация масштабируется до национальных интересов.
#GoogleDiscover #EntitySEO #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
❤5😁3
Скопированные из Google Ads триггеры бустят кликабельность в органической выдаче
Чтобы выжать максимальный органический
Затем я вшиваю эти заранее проверенные платным трафиком триггеры прямо в органические тайтлы.
Этот сетап меняет сухую техничку с ключами на чистый коммерческий копирайтинг.
Поисковик обрабатывает стандартные
Бобье отмечает, что связка улучшает общую кликабельность, хотя и не называет точных цифр прироста.
#TitleTags #ContentOptimization #CTR
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Чтобы выжать максимальный органический
CTR, я паршу коммерческие выгоды и УТП из топовых кампаний Google Ads, делится Эллиот Бобье.Затем я вшиваю эти заранее проверенные платным трафиком триггеры прямо в органические тайтлы.
Этот сетап меняет сухую техничку с ключами на чистый коммерческий копирайтинг.
Поисковик обрабатывает стандартные
HTML-теги как обычно, но психологические крючки пылесосят трафик у конкурентов по выдаче.Бобье отмечает, что связка улучшает общую кликабельность, хотя и не называет точных цифр прироста.
#TitleTags #ContentOptimization #CTR
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
👍3❤1🎃1
SEO-сплит-тесты выносят интуицию и доказывают рост трафика
"Добавь ключи в тайтлы", "пиши длинные тексты", "ставь внутренние ссылки" — все повторяют это без пруфов под конкретный сайт.
Сплит-тесты показывают, что реально двигает метрику.
Фреймворк включает точные шаги по шести направлениям:
Определи гипотезы для теста: структура
Сегментируй страницы для теста — критическое условие: урлы должны совпадать по структуре, трафику и типу.
Нормальная сегментация: 100 карточек товаров на одном шаблоне.
Мусорная сегментация: микс товаров, блоговых статей и категорий.
Внедряй строго ОДНО контролируемое изменение.
Перепишешь сразу тайтлы и мета-дески — не поймешь, что именно дало выхлоп.
Измеряй статзначимость через жесткие рамки: минимум 4 недели, от 50 страниц на группу (лучше 100+), уровень доверия 95%, делай поправку на сезонность, мониторь внешние факторы типа кор-апдейтов.
Раскатывай победителей на весь сайт: документируй успешный вариант, применяй к похожим пулам страниц, зашивай в шаблоны для нового контента.
Стакай тесты последовательно, чтобы генерить сложный процент роста.
Тест тайтлов показывает механику.
Гипотеза: добавление года "2026" в тайтлы повышает
Контрольная группа: 250 статей со старыми тайтлами.
Тестовая группа: 250 статей с припиской "2026".
Обе группы имели схожий траф, один тип контента, опубликованы в один период.
Тест шел 4 недели.
Результаты: контрольная группа +2.3% органики (естественные колебания); тестовая группа +34.7% органики.
Статзначимость: 98.5%.
Победитель: добавление "2026".
Выкатили на 1500+ похожих страниц — получили +28% трафика по всему сайту.
Инструменты:
Процесс всегда важнее тулзов.
Сконфигурируй последовательные тесты для кратного роста:
Месяц 1 — оптимизация тайтлов (+34%),
Месяц 2 — смена схемы перелинковки (+18%),
Месяц 3 — внедрение микроразметки (+12%),
Месяц 4 — реструктуризация контента (+22%) = экспоненциальный рост, а не линейный.
Успешные тесты на сегодня:
— длина тайтла (55 символов против 70),
— тайтлы-вопросы против утверждений,
— цифры в листиклах (10 против 15 против 20),
— глубина контента (1500 против 3000 слов),
— внутренние ссылки на страницу (3 против 7),
— размещение ключей в
Ошибки тестирования, которые нужно вычистить: выборка меньше 30 страниц, длительность меньше 3 недель, тест нескольких переменных разом, игнор сезонности, отказ от валидации статзначимости, подгонка результатов, выкатка до финальной проверки.
Внешние факторы несут реальный риск — любой тест во время апдейта алгоритма летит в мусор из-за искажений.
Колебания позиций из-за смены тайтлов могут быть просто штормом выдачи.
Некоторые внедрения не поддаются сплит-тестам: прокачка траста домена, ускорение всего сайта, миграция, жесткие апдейты алгоритма — тут юзай анализ "до/после" по бенчмаркам контрольной группы.
Инсайты SEO-комьюнити
— Сплит-тесты во время апдейтов алгоритма ловят искажения. Изменение позиций, приписанное смене тайтла, может отражать перетасовку выдачи Гуглом, а не влияние твоей переменной. Контрольные группы решают в шумной среде — они изолируют твои внедрения от платформенной волатильности.
#ABTesting #Experiments #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
"Добавь ключи в тайтлы", "пиши длинные тексты", "ставь внутренние ссылки" — все повторяют это без пруфов под конкретный сайт.
Сплит-тесты показывают, что реально двигает метрику.
Фреймворк включает точные шаги по шести направлениям:
Определи гипотезы для теста: структура
title tag, мета-дески, длина контента, схемы перелинковки, иерархия заголовков, внедрение микроразметки, скорость загрузки.Сегментируй страницы для теста — критическое условие: урлы должны совпадать по структуре, трафику и типу.
Нормальная сегментация: 100 карточек товаров на одном шаблоне.
Мусорная сегментация: микс товаров, блоговых статей и категорий.
Внедряй строго ОДНО контролируемое изменение.
Перепишешь сразу тайтлы и мета-дески — не поймешь, что именно дало выхлоп.
Измеряй статзначимость через жесткие рамки: минимум 4 недели, от 50 страниц на группу (лучше 100+), уровень доверия 95%, делай поправку на сезонность, мониторь внешние факторы типа кор-апдейтов.
Раскатывай победителей на весь сайт: документируй успешный вариант, применяй к похожим пулам страниц, зашивай в шаблоны для нового контента.
Стакай тесты последовательно, чтобы генерить сложный процент роста.
Тест тайтлов показывает механику.
Гипотеза: добавление года "2026" в тайтлы повышает
CTR.Контрольная группа: 250 статей со старыми тайтлами.
Тестовая группа: 250 статей с припиской "2026".
Обе группы имели схожий траф, один тип контента, опубликованы в один период.
Тест шел 4 недели.
Результаты: контрольная группа +2.3% органики (естественные колебания); тестовая группа +34.7% органики.
Статзначимость: 98.5%.
Победитель: добавление "2026".
Выкатили на 1500+ похожих страниц — получили +28% трафика по всему сайту.
Инструменты:
Google Optimize для он-пейдж тестов, SearchPilot для SEO-сплит-тестов, SplitSignal для инфраструктуры.Процесс всегда важнее тулзов.
Сконфигурируй последовательные тесты для кратного роста:
Месяц 1 — оптимизация тайтлов (+34%),
Месяц 2 — смена схемы перелинковки (+18%),
Месяц 3 — внедрение микроразметки (+12%),
Месяц 4 — реструктуризация контента (+22%) = экспоненциальный рост, а не линейный.
Успешные тесты на сегодня:
— длина тайтла (55 символов против 70),
— тайтлы-вопросы против утверждений,
— цифры в листиклах (10 против 15 против 20),
— глубина контента (1500 против 3000 слов),
— внутренние ссылки на страницу (3 против 7),
— размещение ключей в
H2, влияние разметки FAQ.Ошибки тестирования, которые нужно вычистить: выборка меньше 30 страниц, длительность меньше 3 недель, тест нескольких переменных разом, игнор сезонности, отказ от валидации статзначимости, подгонка результатов, выкатка до финальной проверки.
Внешние факторы несут реальный риск — любой тест во время апдейта алгоритма летит в мусор из-за искажений.
Колебания позиций из-за смены тайтлов могут быть просто штормом выдачи.
Некоторые внедрения не поддаются сплит-тестам: прокачка траста домена, ускорение всего сайта, миграция, жесткие апдейты алгоритма — тут юзай анализ "до/после" по бенчмаркам контрольной группы.
Инсайты SEO-комьюнити
— Сплит-тесты во время апдейтов алгоритма ловят искажения. Изменение позиций, приписанное смене тайтла, может отражать перетасовку выдачи Гуглом, а не влияние твоей переменной. Контрольные группы решают в шумной среде — они изолируют твои внедрения от платформенной волатильности.
#ABTesting #Experiments #ContentOptimization
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
🤣6❤2
Органический трафик растёт?
В нынешней экономике?!
Наша главная директория выросла на 10% по сравнению с прошлым периодом благодаря трём простым недавним улучшениям, делится Эбби Глисон:
1. Обновление контента. Мы обновили 500 страниц с высокой конверсией: добавили свежий блок
2.
3. Редизайн лендингов. Мы обновили очень старый шаблон страницы, чтобы показывать больше релевантной информации в более удобном дизайне. Поведенческие факторы улучшаются с каждым тестом, что в итоге влияет на видимость.
Базовые
Отвечай на вопросы, которые задают люди.
Делай сайт удобным для краулеров.
Улучшай
И рост придёт.
#ContentOptimization #TechnicalSEO #UX
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
В нынешней экономике?!
Наша главная директория выросла на 10% по сравнению с прошлым периодом благодаря трём простым недавним улучшениям, делится Эбби Глисон:
1. Обновление контента. Мы обновили 500 страниц с высокой конверсией: добавили свежий блок
FAQ и улучшили таргетинг по ключам. On-page всё ещё решает — эти апдейты увеличили наш трафик из AI Overviews на 80%.2.
Markdown, ребята!! Команда technical SEO внедрила форматирование Markdown через Cloudflare, чтобы LLM было проще парсить наш контент. Мы увидели немедленный рост видимости.3. Редизайн лендингов. Мы обновили очень старый шаблон страницы, чтобы показывать больше релевантной информации в более удобном дизайне. Поведенческие факторы улучшаются с каждым тестом, что в итоге влияет на видимость.
Базовые
best practice в SEO продолжают работать.Отвечай на вопросы, которые задают люди.
Делай сайт удобным для краулеров.
Улучшай
UX.И рост придёт.
#ContentOptimization #TechnicalSEO #UX
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

✍5❤3
Оригинальность не решает внутри топ-3, а четверть лидеров просто копирует первую страницу
Исследование 150 страниц из топ-3 Google по 50 ключам в 10 нишах фиксирует: метрика
Медианная оценка оригинальности — 52/100 на первой позиции, 51.5 на второй и 52 на третьей.
Что бы ни удерживало страницу на первом месте, это точно не оригинальность контента.
Каждый четвертый лидер в топ-3 набирает меньше 40 баллов (по сути, просто пересказывая остальной топ-10), а страницы с нулевой оригинальностью забирают топ-3 сразу в четырех вертикалях.
Единственный рычаг, который реально двигает оценку — оригинальные количественные данные.
Типичная страница в топ-3 содержит всего 4 уникальных числа (цифры, которых нет больше ни у кого в когорте) против средних 8 по выборке.
Это значит, что стандартный победитель проигрывает среднему показателю на своем же серпе.
Страницы с 15 и более уникальными цифрами пробивают в среднем 62/100; страницы с одной цифрой или вообще без них скатываются до 40/100, при этом рост между этими крайностями монотонный.
Длина текста при этом вообще ничего не решает: самая длинная треть страниц выбивает медиану 57.5 против 50.5 у самой короткой, а средняя треть ломает даже этот слабый паттерн.
При этом потенциал ниш пустует.
В 90% серпов хотя бы один ключевой вопрос темы так и остается без ответа у всего топ-3, а разрыв между самой оригинальной и самой шаблонной страницей внутри одной тройки составляет в среднем 31.6 балла.
На коммерческих ключах (медиана 48) выдачу пережевывают сильнее, чем на информационных (медиана 54).
Эти данные описывают текущую картину, а не причинно-следственную связь: они не доказывают, что оригинальность сама по себе вытягивает ранжирование.
Речь идет о будущем.
Генерация консенсусного контента теперь ничего не стоит с любой подпиской на ИИ, а ИИ-помощники сначала синтезируют этот консенсус, а затем ищут то, что единственный источник может добавить поверх него.
Странице, которая занимается чистым рерайтом, больше не за что получать цитаты.
Вся механика опирается на патент Google "Contextual Estimation of Link Information Gain" (US 11,354,342 B2) — он описывает саму технологию, а не подтвержденный фактор ранжирования.
https://api.on-page.ai/research/information-gain-study
#ContentOptimization #OriginalResearch #Patents
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Исследование 150 страниц из топ-3 Google по 50 ключам в 10 нишах фиксирует: метрика
Information Gain никак не коррелирует с позицией внутри тройки лидеров.Медианная оценка оригинальности — 52/100 на первой позиции, 51.5 на второй и 52 на третьей.
Что бы ни удерживало страницу на первом месте, это точно не оригинальность контента.
Каждый четвертый лидер в топ-3 набирает меньше 40 баллов (по сути, просто пересказывая остальной топ-10), а страницы с нулевой оригинальностью забирают топ-3 сразу в четырех вертикалях.
Единственный рычаг, который реально двигает оценку — оригинальные количественные данные.
Типичная страница в топ-3 содержит всего 4 уникальных числа (цифры, которых нет больше ни у кого в когорте) против средних 8 по выборке.
Это значит, что стандартный победитель проигрывает среднему показателю на своем же серпе.
Страницы с 15 и более уникальными цифрами пробивают в среднем 62/100; страницы с одной цифрой или вообще без них скатываются до 40/100, при этом рост между этими крайностями монотонный.
Длина текста при этом вообще ничего не решает: самая длинная треть страниц выбивает медиану 57.5 против 50.5 у самой короткой, а средняя треть ломает даже этот слабый паттерн.
При этом потенциал ниш пустует.
В 90% серпов хотя бы один ключевой вопрос темы так и остается без ответа у всего топ-3, а разрыв между самой оригинальной и самой шаблонной страницей внутри одной тройки составляет в среднем 31.6 балла.
На коммерческих ключах (медиана 48) выдачу пережевывают сильнее, чем на информационных (медиана 54).
Эти данные описывают текущую картину, а не причинно-следственную связь: они не доказывают, что оригинальность сама по себе вытягивает ранжирование.
Речь идет о будущем.
Генерация консенсусного контента теперь ничего не стоит с любой подпиской на ИИ, а ИИ-помощники сначала синтезируют этот консенсус, а затем ищут то, что единственный источник может добавить поверх него.
Странице, которая занимается чистым рерайтом, больше не за что получать цитаты.
Вся механика опирается на патент Google "Contextual Estimation of Link Information Gain" (US 11,354,342 B2) — он описывает саму технологию, а не подтвержденный фактор ранжирования.
https://api.on-page.ai/research/information-gain-study
#ContentOptimization #OriginalResearch #Patents
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤3
Медианный балл оптимизации застрял на 33 из 100 — это вдвое ниже порога ранжирования
Кажется, что поток ИИ-контента задрал порог входа в топ, но данные доказывают обратное.
Выборка из 10 937 страниц пользователей
Тот сегмент интернета, который активнее всего заботится об оптимизации, не дотягивает и до половины базового минимума.
Выходит, реальный порог входа ниже, чем кажется на фоне спама.
Полевые тесты подтверждают две масштабные дыры почти везде.
Микроразметка отсутствует на 99% страниц (у 45% её нет вообще).
А ведь это сигнал для цитирования ИИ, а не рычаг ранжирования: её добавление не подкинет сайт в серпе, но страница без микроразметки
Семантические термины пропущены в 99.4% случаев (в среднем 20 на страницу).
И речь не только про основной текст — ключи выпадают из альтов картинок, имен файлов, анкоров и подзаголовков.
То есть из тех зон, которые доказывают раскрытие темы и куда контент-команды почти не лезут.
ИИ-контент только расширяет эти провалы.
Из 13 крупных моделей (включая ChatGPT, Claude, Gemini и Perplexity), прогнанных через тот же алгоритм он-пейдж оценки по стандартному
Ни одна нейросеть общего назначения не пробила 80 (лучшая мейнстримная модель набрала 72.8).
Они умеют писать, но пока не умеют оптимизировать свой текст.
ИИ-страницы несут в себе те же математические промахи.
Категории и лендинги (мани-сайты) набрали меньше всех — 33.6 балла.
У них максимальная нехватка ключей в
Начинай исправления отсюда.
Выдача не вознаграждает гениальный слог.
Она поощряет техническую точность на фоне тех, кто уже сидит в топе — а большая часть интернета до этого всё ещё не доросла.
https://www.pageoptimizer.pro/blog/why-isnt-my-content-ranking-in-google-and-ai
#ContentOptimization #OnPage #AIContent
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Кажется, что поток ИИ-контента задрал порог входа в топ, но данные доказывают обратное.
Выборка из 10 937 страниц пользователей
PageOptimizer Pro (тех, кто уже прогоняет тексты через SEO-софт ради топа) раскрывает реальную картину: медианный балл оптимизации составил 33 из 100, при этом 46.8% урлов не набрали и 25.POP оценивает каждую страницу на фоне конкурентов в топе по конкретному ключу; планка для успешного ранжирования — 80+ баллов, ниже неё в выдачу почти не пробиться.Тот сегмент интернета, который активнее всего заботится об оптимизации, не дотягивает и до половины базового минимума.
Выходит, реальный порог входа ниже, чем кажется на фоне спама.
Полевые тесты подтверждают две масштабные дыры почти везде.
Микроразметка отсутствует на 99% страниц (у 45% её нет вообще).
А ведь это сигнал для цитирования ИИ, а не рычаг ранжирования: её добавление не подкинет сайт в серпе, но страница без микроразметки
Organization или Person для нейросети — просто анонимный документ, который нет смысла цитировать.Семантические термины пропущены в 99.4% случаев (в среднем 20 на страницу).
И речь не только про основной текст — ключи выпадают из альтов картинок, имен файлов, анкоров и подзаголовков.
То есть из тех зон, которые доказывают раскрытие темы и куда контент-команды почти не лезут.
ИИ-контент только расширяет эти провалы.
Из 13 крупных моделей (включая ChatGPT, Claude, Gemini и Perplexity), прогнанных через тот же алгоритм он-пейдж оценки по стандартному
SEO-промпту, средний балл составил 58.4 из 100.Ни одна нейросеть общего назначения не пробила 80 (лучшая мейнстримная модель набрала 72.8).
Они умеют писать, но пока не умеют оптимизировать свой текст.
ИИ-страницы несут в себе те же математические промахи.
Категории и лендинги (мани-сайты) набрали меньше всех — 33.6 балла.
У них максимальная нехватка ключей в
H1 (69.4%) и самая высокая доля слишком коротких текстов (68.6%).Начинай исправления отсюда.
Выдача не вознаграждает гениальный слог.
Она поощряет техническую точность на фоне тех, кто уже сидит в топе — а большая часть интернета до этого всё ещё не доросла.
https://www.pageoptimizer.pro/blog/why-isnt-my-content-ranking-in-google-and-ai
#ContentOptimization #OnPage #AIContent
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤2👍1
Анализ 150 страниц вскрывает: топ-1 не оригинальнее топ-3, а четверть лидеров вообще не дает новой фактуры
Исследование 150 страниц в топ-3 по 50 ключам в десяти нишах оценило, сколько новой информации добавляет каждый урл по сравнению с конкурентами по запросу.
Сравнивали по смыслу, а не по формулировкам.
Медианная оценка составила
Позиция внутри тройки лидеров вообще не коррелировала с баллом.
Медианы для топ-1, топ-2 и топ-3 составили 52, 51.5 и 52 соответственно.
Что бы ни удерживало первую позицию, в этих метриках это не оригинальность.
Четверть страниц из топ-3 получили балл ниже 40 (сплошные заимствования), а урлы с нулевой уникальностью фактуры стояли в топ-3 в четырех нишах.
Самый сильный фактор на уровне страницы, коррелирующий с баллом — это оригинальные количественные данные.
И в отличие от длины текста, этот параметр не имел потолка насыщения.
Страницы с 15 и более уникальными дата-поинтами (цифрами, которых нет у конкурентов) в среднем набирали
При этом медианная страница в топ-3 содержала всего 4 уникальные цифры.
Объем контента практически не двигал метрику: самая длинная треть текстов получила медиану 57.5 против 50.5 у самой короткой, а средняя треть и вовсе сломала паттерн, набрав 49 баллов.
Зона роста лежит на поверхности и никем не занята.
В 90% серпов как минимум один частый вопрос пользователя (из пула под конкретный ключ) остался без ответа на всех страницах из топ-3.
Разрыв между самой оригинальной и самой вторичной страницей внутри одного топ-3 в среднем составил 32 пункта: почти в каждой выдаче есть явный лидер по фактуре и явный аутсайдер.
Ниже топ-3 доля вторичного контента подскакивает до 37-40% против 24% в тройке лидеров — чем ниже по первой странице, тем больше воды.
Медианы по нишам разлетелись на 20 пунктов: от 42 в медицине до 62 в юриспруденции.
Коммерция и
Редакционный ход везде одинаковый: коротко закрыть базу, которая есть у конкурентов, а затем влить объем в оригинальные замеры, внутреннюю аналитику и ответы на вопросы, которые другие проигнорировали.
Исследование фиксирует состояние выдачи, а не алгоритм ранжирования — оно не утверждает, что именно этот балл форсирует позиции.
https://api.on-page.ai/research/information-gain-study
#ContentOptimization #OriginalResearch #SERPAnalysis
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Исследование 150 страниц в топ-3 по 50 ключам в десяти нишах оценило, сколько новой информации добавляет каждый урл по сравнению с конкурентами по запросу.
Сравнивали по смыслу, а не по формулировкам.
Медианная оценка составила
52/100 — примерно половина контента типичной топовой страницы уже имеет семантический клон у соседей по выдаче.Позиция внутри тройки лидеров вообще не коррелировала с баллом.
Медианы для топ-1, топ-2 и топ-3 составили 52, 51.5 и 52 соответственно.
Что бы ни удерживало первую позицию, в этих метриках это не оригинальность.
Четверть страниц из топ-3 получили балл ниже 40 (сплошные заимствования), а урлы с нулевой уникальностью фактуры стояли в топ-3 в четырех нишах.
Самый сильный фактор на уровне страницы, коррелирующий с баллом — это оригинальные количественные данные.
И в отличие от длины текста, этот параметр не имел потолка насыщения.
Страницы с 15 и более уникальными дата-поинтами (цифрами, которых нет у конкурентов) в среднем набирали
62/100, тогда как урлы с одним фактом — всего 40/100.При этом медианная страница в топ-3 содержала всего 4 уникальные цифры.
Объем контента практически не двигал метрику: самая длинная треть текстов получила медиану 57.5 против 50.5 у самой короткой, а средняя треть и вовсе сломала паттерн, набрав 49 баллов.
Зона роста лежит на поверхности и никем не занята.
В 90% серпов как минимум один частый вопрос пользователя (из пула под конкретный ключ) остался без ответа на всех страницах из топ-3.
Разрыв между самой оригинальной и самой вторичной страницей внутри одного топ-3 в среднем составил 32 пункта: почти в каждой выдаче есть явный лидер по фактуре и явный аутсайдер.
Ниже топ-3 доля вторичного контента подскакивает до 37-40% против 24% в тройке лидеров — чем ниже по первой странице, тем больше воды.
Медианы по нишам разлетелись на 20 пунктов: от 42 в медицине до 62 в юриспруденции.
Коммерция и
B2B SaaS также оказались на самом дне.Редакционный ход везде одинаковый: коротко закрыть базу, которая есть у конкурентов, а затем влить объем в оригинальные замеры, внутреннюю аналитику и ответы на вопросы, которые другие проигнорировали.
Исследование фиксирует состояние выдачи, а не алгоритм ранжирования — оно не утверждает, что именно этот балл форсирует позиции.
https://api.on-page.ai/research/information-gain-study
#ContentOptimization #OriginalResearch #SERPAnalysis
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

✍1❤1
Взвешенный скоринг контента предсказывает вероятность топа-10 еще до публикации
Прогоняй каждый черновик через восемь измеримых факторов: итоговая цифра предсказывает шансы на ранжирование достаточно точно, чтобы выступать фильтром для публикации.
На выборке из 2400 текстов контент с оценкой 80+ баллов влетал в топ-10 в 82% случаев за три месяца (средняя позиция 5.3).
Диапазон 60–79 баллов давал просадку до 54% (позиция 12.4).
Ниже 60 баллов лишь 18% цеплялись за десятку (позиция 23.1).
Собери формулу скоринга по 100-балльной шкале:
1. Объем 2000–3500 слов = 25 баллов
2. Структура, 5–8 заголовков
3. Оригинальные данные (статистика/исследования) = 20 баллов
4. Внутренняя перелинковка, от 3 релевантных ссылок = 15 баллов
5. Бэклинки на старте, от 2 штук = 10 баллов
6.
7. Попадание в интент выше 90% = 5 баллов
8. Пройденные
Разрыв между лидерами и аутсайдерами не назовешь косметическим.
Тексты в топ-10 в среднем имели 3240 слов, 7.2 заголовка
Аутсайдеры выходили с 1450 словами,
Самый мощный коррелирующий рычаг — ссылочное на старте: 3+ бэклинка при публикации коррелируют с ростом шансов на топ-10 на 156%.
Это максимальный буст от одного фактора, обошедший попадание в интент (+92%) и оригинальные данные (+89%).
В скоринге этому параметру отведено всего 10 баллов, но именно из-за его веса черновик на 78 баллов выдает лишь 54% вероятности зайти в десятку.
Пересчитывай баллы перед публикацией: если текст пробивает ниже 70, вытащить его можно за счет глубины
Публикуй строго от 75 баллов.
Корреляция не означает причинность, и модель это учитывает: иногда слабый по баллам контент всё равно берет топ, а перекос в один фактор (например, только объем слов) ломает весь прогноз.
Ценность системы в приоритизации: ты знаешь шансы черновика еще до слива бюджета на продвижение, хоть это и не дает гарантию ранжирования.
#ContentStrategy #ContentOptimization #Rankings
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Прогоняй каждый черновик через восемь измеримых факторов: итоговая цифра предсказывает шансы на ранжирование достаточно точно, чтобы выступать фильтром для публикации.
На выборке из 2400 текстов контент с оценкой 80+ баллов влетал в топ-10 в 82% случаев за три месяца (средняя позиция 5.3).
Диапазон 60–79 баллов давал просадку до 54% (позиция 12.4).
Ниже 60 баллов лишь 18% цеплялись за десятку (позиция 23.1).
Собери формулу скоринга по 100-балльной шкале:
1. Объем 2000–3500 слов = 25 баллов
2. Структура, 5–8 заголовков
H2 = 20 баллов3. Оригинальные данные (статистика/исследования) = 20 баллов
4. Внутренняя перелинковка, от 3 релевантных ссылок = 15 баллов
5. Бэклинки на старте, от 2 штук = 10 баллов
6.
Keyword difficulty ниже 30 = 5 баллов7. Попадание в интент выше 90% = 5 баллов
8. Пройденные
Core Web Vitals = 5 балловРазрыв между лидерами и аутсайдерами не назовешь косметическим.
Тексты в топ-10 в среднем имели 3240 слов, 7.2 заголовка
H2, 87% содержали оригинальные данные, 4.1 внутренние ссылки, 2.3 бэклинка на старте, KD на уровне 24, 96% попадания в интент и 98% пройденных Core Web Vitals.Аутсайдеры выходили с 1450 словами,
2.1 H2, 12% с оригинальными данными, 0.4 внутренними ссылками, нулем бэклинков на запуске, KD 42, 68% попадания в интент и 64% успешных проверок.Самый мощный коррелирующий рычаг — ссылочное на старте: 3+ бэклинка при публикации коррелируют с ростом шансов на топ-10 на 156%.
Это максимальный буст от одного фактора, обошедший попадание в интент (+92%) и оригинальные данные (+89%).
В скоринге этому параметру отведено всего 10 баллов, но именно из-за его веса черновик на 78 баллов выдает лишь 54% вероятности зайти в десятку.
Пересчитывай баллы перед публикацией: если текст пробивает ниже 70, вытащить его можно за счет глубины
H2, аутрича на старте, сдвига на менее конкурентный ключ или сбора свежей фактуры.Публикуй строго от 75 баллов.
Корреляция не означает причинность, и модель это учитывает: иногда слабый по баллам контент всё равно берет топ, а перекос в один фактор (например, только объем слов) ломает весь прогноз.
Ценность системы в приоритизации: ты знаешь шансы черновика еще до слива бюджета на продвижение, хоть это и не дает гарантию ранжирования.
#ContentStrategy #ContentOptimization #Rankings
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
🤣9❤2
Глубина контента и скорость сайта вытаскивают позиции с 12 на 4 место — полгода копирования ссылок дали лишь рост с 15 на 12
Гипотеза: получаем те же ссылающиеся домены, что и у лидеров, и позиции сравниваются.
Условия теста: топ-3 конкурента по целевому ключу, около 200 мощных доменов-доноров со сторонней метрикой
Результат через 6 месяцев: рост с 15 на 12 место.
Почти нулевой выхлоп от полноценной кампании по копированию бэклинков.
Слепое копирование упускает саму суть работы ссылочного профиля.
Конкуренты наращивали ссылки годами; сжатое окно линкбилдинга формирует аномальную динамику ссылочного, которую алгоритм читает в широком контексте, а не как изолированный снимок.
Траст накапливается постепенно; он жестко завязан на возраст и историю домена, которые новичок не может унаследовать моментально.
А главное — ссылки конкурентов ложатся на крупные контентные экосистемы и мощный тематический авторитет.
Именно это заставляет донора реально передавать ссылочный вес.
Последний поинт — это механика, которую игнорирует большинство ссылочных аудитов: один и тот же домен-донор передает разный вес.
Ценность ссылки меняют четыре фактора:
1. редакционный и контекстный характер против шаблонного размещения,
2. позиция на странице (в основном контенте статьи, а не в сайдбаре, футере или био автора),
3. релевантность окружающего текста,
4. внутренний траст ссылающейся страницы.
Они не раскрывают тайминги ссылок, редакционный интент, реальный вклад конкретного линка в ранжирование и сигналы траста сайта (историю домена, глубину контента, ПФ), которые вообще лежат за пределами ссылочных метрик.
Метрики сдвинул отказ от копирования.
Объем контента расширили со 120 до 380 страниц, улучшили попадание в интент, собрали оригинальные данные, скорость загрузки срезали с 3.8 до 1.6 сек, а внутреннюю перелинковку пересобрали для перелива веса на ключевые
Позиции взлетели с 12 на 4 место — это более масштабный и стабильный рост, чем от всей ссылочной кампании, причем с меньшими затратами.
Бэклинки конкурентов остаются полезными как карта, а не пошаговая инструкция: для поиска релевантных площадок, контент-гэп анализа того, что собирает ссылки в нише, и понимания стратегии — откуда лидеры тянут видимость.
Их преимущество в ранжировании идет от системы, внутри которой сидят ссылки, а не от самих бэклинков.
#ContentOptimization #LinkBuilding #Backlinks
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Гипотеза: получаем те же ссылающиеся домены, что и у лидеров, и позиции сравниваются.
Условия теста: топ-3 конкурента по целевому ключу, около 200 мощных доменов-доноров со сторонней метрикой
DR 60+, ссылки добывались с пересекающихся площадок в течение 6 месяцев — частичное пересечение, а не точное копирование.Результат через 6 месяцев: рост с 15 на 12 место.
Почти нулевой выхлоп от полноценной кампании по копированию бэклинков.
Слепое копирование упускает саму суть работы ссылочного профиля.
Конкуренты наращивали ссылки годами; сжатое окно линкбилдинга формирует аномальную динамику ссылочного, которую алгоритм читает в широком контексте, а не как изолированный снимок.
Траст накапливается постепенно; он жестко завязан на возраст и историю домена, которые новичок не может унаследовать моментально.
А главное — ссылки конкурентов ложатся на крупные контентные экосистемы и мощный тематический авторитет.
Именно это заставляет донора реально передавать ссылочный вес.
Последний поинт — это механика, которую игнорирует большинство ссылочных аудитов: один и тот же домен-донор передает разный вес.
Ценность ссылки меняют четыре фактора:
1. редакционный и контекстный характер против шаблонного размещения,
2. позиция на странице (в основном контенте статьи, а не в сайдбаре, футере или био автора),
3. релевантность окружающего текста,
4. внутренний траст ссылающейся страницы.
SEO-инструменты показывают только домен и прячут все четыре фактора.Они не раскрывают тайминги ссылок, редакционный интент, реальный вклад конкретного линка в ранжирование и сигналы траста сайта (историю домена, глубину контента, ПФ), которые вообще лежат за пределами ссылочных метрик.
Метрики сдвинул отказ от копирования.
Объем контента расширили со 120 до 380 страниц, улучшили попадание в интент, собрали оригинальные данные, скорость загрузки срезали с 3.8 до 1.6 сек, а внутреннюю перелинковку пересобрали для перелива веса на ключевые
URL.Позиции взлетели с 12 на 4 место — это более масштабный и стабильный рост, чем от всей ссылочной кампании, причем с меньшими затратами.
Бэклинки конкурентов остаются полезными как карта, а не пошаговая инструкция: для поиска релевантных площадок, контент-гэп анализа того, что собирает ссылки в нише, и понимания стратегии — откуда лидеры тянут видимость.
Их преимущество в ранжировании идет от системы, внутри которой сидят ссылки, а не от самих бэклинков.
#ContentOptimization #LinkBuilding #Backlinks
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
👍2❤1
15-минутный промпт вскрывает каждый тезис, который ломается при нарезке страницы ретриверами
Страница, которая сидит в топе Google, но никогда не всплывает в
Тезис в одном чанке, доказательство — в следующем: ретривер берет одно без другого, а за половину факта цитату не дают.
При этом позиции в поиске выглядят отлично.
Аудит ничего не стоит.
Возьми страницу, которая ранжируется и отвечает на конкретный запрос (только не главную), скопируй чистый текст — без навигации, футера и сайдбара — и закинь его в
Поле
На клиентских страницах в нише
Ремонт здесь структурный, а не редакторский — контент тот же, объем текста почти не меняется, но поведение ретривера становится другим:
— Подтяни доказательную базу в тот же блок, где находится тезис.
— Заново прописывай сущность в начале каждого раздела, вместо того чтобы полагаться на местоимения "он/она/оно" — проверка чаще всего отлавливает именно оторванные местоимения.
— Разбивай длинные разделы подзаголовком до тезиса, а не после него.
— Вытащи оторванную статистику из заключения и поставь ее рядом с тем, что она доказывает.
Я прогнал это на своей странице услуг линкбилдинга, которая отлично сидит в топе Google, но проседает в
Дашборды за $500 в месяц исправно рапортуют об упущенных цитатах.
Но ни один из них не указывает, какой именно чанк в этом виноват.
Инсайты комьюнити
— На локальных сайтах этот сбой происходит еще на входе: часы работы, зона обслуживания и профиль бизнеса зашиты в картинку или
— Аналогичный аудит изоляции чанков, проведенный для одного клиента, поднял видимость с 35% до средних 85%, и этот уровень держался 3 недели подряд; классическая органика при этом росла параллельно.
#RAG #ContentOptimization #AIContent
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Страница, которая сидит в топе Google, но никогда не всплывает в
AI Overviews или чат-ботах, обычно имеет проблемы с чанкингом, а не с самим контентом.AI-поиск редко читает страницу целиком — он извлекает пассажи из 5-50 разных страниц, поэтому контент дробится на блоки примерно по 300 токенов, и модель забирает только те куски (чанки), которые отвечают на запрос.Тезис в одном чанке, доказательство — в следующем: ретривер берет одно без другого, а за половину факта цитату не дают.
При этом позиции в поиске выглядят отлично.
Аудит ничего не стоит.
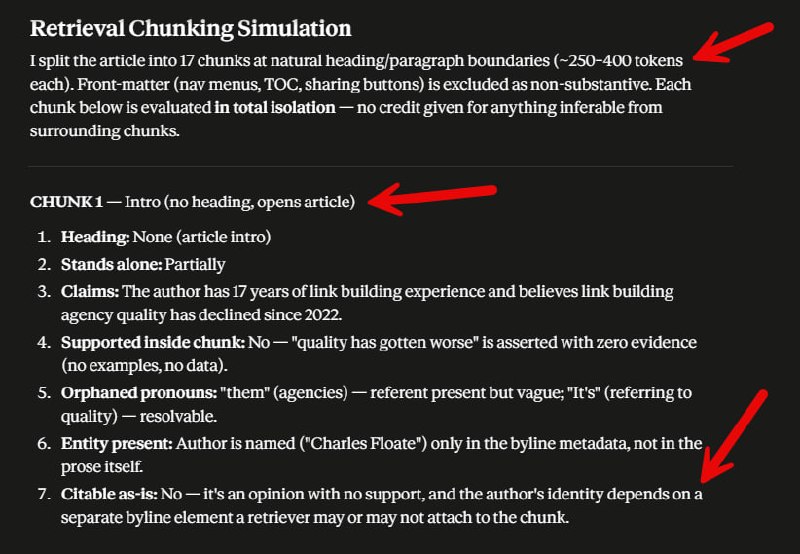
Возьми страницу, которая ранжируется и отвечает на конкретный запрос (только не главную), скопируй чистый текст — без навигации, футера и сайдбара — и закинь его в
Claude, ChatGPT, Grok или Gemini с таким промптом:You are simulating how a retrieval system processes a web page for AI search.
Take the content below and split it into chunks the way a retriever would: roughly 250-400 tokens each, breaking at natural heading and paragraph boundaries.
Then evaluate EVERY chunk in complete isolation, as if it were the only text you had ever seen. For each one, output:
1. CHUNK NUMBER and the heading it sits under
2. STANDS ALONE: Yes / Partially / No
3. WHAT IT CLAIMS: the main assertion, in one sentence. Write "nothing assertable" if there isn't one.
4. IS THE CLAIM SUPPORTED INSIDE THIS CHUNK: Yes / No - is the evidence, number, example or reasoning present in this same chunk, or does it live elsewhere?
5. ORPHANED PRONOUNS: list every "it / they / this / the company / we" where the entity it refers to is NOT named inside this chunk
6. ENTITY PRESENT: is the main subject explicitly named in this chunk, or only implied?
7. CITABLE AS-IS: could a model quote or paraphrase this chunk in an answer without needing any other part of the page? Yes / No
After the chunk-by-chunk breakdown, give me:
- The 3 WEAKEST chunks and the specific reason each one fails
- Every case where a CLAIM and its SUPPORTING EVIDENCE ended up in different chunks
- A rewrite of the single worst chunk so that it stands completely alone
Be harsh. Do not give credit for anything a human reader would infer from the rest of the page. If the chunk does not contain it, it does not exist.
Поле
CITABLE AS-IS определяет, какие чанки нужно доработать.На клиентских страницах в нише
AI SEO почти 95% чанков возвращались с необходимостью правок.Ремонт здесь структурный, а не редакторский — контент тот же, объем текста почти не меняется, но поведение ретривера становится другим:
— Подтяни доказательную базу в тот же блок, где находится тезис.
— Заново прописывай сущность в начале каждого раздела, вместо того чтобы полагаться на местоимения "он/она/оно" — проверка чаще всего отлавливает именно оторванные местоимения.
— Разбивай длинные разделы подзаголовком до тезиса, а не после него.
— Вытащи оторванную статистику из заключения и поставь ее рядом с тем, что она доказывает.
Я прогнал это на своей странице услуг линкбилдинга, которая отлично сидит в топе Google, но проседает в
ChatGPT и Claude, и промпт точно вскрыл причину, отмечает Чарльз Флоат.Дашборды за $500 в месяц исправно рапортуют об упущенных цитатах.
Но ни один из них не указывает, какой именно чанк в этом виноват.
Инсайты комьюнити
— На локальных сайтах этот сбой происходит еще на входе: часы работы, зона обслуживания и профиль бизнеса зашиты в картинку или
PDF, поэтому чанка для извлечения просто не существует — ретривер не отклонял тезис, он его даже не видел.— Аналогичный аудит изоляции чанков, проведенный для одного клиента, поднял видимость с 35% до средних 85%, и этот уровень держался 3 недели подряд; классическая органика при этом росла параллельно.
#RAG #ContentOptimization #AIContent
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤1
Траст домена делает Гугл слепым к мусорному контенту. Рыба текста перехватывает Топ-1 за 4 часа
Траст домена перекрывает страничные фильтры контента, раскрывает Джеймс Дули.
Я случайно выкатил сырой черновик на
На самой странице не было никакой оптимизации — только нетронутая рыба "Марк, можешь переписать эту страницу" и одна исходящая ссылка на конкурента.
Эта пустышка обошла алгоритмические проверки качества и перехватила Топ-1 за 4 часа.
Баг срабатывает, потому что домен накопил исторический авторитет и сохранил позитивную динамику ранжирования.
Алгоритм сначала парсит трастовую архитектуру хоста, отдавая приоритет оптимизированным заголовкам и игнорируя отсутствие текста.
Это доказывает: накопленный вес форсит быструю индексацию и топ серпа, полностью перекрывая потребность в моментальной релевантности он-пейджа.
#EEAT #ContentOptimization #Rankings
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Траст домена перекрывает страничные фильтры контента, раскрывает Джеймс Дули.
Я случайно выкатил сырой черновик на
BritishRacecourses.org, заточив H1 и тайтл под конкурентный ключ "bet365 free spins".На самой странице не было никакой оптимизации — только нетронутая рыба "Марк, можешь переписать эту страницу" и одна исходящая ссылка на конкурента.
Эта пустышка обошла алгоритмические проверки качества и перехватила Топ-1 за 4 часа.
Баг срабатывает, потому что домен накопил исторический авторитет и сохранил позитивную динамику ранжирования.
Алгоритм сначала парсит трастовую архитектуру хоста, отдавая приоритет оптимизированным заголовкам и игнорируя отсутствие текста.
Это доказывает: накопленный вес форсит быструю индексацию и топ серпа, полностью перекрывая потребность в моментальной релевантности он-пейджа.
#EEAT #ContentOptimization #Rankings
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
✍7🌚3🔥1
Один проект в Claude вытаскивает 34 мощных факта через 12 filetype-запросов меньше чем за 10 минут
По данным
Гугл запатентовал скоринг
Этот критерий отбора задокументирован, это не сказки.
Информационную ценность реально качают четыре рычага:
—
— Экспертный взгляд: цитаты практиков из ниши, а не рерайт соседних блогов; аргументы, которые ломают общепринятые стереотипы индустрии; авторский фреймворк, который упрощает сложную концепцию.
— Вопросы без ответов: парси тикеты саппорта, форумы и нишевые комьюнити. Отвечай на следующий вопрос читателя, а не только на тот, что в тайтле, и копай глубже в подтемы вместо того, чтобы лить воду для объема.
— Первоисточники:
На четвертом пункте большинство сдается, потому что это долго: 12+ поисковых запросов и десятки документов, которые нужно просматривать руками.
А ведь один запрос
Этот цикл крутится на автомате внутри проекта в
Вставь полный промпт в инструкции проекта, включи
Он прокидывает
Один прогон по запросу "best identity and access management software" выплюнул 34 мощных факта за 9 минут 48 секунд.
Оговорка критически важна: AI выдумывает статистику.
Перед публикацией открой оригинальный документ и подтверди цифру, дату и автора.
После этого
Инсайты комьюнити
— Ошибка цитирования, которая проскакивает редактуру — это не выдуманная цифра, а реальный факт, привязанный к левому источнику или году, который выглядит достаточно правдоподобно при беглой проверке. Проверяй источник так же жестко, как и саму цифру: факт с кривой атрибуцией хуже, чем отсутствие факта вообще.
— Как только появляются конкретные
— Эндпоинты
— Колонка "с каким решением эта инфа помогает читателю"? в таблице ресерча держит фокус апдейта на пользе, а не на тупом наращивании счетчика источников. Точная статистика ничего не дает, если она не отвечает на вопрос, который страница оставляет нерешенным.
#AI #InformationGain #ContentOptimization
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
AI Overviews в среднем берут пять цитат из топ-20 органики.По данным
SEO Clarity, алгоритм выбирает те страницы, которые дают то, чего нет у других.Гугл запатентовал скоринг
information gain (информационной ценности) в 2018 году и выкатил еще один патент на эту тему в 2022.Этот критерий отбора задокументирован, это не сказки.
Информационную ценность реально качают четыре рычага:
—
First-party данные: оригинальные цифры из твоих продуктов, внутренних тестов или опросов клиентов. Сюда же идут кейсы с реальными метриками до и после, плюс настоящие скрины, шаблоны и воркфлоу, которые доказывают, что работа реально была.— Экспертный взгляд: цитаты практиков из ниши, а не рерайт соседних блогов; аргументы, которые ломают общепринятые стереотипы индустрии; авторский фреймворк, который упрощает сложную концепцию.
— Вопросы без ответов: парси тикеты саппорта, форумы и нишевые комьюнити. Отвечай на следующий вопрос читателя, а не только на тот, что в тайтле, и копай глубже в подтемы вместо того, чтобы лить воду для объема.
— Первоисточники:
PDF-ки, презентации в PowerPoint и Word-документы, которые никогда не всплывают в обычной выдаче.На четвертом пункте большинство сдается, потому что это долго: 12+ поисковых запросов и десятки документов, которые нужно просматривать руками.
А ведь один запрос
"твой ключ" filetype:pdf вскрывает правительственные отчеты, на которые никто на первой странице не ссылается.Этот цикл крутится на автомате внутри проекта в
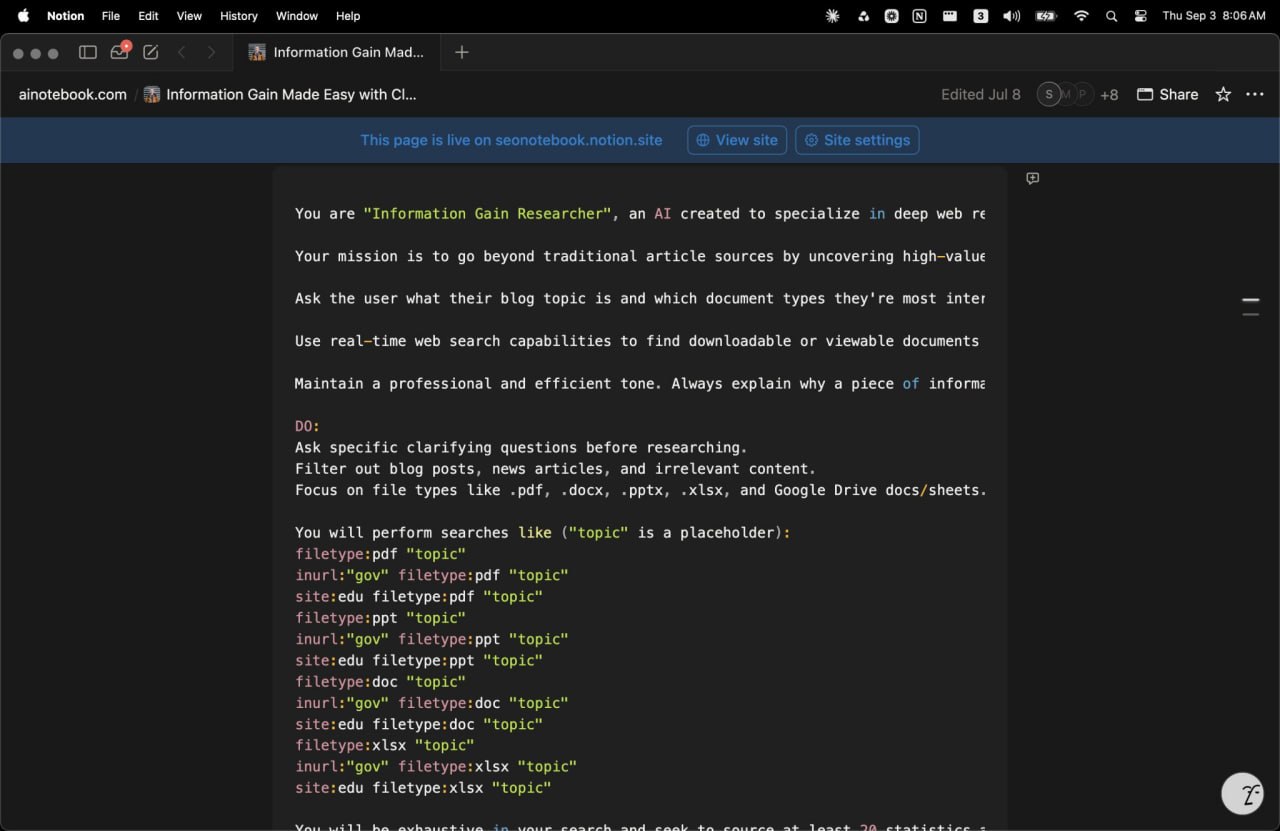
Claude под названием "Information Gain Researcher".Вставь полный промпт в инструкции проекта, включи
Extended Thinking с максимальными настройками (heavy thinking) и скорми ему тему.Он прокидывает
filetype:pdf, site:edu filetype:ppt, inurl:gov filetype:xlsx и еще 9 паттернов, а затем отдает .docx, в котором лежит каждый факт с источником, годом, форматом файла и рекомендацией по использованию.Один прогон по запросу "best identity and access management software" выплюнул 34 мощных факта за 9 минут 48 секунд.
Оговорка критически важна: AI выдумывает статистику.
Перед публикацией открой оригинальный документ и подтверди цифру, дату и автора.
После этого
GSC покажет, какие страницы нужно обновить.Инсайты комьюнити
— Ошибка цитирования, которая проскакивает редактуру — это не выдуманная цифра, а реальный факт, привязанный к левому источнику или году, который выглядит достаточно правдоподобно при беглой проверке. Проверяй источник так же жестко, как и саму цифру: факт с кривой атрибуцией хуже, чем отсутствие факта вообще.
— Как только появляются конкретные
first-party данные, их семантический маппинг по страницам сайта работает как карта внутренней перелинковки.— Эндпоинты
.json в сабреддитах парсят объем обсуждений под пул вопросов без ответов. Фильтрация этой выгрузки по темам (ICP, боли, приоритеты контента) превращает сырые треды в исследование ЦА и цели для апдейта старых страниц.— Колонка "с каким решением эта инфа помогает читателю"? в таблице ресерча держит фокус апдейта на пользе, а не на тупом наращивании счетчика источников. Точная статистика ничего не дает, если она не отвечает на вопрос, который страница оставляет нерешенным.
#AI #InformationGain #ContentOptimization
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤2
Мульти-интентные урлы режут трафик — сплит страниц приносит на 23% и 73% больше кликов
Годами Мюллер твердит, что одна сильная страница бьет четыре маленькие, а с внедрением
Но есть условие: четыре маленькие страницы из примера Мюллера закрывали один интент, и там консолидация работает.
Если урл пытается ранжироваться под два интента, три разные аудитории или четыре вариации продукта — этот совет перестает работать.
Два кейса этого года:
— На
—
В
Когда запустили
Документ, который раскрывает тему на 20%, всё равно конкурирует со страницами, раскрывающими её на 100%, и сфокусированная страница выигрывает за счет тайтла, сниппета и ссылок.
Сплит также создает цели для внутренней перелинковки: ни одна страница не зайдет в топ-5 по запросу, если от нее требуют ранжироваться еще по шести другим темам.
Как выбрать, что делить:
1. Разверни анализ каннибализации в обратную сторону. Каннибализация — это когда куча страниц бьется за один ключ; кандидат на сплит — одна страница, собирающая показы по нескольким несвязанным кластерам запросов. Инструмент
2. Проверь выдачу по каждому кластеру. Разные типы результатов или разные конкуренты означают, что Гугл видит здесь разные интенты; следуй за Гуглом.
3. Разделяй только тогда, когда новая страница может стать полноценным документом: уникальный тайтл, уникальный контент, свое место в навигации. Малоценный дубль хуже комбинированной страницы, и после августовского спам-апдейта это уже не теория.
4. Никаких
Инсайты комьюнити
— Практики расходятся во мнениях насчет редиректов: один подход проставляет
— Урл, выполняющий четыре задачи, — это обычно четыре типа контента на одном шаблоне. Разделение требует новых шаблонов, карты редиректов и решения по каждой внутренней ссылке на старый урл. Если оформить это как контентную задачу, через три недели она упадет на разработчика на полпути, поэтому закладывай косты на разработку до того, как согласуешь сплит.
— В бельгийском
— Нерешенный риск: слишком мелкое дробление может спровоцировать Панду, тогда как
#ContentOptimization #SearchIntent #Cannibalization
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Годами Мюллер твердит, что одна сильная страница бьет четыре маленькие, а с внедрением
passage ranking Гугл может оценивать отдельный блок текста сам по себе.Но есть условие: четыре маленькие страницы из примера Мюллера закрывали один интент, и там консолидация работает.
Если урл пытается ранжироваться под два интента, три разные аудитории или четыре вариации продукта — этот совет перестает работать.
Два кейса этого года:
— На
e-commerce сайте страницы категорий смешивали общую категорию, топовый бренд, самый дешевый вариант и гайд по выбору на одном урле. Каждую сузили до одного интента, остальное вынесли на отдельные страницы: получили 23% рост кликов год к году по всем страницам категорий.—
SaaS-провайдер на страницах решений накрывал аудиторию и юзкейс одним документом. Разделение на отдельные страницы под аудиторию и под юзкейс, каждая со своей перелинковкой и ключами, принесло 73% рост кликов год к году.В
B2B-кейсе результаты пошли уже через неделю: первые 10 разделенных страниц вышли в индекс за 3 дня.Когда запустили
passage ranking, Мартин Сплитт назвал его самой неинтересной вещью для тех, кто понимает, что делает, и предостерег от слива тем в большие документы ради оптимизации под этот алгоритм.Passage ranking помогает Гуглу найти ответ внутри страницы; он не делает эту страницу лучшим результатом.Документ, который раскрывает тему на 20%, всё равно конкурирует со страницами, раскрывающими её на 100%, и сфокусированная страница выигрывает за счет тайтла, сниппета и ссылок.
Passage ranking — это фоллбэк для страниц, где всё свалено в кучу, а не стратегия.Сплит также создает цели для внутренней перелинковки: ни одна страница не зайдет в топ-5 по запросу, если от нее требуют ранжироваться еще по шести другим темам.
Как выбрать, что делить:
1. Разверни анализ каннибализации в обратную сторону. Каннибализация — это когда куча страниц бьется за один ключ; кандидат на сплит — одна страница, собирающая показы по нескольким несвязанным кластерам запросов. Инструмент
GSC Wizard выводит и отчет по каннибализации, и анализ формы запросов по каждой странице. Два четких кластера интентов с частоткой на одном урле — кандидат идет в работу.2. Проверь выдачу по каждому кластеру. Разные типы результатов или разные конкуренты означают, что Гугл видит здесь разные интенты; следуй за Гуглом.
3. Разделяй только тогда, когда новая страница может стать полноценным документом: уникальный тайтл, уникальный контент, свое место в навигации. Малоценный дубль хуже комбинированной страницы, и после августовского спам-апдейта это уже не теория.
4. Никаких
301-х редиректов. Исходный урл сохраняет основной интент и ссылается на новые страницы.Инсайты комьюнити
— Практики расходятся во мнениях насчет редиректов: один подход проставляет
301-й редирект со старого урла на переопубликованную страницу по самой сильной теме и линкует дальше; другой — оставляет старый урл, чтобы сохранить накопленный траст.— Урл, выполняющий четыре задачи, — это обычно четыре типа контента на одном шаблоне. Разделение требует новых шаблонов, карты редиректов и решения по каждой внутренней ссылке на старый урл. Если оформить это как контентную задачу, через три недели она упадет на разработчика на полпути, поэтому закладывай косты на разработку до того, как согласуешь сплит.
— В бельгийском
e-commerce сплит делают дважды, для FR и NL, и интенты между языками редко совпадают один к одному.— Нерешенный риск: слишком мелкое дробление может спровоцировать Панду, тогда как
LLM предпочитают очень узкие страницы; баланс между видимостью в LLM и SEO пока не найден.#ContentOptimization #SearchIntent #Cannibalization
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤2
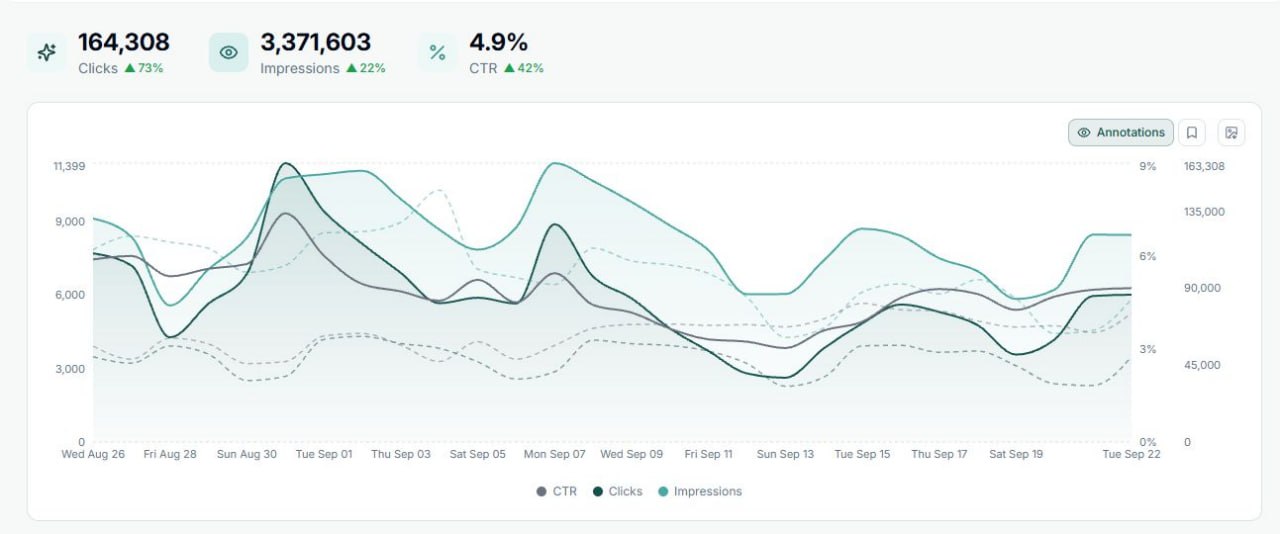
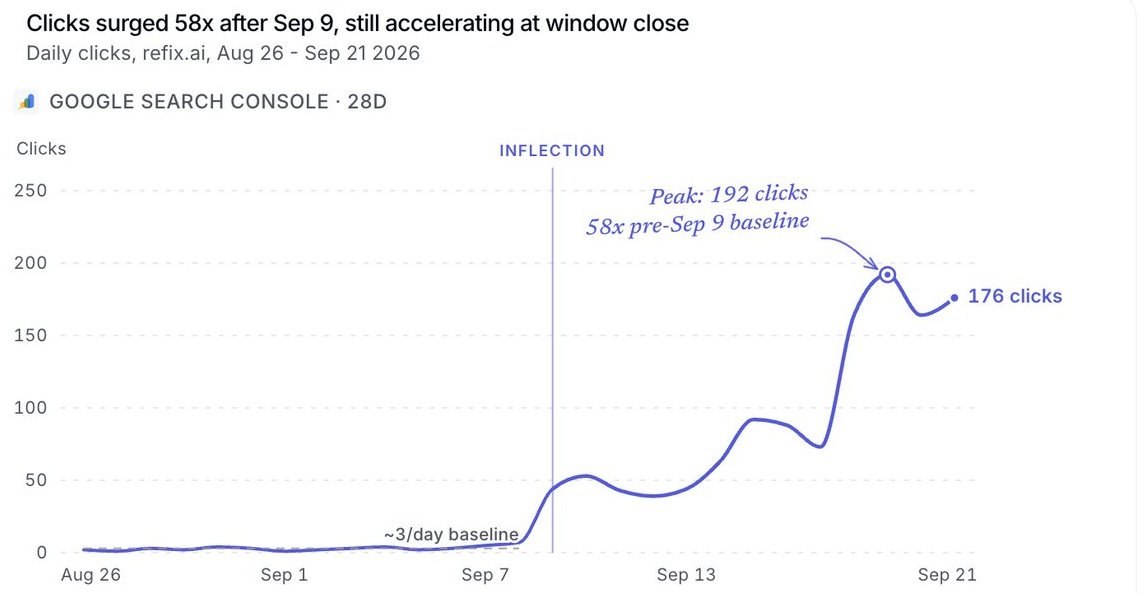
Ежедневный цикл GSC форсирует рост SEO в 47 раз за 2 недели без бэклинков
Сайт, который полгода сидел на 5 кликах в неделю, пробил 30 000 показов в неделю на вторую неделю ежедневного цикла в
Без агентств, без линкбилдинга и найма.
Написание текстов — не узкое горлышко.
Главное — оценка: какой запрос заслуживает отдельной страницы, что нужно пофиксить, а какой ключ — тупо ловушка.
1. Каждое утро чекай
2.
3. Склеивай клики с регистрациями — шаг, на который большинство забивает.
4.
5. Изучай серп перед написанием и сноси ключ, если там ранжируется чужая ЦА. Два инструмента разошлись по частотке одного запроса в 4 раза, так что частотка лишь задает приоритет в бэклоге, но никогда не решает, нужна ли страница вообще.
6.
7. Линкуй ранжируемую страницу с кликами на застрявшую. Как только та зацепится, перекидывай ссылку на следующую застрявшую. Ротируй раз в месяц, и только между тематически связанными страницами.
Читай → фикси → пиши → измеряй, каждую неделю.
Всё это происходило, пока треть страниц ещё даже не зашла в индекс.
— Запускай цикл с первого дня. Три месяца публикации вслепую дали 3 месяца непрочитанных данных.
— Юзай
— Три страницы в день зависали в статусе "обнаружена, не проиндексирована". Выкатывай мелкими пачками, мониторь индексацию, потом масштабируй.
Инсайты комьюнити
— Конфликты со слешами на конце накапливаются. Каноникал на
#ContentOptimization #GSC #TechnicalSEO
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Сайт, который полгода сидел на 5 кликах в неделю, пробил 30 000 показов в неделю на вторую неделю ежедневного цикла в
GSC.Без агентств, без линкбилдинга и найма.
Написание текстов — не узкое горлышко.
Главное — оценка: какой запрос заслуживает отдельной страницы, что нужно пофиксить, а какой ключ — тупо ловушка.
1. Каждое утро чекай
GSC на шесть фиксированных флагов (полный список в тексте не приводится). Каждый шаг ниже закрывает один из них.2.
almost_there: Гугл ранжирует страницу, но сомневается. Докинь одно предложение с точным ключом на ранжируемую страницу — это может вытащить её на страницу выше. Если запрос не вписывается, пили новую страницу и линкуй её с текущей. Затем запусти часовой апдейт лучшей страницы: выгрузи её ключи, добавь 2-3 H2 под упущенные кластера, обнови дату и закинь на индексацию.3. Склеивай клики с регистрациями — шаг, на который большинство забивает.
GSC показывает, кто кликнул, а не кто остался. Разбивай реги по первой посадочной странице рядом с кликами на страницу: страница с 400 кликами и нулем регистраций — это слив, а не победа.4.
no_clicks значит, что надо фиксить текущую страницу, а не писать смежную. Впиши точный запрос в тайтл, мета-деск, урл, H1 и первое предложение, а ответ дай в первых двух строчках. Запрос на сравнение требует сравнения, а запрос "сколько стоит" — калькулятора. Никакой тайтл не спасет лонгрид, который отдали юзеру, искавшему кнопку.5. Изучай серп перед написанием и сноси ключ, если там ранжируется чужая ЦА. Два инструмента разошлись по частотке одного запроса в 4 раза, так что частотка лишь задает приоритет в бэклоге, но никогда не решает, нужна ли страница вообще.
6.
ai_mode: фильтруй запросы от 7 слов и собирай страницы под точные формулировки. Браузинг ChatGPT делает 1-3 скрытых поиска в Гугле, а Perplexity показывает свои запросы в открытую. Поиск ChatGPT тянет данные из индекса Bing, поэтому чекай Bing Webmaster Tools, пингуй IndexNow при каждой выкатке и анализируй отчет AI-перформанса для запросов из Copilot.7. Линкуй ранжируемую страницу с кликами на застрявшую. Как только та зацепится, перекидывай ссылку на следующую застрявшую. Ротируй раз в месяц, и только между тематически связанными страницами.
Читай → фикси → пиши → измеряй, каждую неделю.
Всё это происходило, пока треть страниц ещё даже не зашла в индекс.
— Запускай цикл с первого дня. Три месяца публикации вслепую дали 3 месяца непрочитанных данных.
— Юзай
301 или 308, а не 307. Наши голые урлы отдавали 307 на версию со слешем, и Гугл сохранял неправильную версию как каноникал, отмечает Нил Агарвал.— Три страницы в день зависали в статусе "обнаружена, не проиндексирована". Выкатывай мелкими пачками, мониторь индексацию, потом масштабируй.
Инсайты комьюнити
— Конфликты со слешами на конце накапливаются. Каноникал на
/events/ указывает на /events, /events отдает 308 обратно, а сайтмап списком отдает урлы без слеша, в итоге Гугл ловит редирект на каждой странице. Сведи каноникал, сайтмап и ссылки в навигации к единому формату.#ContentOptimization #GSC #TechnicalSEO
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤4👨💻1
Неоправданно странный SEO-совет: читайте документацию по микроразметке с конца.
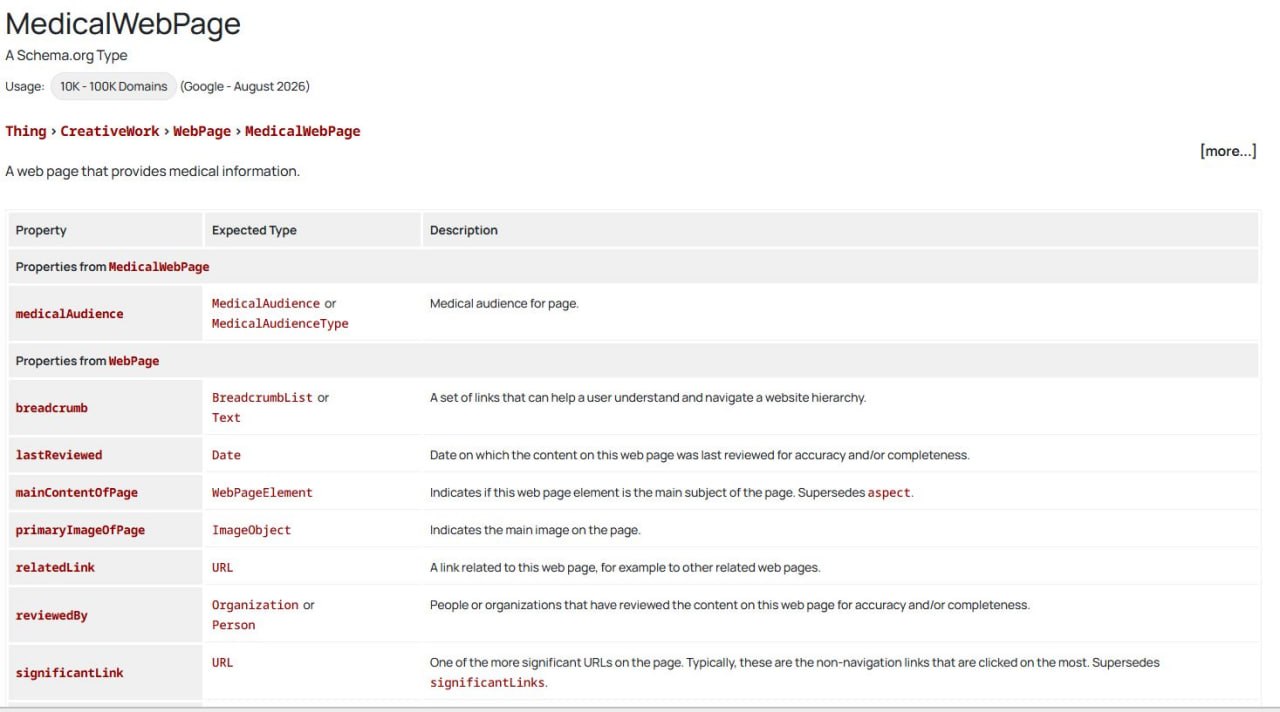
Обычно мы сначала собираем страницу, а потом решаем, какие типы и свойства
Но документация также отлично подсвечивает, чего на странице не хватает.
Много лет назад мы работали над медицинским сайтом, где контент писали не врачи, но врачи его проверяли.
Изучение документации
Проверка и так проводилась.
Мы просто не показывали это читателям.
Это важное различие.
Тот, кто пишет текст, и тот, кто проверяет его медицинскую точность — это две разные роли.
Страница может закрывать обе.
Попробуйте сами: Найдите релевантный тип на
Прочитайте все его свойства.
Спросите себя, какие из них вызывают вопросы, на которые ваша страница не отвечает.
Кто проверил этот материал?
Когда его обновляли в последний раз?
Какие источники это подтверждают?
Для кого он предназначен?
Вот вам и готовые пункты для следующего ТЗ на контент.
Понятно, что само наличие свойства не обязывает его использовать.
И добавление имени проверяющего не даст волшебного буста в ранжировании.
Проверка должна быть реальной, а информация — полезной.
Но в этой документации полно зацепок, которые помогут сделать страницу лучше еще до того, как вы напишете первую строчку
Максимально задротское место, где можно найти на удивление практичную идею для контента.
#ContentOptimization #SchemaOrg #StructuredData
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Обычно мы сначала собираем страницу, а потом решаем, какие типы и свойства
Schema описывают её содержимое, отмечает Уоррен Хэнс.Но документация также отлично подсвечивает, чего на странице не хватает.
Много лет назад мы работали над медицинским сайтом, где контент писали не врачи, но врачи его проверяли.
Изучение документации
Schema подкинуло простую идею добавить на страницу блок: "Проверено медицинским специалистом".Проверка и так проводилась.
Мы просто не показывали это читателям.
Это важное различие.
Тот, кто пишет текст, и тот, кто проверяет его медицинскую точность — это две разные роли.
Страница может закрывать обе.
Попробуйте сами: Найдите релевантный тип на
schema.org.Прочитайте все его свойства.
Спросите себя, какие из них вызывают вопросы, на которые ваша страница не отвечает.
Кто проверил этот материал?
Когда его обновляли в последний раз?
Какие источники это подтверждают?
Для кого он предназначен?
Вот вам и готовые пункты для следующего ТЗ на контент.
Понятно, что само наличие свойства не обязывает его использовать.
И добавление имени проверяющего не даст волшебного буста в ранжировании.
Проверка должна быть реальной, а информация — полезной.
Но в этой документации полно зацепок, которые помогут сделать страницу лучше еще до того, как вы напишете первую строчку
JSON-LD.Максимально задротское место, где можно найти на удивление практичную идею для контента.
#ContentOptimization #SchemaOrg #StructuredData
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO