Программная схема и сигналы свежести перекрывают штрафы за тонкий контент
Архитектура директории, дающая 120К сессий в месяц, раскрывает механизм обхода алгоритмов "
Синхронизируя жесткие структуры шаблонов с плотной микроразметкой и свежестью через
"Фильтр" аннулируется, потому что формат шаблона (сканируемые списки, прайсинг, быстрые сравнения) матчит интент юзера точнее, чем лонгриды, что подтверждается сильными поведенческими: 4:12 среднее время на сайте и 38% отказов.
Инъекция Схемы и Таксономия
Стратегия полагается на монополизацию фич выдачи через полный стек
Страницы листинга развертывают
Этот конфиг обеспечивает рич сниппеты для 67% ранжируемых страниц.
Сайт цементирует тематический авторитет через жесткую таксономию из 45 главных категорий, 180 подкатегорий и 340 тегов, сигнализируя краулеру о глубокой структуре.
Автоматизированный контент и Петли свежести
Масштаб достигается через программный движок "
Более 1,200 страниц сравнения (типа
Чтобы предотвратить протухание статических шаблонов, система автоматизирует сигналы свежести через
— Ежедневно: Чеки цен и добавление 2-3 новых тулов.
— Ежечасно: Агрегация отзывов.
— Еженедельно: Апдейты списка фич.
Консолидированная Польза
Вместо написания уникальных обзоров, сайт агрегирует данные с
Этот
#Programmatic #SchemaOrg #StructuredData
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Архитектура директории, дающая 120К сессий в месяц, раскрывает механизм обхода алгоритмов "
thin content".Синхронизируя жесткие структуры шаблонов с плотной микроразметкой и свежестью через
API, система ранжируется по 2,400 ключам, имея в среднем всего 200-400 слов уникального текста на страницу."Фильтр" аннулируется, потому что формат шаблона (сканируемые списки, прайсинг, быстрые сравнения) матчит интент юзера точнее, чем лонгриды, что подтверждается сильными поведенческими: 4:12 среднее время на сайте и 38% отказов.
Инъекция Схемы и Таксономия
Стратегия полагается на монополизацию фич выдачи через полный стек
Schema, а не глубину контента.Страницы листинга развертывают
SoftwareApplication, AggregateRating, Offers (для цен) и Organization, а категории юзают ItemList и Breadcrumb.Этот конфиг обеспечивает рич сниппеты для 67% ранжируемых страниц.
Сайт цементирует тематический авторитет через жесткую таксономию из 45 главных категорий, 180 подкатегорий и 340 тегов, сигнализируя краулеру о глубокой структуре.
Автоматизированный контент и Петли свежести
Масштаб достигается через программный движок "
Vs".Более 1,200 страниц сравнения (типа
[Tool A] vs [Tool B]) генерятся автоматически на базе пересечения категорий, таргетируя НЧ (100-500/мес), но с высоким интентом.Чтобы предотвратить протухание статических шаблонов, система автоматизирует сигналы свежести через
API:— Ежедневно: Чеки цен и добавление 2-3 новых тулов.
— Ежечасно: Агрегация отзывов.
— Еженедельно: Апдейты списка фич.
Консолидированная Польза
Вместо написания уникальных обзоров, сайт агрегирует данные с
G2, Capterra и TrustPilot (45,000+ всего отзывов), давая "консенсусный взгляд".Этот
utility-first подход заменяет необходимость в уникальном тексте, доказывая, что в софтовых вертикалях Google награждает консолидированные данные и точные сигналы lastmod выше, чем количество слов.#Programmatic #SchemaOrg #StructuredData
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
👍4❤1🤣1
Я всегда тестирую всю микроразметку четырьмя разными валидаторами, пишет Келли Шеппард:
1. Валидатор `Schema.org
2`.
Я тестирую как до внедрения, так и после.
И вот почему:
✅ Они все выдают разные ошибки:
—
— Тестер
— Тестер
✅ Не все показывают вложенность:
— Визуализация
— У
✅ У всех разные баги:
— У каждого тестера свои баги — вещи, которые работают не совсем так, как должны. Поэтому то, что выглядит как ошибка в одном тестере, может быть абсолютно норм в трех остальных.
✅
#StructuredData #SchemaOrg #RichSnippets
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
1. Валидатор `Schema.org
2`.
Classy Schema 3. Google Rich Results 4. Chrome-расширение SEO Schema Visualizer от Зигги Штросберга (после выкатки)Я тестирую как до внедрения, так и после.
И вот почему:
✅ Они все выдают разные ошибки:
—
Classy Schema отлично подсвечивает лишние скобки и кривой регистр (например, Website вместо WebSite).— Тестер
Google Rich Results показывает, что реально важно Google для попадания в рич сниппеты.— Тестер
Schema.org отлично находит кривое экранирование кавычек в тексте. Например, Here is my description "of that product" сломает разметку, если запихнуть это в описание микроразметки из-за неэкранированных кавычек.✅ Не все показывают вложенность:
— Визуализация
Classy Schema критически важна для моей работы. По связям между нодами я сразу вижу, правильно ли вложена разметка.— У
Ziggy's Schema Visualizer есть контроль глубины, так что я могу сворачивать или разворачивать ноды, чтобы четче видеть связи в массивных кусках разметки. Я также могу менять размер ссылок, силу заряда и размер шрифта. Я вижу уникальное количество ID, сколько у меня нод, и могу скачать визуал. Если ты еще не юзаешь его для микроразметки, качай здесь!✅ У всех разные баги:
— У каждого тестера свои баги — вещи, которые работают не совсем так, как должны. Поэтому то, что выглядит как ошибка в одном тестере, может быть абсолютно норм в трех остальных.
✅
JS на e-commerce сайтах с автоматизацией микроразметки может влиять на то, как Google и LLM читают код. Поэтому важно чекнуть URL через каждый валидатор после выкатки, чтобы убедиться, что они всё нормально парсят.#StructuredData #SchemaOrg #RichSnippets
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

1❤2
💡 Фича по структурированным данным
У твоего бизнеса скорее всего есть:
— Коммерческое название (как тебя знают клиенты)
— Юридическое название (точное имя по докам)
— Аббревиатуры, никнеймы или альтернативные юр. формы (например, Ltd / Limited / Ltd.)
Разметь их все:
Это помогает Гуглу отличать твою сущность от похожих бизнесов и создает консистентный бренд по всем упоминаниям.
Критично, если в названии твоего бизнеса есть общие слова.
#StructuredData #SchemaOrg #OrganizationSchema
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Schema.org!alternateName против legalName — используй оба!У твоего бизнеса скорее всего есть:
— Коммерческое название (как тебя знают клиенты)
— Юридическое название (точное имя по докам)
— Аббревиатуры, никнеймы или альтернативные юр. формы (например, Ltd / Limited / Ltd.)
Разметь их все:
"name": "The Structured Data Company",
"alternateName": ["Structured Data Company", "The Structured Data Company Ltd"],
"legalName": "THE STRUCTURED DATA COMPANY LIMITED"
Это помогает Гуглу отличать твою сущность от похожих бизнесов и создает консистентный бренд по всем упоминаниям.
Критично, если в названии твоего бизнеса есть общие слова.
#StructuredData #SchemaOrg #OrganizationSchema
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
👍4
💡 Совет по микроразметке!
А вы знали, что можно сделать типы сущностей еще точнее с помощью
Нельзя использовать два значения
поскольку это сломает микроразметку и выдаст ошибку дублирования ключа.
Вы можете добавить несколько типов в виде массива (это также работает для
Или используйте
Например, если вы предлагаете автострахование как
Можно пойти еще дальше и использовать
Примечание:
Стоит добавлять там, где это действительно уместно.
Больше контекста = лучшее понимание сущности алгоритмами.
Инсайты SEO-комьюнити
—
—
— Когда в стандартном словаре
#SchemaOrg #StructuredData #EntitySEO
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
А вы знали, что можно сделать типы сущностей еще точнее с помощью
additionalType?Нельзя использовать два значения
@type в одном блоке вот так:"@type": "Product",
"@type": "FinancialProduct"
поскольку это сломает микроразметку и выдаст ошибку дублирования ключа.
Вы можете добавить несколько типов в виде массива (это также работает для
LocalBusiness, так как там additionalType не поддерживается):"@type": ["Product", "FinancialProduct"],
Или используйте
additionalType для дополнительного контекста.Например, если вы предлагаете автострахование как
Product, можно дополнительно разметить его как FinancialProduct:"@type": "Product",
"additionalType": "FinancialProduct"
Можно пойти еще дальше и использовать
Product Ontology, чтобы сослаться на сущность из Википедии для максимальной точности:"additionalType": [
"FinancialProduct",
"http://www.productontology.org/id/Vehicle_insurance"
]
Примечание:
Product Ontology использует HTTP, а не HTTPS — это не опечатка!Стоит добавлять там, где это действительно уместно.
Больше контекста = лучшее понимание сущности алгоритмами.
Инсайты SEO-комьюнити
—
API Google (NlpSemanticParsingLocalBusinessType) напрямую связывает @type из Schema с additionalType, позволяя точнее задавать категорию локального бизнеса, если основная категория соответствует расширенным типам разметки.—
additionalType расширяет микроразметку за пределы словаря Schema.org, поддерживая онтологии вроде telecom и FIBO. Это дает enterprise-проектам возможность указывать сущности с точностью, недоступной стандартным типам Schema.— Когда в стандартном словаре
Schema нет нужного типа (например, Personal Injury Lawyer сводится к базовому LegalService), связка additionalType и ссылок на Википедию через Product Ontology помогает поисковикам и LLM правильно определить контекст сущности.#SchemaOrg #StructuredData #EntitySEO
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
❤3✍2👍1
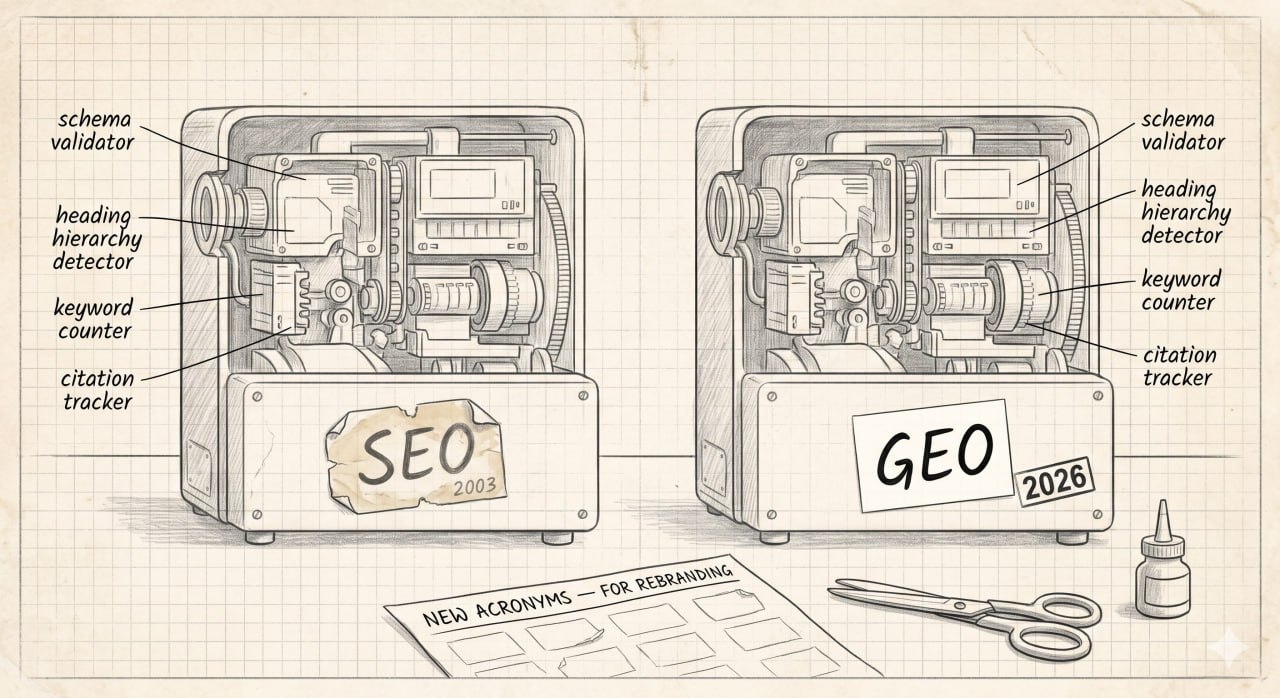
Архитектура LLM опровергает мифы SaaS-вендоров: нейросети не читают микроразметку
Микроразметка якобы гарантирует, что ИИ-поисковики спарсят и поймут ваш контент —
Архитектура доказывает обратное:
Сигналы
Трансформеры обрабатывают язык как последовательности токенов.
Внутри модели нет парсера, который читает теги
Модель читает слова.
Это и есть весь механизм.
На этапе инференса модель генерирует токены на основе входящего текста.
Весь пайплайн извлечения отрабатывает до генерации: документы-кандидаты собираются, бьются на чанки по правилам вендора и отправляются в контекстное окно
Паблишеры не видят этот чанкер: вендоры крутят длину чанков, перекрытие, модели эмбеддингов и семантические границы по собственному скрытому расписанию.
Научная работа по
Максимальный рост видимости дали: добавление ссылок на трастовые источники, цитирование релевантных экспертов, добавление статистики, улучшение читабельности и упрощение восприятия текста — то есть работа с контентом, а не с метаданными.
Переспам ключами (аналог из эпохи SEO) провалился ниже базовой линии.
Они просто не являются поверхностью оптимизации.
Работают только техники, завязанные на текст.
Выводы так и остались в научной статье.
Питч вендоров продается лишь потому, что опирается на ложную предпосылку: якобы недетерминированные генеративные системы работают с той же управляемой причинно-следственной связью, что и классический поиск в прошлом.
Это не так.
Один и тот же промпт выдает разные ответы в зависимости от сессии, юзера, температуры, версии модели и даже дня недели.
Нет никакого жесткого рычага между "я добавил FAQ-разметку" и "модель процитировала мою страницу".
Есть лишь распределение вероятностей, которое невозможно чисто атрибуцировать.
Хотя именно вокруг атрибуции индустрия строилась последние 25 лет.
Главное — можно составить красивый отчет и защитить бюджет.
Сам дашборд становится проблемой, и пока
https://theinference.io/p/the-whole-point-was-the-mess
#SchemaOrg #AI #StructuredData
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Микроразметка якобы гарантирует, что ИИ-поисковики спарсят и поймут ваш контент —
SaaS-вендоры выстроили целую индустрию оптимизации вокруг этого мифа.Архитектура доказывает обратное:
LLM токенизируют текст, а не метаданные.Сигналы
Schema.org питают рич-сниппеты в классической выдаче и формируют Граф Знаний, но они не проникают внутрь модели-трансформера, чтобы улучшить понимание вашего текста.Трансформеры обрабатывают язык как последовательности токенов.
Внутри модели нет парсера, который читает теги
<schema> или отдает приоритет FAQ-разметке.Модель читает слова.
Это и есть весь механизм.
На этапе инференса модель генерирует токены на основе входящего текста.
Весь пайплайн извлечения отрабатывает до генерации: документы-кандидаты собираются, бьются на чанки по правилам вендора и отправляются в контекстное окно
LLM.Паблишеры не видят этот чанкер: вендоры крутят длину чанков, перекрытие, модели эмбеддингов и семантические границы по собственному скрытому расписанию.
Научная работа по
GEO (Аггарвал и соавторы, KDD 2024) протестировала девять методов оптимизации на бенчмарке из 10 000 запросов.Максимальный рост видимости дали: добавление ссылок на трастовые источники, цитирование релевантных экспертов, добавление статистики, улучшение читабельности и упрощение восприятия текста — то есть работа с контентом, а не с метаданными.
Переспам ключами (аналог из эпохи SEO) провалился ниже базовой линии.
Schema, микроразметка, разметка FAQ, иерархия заголовков и машиночитаемые форматы вообще не тестировались.Они просто не являются поверхностью оптимизации.
Работают только техники, завязанные на текст.
SaaS-индустрия тупо позаимствовала аббревиатуру.Выводы так и остались в научной статье.
Питч вендоров продается лишь потому, что опирается на ложную предпосылку: якобы недетерминированные генеративные системы работают с той же управляемой причинно-следственной связью, что и классический поиск в прошлом.
Это не так.
Один и тот же промпт выдает разные ответы в зависимости от сессии, юзера, температуры, версии модели и даже дня недели.
Нет никакого жесткого рычага между "я добавил FAQ-разметку" и "модель процитировала мою страницу".
Есть лишь распределение вероятностей, которое невозможно чисто атрибуцировать.
Хотя именно вокруг атрибуции индустрия строилась последние 25 лет.
SaaS заполняет дыру в видимости фейковыми рычагами: хабами контента, фреймворками, процентами роста, аудитами чанкинга и машиночитаемыми форматами.Главное — можно составить красивый отчет и защитить бюджет.
Сам дашборд становится проблемой, и пока
SEO-специалисты это замечают, вендор уже выкатывает новый бриф.https://theinference.io/p/the-whole-point-was-the-mess
#SchemaOrg #AI #StructuredData
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤1
Микроразметка LocalBusiness не влияет на позиции в Google — профит выдает только ChatGPT
В ходе 10-недельного контролируемого теста микроразметку вычистили с 29 клиентских доменов, разбили их на гео-сопоставимые контрольную и тестовую группы, а затем внедрили продвинутую микроразметку
Статзначимость измеряли односторонним
Порог статзначимости в 90% отделял реальные выводы от шума.
В десктопном и мобильном Google,
В
Единственной поисковой системой, показавшей хоть какой-то сигнал, стал
Настоящий разрыв происходит на уровне
А вот
Почему
Фокус исследования специально заузили: одна ниша (локальные бизнесы с выездом к клиенту), один тип микроразметки, только главная страница, никаких
Микроразметка по-прежнему критична там, где Гугл опирается на нее для рендера выдачи — списки вакансий, отели и билеты, а также товарная разметка для органического
Но споры, где микроразметка считается фактором ранжирования, направлены не на ту систему.
https://evergrowmarketing.com/how-schema-affects-google-and-ai/
#LocalBusinessSchema #ChatGPT #StructuredData
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
В ходе 10-недельного контролируемого теста микроразметку вычистили с 29 клиентских доменов, разбили их на гео-сопоставимые контрольную и тестовую группы, а затем внедрили продвинутую микроразметку
LocalBusiness только на главные страницы тестовых сайтов.Статзначимость измеряли односторонним
t-критерием Уэлча для двух независимых выборок, при этом ревьюеры (включая Ярно ван Дриеля, Moz и Yoast) валидировали методологию еще до получения результатов.Порог статзначимости в 90% отделял реальные выводы от шума.
В десктопном и мобильном Google,
Bing и Yahoo микроразметка LocalBusiness не дала никакого прироста ни в позициях, ни в поисковой видимости.В
Google Maps всё оказалось еще хуже: контрольная группа обошла тестовую как по среднему ранжированию, так и по Share of Local Voice, поэтому t-критерий даже не пришлось применять.Единственной поисковой системой, показавшей хоть какой-то сигнал, стал
Yahoo, но статзначимость осталась ниже 85%.Настоящий разрыв происходит на уровне
LLM.Google AI Mode, AI Overviews, Gemini и Grok выдали результаты на уровне подбрасывания монетки (статзначимость 50–60%).А вот
ChatGPT оторвался от остальных: статзначимость 92,91% доказала, что микроразметка LocalBusiness улучшила позицию в рекомендациях на 3,33 пункта; и со статзначимостью 91,51% — что она увеличила частоту цитирования бренда в ChatGPT на 10 процентных пунктов.Почему
ChatGPT взвешивает микроразметку именно так — неизвестно; тест фиксирует эффект, а не причину.Фокус исследования специально заузили: одна ниша (локальные бизнесы с выездом к клиенту), один тип микроразметки, только главная страница, никаких
rich snippets.Микроразметка по-прежнему критична там, где Гугл опирается на нее для рендера выдачи — списки вакансий, отели и билеты, а также товарная разметка для органического
Shopping.Но споры, где микроразметка считается фактором ранжирования, направлены не на ту систему.
https://evergrowmarketing.com/how-schema-affects-google-and-ai/
#LocalBusinessSchema #ChatGPT #StructuredData
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤1
Неоправданно странный SEO-совет: читайте документацию по микроразметке с конца.
Обычно мы сначала собираем страницу, а потом решаем, какие типы и свойства
Но документация также отлично подсвечивает, чего на странице не хватает.
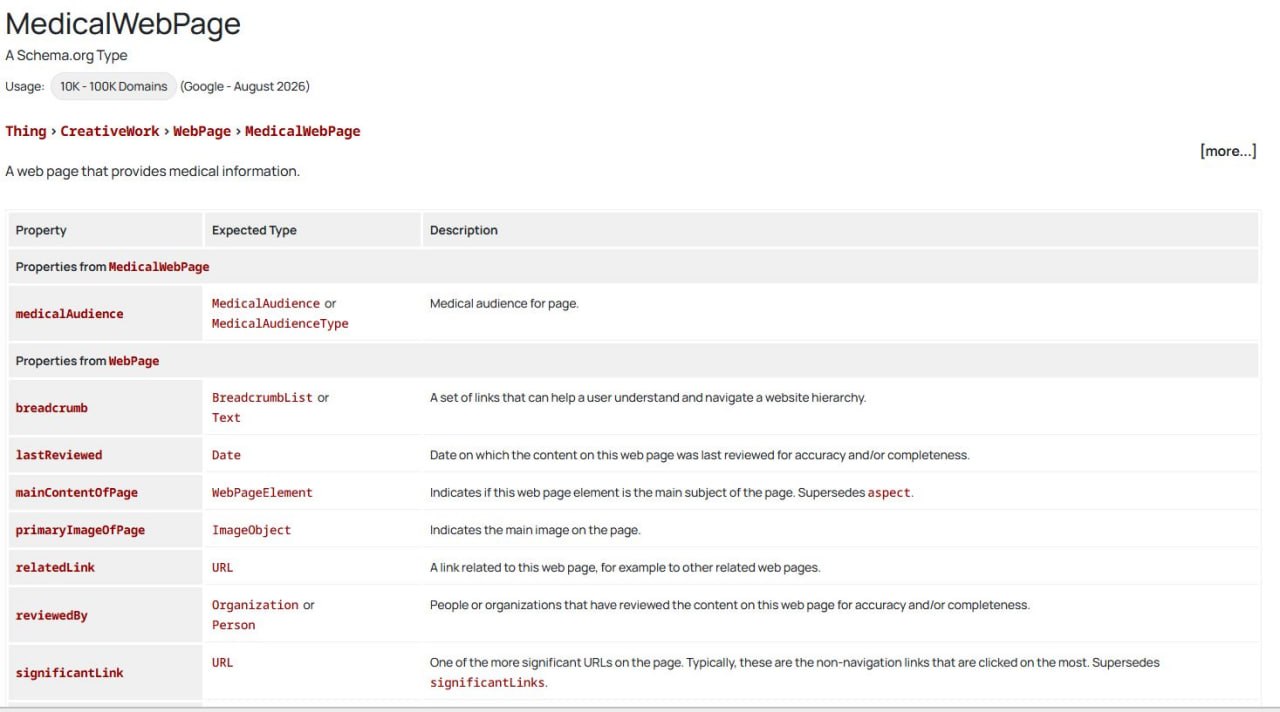
Много лет назад мы работали над медицинским сайтом, где контент писали не врачи, но врачи его проверяли.
Изучение документации
Проверка и так проводилась.
Мы просто не показывали это читателям.
Это важное различие.
Тот, кто пишет текст, и тот, кто проверяет его медицинскую точность — это две разные роли.
Страница может закрывать обе.
Попробуйте сами: Найдите релевантный тип на
Прочитайте все его свойства.
Спросите себя, какие из них вызывают вопросы, на которые ваша страница не отвечает.
Кто проверил этот материал?
Когда его обновляли в последний раз?
Какие источники это подтверждают?
Для кого он предназначен?
Вот вам и готовые пункты для следующего ТЗ на контент.
Понятно, что само наличие свойства не обязывает его использовать.
И добавление имени проверяющего не даст волшебного буста в ранжировании.
Проверка должна быть реальной, а информация — полезной.
Но в этой документации полно зацепок, которые помогут сделать страницу лучше еще до того, как вы напишете первую строчку
Максимально задротское место, где можно найти на удивление практичную идею для контента.
#ContentOptimization #SchemaOrg #StructuredData
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Обычно мы сначала собираем страницу, а потом решаем, какие типы и свойства
Schema описывают её содержимое, отмечает Уоррен Хэнс.Но документация также отлично подсвечивает, чего на странице не хватает.
Много лет назад мы работали над медицинским сайтом, где контент писали не врачи, но врачи его проверяли.
Изучение документации
Schema подкинуло простую идею добавить на страницу блок: "Проверено медицинским специалистом".Проверка и так проводилась.
Мы просто не показывали это читателям.
Это важное различие.
Тот, кто пишет текст, и тот, кто проверяет его медицинскую точность — это две разные роли.
Страница может закрывать обе.
Попробуйте сами: Найдите релевантный тип на
schema.org.Прочитайте все его свойства.
Спросите себя, какие из них вызывают вопросы, на которые ваша страница не отвечает.
Кто проверил этот материал?
Когда его обновляли в последний раз?
Какие источники это подтверждают?
Для кого он предназначен?
Вот вам и готовые пункты для следующего ТЗ на контент.
Понятно, что само наличие свойства не обязывает его использовать.
И добавление имени проверяющего не даст волшебного буста в ранжировании.
Проверка должна быть реальной, а информация — полезной.
Но в этой документации полно зацепок, которые помогут сделать страницу лучше еще до того, как вы напишете первую строчку
JSON-LD.Максимально задротское место, где можно найти на удивление практичную идею для контента.
#ContentOptimization #SchemaOrg #StructuredData
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO