Код 499 в логах Nginx убивает цитируемость сайта в ответах AI
Когда
Для сайтов, работающих на серверах
В этих сценариях реального времени
Решает только ваш
Если ваш сервер слишком медленно отвечает,
И это не тихий провал.
Эта прерванная попытка логируется как код состояния
Вам нужно работать со своими инженерами по надежности сайта (SRE), чтобы мониторить именно эти ошибки.
Отслеживание кодов
#ServerResponse #LogFileAnalysis #RAG
@MikeBlazerX
Пушки — в @MikeBlazerPRO
Когда
AI-система выполняет RAG-запрос в реальном времени, скорость — это не опция, это требование.Для сайтов, работающих на серверах
Nginx, есть конкретный криминалистический сигнал, который показывает, когда ваша инфраструктура проваливает этот тест, детализирует Джейми Индиго.В этих сценариях реального времени
AI-бот действует от имени пользователя и ждать не может.Решает только ваш
TTFB.Если ваш сервер слишком медленно отвечает,
LLM просто забивает и закрывает соединение.И это не тихий провал.
Эта прерванная попытка логируется как код состояния
499 Client Closed Request.Вам нужно работать со своими инженерами по надежности сайта (SRE), чтобы мониторить именно эти ошибки.
Отслеживание кодов
499 позволяет точно определить, когда и где время ответа вашего сервера становится прямым узким местом, из-за которого вы теряете ценные цитирования в AI-ответах и пользовательский трафик, который за ними следует.#ServerResponse #LogFileAnalysis #RAG
@MikeBlazerX
Пушки — в @MikeBlazerPRO
Десктопный бот GoogleOther — это скрытый агент, который кормит данными Gemini 3
Ежедневный анализ логов сервера подтвердил, что Google развернул скрытый движок для своего
Паттерн краулинга семейства
Мои логи показывают, что мобильный бот
Это не новое изобретение; это проверенная архитектура краулинга, перепрофилированная специально для поглощения данных ИИ.
Это изменение — не совпадение.
Новый десктопный рендер-бот начал появляться примерно 20 ноября 2023 года.
Это идеально совпадает с заморозкой отчета о покрытии в
Гуглу нужен был экономически эффективный способ кормить свой ИИ полностью отрендеренным, динамическим контентом, и вместо того, чтобы создавать новый краулер с нуля, он расширил семейство
Это открывает четкий тактический вектор.
Теперь вы должны относиться к десктопному юзер-агенту
Заход этого конкретного агента — прямое подтверждение, что ваш полностью отрендеренный контент обнаружен и анализируется для поглощения в
Критически важно не блокировать этого краулера, как некоторые вебмастера делали ранее из-за его кажущейся агрессивности.
Чтобы это заюзать, сделайте приоритетом полную доступность ваших страниц с тяжелым
Если технически возможно, переход на серверный рендеринг (SSR) — самая прямая стратегия для обеспечения максимальной доступности контента для этого нового ИИ-рендеринг агента.
Есть и контринтуитивная гипотеза: многолетнее давление Гугла на
Улучшение отклика сервера специально для этих краулеров
#Gemini #LogFileAnalysis #SSR
@MikeBlazerX
☠️ Black Hat — в @MikeBlazerPRO
Ежедневный анализ логов сервера подтвердил, что Google развернул скрытый движок для своего
Gemini 3, и это система, которую вы уже видели, раскрывает Кэролин Хольцман.Паттерн краулинга семейства
GoogleOther теперь в точности повторяет двухпроходную систему, которую использовал основной Googlebot до полного перехода на mobile-first индексацию.Мои логи показывают, что мобильный бот
GoogleOther выполняет первоначальный проход по сырому HTML, в то время как новый десктопный бот GoogleOther делает второй, более критичный, проход с рендерингом JavaScript.Это не новое изобретение; это проверенная архитектура краулинга, перепрофилированная специально для поглощения данных ИИ.
Это изменение — не совпадение.
Новый десктопный рендер-бот начал появляться примерно 20 ноября 2023 года.
Это идеально совпадает с заморозкой отчета о покрытии в
Google Search Console 17 ноября и официальным запуском Gemini 3 18 ноября.Гуглу нужен был экономически эффективный способ кормить свой ИИ полностью отрендеренным, динамическим контентом, и вместо того, чтобы создавать новый краулер с нуля, он расширил семейство
GoogleOther для выполнения этой роли.Это открывает четкий тактический вектор.
Теперь вы должны относиться к десктопному юзер-агенту
GoogleOther как к основному сигналу.Заход этого конкретного агента — прямое подтверждение, что ваш полностью отрендеренный контент обнаружен и анализируется для поглощения в
Gemini 3.Критически важно не блокировать этого краулера, как некоторые вебмастера делали ранее из-за его кажущейся агрессивности.
Чтобы это заюзать, сделайте приоритетом полную доступность ваших страниц с тяжелым
JavaScript для десктопных рендер-краулов.Если технически возможно, переход на серверный рендеринг (SSR) — самая прямая стратегия для обеспечения максимальной доступности контента для этого нового ИИ-рендеринг агента.
Есть и контринтуитивная гипотеза: многолетнее давление Гугла на
Core Web Vitals, возможно, было подготовительной мерой к ресурсоемкому краулингу, необходимому для ИИ.Улучшение отклика сервера специально для этих краулеров
GoogleOther теперь является критически важной задачей, так как быстрые ответы помогают Гуглу эффективно процессить страницы для поглощения ИИ, что напрямую влияет на вашу видимость в поиске, управляемом ИИ.#Gemini #LogFileAnalysis #SSR
@MikeBlazerX
☠️ Black Hat — в @MikeBlazerPRO
❤1
Сигнал "Browser Exit" роняет бренд с Топ-1 на 11-ю страницу
Анализ идентифицирует "выход из браузера" (закрытие браузера сразу после просмотра лендинга) как сигнал негатива, который значительно мощнее стандартного возврата в выдачу (bounce).
Если отказ подразумевает возврат в Google (удержание юзера внутри экосистемы поиска), то
У меня на руках данные
Механизм пессимизации завязан на прерывании "Цепочки Монетизации".
Поисковики и агрегаторы приоритизируют потоки трафика, поддерживающие рекламный потенциал; закрытие браузера отрезает этот поток кэша.
Следовательно, алгоритм понижает сайты, которые не могут удержать юзера в экосистеме монетизации, трактуя выход как неспособность дестинейшена удовлетворить или монетизировать интент.
#LogFileAnalysis #UserSignals #BounceRate
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Анализ идентифицирует "выход из браузера" (закрытие браузера сразу после просмотра лендинга) как сигнал негатива, который значительно мощнее стандартного возврата в выдачу (bounce).
Если отказ подразумевает возврат в Google (удержание юзера внутри экосистемы поиска), то
browser exit обрывает сессию полностью.У меня на руках данные
GSC, доказывающие: когда этот специфический сигнал накапливается на брендовых страницах, основные ключи улетают с Позиции 1 на 11-ю страницу, палит Лео Сулас.Механизм пессимизации завязан на прерывании "Цепочки Монетизации".
Поисковики и агрегаторы приоритизируют потоки трафика, поддерживающие рекламный потенциал; закрытие браузера отрезает этот поток кэша.
Следовательно, алгоритм понижает сайты, которые не могут удержать юзера в экосистеме монетизации, трактуя выход как неспособность дестинейшена удовлетворить или монетизировать интент.
#LogFileAnalysis #UserSignals #BounceRate
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
🤣16
Отлив платного трафика заставляет гуглобота преследовать Ads Bot и бустит позиции
Логи раскрывают прямой механизм: гуглобот физически следует по пятам за ботом
Аудит серверов подтверждает, что масштабирование бюджета
Так как алгоритм юзает активность
Эта зависимость дает возможность использовать платный трафик тупо для манипуляции органическим краулингом.
Принудительная частота обхода ускоряет циклы индексации и искусственно накачивает траст алгоритма к целевому
Данные показывают: такой разгон визитов гуглобота напрямую бустит позиции в органике, фактически конвертируя рекламный бюджет в сигнал приоритетного краулинга.
#LogFileAnalysis #CrawlBudget #SEM
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Логи раскрывают прямой механизм: гуглобот физически следует по пятам за ботом
Google Ads на целевых доменах, объясняет Джеймс Оуэн.Аудит серверов подтверждает, что масштабирование бюджета
PPC на конкретных URL заставляет Ads Bot непрерывно пинговать эти таргеты.Так как алгоритм юзает активность
Ads-бота как сигнал приоритета для краулинга, гуглобот идет ровно по тому же маршруту.Эта зависимость дает возможность использовать платный трафик тупо для манипуляции органическим краулингом.
Принудительная частота обхода ускоряет циклы индексации и искусственно накачивает траст алгоритма к целевому
URL.Данные показывают: такой разгон визитов гуглобота напрямую бустит позиции в органике, фактически конвертируя рекламный бюджет в сигнал приоритетного краулинга.
#LogFileAnalysis #CrawlBudget #SEM
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
❤1
Смена User-Agent в логах сервера палит начало Core Update за неделю до анонса
Вы должны быть предельно осторожны с официальными датами анонсов
Мы видели значительные сдвиги в позициях за неделю до того, как апдейт вообще анонсировали, а волатильность может продолжаться до месяца после того, как Google заявляет о завершении выкатки, так что вас может зацепить уже после того, как они отрапортовали об окончании, предупреждает Тед Кубайтис.
Более надежный опережающий индикатор можно найти в ваших серверных логах.
Резкое изменение в паттерне краулинга Гуглобота — это сильный сигнал о том, что развертывание крупного апдейта неизбежно, часто опережающий официальный анонс на 7-10 дней.
С нашей точки зрения, процессинг начинается задолго до того, как об этом сообщают публике, раскрывает Ли Уитчер.
Мы даже наблюдали повторяющийся
Новые версии Гуглобота часто выкатываются по четвергам около 4
Как только апдейт начался, вы можете отслеживать его ход, мониторя самих ботов, отмечает Ли Уитчер.
Типичный паттерн — это первоначальная выкатка "бота-анонсера", за которым следует совершенно другая версия бота примерно через неделю-10 дней.
Помимо серверных логов, мы используем подход "канарейки в угольной шахте", чтобы получить раннее предупреждение о конкретных алгоритмических изменениях, объясняет Тед Кубайтис.
Это включает в себя создание и отслеживание позиций страниц, которые намеренно используют черные или спамные тактики, которые Google, в теории, должен штрафовать.
У нас есть целая когорта таких "канареечных" страниц, созданных с переспамом ключевыми словами, скрытым текстом в
Если группа таких страниц внезапно вылетает из индекса, это дает сильный, ранний сигнал о том, что Google наконец-то выкатил алгоритмическое обновление, нацеленное на эту конкретную тактику.
#CoreUpdates #LogFileAnalysis #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Вы должны быть предельно осторожны с официальными датами анонсов
core-апдейтов от Google, так как они являются ненадежными индикаторами того, когда на самом деле прилетит эффект.Мы видели значительные сдвиги в позициях за неделю до того, как апдейт вообще анонсировали, а волатильность может продолжаться до месяца после того, как Google заявляет о завершении выкатки, так что вас может зацепить уже после того, как они отрапортовали об окончании, предупреждает Тед Кубайтис.
Более надежный опережающий индикатор можно найти в ваших серверных логах.
Резкое изменение в паттерне краулинга Гуглобота — это сильный сигнал о том, что развертывание крупного апдейта неизбежно, часто опережающий официальный анонс на 7-10 дней.
С нашей точки зрения, процессинг начинается задолго до того, как об этом сообщают публике, раскрывает Ли Уитчер.
Мы даже наблюдали повторяющийся
DevOps-паттерн, который может помочь вам предвидеть эти изменения.Новые версии Гуглобота часто выкатываются по четвергам около 4
PM по восточному времени (ET), что дает еще один потенциальный сигнал, за которым стоит следить, добавляет Чарльз Тейлор.Как только апдейт начался, вы можете отслеживать его ход, мониторя самих ботов, отмечает Ли Уитчер.
Типичный паттерн — это первоначальная выкатка "бота-анонсера", за которым следует совершенно другая версия бота примерно через неделю-10 дней.
Помимо серверных логов, мы используем подход "канарейки в угольной шахте", чтобы получить раннее предупреждение о конкретных алгоритмических изменениях, объясняет Тед Кубайтис.
Это включает в себя создание и отслеживание позиций страниц, которые намеренно используют черные или спамные тактики, которые Google, в теории, должен штрафовать.
У нас есть целая когорта таких "канареечных" страниц, созданных с переспамом ключевыми словами, скрытым текстом в
div'ах, белым текстом на белом фоне и даже lorem ipsum, заточенным под ключи.Если группа таких страниц внезапно вылетает из индекса, это дает сильный, ранний сигнал о том, что Google наконец-то выкатил алгоритмическое обновление, нацеленное на эту конкретную тактику.
#CoreUpdates #LogFileAnalysis #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Логи WebSocket фиксируют: ChatGPT Deep Research читает исходный код строго сверху вниз, а навигация съедает бюджет
Запись логов в
Бот читает
Порядок в исходном коде решает, что влезет в лимит, а не позиция на экране: меню, которое
Это первое чтение ограничено ~5700 символами (медиана, максимум — ~8000).
Каждая ссылка отрисовывается инлайн как маркер
Метрика по количеству ссылок: до 20 ссылок оставляет ~78% лимита под ваш контент; 20-59 ссылок (стандарт для большинства страниц) снижает долю до ~55%; 60+ ссылок оставляет всего ~33% — две трети лимита сжирают меню до того, как агент дойдет до ответа.
Ссылка "
Всё управляется тремя командами:
Успешный
Если искомого термина нет на странице буквально, агент пробует другой ключ или уходит; поэтому точное вхождение слова в тексте гарантирует второе чтение.
Ещё два рычага, которые упускает большинство команд.
Атрибуты
Данные тянет юзер-агент
Блокировка в
Механика (поиск через Bing, три команды, ноль кликов, лимит окна, чтение альтов) фиксируется стабильно; точные цифры — это срез на июнь 2026 года для платформы, которую
https://peec.ai/blog/how-chatgpt-deep-research-reads-your-site-what-the-logs-reveal
#ChatGPT #LogFileAnalysis #Bots
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Deep Research транслирует всю свою сессию обратно клиенту через WebSocket: каждый запрос, каждую открытую страницу, вытянутый сырой текст и цепочку рассуждений.Запись логов в
DevTools с 10+ аккаунтов (по ~20 запросов на каждом) вскрывает, как именно читает агент и на чем сайты теряют это чтение.Бот читает
HTML строго линейно сверху вниз: выкидывает <head>, игнорирует JavaScript.Порядок в исходном коде решает, что влезет в лимит, а не позиция на экране: меню, которое
CSS отрисовывает наверху, но висящее в конце кода, не стоит ничего; а ответ, зарытый после массивного блока навигации, может вообще не попасть в первое чтение.Это первое чтение ограничено ~5700 символами (медиана, максимум — ~8000).
Каждая ссылка отрисовывается инлайн как маркер
【n†anchor†url】, который тратит тот же бюджет.Метрика по количеству ссылок: до 20 ссылок оставляет ~78% лимита под ваш контент; 20-59 ссылок (стандарт для большинства страниц) снижает долю до ~55%; 60+ ссылок оставляет всего ~33% — две трети лимита сжирают меню до того, как агент дойдет до ответа.
Ссылка "
Skip to main content" не спасает: для ее активации нужен клик, а Deep Research не кликает вообще (команда click использовалась ровно ноль раз за все записанные сессии).Всё управляется тремя командами:
search (читает сниппеты Bing через webwithbing, никакого Google), open (беглое чтение) и find (Ctrl+F внутри открытой страницы).Успешный
find — главный триггер перечитывания; в 95% случаев выборки страница открывается заново ровно на найденной строке.Если искомого термина нет на странице буквально, агент пробует другой ключ или уходит; поэтому точное вхождение слова в тексте гарантирует второе чтение.
Ещё два рычага, которые упускает большинство команд.
Атрибуты
alt отрисовываются как обычный текст — это единственное, что бот читает из картинок: бейдж с прописанным альтом закидывает факт прямо в ответ, тогда как alt="" пропускается как декор.Данные тянет юзер-агент
OAI-SearchBot, он работает отдельно от GPTBot (сбор данных для обучения моделей); разблокировка одного ничего не дает другому.Блокировка в
robots.txt отдает боту viewing lines [0 - 0] of 0: ноль контента, и страница молча выпадает из финального отчета.Механика (поиск через Bing, три команды, ноль кликов, лимит окна, чтение альтов) фиксируется стабильно; точные цифры — это срез на июнь 2026 года для платформы, которую
OpenAI постоянно обновляет.https://peec.ai/blog/how-chatgpt-deep-research-reads-your-site-what-the-logs-reveal
#ChatGPT #LogFileAnalysis #Bots
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

🔥1🌚1
ИИ-краулинг и трафик расходятся — главные страницы забирают в 15 раз больше ботов, а услуги получают х3 визитов
Анализ 560 695 запросов ИИ-краулеров по 74 аккаунтам
Главные страницы получают примерно в 15 раз больше ИИ-краулинга, чем предсказывает их доля в структуре урлов.
С поправкой на то, что главная — это одна страница против десятков или сотен других, цифры просто зашкаливают: ничего похожего и близко нет.
Вывод переворачивает привычный вопрос: где публиковать теперь важнее того, что публиковать.
Хочешь, чтобы ИИ узнал что-то о бренде — вешай это на главную.
Объем сайта почти идеально коррелирует со вниманием ИИ — корреляция 0.86 между общим числом урлов и запросами краулеров, без просадок и без эффекта сложного процента при масштабировании.
Больше страниц — больше точек входа для совпадения с промптами.
Впрочем, корреляция не абсолютная: некоторые сайты на 50 страниц собирают столько же запросов, сколько и тысячники.
Скорее всего, дело в сильном присутствии бренда в обучающих данных или лучшей оптимизации страниц.
Трафик показывает картину резче, чем краулинг, хотя данные по переходам взяты из меньшей выборки в 27 сайтов на тарифе
Страницы услуг и товаров собирают в среднем в 3 раза больше ИИ-трафика на страницу, чем типичная статья.
ИИ читает и суммаризирует статьи, но по реферальным переходам они проигрывают главным страницам почти на 20%.
Это
При этом 47% всех страниц в датасете сгенерировали ноль переходов.
Глубина папок накладывает налог на архитектуру.
ИИ-краулеры без проблем находят страницы на третьем-четвертом уровне вложенности, но в реферальных данных тарифа
Паттерн сохраняется независимо от размера сайта и типа страниц.
Это корреляция, а не причинно-следственная связь — если просто вытащить страницу выше, это не нальет ей ИИ-трафика автоматом.
Но при запуске нового проекта или переезде держать ключевые услуги в одном-двух кликах от главной — это железобетонная тактика.
#LogFileAnalysis #Crawling #AI
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Анализ 560 695 запросов ИИ-краулеров по 74 аккаунтам
Cloudflare и 446 267 реферальных переходов от ИИ на 27 аккаунтах с тарифом Pro раскрывает разрыв, который бренды оптимизируют вслепую: то, что ИИ читает, и то, куда он отправляет живых юзеров — это два разных паттерна.Cloudflare стоит до GA4, поэтому реферальные переходы — это реальные клики, а не просто цитации.Главные страницы получают примерно в 15 раз больше ИИ-краулинга, чем предсказывает их доля в структуре урлов.
С поправкой на то, что главная — это одна страница против десятков или сотен других, цифры просто зашкаливают: ничего похожего и близко нет.
Вывод переворачивает привычный вопрос: где публиковать теперь важнее того, что публиковать.
Хочешь, чтобы ИИ узнал что-то о бренде — вешай это на главную.
Объем сайта почти идеально коррелирует со вниманием ИИ — корреляция 0.86 между общим числом урлов и запросами краулеров, без просадок и без эффекта сложного процента при масштабировании.
Больше страниц — больше точек входа для совпадения с промптами.
Впрочем, корреляция не абсолютная: некоторые сайты на 50 страниц собирают столько же запросов, сколько и тысячники.
Скорее всего, дело в сильном присутствии бренда в обучающих данных или лучшей оптимизации страниц.
Трафик показывает картину резче, чем краулинг, хотя данные по переходам взяты из меньшей выборки в 27 сайтов на тарифе
Pro, так что воспринимай их как вектор.Страницы услуг и товаров собирают в среднем в 3 раза больше ИИ-трафика на страницу, чем типичная статья.
ИИ читает и суммаризирует статьи, но по реферальным переходам они проигрывают главным страницам почти на 20%.
Это
Dark Library Effect — та же динамика нулевых поисков, которая перекроила классический поиск: юзеры с информационным интентом получают ответ прямо в выдаче и не кликают, тогда как коммерческий интент всё ещё заставляет людей переходить на главную или страницы услуг перед покупкой.При этом 47% всех страниц в датасете сгенерировали ноль переходов.
Глубина папок накладывает налог на архитектуру.
ИИ-краулеры без проблем находят страницы на третьем-четвертом уровне вложенности, но в реферальных данных тарифа
Pro виден жесткий обвал: страница в трех папках от корня собирает около четверти ожидаемого ИИ-трафика, а на четвертом уровне эта цифра падает почти до нуля.Паттерн сохраняется независимо от размера сайта и типа страниц.
Это корреляция, а не причинно-следственная связь — если просто вытащить страницу выше, это не нальет ей ИИ-трафика автоматом.
Но при запуске нового проекта или переезде держать ключевые услуги в одном-двух кликах от главной — это железобетонная тактика.
#LogFileAnalysis #Crawling #AI
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

👻1
Логи Google Analytics палят заходы из RaterHub за 48 часов до ручника от Гугла
Мониторинг логов реф-трафика в
Алгоритм автоматически флагает
Когда беттинг-сайт
Асессоры прицельно проверили урлы
В течение 48 часов в
Дули отмечает: более 90% сайтов с визитами из
При этом, пока практики списывают
Чтобы нейтрализовать этот фильтр, сайтам нужно выкатить выделенную инфраструктуру — подтвержденные авторы, четкие даты публикаций, физические адреса и доступные контакты закроют чек-лист асессора до того, как проверка обернется санкциями.
#ManualActions #LogFileAnalysis #EEAT
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Мониторинг логов реф-трафика в
Google Analytics на предмет raterhub вскрывает ручные санкции за 24–48 часов до их прилета, раскрывает Джеймс Дули.Алгоритм автоматически флагает
YMYL-сайты под ручную проверку ровно в тот момент, когда они забирают первую страницу по ВЧ-запросам.Когда беттинг-сайт
awaygrounds.com прыгнул на 7 позицию по ключу "bet365", трафик из RaterHub сразу же всплыл в логах.Асессоры прицельно проверили урлы
/about, /meet-the-team и /privacy-policy.В течение 48 часов в
GSC прилетел хостовый ручник "Transparency" с пометкой об отсутствии данных авторов, информации о сетке паблишера и контактов.Дули отмечает: более 90% сайтов с визитами из
RaterHub в логах в итоге ловят санкции.При этом, пока практики списывают
E-E-A-T на алгоритмическую шелуху, эти структурные страницы работают как бетонный щит от ручной проверки.Чтобы нейтрализовать этот фильтр, сайтам нужно выкатить выделенную инфраструктуру — подтвержденные авторы, четкие даты публикаций, физические адреса и доступные контакты закроют чек-лист асессора до того, как проверка обернется санкциями.
#ManualActions #LogFileAnalysis #EEAT
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
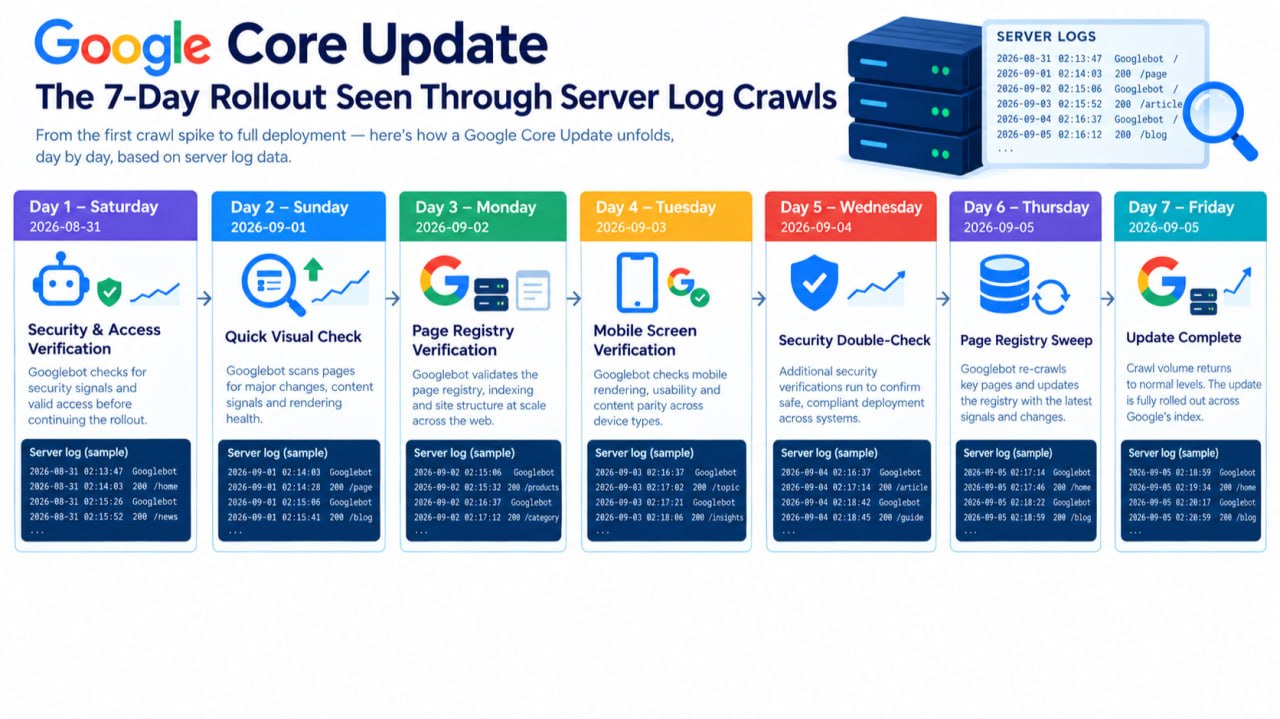
Логи серверов на четырех доменах вскрывают синхронизированную выкатку кор-апдейта, которую Google не анонсировал
Был ли этот гэп задержкой индексации, багом выдачи или чем-то локальным — оставалось загадкой.
Сырые данные логов серверов с четырех доменов из одного портфеля задокументировали пошаговую хронологию, которую дашборд не показал.
На фоне этой заморозки краулинг с рендером систематически пробивал каждый домен в портфеле, и таймлайн логов по всем четырем сайтам совпадает на 100% — ежедневные этапы синхронны, несмотря на абсолютно разные профили и архитектуру площадок.
Эта идентичность доказывает автоматизированную, централизованную выкатку, а не четыре независимых алгоритмических всплеска; она опровергает привычную установку, что кор-апдейт — это непредсказуемое событие, заметное только постфактум.
Что реально отличалось между четырьмя сайтами, так это вычислительный налог: мощности сервера, затраченные на парсинг контента, радикально разнились в зависимости от архитектуры, хотя анализ не дает точных цифр этого разброса.
3 сентября стал пиком.
Предлагаемое объяснение этого рассинхрона — физическая задержка при миграции гугловских конвейеров данных на фоне лайв-выкатки кор-апдейта; логи фиксируют совпадение по времени, но не подтверждают саму механику.
К 4 сентября логи зафиксировали возобновление нормального краулинга и снятие заморозки.
Один артефакт выбивается из этого таймлайна.
30 августа
Синхронизированный таймлайн логов, снятый с разнородного портфеля, а не с одного сайта — вот что сделало теневую выкатку читаемой прямо в процессе её исполнения.
#CoreUpdates #LogFileAnalysis #Crawling
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Google Search Status Dashboard показывал "Нет инцидентов", пока паблишеры фиксировали проблему с индексацией, начавшуюся примерно 1 сентября 2026 года.Был ли этот гэп задержкой индексации, багом выдачи или чем-то локальным — оставалось загадкой.
Сырые данные логов серверов с четырех доменов из одного портфеля задокументировали пошаговую хронологию, которую дашборд не показал.
Google Web Rendering Service был заморожен с 25 августа 2026 года.На фоне этой заморозки краулинг с рендером систематически пробивал каждый домен в портфеле, и таймлайн логов по всем четырем сайтам совпадает на 100% — ежедневные этапы синхронны, несмотря на абсолютно разные профили и архитектуру площадок.
Эта идентичность доказывает автоматизированную, централизованную выкатку, а не четыре независимых алгоритмических всплеска; она опровергает привычную установку, что кор-апдейт — это непредсказуемое событие, заметное только постфактум.
Что реально отличалось между четырьмя сайтами, так это вычислительный налог: мощности сервера, затраченные на парсинг контента, радикально разнились в зависимости от архитектуры, хотя анализ не дает точных цифр этого разброса.
3 сентября стал пиком.
Page Registry Sweeps и Live Layout/Deep Code Audits достигли максимума по всему портфелю в тот же день, когда паблишеры рапортовали, что свежие статьи всплывают во вкладке новостей, исчезают, а затем возвращаются около 16:00 ET, тогда как веб-поиск всё это время отдавал их без сбоев.Предлагаемое объяснение этого рассинхрона — физическая задержка при миграции гугловских конвейеров данных на фоне лайв-выкатки кор-апдейта; логи фиксируют совпадение по времени, но не подтверждают саму механику.
К 4 сентября логи зафиксировали возобновление нормального краулинга и снятие заморозки.
Один артефакт выбивается из этого таймлайна.
30 августа
Googlebot Mobile и GoogleOther с разницей в несколько часов обновили сборку Chrome до Chrome/151.0.7922.173, и оба сидели на этом билде по состоянию на 7 сентября 2026 года, 16:00 CDT.Синхронизированный таймлайн логов, снятый с разнородного портфеля, а не с одного сайта — вот что сделало теневую выкатку читаемой прямо в процессе её исполнения.
#CoreUpdates #LogFileAnalysis #Crawling
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
🎄1
Статистика сканирования в GSC раскрывает запросы Googlebot, которые CDN поглощает до основного сервера
Выгрузка логов основного сервера за 40 дней для крупного
То есть около 88% оказались сканерами, подделывающими
В сухом остатке — порядка 5 600 правдоподобно реальных обращений
Остальная часть выгрузки выглядела не лучше: 76 377 из 76 381 событий
А набор
Согласно Джону Мюллеру: бери для работы меньшую подвыборку (поддомен, если есть), затем сравнивай запросы на краулинг в
Идеально не будет — Google использует много юзер-агентов, а сайт с тяжелым каталогом товаров или активной рекламой тоже генерирует массу таких обращений.
Статистика сканирования в
Десять лет полных логов для сайта такого размера — это территория петабайтов, при этом сам объем здесь не главное ограничение.
Если впереди стоит кеш, запросы обрабатываются на
Поэтому логи не дадут ответа, сколько бы дней ни выгружали.
Вместо этого запрашивай предварительно отфильтрованные данные: короткий период, только трафик ботов, с фокусом на масштабируемые разделы сайта, такие как
Фильтрация сырых логов по юзер-агенту выдает только потенциальных ботов — реального
Инсайты комьюнити
— Сначала загрузи 7 дней в
— Обработка ботов может отличаться в зависимости от фронтенд-окружения, поэтому подтверди, логи какой именно среды тебе передали: в одном случае один фронтенд рапортовал, что каждый бот получает
#LogFileAnalysis #CrawlBudget #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Выгрузка логов основного сервера за 40 дней для крупного
e-commerce домена содержала 45 765 событий с юзер-агентом Googlebot — и 40 157 из них были запросами к /.env, /.ssh/id_ecdsa_sk.priv, /keystore.jks и подобным.То есть около 88% оказались сканерами, подделывающими
UA.В сухом остатке — порядка 5 600 правдоподобно реальных обращений
Googlebot за 30 дней.Остальная часть выгрузки выглядела не лучше: 76 377 из 76 381 событий
www отдавали 3xx на 80 порту без единого 200 — это отскок с HTTP на HTTPS, а не краулинг.А набор
intl_bots, охватывающий примерно две трети данных, вообще не содержал статус-кодов.Согласно Джону Мюллеру: бери для работы меньшую подвыборку (поддомен, если есть), затем сравнивай запросы на краулинг в
GSC с запросами от Google в логах и проверяй, совпадает ли хотя бы тренд.Идеально не будет — Google использует много юзер-агентов, а сайт с тяжелым каталогом товаров или активной рекламой тоже генерирует массу таких обращений.
Статистика сканирования в
GSC также показывает, тормозит ли Googlebot, отваливается ли по тайм-ауту или в целом ловит ошибки.Десять лет полных логов для сайта такого размера — это территория петабайтов, при этом сам объем здесь не главное ограничение.
Если впереди стоит кеш, запросы обрабатываются на
edge-серверах, и основной сервер их никогда не видит.Поэтому логи не дадут ответа, сколько бы дней ни выгружали.
Вместо этого запрашивай предварительно отфильтрованные данные: короткий период, только трафик ботов, с фокусом на масштабируемые разделы сайта, такие как
plp и pdp.Фильтрация сырых логов по юзер-агенту выдает только потенциальных ботов — реального
Googlebot подтверждает обратный поиск по IP.Инсайты комьюнити
— Сначала загрузи 7 дней в
Screaming Frog Log File Analyser, затем добавляй по одному логу в день и следи за паттерном; грузить всё сразу — слишком много информации для анализа. Перед импортом проверь заголовки сырого файла и подтверди, что есть что — в логах IIS поля c-ip и IP клиента WAF легко перепутать, а с Sucuri спереди именно поле IP WAF изолирует Googlebot и Bingbot. Сверяй это с данными краулинга GSC в настройках. Ведущие WAF и CDN по умолчанию не должны блокировать настоящих ботов вроде Googlebot.— Обработка ботов может отличаться в зависимости от фронтенд-окружения, поэтому подтверди, логи какой именно среды тебе передали: в одном случае один фронтенд рапортовал, что каждый бот получает
429, тогда как остальные этого не делали. Некоторые переданные урлы были маршрутами, а не путями, поэтому в ТЗ на выгрузку нужно указывать пути и урлы явно. Отслеживание даже одного случая из GSC обратно в логи подтверждает правильное место и нужного бота; в том же кейсе многие боты, видимые в GSC, оказались не теми, кого ждали, а количество сканирований от самого Googlebot оказалось ниже, чем подразумевал график.#LogFileAnalysis #CrawlBudget #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
⚡1
Логи серверов доказывают: во время июньского блэкаута в GSC Google переводил рендеринг на Chrome 149
Google подтвердил: данные об индексации в
Логи доступа к серверам на 9 проектах раскрывают, чем занимался флот рендеринга в этом окне:
—
—
—
Как показывает анализ логов от автора, эти инстансы рендеринга игнорировали ссылки и
Всё, что выходит за рамки логов — это гипотеза автора, а не заявления Google.
Нагрузка от миграции плюс аудиты перед апдейтом, вероятно, заставили инженеров поставить на паузу обработку логов
Восстановление данных означало бы повторный краулинг и рендеринг каждого
Грубые расчеты автора: при предполагаемой внутренней стоимости от $0.00001 до $0.00005 за рендер, консервативные 20 миллиардов
Этот же фреймворк выдвигает еще три гипотезы, под которые не предоставлено никаких данных:
— Лаг между
— Гуглобот оценивает структуру сырого
— Июньский спам-апдейт прицельно бил по несовпадениям между сырым
Операционный урок актуален независимо от причин.
Статус "Не проиндексировано" во время инфраструктурного апдейта не доказывает, что страница вылетела из поиска: пробейте полный
https://vizzex.ai/google-search-console-missing-june-2026-indexing-data/
#LogFileAnalysis #Crawling #GSC
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Google подтвердил: данные об индексации в
Search Console, пропавшие за 16–29 июня 2026 года, не будут восстановлены.Логи доступа к серверам на 9 проектах раскрывают, чем занимался флот рендеринга в этом окне:
Web Rendering Service гонял разные сборки Chrome с идентичных IP-блоков краулеров.—
Chrome 99, билд 99.0.4844.84: фиксированная база для первого прохода парсинга сырого HTML—
Chrome 148, билд 148.0.7778.96: уходящий рендерер, последний раз замечен 25 июня—
Chrome 149, билд 149.0.7827.54: входящий рендерер, впервые замечен 11 июняКак показывает анализ логов от автора, эти инстансы рендеринга игнорировали ссылки и
sitemaps, подтягивая данные из внутреннего Unified Document Cache Google, чтобы перерендерить страницы, которые уже находились в индексе, параллельно с июньским спам-апдейтом.Всё, что выходит за рамки логов — это гипотеза автора, а не заявления Google.
Нагрузка от миграции плюс аудиты перед апдейтом, вероятно, заставили инженеров поставить на паузу обработку логов
GSC, чтобы защитить живые запросы и генеративные ответы.Восстановление данных означало бы повторный краулинг и рендеринг каждого
URL, пройденного в этом окне.Грубые расчеты автора: при предполагаемой внутренней стоимости от $0.00001 до $0.00005 за рендер, консервативные 20 миллиардов
URL с тяжелым JavaScript обошлись бы от $200 000 до $1 млн серверного времени чисто ради исторических данных в дашборде с нулевой коммерческой отдачей.Этот же фреймворк выдвигает еще три гипотезы, под которые не предоставлено никаких данных:
— Лаг между
HTML-проходом и проходом рендеринга теперь составляет недели или месяцы— Гуглобот оценивает структуру сырого
HTML до постановки в очередь на рендер и пессимизирует страницы, размеченные как раздутые или фрагментированные— Июньский спам-апдейт прицельно бил по несовпадениям между сырым
HTML и отрендеренным макетомОперационный урок актуален независимо от причин.
GSC — это даунстрим-база, которая обрабатывает логи краулеров постфактум, с задержкой минимум в 48 часов, а не живой поисковый индекс.Статус "Не проиндексировано" во время инфраструктурного апдейта не доказывает, что страница вылетела из поиска: пробейте полный
URL в кавычках, и если он выдается, страница в индексе.https://vizzex.ai/google-search-console-missing-june-2026-indexing-data/
#LogFileAnalysis #Crawling #GSC
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Я отслеживаю
Я продолжаю это делать, потому что они показывают, когда проблема именно в Google (с 28-летием!).
Когда клики падают в
Я никогда не сравниваю их клики, так как они слишком малы, но каждую неделю сравниваю статусы индексации и ошибки сканирования во всех трех поисковиках.
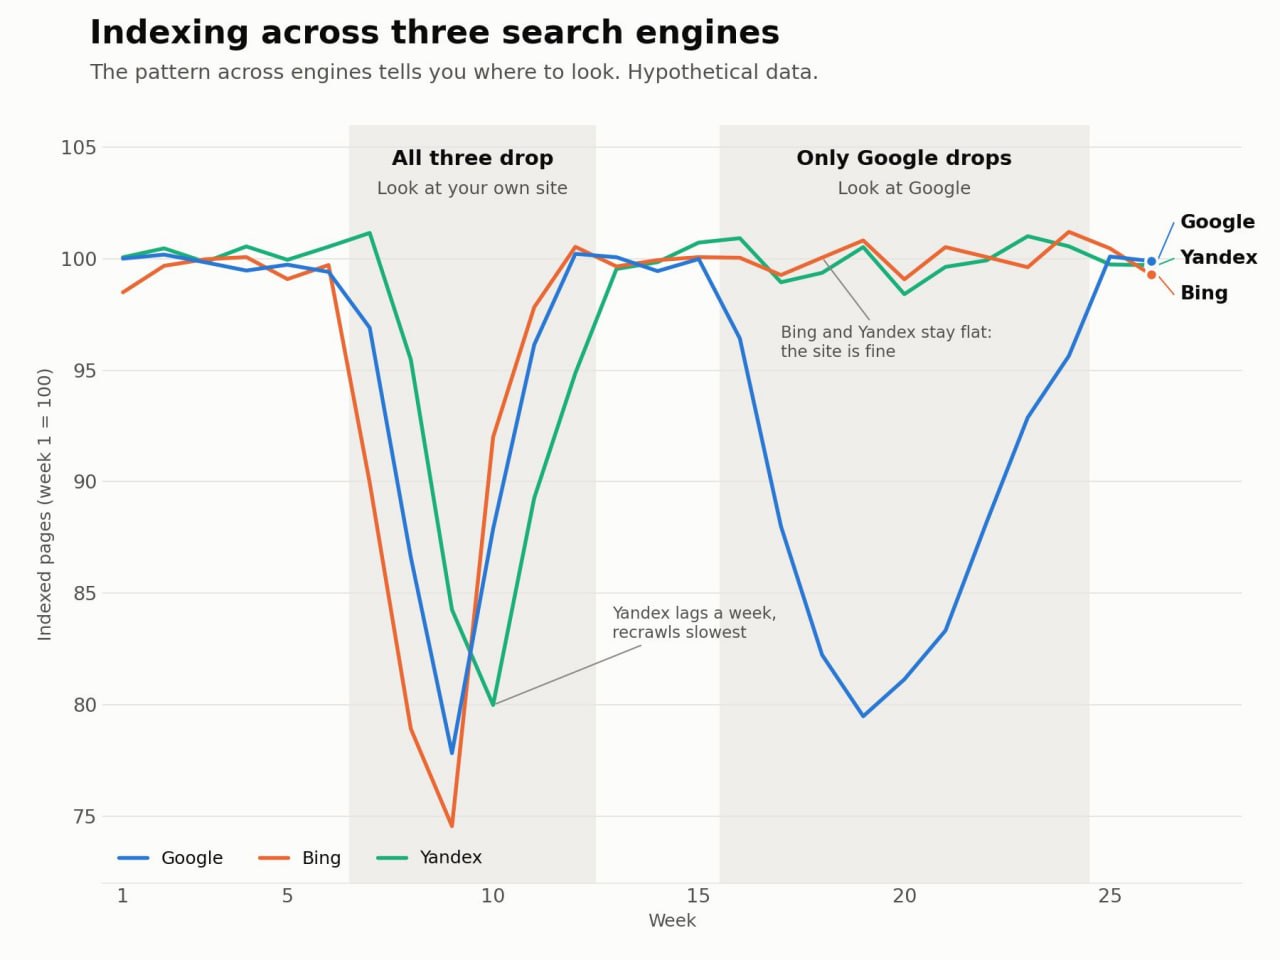
Если проиндексированные страницы падают во всех трех одновременно, я в первую очередь смотрю на свой сайт, потому что такой паттерн обычно означает изменения в
Если падает только Google, а
Каждый поисковик также репортит некоторые проблемы лучше, чем Google:
1.
2.
3.
Запуск трех
Для меня ценность именно в паттерне по всем трем поисковикам.
Успешной оптимизации!
Инсайты комьюнити
— Не каждый
— У ИИ-краулеров нет статуса индекса или отчета об ошибках, чтобы служить третьим контрольным показателем, оставляя логи доступа единственной контрольной группой;
#TechnicalSEO #Crawling #LogFileAnalysis
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Bing и Yandex на сайтах, где они почти не дают кликов, рассказывает Ян-Виллем Боббинк.Я продолжаю это делать, потому что они показывают, когда проблема именно в Google (с 28-летием!).
Когда клики падают в
GSC, причиной может быть кор-апдейт, самостоятельный выбор каноникала со стороны Google, блокировка Googlebot на уровне CDN или реальная техническая проблема, с которой столкнется каждый краулер.GSC в одиночку не может сказать, в чем именно дело, потому что вам не с чем сравнивать.Bing и Yandex сканируют те же URL и обращаются к тем же серверам, но у них своя логика ранжирования и каноникализации.Я никогда не сравниваю их клики, так как они слишком малы, но каждую неделю сравниваю статусы индексации и ошибки сканирования во всех трех поисковиках.
Если проиндексированные страницы падают во всех трех одновременно, я в первую очередь смотрю на свой сайт, потому что такой паттерн обычно означает изменения в
robots.txt, сломанный сайтмап, случайный noindex или ошибки сервера.Если падает только Google, а
Bing и Yandex остаются на месте, с сайтом, скорее всего, всё в порядке, и я начинаю копать в сторону Google.Каждый поисковик также репортит некоторые проблемы лучше, чем Google:
1.
Yandex точно говорит, почему страница вылетела из индекса, указывая такие причины, как группировка зеркал, обработка Clean-param или noindex, для до 50.000 URL через свой API.2.
Bing разделяет ошибки сканирования на сбои DNS, таймауты и коды состояния, а его отчет AI Performance показывает, какие страницы цитирует Copilot и для каких опорных запросов.3.
IndexNow доходит до Bing и Yandex, но не до Google, поэтому, когда Bing индексирует новую страницу за несколько часов, а Google не индексирует ее вообще, я знаю, что страница рендерится нормально, а задержка связана с краулинговым спросом Google.Запуск трех
API не делает позиции в Bing прокси для позиций в Google, и поисковики постоянно расходятся во мнениях по причинам, не связанным с вашим сайтом.Для меня ценность именно в паттерне по всем трем поисковикам.
Успешной оптимизации!
Инсайты комьюнити
— Не каждый
API возвращает данные, необходимые для сравнения трех поисковиков: часть еженедельного трекинга идет через Google Indexing API, а агент, который логинится через браузер, парсит данные, которые API не отдают.— У ИИ-краулеров нет статуса индекса или отчета об ошибках, чтобы служить третьим контрольным показателем, оставляя логи доступа единственной контрольной группой;
LLM собирают информацию через отдельные пути (обучение, RAG), и блокировка Common Crawl, вероятно, снижает представленность в обучающих данных.#TechnicalSEO #Crawling #LogFileAnalysis
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
👍4❤3