Логи GSC доказывают: органический трафик, а не бэклинки, заставляет Google переиндексировать страницы
Практики подтверждают прямую, проверяемую корреляцию между органическим трафиком и частотой переиндексации Google.
Это устанавливает четкую иерархию, где сигналы от юзеров перебивают статичные метрики авторитета вроде бэклинков.
Суровая правда из логов: страницы, на которые активно кликают, попадают в приоритетную очередь на краулинг, в то время как страницы с нулевым трафиком теряют приоритет, независимо от недавних правок или ссылочного профиля.
Эту динамику можно измерить как "Показатель задержки индексации авторитета" — метрику эффективности краулинга домена, основанную на вовлеченности пользователей.
Метод вскрытия этого механизма целиком выполняется в
Сначала проверьте десять самых кликабельных страниц в
Чтобы доказать обратное, отсортируйте отчет в обратном порядке и посмотрите на страницы с наименьшим количеством кликов.
У этих активов будет самая большая задержка с момента последней индексации.
Эта разница во времени между последним краулом вашей наименее посещаемой страницы и текущей датой и есть задержка эффективности вашего домена.
Хотя первичной индексации можно добиться за счет таких факторов, как тематический авторитет и внутренняя перелинковка с трастовых страниц, поддержание частоты краулинга — это функция реального авторитета, который определяется кликами пользователей и
Это опровергает распространенный миф о том, что страница с сильными бэклинками, но без трафика, имеет значительный вес в глазах планировщика краулинга.
Предлагаемая формула для количественной оценки ценности страницы:
Она отдает предпочтение страницам с постоянным трафиком и свежими краулами.
Практический вывод: даже страницы с большим количеством показов, но без кликов, рискуют быть переведены в очередь с более низким приоритетом краулинга.
Чтобы заставить систему переоценить и часто индексировать страницу, нужно генерировать реальный пользовательский трафик.
Это подтверждает, что клики — окончательный сигнал релевантности, который заслуживает внимания алгоритма.
https://www.reddit.com/r/SEO/comments/1pecrgy/simple_seo_workshop_example_traffic_authority/
#UserSignals #Indexing #GSC
@MikeBlazerX
Пушки — в @MikeBlazerPRO
Практики подтверждают прямую, проверяемую корреляцию между органическим трафиком и частотой переиндексации Google.
Это устанавливает четкую иерархию, где сигналы от юзеров перебивают статичные метрики авторитета вроде бэклинков.
Суровая правда из логов: страницы, на которые активно кликают, попадают в приоритетную очередь на краулинг, в то время как страницы с нулевым трафиком теряют приоритет, независимо от недавних правок или ссылочного профиля.
Эту динамику можно измерить как "Показатель задержки индексации авторитета" — метрику эффективности краулинга домена, основанную на вовлеченности пользователей.
Метод вскрытия этого механизма целиком выполняется в
GSC.Сначала проверьте десять самых кликабельных страниц в
отчете по эффективности; дата их последней индексации почти всегда будет свежей, часто — в пределах последней недели.Чтобы доказать обратное, отсортируйте отчет в обратном порядке и посмотрите на страницы с наименьшим количеством кликов.
У этих активов будет самая большая задержка с момента последней индексации.
Эта разница во времени между последним краулом вашей наименее посещаемой страницы и текущей датой и есть задержка эффективности вашего домена.
Хотя первичной индексации можно добиться за счет таких факторов, как тематический авторитет и внутренняя перелинковка с трастовых страниц, поддержание частоты краулинга — это функция реального авторитета, который определяется кликами пользователей и
CTR с течением времени.Это опровергает распространенный миф о том, что страница с сильными бэклинками, но без трафика, имеет значительный вес в глазах планировщика краулинга.
Предлагаемая формула для количественной оценки ценности страницы:
Ценность страницы = Клики / Дни с последнего краула.Она отдает предпочтение страницам с постоянным трафиком и свежими краулами.
Практический вывод: даже страницы с большим количеством показов, но без кликов, рискуют быть переведены в очередь с более низким приоритетом краулинга.
Чтобы заставить систему переоценить и часто индексировать страницу, нужно генерировать реальный пользовательский трафик.
Это подтверждает, что клики — окончательный сигнал релевантности, который заслуживает внимания алгоритма.
https://www.reddit.com/r/SEO/comments/1pecrgy/simple_seo_workshop_example_traffic_authority/
#UserSignals #Indexing #GSC
@MikeBlazerX
Пушки — в @MikeBlazerPRO
👍9😁2
Протоколы накрутки для алгоритмов комментариев 'Top' и 'Best' на Reddit
Прямой партнерский маркетинг на
Чтобы обойти это, я юзаю тактику в два шага, которую можно считать "отмыванием" ссылок, — раскрывает Джеки Чоу.
Вместо того чтобы линковать напрямую на оффер, вы ссылаетесь на промежуточный пост на трастовом, авторитетном домене вроде
У этих платформ меньше шансов попасть под автоматические флаги модерации
Как только ваш комментарий опубликован, его продвижение в топ полностью зависит от метода сортировки в треде, так как каждый требует своего протокола для накрутки.
Если тред отсортирован по "
Вы постите коммент, ждете ровно семь дней, а затем делаете "взрыв" большим количеством апвоутов — скажем, штук 200 — все разом.
Этого одного выстрела обычно достаточно, чтобы занять топовую позицию.
Однако манипулировать тредом, отсортированным по "
Дело не только в голом количестве апвоутов; это комбинация апвоутов, ответов на комментарий и постоянных сигналов вовлеченности, таких как клики по профилю.
Для таких тредов стратегия такова: вы постите коммент, ждете несколько дней, а затем начинаете капельно подливать апвоуты в течение времени.
Одновременно вы должны закупать ответы на коммент, чтобы симулировать естественную, идущую беседу, что сигнализирует алгоритму о том, что ваш комментарий генерирует ценное вовлечение.
Этот подход также работает для управления репутацией в сети, особенно в архивных тредах, где новые комментарии заблокированы, но голосование все еще возможно.
Если вы работаете с брендом, вы можете найти любое существующее позитивное упоминание — неважно, как глубоко оно закопано — и просто "взорвать" его апвоутами.
Это действие выталкивает позитивный комментарий наверх, мгновенно меняя видимую картину в заблокированном обсуждении.
#Reddit #BlackHatSEO #UserSignals
@MikeBlazerX
Пушки — в @MikeBlazerPRO
Прямой партнерский маркетинг на
Reddit сейчас — это гемор, так как любая рекламная ссылка, которую вы добавляете, резко повышает шансы на удаление.Чтобы обойти это, я юзаю тактику в два шага, которую можно считать "отмыванием" ссылок, — раскрывает Джеки Чоу.
Вместо того чтобы линковать напрямую на оффер, вы ссылаетесь на промежуточный пост на трастовом, авторитетном домене вроде
Medium или LinkedIn.У этих платформ меньше шансов попасть под автоматические флаги модерации
Reddit, и уже оттуда вы можете разместить свою конечную исходящую ссылку.Как только ваш комментарий опубликован, его продвижение в топ полностью зависит от метода сортировки в треде, так как каждый требует своего протокола для накрутки.
Если тред отсортирован по "
Top", процесс простой и основан на грубой силе.Вы постите коммент, ждете ровно семь дней, а затем делаете "взрыв" большим количеством апвоутов — скажем, штук 200 — все разом.
Этого одного выстрела обычно достаточно, чтобы занять топовую позицию.
Однако манипулировать тредом, отсортированным по "
Best", сложнее, потому что его алгоритм ранжирования более тонкий.Дело не только в голом количестве апвоутов; это комбинация апвоутов, ответов на комментарий и постоянных сигналов вовлеченности, таких как клики по профилю.
Для таких тредов стратегия такова: вы постите коммент, ждете несколько дней, а затем начинаете капельно подливать апвоуты в течение времени.
Одновременно вы должны закупать ответы на коммент, чтобы симулировать естественную, идущую беседу, что сигнализирует алгоритму о том, что ваш комментарий генерирует ценное вовлечение.
Этот подход также работает для управления репутацией в сети, особенно в архивных тредах, где новые комментарии заблокированы, но голосование все еще возможно.
Если вы работаете с брендом, вы можете найти любое существующее позитивное упоминание — неважно, как глубоко оно закопано — и просто "взорвать" его апвоутами.
Это действие выталкивает позитивный комментарий наверх, мгновенно меняя видимую картину в заблокированном обсуждении.
#Reddit #BlackHatSEO #UserSignals
@MikeBlazerX
Пушки — в @MikeBlazerPRO
❤9
Сигналы ранжирования Google
Взаимодействие с юзером и модели прогнозирования
Ранжирование жестко опирается на сигналы популярности из интеракций юзеров; выше вовлеченность — сильнее буст.
Система юзает модели `Predicted CTR` (PCTR) для оценки вероятности просмотра на основе истории.
Персонализированный `PCTR` уточняет это через метаданные и историю юзера, но эта конкретная модель активируется только после 100 000 запросов, обработанных через
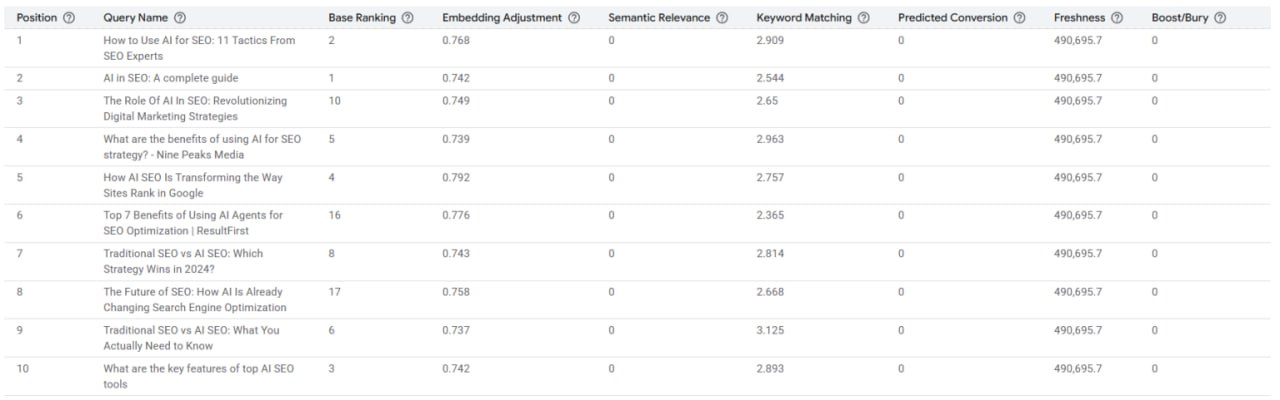
Стек скоринга
Финальная Позиция документа начинается с Базового ранжирования — начального скора от основного алгоритма.
Дальше она допиливается несколькими слоями:
— Корректировка эмбеддингов (Gecko): Меняет скоры на основе семантической близости.
— Семантическая релевантность (Jetstream): Использует
— Соответствие ключей: Применяет традиционные алгоритмы частотности (типа BM25).
— Прогнозируемая конверсия: Предсказывает вовлеченность (например, клики), используя данные
— Свежесть и бизнес-правила: Корректировки на новизну контента и ручные протоколы
Режимы поиска и архитектура ИИ
Гугл определяет три режима поиска: стандартные списки, поиск с генеративными саммари (Answers) и разговорный поиск с фоллоу-апами.
Критично: топ-5 результатов кормят генерацию ИИ-поиска.
Форматы вывода различают короткие Сниппеты и длинные
Метрики и безопасность
Перформанс системы оценивается сравнением
Плюс стоят предохранители, чтобы игнорировать состязательные запросы (adversarial queries), не давая
https://dejan.ai/blog/googles-ranking-signals/
#RankingFactors #UserSignals #AIOverview
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
Взаимодействие с юзером и модели прогнозирования
Ранжирование жестко опирается на сигналы популярности из интеракций юзеров; выше вовлеченность — сильнее буст.
Система юзает модели `Predicted CTR` (PCTR) для оценки вероятности просмотра на основе истории.
Персонализированный `PCTR` уточняет это через метаданные и историю юзера, но эта конкретная модель активируется только после 100 000 запросов, обработанных через
VAIS.Стек скоринга
Финальная Позиция документа начинается с Базового ранжирования — начального скора от основного алгоритма.
Дальше она допиливается несколькими слоями:
— Корректировка эмбеддингов (Gecko): Меняет скоры на основе семантической близости.
— Семантическая релевантность (Jetstream): Использует
cross-attention модель, чтобы обрабатывать контекст и отрицания лучше стандартных эмбеддингов.— Соответствие ключей: Применяет традиционные алгоритмы частотности (типа BM25).
— Прогнозируемая конверсия: Предсказывает вовлеченность (например, клики), используя данные
PCTR/PCVR.— Свежесть и бизнес-правила: Корректировки на новизну контента и ручные протоколы
Boost/Bury.Режимы поиска и архитектура ИИ
Гугл определяет три режима поиска: стандартные списки, поиск с генеративными саммари (Answers) и разговорный поиск с фоллоу-апами.
Критично: топ-5 результатов кормят генерацию ИИ-поиска.
Форматы вывода различают короткие Сниппеты и длинные
Extractive Answers, вытянутые из контента результатов.Метрики и безопасность
Перформанс системы оценивается сравнением
Search Count, CTR и No Results Rate с установленными бейслайнами.Плюс стоят предохранители, чтобы игнорировать состязательные запросы (adversarial queries), не давая
LLM генерить ответы на вредоносные инпуты.https://dejan.ai/blog/googles-ranking-signals/
#RankingFactors #UserSignals #AIOverview
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
❤1
Дрессировка алгоритма: как через брендовые запросы привязать свой сайт к жирным ключам
Фокус на брендинге — это критическая практика 20/80, не для пузомерки, а как прямое оружие для ранжирования, утверждает Лоик Шемель.
Вся стратегия строится на дрессировке алгоритма Гугла через поисковое поведение юзеров.
Цитируя классический пример Реми Нестасио, когда достаточное количество юзеров ищет
Это напрямую бустит ранжирование бренда по самому общему, жирному запросу.
Исполнение требует превратить вашу аудиторию в оружие на внешних платформах типа
Вместо того чтобы делиться прямой ссылкой на ваш контент, вы должны дать команду своим подписчикам самим выполнить поиск.
Дайте прямой приказ: "Идите в Гугл и вбейте
Это обходит пассивные клики и скармливает алгоритму мощный поведенческий сигнал.
Это заставляет его создавать ассоциацию между вашим брендом и вашими целевыми коммерческими терминами, манипулируя и позициями в выдаче, и поисковыми подсказками.
Трафик, сгенерированный вне традиционной
Каждый юзер, который вбивает название вашего бренда плюс ключевое слово, отдает голос авторитета, который алгоритм вынужден засчитать, создавая долговечное конкурентное преимущество, основанное на сигналах, которое не могут воспроизвести только контент и ссылки.
#BrandedSearch #UserSignals #TopicalAuthority
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
Фокус на брендинге — это критическая практика 20/80, не для пузомерки, а как прямое оружие для ранжирования, утверждает Лоик Шемель.
Вся стратегия строится на дрессировке алгоритма Гугла через поисковое поведение юзеров.
Цитируя классический пример Реми Нестасио, когда достаточное количество юзеров ищет
"Louis Vuitton handbag", алгоритм учится ассоциировать сущность "Louis Vuitton" с общим термином "handbag".Это напрямую бустит ранжирование бренда по самому общему, жирному запросу.
Исполнение требует превратить вашу аудиторию в оружие на внешних платформах типа
YouTube, LinkedIn или в рассылках.Вместо того чтобы делиться прямой ссылкой на ваш контент, вы должны дать команду своим подписчикам самим выполнить поиск.
Дайте прямой приказ: "Идите в Гугл и вбейте
Мой Бренд + Целевой Ключ".Это обходит пассивные клики и скармливает алгоритму мощный поведенческий сигнал.
Это заставляет его создавать ассоциацию между вашим брендом и вашими целевыми коммерческими терминами, манипулируя и позициями в выдаче, и поисковыми подсказками.
Трафик, сгенерированный вне традиционной
SEO-экосистемы — из соцсетей, подкастов или любой платформы, где у вас есть комьюнити — имеет непропорционально большой выхлоп именно потому, что он подпитывает этот механизм.Каждый юзер, который вбивает название вашего бренда плюс ключевое слово, отдает голос авторитета, который алгоритм вынужден засчитать, создавая долговечное конкурентное преимущество, основанное на сигналах, которое не могут воспроизвести только контент и ссылки.
#BrandedSearch #UserSignals #TopicalAuthority
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
👍6❤1🤝1
Сигнал "Browser Exit" роняет бренд с Топ-1 на 11-ю страницу
Анализ идентифицирует "выход из браузера" (закрытие браузера сразу после просмотра лендинга) как сигнал негатива, который значительно мощнее стандартного возврата в выдачу (bounce).
Если отказ подразумевает возврат в Google (удержание юзера внутри экосистемы поиска), то
У меня на руках данные
Механизм пессимизации завязан на прерывании "Цепочки Монетизации".
Поисковики и агрегаторы приоритизируют потоки трафика, поддерживающие рекламный потенциал; закрытие браузера отрезает этот поток кэша.
Следовательно, алгоритм понижает сайты, которые не могут удержать юзера в экосистеме монетизации, трактуя выход как неспособность дестинейшена удовлетворить или монетизировать интент.
#LogFileAnalysis #UserSignals #BounceRate
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Анализ идентифицирует "выход из браузера" (закрытие браузера сразу после просмотра лендинга) как сигнал негатива, который значительно мощнее стандартного возврата в выдачу (bounce).
Если отказ подразумевает возврат в Google (удержание юзера внутри экосистемы поиска), то
browser exit обрывает сессию полностью.У меня на руках данные
GSC, доказывающие: когда этот специфический сигнал накапливается на брендовых страницах, основные ключи улетают с Позиции 1 на 11-ю страницу, палит Лео Сулас.Механизм пессимизации завязан на прерывании "Цепочки Монетизации".
Поисковики и агрегаторы приоритизируют потоки трафика, поддерживающие рекламный потенциал; закрытие браузера отрезает этот поток кэша.
Следовательно, алгоритм понижает сайты, которые не могут удержать юзера в экосистеме монетизации, трактуя выход как неспособность дестинейшена удовлетворить или монетизировать интент.
#LogFileAnalysis #UserSignals #BounceRate
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
🤣16
Алгоритм "Stale-Seeking" инвертирует сигналы свежести и ломает мандат на новизну
Алгоритм может инвертировать сигналы свежести (Freshness) на основе паттерна "Stale-Seeking" (Поиск устаревшего), раскрывает Жан-Кристоф Шуинар.
Если данные показывают, что пользователи систематически пропускают свежие результаты (топ позиций) и кликают на более старые документы ниже, Google переворачивает сигнал, отдавая предпочтение старому контенту для конкретного запроса.
И наоборот, если клики концентрируются на свежих ассетах, алгоритм вводит мандат на свежесть, подавляя старые статичные страницы независимо от их траста.
По вектору Детекта Трендов, Google сопоставляет объем запросов со скоростью создания документов для категоризации интента:
— Вирусная сенсация: Высокий рост запросов + Низкий рост документов. (Указывает на gap контента на ранней стадии; мгновенная возможность для ранжирования).
— Институциональный релиз: Высокий рост документов + Низкий объем запросов. (Указывает на пресс-релизы правительства или крупных новостников; сигнал насыщения авторитетом).
Касательно Протухания документа (Document Decay): стареющие активы не падают линейно.
Сначала они теряют видимость по запросам с конкретным текущим интентом (например, "
Эта потеря специфичности — первый механический индикатор того, что алгоритм классифицировал документ как смещающийся в сторону устаревания.
Наконец, Google рассчитывает Score Удовлетворенности Запросом для всей выдачи.
Если запрос генерирует высокий совокупный
Это триггерит повышение порогов ранжирования, фактически активируя "
Отдельно стоит учитывать, что "коммерческий скоринг" документа зависит от данных о рекламе на стороне паблишера.
Google анализирует качество рекламодателей, участвующих в аукционе за ключи страницы, и частоту показа объявлений как прокси стабильности и легитимности.
Рекламодатели высокого уровня (крупные бренды), делающие ставки на странице, служат внешним сигналом валидации, а Ad CTR выступает вторичным сигналом релевантности: взаимодействие с рекламой подтверждает, что страница удовлетворяет коммерческий интент.
#AlgorithmicScoring #UserSignals #TrendAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Алгоритм может инвертировать сигналы свежести (Freshness) на основе паттерна "Stale-Seeking" (Поиск устаревшего), раскрывает Жан-Кристоф Шуинар.
Если данные показывают, что пользователи систематически пропускают свежие результаты (топ позиций) и кликают на более старые документы ниже, Google переворачивает сигнал, отдавая предпочтение старому контенту для конкретного запроса.
И наоборот, если клики концентрируются на свежих ассетах, алгоритм вводит мандат на свежесть, подавляя старые статичные страницы независимо от их траста.
По вектору Детекта Трендов, Google сопоставляет объем запросов со скоростью создания документов для категоризации интента:
— Вирусная сенсация: Высокий рост запросов + Низкий рост документов. (Указывает на gap контента на ранней стадии; мгновенная возможность для ранжирования).
— Институциональный релиз: Высокий рост документов + Низкий объем запросов. (Указывает на пресс-релизы правительства или крупных новостников; сигнал насыщения авторитетом).
Касательно Протухания документа (Document Decay): стареющие активы не падают линейно.
Сначала они теряют видимость по запросам с конкретным текущим интентом (например, "
World Series 2024"), сохраняя позиции по широким тематическим запросам ("World Series").Эта потеря специфичности — первый механический индикатор того, что алгоритм классифицировал документ как смещающийся в сторону устаревания.
Наконец, Google рассчитывает Score Удовлетворенности Запросом для всей выдачи.
Если запрос генерирует высокий совокупный
CTR по всем топовым результатам (например, 90% для "Jobs in New York"), Google интерпретирует запрос как "хорошо удовлетворенный".Это триггерит повышение порогов ранжирования, фактически активируя "
Hard Mode", при котором новым или слабым документам математически сложнее сместить инкумбентов по сравнению с запросами с низкой удовлетворенностью (например, 60% совокупного CTR).Отдельно стоит учитывать, что "коммерческий скоринг" документа зависит от данных о рекламе на стороне паблишера.
Google анализирует качество рекламодателей, участвующих в аукционе за ключи страницы, и частоту показа объявлений как прокси стабильности и легитимности.
Рекламодатели высокого уровня (крупные бренды), делающие ставки на странице, служат внешним сигналом валидации, а Ad CTR выступает вторичным сигналом релевантности: взаимодействие с рекламой подтверждает, что страница удовлетворяет коммерческий интент.
#AlgorithmicScoring #UserSignals #TrendAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
🔥1👀1
У алгоритма Google есть заранее просчитанные UX-ожидания для категории вашей страницы
В качественных сигналах Google есть паттерны, которые выходят за рамки простых он-пейдж факторов; один из самых критичных — то, что я называю "session based on category based search session duration" (длительность сессии, основанная на категории поисковой сессии), раскрывает Корай Тугберк Гюбюр.
Это гипотеза о том, что алгоритмы Google имеют заранее просчитанные ожидания относительно поведения пользователя — вроде длительности сессии и паттернов кликов — на основе конкретной функциональной категории страницы.
Тип вашей страницы диктует ожидаемые взаимодействия пользователя, и синхронизация вашего
Именно поэтому многие аффилиатные сайты сейчас пытаются имитировать локальный бизнес на своей главной странице.
Например, сайт, который полностью посвящен обзорам "лучших объективов" или "лучших камер", создаст главную, которая выглядит как местная фотостудия, в комплекте с функцией бронирования.
Это дает сайту ощутимую "функцию" и помогает ему избежать обесценивания системами вроде
Тот же принцип применим и в других нишах.
Для аффилиатных страниц по кредитным картам, в тот момент, когда вы добавляете функциональную форму заявки, вы можете увидеть рост позиций.
Если вы ее убираете, вы просто еще один аффилиат.
С точки зрения Google, трудно сказать, кто является реальным провайдером, а кто аффилиатом, просто имитирующим его, но добавление функционального элемента меняет классификацию страницы и сигнализирует о более высоком удовлетворении пользователя.
В конечном счете, вам нужно изменить свою страницу, чтобы повысить ее отзывчивость на подразумеваемую задачу пользователя.
Со временем, по мере того как Google собирает больше данных, его алгоритмы распознают, что поведение кликов и удовлетворенность пользователей на вашей странице отличаются — и они лучше, — чем у конкурентов, которые не могут сопоставить функцию своей страницы с ее категорией.
#UserSignals #UX #HCU
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
В качественных сигналах Google есть паттерны, которые выходят за рамки простых он-пейдж факторов; один из самых критичных — то, что я называю "session based on category based search session duration" (длительность сессии, основанная на категории поисковой сессии), раскрывает Корай Тугберк Гюбюр.
Это гипотеза о том, что алгоритмы Google имеют заранее просчитанные ожидания относительно поведения пользователя — вроде длительности сессии и паттернов кликов — на основе конкретной функциональной категории страницы.
Тип вашей страницы диктует ожидаемые взаимодействия пользователя, и синхронизация вашего
UX с этими скрытыми ожиданиями напрямую влияет на то, как кликовая модель Google оценивает ваш сайт.Именно поэтому многие аффилиатные сайты сейчас пытаются имитировать локальный бизнес на своей главной странице.
Например, сайт, который полностью посвящен обзорам "лучших объективов" или "лучших камер", создаст главную, которая выглядит как местная фотостудия, в комплекте с функцией бронирования.
Это дает сайту ощутимую "функцию" и помогает ему избежать обесценивания системами вроде
HCU.Тот же принцип применим и в других нишах.
Для аффилиатных страниц по кредитным картам, в тот момент, когда вы добавляете функциональную форму заявки, вы можете увидеть рост позиций.
Если вы ее убираете, вы просто еще один аффилиат.
С точки зрения Google, трудно сказать, кто является реальным провайдером, а кто аффилиатом, просто имитирующим его, но добавление функционального элемента меняет классификацию страницы и сигнализирует о более высоком удовлетворении пользователя.
В конечном счете, вам нужно изменить свою страницу, чтобы повысить ее отзывчивость на подразумеваемую задачу пользователя.
Со временем, по мере того как Google собирает больше данных, его алгоритмы распознают, что поведение кликов и удовлетворенность пользователей на вашей странице отличаются — и они лучше, — чем у конкурентов, которые не могут сопоставить функцию своей страницы с ее категорией.
#UserSignals #UX #HCU
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Снос хедера на товарках форсирует сигналы конверсии
Стандартные инъекции контента и ссылок часто не дают выхлопа в перегретой
Чтобы пробить плато, я внедряю радикальный Протокол Лендингов: сношу меню основной навигации со страниц товаров, раскрывает Леопольд Астра.
Убирая хедер и загоняя юзеров в выделенную воронку "кастомизации", я фабрикую сигналы высокой конверсии, которые Google интерпретирует как "удовлетворение запроса".
Это минимизирует выходы и фокусирует взаимодействие чисто на транзакционном интенте.
В референсных данных эта калибровка
Чтобы сбалансировать ограничение, я оптимизирую страницы Категорий под "Навигационный поток".
Ставлю визуальные иконки навигации сразу в первом экране (above the fold), чтобы стимулировать мульти-страничные сессии.
Это бустит метрику "страниц на сессию" — которую Google палит через
Отдельно эксплуатирую Ценовой якорь в `Merchant Center`, создавая лоу-прайс
Конфиг показывает низкий ценник в результатах
Этот поведенческий всплеск работает как мощный косвенный сигнал, поднимающий органический траст основной линейки.
#EcommerceSEO #UserSignals #CRO
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Стандартные инъекции контента и ссылок часто не дают выхлопа в перегретой
E-com выдаче (данные показали стагнацию на 15 позиции, несмотря на вливания).Чтобы пробить плато, я внедряю радикальный Протокол Лендингов: сношу меню основной навигации со страниц товаров, раскрывает Леопольд Астра.
Убирая хедер и загоняя юзеров в выделенную воронку "кастомизации", я фабрикую сигналы высокой конверсии, которые Google интерпретирует как "удовлетворение запроса".
Это минимизирует выходы и фокусирует взаимодействие чисто на транзакционном интенте.
В референсных данных эта калибровка
UX — конкретно удаление навигации для фокуса — катапультировала позиции с 15-й на 6-ю за один месяц, параллельно подняв выручку на 15%.Чтобы сбалансировать ограничение, я оптимизирую страницы Категорий под "Навигационный поток".
Ставлю визуальные иконки навигации сразу в первом экране (above the fold), чтобы стимулировать мульти-страничные сессии.
Это бустит метрику "страниц на сессию" — которую Google палит через
Chrome — и уплотняет внутренний граф сканирования для подкатегорий.Отдельно эксплуатирую Ценовой якорь в `Merchant Center`, создавая лоу-прайс
SKU-"пробник" (например, $15 против стандарта $20).Конфиг показывает низкий ценник в результатах
Google Shopping, искусственно раздувая CTR выдачи.Этот поведенческий всплеск работает как мощный косвенный сигнал, поднимающий органический траст основной линейки.
#EcommerceSEO #UserSignals #CRO
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
🤔4✍1
Утечка API Google раскрывает: качество кликов перевешивает объем CTR при ранжировании
Индустрия гоняется за
Конкретно, Google отслеживает показы (как часто URL появляется в результатах), клики (сырое количество),
Антимонопольный суд раскрыл: данные о кликах формируют основу "преимущества масштаба Google" — эти данные алгоритм использует для ранжирования и обучения
Механизм: Google взвешивает каждый клик по запросу, типу пользователя, устройству, локации и языку.
Пользователю, который ищет "
Google не измеряет голое время на сайте — он оценивает контекстное удовлетворение.
Высокий
Более низкий
Релевантность — Создавай свой сниппет в выдаче под интент запроса (интент, обещание, понятность бренда).
Метрики Google накладывают санкции на кликбейтные тайтлы, которые собирают клики, но не закрывают интент.
Полезность — Структурируй контент для удержания: сначала ответь на запрос, затем добавь детали, связанные вопросы и доказательства.
Полевые данные указывают: исчерпывающая полнота — ответы на дополнительные вопросы, которые могут понадобиться пользователю дальше — продлевает время на сайте и предотвращает возвраты в выдачу.
Удовлетворение — Стань последним результатом, на который кликает юзер.
Добавляй внешние отзывы при обзоре локального бизнеса, давай инструкции для следующих шагов, предвосхищай будущие вопросы.
Каждый шаг усиливает предыдущий: релевантность дает клик, полезность удерживает ПФ, удовлетворение отрезает возврат к поиску.
Отслеживай это косвенно через
Ты не видишь данные по кликам конкурентов, поэтому оптимизируешь относительно своей базы — но улучшение этих метрик коррелирует с сигналами кликов, которые Google реально использует.
https://signal.zyppy.com/p/google-click-signals
#UserSignals #PogoSticking #SERPAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Индустрия гоняется за
CTR как за рычагом ранжирования, но утечка API Google и антимонопольные слушания разоблачают другую реальность: Google измеряет качество клика, а не его объем.Конкретно, Google отслеживает показы (как часто URL появляется в результатах), клики (сырое количество),
badClicks (мгновенные возвраты в выдачу), goodClicks (длительное время на сайте до отказа) и lastLongestClicks (пользователь вообще не возвращается в поиск).Антимонопольный суд раскрыл: данные о кликах формируют основу "преимущества масштаба Google" — эти данные алгоритм использует для ранжирования и обучения
AI Overviews через RankEmbedBERT (поглощает логи поисков за 70 дней) и NavBoost (запоминает историю взаимодействий за 13 месяцев).Механизм: Google взвешивает каждый клик по запросу, типу пользователя, устройству, локации и языку.
Пользователю, который ищет "
how tall is Mount Everest", нужны секунды; запрос "optimize investment portfolio for inflation" требует минут.Google не измеряет голое время на сайте — он оценивает контекстное удовлетворение.
Высокий
CTR в паре с быстрыми возвратами (badClicks) сигнализирует о провале.Более низкий
CTR вместе с долгими, взвешенными кликами доказывает успех.Релевантность — Создавай свой сниппет в выдаче под интент запроса (интент, обещание, понятность бренда).
Метрики Google накладывают санкции на кликбейтные тайтлы, которые собирают клики, но не закрывают интент.
Полезность — Структурируй контент для удержания: сначала ответь на запрос, затем добавь детали, связанные вопросы и доказательства.
Полевые данные указывают: исчерпывающая полнота — ответы на дополнительные вопросы, которые могут понадобиться пользователю дальше — продлевает время на сайте и предотвращает возвраты в выдачу.
Удовлетворение — Стань последним результатом, на который кликает юзер.
Добавляй внешние отзывы при обзоре локального бизнеса, давай инструкции для следующих шагов, предвосхищай будущие вопросы.
Каждый шаг усиливает предыдущий: релевантность дает клик, полезность удерживает ПФ, удовлетворение отрезает возврат к поиску.
Отслеживай это косвенно через
GSC (CTR по позициям), ГА4 (время взаимодействия по источнику organic) и объем брендовых запросов.Ты не видишь данные по кликам конкурентов, поэтому оптимизируешь относительно своей базы — но улучшение этих метрик коррелирует с сигналами кликов, которые Google реально использует.
https://signal.zyppy.com/p/google-click-signals
#UserSignals #PogoSticking #SERPAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

❤3👍1😍1
Грамотная структура страницы бустит сигнал lastLongestClick для NavBoost
Он фиксирует момент, когда пользователь проводит на твоей странице больше времени, чем на любом другом результате в рамках поисковой сессии, и больше не возвращается в Гугл — это означает, что сессия закрыта, потому что ответ найден.
Но большинство сайтов собирают
Дело не в качестве — юзеры просто считывают коммодити-контент и уходят обратно в поиск.
Они также возвращаются, если страница отвечает на один вопрос, но игнорирует логическое продолжение, или когда внутренняя структура создает трение (медленная загрузка, кликбейтный
Умножь эти возвраты на сотни сессий, и получишь фактор ранжирования, который пенализирует структурные провалы, а не только плохой текст.
Семь форматов забирают
— Ультимативные гайды: Полное покрытие темы отрезает потребность в новых поисках.
— Страницы сравнения: Принятие решения прямо на странице отсекает переходы к конкурентам. Сравнения кредиток на
— Инструменты и калькуляторы: Выполнение задачи (ипотечный калькулятор, чек сложности ключа, расчет ROI) полностью закрывает интент без возврата. Инструменты
— Кейсы с цифрами: Специфика намертво приклеивает юзера к странице. Обобщенные кейсы генерируют возвраты в поиск. Конкретика ("с 11 на 3 позицию за 90 дней по ключу стоимостью £8,000/месяц") закрывает дополнительные вопросы еще до того, как они появятся.
— Уникальные исследования: Проприетарная дата становится первоисточником. Статистику
— Пошаговые процессы: Активное вовлечение форсирует удержание. Пользователи, идущие по шагам, не возвращаются в серп на середине процесса.
— FAQ-хабы: Несколько запросов закрываются за один заход. Юзер видит, что следующий логичный вопрос уже разобран, остается на сайте и читает глубже.
Девять тактик на уровне страницы защищают этот сигнал: давай ответ на главный вопрос на первом экране, предугадывай следующий шаг, вычищай заявления без пруфов (триггеры
Чего стоит избегать: новостей без контекста (юзеры идут гуглить бэкграунд), мнений без фактуры (уходят проверять), пустых категорий (задача не закрыта), базовых листиклов (генерируют десяток новых запросов) и хабовых страниц, которые просто линкуют без ответа (пользователям проще вернуться в Гугл, чем ковыряться в навигации).
https://www.lucatagliaferro.com/how-to-optimise-for-lastlongestclick/
#UserSignals #PogoSticking #SearchIntent
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
lastLongestClick — железобетонный сигнал удовлетворенности в NavBoost.Он фиксирует момент, когда пользователь проводит на твоей странице больше времени, чем на любом другом результате в рамках поисковой сессии, и больше не возвращается в Гугл — это означает, что сессия закрыта, потому что ответ найден.
Но большинство сайтов собирают
badClicks.Дело не в качестве — юзеры просто считывают коммодити-контент и уходят обратно в поиск.
Они также возвращаются, если страница отвечает на один вопрос, но игнорирует логическое продолжение, или когда внутренняя структура создает трение (медленная загрузка, кликбейтный
title tag, кривой рендер на мобилке).Умножь эти возвраты на сотни сессий, и получишь фактор ранжирования, который пенализирует структурные провалы, а не только плохой текст.
Семь форматов забирают
lastLongestClick по умолчанию:— Ультимативные гайды: Полное покрытие темы отрезает потребность в новых поисках.
SEO-гайд от Backlinko и Beginner's Guide от Moz впитывают все связанные запросы в одну сессию.— Страницы сравнения: Принятие решения прямо на странице отсекает переходы к конкурентам. Сравнения кредиток на
NerdWallet закрывают сессию, выдавая продукты под конкретные сценарии.— Инструменты и калькуляторы: Выполнение задачи (ипотечный калькулятор, чек сложности ключа, расчет ROI) полностью закрывает интент без возврата. Инструменты
Ahrefs задают стандарт: результат по клику, никаких пейволов за email.— Кейсы с цифрами: Специфика намертво приклеивает юзера к странице. Обобщенные кейсы генерируют возвраты в поиск. Конкретика ("с 11 на 3 позицию за 90 дней по ключу стоимостью £8,000/месяц") закрывает дополнительные вопросы еще до того, как они появятся.
— Уникальные исследования: Проприетарная дата становится первоисточником. Статистику
SparkToro и Orbit Media цитируют, а не пытаются повторить. AI может сделать саммари, но не может присвоить авторство.— Пошаговые процессы: Активное вовлечение форсирует удержание. Пользователи, идущие по шагам, не возвращаются в серп на середине процесса.
— FAQ-хабы: Несколько запросов закрываются за один заход. Юзер видит, что следующий логичный вопрос уже разобран, остается на сайте и читает глубже.
Девять тактик на уровне страницы защищают этот сигнал: давай ответ на главный вопрос на первом экране, предугадывай следующий шаг, вычищай заявления без пруфов (триггеры
badClick), ставь CTA в момент завершения задачи, режь скорость загрузки (отвал на 4 секундах), жестко маппи title tag с контентом (переожидание = максимальный риск badClick), оптимизируй глубину скролла под мобилку, внедряй микроразметку FAQ/HowTo для преквалификации в серпе, и строй вечнозеленый контент (устаревшие страницы размывают сигналы в рамках 13-месячного окна NavBoost).Чего стоит избегать: новостей без контекста (юзеры идут гуглить бэкграунд), мнений без фактуры (уходят проверять), пустых категорий (задача не закрыта), базовых листиклов (генерируют десяток новых запросов) и хабовых страниц, которые просто линкуют без ответа (пользователям проще вернуться в Гугл, чем ковыряться в навигации).
https://www.lucatagliaferro.com/how-to-optimise-for-lastlongestclick/
#UserSignals #PogoSticking #SearchIntent
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

❤1🌚1
Алгоритм Rhubarb: одна страница на 10/10 заставляет Гугл повысить траст всего домена
Гугл считает средние показатели качества по всему сайту через модели Rhubarb и Content Effort.
Чтобы заабузить этот скоринг, выкатывай одну страницу с оценкой
Система оценивает домены по математическому среднему.
Получается, одна идеальная страница тянет общесайтовую среднюю вверх и пробивает потолок ранжирования для всех соседних урлов.
Форсируй максимальный балл Content Effort за счет инжекта сложных элементов: оригинальных данных исследований, внешних источников под конкретные цифры и встроенных интерактивных ассетов вроде кастомных диаграмм или рабочих тулзов.
Как только страница прорывается в топ-20, включается NavBoost, чтобы умножить базовый балл
Страницы, висящие на 70+ позициях, остаются невидимыми для системы и получают ноль навигационных бонусов.
При этом
Проектируй страницу так, чтобы забрать Last Click и выбить положительный вес 0.9.
Если юзеры выдают Short Click (отскок) или Medium Click (возврат в серп для уточнения запроса), алгоритм читает контент как неполный ответ и влепляет нейтрально-негативный вес.
Зависание на 10-м месте — это провал NavBoost, а не нехватка ссылочного веса.
Если страница застряла на дне первой страницы, аудируй верстку, чтобы нарастить время на сайте и закрепить финальный клик.
Отдельно упаковывай гестпосты с полной техничкой.
Выкатывай плотную структуру заголовков,
Разгон собственного скора Content Effort у гестпоста усиливает и сигнал качества, и ссылочный вес, который перетекает обратно на целевой домен.
#UserSignals #ContentSEO #LinkEquity
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Гугл считает средние показатели качества по всему сайту через модели Rhubarb и Content Effort.
Чтобы заабузить этот скоринг, выкатывай одну страницу с оценкой
Information Retrieval (IR) на 10/10, которая сработает как алгоритмическая лазейка, советует Алехандро Мейерханс.Система оценивает домены по математическому среднему.
Получается, одна идеальная страница тянет общесайтовую среднюю вверх и пробивает потолок ранжирования для всех соседних урлов.
Форсируй максимальный балл Content Effort за счет инжекта сложных элементов: оригинальных данных исследований, внешних источников под конкретные цифры и встроенных интерактивных ассетов вроде кастомных диаграмм или рабочих тулзов.
Как только страница прорывается в топ-20, включается NavBoost, чтобы умножить базовый балл
IR.Страницы, висящие на 70+ позициях, остаются невидимыми для системы и получают ноль навигационных бонусов.
При этом
NavBoost накладывает взвешенный балл за клик на базе скрытых юзерских реакций.Проектируй страницу так, чтобы забрать Last Click и выбить положительный вес 0.9.
Если юзеры выдают Short Click (отскок) или Medium Click (возврат в серп для уточнения запроса), алгоритм читает контент как неполный ответ и влепляет нейтрально-негативный вес.
Зависание на 10-м месте — это провал NavBoost, а не нехватка ссылочного веса.
Если страница застряла на дне первой страницы, аудируй верстку, чтобы нарастить время на сайте и закрепить финальный клик.
Отдельно упаковывай гестпосты с полной техничкой.
Выкатывай плотную структуру заголовков,
FAQs, микроразметку и внешние ссылки на самом доноре.Разгон собственного скора Content Effort у гестпоста усиливает и сигнал качества, и ссылочный вес, который перетекает обратно на целевой домен.
#UserSignals #ContentSEO #LinkEquity
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤2
Годами Google настаивал на том, что
Они используют не сырой
Утекшее поле
Рядом с ним находится
Это совместная работа
Я видел слишком много
5%
Google сравнивает твои клики с ожидаемым показателем именно для этого запроса, этой позиции, этого устройства и этого возраста документа, а не с глобальным бенчмарком.
Да, именно из-за этого строить прогнозы — сущий кошмар, но это уже другая история 📖
Также стоит отметить, что клик должен соответствовать ожиданиям.
Существуют целые уровни систем, определяющих, действительно ли пользователь остался доволен найденным.
Это означает, что кликбейт или отсутствие качественного контента — в долгосрочной перспективе тоже проигрышная стратегия.
Некоторые источники в комментариях (нажми "
Инсайты комьюнити
— Изменения элементов выдачи (LSA, заметность рекламных блоков PPC) могут провоцировать перекалибровку модели вероятностей — вмешательство элементов усложняет контекстные слои сверх запроса, позиции, устройства и возраста.
— Система
— Согласно Дон Андерсон: каждый
— Логика вероятности
#UserSignals #CTR #SERPAnalysis
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
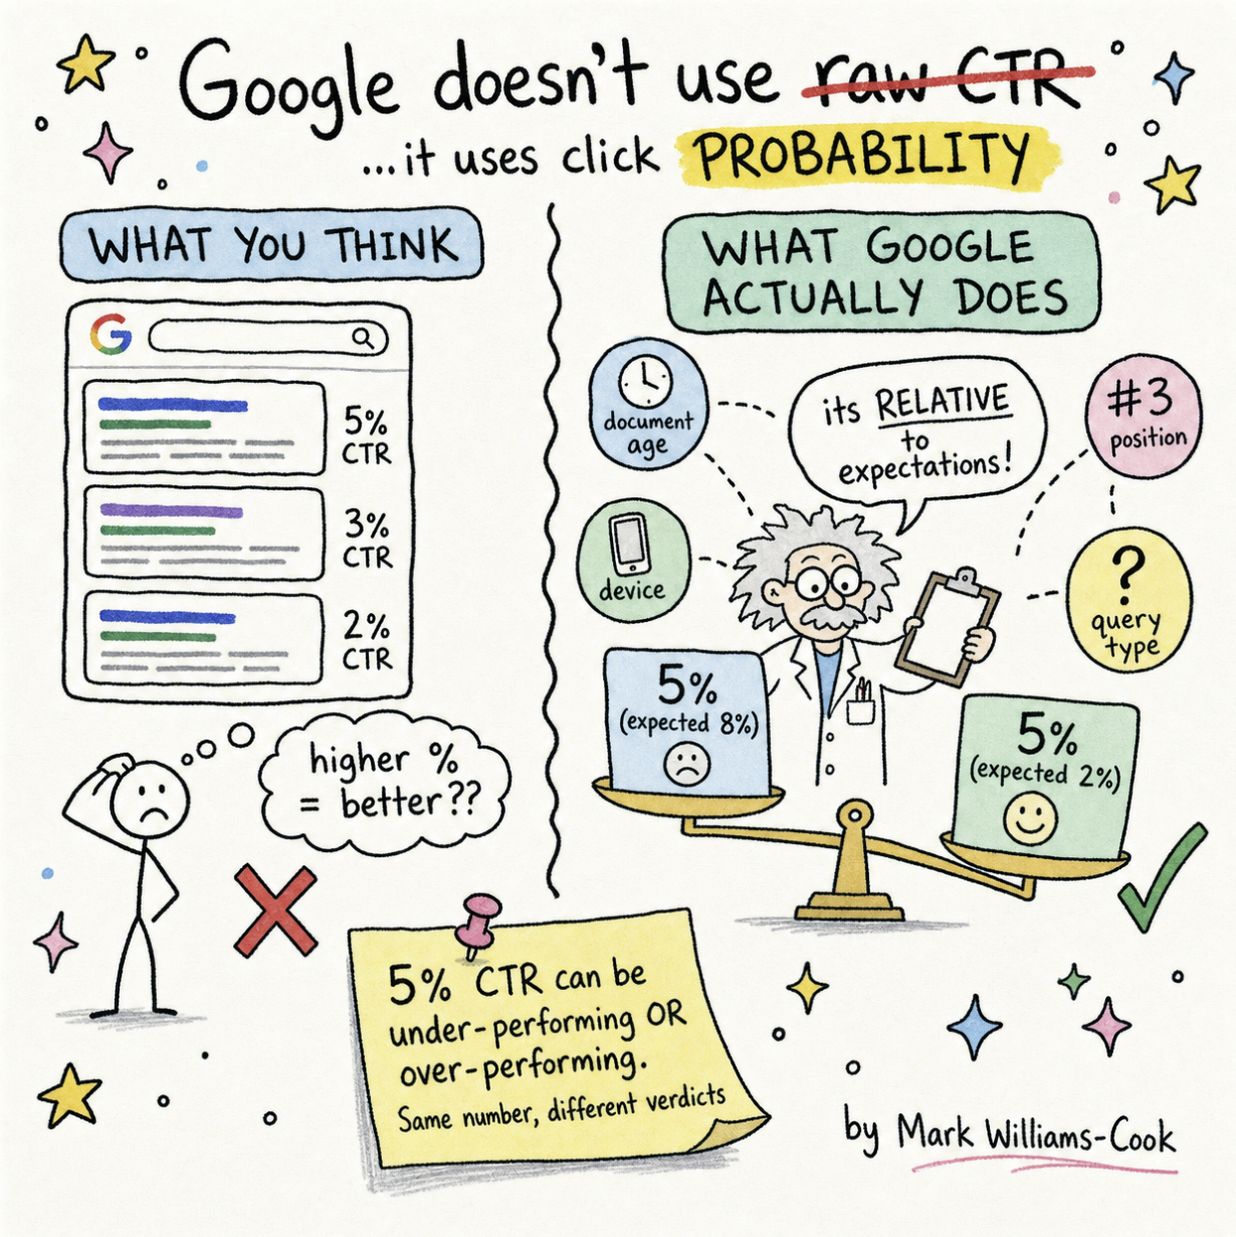
CTR не является прямым фактором ранжирования, и найденный нами эксплойт параметров ранжирования Google, похоже, подтверждает, почему это так, пишет Марк Уильямс-Кук.Они используют не сырой
CTR, а вероятность клика, обусловленную контекстом.Утекшее поле
click_age_probability — это вероятность клика с учетом возраста документа по сравнению с тем, что пользователи ожидают увидеть по этому запросу.Рядом с ним находится
relative_click_order (твоя позиция в пересортированной по кликам выдаче, а не изначальный ранк) и dense_glue_trad_imp_mobile (специфичный для устройства и макета вес показа).Это совместная работа
NavBoost и Glue, как Панду Наяк описывал под присягой на суде DOJ: реранкер, сидящий поверх Mustang.Я видел слишком много
SEO-команд, зацикленных на каком-то универсальном ожидаемом CTR.5%
CTR на третьей позиции по быстро меняющемуся новостному запросу может оказаться ниже ожиданий, тогда как те же 5% по медленному вечнозеленому запросу — перевыполнением нормы.Google сравнивает твои клики с ожидаемым показателем именно для этого запроса, этой позиции, этого устройства и этого возраста документа, а не с глобальным бенчмарком.
Да, именно из-за этого строить прогнозы — сущий кошмар, но это уже другая история 📖
Также стоит отметить, что клик должен соответствовать ожиданиям.
Существуют целые уровни систем, определяющих, действительно ли пользователь остался доволен найденным.
Это означает, что кликбейт или отсутствие качественного контента — в долгосрочной перспективе тоже проигрышная стратегия.
Некоторые источники в комментариях (нажми "
recent" и прокрути, потому что LinkedIn такой, какой есть, ребят).Инсайты комьюнити
— Изменения элементов выдачи (LSA, заметность рекламных блоков PPC) могут провоцировать перекалибровку модели вероятностей — вмешательство элементов усложняет контекстные слои сверх запроса, позиции, устройства и возраста.
— Система
CTR интегрирована с ранжированием, сигналами удовлетворенности, структурой контента, извлечением сущностей и оценкой доверия — изолированная оптимизация обречена на провал без учета этих взаимосвязей.— Согласно Дон Андерсон: каждый
Core Update, вероятно, меняет базовую линию измерения кликовой модели, сдвигая перекалибровку ожиданий по всему корпусу.— Логика вероятности
CTR распространяется и на оценку в Google Ads, что указывает на кросс-продуктовую согласованность методологии калибровки на основе ожиданий.#UserSignals #CTR #SERPAnalysis
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤2
Утекшая метрика Google «Craps» показывает, что алгоритм ценит только «последний долгий клик»
Внутренняя документация показывает, что на архитектуру ранжирования Google сильно влияет система под кодовым названием "
Эта система уходит далеко за рамки простого
Данные, которые она генерирует, — это основной инпут для мощной системы переранжирования
Система
Этот последний показатель определяет, что сессия поиска юзера закончилась на вашей странице, сигнализируя о полном удовлетворении его задачи.
Ваша главная стратегическая цель — максимизировать эти
Критически важно, что атрибут
Это создает "тематические районы" (topical neighborhoods), где целые разделы вашего сайта выстраивают репутацию, основанную на коллективной удовлетворенности юзеров страницами внутри них.
Это делает стратегическую архитектуру сайта критическим рычагом для концентрации позитивных сигналов ранжирования.
Более того, существует мощная петля обратной связи через атрибут
Система находит страницы с "высокими кликами в craps" и использует их как стартовые точки в симуляции потока трафика для моделирования внутреннего авторитета.
Страницы, которые стабильно удовлетворяют юзеров, не только получают награду в
Система также нарезает все данные по
https://www.hobo-web.co.uk/craps/
#UserSignals #PogoSticking #Rankings
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Внутренняя документация показывает, что на архитектуру ранжирования Google сильно влияет система под кодовым названием "
Craps" (QualityNavboostCrapsCrapsData), которая оценивает удовлетворенность юзеров на основе их поведения после клика.Эта система уходит далеко за рамки простого
CTR, фокусируясь на качестве и результате каждого клика.Данные, которые она генерирует, — это основной инпут для мощной системы переранжирования
NavBoost, которая анализирует 13-месячную историю этих пользовательских сигналов.Система
Craps делит клики на три критические метрики: goodClicks (юзеры, которые залипают на странице), badClicks (пого-стикинг) и, возможно, самый мощный позитивный сигнал — lastLongestClicks.Этот последний показатель определяет, что сессия поиска юзера закончилась на вашей странице, сигнализируя о полном удовлетворении его задачи.
Ваша главная стратегическая цель — максимизировать эти
lastLongestClicks.Критически важно, что атрибут
patternLevel подтверждает: эти сигналы удовлетворенности агрегируются на трех уровнях: отдельный URL, директория (p://host/path) и сабдомен.Это создает "тематические районы" (topical neighborhoods), где целые разделы вашего сайта выстраивают репутацию, основанную на коллективной удовлетворенности юзеров страницами внутри них.
Это делает стратегическую архитектуру сайта критическим рычагом для концентрации позитивных сигналов ранжирования.
Более того, существует мощная петля обратной связи через атрибут
onsiteProminence.Система находит страницы с "высокими кликами в craps" и использует их как стартовые точки в симуляции потока трафика для моделирования внутреннего авторитета.
Страницы, которые стабильно удовлетворяют юзеров, не только получают награду в
SERPs, но и становятся внутренними авторитетными хабами, усиливая важность юзабилити всего вашего сайта.Система также нарезает все данные по
country, language и device, а это значит, что ваш портфель сигналов управляется независимо для каждого контекста.https://www.hobo-web.co.uk/craps/
#UserSignals #PogoSticking #Rankings
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
😁4👍3❤1
Медленная инъекция трафика с плохими ПФ отравляет поведенческие факторы без срабатывания защиты
Самые продвинутые спецы уже не занимаются простым ссылочным спамом; они настолько хорошо понимают алгоритмы, что знают, что именно не работает, и применяют эти знания прямо против своих конкурентов.
Особенно опасный вектор атаки, который мы наблюдаем, — это не массированная, шумная атака, а медленное отравление поведенческих метрик, рассказывает Джеймс Дули.
Вместо грубой
Атакующие посылают небольшой, постоянный поток прямого трафика с намеренно плохими поведенческими сигналами — например, с экстремально низким временем на странице — и распределяют его по множеству разных страниц в течение дня.
Этот метод специально заточен под то, чтобы оставаться незамеченным.
Цель — не положить ваш сайт, а медленно испортить данные по долгосрочным поведенческим метрикам, которые идут в системы типа
Google собирает эти данные за 28-дневный период и хранит их в истории до 13 месяцев.
Со временем эта "капельница" из плохих сигналов заставляет алгоритмы Гугла поверить, что ваш сайт дает плохой пользовательский опыт, что приводит к постепенному, но разрушительному обвалу позиций.
Из-за этого атаку невероятно сложно обнаружить и защититься от нее.
Поскольку трафик "капает" с постоянно меняющихся
Хотя стратегический эффект очевиден, конкретный технический метод для реализации этого в обсуждении не упоминался.
Защита от этого — постоянная и заведомо проигрышная битва с искушенным противником.
#NegativeSEO #UserSignals #BlackHatSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Самые продвинутые спецы уже не занимаются простым ссылочным спамом; они настолько хорошо понимают алгоритмы, что знают, что именно не работает, и применяют эти знания прямо против своих конкурентов.
Особенно опасный вектор атаки, который мы наблюдаем, — это не массированная, шумная атака, а медленное отравление поведенческих метрик, рассказывает Джеймс Дули.
Вместо грубой
DDoS-атаки, которая положит сервер и поднимет тревогу, это медленная атака "под капельницей".Атакующие посылают небольшой, постоянный поток прямого трафика с намеренно плохими поведенческими сигналами — например, с экстремально низким временем на странице — и распределяют его по множеству разных страниц в течение дня.
Этот метод специально заточен под то, чтобы оставаться незамеченным.
Цель — не положить ваш сайт, а медленно испортить данные по долгосрочным поведенческим метрикам, которые идут в системы типа
Navboost (система ранжирования на основе кликов).Google собирает эти данные за 28-дневный период и хранит их в истории до 13 месяцев.
Со временем эта "капельница" из плохих сигналов заставляет алгоритмы Гугла поверить, что ваш сайт дает плохой пользовательский опыт, что приводит к постепенному, но разрушительному обвалу позиций.
Из-за этого атаку невероятно сложно обнаружить и защититься от нее.
Поскольку трафик "капает" с постоянно меняющихся
IP, можно обойти даже такие инструменты, как Cloudflare.Хотя стратегический эффект очевиден, конкретный технический метод для реализации этого в обсуждении не упоминался.
Защита от этого — постоянная и заведомо проигрышная битва с искушенным противником.
#NegativeSEO #UserSignals #BlackHatSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
🌚2
Агрессивный залив на EMD-домены фабрикует брендовый сигнал и ускоряет ранжирование
Я отказываюсь ждать окончания традиционного периода "песочницы".
Вместо пассивного наращивания авторитета, я использую платный трафик, чтобы заставить алгоритм Google немедленно признать новый домен валидной сущностью.
Мы абузим `EMD`-домены (Exact Match Domains) и агрессивный
Механизм представляет собой принудительную петлю обратной связи: мы запускаем шоп на целевом
Это не просто для немедленных продаж; это инъекция сигнала.
В течение шести месяцев это давление заставляет источник трафика "
Google детектит этот всплеск прямых заходов и поведение юзеров с высоким интентом — изначально триггернутое рекламой — и интерпретирует это как сильный брендовый сигнал.
Доказывая конверсионную ценность сайта и удержание юзеров через платные каналы, мы "прогреваем" траст домена.
Алгоритм видит, что юзеры потребляют контент и конвертятся, что напрямую бустит органические
Мы фактически платим, чтобы скипнуть фазу наработки траста, используя рекламный бюджет для валидации качества сайта перед краулером до того, как он начнет ранжироваться органически.
#UserSignals #EMD #Ecommerce
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Я отказываюсь ждать окончания традиционного периода "песочницы".
Вместо пассивного наращивания авторитета, я использую платный трафик, чтобы заставить алгоритм Google немедленно признать новый домен валидной сущностью.
Мы абузим `EMD`-домены (Exact Match Domains) и агрессивный
Google Ads (SEA), чтобы сфабриковать брендовый сигнал, который ускоряет органическое ранжирование, раскрывает Энцо Оноре.Механизм представляет собой принудительную петлю обратной связи: мы запускаем шоп на целевом
EMD и сразу заливаем его платным трафиком.Это не просто для немедленных продаж; это инъекция сигнала.
В течение шести месяцев это давление заставляет источник трафика "
Direct" составлять 7-10% от нашего общего оборота.Google детектит этот всплеск прямых заходов и поведение юзеров с высоким интентом — изначально триггернутое рекламой — и интерпретирует это как сильный брендовый сигнал.
Доказывая конверсионную ценность сайта и удержание юзеров через платные каналы, мы "прогреваем" траст домена.
Алгоритм видит, что юзеры потребляют контент и конвертятся, что напрямую бустит органические
SEO-позиции.Мы фактически платим, чтобы скипнуть фазу наработки траста, используя рекламный бюджет для валидации качества сайта перед краулером до того, как он начнет ранжироваться органически.
#UserSignals #EMD #Ecommerce
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Claude тянет выдачу из Brave в 86.7% случаев — и там решают поведенческие, а не бэклинки
Корреляционный анализ
Документация
Полевые тесты подтверждают:
До того как сигнал уйдет из браузера,
Страницы отбрасываются, если совпадает хоть что-то: нет тайтла хотя бы в одном фетче, стоит
Страница, которая отдает каноникал залогиненным юзерам, но скрывает его от анонимных краулеров, генерирует ноль
Закрытые логином, персонализированные страницы с расхождением
Стек сигналов
1. Корреляция запроса (qr.q) — запрос в
2. Активное время (a) — инкрементируется каждую секунду только если за последние 5 секунд зафиксировано взаимодействие (движение мыши, скролл, нажатие клавиши, копирование, клик). Фоновые вкладки отдают почти нулевой
3. События копирования (e.cp) — пассивный сигнал с самым высоким интентом. Требует накопленного активного времени, целенаправленного выделения текста и явного копирования. Контент, из которого можно вытащить пользу (данные, определения, код, фреймворки), генерирует больше
4. Глубина скролла (x.lt) и события скролла (e.sc) — схлопываются до одного в секунду;
5. Клики по внутренней перелинковке (массив
Каждое событие вовлеченности проходит двойной гейт: оно засчитывается, только если уже накопилось
Синтетические высокочастотные клики сигнал не раздувают.
Страницы, которые не успели отрендериться к этому моменту, отдают урезанный пейлоад.
Сессии дольше
Сигналы шифруются через протокол
Бэклинки всё ещё управляют приоритизацией краулинга
#Claude #SearchEngines #UserSignals
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Корреляционный анализ
Profound фиксирует 86.7% пересечения между ссылками Claude и топом органики Brave.Документация
Anthropic по субпроцессорам прямо называет Brave провайдером; функция веб-поиска содержит параметр BraveSearchParams; интеграция Claude в Google Cloud Vertex AI указывает Brave открытым текстом.Полевые тесты подтверждают:
Claude вытягивает страницы из топа Brave, даже если Google их еще не проиндексировал, и игнорирует топ Bing вне индекса Brave.Perplexity и ChatGPT показывают слабую корреляцию с Brave — оптимизировать нужно именно связку Brave/Claude.Brave Search опирается на два инпута: BraveBot для классического краулинга и Web Discovery Project (WDP) — поток opt-in сигналов из браузера Brave.WDP лежит в опенсорсе (github.com/brave/web-discovery-project) и читается как алгоритм ранжирования на JavaScript.До того как сигнал уйдет из браузера,
WDP прогоняет фильтр validDoubleFetch().Страницы отбрасываются, если совпадает хоть что-то: нет тайтла хотя бы в одном фетче, стоит
noindex, несовпадение каноникала, разница длины HTML между авторизованным и анонимным фетчем ниже 10% или выше 90%, поле пароля только в анонимном фетче, форма только в анонимном.Страница, которая отдает каноникал залогиненным юзерам, но скрывает его от анонимных краулеров, генерирует ноль
WDP-сигналов.Закрытые логином, персонализированные страницы с расхождением
HTML в пайплайн не попадают.Стек сигналов
WDP по убыванию силы:1. Корреляция запроса (qr.q) — запрос в
Brave, который привел к клику, плюс глубина (максимум 2). Эквивалент связки запрос→страница, которую Google держит в GSC, только собирается на стороне клиента. Самый сильный сигнал в системе.2. Активное время (a) — инкрементируется каждую секунду только если за последние 5 секунд зафиксировано взаимодействие (движение мыши, скролл, нажатие клавиши, копирование, клик). Фоновые вкладки отдают почти нулевой
a независимо от времени жизни.3. События копирования (e.cp) — пассивный сигнал с самым высоким интентом. Требует накопленного активного времени, целенаправленного выделения текста и явного копирования. Контент, из которого можно вытащить пользу (данные, определения, код, фреймворки), генерирует больше
e.cp, чем размытый текст — так задумано алгоритмом.4. Глубина скролла (x.lt) и события скролла (e.sc) — схлопываются до одного в секунду;
e.sc = 12 означает 12 уникальных секунд скролла, а не 12 сырых событий.5. Клики по внутренней перелинковке (массив
c) — фиксируется каждый внутренний клик, отдавая Brave навигационный граф на основе реальных юзеров в отрыве от графа краулинга. Мощная перелинковка бустит сигнал для вложенных страниц.Каждое событие вовлеченности проходит двойной гейт: оно засчитывается, только если уже накопилось
a > 1 секунды, а каждый тип события троттлится до одного инкремента в секунду — учитываются уникальные секунды взаимодействия, а не количество действий.Синтетические высокочастотные клики сигнал не раздувают.
PAGE_WAIT_TIME = 5000ms — WDP собирает структурные данные строго через 5 секунд после загрузки.Страницы, которые не успели отрендериться к этому моменту, отдают урезанный пейлоад.
Сессии дольше
deadTwentyMts = 20 minutes капятся и отправляют частичные данные.Сигналы шифруются через протокол
STAR — Brave читает агрегированные данные только после того, как 20 уникальных /24 подсетей отправят один и тот же URL (поле oc форсирует разнообразие подсетей).WDP не учитывает: бэклинки, социальные сигналы, возраст домена, микроразметку.Бэклинки всё ещё управляют приоритизацией краулинга
BraveBot, но слой ранжирования по ПФ, который кормит Claude, читает поведение, а не графы.#Claude #SearchEngines #UserSignals
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤1
Метрика unicornClicks фиксирует клики детей, а не премиальные сигналы суперпользователей
Утечка
Большая часть
Нейминг доказывает обратное.
Переменные
То есть это поле маркирует источник клика, а не его ценность.
А "``Unicorn``" (Единорог) во внутренних документах Гугла означает только одно: детский аккаунт.
Выйдя за рамки утечки, я вытащил собственный код Гугла, и это закрыло вопрос.
В слитом модуле
Исходники мобильных приложений докидывают остальные пруфы: флаг
Плюс метрика
Этот термин фигурирует в
Публичный файл
Закон
Поисковику приходится идентифицировать клики детей, чтобы исключать их из обычного ранжирования.
Участвуют ли
В любом случае, "оптимизация под unicornClicks" — это погоня за сигналом, который закон обязывает Гугл изолировать.
https://seekio.pl/unicornclicks-sygnal-klikniec-dzieci/
#UserSignals #SearchEngines #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Утечка
Google API Content Warehouse 2024 года вскрыла поле unicornClicks.Большая часть
SEO-индустрии приняла его за премиальный сигнал — качественные клики от трастовых "суперпользователей".Нейминг доказывает обратное.
Переменные
goodClicks и badClicks образуют парную метрику качества, тогда как у unicornClicks нет антонима notUnicornClicks.То есть это поле маркирует источник клика, а не его ценность.
А "``Unicorn``" (Единорог) во внутренних документах Гугла означает только одно: детский аккаунт.
Выйдя за рамки утечки, я вытащил собственный код Гугла, и это закрыло вопрос.
В слитом модуле
FieldAcl доступ юзера-единорога ограничен параметром SAME_UNICORN_FAMILY — аккаунт живет внутри семейной группы, а не как самостоятельный профиль.Исходники мобильных приложений докидывают остальные пруфы: флаг
IS_UNICORN_CHILD_ACCOUNT в YouTube, UNICORN_DUMBLEDORE_PARENTAL_CONTROLS в Play Services, а также жизненный цикл от создания с согласия родителей до UNICORN_GRADUATION.Плюс метрика
wasUnicorn, которая сохраняет ярлык даже после того, как детский аккаунт становится взрослым.Этот термин фигурирует в
Play Services, YouTube, Photos и Maps, но отсутствует в Family Link или YouTube Kids — то есть в приложениях, которые изначально созданы для детей и не нуждаются во внутренних маркерах для распознавания детских профилей.Публичный файл
usertypes.md в Chromium заявляет прямо: аккаунт Unicorn предназначен "для детей, не достигших возраста согласия в своей юрисдикции".NavBoost изолирует эти клики по юридическим, а не качественным причинам.Закон
COPPA в США запрещает использовать поведенческие данные лиц младше 13 лет для профилирования, а европейский GDPR-K еще жестче (для строгих возрастных правил ЕС у Гугла даже заведен флаг REGISTERED_GAIA_SERVICES_IS_UNICORN_OVER_13_IN_EU).Поисковику приходится идентифицировать клики детей, чтобы исключать их из обычного ранжирования.
Участвуют ли
unicornClicks в ранжировании вообще — или они просто логируются и отправляются в карантин — пока не подтверждено.В любом случае, "оптимизация под unicornClicks" — это погоня за сигналом, который закон обязывает Гугл изолировать.
https://seekio.pl/unicornclicks-sygnal-klikniec-dzieci/
#UserSignals #SearchEngines #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤🔥1❤1
Логи высокочастотного парсинга доказывают: Гугл ротирует позиции поиска 20-минутными окнами для клик-тестов
Скачки позиций после апдейтов сайта отрабатывают как временные клик-тесты, а не постоянная прописка в индексе, фиксирует Корай Тугберк Гюбюр.
Алгоритм распределяет тестовые страницы по выделенным слотам диверсификации серпа на короткие окна видимости.
Сначала система выводит целевой урл ровно на 20 минут в день.
Если за это время страница собирает позитивный фидбек по кликам, на следующий день алгоритм расширяет окно показов до 40 минут.
Этот тестовый цикл растет шаг за шагом, пока страница не получит постоянные позиции на все 24 часа.
Тем временем ежедневные трекеры позиций маскируют эти почасовые перестановки, детализирует Корай.
Он связывает такую непрерывную ротацию урлов в выдаче с механизмом Liquid SERPs, который балансирует распределение показов между доменами-конкурентами.
Чтобы вскрыть точные временные окна, нужны скрипты высокочастотного парсинга, которые логируют посекундные изменения.
Во время тестов скрипт
#SERPVolatility #RankTracking #UserSignals
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Скачки позиций после апдейтов сайта отрабатывают как временные клик-тесты, а не постоянная прописка в индексе, фиксирует Корай Тугберк Гюбюр.
Алгоритм распределяет тестовые страницы по выделенным слотам диверсификации серпа на короткие окна видимости.
Сначала система выводит целевой урл ровно на 20 минут в день.
Если за это время страница собирает позитивный фидбек по кликам, на следующий день алгоритм расширяет окно показов до 40 минут.
Этот тестовый цикл растет шаг за шагом, пока страница не получит постоянные позиции на все 24 часа.
Тем временем ежедневные трекеры позиций маскируют эти почасовые перестановки, детализирует Корай.
Он связывает такую непрерывную ротацию урлов в выдаче с механизмом Liquid SERPs, который балансирует распределение показов между доменами-конкурентами.
Чтобы вскрыть точные временные окна, нужны скрипты высокочастотного парсинга, которые логируют посекундные изменения.
Во время тестов скрипт
SERP beat собрал 60,000 снимков одной страницы выдачи с миллисекундными интервалами — это доказывает, что серп живет в вечном движении для замера кликовых моделей в реальном времени.#SERPVolatility #RankTracking #UserSignals
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Утечка Content Warehouse API доказывает: 10-секундный dwell time вешает фильтры на страницы конвертеров
Слитое
Система корректирует позиции в живом серпе через
В итоге
На утилитарных запросах и конвертерах валют затянутый
Если посетитель висит на странице дольше 10 секунд, алгоритм классифицирует взаимодействие как провал.
Система трекает эту точную телеметрию через
Отдельно
Когда юзер кликает на домен, прокликивает 5–6 внутренних страниц, возвращается на стартовый урл и уходит без конверсии, алгоритм флагит сессию как нерешенную.
Если тот же юзер после этого совершает покупку на домене конкурента,
#API #UserSignals #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Слитое
API Гугла содержит модуль RankLab, который присваивает каждому урлу алгоритмический base rank вместе с экспериментальным test rank, вскрывает Корай Тугберк Гюбюр.Система корректирует позиции в живом серпе через
NavBoost — гибридный фактор скоринга, который агрегирует кликовый фидбек юзеров, PageRank и тематические эмбеддинги.В итоге
RankLab не награждает за длинные сессии тупо по умолчанию, а применяет разные пороги удовлетворенности кликом в зависимости от скрытого интента запроса.На утилитарных запросах и конвертерах валют затянутый
dwell time напрямую сигналит о фрустрации юзера.Если посетитель висит на странице дольше 10 секунд, алгоритм классифицирует взаимодействие как провал.
Система трекает эту точную телеметрию через
Site Engagement Score из Chromium и INP, чтобы проверить, эффективно ли юзер закрыл свою задачу.Отдельно
e-commerce сайты ловят прямые просадки позиций из-за паттерна engagement trap.Когда юзер кликает на домен, прокликивает 5–6 внутренних страниц, возвращается на стартовый урл и уходит без конверсии, алгоритм флагит сессию как нерешенную.
Если тот же юзер после этого совершает покупку на домене конкурента,
RankLab пессимизирует первый сайт и бустит конвертящего конкурента в товарной выдаче.#API #UserSignals #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤1
Логи Discover вскрывают 8x разрыв в бусте охватов: всё решает аффинити, а не кнопка Follow
Каждая карточка
Всего их около девяти, данные вывели за два года трекинга лент тестовых аккаунтов.
Вакансия Гугла в команду
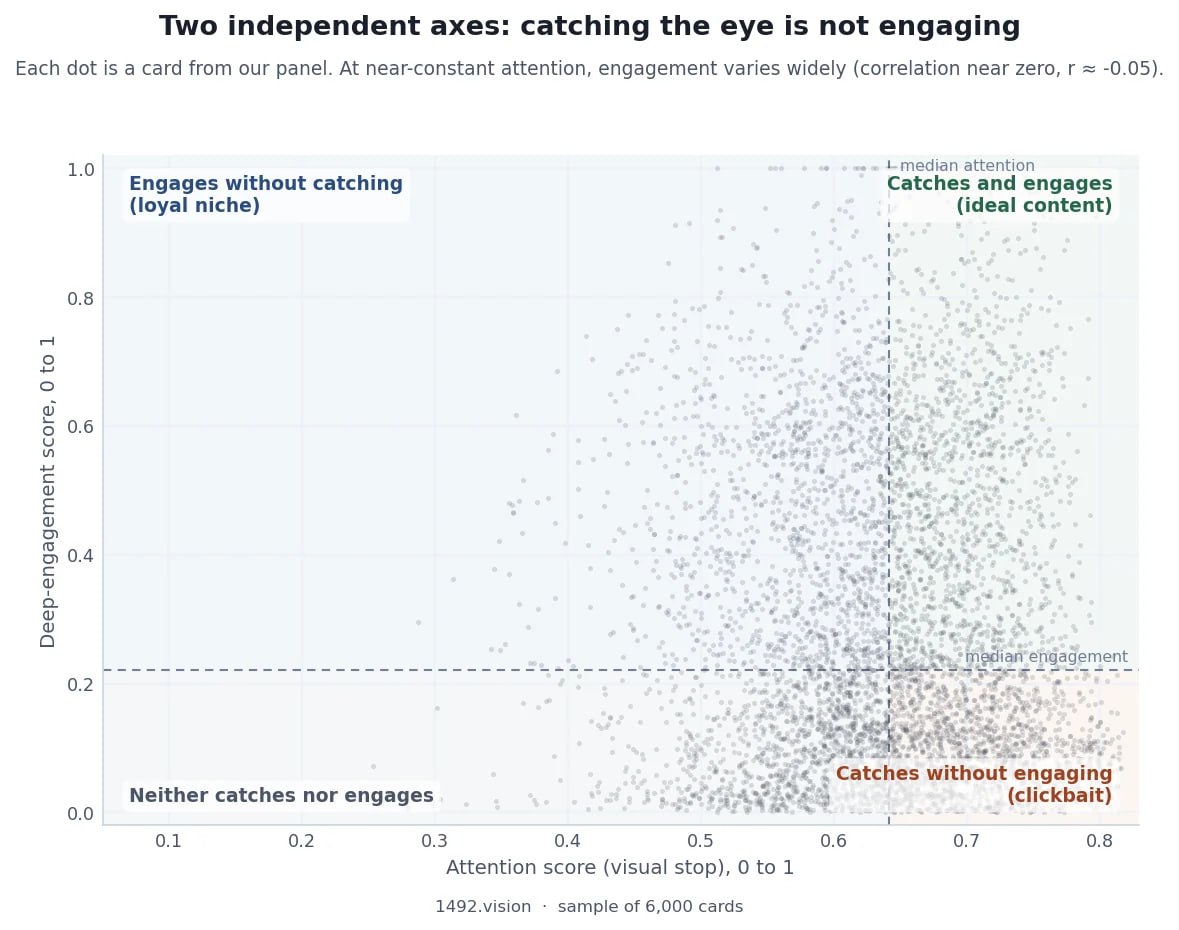
Эти девять скоров сводятся к двум осям, которые почти не коррелируют.
Внимание привязано к статье: оно группирует скор визуальной остановки и его почти зеркальный антипод — скор пролистывания.
Между пользователями этот показатель почти не меняется.
Вовлеченность завязана на пару "читатель-контент".
Она объединяет глубокую вовлеченность и глубину чтения, и вот тут значения дико скачут от читателя к читателю на одной и той же статье.
Заголовок может захватить внимание без вовлечения (паттерн кликбейта) или вовлечь узкую нишу, пока большинство тупо пролистывает статью.
На тестовой панели интеракции растут вместе с предсказанной глубокой вовлеченностью (соотношение примерно 1 к 2 от дна к топу шкалы), стабильно падают по мере роста вероятности пролистывания, и снова удваиваются, когда высокая глубина вовлечения накладывается на низкую вероятность пролистывания.
Масштаб усиления охватов определяет персонализация, а не тематика.
Два французских спортивных паблишера с почти идентичным тематическим потенциалом (до этапа персонализации) откручивались на одних и тех же аккаунтах.
Тот, кому алгоритм предсказал большую вовлеченность, собрал примерно в 2 раза больше предсказанной глубокой вовлеченности и получил в 8 раз больший итоговый буст охватов.
Причем доминирующий источник (L'Équipe) — это тот, на который подписано меньше тестовых аккаунтов.
В американском тесте
Зеркальный тест на одном источнике (9to5Google) доказывает обратное: при идентичном тематическом потенциале предсказанная глубокая вовлеченность у подписанных на паблишера аккаунтов почти вдвое выше, чем у неподписанных.
Кнопка
При этом оба теста — лишь локальные иллюстрации механики на малой выборке, а не масштабное доказательство.
На верхнем уровне каждый юзер, похоже, тащит за собой несколько семейств эмбеддингов, а не один вектор:
—
—
—
—
Эти векторы уходят в двухбашенный поиск, где кандидаты подтягиваются по близости пары "юзер-контент" в общем пространстве.
Google также, судя по всему, держит отдельный профиль под каждый канал извлечения и обучается тому, какие каналы подходят конкретному юзеру.
Похоже,
Названия скоров и роли семейств — это гипотезы автора на базе логов, а не словарь Гугла; как минимум два показателя до сих пор не поддаются четкой расшифровке.
Плюс вовлеченность — это лишь половина картины: Google отделяет вовлеченность от удовлетворенности, и эти данные раскрывают только первую часть.
https://1492.vision/research/discover-prediction-embedding-en
#GoogleDiscover #Embeddings #UserSignals
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Каждая карточка
Discover — показанная или нет — несет в себе скоры предсказания от 0 до 1.Всего их около девяти, данные вывели за два года трекинга лент тестовых аккаунтов.
Вакансия Гугла в команду
Discover Ranking прямо называет пайплайн: извлечение, предсказание, ранжирование, эмбеддинги.Эти девять скоров сводятся к двум осям, которые почти не коррелируют.
Внимание привязано к статье: оно группирует скор визуальной остановки и его почти зеркальный антипод — скор пролистывания.
Между пользователями этот показатель почти не меняется.
Вовлеченность завязана на пару "читатель-контент".
Она объединяет глубокую вовлеченность и глубину чтения, и вот тут значения дико скачут от читателя к читателю на одной и той же статье.
Заголовок может захватить внимание без вовлечения (паттерн кликбейта) или вовлечь узкую нишу, пока большинство тупо пролистывает статью.
На тестовой панели интеракции растут вместе с предсказанной глубокой вовлеченностью (соотношение примерно 1 к 2 от дна к топу шкалы), стабильно падают по мере роста вероятности пролистывания, и снова удваиваются, когда высокая глубина вовлечения накладывается на низкую вероятность пролистывания.
Масштаб усиления охватов определяет персонализация, а не тематика.
Два французских спортивных паблишера с почти идентичным тематическим потенциалом (до этапа персонализации) откручивались на одних и тех же аккаунтах.
Тот, кому алгоритм предсказал большую вовлеченность, собрал примерно в 2 раза больше предсказанной глубокой вовлеченности и получил в 8 раз больший итоговый буст охватов.
Причем доминирующий источник (L'Équipe) — это тот, на который подписано меньше тестовых аккаунтов.
В американском тесте
ESPN против NFL.com вектор сохранился, хотя разрыв меньше: источник с лучшим прогнозом вовлеченности показал предсказанную глубокую вовлеченность 0,22 против 0,13, а итоговый буст составил 1,28x.Зеркальный тест на одном источнике (9to5Google) доказывает обратное: при идентичном тематическом потенциале предсказанная глубокая вовлеченность у подписанных на паблишера аккаунтов почти вдвое выше, чем у неподписанных.
Кнопка
Follow качает аффинити, но алгоритм взвешивает именно накопленную историю взаимодействия с источником.При этом оба теста — лишь локальные иллюстрации механики на малой выборке, а не масштабное доказательство.
На верхнем уровне каждый юзер, похоже, тащит за собой несколько семейств эмбеддингов, а не один вектор:
—
Astria: интересы для Discover (основной профиль плюс краткосрочный вариант).—
Hobbes: тренды.—
Deep Now: реал-тайм контент.—
Monet: впервые засекли на шоппинге, а затем как канал извлечения, отвечающий за карточки AI-сводок для финансов и технопрессы (связь держится только на названии канала).Эти векторы уходят в двухбашенный поиск, где кандидаты подтягиваются по близости пары "юзер-контент" в общем пространстве.
Google также, судя по всему, держит отдельный профиль под каждый канал извлечения и обучается тому, какие каналы подходят конкретному юзеру.
Похоже,
Monet опирается на ортогонализированные эмбеддинги: искусственно накрученный сигнал просто перестаёт влиять на рекомендации, не помечая сам контент как нежелательный.Названия скоров и роли семейств — это гипотезы автора на базе логов, а не словарь Гугла; как минимум два показателя до сих пор не поддаются четкой расшифровке.
Плюс вовлеченность — это лишь половина картины: Google отделяет вовлеченность от удовлетворенности, и эти данные раскрывают только первую часть.
https://1492.vision/research/discover-prediction-embedding-en
#GoogleDiscover #Embeddings #UserSignals
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO