Сопоставление апдейтов алгоритма Google с атрибутами из утечек данных
Логические выводы в скриншоте.
#CoreUpdates #AlgorithmPenalties #SERPAnalysis
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
content warehouse api.Логические выводы в скриншоте.
#CoreUpdates #AlgorithmPenalties #SERPAnalysis
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
🤝2
Утечка раскрыла систему Firefly, которая пессимизирует сайты целиком
Слитый
Эта система работает на уровне домена, оценивая паттерны по всему сайту, а не отдельные страницы, чтобы определить манипулятивный умысел и бесполезный выхлоп.
Теперь выживание зависит от того, чтобы понимать ее ключевые метрики и соответствовать им.
Логика системы строится на синтезе трех категорий сигналов: скорость публикации контента, оценка качества и удовлетворенность юзеров.
Скорость производства контента отслеживается через
Резкий, драматический скачок этого показателя — главный флаг для потенциального абьюза.
Чтобы отличить легальное расширение от спама,
"Высококачественная" страница определяется по внутреннему скору (
Большое расхождение между общим числом новых урлов и числом новых качественных статей — это мощный негативный сигнал.
Удовлетворенность юзеров — финальный валидатор, который измеряется напрямую через данные из системы
Критическая метрика — это отношение `dailyClicks` к `dailyGoodClicks`.
Большой объем кликов ничего не значит, если число "хороших кликов" непропорционально низкое.
Это дает мощный математический сигнал о неудовлетворенности юзеров в масштабе.
Эти данные напрямую соотносятся с политиками по спаму, такими как '
Система также отслеживает манипуляции со свежестью контента, сравнивая
https://www.hobo-web.co.uk/firefly/
#Penalties #UserSignals #AlgorithmPenalties
@MikeBlazerX
Пушки — в @MikeBlazerPRO
Слитый
protobuf от Google, QualityCopiaFireflySiteSignal, раскрывает архитектуру того, как Google автоматизирует обнаружение и пессимизацию сайтов за массовое злоупотребление контентом.Эта система работает на уровне домена, оценивая паттерны по всему сайту, а не отдельные страницы, чтобы определить манипулятивный умысел и бесполезный выхлоп.
Теперь выживание зависит от того, чтобы понимать ее ключевые метрики и соответствовать им.
Логика системы строится на синтезе трех категорий сигналов: скорость публикации контента, оценка качества и удовлетворенность юзеров.
Скорость производства контента отслеживается через
numOfUrlsByPeriods, который считает новые URL в 30-дневных окнах.Резкий, драматический скачок этого показателя — главный флаг для потенциального абьюза.
Чтобы отличить легальное расширение от спама,
Firefly сравнивает сырой рост URL с созданием высококачественного контента, который отслеживается через numOfArticlesByPeriods."Высококачественная" страница определяется по внутреннему скору (
numOfArticles8 для страниц с оценкой >= 0.8), который, вероятно, берется из других моделей, таких как QualityNsrPQData, измеряющей contentEffort.Большое расхождение между общим числом новых урлов и числом новых качественных статей — это мощный негативный сигнал.
Удовлетворенность юзеров — финальный валидатор, который измеряется напрямую через данные из системы
NavBoost.Критическая метрика — это отношение `dailyClicks` к `dailyGoodClicks`.
Большой объем кликов ничего не значит, если число "хороших кликов" непропорционально низкое.
Это дает мощный математический сигнал о неудовлетворенности юзеров в масштабе.
Эти данные напрямую соотносятся с политиками по спаму, такими как '
Thin Affiliation' и 'Doorway Abuse'.Система также отслеживает манипуляции со свежестью контента, сравнивая
latestFirstseenSec (когда краулер обнаружил) с latestBylineDateSec (дата публикации), и содержит специфические флаги риска, вроде numOfGamblingPages, для выявления потенциального абьюза репутации сайта.https://www.hobo-web.co.uk/firefly/
#Penalties #UserSignals #AlgorithmPenalties
@MikeBlazerX
Пушки — в @MikeBlazerPRO
👍9❤2
Слив Google: QRG захардкожен
Споры о том, влияют ли
Мы нашли захардкоженные переменные в сливе
Пистолет с дымком — переменная под названием
Определенная в сливе как "оценка стандартного отклонения рейтинга PQ сайта", эта переменная подтверждает, что Google вычисляет конкретное целое число
Критически важно:
Это создает "Математическую Ловушку", которая декодирует заявление Джона Мюллера от 2025 года о том, что "последовательность — самый большой фактор технического SEO".
Он не говорил метафорами; он описывал именно эту формулу.
Если у вас "Высокая Дисперсия" — микс из качественных активов и низкопробной шелухи — ваш
Это сигнализирует алгоритму, что ваша сущность математически непредсказуема, утаскивая вниз позиции даже ваших лучших страниц.
Поэтому "Самооценка" — это не мягкий совет; это техническая инструкция по предсказанию вашего собственного
Прунинг контента — больше не просто уборка, это статистическая необходимость для снижения вашего стандартного отклонения.
Чтобы восстановить траст, вы должны механически снизить это число, безжалостно удаляя, объединяя или вынося на поддомены страницы с низким скором.
Вас ранжируют не только за ваше превосходство; вас штрафуют за отклонение от него.
https://www.hobo-web.co.uk/google-pq-page-quality-rating/
#QualityRaters #AlgorithmPenalties #Pruning
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
Споры о том, влияют ли
Quality Rater Guidelines (QRG) на алгоритм, мертвы.Мы нашли захардкоженные переменные в сливе
Content Warehouse API, которые доказывают, что "Page Quality" (PQ) — это не просто концепт для людей, это прямой сигнал ранжирования, определенный конкретными целыми числами в пайплайне.Пистолет с дымком — переменная под названием
siteQualityStddev.Определенная в сливе как "оценка стандартного отклонения рейтинга PQ сайта", эта переменная подтверждает, что Google вычисляет конкретное целое число
pqData для каждого URL — "Цифровой Двойник" оценок живых асессоров, сгенерированный через Supervised Machine Learning.Критически важно:
siteQualityStddev измеряет разброс (Стандартное Отклонение) этих скоров по всему вашему домену.Это создает "Математическую Ловушку", которая декодирует заявление Джона Мюллера от 2025 года о том, что "последовательность — самый большой фактор технического SEO".
Он не говорил метафорами; он описывал именно эту формулу.
Если у вас "Высокая Дисперсия" — микс из качественных активов и низкопробной шелухи — ваш
siteQualityStddev спайкует.Это сигнализирует алгоритму, что ваша сущность математически непредсказуема, утаскивая вниз позиции даже ваших лучших страниц.
Поэтому "Самооценка" — это не мягкий совет; это техническая инструкция по предсказанию вашего собственного
pqData.Прунинг контента — больше не просто уборка, это статистическая необходимость для снижения вашего стандартного отклонения.
Чтобы восстановить траст, вы должны механически снизить это число, безжалостно удаляя, объединяя или вынося на поддомены страницы с низким скором.
Вас ранжируют не только за ваше превосходство; вас штрафуют за отклонение от него.
https://www.hobo-web.co.uk/google-pq-page-quality-rating/
#QualityRaters #AlgorithmPenalties #Pruning
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO

🤔9👍4
Google наконец-то закручивает гайки по самопиарным листиклам?
Анализ волатильности ранжирования за январь 2026 года выделил конкретный вектор токсичности: Self-Preferencing Listicle (Листиклы с самопреференциями).
Распространенная тактика
Форензика данных
В период с 19 января по 2 февраля 2026 года несколько
Подавление было не сквозным (sitewide decay), а хирургическими ударами по конкретным подпапкам (Блоги, Гайды, Туториалы), которые функционировали как фермы "
Один
Другой
Паттерн абсолютен: высокая концентрация само-ранжирующего контента без независимой валидации теперь является токсичным активом.
Механизм провала
Вектор выглядит как переобученная Reviews System, таргетирующая коммерческий конфликт интересов.
Google классифицирует эти страницы как предвзятые рекламные материалы, а не независимую редакционку.
Подавление триггерится комбинацией:
— Отсутствие доказательств: Нарушение двойного
— Реципрокные картели: Детект паттернов "ты ранжируешь меня, я ранжирую тебя" между игроками индустрии.
— Компаундинг сигналов: Пострадавшие страницы часто демонстрировали агрессивный спуфинг дат (тег "2026" в тайтлах без существенных обновлений) и сигнатуры 100%
Каскад GEO
Этот фильтр создает критический сбой в
Поскольку
Шорткат для доминации в
Протокол аудита
Оцените немедленную экспозицию, выполнив:
или
Если этот оператор возвращает значительный объем, ваш "контент-маркетинг" в данный момент помечен как балласт.
https://lilyraynyc.substack.com/p/is-google-finally-cracking-down-on
#AlgorithmPenalties #ProductReviewUpdate #GEO
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Анализ волатильности ранжирования за январь 2026 года выделил конкретный вектор токсичности: Self-Preferencing Listicle (Листиклы с самопреференциями).
Распространенная тактика
GEO — публикация статей "Best [Industry] Tools", чтобы ранжировать свой продукт на #1 месте — превратилась из серого арбитража в основной драйвер алгоритмического подавления.Форензика данных
В период с 19 января по 2 февраля 2026 года несколько
SaaS-брендов испытали обвал органической видимости в диапазоне от -29% до -49% (данные Sistrix US).Подавление было не сквозным (sitewide decay), а хирургическими ударами по конкретным подпапкам (Блоги, Гайды, Туториалы), которые функционировали как фермы "
Best Of".Один
B2B бренд с оценкой $8B потерял 49% общей видимости, что напрямую коррелирует с разделом блога, где 77% трафика шло со 191 статьи, ранжирующей компанию-хоста на #1 месте.Другой
SaaS-игрок просел на 43%, когда его папка /guide/ — хостящая 228 самопиарных листиклов — попала под раздачу.Паттерн абсолютен: высокая концентрация само-ранжирующего контента без независимой валидации теперь является токсичным активом.
Механизм провала
Вектор выглядит как переобученная Reviews System, таргетирующая коммерческий конфликт интересов.
Google классифицирует эти страницы как предвзятые рекламные материалы, а не независимую редакционку.
Подавление триггерится комбинацией:
— Отсутствие доказательств: Нарушение двойного
E-E-A-T путем заявлений об исследованиях без логов тестирования, оригинальных фото или негативных критериев.— Реципрокные картели: Детект паттернов "ты ранжируешь меня, я ранжирую тебя" между игроками индустрии.
— Компаундинг сигналов: Пострадавшие страницы часто демонстрировали агрессивный спуфинг дат (тег "2026" в тайтлах без существенных обновлений) и сигнатуры 100%
AI-генерации.Каскад GEO
Этот фильтр создает критический сбой в
AI-стратегии.Поскольку
AI Overviews и LLM используют RAG, основанный на топ-слотах органики, событие органического подавления эффективно удаляет бренд из ответов AI.Шорткат для доминации в
AI-поиске стал механизмом исчезновения из него.Протокол аудита
Оцените немедленную экспозицию, выполнив:
site:company.com/blog/ intitle:best "1. company"
или
site:company.com/blog/ "best" "1. company"
Если этот оператор возвращает значительный объем, ваш "контент-маркетинг" в данный момент помечен как балласт.
https://lilyraynyc.substack.com/p/is-google-finally-cracking-down-on
#AlgorithmPenalties #ProductReviewUpdate #GEO
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

❤4👎3👍1
Взрывной рост публикаций триггерит алгоритм нормализации трафика
Я идентифицировал механизм, который называю Гипотеза Коррекции: Гугл активно мониторит скорость публикации
Если объем постов показывает значительный спайк по сравнению с предыдущим периодом — классика для
Это работает как алгоритм ребалансировки.
Вы можете увидеть начальный рост трафика, но система в итоге нормализует сайт обратно к исходному бейслайну, фактически стирая весь профит от скоростного вброса.
Часто причина в том, что я называю "размазыванием" (smearing).
Гугл не оценивает каждую новую страницу индивидуально в реал-тайме; вместо этого он берет небольшую выборку страниц, считает скор качества и затем "размазывает" этот сигнал по всему домену.
Если сэмпл помечен как
Следовательно, если устоявшийся сайт не может проиндексировать новые страницы, это почти всегда проблема сигнала качества всего сайта, а не техническая проблема краулингового бюджета.
Атрибут "
Чтобы диагностировать это, я использую
#ContentVelocity #Indexing #AlgorithmPenalties
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Я идентифицировал механизм, который называю Гипотеза Коррекции: Гугл активно мониторит скорость публикации
URL относительно исторического бейслайна сайта.Если объем постов показывает значительный спайк по сравнению с предыдущим периодом — классика для
AI-дампов — это триггерит алгоритмическую "коррекцию" или нормализацию, объясняет Шон Андерсон.Это работает как алгоритм ребалансировки.
Вы можете увидеть начальный рост трафика, но система в итоге нормализует сайт обратно к исходному бейслайну, фактически стирая весь профит от скоростного вброса.
Часто причина в том, что я называю "размазыванием" (smearing).
Гугл не оценивает каждую новую страницу индивидуально в реал-тайме; вместо этого он берет небольшую выборку страниц, считает скор качества и затем "размазывает" этот сигнал по всему домену.
Если сэмпл помечен как
low-effort или аномалия, пессимизируется вся пачка.Следовательно, если устоявшийся сайт не может проиндексировать новые страницы, это почти всегда проблема сигнала качества всего сайта, а не техническая проблема краулингового бюджета.
Атрибут "
Content Effort" (оценка усилий на базе LLM из утечки Гугла), вероятно, фейлится на этапе сэмплинга.Чтобы диагностировать это, я использую
Google Gemini для грейдинга своих страниц по гайдлайнам Гугла перед публикацией, гарантируя, что сигнал "Content Effort" достаточно высок, чтобы пережить процесс сэмплинга и размазывания.#ContentVelocity #Indexing #AlgorithmPenalties
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
❤3👍1🆒1
Жесткая структура подпапок работает как шлюз против алгоритмических фильтров
Я вижу массовую техническую ошибку: сеошники сплющивают структуру
Я отвергаю эту плоскую архитектуру полностью.
Внедряйте строгую иерархию подпапок, чтобы диктовать контекст краулинга и, что важнее, строить фаерволы от алгоритмических санкций, утверждает Джейк Хандли.
Теория о том, что ключ в корне (domain.com/keyword) ранжируется лучше — это миф, порождающий помойку на сайте.
Гугл не просто кроулит страницу; он кроулит страницу в связке с её соседями.
Форсируя жесткий путь типа
Это заставляет бота понимать тематическую иерархию, вместо того чтобы гадать о контексте тысяч осиротевших файлов в корне.
Но киллер-фича подпапок — Управление Алгоритмическими Рисками.
Мы наблюдали за крупным аффилиатником с 300 000 – 400 000 кликов в месяц, который выживает только на этой архитектуре.
Изолируя типы контента в отдельные директории (например,
Если
В плоской архитектуре шлюзов нет; та же токсичность заливает весь корневой домен, вызывая коллапс позиций по всему сайту.
#URLStructure #SiteArchitecture #AlgorithmPenalties
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Я вижу массовую техническую ошибку: сеошники сплющивают структуру
URL, полагая, что близость к корневому домену улучшает ранжирование.Я отвергаю эту плоскую архитектуру полностью.
Внедряйте строгую иерархию подпапок, чтобы диктовать контекст краулинга и, что важнее, строить фаерволы от алгоритмических санкций, утверждает Джейк Хандли.
Теория о том, что ключ в корне (domain.com/keyword) ранжируется лучше — это миф, порождающий помойку на сайте.
Гугл не просто кроулит страницу; он кроулит страницу в связке с её соседями.
Форсируя жесткий путь типа
domain.com/location/services/specific-service вместо плоского domain.com/service-location, мы явно программируем отношения между родительскими и дочерними страницами.Это заставляет бота понимать тематическую иерархию, вместо того чтобы гадать о контексте тысяч осиротевших файлов в корне.
Но киллер-фича подпапок — Управление Алгоритмическими Рисками.
Мы наблюдали за крупным аффилиатником с 300 000 – 400 000 кликов в месяц, который выживает только на этой архитектуре.
Изолируя типы контента в отдельные директории (например,
/faqs/ vs. /reviews/), мы создаем гермодвери.Если
Core Update бьет по "unhelpful content", расположенному конкретно в секции FAQ, алгоритмическая девальвация часто замыкается внутри этой папки.В плоской архитектуре шлюзов нет; та же токсичность заливает весь корневой домен, вызывая коллапс позиций по всему сайту.
#URLStructure #SiteArchitecture #AlgorithmPenalties
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
🤔9❤1
Качество контента не защищает от пессимизации.
Я проанализировал патент
Гугл оценивает не только ТВОЮ страницу.
Он оценивает ВСЕ пространство запроса.
Если твой ключ притягивает спам, кликбейт и абьюз
→ Гугл задирает порог качества для ВСЕХ результатов.
→ Включая твой.
Воспринимай это как цены на недвижимость.
Тот же дом.
Плохой район.
Ниже стоимость.
Патент описывает "query goodness value".
Рискованные запросы = более жесткий фильтр = твой хороший контент попадает под раздачу.
Что ты можешь сделать:
✓ Аудит твоих серпов — много спама? Твой ключ "высокорисковый"
✓ Отстраивайся от спамных паттернов в тайтлах и структуре
✓ Качай репутацию домена/канала — это защитный сигнал
✓ Следи за соотношением вовлеченности к показам — низкий
Твои позиции зависят не только от того, насколько хороша ТВОЯ страница — но и от того, насколько плохи ОСТАЛЬНЫЕ страницы по этому же ключу.
https://patents.google.com/patent/US12517950B2/en
• Патент Google:
•
• Дата публикации: 6.01.2026
#Patents #AlgorithmPenalties #SERPAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Я проанализировал патент
US12517950B2 и расскажу почему, пишет Рафал Боровец.Гугл оценивает не только ТВОЮ страницу.
Он оценивает ВСЕ пространство запроса.
Если твой ключ притягивает спам, кликбейт и абьюз
→ Гугл задирает порог качества для ВСЕХ результатов.
→ Включая твой.
Воспринимай это как цены на недвижимость.
Тот же дом.
Плохой район.
Ниже стоимость.
Патент описывает "query goodness value".
Рискованные запросы = более жесткий фильтр = твой хороший контент попадает под раздачу.
Что ты можешь сделать:
✓ Аудит твоих серпов — много спама? Твой ключ "высокорисковый"
✓ Отстраивайся от спамных паттернов в тайтлах и структуре
✓ Качай репутацию домена/канала — это защитный сигнал
✓ Следи за соотношением вовлеченности к показам — низкий
CTR = красный флагТвои позиции зависят не только от того, насколько хороша ТВОЯ страница — но и от того, насколько плохи ОСТАЛЬНЫЕ страницы по этому же ключу.
https://patents.google.com/patent/US12517950B2/en
• Патент Google:
US12517950B2•
Methods, systems, and media for modifying search results based on search query risk• Дата публикации: 6.01.2026
#Patents #AlgorithmPenalties #SERPAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

😁3
Патент US9031929B1 подтверждает: прокачанный ссылочный профиль без брендовых запросов триггерит пессимизацию
Поисковый алгоритм использует специальный коэффициент "
Патент
Когда система видит мощный траст домена и нулевой объем брендовых запросов, она активирует главный классификатор переоптимизации.
Алгоритм помечает такой дисбаланс как накрутку.
Именно эта логика лежит в основе исторических фильтров
Этот фильтр вводит двухуровневую оценку для конкурентных запросов.
Базовые
Чтобы забрать топы, системе нужны симпатии пользователей и лояльность к бренду — они подтверждают ссылочный профиль.
Если алгоритм фиксирует тысячи входящих линков, но не видит брендовой органики, он считает профиль фейковым и режет позиции урлов.
Отдельно данные выдачи подтверждают: алгоритм постоянно крутит вес этого брендового фактора.
Анализ 1 500 сайтов, попавших под четыре и более кор-апдейта, показывает: только 37 доменов падали стабильно.
Система регулярно разворачивает собственные параметры оценки и перекидывает приоритет от огромных широких брендов к узким нишевым сайтам и обратно.
Этот шторм выдачи — вшитая фича оценки, поэтому резкая смена курса сразу после просадки от кор-апдейта обычно бьет по самому сайту.
#AlgorithmPenalties #BrandedSearch #EEAT
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Поисковый алгоритм использует специальный коэффициент "
Over-SEOed" для поиска манипуляций, детализирует Том Каппер.Патент
US9031929B1 измеряет математический разрыв между силой бэклинков сайта и реальным спросом юзеров.Когда система видит мощный траст домена и нулевой объем брендовых запросов, она активирует главный классификатор переоптимизации.
Алгоритм помечает такой дисбаланс как накрутку.
Именно эта логика лежит в основе исторических фильтров
Panda и свежих HCU.Этот фильтр вводит двухуровневую оценку для конкурентных запросов.
Базовые
SEO-элементы вроде покупки ссылок лишь дают сайту пропуск в первичный пул ранжирования.Чтобы забрать топы, системе нужны симпатии пользователей и лояльность к бренду — они подтверждают ссылочный профиль.
Если алгоритм фиксирует тысячи входящих линков, но не видит брендовой органики, он считает профиль фейковым и режет позиции урлов.
Отдельно данные выдачи подтверждают: алгоритм постоянно крутит вес этого брендового фактора.
Анализ 1 500 сайтов, попавших под четыре и более кор-апдейта, показывает: только 37 доменов падали стабильно.
Система регулярно разворачивает собственные параметры оценки и перекидывает приоритет от огромных широких брендов к узким нишевым сайтам и обратно.
Этот шторм выдачи — вшитая фича оценки, поэтому резкая смена курса сразу после просадки от кор-апдейта обычно бьет по самому сайту.
#AlgorithmPenalties #BrandedSearch #EEAT
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
1❤3
Динамика ссылочного вскрывает алгоритм распознавания паттернов: Google читает историю бэклинков
Google определяет динамику ссылочного не по скорости, а по консистентности паттерна.
Прогон 500 ссылок за 30 дней триггерит санкции за 48 часов; 370 бэклинков за 8 месяцев выводят в топ-3.
Алгоритм считывает историю, которую рассказывают ссылки.
Неестественные паттерны отправляют сайт на ручник: точное количество ссылок ежемесячно, закупка в один день, 100% точных вхождений в анкорах, ссылки только на главную, ноль
Естественная динамика отражает реальный рост траста — она хаотична, а не линейна.
Распределение анкоров: 40-50% брендовые, 20-30% безанкорка, 15-25% общие, 10-15% частичное вхождение, 5-10% точное.
Доля
География для бизнеса из США: 60-70% США, 15-20% англоговорящие страны, 10-15% международные.
Смирись с отвалом бэклинков (5-15% в год).
Временное распределение: 1-4 недели — цитации, 5-8 недели — каталоги, 9-12 недели — гестпосты, 4-6 месяцы — редакционные статьи, 7-12 месяцы — органика.
Сезонные всплески (запуск продукта, PR-кампании) вызывают доверие; плоский линейный рост выглядит подозрительно.
Инсайты комьюнити
— Google фиксирует ссылочные паттерны как маркеры подлинности, а не просто скорость прироста. Забудь про метрику "сколько штук в месяц" и смотри, отражает ли временное распределение реальную активность бизнеса.
— Вирусные скачки ссылочного от запуска продуктов и
— Комментарии и обсуждения в комьюнити не работают для линкбилдинга — вопреки популярным
#LinkVelocity #LinkBuilding #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Google определяет динамику ссылочного не по скорости, а по консистентности паттерна.
Прогон 500 ссылок за 30 дней триггерит санкции за 48 часов; 370 бэклинков за 8 месяцев выводят в топ-3.
Алгоритм считывает историю, которую рассказывают ссылки.
Неестественные паттерны отправляют сайт на ручник: точное количество ссылок ежемесячно, закупка в один день, 100% точных вхождений в анкорах, ссылки только на главную, ноль
nofollow, доноры из одной страны, нулевой отвал ссылок.Естественная динамика отражает реальный рост траста — она хаотична, а не линейна.
Распределение анкоров: 40-50% брендовые, 20-30% безанкорка, 15-25% общие, 10-15% частичное вхождение, 5-10% точное.
Доля
nofollow: 30-50%.География для бизнеса из США: 60-70% США, 15-20% англоговорящие страны, 10-15% международные.
Смирись с отвалом бэклинков (5-15% в год).
Временное распределение: 1-4 недели — цитации, 5-8 недели — каталоги, 9-12 недели — гестпосты, 4-6 месяцы — редакционные статьи, 7-12 месяцы — органика.
Сезонные всплески (запуск продукта, PR-кампании) вызывают доверие; плоский линейный рост выглядит подозрительно.
Инсайты комьюнити
— Google фиксирует ссылочные паттерны как маркеры подлинности, а не просто скорость прироста. Забудь про метрику "сколько штук в месяц" и смотри, отражает ли временное распределение реальную активность бизнеса.
— Вирусные скачки ссылочного от запуска продуктов и
PR — это легитимные временные аномалии. Сайты с сезонными всплесками бэклинков во время релизов обходят конкурентов с ровным стабильным ростом за те же периоды.— Комментарии и обсуждения в комьюнити не работают для линкбилдинга — вопреки популярным
SEO-мифам.#LinkVelocity #LinkBuilding #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
👍2
Массовые DMCA-жалобы активируют 18-месячный алгоритмический фильтр
Мониторинг серпа внутри дня показывает, что падение позиций за 20 минут (например, с топ-1 на топ-10) сигнализирует о целенаправленных
Для нейтрализации этих атак в периоды изменения регуляций
Когда правительство внезапно запрещает вещество (например, HHC во Франции), а магазин устраивает финальную распродажу, генерируя аномальные 60 000 запросов в секунду на сервер, конкуренты тут же бьют анонимными жалобами в Google.
Для защиты от ручных санкций целевые страницы с проблемным товаром должны быть немедленно удалены и перенаправлены через
Это не дает Google проиндексировать проблемный контент и запустить ручник на весь сайт.
Алгоритм жестко наказывает инициаторов фейкового негативного SEO, создавая "эффект бумеранга".
Если домен абузит систему легальных репортов (в кейсе Жюльена конкурент заливал по 800 ложных
За такую токсичность сайт инициатора полностью выкидывается из выдачи, а восстановление позиций занимает от 18 до 24 месяцев.
#NegativeSEO #DMCA #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Мониторинг серпа внутри дня показывает, что падение позиций за 20 минут (например, с топ-1 на топ-10) сигнализирует о целенаправленных
DMCA-атаках, а не о стандартных кор-апдейтах, отмечает Жюльен Кордобес.Для нейтрализации этих атак в периоды изменения регуляций
CBD Oil (маслa каннабидиола) применяется стратегия редиректа с "нулевым следом".Когда правительство внезапно запрещает вещество (например, HHC во Франции), а магазин устраивает финальную распродажу, генерируя аномальные 60 000 запросов в секунду на сервер, конкуренты тут же бьют анонимными жалобами в Google.
Для защиты от ручных санкций целевые страницы с проблемным товаром должны быть немедленно удалены и перенаправлены через
301 на главную, не оставляя боту следов для проверки.Это не дает Google проиндексировать проблемный контент и запустить ручник на весь сайт.
Алгоритм жестко наказывает инициаторов фейкового негативного SEO, создавая "эффект бумеранга".
Если домен абузит систему легальных репортов (в кейсе Жюльена конкурент заливал по 800 ложных
DMCA-жалоб в день, чтобы потопить чужие сайты), Google активирует санкции против самого заявителя.За такую токсичность сайт инициатора полностью выкидывается из выдачи, а восстановление позиций занимает от 18 до 24 месяцев.
#NegativeSEO #DMCA #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
✍8
Все говорят о том, чего хочет Google 🔄
Свежий контент.
Быстрый контент.
Полезный контент.
Никто не говорит о том, в чем заключается "доктрина" Google: Google не доверяет паблишеру 🚫
Вот почему он не может оценивать качество контента 👇
1️⃣ Субъективность Качество — понятие человеческое и контекстуальное.
Ни одна система не способна охватить 8 миллиардов определений.
2️⃣ Непроверяемость Нельзя подтвердить то, чего не видишь.
Стандарты Google — это черный ящик по определению 👁
3️⃣ Произвольность Подвижный стандарт — это не стандарт.
Это предпочтение, у которого есть
4️⃣ Цикличность Он вознаграждает то, что уже ранжируется.
Выходные данные становятся входными.
Это не измерение — это замкнутый цикл 🔒
5️⃣ Категориальная ошибка Google — это прокси-система, которая выдает себя за систему оценки.
Это не предвзятость — это фундаментальное непонимание того, чем она является на самом деле 🤯
Существует закон логики возрастом в 2000 лет, который всё ещё работает 🏛
Утверждение не является доказательством утверждения.
Ни один алгоритм это не исправит.
Ни одна
Google — это не 8 миллиардов человек.
Он держит в руках размытую склейку и называет её правдой 🌫
Ты не оптимизируешь под качество.
Ты оптимизируешь под сигналы доверия внутри системы, которая по умолчанию не может тебе доверять ♟
#AlgorithmPenalties #ContentSEO #SearchEngines
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Свежий контент.
Быстрый контент.
Полезный контент.
Никто не говорит о том, в чем заключается "доктрина" Google: Google не доверяет паблишеру 🚫
Вот почему он не может оценивать качество контента 👇
1️⃣ Субъективность Качество — понятие человеческое и контекстуальное.
Ни одна система не способна охватить 8 миллиардов определений.
2️⃣ Непроверяемость Нельзя подтвердить то, чего не видишь.
Стандарты Google — это черный ящик по определению 👁
3️⃣ Произвольность Подвижный стандарт — это не стандарт.
Это предпочтение, у которого есть
PR-команда 📏4️⃣ Цикличность Он вознаграждает то, что уже ранжируется.
Выходные данные становятся входными.
Это не измерение — это замкнутый цикл 🔒
5️⃣ Категориальная ошибка Google — это прокси-система, которая выдает себя за систему оценки.
Это не предвзятость — это фундаментальное непонимание того, чем она является на самом деле 🤯
Существует закон логики возрастом в 2000 лет, который всё ещё работает 🏛
Утверждение не является доказательством утверждения.
Ни один алгоритм это не исправит.
Ни одна
LLM это не исправит.Google — это не 8 миллиардов человек.
Он держит в руках размытую склейку и называет её правдой 🌫
Ты не оптимизируешь под качество.
Ты оптимизируешь под сигналы доверия внутри системы, которая по умолчанию не может тебе доверять ♟
#AlgorithmPenalties #ContentSEO #SearchEngines
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
🙈4👀2
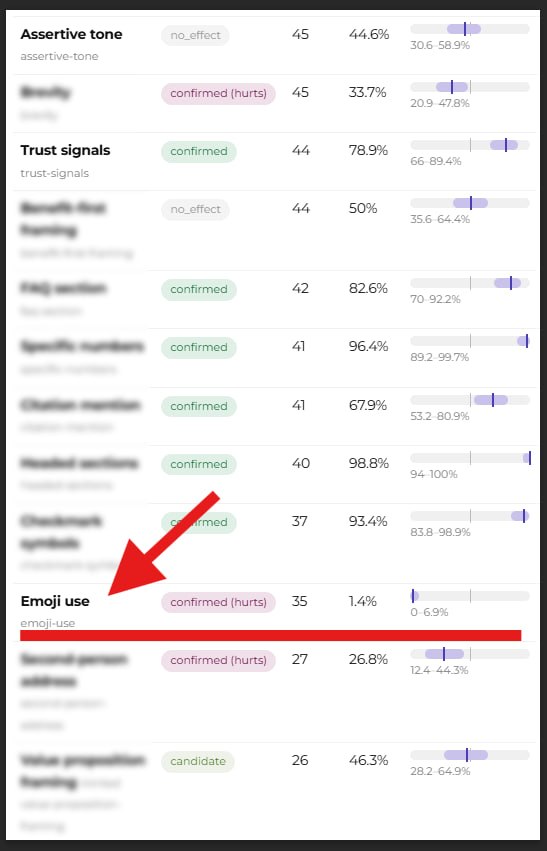
Эмодзи подтверждены как негативный сигнал для
Полная картина: https://dejan.ai/sro/
Инсайты комьюнити
— Наличие эмодзи в контенте страницы снижает вероятность того, что
#AI #Gemini #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Gemini 3.6 Flash.Полная картина: https://dejan.ai/sro/
Инсайты комьюнити
— Наличие эмодзи в контенте страницы снижает вероятность того, что
Gemini 3.6 Flash выберет эту страницу, бренд, продукт или услугу в качестве рекомендации.#AI #Gemini #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
👍5
Утечка Content Warehouse API доказывает: 10-секундный dwell time вешает фильтры на страницы конвертеров
Слитое
Система корректирует позиции в живом серпе через
В итоге
На утилитарных запросах и конвертерах валют затянутый
Если посетитель висит на странице дольше 10 секунд, алгоритм классифицирует взаимодействие как провал.
Система трекает эту точную телеметрию через
Отдельно
Когда юзер кликает на домен, прокликивает 5–6 внутренних страниц, возвращается на стартовый урл и уходит без конверсии, алгоритм флагит сессию как нерешенную.
Если тот же юзер после этого совершает покупку на домене конкурента,
#API #UserSignals #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Слитое
API Гугла содержит модуль RankLab, который присваивает каждому урлу алгоритмический base rank вместе с экспериментальным test rank, вскрывает Корай Тугберк Гюбюр.Система корректирует позиции в живом серпе через
NavBoost — гибридный фактор скоринга, который агрегирует кликовый фидбек юзеров, PageRank и тематические эмбеддинги.В итоге
RankLab не награждает за длинные сессии тупо по умолчанию, а применяет разные пороги удовлетворенности кликом в зависимости от скрытого интента запроса.На утилитарных запросах и конвертерах валют затянутый
dwell time напрямую сигналит о фрустрации юзера.Если посетитель висит на странице дольше 10 секунд, алгоритм классифицирует взаимодействие как провал.
Система трекает эту точную телеметрию через
Site Engagement Score из Chromium и INP, чтобы проверить, эффективно ли юзер закрыл свою задачу.Отдельно
e-commerce сайты ловят прямые просадки позиций из-за паттерна engagement trap.Когда юзер кликает на домен, прокликивает 5–6 внутренних страниц, возвращается на стартовый урл и уходит без конверсии, алгоритм флагит сессию как нерешенную.
Если тот же юзер после этого совершает покупку на домене конкурента,
RankLab пессимизирует первый сайт и бустит конвертящего конкурента в товарной выдаче.#API #UserSignals #AlgorithmPenalties
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤1
Слив Гугла вскрывает New Site Rank: это офлайн-потолок, который нельзя сдвинуть он-пейджем
В сливе
Кэш презентаций
А устаревшее поле
Индустриальные названия — результат ранней догадки, которую повторяли вплоть до статуса факта.
Эта расшифровка меняет прицел.
Он высчитывается в пайплайне
Обучение крутится в
Затем скоринги морозятся в офлайн-песочнице и раскатываются глобально во время
Между выкатками база зафиксирована — вот почему видимость меняется ступенчато, а не плавно дрейфует, и почему локальные правки он-пейджа не дают восстановления, пока не выкатят следующий батч.
Силу давления этого потолка определяют два демпфера.
А низкая уверенность глушит агрессивность, с которой
Скоринг также оценивается по
Система изолирует поддомены, директории и хабы юзерского контента, поэтому один мусорный кусок не тянет за собой базовый уровень авторитетных разделов.
Там, где чанку не хватает данных трафика или краулинга,
Ссылочный вес, питающий эту базу, может быть обнулен без ручника.
Модели
Никаких уведомлений при этом не прилетает.
В обратную сторону работает
Значение выше
Это резервный рычаг для восстановления крупных новостных брендов или ресурсов общественной безопасности, если автоматическая выкатка дает сбой.
Рычаги, которые двигают офлайн-оценку всего сайта — макроуровневые, а не постраничные.
Это кампании, генерирующие прямые брендовые навигационные запросы для усиления векторов предпочтений
Пропорции веса, сглаживания и точная кривая компонентов
https://www.hobo-web.co.uk/new-site-rank-nsr-googles-site-wide-quality-engine/
#GoogleLeak #AlgorithmPenalties #CoreUpdates
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
В сливе
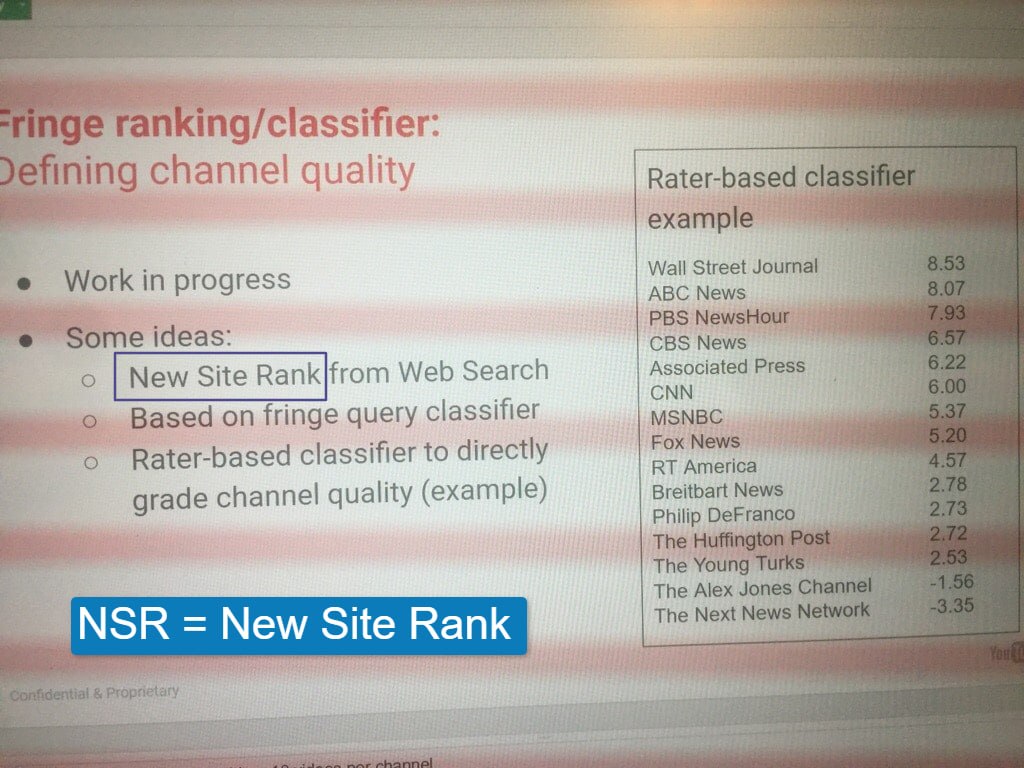
Content Warehouse за 2024 год NSR — это ни Normalized, ни Neural Site Rank.Кэш презентаций
Project Veritas 2019 года, не связанный со сливом API, содержит внутренний слайд Google под названием "Fringe ranking/classifier: Defining channel quality", где упоминается "New Site Rank from Web Search".А устаревшее поле
hostNsr в схеме 2024 года несет собственное описание в коде: "This value encodes nsr, site_pr and new_nsr".Индустриальные названия — результат ранней догадки, которую повторяли вплоть до статуса факта.
Эта расшифровка меняет прицел.
NSR — не динамическая оценка на уровне страницы, а офлайн макро-классификатор, который задает базовый потолок траста домена.Он высчитывается в пайплайне
Goldmine и отдается на живые шарды Mustang как урезанный векторный контейнер (nsrDataProto).Обучение крутится в
RankLab на кликстримах, показах, трафике Chrome и фидбеке асессоров.Затем скоринги морозятся в офлайн-песочнице и раскатываются глобально во время
Broad Core Updates.Между выкатками база зафиксирована — вот почему видимость меняется ступенчато, а не плавно дрейфует, и почему локальные правки он-пейджа не дают восстановления, пока не выкатят следующий батч.
Силу давления этого потолка определяют два демпфера.
nsrConfidence и nsrVariance снижают уверенность алгоритма при скудных поведенческих сигналах.А низкая уверенность глушит агрессивность, с которой
NSR меняет базовую позицию страницы: на сайте с низким трафиком NSR слабее сдвигает базу в любую из сторон, что страхует от жестких ошибочных санкций.Скоринг также оценивается по
sitechunks, а не по целым доменам.Система изолирует поддомены, директории и хабы юзерского контента, поэтому один мусорный кусок не тянет за собой базовый уровень авторитетных разделов.
Там, где чанку не хватает данных трафика или краулинга,
nsrdataFromFallbackPatternKey подставляет среднее структурное значение родственных чанков хоста.Ссылочный вес, питающий эту базу, может быть обнулен без ручника.
Модели
SpamBrain нейтрализуют ссылочное: они обнуляют PageRank, идущий через искусственные ссылочные графы и PBN, тогда как spambrainLavcScore замеряет долю мусорных линков, приклеенных к домену.Никаких уведомлений при этом не прилетает.
В обратную сторону работает
nsrOverrideBid (задокументирован по адресу go/nsr-override-bid) — это ручной переключатель.Значение выше
0.001 безусловно перебивает рассчитанную базу NSR домена внутри движка Q (Quality Score).Это резервный рычаг для восстановления крупных новостных брендов или ресурсов общественной безопасности, если автоматическая выкатка дает сбой.
Рычаги, которые двигают офлайн-оценку всего сайта — макроуровневые, а не постраничные.
Это кампании, генерирующие прямые брендовые навигационные запросы для усиления векторов предпочтений
NavBoost; прунинг нетематического и малоценного контента для снижения siteRadius при проверках согласованности Site2Vec; и прямой трафик, переходы из рассылок и закладок для разгона chromeInTotal, а вместе с ним и nsrConfidence.Пропорции веса, сглаживания и точная кривая компонентов
NSR остаются нераскрытыми, а сама модель пайплайна — это логический вывод, собранный по кускам из слитого кода, а не из документации Google.https://www.hobo-web.co.uk/new-site-rank-nsr-googles-site-wide-quality-engine/
#GoogleLeak #AlgorithmPenalties #CoreUpdates
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO