Мы копнули эту тему, пишет Пенни Мэри.
После нескольких постов в
Когда мы это увидели, мы сразу захотели абьюзнуть этот хак...
и он отлично пашет.
Откройте 100
Да, он заходит и десктопным, и мобильным ботом!
Разумеется, мы пробили диапазон
Тогда мы задались вопросом: как и почему
Первая мысль была, что
Но мы затестили с другими браузерами, типа
Потом мы полезли в
опять ничего.
Тогда мы пошли еще дальше, с помощью небольшой проги
И тут мы обнаружили, что
Когда мы увидели
Но при детальном рассмотрении, никаких вызовов к этому домену не было.
Тогда мы начали по одному блокировать доступ к каждому домену, принадлежащему Google, чтобы воспроизвести то поведение, которое мы засекли.
И когда мы отключили
К сожалению, все, что отправляется на этот домен, зашифровано, и поэтому содержимое не видно.
Так что мы не можем знать, что именно
Копаясь в логах, мы видим, что два бота, которые приходят на наши страницы, похожи на тех, что мы часто видим на наших сайтах:
→ десктопный бот: тот же
→ мобильный бот: тот же
Мы также заметили, что проанализированное поведение не является систематическим на наших сайтах, которые отправляют большие объемы вакансий в
Есть связь?
#ChatGPTAtlas #GoogleBot #Crawling
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
ChatGPT Atlas триггерит хиты от Googlebot?Мы копнули эту тему, пишет Пенни Мэри.
После нескольких постов в
LinkedIn (от Жан-Кристофа Шуинара) мы заметили, что Googlebot приходит хитануть наши страницы, как только их открываешь в Atlas.Когда мы это увидели, мы сразу захотели абьюзнуть этот хак...
и он отлично пашет.
Откройте 100
URL вашего сайта в Atlas, и Googlebot придет к вам 200 раз.Да, он заходит и десктопным, и мобильным ботом!
Разумеется, мы пробили диапазон
IP: он действительно соответствует гугловскому → 66.249.Тогда мы задались вопросом: как и почему
Googlebot приходит на наши страницы после их открытия в Atlas?Первая мысль была, что
Atlas работает на Chromium.Но мы затестили с другими браузерами, типа
Brave, и такого поведения не обнаружили.Потом мы полезли в
DevTools (вкладка Network), чтобы посмотреть серверные обмены...опять ничего.
Тогда мы пошли еще дальше, с помощью небольшой проги
Little Snitch, которая позволяет видеть все внешние соединения, которые софт устанавливает во время работы.И тут мы обнаружили, что
Atlas обращается к нескольким сервисам Google: → google.com → gstatic.com → cdn.google → googleapis.comКогда мы увидели
googleapis.com, мы сразу подумали, что он, возможно, шлет урлы в API indexing.googleapis.com.Но при детальном рассмотрении, никаких вызовов к этому домену не было.
Тогда мы начали по одному блокировать доступ к каждому домену, принадлежащему Google, чтобы воспроизвести то поведение, которое мы засекли.
И когда мы отключили
gstatic.com, мы поняли, что Googlebot больше не приходит.К сожалению, все, что отправляется на этот домен, зашифровано, и поэтому содержимое не видно.
Так что мы не можем знать, что именно
Atlas отправляет на gstatic.com, что триггерит визит Googlebot, но мы знаем, что именно этот вызов является причиной.Копаясь в логах, мы видим, что два бота, которые приходят на наши страницы, похожи на тех, что мы часто видим на наших сайтах:
→ десктопный бот: тот же
user-agent и IP, что и у хитов бота, который обходит наши страницы после посещения одного из наших сайтмапов.→ мобильный бот: тот же
user-agent и IP, что и у хитов бота, который приходит посмотреть наши вакансии через API индексации.Мы также заметили, что проанализированное поведение не является систематическим на наших сайтах, которые отправляют большие объемы вакансий в
API индексации.Есть связь?
#ChatGPTAtlas #GoogleBot #Crawling
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO

👍19❤1
"Другой" движок JavaScript у Googlebot: как по скорости рендеринга отличить настоящего краулера от фейка
Продакшн-версия
Он работает на чем-то, что выглядит как инопланетная технология, и вы можете использовать это в своих интересах, раскрывает Тед Кубайтис.
Мы провели бенчмарки и обнаружили, что он может выполнять массивные, итеративные циклы
Стандартные
Этот разрыв в производительности — однозначный отпечаток пальца, который можно использовать, чтобы отличить настоящего
Инструмент проверки
Именно поэтому вы можете видеть расхождения в рендеринге, особенно на страницах с тяжелым
Однако ваше безопасное допущение должно быть таким: если
Критическое исключение из этого правила — время выполнения.
Поскольку у продакшн-бота есть это ускоренное процессирование, существует граничный случай, когда он может успешно отрендерить сложный
#GoogleBot #JavaScript #Cloaking
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
Продакшн-версия
Googlebot, которая краулит веб в промышленных масштабах, — это не тот же инструмент, что вы юзаете в GSC.Он работает на чем-то, что выглядит как инопланетная технология, и вы можете использовать это в своих интересах, раскрывает Тед Кубайтис.
Мы провели бенчмарки и обнаружили, что он может выполнять массивные, итеративные циклы
JavaScript — например, посчитать до 10 миллиардов — за время, которое регистрируется как ноль миллисекунд.Стандартные
headless-браузеры и фейковые боты, притворяющиеся Googlebot, просто не могут этого повторить; они не работают на гиперускоренном железе стоимостью в миллионы долларов.Этот разрыв в производительности — однозначный отпечаток пальца, который можно использовать, чтобы отличить настоящего
Googlebot от всего остального.Инструмент проверки
URL в GSC, который использует юзер-агент inspectbot, является отдельной, форкнутой версией продакшн-бота и, скорее всего, работает на другом железе.Именно поэтому вы можете видеть расхождения в рендеринге, особенно на страницах с тяжелым
JavaScript.Однако ваше безопасное допущение должно быть таким: если
inspectbot не может увидеть элемент, то, скорее всего, и продакшн-бот не сможет.Критическое исключение из этого правила — время выполнения.
Поскольку у продакшн-бота есть это ускоренное процессирование, существует граничный случай, когда он может успешно отрендерить сложный
JavaScript-элемент, на котором инструмент проверки URL отвалится по таймауту.#GoogleBot #JavaScript #Cloaking
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
👍1
Физическое удаление ссылок из DOM спасает краулинговый бюджет
Стандартные директивы управления краулингом, такие как
Этот механизм диктует: если ссылка существует в
Для жесткой экономии ресурсов на
Это требует логики динамического рендеринга, которая определяет
Для небольших сайтов с потолком бюджета около 3,000 страниц эта архитектура не дает пауку тратить циклы на технические страницы или дубли, которые обычно размывают вес.
#CrawlBudget #Rendering #GoogleBot
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Стандартные директивы управления краулингом, такие как
robots.txt или noindex, не спасают краулинговый бюджет, потому что фаза обнаружения Googlebot выдергивает и ставит в очередь каждый href, присутствующий в HTML-структуре, независимо от последующих правил индексации.Этот механизм диктует: если ссылка существует в
DOM, краулер попытается перейти по ней, эффективно сжигая бюджет на неприоритетные ассеты, заявляет Чарльз Тейлор.Для жесткой экономии ресурсов на
mass-page архитектурах система должна полностью скрыть путь URL от краулера.Это требует логики динамического рендеринга, которая определяет
user-agent Googlebot и физически вырезает внутренние ссылки на малоценные страницы из DOM до отправки ответа, советует Тед Кубайтис.Для небольших сайтов с потолком бюджета около 3,000 страниц эта архитектура не дает пауку тратить циклы на технические страницы или дубли, которые обычно размывают вес.
#CrawlBudget #Rendering #GoogleBot
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
❤1👍1
🛑 Паника вокруг лимита краулинга в
Все запускают
Это норм, но это только полдела в истории с индексацией.
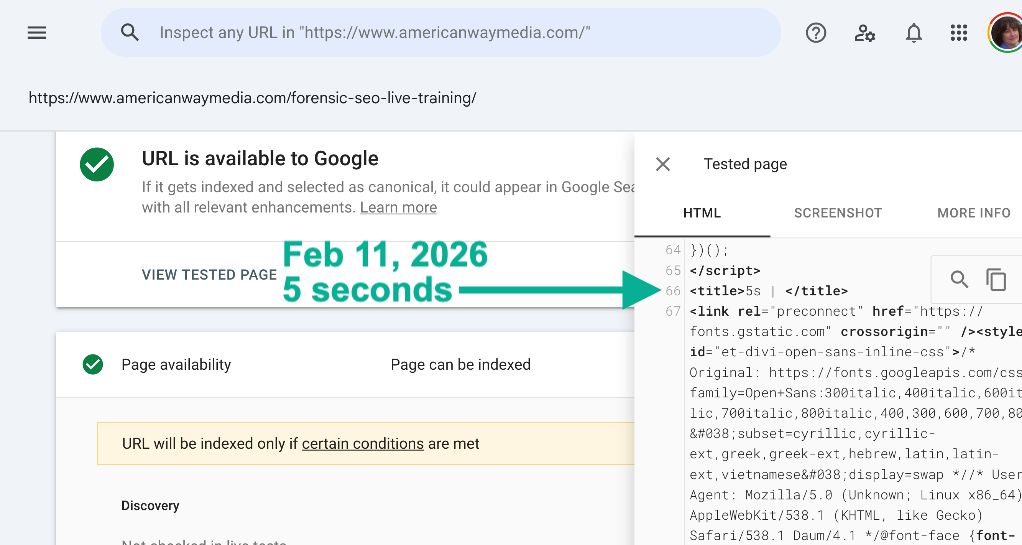
Я забенчмаркала несколько страниц через Live Test в GSC, пишет Кэролин Хольцман.
Вот скриншот, подтверждающий секунды жизни (seconds alive).
У меня сегодня стабильно отбивало по 5 секунд.
Отличается ли это от того, что было раньше?
"Медианное время рендера для Googlebot... 5 секунд" — @igrigorik, 2019.
В 2026 это все еще актуально.
Более качественный аудит: Не "у меня HTML <2MB"?, а "Рендерится ли мой критический контент быстрее чем за 5 секунд"?.
Приоритет на оптимизацию загрузки на стороне клиента (client-side).
Или рискуете тем, что Google увидит вашу страницу полупустой.
#CrawlBudget #Rendering #GoogleBot
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
2MB упускает РЕАЛЬНОЕ узкое горлышко.Все запускают
Screaming Frog, чтобы чекнуть размер страницы.Это норм, но это только полдела в истории с индексацией.
Я забенчмаркала несколько страниц через Live Test в GSC, пишет Кэролин Хольцман.
Вот скриншот, подтверждающий секунды жизни (seconds alive).
У меня сегодня стабильно отбивало по 5 секунд.
Отличается ли это от того, что было раньше?
"Медианное время рендера для Googlebot... 5 секунд" — @igrigorik, 2019.
В 2026 это все еще актуально.
Более качественный аудит: Не "у меня HTML <2MB"?, а "Рендерится ли мой критический контент быстрее чем за 5 секунд"?.
SSR везде, где возможно.Приоритет на оптимизацию загрузки на стороне клиента (client-side).
Или рискуете тем, что Google увидит вашу страницу полупустой.
#CrawlBudget #Rendering #GoogleBot
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
🤷5👍3🥰1🤝1
Смена User-Agent в логах сервера палит начало Core Update за неделю до анонса
Вы должны быть предельно осторожны с официальными датами анонсов
Мы видели значительные сдвиги в позициях за неделю до того, как апдейт вообще анонсировали, а волатильность может продолжаться до месяца после того, как Google заявляет о завершении выкатки, так что вас может зацепить уже после того, как они отрапортовали об окончании, предупреждает Тед Кубайтис.
Более надежный опережающий индикатор можно найти в ваших серверных логах.
Резкое изменение в паттерне краулинга Гуглобота — это сильный сигнал о том, что развертывание крупного апдейта неизбежно, часто опережающий официальный анонс на 7-10 дней.
С нашей точки зрения, процессинг начинается задолго до того, как об этом сообщают публике, раскрывает Ли Уитчер.
Мы даже наблюдали повторяющийся
Новые версии Гуглобота часто выкатываются по четвергам около 4
Как только апдейт начался, вы можете отслеживать его ход, мониторя самих ботов, отмечает Ли Уитчер.
Типичный паттерн — это первоначальная выкатка "бота-анонсера", за которым следует совершенно другая версия бота примерно через неделю-10 дней.
Помимо серверных логов, мы используем подход "канарейки в угольной шахте", чтобы получить раннее предупреждение о конкретных алгоритмических изменениях, объясняет Тед Кубайтис.
Это включает в себя создание и отслеживание позиций страниц, которые намеренно используют черные или спамные тактики, которые Google, в теории, должен штрафовать.
У нас есть целая когорта таких "канареечных" страниц, созданных с переспамом ключевыми словами, скрытым текстом в
Если группа таких страниц внезапно вылетает из индекса, это дает сильный, ранний сигнал о том, что Google наконец-то выкатил алгоритмическое обновление, нацеленное на эту конкретную тактику.
#CoreUpdates #LogFileAnalysis #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Вы должны быть предельно осторожны с официальными датами анонсов
core-апдейтов от Google, так как они являются ненадежными индикаторами того, когда на самом деле прилетит эффект.Мы видели значительные сдвиги в позициях за неделю до того, как апдейт вообще анонсировали, а волатильность может продолжаться до месяца после того, как Google заявляет о завершении выкатки, так что вас может зацепить уже после того, как они отрапортовали об окончании, предупреждает Тед Кубайтис.
Более надежный опережающий индикатор можно найти в ваших серверных логах.
Резкое изменение в паттерне краулинга Гуглобота — это сильный сигнал о том, что развертывание крупного апдейта неизбежно, часто опережающий официальный анонс на 7-10 дней.
С нашей точки зрения, процессинг начинается задолго до того, как об этом сообщают публике, раскрывает Ли Уитчер.
Мы даже наблюдали повторяющийся
DevOps-паттерн, который может помочь вам предвидеть эти изменения.Новые версии Гуглобота часто выкатываются по четвергам около 4
PM по восточному времени (ET), что дает еще один потенциальный сигнал, за которым стоит следить, добавляет Чарльз Тейлор.Как только апдейт начался, вы можете отслеживать его ход, мониторя самих ботов, отмечает Ли Уитчер.
Типичный паттерн — это первоначальная выкатка "бота-анонсера", за которым следует совершенно другая версия бота примерно через неделю-10 дней.
Помимо серверных логов, мы используем подход "канарейки в угольной шахте", чтобы получить раннее предупреждение о конкретных алгоритмических изменениях, объясняет Тед Кубайтис.
Это включает в себя создание и отслеживание позиций страниц, которые намеренно используют черные или спамные тактики, которые Google, в теории, должен штрафовать.
У нас есть целая когорта таких "канареечных" страниц, созданных с переспамом ключевыми словами, скрытым текстом в
div'ах, белым текстом на белом фоне и даже lorem ipsum, заточенным под ключи.Если группа таких страниц внезапно вылетает из индекса, это дает сильный, ранний сигнал о том, что Google наконец-то выкатил алгоритмическое обновление, нацеленное на эту конкретную тактику.
#CoreUpdates #LogFileAnalysis #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Гугл проактивно сносит из выдачи даже непроиндексированные урлы по запросу трастовых правообладателей
Крупнейший отправитель
На счету компании более 6,5 миллиардов запросов на деиндексацию — это больше трети от почти 18 миллиардов, полученных Гуглом за всё время, и в четыре раза больше, чем у ближайшего преследователя.
При текущих темпах они отправляют около 3,5 миллиардов урлов в год.
Но две детали важнее, чем общие объемы.
Доля ошибок у
Гугл вычищал эти непроиндексированные урлы проактивно, идя навстречу правообладателю, и блокировал страницы до того, как они вообще попадали в индекс.
Механизм, позволяющий пробивать потолок, — это скрытый от глаз канал:
На прямой вопрос о наличии дневных лимитов Гугл не дал ни подтверждения, ни опровержения, заявив лишь, что трастовые партнеры "могут отправлять то количество, которое им необходимо".
Это куда более осторожный ответ, чем в 2013 году, когда Гугл заявлял, что лимитов на уведомления "не существует".
Тогда его обвиняли в жестком ограничении правообладателей планкой в 10 000 урлов в день.
Один заявитель, зачищающий сейчас около 10 миллионов урлов ежедневно, означает скачок в 1000 раз.
Остается вопросом, являются ли 70 миллионов в неделю намеренным лимитом, техническим бутылочным горлышком или же пределом мощностей краулеров самих
Данные о прозрачности подтверждают двухуровневую реальность: трастовые отправители работают в таких масштабах и с таким проактивным подавлением индексации, до которых обычным отправителям
https://torrentfreak.com/googles-top-dmca-sender-plateaus-at-70-million-takedowns-per-week/
#DMCA #Indexing #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Крупнейший отправитель
DMCA-запросов в Гугл, компания Link-Busters, вышла на плато в 60–70 миллионов запросов на удаление URL в неделю и держит эту планку уже около года.На счету компании более 6,5 миллиардов запросов на деиндексацию — это больше трети от почти 18 миллиардов, полученных Гуглом за всё время, и в четыре раза больше, чем у ближайшего преследователя.
При текущих темпах они отправляют около 3,5 миллиардов урлов в год.
Но две детали важнее, чем общие объемы.
Доля ошибок у
Link-Busters держится ниже 1% (что сильно лучше среднего показателя), а почти 8% отправленных ими урлов еще даже не были проиндексированы Гуглом.Гугл вычищал эти непроиндексированные урлы проактивно, идя навстречу правообладателю, и блокировал страницы до того, как они вообще попадали в индекс.
Механизм, позволяющий пробивать потолок, — это скрытый от глаз канал:
Trusted Content Removal Program (TCRP), путь для массовой загрузки жалоб, который Гугл предоставляет проверенным партнерам.На прямой вопрос о наличии дневных лимитов Гугл не дал ни подтверждения, ни опровержения, заявив лишь, что трастовые партнеры "могут отправлять то количество, которое им необходимо".
Это куда более осторожный ответ, чем в 2013 году, когда Гугл заявлял, что лимитов на уведомления "не существует".
Тогда его обвиняли в жестком ограничении правообладателей планкой в 10 000 урлов в день.
Один заявитель, зачищающий сейчас около 10 миллионов урлов ежедневно, означает скачок в 1000 раз.
Остается вопросом, являются ли 70 миллионов в неделю намеренным лимитом, техническим бутылочным горлышком или же пределом мощностей краулеров самих
Link-Busters.Данные о прозрачности подтверждают двухуровневую реальность: трастовые отправители работают в таких масштабах и с таким проактивным подавлением индексации, до которых обычным отправителям
DMCA никогда не дотянуться.https://torrentfreak.com/googles-top-dmca-sender-plateaus-at-70-million-takedowns-per-week/
#DMCA #Indexing #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

👀6❤1
Гуглобот рендерит страницу не так, как обычный браузер, даже несмотря на то, что Google использует актуальную версию
Тут много нюансов, но главный фактор —
Всё, что заблокировано в
Типичный пример — реклама, и обычно её отсутствие при рендере ни на что не влияет.
Но периодически под блокировку попадают важные
Можно использовать проверку
И если подозреваешь, что что-то идет не так, определенно стоит это сделать, чтобы увидеть страницу глазами гуглобота.
Но также можно заюзать мой новый
Его можно запустить локально, но я также добавил два
Один для самого прокси, а второй — для отдельного инстанса
Источник: https://github.com/VorticonCmdr/robotstxtProxy
Дока: https://vorticoncmdr.github.io/robotstxtProxy/
Инсайты комьюнити
— Блокировка запросов через
#Rendering #RobotsTxt #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Chromium.Тут много нюансов, но главный фактор —
robots.txt.Всё, что заблокировано в
robots.txt, не скачивается и, соответственно, не рендерится.Типичный пример — реклама, и обычно её отсутствие при рендере ни на что не влияет.
Но периодически под блокировку попадают важные
JS и CSS, из-за чего отрендеренная страница в лучшем случае выглядит криво, а в худшем — вообще не читается.Можно использовать проверку
URL в GSC или Rich Result Test, чтобы посмотреть на конкретную страницу.И если подозреваешь, что что-то идет не так, определенно стоит это сделать, чтобы увидеть страницу глазами гуглобота.
Но также можно заюзать мой новый
robotstxtProxy, который перехватывает все запросы, сверяет их с robots.txt хоста и разрешает или блокирует их соответственно, пишет Валентин Плетцер.Его можно запустить локально, но я также добавил два
Docker-контейнера.Один для самого прокси, а второй — для отдельного инстанса
Chromium, чтобы тебе не пришлось возиться с TLS-сертификатами, которые нужны для перехвата HTTPS-запросов.Источник: https://github.com/VorticonCmdr/robotstxtProxy
Дока: https://vorticoncmdr.github.io/robotstxtProxy/
Инсайты комьюнити
— Блокировка запросов через
Chrome DevTools (вкладка Inspect) — это ручной способ воспроизвести аналогичную картину: ты блокируешь ресурсы, запрещенные в robots.txt, и смотришь на тот же ухудшенный рендер, который получает гуглобот, не поднимая никаких прокси.#Rendering #RobotsTxt #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤2
Я пережил главный сдвиг майндсета после отслеживания миллионов страниц, раскрывает Адам Гент.
Индекс Google спроектирован так, чтобы исключать ваш контент.
А не включать его.
Существуют жесткие лимиты на то, сколько страниц Google может держать в индексе.
Когда он достигает этих лимитов, Google повышает планку качества и удаляет страницы ниже порога.
Каждый раз, когда вы публикуете новую страницу, вы вступаете в конкуренцию за конечный слот.
Патент, описывающий это —
Гэри Илш подтвердил это публично: Google активно деиндексировал огромные массивы
Вы относитесь к индексации как к тому, что нужно заслужить, или как к чему-то, что происходит автоматически?
#Indexing #GoogleBot #CrawlBudget
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Индекс Google спроектирован так, чтобы исключать ваш контент.
А не включать его.
Существуют жесткие лимиты на то, сколько страниц Google может держать в индексе.
Когда он достигает этих лимитов, Google повышает планку качества и удаляет страницы ниже порога.
Каждый раз, когда вы публикуете новую страницу, вы вступаете в конкуренцию за конечный слот.
Патент, описывающий это —
Managing URLs (US7509315B1).Гэри Илш подтвердил это публично: Google активно деиндексировал огромные массивы
URL на сайтах просто потому, что его восприятие качества сайта изменилось.Вы относитесь к индексации как к тому, что нужно заслужить, или как к чему-то, что происходит автоматически?
#Indexing #GoogleBot #CrawlBudget
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤3
Тесты опровергают 5-секундный лимит рендера — Web Rendering Service ставит внутренние часы на паузу
Миф о 5-секундном лимите рендера ходит давно, но тесты, которые его якобы подтверждают, неправильно интерпретируют работу
Любые нужные
Этот крюк — одно из отличий от обычного браузера.
Второе — время.
Он работает на виртуальных часах, которыми управляет Google, и может ускорять, замедлять или намертво замораживать время для
Тестовая страница с двумя серверными
Итоговое время для обоих вызовов возвращается как 0.02 секунды, потому что
Получается, счетчик
Рендер заканчивается, когда
Но терпение не бесконечно.
Страница, которая запрашивает данные в бесконечном цикле (3 секунды серверной задержки на вызов), действительно обрубается: инструменты проверки в реальном времени остановились после 16-18 вызовов (48-54 секунды), а фактическая индексация оборвалась после 10 вызовов (30 секунд), хотя точный порог плавает.
Это и есть реальный потолок — пустой
Оба состояния наступают далеко за пределами 5 секунд и намного позже, чем дождался бы любой живой юзер.
https://tamethebots.com/blog-n-bits/the-5-second-google-render-limit-myth
#Rendering #TechnicalSEO #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Миф о 5-секундном лимите рендера ходит давно, но тесты, которые его якобы подтверждают, неправильно интерпретируют работу
Web Rendering Service (WRS) со временем.Googlebot скачивает сырой HTML, затем передает его в WRS — headless-версию Chrome.Любые нужные
CSS или JS краулинговая инфраструктура запрашивает отдельно, прокидывает обратно через систему и возвращает в Chrome.Этот крюк — одно из отличий от обычного браузера.
Второе — время.
WRS не привязан к аппаратному таймеру.Он работает на виртуальных часах, которыми управляет Google, и может ускорять, замедлять или намертво замораживать время для
headless-инстанса.Тестовая страница с двумя серверными
API-вызовами, каждый с рандомной задержкой от 3 до 6 секунд (в сумме 6-12 секунд, что сильно превышает мнимый порог в 5 секунд), всё равно полностью проходит рендер и индексируется.Итоговое время для обоих вызовов возвращается как 0.02 секунды, потому что
WRS ставит время на паузу во время запроса и считает только работу по вставке результатов в DOM.Получается, счетчик
setInterval, который якобы "доказывает" потолок в 5 секунд, измеряет виртуальные часы, а не реальный лимит.Рендер заканчивается, когда
WRS фиксирует, что event loop простаивает и новых задач нет — а не когда истекает таймер.Но терпение не бесконечно.
Страница, которая запрашивает данные в бесконечном цикле (3 секунды серверной задержки на вызов), действительно обрубается: инструменты проверки в реальном времени остановились после 16-18 вызовов (48-54 секунды), а фактическая индексация оборвалась после 10 вызовов (30 секунд), хотя точный порог плавает.
Это и есть реальный потолок — пустой
event loop или бесконечный цикл.Оба состояния наступают далеко за пределами 5 секунд и намного позже, чем дождался бы любой живой юзер.
https://tamethebots.com/blog-n-bits/the-5-second-google-render-limit-myth
#Rendering #TechnicalSEO #GoogleBot
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤1
Логи отрендеренного HTML фиксируют: часы Гуглобота останавливаются, пока страница подгружает ресурсы
Гуглобот рендерит по собственным часам, а не по реальному времени, и эти часы останавливаются, пока выполняется
В простое он гонит: 5-секундный таймер сработал всего через 455 мс реального серверного времени.
15 ресурсов в цепочке по 500 мс каждый сожгли 9 986 мс реального времени, тогда как часы Гуглобота доползли лишь до 162 мс.
Снапшот срабатывает по внутреннему времени, а не по реальному.
После 5 секунд по собственным часам размер вьюпорта меняется, и страница получает последний шанс загрузить контент; отрендеренный
Реальное время задает лишь внешнюю границу.
При цепочке 5-секундных серверных задержек сетевые запросы обрывались на 52 132 мс реального времени, в то время как внутренние часы показывали 112 мс — после чего они спокойно летели к своей отметке в 5 250 мс и завершали рендер.
Детерминизм зашит в эти же часы.
Я собирал скрипт для сброса кеша, чтобы форсировать перекраулинг ресурсов, и обнаружил, что эти цифры никогда не меняются.
Завязанные на рандом сбросы кеша не работают, и всё, что варьируется от времени суток, сводится для краулера к одному замороженному варианту.
Срабатывают два события изменения размера, оба привязаны ко времени Гуглобота:
1. На 5 000 мс: внешние габариты окна схлопываются до
2. На 5 299.9 мс:
Никаких событий скролла не происходит.
Бесконечный скролл на
Три секции, независимо от длины страницы.
Весь лог пишется хелпером
Побочный эффект такого длинного вьюпорта: главное изображение с высотой
На индексацию это не влияет, судя по ответам на эту находку, и ограничение через
https://bigcommerce.websiteadvantage.com.au/tonys-theory-of-googlebot-relativity/
#Crawling #GoogleBot #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Гуглобот рендерит по собственным часам, а не по реальному времени, и эти часы останавливаются, пока выполняется
JavaScript или висят сетевые запросы.В простое он гонит: 5-секундный таймер сработал всего через 455 мс реального серверного времени.
15 ресурсов в цепочке по 500 мс каждый сожгли 9 986 мс реального времени, тогда как часы Гуглобота доползли лишь до 162 мс.
API времени работают как счетчики, а не часы — каждый вызов Date.now() или performance.now() двигает собственный счетчик на 1 мс, и оба идут независимо: 10 000 вызовов Date.now() довели его значение до 10001, тогда как performance.now() остался нетронутым.Снапшот срабатывает по внутреннему времени, а не по реальному.
После 5 секунд по собственным часам размер вьюпорта меняется, и страница получает последний шанс загрузить контент; отрендеренный
HTML фиксируется примерно на отметке 5 250 мс этих часов, а 6-секундный таймаут так и не наступает.Реальное время задает лишь внешнюю границу.
При цепочке 5-секундных серверных задержек сетевые запросы обрывались на 52 132 мс реального времени, в то время как внутренние часы показывали 112 мс — после чего они спокойно летели к своей отметке в 5 250 мс и завершали рендер.
Детерминизм зашит в эти же часы.
performance.timeOrigin у реального Гуглобота сброшен на полночь по UTC, стирая время суток.Math.random() выдает идентичную последовательность при каждом краулинге (0.6393021999392658, затем 0.5943970666266978) во всех средах: реальном Гуглоботе, Google-InspectionTool и Rich Result Test, в разное время суток, причем криптографические случайные значения тоже совпадают.Я собирал скрипт для сброса кеша, чтобы форсировать перекраулинг ресурсов, и обнаружил, что эти цифры никогда не меняются.
Завязанные на рандом сбросы кеша не работают, и всё, что варьируется от времени суток, сводится для краулера к одному замороженному варианту.
Срабатывают два события изменения размера, оба привязаны ко времени Гуглобота:
1. На 5 000 мс: внешние габариты окна схлопываются до
1px, а масштаб вьюпорта прыгает 0.42 → 1.2. На 5 299.9 мс:
window.innerHeight отдает 1 251 074px на странице, которая добавляет блоки по 1000px каждую миллисекунду Гуглобота.Никаких событий скролла не происходит.
Бесконечный скролл на
IntersectionObserver продвигается только при этих двух изменениях размера — первая секция грузится на первом, вторая на втором, а затем время останавливается.Три секции, независимо от длины страницы.
Весь лог пишется хелпером
htmlLog(), который добавляет текстовые ноды в тег <script type="text/plain">, и этот тег доживает до отрендеренного HTML, который возвращают инструменты тестирования.Побочный эффект такого длинного вьюпорта: главное изображение с высотой
100vh искажает превью в URL Inspection, потому что видимый контент всегда оказывается за пределами области рендера.На индексацию это не влияет, судя по ответам на эту находку, и ограничение через
max-height служит решением; сказывается ли такая структура на позициях — не проверено.https://bigcommerce.websiteadvantage.com.au/tonys-theory-of-googlebot-relativity/
#Crawling #GoogleBot #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

Статистика сканирования в GSC раскрывает запросы Googlebot, которые CDN поглощает до основного сервера
Выгрузка логов основного сервера за 40 дней для крупного
То есть около 88% оказались сканерами, подделывающими
В сухом остатке — порядка 5 600 правдоподобно реальных обращений
Остальная часть выгрузки выглядела не лучше: 76 377 из 76 381 событий
А набор
Согласно Джону Мюллеру: бери для работы меньшую подвыборку (поддомен, если есть), затем сравнивай запросы на краулинг в
Идеально не будет — Google использует много юзер-агентов, а сайт с тяжелым каталогом товаров или активной рекламой тоже генерирует массу таких обращений.
Статистика сканирования в
Десять лет полных логов для сайта такого размера — это территория петабайтов, при этом сам объем здесь не главное ограничение.
Если впереди стоит кеш, запросы обрабатываются на
Поэтому логи не дадут ответа, сколько бы дней ни выгружали.
Вместо этого запрашивай предварительно отфильтрованные данные: короткий период, только трафик ботов, с фокусом на масштабируемые разделы сайта, такие как
Фильтрация сырых логов по юзер-агенту выдает только потенциальных ботов — реального
Инсайты комьюнити
— Сначала загрузи 7 дней в
— Обработка ботов может отличаться в зависимости от фронтенд-окружения, поэтому подтверди, логи какой именно среды тебе передали: в одном случае один фронтенд рапортовал, что каждый бот получает
#LogFileAnalysis #CrawlBudget #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Выгрузка логов основного сервера за 40 дней для крупного
e-commerce домена содержала 45 765 событий с юзер-агентом Googlebot — и 40 157 из них были запросами к /.env, /.ssh/id_ecdsa_sk.priv, /keystore.jks и подобным.То есть около 88% оказались сканерами, подделывающими
UA.В сухом остатке — порядка 5 600 правдоподобно реальных обращений
Googlebot за 30 дней.Остальная часть выгрузки выглядела не лучше: 76 377 из 76 381 событий
www отдавали 3xx на 80 порту без единого 200 — это отскок с HTTP на HTTPS, а не краулинг.А набор
intl_bots, охватывающий примерно две трети данных, вообще не содержал статус-кодов.Согласно Джону Мюллеру: бери для работы меньшую подвыборку (поддомен, если есть), затем сравнивай запросы на краулинг в
GSC с запросами от Google в логах и проверяй, совпадает ли хотя бы тренд.Идеально не будет — Google использует много юзер-агентов, а сайт с тяжелым каталогом товаров или активной рекламой тоже генерирует массу таких обращений.
Статистика сканирования в
GSC также показывает, тормозит ли Googlebot, отваливается ли по тайм-ауту или в целом ловит ошибки.Десять лет полных логов для сайта такого размера — это территория петабайтов, при этом сам объем здесь не главное ограничение.
Если впереди стоит кеш, запросы обрабатываются на
edge-серверах, и основной сервер их никогда не видит.Поэтому логи не дадут ответа, сколько бы дней ни выгружали.
Вместо этого запрашивай предварительно отфильтрованные данные: короткий период, только трафик ботов, с фокусом на масштабируемые разделы сайта, такие как
plp и pdp.Фильтрация сырых логов по юзер-агенту выдает только потенциальных ботов — реального
Googlebot подтверждает обратный поиск по IP.Инсайты комьюнити
— Сначала загрузи 7 дней в
Screaming Frog Log File Analyser, затем добавляй по одному логу в день и следи за паттерном; грузить всё сразу — слишком много информации для анализа. Перед импортом проверь заголовки сырого файла и подтверди, что есть что — в логах IIS поля c-ip и IP клиента WAF легко перепутать, а с Sucuri спереди именно поле IP WAF изолирует Googlebot и Bingbot. Сверяй это с данными краулинга GSC в настройках. Ведущие WAF и CDN по умолчанию не должны блокировать настоящих ботов вроде Googlebot.— Обработка ботов может отличаться в зависимости от фронтенд-окружения, поэтому подтверди, логи какой именно среды тебе передали: в одном случае один фронтенд рапортовал, что каждый бот получает
429, тогда как остальные этого не делали. Некоторые переданные урлы были маршрутами, а не путями, поэтому в ТЗ на выгрузку нужно указывать пути и урлы явно. Отслеживание даже одного случая из GSC обратно в логи подтверждает правильное место и нужного бота; в том же кейсе многие боты, видимые в GSC, оказались не теми, кого ждали, а количество сканирований от самого Googlebot оказалось ниже, чем подразумевал график.#LogFileAnalysis #CrawlBudget #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
⚡1
Это исследование показало, что блокировка "
https://arxiv.org/pdf/2604.27790
#BotBlocking #AIOverviews #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Google-Extended Bot" может привести к меньшему числу цитаций в AIO, вопреки заявлениям Google.https://arxiv.org/pdf/2604.27790
#BotBlocking #AIOverviews #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
🔥1
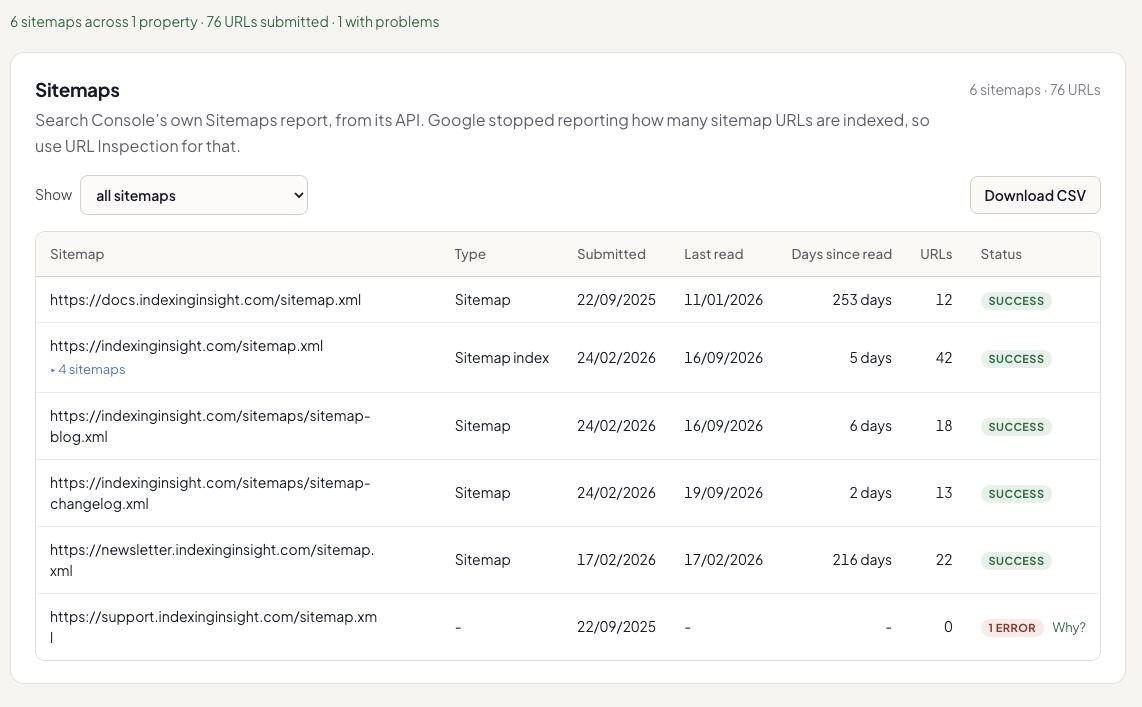
Если Гуглобот давно не читал
Простая метрика в
Но это может быть реальным индикатором того, что Гугл думает о твоем сайте.
Помни, качество пронизывает всю их систему.
От ранжирования до сайтмапов 😝.
Инсайты комьюнити
— Сегментируй урлы в сайтмапах по давности — выноси старые урлы в отдельный сайтмап, отдельно от часто обновляемых страниц, — чтобы проблемы с качеством сайтмапа было проще изолировать и анализировать.
— Гипотеза: постоянная отправка технически битых или некачественных по контенту урлов сайтмапа заставляет Гуглобота снизить частоту краулинга. Оставлять индексируемую страницу "в разработке" открытой, с бэклинками и в сайтмапе — плохая идея по той же причине: это сжигает краулинговый бюджет и оттягивает запуск новой версии, что называют худшим решением в такой ситуации.
#Crawling #Sitemaps #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
XML-сайтмап (скажем, 253 дня)... это признак того, что системы Гугла считают урлы в сайтмапе "низкокачественными".Простая метрика в
GSC, которую все упускают из виду.Но это может быть реальным индикатором того, что Гугл думает о твоем сайте.
Помни, качество пронизывает всю их систему.
От ранжирования до сайтмапов 😝.
Инсайты комьюнити
— Сегментируй урлы в сайтмапах по давности — выноси старые урлы в отдельный сайтмап, отдельно от часто обновляемых страниц, — чтобы проблемы с качеством сайтмапа было проще изолировать и анализировать.
— Гипотеза: постоянная отправка технически битых или некачественных по контенту урлов сайтмапа заставляет Гуглобота снизить частоту краулинга. Оставлять индексируемую страницу "в разработке" открытой, с бэклинками и в сайтмапе — плохая идея по той же причине: это сжигает краулинговый бюджет и оттягивает запуск новой версии, что называют худшим решением в такой ситуации.
#Crawling #Sitemaps #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤1✍1
Гуглобот игнорит HTTPS-редиректы из-за забытых disallow в HTTP robots.txt
Какой
Ни один не получает приоритета.
Каждый протокол тянет свой собственный
Вероятно, система видит разные протоколы как разные
Когда
Именно в этом расколе и кроется ловушка.
Если сайт полностью переехал на
Но если старые
В итоге редирект тупо не считывается.
В одном кейсе на
Фикс оказался простым: нужно привести оба файла к паритету, пока оба протокола остаются доступны.
Джон Мюллер называет главную ошибку, которая чаще всего бьет по сайтам:
Если на
В треде не ответили, как
Инсайты комьюнити
—
— Гипотеза о том, какой файл выигрывает: если нет жесткого сигнала, что
#RobotsTxt #Redirects #GoogleBot
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
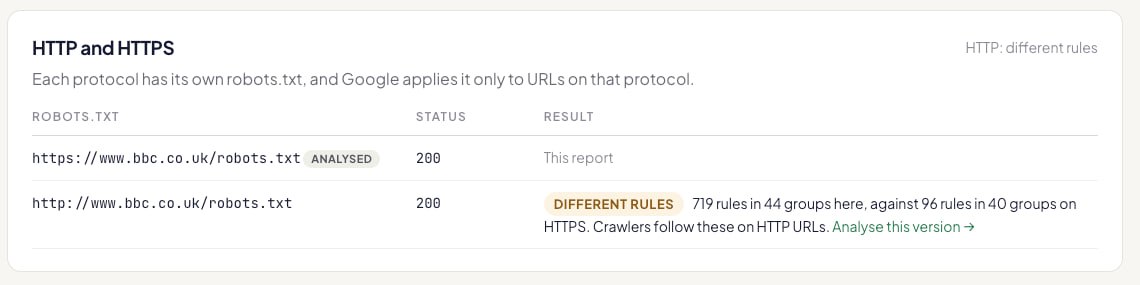
Какой
robots.txt побеждает, если версии HTTP и HTTPS отличаются?Ни один не получает приоритета.
Каждый протокол тянет свой собственный
robots.txt: HTTP-файл управляет HTTP-урлами, HTTPS-файл — HTTPS-урлами.Вероятно, система видит разные протоколы как разные
URI, и применяемый файл зависит от запрашиваемого урла.Когда
HTTP редиректит на HTTPS, Гугл идет по редиректу, и HTTPS-версия становится актуальным пунктом назначения, однако эти два файла всё равно могут содержать разные правила.Именно в этом расколе и кроется ловушка.
Если сайт полностью переехал на
HTTPS и HTTP-урлов больше нет, HTTP-версия robots.txt особой роли не сыграет.Но если старые
HTTP-урлы всё ещё живы и редиректят на HTTPS, забытое правило disallow в HTTP-файле блочит Гуглу краулинг этих урлов, а Гуглу этот краулинг жизненно необходим, чтобы увидеть редирект на HTTPS.В итоге редирект тупо не считывается.
В одном кейсе на
HTTPS-сайте казалось, что для Гугла срабатывает HTTPS-файл.Фикс оказался простым: нужно привести оба файла к паритету, пока оба протокола остаются доступны.
Джон Мюллер называет главную ошибку, которая чаще всего бьет по сайтам:
HTTP-версия отдает дефолтную страницу сервера, из-за чего сайт выглядит мертвым.Если на
HTTP нечего краулить и индексировать, HTTP robots.txt в любом случае ни на что не повлияет.В треде не ответили, как
Bing и AI-краулеры разруливают конфликтующие файлы; все наблюдения выше касаются исключительно Гугла.Инсайты комьюнити
—
HTTP-страница, которая отдает 302 на HTTPS-версию — это отдельная аномалия: возможно, промах в правилах редиректа.— Гипотеза о том, какой файл выигрывает: если нет жесткого сигнала, что
HTTP можно обходить, системы ставят в очередь и запрашивают HTTPS-версию robots.txt по умолчанию. Если не с первого захода, то она в итоге побеждает, когда выбирается и подтверждается каноникал, а количество не-TLS урлов со временем должно падать. Настроенный HSTS на документах — это, скорее всего, сильный сигнал, особенно если домен был отправлен или автоматически добавлен в preload-список.#RobotsTxt #Redirects #GoogleBot
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤1
Данные раскрывают реальный лимит: Гугл виснет на сайтмапах задолго до 50K файлов — потолок около 200
Индексный сайтмап на 19 000 вложенных файлов для сайта с 1 млрд урлов так и не обработался и показал ноль вложенных карт спустя месяц.
Каждый файл вписывался в официальные лимиты: вес до 50 МБ без сжатия, до 50К урлов на файл, меньше 50К вложенных карт на индекс.
Раньше этот сетап работал без сбоев — до августа проблем не было на чуть меньшем объеме урлов, затем сайтмап пробил 900 млн, но так и не смог переварить 950 млн, а теперь даже срез на 95 млн обрабатывается со скрипом.
Диагноз сводится к масштабам обработки, а не к формату сайтмапа.
Мелкие индексы работают, тогда как индексы на 5К+ файлов виснут наглухо — это указывает на скрытый лимит или на то, что
Сразу несколько тредов в справке Гугла за май-август описывают тот же сбой: валидные сайтмапы, которые гуглобот может парсить, но
— https://support.google.com/webmasters/thread/456480618/child-sitemaps-show-couldn-t-fetch-despite-verified-google-http-200-responses
— https://support.google.com/webmasters/thread/449591907/artikels-of-sub-sitemaps-not-shown-in-gsc-as-submitted-pages
— https://support.google.com/webmasters/thread/455164087/sitemap-index-shows-success-but-0-discovered-urls-when-submitted-directly-same-content-via-redir
Единственный способ нащупать реальный потолок — это ступенчатое тестирование.
Оставляешь всё остальное без изменений и шагами урезаешь родительский индекс: 10 вложенных файлов, затем 50, затем 100 и так далее, параллельно мониторя серверные логи на предмет парсинга сайтмапов гуглоботом.
Если 100 файлов залетают нормально, а на 500 всё виснет, то это и есть фактический порог, что бы там ни писали про официальные 50К.
Срезы говорят сами за себя.
Индексы размером до 5К файлов фиксировали по одной вложенной карте и останавливались.
Индекс всего на 10 файлов Гугл обработал полностью за пару минут.
Что в итоге сработало: 100 индексных файлов, в каждом меньше 200 вложенных сайтмапов — они залетели в панель за считанные минуты, и гуглобот начал их парсить.
Тестировали не каждый шаг, поэтому больший размер индекса тоже может прокатить; точный потолок так и остался нераскрытым.
Инсайты комьюнити
— Гуглобот продолжал краулить сайт со скоростью 1-5 млн хитов в день всё то время, пока висел сайтмап. Такой стабильный объем парсинга указывает на то, что проблема именно в неспособности гуглобота переварить файлы сайтмапа, а не в урезании краулингового бюджета для самого сайта.
— Правило ожидания при тестах индексации: для индекса на 1000+ файлов закладывай неделю, или две, если хочешь перестраховаться. Если индекс на 5К файлов спустя это время так и висит с одним обработанным файлом, то это, скорее всего, проваленный тест на индексацию, а не нормальная задержка.
— Структурные альтернативы одному гигантскому индексу: дробить индексные файлы по подпапкам или завести отдельный ресурс в
— Смежный пост по
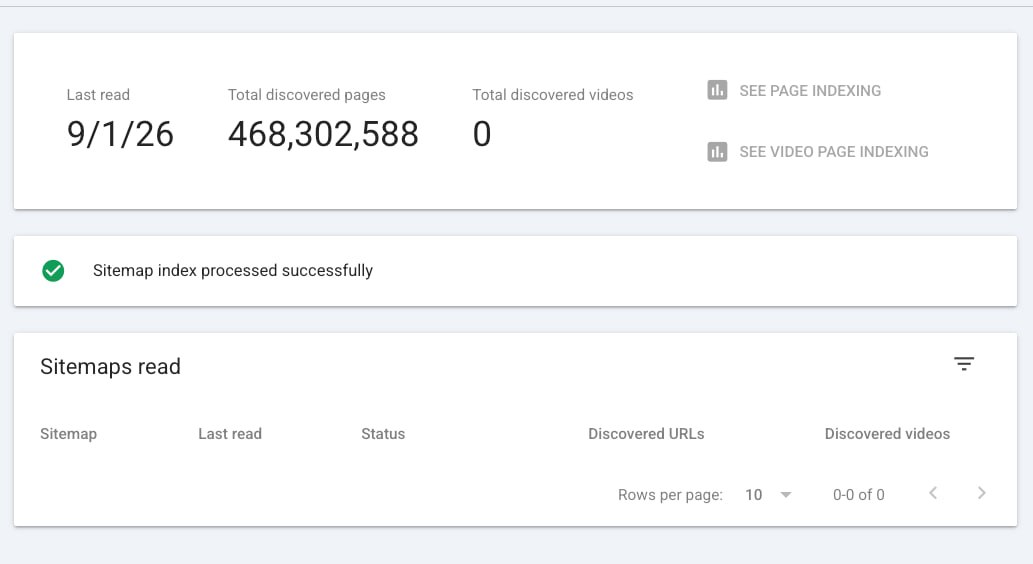
— Цифра в 468 млн "обнаруженных" урлов в
#Sitemaps #TechnicalSEO #GoogleBot
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
Индексный сайтмап на 19 000 вложенных файлов для сайта с 1 млрд урлов так и не обработался и показал ноль вложенных карт спустя месяц.
Каждый файл вписывался в официальные лимиты: вес до 50 МБ без сжатия, до 50К урлов на файл, меньше 50К вложенных карт на индекс.
Bing парсил тысячи вложенных файлов в день из тех же исходников; Гугл скраулил около 20 за весь месяц.Раньше этот сетап работал без сбоев — до августа проблем не было на чуть меньшем объеме урлов, затем сайтмап пробил 900 млн, но так и не смог переварить 950 млн, а теперь даже срез на 95 млн обрабатывается со скрипом.
Диагноз сводится к масштабам обработки, а не к формату сайтмапа.
Мелкие индексы работают, тогда как индексы на 5К+ файлов виснут наглухо — это указывает на скрытый лимит или на то, что
GSC захлебывается от размера файла даже в рамках официальных ограничений.Сразу несколько тредов в справке Гугла за май-август описывают тот же сбой: валидные сайтмапы, которые гуглобот может парсить, но
GSC их тупо не обрабатывает, либо обрабатывает лишь частично:— https://support.google.com/webmasters/thread/456480618/child-sitemaps-show-couldn-t-fetch-despite-verified-google-http-200-responses
— https://support.google.com/webmasters/thread/449591907/artikels-of-sub-sitemaps-not-shown-in-gsc-as-submitted-pages
— https://support.google.com/webmasters/thread/455164087/sitemap-index-shows-success-but-0-discovered-urls-when-submitted-directly-same-content-via-redir
Единственный способ нащупать реальный потолок — это ступенчатое тестирование.
Оставляешь всё остальное без изменений и шагами урезаешь родительский индекс: 10 вложенных файлов, затем 50, затем 100 и так далее, параллельно мониторя серверные логи на предмет парсинга сайтмапов гуглоботом.
Если 100 файлов залетают нормально, а на 500 всё виснет, то это и есть фактический порог, что бы там ни писали про официальные 50К.
Срезы говорят сами за себя.
Индексы размером до 5К файлов фиксировали по одной вложенной карте и останавливались.
Индекс всего на 10 файлов Гугл обработал полностью за пару минут.
Что в итоге сработало: 100 индексных файлов, в каждом меньше 200 вложенных сайтмапов — они залетели в панель за считанные минуты, и гуглобот начал их парсить.
Тестировали не каждый шаг, поэтому больший размер индекса тоже может прокатить; точный потолок так и остался нераскрытым.
Инсайты комьюнити
— Гуглобот продолжал краулить сайт со скоростью 1-5 млн хитов в день всё то время, пока висел сайтмап. Такой стабильный объем парсинга указывает на то, что проблема именно в неспособности гуглобота переварить файлы сайтмапа, а не в урезании краулингового бюджета для самого сайта.
— Правило ожидания при тестах индексации: для индекса на 1000+ файлов закладывай неделю, или две, если хочешь перестраховаться. Если индекс на 5К файлов спустя это время так и висит с одним обработанным файлом, то это, скорее всего, проваленный тест на индексацию, а не нормальная задержка.
— Структурные альтернативы одному гигантскому индексу: дробить индексные файлы по подпапкам или завести отдельный ресурс в
GSC под каждую подпапку и скармливать их отдельно. GSC ограничивает один ресурс 500 индексными файлами, но сабмитить ~1900 крошечных индексов нет смысла — разбить единый индекс на 5 или 10 индексных файлов куда логичнее (на этом сайте 5 файлов всё равно зависли; потребовалось 100).— Смежный пост по
GSC-аналитике, который стоит изучить: https://www.linkedin.com/posts/ajkohn_gsc-analytics-ugcPost-7502749443960672256-Fxta— Цифра в 468 млн "обнаруженных" урлов в
GSC, зависшая на месяц примерно на половине от общего объема, считает только те урлы, которые Гугл вытащил из сайтмапа, а не скраулил или проиндексировал.#Sitemaps #TechnicalSEO #GoogleBot
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤3