Представляю
Все больше сайтов полагаются на
Для пользователей это нормально, но для поисковых систем и
И хотя продвинутые поисковики вроде Google достигли значительного прогресса в рендеринге и понимании
Мне надоело тратить кучу времени, пытаясь понять, что на самом деле видят Google и новые
Оно подсвечивает КАЖДОЕ различие в тегах в
Расширение офигенно помогает дебажить проблемы с паритетом рендеринга и отлавливать регрессии в метаданных до того, как они повлияют на индексацию или видимость для
Что оно делает:
— Сравнивает
— Отмечает измененные, добавленные или удаленные элементы.
— Работает почти на любой
— Экспортирует отчеты для
— Легкое, приватное и создано для реального дебаггинга — без зависимостей, сбора данных и настройки.
Если вам важно, как ваши страницы понимают и поисковики, и
https://chromewebstore.google.com/detail/seo-js-checker/mllilfpgoolaefgngamnamojfgpggglo
#JavaScript #Rendering #Tools
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
SEO JavaScript Checker — мое первое расширение для Chrome, сделанное, чтобы ваши аудиты JavaScript SEO были менее геморными, пишет Адам Кинг.Все больше сайтов полагаются на
JavaScript-фреймворки вроде React, Next.js, фронтенды на Shopify, сложные менеджеры тегов, и они часто переписывают ключевой HTML.Для пользователей это нормально, но для поисковых систем и
AI-краулеров это создает неопределенность в том, что на самом деле содержится на вашей странице.AI-краулеры, особенно те, что связаны с большими языковыми моделями (LLM) и поисковиками на базе AI, часто сталкиваются с проблемами на сайтах с тяжелым JavaScript.И хотя продвинутые поисковики вроде Google достигли значительного прогресса в рендеринге и понимании
JavaScript, многие AI-краулеры с этим не справляются.Мне надоело тратить кучу времени, пытаясь понять, что на самом деле видят Google и новые
AI-модели типа ChatGPT, Perplexity и Gemini, поэтому я создал SEO JS Checker — расширение для Chrome, которое сравнивает сырой HTML с сервера с отрендеренным на клиенте DOM.Оно подсвечивает КАЖДОЕ различие в тегах в
<head>, видимом тексте и ссылках, так что вы сразу видите, что изменилось после выполнения JavaScript.Расширение офигенно помогает дебажить проблемы с паритетом рендеринга и отлавливать регрессии в метаданных до того, как они повлияют на индексацию или видимость для
AI.Что оно делает:
— Сравнивает
HTML с сервера и отрендеренный HTML.— Отмечает измененные, добавленные или удаленные элементы.
— Работает почти на любой
HTTPS-странице.— Экспортирует отчеты для
QA или документации.— Легкое, приватное и создано для реального дебаггинга — без зависимостей, сбора данных и настройки.
Если вам важно, как ваши страницы понимают и поисковики, и
AI-краулеры, эта штука поможет сократить разрыв.https://chromewebstore.google.com/detail/seo-js-checker/mllilfpgoolaefgngamnamojfgpggglo
#JavaScript #Rendering #Tools
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO

🔥11❤1👌1
"Другой" движок JavaScript у Googlebot: как по скорости рендеринга отличить настоящего краулера от фейка
Продакшн-версия
Он работает на чем-то, что выглядит как инопланетная технология, и вы можете использовать это в своих интересах, раскрывает Тед Кубайтис.
Мы провели бенчмарки и обнаружили, что он может выполнять массивные, итеративные циклы
Стандартные
Этот разрыв в производительности — однозначный отпечаток пальца, который можно использовать, чтобы отличить настоящего
Инструмент проверки
Именно поэтому вы можете видеть расхождения в рендеринге, особенно на страницах с тяжелым
Однако ваше безопасное допущение должно быть таким: если
Критическое исключение из этого правила — время выполнения.
Поскольку у продакшн-бота есть это ускоренное процессирование, существует граничный случай, когда он может успешно отрендерить сложный
#GoogleBot #JavaScript #Cloaking
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
Продакшн-версия
Googlebot, которая краулит веб в промышленных масштабах, — это не тот же инструмент, что вы юзаете в GSC.Он работает на чем-то, что выглядит как инопланетная технология, и вы можете использовать это в своих интересах, раскрывает Тед Кубайтис.
Мы провели бенчмарки и обнаружили, что он может выполнять массивные, итеративные циклы
JavaScript — например, посчитать до 10 миллиардов — за время, которое регистрируется как ноль миллисекунд.Стандартные
headless-браузеры и фейковые боты, притворяющиеся Googlebot, просто не могут этого повторить; они не работают на гиперускоренном железе стоимостью в миллионы долларов.Этот разрыв в производительности — однозначный отпечаток пальца, который можно использовать, чтобы отличить настоящего
Googlebot от всего остального.Инструмент проверки
URL в GSC, который использует юзер-агент inspectbot, является отдельной, форкнутой версией продакшн-бота и, скорее всего, работает на другом железе.Именно поэтому вы можете видеть расхождения в рендеринге, особенно на страницах с тяжелым
JavaScript.Однако ваше безопасное допущение должно быть таким: если
inspectbot не может увидеть элемент, то, скорее всего, и продакшн-бот не сможет.Критическое исключение из этого правила — время выполнения.
Поскольку у продакшн-бота есть это ускоренное процессирование, существует граничный случай, когда он может успешно отрендерить сложный
JavaScript-элемент, на котором инструмент проверки URL отвалится по таймауту.#GoogleBot #JavaScript #Cloaking
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
👍1
Частичный гейтинг вооружает интерактивные калькуляторы и форсирует 200% ROI
Обычные статические страницы дают 2–3% вовлеченности.
Полевые данные раскрывают, что внедрение интерактивных активов — конкретно калькуляторов и инструментов оценки — форсирует вовлеченность до 20–25% и генерирует в 2 раза больше конверсий, чем статика.
Алгоритм обрабатывает итоговый рост времени на сайте в 4–5 раз, повышение общей вовлеченности на 70% и увеличение естественного прироста бэклинков на 50% как прямые сигналы ранжирования.
Кастомный
Реализация таргетируется на модификаторы с высоким интентом типа "
Пример — перехват запросов "
Архитектура должна решать конкретные вычислительные задачи, например, развертывание "SaaS LTV:CAC ratio calculator with benchmarks" вместо базовых моделей.
Формат выкатки зависит от ресурсов: самописный код закрывает простую логику вроде расчета
Классический подход полностью закрывает инструмент лид-формой на старте, что сразу убивает конверсию.
Тесты раскрывают специфическую конфигурацию захвата, которая форсирует рост конверсии с 0.8% до 2.4%: система обязана моментально показывать базовые результаты расчетов при взаимодействии, отдавать детальный
Техническая выкатка требует оптимизации рендера
Чтобы удерживать
Непрерывное паразитирование требует ежеквартального апдейта актива для свежести контента и вшивания метрик использования прямо в
#CRO #LeadGeneration #JavaScript
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Обычные статические страницы дают 2–3% вовлеченности.
Полевые данные раскрывают, что внедрение интерактивных активов — конкретно калькуляторов и инструментов оценки — форсирует вовлеченность до 20–25% и генерирует в 2 раза больше конверсий, чем статика.
Алгоритм обрабатывает итоговый рост времени на сайте в 4–5 раз, повышение общей вовлеченности на 70% и увеличение естественного прироста бэклинков на 50% как прямые сигналы ранжирования.
Кастомный
SaaS-калькулятор цен за $4200, собранный за три недели, подтверждает эффективность механики: он перехватывает 14000 посетителей в месяц и вытаскивает 340 лидов, обеспечивая пайплайн на $890,000 и 200% ROI за 90 дней.Реализация таргетируется на модификаторы с высоким интентом типа "
calculator", "tool" и "compare" там, где выдача сейчас подсовывает статику.Пример — перехват запросов "
marketing budget calculator" с частоткой 12000 в месяц.Архитектура должна решать конкретные вычислительные задачи, например, развертывание "SaaS LTV:CAC ratio calculator with benchmarks" вместо базовых моделей.
Формат выкатки зависит от ресурсов: самописный код закрывает простую логику вроде расчета
ROI, тогда как платформы вроде Outgrow, Typeform или involve.me обходят лимиты разработки для сложных функций.Классический подход полностью закрывает инструмент лид-формой на старте, что сразу убивает конверсию.
Тесты раскрывают специфическую конфигурацию захвата, которая форсирует рост конверсии с 0.8% до 2.4%: система обязана моментально показывать базовые результаты расчетов при взаимодействии, отдавать детальный
PDF-отчет строго в обмен на email и прятать за формой захвата только продвинутые аналитические фичи.Техническая выкатка требует оптимизации рендера
JavaScript или динамического рендеринга для железного краулинга, плюс заливку микроразметки FAQPage и HowTo.Чтобы удерживать
ROI, настройте прямую передачу событий вовлеченности из ГА4 в параметры атрибуции лидов и привязки дохода для подсчета точной маржинальности.Непрерывное паразитирование требует ежеквартального апдейта актива для свежести контента и вшивания метрик использования прямо в
UI как социального доказательства.#CRO #LeadGeneration #JavaScript
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
ChatGPT отдает трафик G2, если таблица с ценами закрыта через JavaScript
"Мыслящая" модель
Когда это число спрятано за
Держи факты и спецификации в сканируемом
Вкладка
С включенным
Лицензионный уровень закрыт, если только у тебя нет национальной газеты, поэтому большинство сайтов бьются на уровне скрапинга — где главный рычаг сводится к тому, чтобы отдавать чистый код, оставляя факты в
Некоторые вопросы вообще не доходят до веба.
Поле
Корзину решает формулировка, а не тема, поэтому сначала убедись, что запрос в принципе триггерит парсинг веба, прежде чем вливать бюджет в страницу под него.
Вышеописанные поля и паттерны поведения считываются прямо из сети и из собственных сохраненных логов модели, поэтому это жесткий факт.
А вот проценты — какие домены лидируют, как часто парсит
Сам скоринг ранжирования никогда не доходит до браузера; он остается на серверах
https://suganthan.com/blog/how-chatgpt-picks-sources/
#ChatGPT #Scraping #JavaScript
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
"Мыслящая" модель
ChatGPT хочет забрать цены прямо с твоей страницы: она идет туда первой и парсит сырой HTML в поисках знаков $ или €, чтобы подтвердить цифру.Когда это число спрятано за
JavaScript-тумблером или внутри картинки, парсер сдается — в сохраненном логе рассуждений по двум SaaS-вендорам так и написано: "цена не отображается напрямую, возможно, скрыта с помощью JavaScript" — и модель откатывается к цитированию третьей стороны, G2.JS-таблица с ценами не просто плохо ранжируется; она сливает твои собственные цифры агрегаторам.Держи факты и спецификации в сканируемом
plain text и жди пробивки формата site:yourdomain.com/pricing, сгенерированной под вычищенный запрос, а не под ту корявую фразу, которую вбивает человек.Вкладка
Network вскрывает механику под капотом этого парсинга.С включенным
Preserve log я вбил запрос и прошелся по ответам — каждый веб-результат возвращался с полем resultsource, где стояло одно из четырех значений: serp (новости из открытого веба), labrador (лицензионный вайтлист национальных паблишеров вроде Reuters и WSJ с полными сниппетами на ~1080 символов), bright (скрапер Bright Data, доминирует в шопинге, финансах и погоде) и oxylabs (Oxylabs, с уклоном в региональную прессу).Лицензионный уровень закрыт, если только у тебя нет национальной газеты, поэтому большинство сайтов бьются на уровне скрапинга — где главный рычаг сводится к тому, чтобы отдавать чистый код, оставляя факты в
HTML, а не в PDF или скриптах.Некоторые вопросы вообще не доходят до веба.
Поле
turnusecase сначала раскидывает каждый запрос по корзинам, и корзина text отвечает из обучающей выборки с пустой вкладкой Network — запрос "latest treatment guidelines for type 2 diabetes" улетел именно туда, без подтягивания живых источников.Корзину решает формулировка, а не тема, поэтому сначала убедись, что запрос в принципе триггерит парсинг веба, прежде чем вливать бюджет в страницу под него.
Вышеописанные поля и паттерны поведения считываются прямо из сети и из собственных сохраненных логов модели, поэтому это жесткий факт.
А вот проценты — какие домены лидируют, как часто парсит
bright — собраны с одного залогиненного аккаунта на выборке с SaaS-уклоном, так что они показывают лишь вектор, а не точные значения.Сам скоринг ранжирования никогда не доходит до браузера; он остается на серверах
OpenAI — вот почему разговоры про "факторы ранжирования ChatGPT" это типичная продажа воздуха.https://suganthan.com/blog/how-chatgpt-picks-sources/
#ChatGPT #Scraping #JavaScript
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤1
Маскировка ссылок через JS не останавливает Google — бот парсит URL-строки напрямую из HTML и JSON
Удаление
Поисковик парсит похожие на урлы строки везде, где их находит — в исходном
Разница между
Но его все равно проиндексируют.
Официальная документация Google по ссылкам намекает на это, помечая нестандартные конструкции как "не рекомендуется (но Google все равно может попытаться это спарсить)".
Логи подтверждают это элементарно: закинь страницу с такой урлоподобной строкой, запроси индексацию и смотри, как бот стучится по этому адресу.
Попытка спрятать ссылку от краулера работает так же паршиво, как безопасность через запутывание кода.
Не отдавать
Если задача реально отрезать ботов от этих страниц, единственные железобетонные рычаги — это
Инсайты комьюнити
— Кодировка
— Самый надежный вектор эксплуатирует механику Гугла: бот ставит цели
#Crawling #JavaScript #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Удаление
<a href> и вывод внутреннего URL только через span с атрибутом data-link или инлайн-объект JSON не прячет его от Google.Поисковик парсит похожие на урлы строки везде, где их находит — в исходном
HTML, в отрендеренном DOM или в JSON-блоках — и ставит их в очередь на краулинг.Разница между
span и классической ссылкой только в одном: URL не будет считаться внутренней ссылкой и не передаст ссылочный вес.Но его все равно проиндексируют.
Официальная документация Google по ссылкам намекает на это, помечая нестандартные конструкции как "не рекомендуется (но Google все равно может попытаться это спарсить)".
Логи подтверждают это элементарно: закинь страницу с такой урлоподобной строкой, запроси индексацию и смотри, как бот стучится по этому адресу.
Попытка спрятать ссылку от краулера работает так же паршиво, как безопасность через запутывание кода.
Не отдавать
URL Гуглу напрямую — нестабильный костыль, который никак не мешает третьим лицам сослаться на этот же актив извне.Если задача реально отрезать ботов от этих страниц, единственные железобетонные рычаги — это
robots.txt (для послушных краулеров) и правила фаервола или WAF, сносящие запросы от нежелательных юзер-агентов.Инсайты комьюнити
— Кодировка
Base64 для URL-строк — это слабая обфускация: Google умеет декодировать Base64 (один практик отмечает, что не ловил бота на дефолтной настройке, но полагаться на это опасно). Чтобы клиентский энкодинг выжил, завяжи кастомный JS-декодер с правилом в robots.txt, которое блочит от сканирования сам скрипт — так бот тупо не доберется до логики, которая собирает URL.— Самый надежный вектор эксплуатирует механику Гугла: бот ставит цели
URL в очередь, но никогда по ним не кликает. Сборка или расшифровка реального URL только внутри обработчика onclick означает, что доступный для краулинга DOM никогда не засветит парсящуюся URL-строку — и тогда блокировка через robots.txt вообще не нужна. Варианты внедрения: хешировать или шифровать урлы с клиентской расшифровкой через объект crypto (или микро-библиотеку), либо прогнать двустороннюю автозамену, меняющую / на символ, который никогда не встречается в урлах.#Crawling #JavaScript #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
🔥4
Бюджет рендеринга, а не краулинговый бюджет, сутками держит свежий JS-контент без индексации
Google делит краулинг и рендеринг на два прохода.
Краулинг — это быстро и дешево; выполнение
Именно из-за этой очереди обновленный контент не появляется в выдаче.
Краулинговый бюджет считает страницы, просканированные за день; бюджет рендеринга — это отдельный ресурс, определяющий, на скольких страницах Google выполнит
Диагностируй это в
Прогони ключевую страницу через
Большой разрыв означает, что гуглобот парсит страницу, но откладывает рендер.
Сверься с отчетом
Если тяжелые
Быстрый тест: открой исходный код через
Если в сыром
Четыре вещи выжигают бюджет рендеринга быстрее всего: бандлы тяжелее 1 МБ, сторонние скрипты (
Гуглобот не скроллит: он рендерит начальный вьюпорт и останавливается, поэтому контент со второй по
Базовое решение — перенести критически важный контент, заголовки и метаданные на
Без фреймворков: отдавай полный
Проверяй каждое изменение по отрендеренному
Затем срежь пейлоад.
Целься в менее 200 КБ распарсенного
Найди раздутые пакеты через
Никогда не вешай ленивую загрузку на
Для бесконечного скролла выкатывай резервные
Если
Google разрешает такой подход, если снапшот совпадает с тем, что видят пользователи — расхождение контента считается клоакингом.
Аудит раз в месяц: разрыв дат краулинга и рендера на 10 ключевых страницах, наличие контента первого экрана в сыром коде,
Инсайты комьюнити
— Полевые тесты на 700-килобайтном бандле показали: Гуглу требовались дни на рендер нового текста; срезка сторонних скриптов и перенос ключевого текста на
#Rendering #JavaScript #CrawlBudget
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Google делит краулинг и рендеринг на два прохода.
Краулинг — это быстро и дешево; выполнение
JavaScript требует реальных вычислительных мощностей, поэтому тяжелые JS-страницы падают в очередь и рендерятся второй волной, иногда спустя часы или дни.Именно из-за этой очереди обновленный контент не появляется в выдаче.
Краулинговый бюджет считает страницы, просканированные за день; бюджет рендеринга — это отдельный ресурс, определяющий, на скольких страницах Google выполнит
JavaScript.Диагностируй это в
GSC.Прогони ключевую страницу через
URL Inspection и сравни дату Last crawl с датой Last crawl rendered.Большой разрыв означает, что гуглобот парсит страницу, но откладывает рендер.
Сверься с отчетом
Page Indexing, отфильтровав по Crawled, currently not indexed.Если тяжелые
JS-урлы скапливаются там, причина — задержка рендера.Быстрый тест: открой исходный код через
Ctrl+U.Если в сыром
HTML нет основного контента, Гуглу придется отрендерить JS, чтобы вообще его увидеть.Четыре вещи выжигают бюджет рендеринга быстрее всего: бандлы тяжелее 1 МБ, сторонние скрипты (
GA4, Hotjar, Intercom, Optimizely, GTM с 15+ тегами — в сумме это от 2 до 5 секунд выполнения), ленивая загрузка, которая не срабатывает при рендере, и бесконечный скролл.Гуглобот не скроллит: он рендерит начальный вьюпорт и останавливается, поэтому контент со второй по
N-ную страницу, который подгружается только по скроллу, остается невидимым.Базовое решение — перенести критически важный контент, заголовки и метаданные на
SSR.Next.js: getServerSideProps или getStaticProps.Nuxt: режим SSR или nuxt generate.Без фреймворков: отдавай полный
HTML, а не пустую оболочку, которую JS заполняет после загрузки.Проверяй каждое изменение по отрендеренному
HTML в URL Inspection.Затем срежь пейлоад.
Целься в менее 200 КБ распарсенного
JavaScript для контента первого экрана.Найди раздутые пакеты через
webpack-bundle-analyzer или source-map-explorer, вычисти неиспользуемый код (tree-shaking), разбей бандл по роутам, отложи некритичные скрипты и запускай сторонние теги по Window Loaded, а не DOM Ready.Никогда не вешай ленивую загрузку на
hero-изображения (используй fetchpriority="high"), основной текст, заголовки или навигацию — всё, что нужно Гуглу для понимания темы страницы, должно быть в первичном рендере.Для бесконечного скролла выкатывай резервные
URL пагинации (/blog/page/2/) с атрибутами rel="next"/rel="prev", где каждый урл отдает полный контент в исходном HTML-ответе.Если
SSR невозможен, пререндеринг через Prerender.io или Rendertron будет отдавать гуглоботу закешированный HTML-снапшот, тогда как юзеры получат JS-версию.Google разрешает такой подход, если снапшот совпадает с тем, что видят пользователи — расхождение контента считается клоакингом.
Аудит раз в месяц: разрыв дат краулинга и рендера на 10 ключевых страницах, наличие контента первого экрана в сыром коде,
Total Blocking Time ниже 200 мс в PageSpeed Insights, запуск сторонних скриптов по window load и наличие резервных ссылок пагинации на каждой странице с бесконечным скроллом.Инсайты комьюнити
— Полевые тесты на 700-килобайтном бандле показали: Гуглу требовались дни на рендер нового текста; срезка сторонних скриптов и перенос ключевого текста на
SSR сократили разрыв в рендере вдвое. Реальный рычаг — это связка сторонних скриптов и SSR, а не вес бандла сам по себе.#Rendering #JavaScript #CrawlBudget
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
🔥1
Гуглобот не скроллит страницы — без гиперссылок генерируемые урлы остаются невидимыми
Лендинг, который перезаписывает собственный адрес при скролле посетителя —
Гуглобот не висит на странице и не скроллит, поэтому эти саб-урлы никогда не генерируются при краулинге.
Триггерит ли изменение
Доступность секций для краулинга важнее вопроса с каноникалом.
Весь контент всей страницы должен как минимум загружаться в исходный
Подмена урла при скролле — рабочий паттерн для контента, который подгружается в
Одной пагинации достаточно для обнаружения урлов, но для ссылочного веса это не работает.
Строка урла в отрендеренном
Код диплинка в таком формате — не гиперссылка.
Это указывает на то, что бОльшая часть страницы ведет себя как
Шесть проверок точно доказывают, что именно доступно для краулинга:
1. Проскролль страницу вниз до смены урла, затем возьми кусок видимого текста или ссылку из этой секции.
2. Вернись наверх и обнови страницу с очисткой кеша (hard reload).
3. Без взаимодействия со страницей проверь отрендеренный
4. Убедись, что найденный текст — это именно видимый текст, а не текст внутри кода, и что любая ссылка является гиперссылкой (<a href="
5. Прогони эти же две проверки по исходному коду.
6. Проверь те же элементы в коде, который видит Гугл, через
Если ничего не нашлось в обоих местах — эти секции, скорее всего, невозможно прокраулить или проиндексировать, и они не извлекаются из исходника.
Идентичный код на саб-урлах создает проблему дублей — это решить проще всего.
Самореферентные каноникалы на каждом саб-урле перенаправляются на первый урл.
Если структура еще в разработке, урлы с фрагментами (
Гугл не смотрит дальше
Рекомендации Гугла по бесконечному скроллу покрывают
Инсайты комьюнити
— Генерация урлов исключительно при скролле — это не изоляция. Гуглобот не наткнется на саб-урлы напрямую, но распарсенный
#Crawling #TechnicalSEO #JavaScript
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Лендинг, который перезаписывает собственный адрес при скролле посетителя —
abc.com/xyz превращается в abc.com/xyz-features, затем в abc.com/xyz-price, а каноникал и мета-теги по-прежнему указывают на основной урл — ломается сразу в двух местах, и каноникал тут меньшая из проблем.Гуглобот не висит на странице и не скроллит, поэтому эти саб-урлы никогда не генерируются при краулинге.
Триггерит ли изменение
history в адресной строке хоть что-то на стороне Гуглобота — не проверено.Доступность секций для краулинга важнее вопроса с каноникалом.
Весь контент всей страницы должен как минимум загружаться в исходный
DOM, а в идеале — лежать в исходном коде.Подмена урла при скролле — рабочий паттерн для контента, который подгружается в
DOM по мере прокрутки, но только если на каждый урл указывает доступная для краулера гиперссылка.Одной пагинации достаточно для обнаружения урлов, но для ссылочного веса это не работает.
Строка урла в отрендеренном
DOM не является ссылкой; я нахожу весь текст в исходном коде и отрендеренном html, хотя ссылки присутствуют только в виде диплинков, фиксирует Анкуш Махаджан.Код диплинка в таком формате — не гиперссылка.
Это указывает на то, что бОльшая часть страницы ведет себя как
SPA, где контент и ссылки могут рендериться только после взаимодействия юзера.Шесть проверок точно доказывают, что именно доступно для краулинга:
1. Проскролль страницу вниз до смены урла, затем возьми кусок видимого текста или ссылку из этой секции.
2. Вернись наверх и обнови страницу с очисткой кеша (hard reload).
3. Без взаимодействия со страницей проверь отрендеренный
HTML на наличие этого текста или урла — без доменного имени, на случай использования относительных ссылок.4. Убедись, что найденный текст — это именно видимый текст, а не текст внутри кода, и что любая ссылка является гиперссылкой (<a href="
url">).5. Прогони эти же две проверки по исходному коду.
6. Проверь те же элементы в коде, который видит Гугл, через
GSC, как второй срез данных.Если ничего не нашлось в обоих местах — эти секции, скорее всего, невозможно прокраулить или проиндексировать, и они не извлекаются из исходника.
Идентичный код на саб-урлах создает проблему дублей — это решить проще всего.
Самореферентные каноникалы на каждом саб-урле перенаправляются на первый урл.
Если структура еще в разработке, урлы с фрагментами (
abc.com/xyz#feature, abc.com/xyz#price) — лучшая сборка.Гугл не смотрит дальше
#, поэтому каждый вариант воспринимается как один и тот же урл.Рекомендации Гугла по бесконечному скроллу покрывают
search-friendly версию этого паттерна: https://developers.google.com/search/blog/2014/02/infinite-scroll-search-friendlyИнсайты комьюнити
— Генерация урлов исключительно при скролле — это не изоляция. Гуглобот не наткнется на саб-урлы напрямую, но распарсенный
JS, внешние бэклинки и собранные данные браузеров засвечивают их независимо. Поэтому их обнаружение нужно закладывать в стратегию, а не тупо игнорировать.#Crawling #TechnicalSEO #JavaScript
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤1
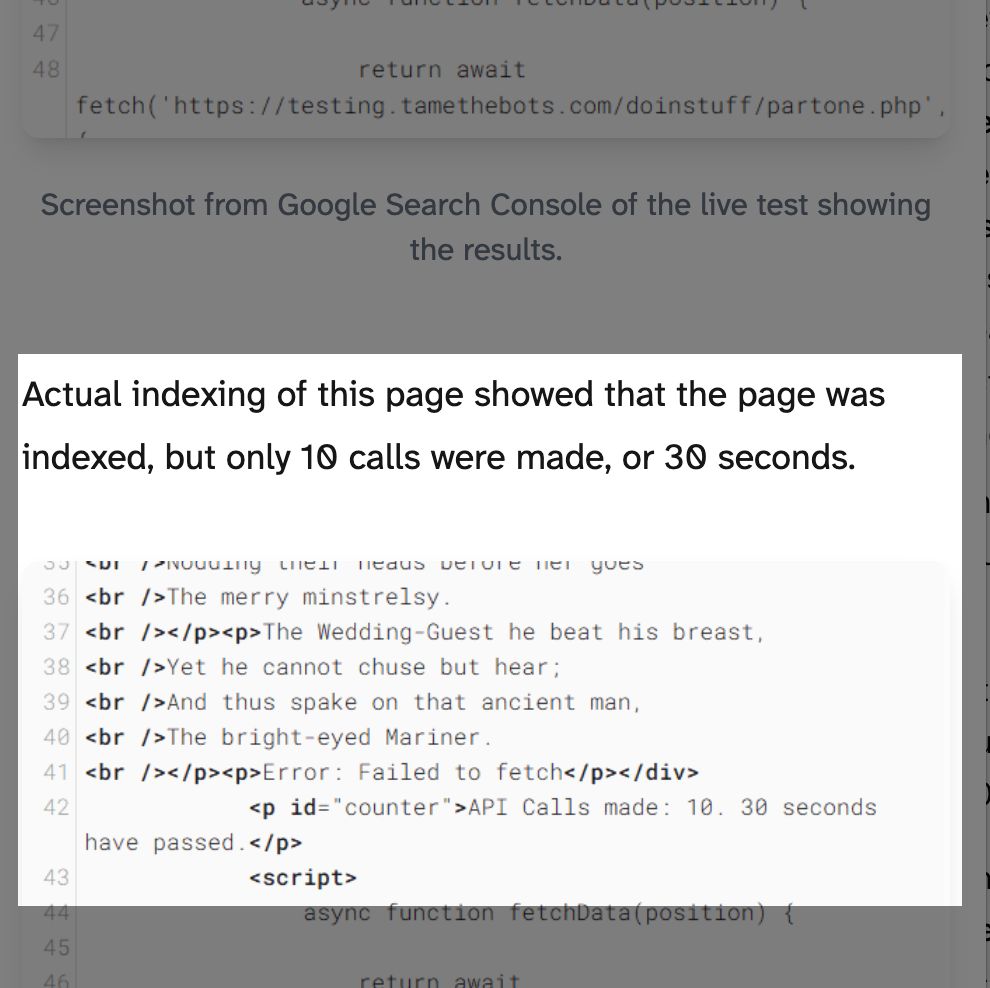
Этот тест показал, что правило «5 секунд на рендер» от Google — это миф. На самом деле он ждал рендера страницы больше 30 секунд!!!
Это был отличный кейс и тест от Дэйва Смарта.
В статье он подробно рассказывает, как обсуждал с клиентом миф о том, что Google ждет всего 5 секунд, чтобы отрендерить контент.
Из своего опыта он знал, что времени дается ГОРАЗДО больше.
В итоге он развернул контролируемый эксперимент на сайте
Он создал тестовую страницу, но со встроенными задержками.
Серверу приходилось ждать 3-6 секунд до ответа, а затем он делал это снова — то есть Google приходилось ждать от 6 до 12 секунд.
Он обнаружил, что Google всё равно смог отрендерить страницу.
По факту лимит, который он нашел в реальном индексе страниц, составил около 30 секунд.
Он увидел доказательства того, что в
Так что эксперимент максимально интересный.
Оказывается, Google готов ждать возврата
https://tamethebots.com/blog-n-bits/the-5-second-google-render-limit-myth
#Rendering #TechnicalSEO #JavaScript
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Это был отличный кейс и тест от Дэйва Смарта.
В статье он подробно рассказывает, как обсуждал с клиентом миф о том, что Google ждет всего 5 секунд, чтобы отрендерить контент.
Из своего опыта он знал, что времени дается ГОРАЗДО больше.
В итоге он развернул контролируемый эксперимент на сайте
TametheBots.Он создал тестовую страницу, но со встроенными задержками.
Серверу приходилось ждать 3-6 секунд до ответа, а затем он делал это снова — то есть Google приходилось ждать от 6 до 12 секунд.
Он обнаружил, что Google всё равно смог отрендерить страницу.
По факту лимит, который он нашел в реальном индексе страниц, составил около 30 секунд.
Он увидел доказательства того, что в
Search Console это время может быть еще больше.Так что эксперимент максимально интересный.
Оказывается, Google готов ждать возврата
JavaScript-контента довольно долго, делится Крис Лонг.https://tamethebots.com/blog-n-bits/the-5-second-google-render-limit-myth
#Rendering #TechnicalSEO #JavaScript
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
👍3
Разница между сырым и отрендеренным кодом вскрывает контент, который AI-краулеры скипают по умолчанию
Контент, который подгружается только после отработки
Двойной парсинг страницы — без
Отрендеренная версия обходится дорого, поэтому большинство
Джон Мюллер называет это сравнение хорошим прокси и отмечает, что
Тулзы, которые делают это без кастомного кода, вероятно, существуют.
Механика сбоя абсолютно конкретна.
В кейсе, переданном через вторые руки от сотрудника ИИ-платформы, клиент оказался единственным брендом, выпавшим из ответа ИИ, где перечислялись 10 брендов.
Без
Получив урл напрямую с инструкцией прочитать страницу целиком,
Данные по конфликтам рендеринга
— Анализ 500+ млн запросов
— Мюллер парирует со стороны логов: серверные логи показывают, что
Инсайты комьюнити
— Отрендеренный гуглоботом
— Если паттерн сырого
#AICrawlers #JavaScript #Rendering
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Контент, который подгружается только после отработки
JavaScript, может тихо выкинуть бренд из ответов ИИ.Двойной парсинг страницы — без
JS и с рендером — точно изолирует, какой именно это контент.Cloudflare Browser Rendering поддерживает оба режима: запрос без JS показывает примерно то же самое, что получают боты ChatGPT, Claude и Perplexity, а парсинг с JS близок к тому, что Гугл видит после рендера.Отрендеренная версия обходится дорого, поэтому большинство
AI-ботов её скипают.Джон Мюллер называет это сравнение хорошим прокси и отмечает, что
Cloudflare не обязателен: Puppeteer запускает Chrome для скрипта, перехватывает сетевые запросы, проверяет каждый на разрешение в robots.txt и блокирует при необходимости.Тулзы, которые делают это без кастомного кода, вероятно, существуют.
Механика сбоя абсолютно конкретна.
В кейсе, переданном через вторые руки от сотрудника ИИ-платформы, клиент оказался единственным брендом, выпавшим из ответа ИИ, где перечислялись 10 брендов.
Без
JavaScript названия не было в HTML, так как JS подтягивал его в таблицу, поэтому AI-боты по умолчанию получали таблицу лишь с 9 брендами.Получив урл напрямую с инструкцией прочитать страницу целиком,
ChatGPT выдал все 10: ChatGPT видит JS-контент только когда его форсируют, а не по умолчанию.Данные по конфликтам рендеринга
AI-краулеров по умолчанию:— Анализ 500+ млн запросов
GPTBot от Vercel зафиксировал нулевое выполнение JS. Тот же паттерн чистого сырого HTML актуален для ClaudeBot и PerplexityBot, что делает разницу между сырым и отрендеренным кодом рабочим прокси для всех трех: https://vercel.com/blog/the-rise-of-the-ai-crawler— Мюллер парирует со стороны логов: серверные логи показывают, что
OpenAI уже давно рендерит как минимум часть страниц, и каждая ИИ-система, юзающая современный поисковик для граундинга, также имеет доступ к отрендеренной версии.Инсайты комьюнити
— Отрендеренный гуглоботом
HTML не стоит считать прокси для всех ИИ-ботов: разные краулеры по-разному парсят и рендерят. По возможности сравнивай сырой HTML и отрендеренный DOM под юзер-агентом каждого конкретного AI-бота — GPTBot, ClaudeBot, PerplexityBot — а не предполагай, что все они работают как гуглобот.— Если паттерн сырого
HTML актуален для самостоятельных AI-ботов, то AI Overviews остается исключением: он наследует рендеринг гуглобота, поэтому отрендеренный на стороне клиента контент всё равно может туда попасть.#AICrawlers #JavaScript #Rendering
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤1
Контент в ваших
Вот как провести аудит
Разделы
Всё больше компаний добавляют
Этому есть несколько причин, но, по сути, это отличный способ интегрировать реальные вопросы клиентов и использовать крайне плотную структуру контента.
У Криса Грина было отличное исследование на эту тему.
Но оказывается, поисковые системы и
Джейсон Мелман недавно разбирал на командном митинге
Вот сам процесс:
1. Откройте страницу или шаблон с
2. Перейдите к разделу
3. В
4. Вставьте строку текста в раздел "
5. Теперь перезагрузите страницу
6. А теперь снова найдите эту строку текста, никуда не кликая
Если при втором поиске вы не видите, что фрагмент
Это проблема, так как поисковые системы и
Это означает, что текст невидим на странице.
На самом деле мы ОЧЕНЬ часто видим это во многих разделах
Так что, если вы это используете, однозначно стоит это проверить.
Видео тут.
Инсайты комьюнити
— Панель
— Полевой аудит на 40+ клиентских сайтах: 6 из 10 блоков
— Отделяйте вторую ошибку от загрузки только по клику: предложение уже находится в сыром
#TechnicalSEO #Rendering #JavaScript
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
FAQ может быть не виден для поисковых систем и LLM.Вот как провести аудит
FAQ с помощью Chrome DevTools:Разделы
FAQ сейчас на пике популярности в ИИ-поиске.Всё больше компаний добавляют
FAQ на свои ключевые лендинги и в редакционный контент.Этому есть несколько причин, но, по сути, это отличный способ интегрировать реальные вопросы клиентов и использовать крайне плотную структуру контента.
У Криса Грина было отличное исследование на эту тему.
Но оказывается, поисковые системы и
LLM не могут найти многие из них.Джейсон Мелман недавно разбирал на командном митинге
Nectiv, как это аудировать.Вот сам процесс:
1. Откройте страницу или шаблон с
FAQ в Google Chrome2. Перейдите к разделу
FAQ. Кликните на тот, который не открыт, и скопируйте текст3. В
Chrome кликните правой кнопкой мыши и выберите Inspect4. Вставьте строку текста в раздел "
Elements". Нажимайте Enter, пока не увидите, что строка с текстом FAQ подсвечена на странице5. Теперь перезагрузите страницу
6. А теперь снова найдите эту строку текста, никуда не кликая
Если при втором поиске вы не видите, что фрагмент
FAQ подсвечен на странице, это означает, что этот компонент загружается только по событию клика.Это проблема, так как поисковые системы и
LLM не будут выполнять это действие (по крайней мере, по умолчанию).Это означает, что текст невидим на странице.
На самом деле мы ОЧЕНЬ часто видим это во многих разделах
FAQ.Так что, если вы это используете, однозначно стоит это проверить.
Видео тут.
Инсайты комьюнити
— Панель
Elements показывает DOM после выполнения JavaScript, поэтому ответ в FAQ, внедренный при загрузке страницы, всё равно проходит тест с перезагрузкой, в то время как краулеры, пропускающие JavaScript, никогда его не увидят; проверяйте сырой исходный код через Ctrl+U (view-source), где отсутствие строки означает, что большинство ИИ-краулеров ее тоже упускают.— Полевой аудит на 40+ клиентских сайтах: 6 из 10 блоков
FAQ загружались по клику, поэтому текст отсутствовал в исходном DOM, тогда как микроразметка на этих страницах всё равно проходила валидацию, давая ложный зеленый свет. Отдавайте ответы на сервере и убедитесь, что строка появляется при перезагрузке.— Отделяйте вторую ошибку от загрузки только по клику: предложение уже находится в сыром
HTML внутри закрытого элемента details или скрыто с помощью CSS. Если оно отображается в view-source до любого клика, Google обычно может его получить; если же оно появляется только после клика, большинство ИИ-краулеров всё равно не будут разворачивать аккордеон.#TechnicalSEO #Rendering #JavaScript
@MikeBlazerX
🚀Схемы — в MikeBlazerPRO.com / @MikeBlazerPRO
❤2