Внутри Google "SearchGuard" (BotGuard v41)
Иск Google против
Доки подтверждают: Google больше не чекает просто репутацию
Система пашет внутри кастомной байт-код виртуалки (VM) с 512 регистрами, чтобы резистить декомпиляцию, мониторя 120+
Она трекает физику курсора (люди следуют кривым Безье с ускорением; боты двигаются линейными векторами), инерцию скролла и ритм нажатия клавиш.
Человек выдает дисперсию между вводами в 80-150 мс; бот палится на своей робо-стабильности (<10 мс).
Критически важно: Google не хранит эти данные — он считает энтропию в лайве.
Используя алгоритм Уэлфорда для дисперсии и
Если граф вашей активности Равномерный (Uniform) или Детерминированный, вы получаете флаг.
Если он следует Гауссовскому распределению, определенному естественным шумом, — вы проходите.
Результирующий токен "
Эксплойт: Синдикация Токенов
Согласно жалобе,
Они использовали Синдикацию Токенов.
Они генерили валидные токены на реальных или стелс-браузерах (где поведенческая биометрия была подлинной) и передавали эти зашифрованные токены на свои машины для скрапинга.
Обход опирается на отвязку генерации токена от выполнения запроса.
Чтобы парсить в масштабе 2026 года, вам не нужен более чистый код.
Вам нужен более качественный шум.
https://think.resoneo.com/botguard-google/
#Scraping #BotBlocking #Security
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
Иск Google против
SerpAPI недавно вскрыл их "черный ящик" анти-скрапинга: SearchGuard (внутри компании — BotGuard или WAA).Доки подтверждают: Google больше не чекает просто репутацию
IP или хедеры; они строят реал-тайм статистический профиль вашего физического "несовершенства".Система пашет внутри кастомной байт-код виртуалки (VM) с 512 регистрами, чтобы резистить декомпиляцию, мониторя 120+
DOM-элементов, чтобы отличить биологический хаос от алгоритмической точности.Она трекает физику курсора (люди следуют кривым Безье с ускорением; боты двигаются линейными векторами), инерцию скролла и ритм нажатия клавиш.
Человек выдает дисперсию между вводами в 80-150 мс; бот палится на своей робо-стабильности (<10 мс).
Критически важно: Google не хранит эти данные — он считает энтропию в лайве.
Используя алгоритм Уэлфорда для дисперсии и
Reservoir sampling для оценки медианы, система сортирует тайминг джиттера по распределениям.Если граф вашей активности Равномерный (Uniform) или Детерминированный, вы получаете флаг.
Если он следует Гауссовскому распределению, определенному естественным шумом, — вы проходите.
Результирующий токен "
proof of humanity" запечатывается шифром ARX с использованием сдвигающихся магических констант, делая статический реверс-инжиниринг устаревшим.Эксплойт: Синдикация Токенов
Согласно жалобе,
SerpAPI не обошли это написанием лучших ботов.Они использовали Синдикацию Токенов.
Они генерили валидные токены на реальных или стелс-браузерах (где поведенческая биометрия была подлинной) и передавали эти зашифрованные токены на свои машины для скрапинга.
Обход опирается на отвязку генерации токена от выполнения запроса.
Чтобы парсить в масштабе 2026 года, вам не нужен более чистый код.
Вам нужен более качественный шум.
https://think.resoneo.com/botguard-google/
#Scraping #BotBlocking #Security
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
👍4✍2
Медленный краулинг Screaming Frog снимает блокировки Cloudflare — подмена на Googlebot делает только хуже
Если
Здоровая статистика краулинга в
Снижение скорости краулинга в самом
Смена
Поэтому
Надёжное решение — вайтлист на стороне клиента: пусть добавят краулер в белые списки
Полностью скипай правила по
Для анализа логов прогоняй логи сервера через
И если твой краулер заблочен, это не значит, что заблочен
Пока логи и
Инсайты комьюнити
— Чтобы подтвердить, что причина именно в управлении ботами
— Обойти
#BotBlocking #Crawling #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Если
Screaming Frog отдаёт статус "too many requests" после первых ~50 URLs на мелком сайте (до 500 URL) на WordPress за Cloudflare (хостинг Cloudways) — это сработал лимит запросов, а не проблема SEO.Здоровая статистика краулинга в
GSC подтверждает: блокировка идёт от защиты от ботов на стороне клиента.Снижение скорости краулинга в самом
Screaming Frog до минимума реально снимает этот блок.Смена
User-Agent краулера на Googlebot делает блокировку жёстче, а не мягче.Cloudflare сверяет IP запроса с официальными пулами Googlebot, а не просто смотрит на строку UA.Поэтому
UA Googlebot с IP Screaming Frog читается как самозванец и отлетает в блок моментально.Надёжное решение — вайтлист на стороне клиента: пусть добавят краулер в белые списки
Cloudflare, связав IP и UA, потому что правила только по IP работают криво.Полностью скипай правила по
IP, если у машины для краулинга нет статического адреса — кастомный UA или bearer-токен держатся лучше при ротации адресов.Для анализа логов прогоняй логи сервера через
Log File Analyser в Screaming Frog — он вообще не касается Cloudflare.И если твой краулер заблочен, это не значит, что заблочен
Googlebot.Пока логи и
GSC не показывают проблем — это просто система управления ботами Cloudflare, а не ошибки сканирования сайта.Инсайты комьюнити
— Чтобы подтвердить, что причина именно в управлении ботами
Cloudflare, настрой Screaming Frog на сбор заголовков ответа и ищи там заголовок bot score — его наличие показывает, что скоринг ботов Cloudflare активен, хотя это фича enterprise-уровня.— Обойти
Cloudflare на объёме через curl-cffi или obscura больше не работает. Чтобы парсить сайты под защитой CF, которые активно блочат, теперь нужно управлять реальным профилем браузера. Screaming Frog не заточен под обход сайтов, которые не хотят, чтобы их парсили, поэтому меняй инструмент, если добавить в вайтлист не вариант.#BotBlocking #Crawling #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

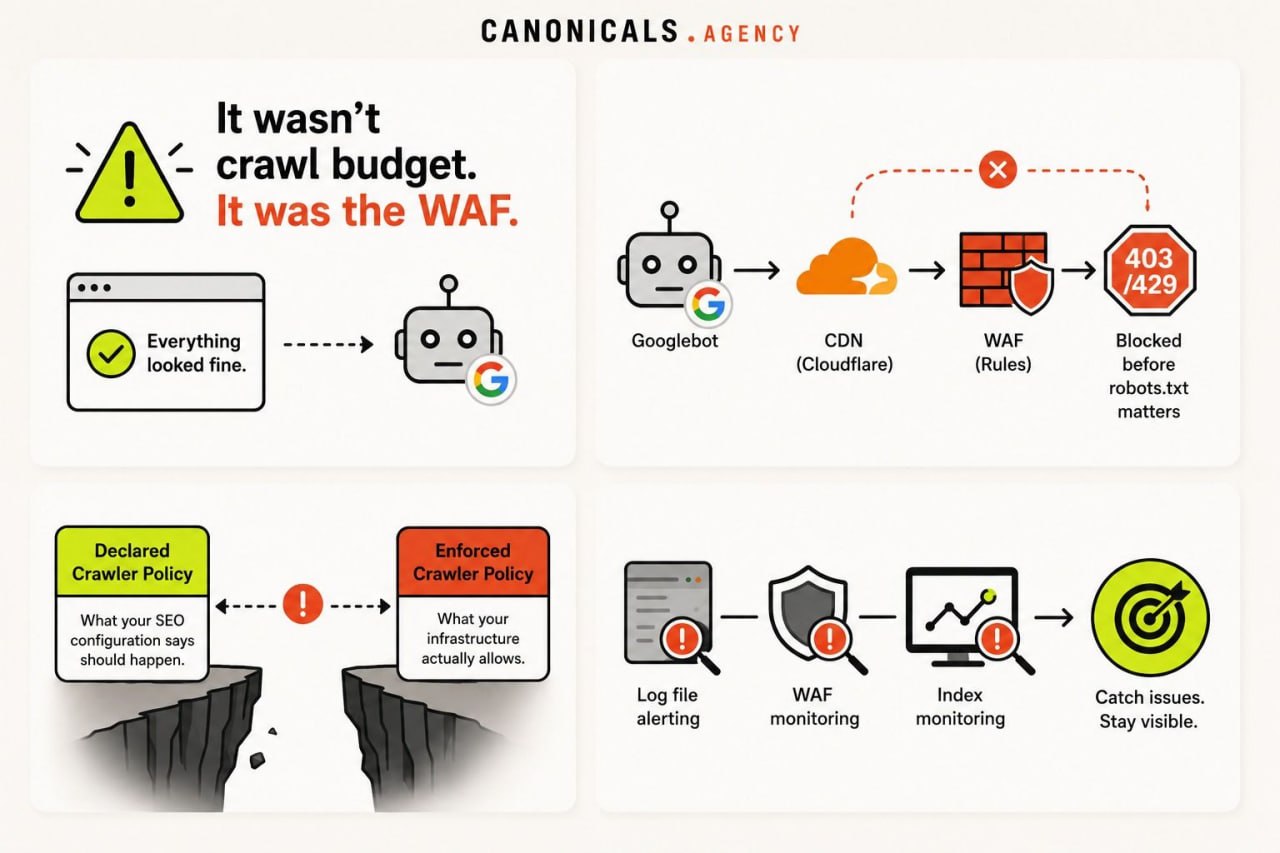
Недавно мы столкнулись с
Это была не она.
Инженеры одного ритейлера закрутили гайки в правилах
С точки зрения SEO всё выглядело нормально:
—
— сайтмапы были валидны
— страницы были открыты для индексации
—
— в
Но затем новые страницы товаров стали дольше появляться в Google.
В
На первый взгляд это выглядело как проблема краулингового бюджета или индексации.
Это была не она.
Поэтому, пока заявленная политика гласила:
фактическая политика выглядела так:
Вот важное различие:
Заявленная политика краулера = то, что должно происходить согласно вашей
Фактическая политика краулера = то, что реально пропускает ваша инфраструктура.
И если вы не мониторите индексацию, доступность для краулеров и логи сервера, подобные проблемы могут висеть в слепой зоне неделями.
Симптомы проявляются в SEO.
Корень проблемы может лежать совершенно в другом месте.
Если бы у вас стояли алерты по логам, вы бы это поймали.
Если бы стоял мониторинг
Если бы стоял мониторинг индекса, вы бы это поймали.
Большинство компаний этого не делают.
Инсайты комьюнити
— Правила
—
#BotBlocking #Crawling #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
SEO-проблемой, которую команда клиента приняла за проблему с краулинговым бюджетом, пишет Джон Феган.Это была не она.
Инженеры одного ритейлера закрутили гайки в правилах
Cloudflare/WAF после всплеска парсинга.С точки зрения SEO всё выглядело нормально:
—
robots.txt разрешал доступ Googlebot— сайтмапы были валидны
— страницы были открыты для индексации
—
Chrome отдавал статус 200— в
CMS ничего не менялосьНо затем новые страницы товаров стали дольше появляться в Google.
В
GSC стало больше URL со статусом "Обнаружено, не проиндексировано", активность сканирования стала хаотичной, а некоторые URL из сайтмапов перестали переобкачиваться.На первый взгляд это выглядело как проблема краулингового бюджета или индексации.
Это была не она.
WAF периодически отдавал краулерам 403 и 429 ответы — в том числе верифицированному Googlebot.Поэтому, пока заявленная политика гласила:
robots.txt → Googlebot разрешенфактическая политика выглядела так:
Googlebot → CDN → WAF → 403/429Googlebot блокировался еще до того, как robots.txt имел хоть какое-то значение.Вот важное различие:
Заявленная политика краулера = то, что должно происходить согласно вашей
SEO-настройке.Фактическая политика краулера = то, что реально пропускает ваша инфраструктура.
И если вы не мониторите индексацию, доступность для краулеров и логи сервера, подобные проблемы могут висеть в слепой зоне неделями.
Симптомы проявляются в SEO.
Корень проблемы может лежать совершенно в другом месте.
Если бы у вас стояли алерты по логам, вы бы это поймали.
Если бы стоял мониторинг
WAF, вы бы это поймали.Если бы стоял мониторинг индекса, вы бы это поймали.
Большинство компаний этого не делают.
Инсайты комьюнити
— Правила
WAF могут триггериться на паттерны хедеров или диапазоны IP, специфичные для юзер-агента Googlebot, даже когда остальной трафик проходит чисто. Если лимиты запросов привязаны к CIDR-блоку, а не к индивидуальным IP верифицированного краулера, легитимные запросы Googlebot сливаются в общую корзину — WAF видит перегруз от "сети" и выдает случайные 429, хотя каждый отдельный запрос абсолютно чист.—
CDN, отдающий страницу с капчей любому запросу без нормального отпечатка браузера, может втихую блочить краулеров, пока сайт визуально работает для любого живого юзера — в Search Console этот сбой выглядит как медленная капель софт 404, которую легко упустить, так как внутри ничего не сломано. Проблема вскрывается только при парсинге под видом Googlebot извне корпоративной сети.#BotBlocking #Crawling #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤2
Мучаетесь с краулингом сайтов на Cloudflare из-за 403 статуса и блокировки ботов?
Просто откройте любую страницу нужного сайта.
Откройте
Обновите страницу.
Перейдите в
В
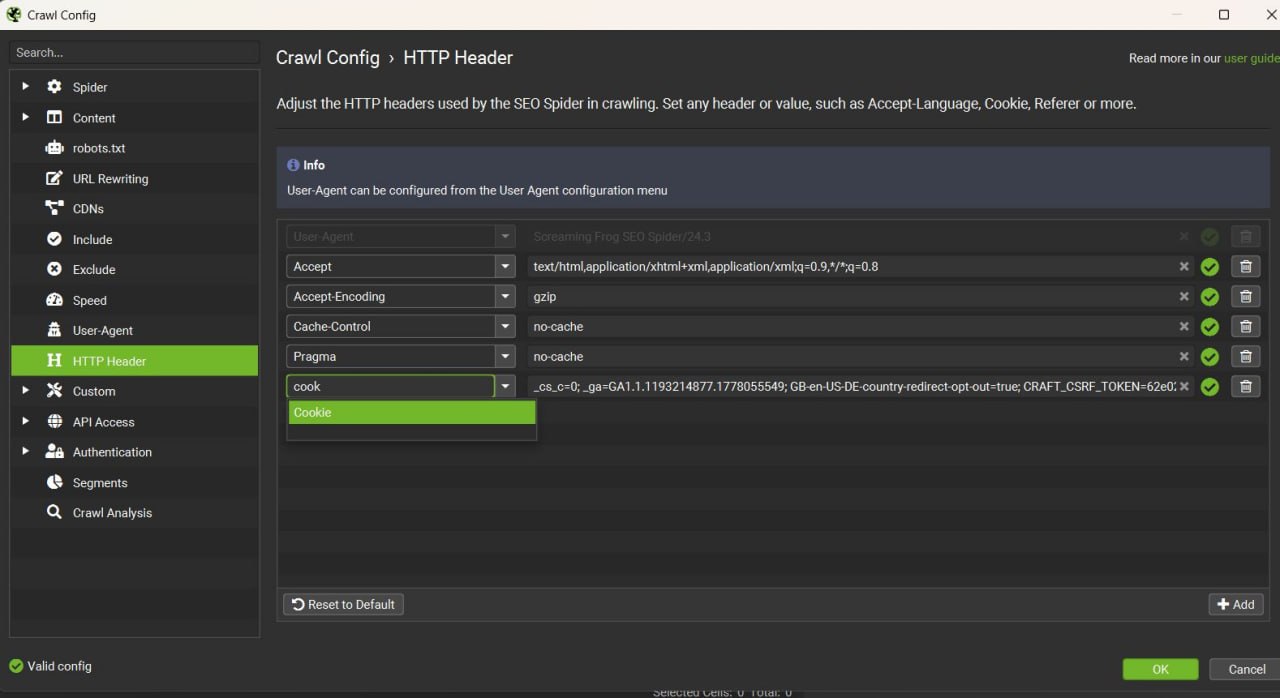
Поздравляю, теперь в большинстве случаев вы получите статусы 200 и больше никаких 403, рассказывает Абдерразак Руаг.
#BotBlocking #Crawling #ScreamingFrog
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Просто откройте любую страницу нужного сайта.
Откройте
Chrome DevTools.Обновите страницу.
Перейдите в
Network > Doc > основной HTML > Cookie и скопируйте их.В
Screaming Frog перейдите в Crawl config > HTTP Header > нажмите Add > добавьте Cookie и вставьте их туда.Поздравляю, теперь в большинстве случаев вы получите статусы 200 и больше никаких 403, рассказывает Абдерразак Руаг.
#BotBlocking #Crawling #ScreamingFrog
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
👍7👀2
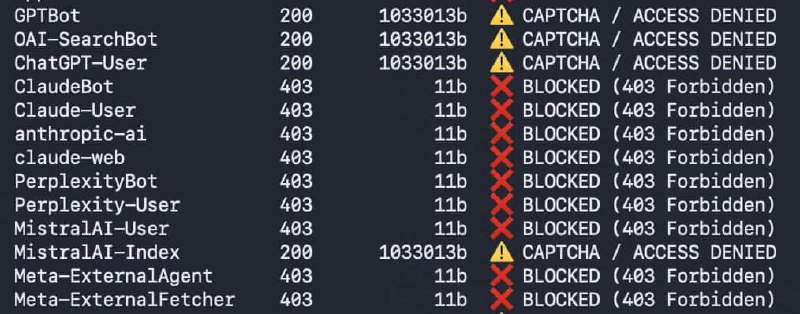
Настройки сервера и CDN отсекают ИИ-краулеров там, где SEO-софт показывает код 200
Соблюдение
А вот блокировки на уровне сервера,
Стандартный
Временное окно закрывается.
С 15 сентября 2026 года
Это же обновление меняет то, как блокировки ИИ-тренировок (включая старую настройку "
Опенсорсный
Сначала он запрашивает урл со стандартной строкой
Статус-кода самого по себе недостаточно —
Любой
Одной локации тоже мало, потому что один и тот же бот получает разные ответы в зависимости от входящего
Прогони тест дважды: с локальной машины на резидентном
Затем сравнивай результаты:
— Блокировка в обеих средах при доступной базе: конкретное правило против бота, разбирайся с ним в первую очередь.
— Блокировка только в одной среде: проблема на уровне сети, например, фильтрация датацентровых
— Идентичный успешный ответ везде: нет признаков того, что к этому
Заблокированный бот — это не всегда проблема.
Если сайт отшивает
Блокировка становится критичной, когда она срезает краулеров класса
Скрипт не может на 100% сымитировать запрос от реального краулера.
Воспринимай любой флаг как сигнал, а не как железобетонное доказательство: подтверждай данные в конфигурации CDN/сервера или логах, прежде чем нести их инфра-команде.
https://athenseo.com/knowledge-hub/how-to-check-if-ai-crawlers-can-actually-reach-your-site/
#AICrawlers #BotBlocking #TechnicalSEO
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Соблюдение
robots.txt — дело добровольное.А вот блокировки на уровне сервера,
CDN или фаервола обойти нельзя: запрос жестко отклоняется, и у краулера нет выбора.Стандартный
SEO-софт не выводит эту разницу: при краулинге урл может отдавать 200, тогда как ИИ-краулер получает 403, страницу-заглушку или вообще другой ответ.Временное окно закрывается.
С 15 сентября 2026 года
Cloudflare применяет новые дефолтные правила для свежих доменов: боты, классифицированные как Training или Agent, блокируются на страницах с рекламой, в то время как ботам класса Search доступ открыт.Это же обновление меняет то, как блокировки ИИ-тренировок (включая старую настройку "
Block AI bots") обрабатывают гибридных краулеров Search + Training.Опенсорсный
bash-скрипт bot-block-checker вскрывает эту слепоту без доступа к логам.Сначала он запрашивает урл со стандартной строкой
User-Agent от Chrome, чтобы зафиксировать базу, а затем отправляет тот же запрос, подставляя более 30 строк User-Agent различных ботов и краулеров.Статус-кода самого по себе недостаточно —
200 может оказаться страницей-заглушкой, — поэтому скрипт также сравнивает размер тела ответа и ищет известные паттерны блокировок относительно базового запроса.Любой
429 перепроверяется изолированно, чтобы отделить реальную блокировку от ложноположительного срабатывания из-за слишком частых запросов.Одной локации тоже мало, потому что один и тот же бот получает разные ответы в зависимости от входящего
IP.Прогони тест дважды: с локальной машины на резидентном
IP и через Google Cloud Shell на датацентровом IP.Затем сравнивай результаты:
— Блокировка в обеих средах при доступной базе: конкретное правило против бота, разбирайся с ним в первую очередь.
— Блокировка только в одной среде: проблема на уровне сети, например, фильтрация датацентровых
IP или гео-ограничения; само по себе это ничего не доказывает.— Идентичный успешный ответ везде: нет признаков того, что к этому
User-Agent относятся иначе.Заблокированный бот — это не всегда проблема.
Если сайт отшивает
Bytespider, это не бьет по SEO или AEO.Блокировка становится критичной, когда она срезает краулеров класса
Search или Agent, которые должны находить, извлекать или цитировать контент.Скрипт не может на 100% сымитировать запрос от реального краулера.
Воспринимай любой флаг как сигнал, а не как железобетонное доказательство: подтверждай данные в конфигурации CDN/сервера или логах, прежде чем нести их инфра-команде.
https://athenseo.com/knowledge-hub/how-to-check-if-ai-crawlers-can-actually-reach-your-site/
#AICrawlers #BotBlocking #TechnicalSEO
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Это исследование показало, что блокировка "
https://arxiv.org/pdf/2604.27790
#BotBlocking #AIOverviews #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Google-Extended Bot" может привести к меньшему числу цитаций в AIO, вопреки заявлениям Google.https://arxiv.org/pdf/2604.27790
#BotBlocking #AIOverviews #GoogleBot
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
🔥1