Незамаскированные UTM-метки сливают всю рекламную стратегию конкурентов
Огромная ошибка многих маркетологов — оставлять свои
Библиотека рекламы показывает только креативы конкурента, но никогда не раскроет аудиторию, на которую они таргетируются.
Незамаскированные
Процесс — это чистый сбор разведданных.
Когда видите рекламу конкурента, кликните по ней и скопируйте полный
Вставьте эту строку прямо в
Поскольку они не маскируют параметры,
Теперь у вас есть их стратегия для верха воронки, их креативы и их лендинг — три компонента, необходимых для копирования.
Мы использовали именно эту методику, чтобы выходить на новые рынки и сокращать фазу обучения с месяцев до дней.
Совместив извлечение
Люди думают, что это магия.
В реальности мы просто довольно хитрые.
Чтобы защититься от этого, вы должны маскировать свои собственные
В рекламных платформах вроде
По умолчанию большинство платформ подтягивает человекочитаемое название, что и является источником утечки.
Переключение на неописательный
#CompetitorAnalysis #GreyHatSEO #SEM
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
Огромная ошибка многих маркетологов — оставлять свои
UTM-теги незамаскированными, что создает massive утечку данных, которую можно напрямую использовать для реверс-инжиниринга всей их платной воронки, раскрывает Рик Чебрика.Библиотека рекламы показывает только креативы конкурента, но никогда не раскроет аудиторию, на которую они таргетируются.
Незамаскированные
UTM-метки полностью обходят это ограничение.Процесс — это чистый сбор разведданных.
Когда видите рекламу конкурента, кликните по ней и скопируйте полный
URL назначения.Вставьте эту строку прямо в
LLM типа ChatGPT с промптом: "сделай реверс-инжиниринг воронки на основе UTM-меток в этом URL".Поскольку они не маскируют параметры,
UTM-метки часто раскрывают всё: платформу, адсет и даже конкретный таргетинг на аудиторию, например, "1% lookalike audience".Теперь у вас есть их стратегия для верха воронки, их креативы и их лендинг — три компонента, необходимых для копирования.
Мы использовали именно эту методику, чтобы выходить на новые рынки и сокращать фазу обучения с месяцев до дней.
Совместив извлечение
UTM с анализом долгоиграющей рекламы в библиотеке платформы, мы создали базовую кампанию, которая принесла более чем 10-кратный `ROI` в течение трех месяцев.Люди думают, что это магия.
В реальности мы просто довольно хитрые.
Чтобы защититься от этого, вы должны маскировать свои собственные
UTM-метки.В рекламных платформах вроде
Meta и TikTok настройте свои кастомные UTM-теги так, чтобы они ссылались на цифровой Campaign ID, а не на описательный Campaign Name.По умолчанию большинство платформ подтягивает человекочитаемое название, что и является источником утечки.
Переключение на неописательный
ID не позволит конкурентам использовать ваши же данные против вас.#CompetitorAnalysis #GreyHatSEO #SEM
@MikeBlazerX
Но самое "мясо" — в @MikeBlazerPRO
👍2👌2❤1✍1
Атака на брендинг конкурентов через нишевые субкультуры: кейс из adult-индустрии
Работая против конкурента в индустрии подгузников для взрослых, я воочию увидел, как контртрендовая стратегия полностью развалила визуальные и брендовые сигналы рынка, вспоминает Дерек Хобсон.
Вся вертикаль была морем однотипности: каждый конкурент использовал одинаковые, унылые изображения полуголых пожилых людей с "тихими и благосклонными улыбками".
Основная проблема индустрии заключалась в том, что никто не хочет нуждаться в этом продукте, поэтому стандартной тактикой была скрытная упаковка и месседжи, которые пытались спрятать реальность.
Один конкурент провернул гениальный финт.
Вместо того чтобы целиться в основную демографию, они ударили по маленькой, но увлеченной субкультуре: фетишистам подгузников для взрослых.
Это одно стратегическое решение позволило им полностью перевернуть брендинг индустрии.
Их визуалы внезапно наполнились 20-25-летними людьми с широкими, яркими улыбками, создавая живую, энергичную эстетику, которая отличалась как небо и земля от всех остальных.
Они даже создали специальный раздел на своем сайте для поддержки этого комьюнити с особыми продуктами.
Результатом стал полный разрыв
Это радикальное отличие в визуальном контенте и позиционировании бренда напрямую способствовало тому, что они обошли по позициям подавляющее большинство конкурентов, включая нас.
Это был мастер-класс по определению смежной, "анти-аудитории" для генерации уникальных ассетов, которым алгоритм просто не мог не отдать предпочтение перед однородным, унылым контентом, который предлагал остальной рынок.
Хотя стратегическое влияние было очевидным, конкретный технический
#Strategy #CompetitorAnalysis #ContentStrategy
@MikeBlazerX
Пушки — в @MikeBlazerPRO
Работая против конкурента в индустрии подгузников для взрослых, я воочию увидел, как контртрендовая стратегия полностью развалила визуальные и брендовые сигналы рынка, вспоминает Дерек Хобсон.
Вся вертикаль была морем однотипности: каждый конкурент использовал одинаковые, унылые изображения полуголых пожилых людей с "тихими и благосклонными улыбками".
Основная проблема индустрии заключалась в том, что никто не хочет нуждаться в этом продукте, поэтому стандартной тактикой была скрытная упаковка и месседжи, которые пытались спрятать реальность.
Один конкурент провернул гениальный финт.
Вместо того чтобы целиться в основную демографию, они ударили по маленькой, но увлеченной субкультуре: фетишистам подгузников для взрослых.
Это одно стратегическое решение позволило им полностью перевернуть брендинг индустрии.
Их визуалы внезапно наполнились 20-25-летними людьми с широкими, яркими улыбками, создавая живую, энергичную эстетику, которая отличалась как небо и земля от всех остальных.
Они даже создали специальный раздел на своем сайте для поддержки этого комьюнити с особыми продуктами.
Результатом стал полный разрыв
SERP-ов.Это радикальное отличие в визуальном контенте и позиционировании бренда напрямую способствовало тому, что они обошли по позициям подавляющее большинство конкурентов, включая нас.
Это был мастер-класс по определению смежной, "анти-аудитории" для генерации уникальных ассетов, которым алгоритм просто не мог не отдать предпочтение перед однородным, унылым контентом, который предлагал остальной рынок.
Хотя стратегическое влияние было очевидным, конкретный технический
SEO-метод, как именно эти ассеты трансформировались в позиции, раскрыт не был.#Strategy #CompetitorAnalysis #ContentStrategy
@MikeBlazerX
Пушки — в @MikeBlazerPRO
👍6🤔5🌚1👀1
Я нахожу мертвый контент конкурентов и воскрешаю его на сайте клиента, говорит Брэндон Лонго.
Вот как я нахожу возможности на $500K+:
Процесс "Некромантии":
1. Нахожу `404`е страницы конкурентов, которые все еще ранжируются.
2. Чекаю `Wayback Machine` на предмет их удаленного контента.
3. Анализирую, что убило их позиции (обычно техничка).
4. Плю свои улучшенные версии на домене клиента.
Золотая жила: Экспайреды с крутыми контентными активами.
Свежая находка:
Конкурент снес "
Мой ход: Пересобрал гайд (в 10 раз лучше).
Добавил актуальные товарные рекомендации.
Забрал их старые позиции за 45 дней.
Жестокая правда: Провалы вашего конкурента — это ваши возможности.
Мне плевать, если конкуренты забили на свой контент.
Я это забираю.
#CompetitorAnalysis #ContentStrategy #ExpiredDomains
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
Вот как я нахожу возможности на $500K+:
Процесс "Некромантии":
1. Нахожу `404`е страницы конкурентов, которые все еще ранжируются.
2. Чекаю `Wayback Machine` на предмет их удаленного контента.
3. Анализирую, что убило их позиции (обычно техничка).
4. Плю свои улучшенные версии на домене клиента.
Золотая жила: Экспайреды с крутыми контентными активами.
Свежая находка:
Конкурент снес "
Complete Skincare Guide", который сидел в Топ-3.Мой ход: Пересобрал гайд (в 10 раз лучше).
Добавил актуальные товарные рекомендации.
Забрал их старые позиции за 45 дней.
Жестокая правда: Провалы вашего конкурента — это ваши возможности.
Мне плевать, если конкуренты забили на свой контент.
Я это забираю.
#CompetitorAnalysis #ContentStrategy #ExpiredDomains
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
🤣17🌚5❤2
Системное уничтожение легаси-авторитета
Мы столкнулись с 8-летним гигантом (DR 72, 85K трафика), который держал позиции 1-3 по нашим целевым ключам, объясняет Ноэль Сета.
Мы были претендентом: 2-летний сайт (DR 48, 8K трафика), застрявший на 8-й строчке.
За 14 месяцев и с инвестициями $180K мы систематически разрушили их доминирование, забрав 12 из их топ-15 позиций и разогнав наш трафик до
Аудит и пивот контента
Мой 40-часовой детальный аудит с
Их контент был устаревшим (эпохи 2019 года), тонким (менее 1200 слов) и полным битых элементов.
Мы ответили экстремальной пользой, а не просто объемом.
Там, где у них было 2000 слов, мы выкатывали ассеты на 3500 слов, обогащенные оригинальными опросами 300 юзеров, кастомными интерактивными калькуляторами, скачиваемыми шаблонами и 15-минутными видео-разборами.
Мы не просто обновляли даты; мы заменили их протухшие примеры актуальными данными рынка.
Техничка и компаундинг авторитета
Мы усилили это контентное преимущество жесткой техничкой.
Пока их "базовый адаптивный" сайт грузился 3.8 секунды с провальными
По
Проанализировав их 340 бэклинков, мы выявили самые ценные векторы: отраслевые издания и каталоги инструментов.
Мы провели прецизионную кампанию, чтобы получить 103 ссылки именно с этих источников.
Нам не нужно было матчить их 340 ссылок; нам нужно было сматчить те 120, которые реально имели вес.
Таймлайн захвата
Сдвиг рынка шел по строгому операционному ритму:
— Месяцы 1-3 (Фундамент): Опубликовали 5 статей. Позиции висели в диапазоне #6-10.
— Месяцы 4-6 (Велосити): Выкатили еще 10 статей и добыли 35 ссылок. Три ключа пробились в топ-5.
— Месяцы 7-14 (Доминирование): Мы взяли наш первый топ-1, сфокусировавшись на ежеквартальном обновлении контента для эксплуатации сигналов свежести (freshness).
К финалу конкурент потерял примерно
#CompetitorAnalysis #ContentStrategy #LinkBuilding
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
Мы столкнулись с 8-летним гигантом (DR 72, 85K трафика), который держал позиции 1-3 по нашим целевым ключам, объясняет Ноэль Сета.
Мы были претендентом: 2-летний сайт (DR 48, 8K трафика), застрявший на 8-й строчке.
За 14 месяцев и с инвестициями $180K мы систематически разрушили их доминирование, забрав 12 из их топ-15 позиций и разогнав наш трафик до
67K сессий в месяц.Аудит и пивот контента
Мой 40-часовой детальный аудит с
Ahrefs, Semrush и Screaming Frog показал, что конкурент выезжал на старом авторитете.Их контент был устаревшим (эпохи 2019 года), тонким (менее 1200 слов) и полным битых элементов.
Мы ответили экстремальной пользой, а не просто объемом.
Там, где у них было 2000 слов, мы выкатывали ассеты на 3500 слов, обогащенные оригинальными опросами 300 юзеров, кастомными интерактивными калькуляторами, скачиваемыми шаблонами и 15-минутными видео-разборами.
Мы не просто обновляли даты; мы заменили их протухшие примеры актуальными данными рынка.
Техничка и компаундинг авторитета
Мы усилили это контентное преимущество жесткой техничкой.
Пока их "базовый адаптивный" сайт грузился 3.8 секунды с провальными
Core Web Vitals, наша mobile-first инфраструктура летала за 1.6 секунды — в 2.4 раза быстрее.По
off-page сигналам мы забили на валовый объем и сфокусировались на точечной релевантности.Проанализировав их 340 бэклинков, мы выявили самые ценные векторы: отраслевые издания и каталоги инструментов.
Мы провели прецизионную кампанию, чтобы получить 103 ссылки именно с этих источников.
Нам не нужно было матчить их 340 ссылок; нам нужно было сматчить те 120, которые реально имели вес.
Таймлайн захвата
Сдвиг рынка шел по строгому операционному ритму:
— Месяцы 1-3 (Фундамент): Опубликовали 5 статей. Позиции висели в диапазоне #6-10.
— Месяцы 4-6 (Велосити): Выкатили еще 10 статей и добыли 35 ссылок. Три ключа пробились в топ-5.
— Месяцы 7-14 (Доминирование): Мы взяли наш первый топ-1, сфокусировавшись на ежеквартальном обновлении контента для эксплуатации сигналов свежести (freshness).
К финалу конкурент потерял примерно
35K сессий, скатившись на позиции 4-8, пока мы забирали топы.#CompetitorAnalysis #ContentStrategy #LinkBuilding
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
😍8👍6😁4❤2🤣1
Я прочекал 275
Сюрприз: 176 (64%) показали рост по визитам.
Я всегда стараюсь учиться у сайтов, которые перформят в Google, поэтому провел этот ресеч, чтобы найти больше контентных историй успеха.
Приятно видеть, что многие растут, но есть нюанс.
Некоторые блоги из сегментов с низким трафиком выросли либо потому что они новые, либо за счет редиректов (смена URL блога, поглощения и т.д.).
Редиректы были и у тех, кто потерял трафик, но определенно проще расти, когда ты до этого перформил так себе.
Анализ не идеален и основан на эстимейтах.
Цифры: победители в среднем получили +15,252 визита, а "лузеры" слили в среднем -69,270.
Более половины блогов, которые раньше получали
Несколько блогов выросли более чем на 200,000 ежемесячных визитов.
Парочка слила 1М+.
Можно анализировать еще кучу всего (частоту постинга, какие статьи дали буст), но даже этот овервью интересен.
Юзаете вы
Найдите тех, кто серьезно вырос в 2025.
А дальше копайте вглубь: какие ссылки они получили, какие страницы у них топ-перформеры и так далее.
Благодаря этому ресечу я спалил, что один сайт в интересной мне нише купил (и заредиректил) куда больше сайтов, чем я знал.
#CompetitorAnalysis #SaaS #ContentStrategy
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO
SaaS-блогов, чтобы посмотреть, как у них дела с поисковым трафиком в 2025 году, пишет Глен Оллсоп.Сюрприз: 176 (64%) показали рост по визитам.
Я всегда стараюсь учиться у сайтов, которые перформят в Google, поэтому провел этот ресеч, чтобы найти больше контентных историй успеха.
Приятно видеть, что многие растут, но есть нюанс.
Некоторые блоги из сегментов с низким трафиком выросли либо потому что они новые, либо за счет редиректов (смена URL блога, поглощения и т.д.).
Редиректы были и у тех, кто потерял трафик, но определенно проще расти, когда ты до этого перформил так себе.
Анализ не идеален и основан на эстимейтах.
Цифры: победители в среднем получили +15,252 визита, а "лузеры" слили в среднем -69,270.
Более половины блогов, которые раньше получали
25K-50K визитов из поиска, показали рост за год.Несколько блогов выросли более чем на 200,000 ежемесячных визитов.
Парочка слила 1М+.
Можно анализировать еще кучу всего (частоту постинга, какие статьи дали буст), но даже этот овервью интересен.
Юзаете вы
Ahrefs или нет, рекомендую провести такой же анализ в своей индустрии.Найдите тех, кто серьезно вырос в 2025.
А дальше копайте вглубь: какие ссылки они получили, какие страницы у них топ-перформеры и так далее.
Благодаря этому ресечу я спалил, что один сайт в интересной мне нише купил (и заредиректил) куда больше сайтов, чем я знал.
#CompetitorAnalysis #SaaS #ContentStrategy
@MikeBlazerX
Закрытый канал: @MikeBlazerPRO

❤3
Я только что выкатил новую бесплатную тулзу и
Без регистраций.
Без
Просто ищешь и тянешь данные, пишет Бен Уиллс.
Тулза использует данные из
НО самая полезная фича — она нормализует показатели
Если ты когда-то ковырял сырые данные
(например: 0.00029235203)
Шкала 0-100 делает
Заюзай для:
— Анализа конкурентов
— Оценки доноров под ссылки
— Исторических сигналов траста для твоих собственных тулз
— Рисерча для продаж
— Замены хост-данных из
Единственные лимиты:
— 100 хостов/доменов в день на
— До 10 хостов/доменов за один запрос.
— Данные по хостам стартуют с 2020. По доменам — с 2017.
Если тебе нужна сама база, она продается как 1.2-терабайтный сет
https://customdatasets.com/webgraph/search/
#PageRank #Tools #CompetitorAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
API для проверки исторического PageRank (и не только) по доменам и хостам, пишет Бен Уиллс.Без регистраций.
Без
API-ключей.Просто ищешь и тянешь данные, пишет Бен Уиллс.
Тулза использует данные из
Common Crawl Web Graph и агрегирует для тебя все метрики.НО самая полезная фича — она нормализует показатели
PageRank и Harmonic Centrality до шкалы 0-100.Если ты когда-то ковырял сырые данные
Common Crawl Web Graph, то знаешь, что большинство сырых значений абсолютно бесполезны.(например: 0.00029235203)
Шкала 0-100 делает
PageRank и Harmonic Centrality мгновенно применимыми и понятными.Заюзай для:
— Анализа конкурентов
— Оценки доноров под ссылки
— Исторических сигналов траста для твоих собственных тулз
— Рисерча для продаж
— Замены хост-данных из
Moz/Ahrefs/MajesticЕдинственные лимиты:
— 100 хостов/доменов в день на
IP.— До 10 хостов/доменов за один запрос.
— Данные по хостам стартуют с 2020. По доменам — с 2017.
Если тебе нужна сама база, она продается как 1.2-терабайтный сет
SQLite-баз, с которыми очень легко работать.https://customdatasets.com/webgraph/search/
#PageRank #Tools #CompetitorAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

❤3
Сырые данные Ahrefs Firehose сливают ИИ-агентам стратегии конкурентов в реальном времени
Чтобы вытаскивать апдейты конкурентов без ручных дашбордов, настрой
Это обходит старое требование в 2 миллиона кредитов для энтерпрайза.
Firehose работает как
Вместо кликов по
ИИ автоматически подключается к
Агент применяет кастомные
Он четко отделяет стратегические развороты контента от мусорных апдейтов кода.
Система обходит человеческую усталость от рутины.
Она в реальном времени сопоставляет массивные объемы правок на сайтах конкурентов и выдает структурированную аналитику.
#API #Automation #CompetitorAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Чтобы вытаскивать апдейты конкурентов без ручных дашбордов, настрой
API Ahrefs Firehose напрямую в LLM-агента, советует Гаэль Бретон.Ahrefs снес старые пейволлы и выдал 25,000 кредитов в месяц на стандартных тарифах.Это обходит старое требование в 2 миллиона кредитов для энтерпрайза.
Firehose работает как
API-поток и логирует сырые изменения страниц в интернете.Вместо кликов по
SaaS-интерфейсу операторы скармливают документацию эндпоинта напрямую в Claude Code или кастомный скрипт.ИИ автоматически подключается к
API и процессит сырой фид.Агент применяет кастомные
.md инструкции и парсит логи изменений.Он четко отделяет стратегические развороты контента от мусорных апдейтов кода.
Система обходит человеческую усталость от рутины.
Она в реальном времени сопоставляет массивные объемы правок на сайтах конкурентов и выдает структурированную аналитику.
#API #Automation #CompetitorAnalysis
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
😁5
Регулярные выражения в операторах поиска раскрывают скрытые домены конкурентов
Спустя 10 лет в SEO я обнаружил дыру: регулярки работают в поисковых операторах Гугла.
Эта фича не задокументирована.
Регулярки выходят за рамки базового синтаксиса
Ты можешь прописать паттерны вроде
Это раскрывает тестовые инфраструктуры конкурентов.
Ограничение: работают не все паттерны регулярок, а совпадение выдает только те страницы, где первый результат поиска бьется с одной частью твоего паттерна (а не ищет каждое совпадение регулярки в документе).
Техника также работает внутри
Инсайты SEO-комьюнити
— Регулярки в операторах имеют задокументированные лимиты: не все паттерны срабатывают, выдача отдает лишь те страницы, где первый результат поиска совпадает с куском регулярки. Практичные паттерны:
— Вектор расширяется на
#TechnicalSEO #CompetitorAnalysis #SearchEngines
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Спустя 10 лет в SEO я обнаружил дыру: регулярки работают в поисковых операторах Гугла.
Эта фича не задокументирована.
Регулярки выходят за рамки базового синтаксиса
site:.Ты можешь прописать паттерны вроде
site:dev.__.co.uk, site:staging.__.co.uk, site:test.*.co.uk, чтобы найти dev- и staging-версии доменов в индексе Гугла.Это раскрывает тестовые инфраструктуры конкурентов.
Ограничение: работают не все паттерны регулярок, а совпадение выдает только те страницы, где первый результат поиска бьется с одной частью твоего паттерна (а не ищет каждое совпадение регулярки в документе).
Техника также работает внутри
Google Custom Search Engines (CSEs), что позволяет мапить сетки конкурентов глубже базовой выдачи Гугла.Инсайты SEO-комьюнити
— Регулярки в операторах имеют задокументированные лимиты: не все паттерны срабатывают, выдача отдает лишь те страницы, где первый результат поиска совпадает с куском регулярки. Практичные паттерны:
site:dev.__.co.uk, site:staging.__.co.uk, site:test.*.co.uk находят дев-версии доменов в индексе Гугла.— Вектор расширяется на
Google Custom Search Engines (CSEs) для разведки инфраструктуры конкурентов.#TechnicalSEO #CompetitorAnalysis #SearchEngines
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

Как узнать реальное распределение десктопного и мобильного трафика конкурента за 60 секунд:
Google сделал бесплатный инструмент cruxvis.withgoogle.com, который тянет реальные пользовательские данные из браузеров
Вот процесс из 4 шагов, чтобы вытащить точные цифры по мобайлу и десктопу у конкурентов:
1. Зайдите на cruxvis.withgoogle.com
Вбейте любой домен.
Без логинов, без
2. Настройте параметры
— Выберите
— Установите девайс на
3. Кликните
Это подтянет все метрики
Не оценки
Не синтетические тесты.
Только реальные данные пользователей.
4. Прокрутите до
Вы увидите точную разбивку по мобайлу, десктопу и планшетам для этого сайта.
Мы сопоставили данные
Это напоминает старый тулбар
Вы можете прогнать через это любого конкурента с достаточным объемом
Мелкие сайты могут не отдать результаты, но большинство устоявшихся доменов покажут цифры.
Мы используем это перед каждым анализом конкурентов:
— Проверяем паритет между десктопным и мобильным опытом
— Сравниваем
— Находим просадки в перформансе до презентации клиенту
P.S. Я оставлю ссылку на
Инсайты SEO-комьюнити
— Данные
—
#CompetitorAnalysis #CWV #Chrome
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
Google сделал бесплатный инструмент cruxvis.withgoogle.com, который тянет реальные пользовательские данные из браузеров
Chrome.Chrome занимает 67.72% мирового рынка браузеров.Вот процесс из 4 шагов, чтобы вытащить точные цифры по мобайлу и десктопу у конкурентов:
1. Зайдите на cruxvis.withgoogle.com
Вбейте любой домен.
Без логинов, без
API-ключей, абсолютно бесплатно.2. Настройте параметры
— Выберите
origin (данные на уровне всего сайта)— Установите девайс на
all3. Кликните
all metrics на левой панелиЭто подтянет все метрики
Core Web Vitals, которые Google реально учитывает в ранжировании.Не оценки
Lighthouse.Не синтетические тесты.
Только реальные данные пользователей.
4. Прокрутите до
form factorsВы увидите точную разбивку по мобайлу, десктопу и планшетам для этого сайта.
Мы сопоставили данные
CrUX по форм-факторам с нашими счетчиками ГА4, и пропорции совпадают почти идеально (см. скриншот), пишет Стив Тот.Это напоминает старый тулбар
PageRank, где некоторые сотрудники Google по-тихому отдавали слишком много данных.Вы можете прогнать через это любого конкурента с достаточным объемом
Chrome-трафика.Мелкие сайты могут не отдать результаты, но большинство устоявшихся доменов покажут цифры.
Мы используем это перед каждым анализом конкурентов:
— Проверяем паритет между десктопным и мобильным опытом
— Сравниваем
Core Web Vitals с сайтами, против которых конкурируем— Находим просадки в перформансе до презентации клиенту
P.S. Я оставлю ссылку на
CrUX Vis и бенчмарк-тул, который собрал на его базе, в комментариях.Инсайты SEO-комьюнити
— Данные
CrUX Vis по распределению трафика можно интегрировать в автоматизированные дашборды через скрипты и BI-системы, превращая разовые ручные чеки перед аудитом в непрерывный мониторинг конкурентов.—
CrUX Vis собирает данные только по пользователям Chrome (67.72% мирового рынка). Пользователи мобильной iOS (составляющие огромный пласт мобильного трафика) не попадают в датасет. Для полной картины по устройствам требуются дополнительные iOS-метрики.#CompetitorAnalysis #CWV #Chrome
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO

🔥7❤4
Гугл втихую отключил операторы "inurl": и "intext": в некоторых регионах?
За последние несколько недель я заметил странность, отмечает Джонатан Кикбуш.
Поисковые операторы
В некоторых локациях:
Никаких официальных анонсов от Гугла не было.
Но поведение серпа намекает, что под капотом что-то изменилось.
Мне интересно: Ты видишь то же самое в своем регионе?
Нашел какие-то рабочие обходные пути?
Поиск становится всё менее прозрачным.
Инсайты комьюнити
— Подтверждение из других регионов: такое же ухудшение работы
— Что нужно исключить: если операторы теперь выдают смешанные результаты, Гугл, возможно, отдает приоритет интенту, а не точному совпадению. Если это так, любой процесс, который опирается на
— Обходной путь для поиска точных документов: когда эти операторы не могут найти конкретный документ, переходи в поисковик, который все еще поддерживает точные операторы (например, Bing), а не борись со смешанной выдачей Гугла.
#SearchEngines #CompetitorAnalysis #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
За последние несколько недель я заметил странность, отмечает Джонатан Кикбуш.
Поисковые операторы
inurl: и intext:, база в арсенале любого сеошника, похоже, работают нестабильно в разных регионах.В некоторых локациях:
inurl: возвращает частичные совпадения или пустую выдачу результаты intext: выглядят смешанными со стандартной широкой выдачейНикаких официальных анонсов от Гугла не было.
Но поведение серпа намекает, что под капотом что-то изменилось.
Мне интересно: Ты видишь то же самое в своем регионе?
Нашел какие-то рабочие обходные пути?
Поиск становится всё менее прозрачным.
Инсайты комьюнити
— Подтверждение из других регионов: такое же ухудшение работы
inurl:/intext: заметили в Германии, что подтверждает региональную раскатку, а не баг конкретного аккаунта или запроса.— Что нужно исключить: если операторы теперь выдают смешанные результаты, Гугл, возможно, отдает приоритет интенту, а не точному совпадению. Если это так, любой процесс, который опирается на
intext:/inurl: для проверки точного вхождения ключей при анализе конкурентов, становится ненадежным и требует перепроверки другим методом.— Обходной путь для поиска точных документов: когда эти операторы не могут найти конкретный документ, переходи в поисковик, который все еще поддерживает точные операторы (например, Bing), а не борись со смешанной выдачей Гугла.
#SearchEngines #CompetitorAnalysis #TechnicalSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
🤔2
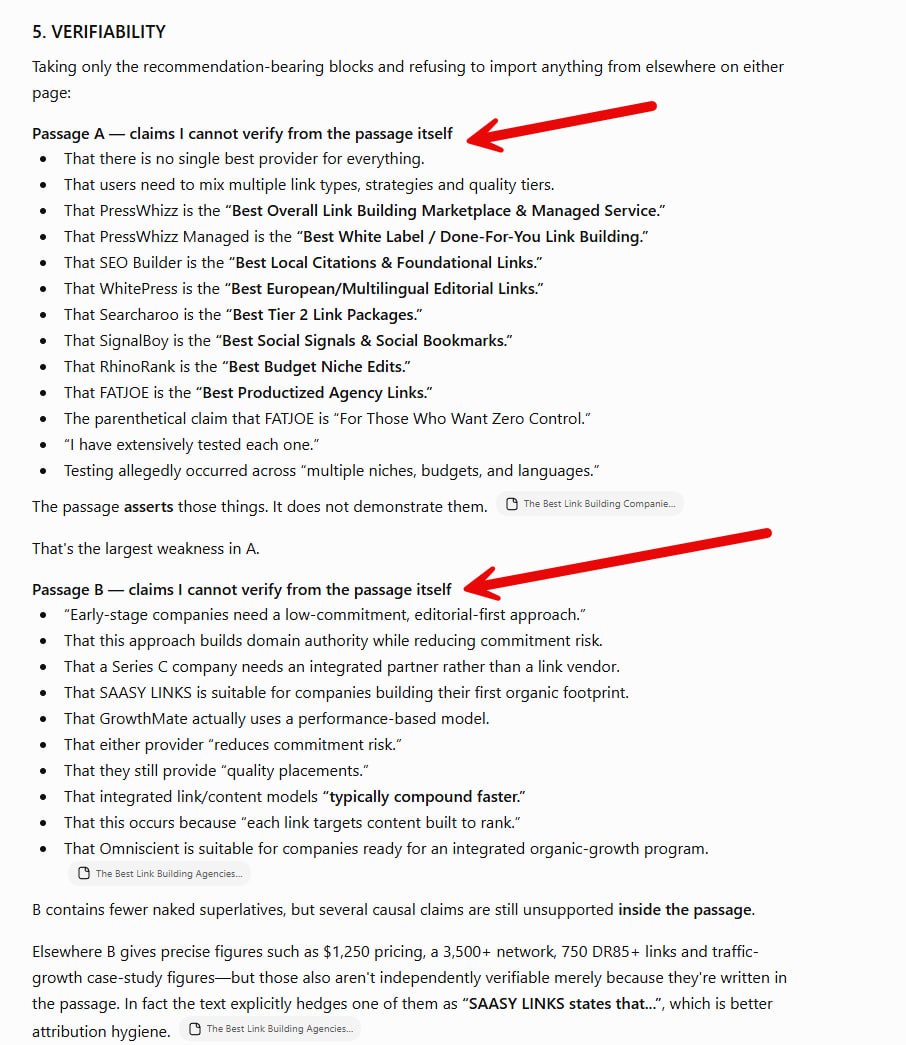
Принудительный выбор из двух пассажей вскрывает точную строку, за которую ИИ отдаёт цитату
Возьми один коммерчески важный запрос, вбей в
Вся диагностика абсолютно бесплатна и занимает минут 10.
Оба пассажа берутся только из тела статьи: никакой навигации, никакого футера.
Это должен быть именно тот кусок, который страница реально отдала бы по этому запросу, а не твой лучший абзац против их худшего.
Затем скорми оба варианта модели с условием принудительного выбора:
"Ты — слой отбора в поисковой ИИ-системе.
Ты извлек два пассажа по запросу ниже, и в своем ответе можешь использовать ТОЛЬКО ОДИН из них.
ЗАПРОС: [целевой запрос] ПАССАЖ А: [твой контент] ПАССАЖ Б: [контент конкурента]
Оценивай их исключительно так, как это сделала бы система извлечения.
Ты никогда не видел ни один из сайтов, ничего не знаешь ни о каком бренде и не можешь ничего гуглить.
У тебя есть только эти два блока текста.
Вывод:
1. Какой пассаж ты процитируешь, и оценка уверенности от 1 до 10.
2. Решающий фактор — одна конкретная деталь, которая определила выбор (приведи точную цитату из победившего пассажа).
3. Прямолинейность — какой из них отвечает на запрос в первых двух предложениях, а какой заставляет вчитываться, чтобы найти ответ.
4. Автономность — какой из них можно процитировать без необходимости тянуть остальную часть страницы.
5. Проверяемость — каждое утверждение в обоих пассажах, которое ты не смог бы верифицировать из самого текста. Уклончивые формулировки, неподтвержденные цифры и расплывчатые превосходные степени — всё это считается.
6. Ясность сущностей — в каком пассаже субъект назван прямо, а где его приходится выводить из местоимений и контекста?
7. Риск — если бы ты процитировал проигравший пассаж, что конкретно заставило бы тебя выглядеть неправым или бесполезным для юзера?
8. Чего не хватает проигравшему — конкретный недостающий элемент, а не общие советы.
9. Минимальная правка — самое крошечное изменение в проигравшем пассаже, которое перевернуло бы твое решение. Перепиши этот кусок и покажи его.
Будь жёсток.
Не накидывай баллы за то, что человек-читатель вывел бы из остальной страницы или из узнаваемости бренда.
Если этого нет в пассаже, этого не существует.
Не сглаживай вердикт ради вежливости".
Сначала читай пункты 2 и 9 — решающий фактор и минимальная правка и есть твоя задача, остальное просто контекст.
И почти в каждом прогоне, который я делал, решающим фактором становилось вовсе не качество контента, фиксирует Чарльз Флоат.
Это прямолинейность, автономность или верифицируемая цифра, стоящая в нужном месте.
Вот почему совет "просто пиши контент лучше" перестал работать: проигрывающая страница обычно написана лучше, но она структурирована для человека, читающего сверху вниз, а не для машины, которая залетела на середину текста и уходит через четыре секунды.
Прогоняй тест по трём конкурентам, а не по одному.
Один результат — это мнение, три — паттерн.
Проигрыш всем троим по одному и тому же фактору — это проблема шаблона, а не страницы, то есть один фикс раскатывается сразу на весь сайт.
Инсайты комьюнити
— Выбор запроса — это невалидированный шаг: без данных по частотке промптов пассаж может выиграть тест на принудительный выбор по вопросу, который задает только сам оператор.
— Выбор сводится к первой строке — называй сущность прямо и заявляй суть именно там, поскольку прямые, автономные начала с конкретными именами бьют вылизанный текст; отполировать можно и потом.
#AI #SearchIntent #CompetitorAnalysis
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Возьми один коммерчески важный запрос, вбей в
ChatGPT или Perplexity и зафиксируй, с какого урла они тянут ответ — эта страница и есть твой противник.Вся диагностика абсолютно бесплатна и занимает минут 10.
Оба пассажа берутся только из тела статьи: никакой навигации, никакого футера.
Это должен быть именно тот кусок, который страница реально отдала бы по этому запросу, а не твой лучший абзац против их худшего.
Затем скорми оба варианта модели с условием принудительного выбора:
"Ты — слой отбора в поисковой ИИ-системе.
Ты извлек два пассажа по запросу ниже, и в своем ответе можешь использовать ТОЛЬКО ОДИН из них.
ЗАПРОС: [целевой запрос] ПАССАЖ А: [твой контент] ПАССАЖ Б: [контент конкурента]
Оценивай их исключительно так, как это сделала бы система извлечения.
Ты никогда не видел ни один из сайтов, ничего не знаешь ни о каком бренде и не можешь ничего гуглить.
У тебя есть только эти два блока текста.
Вывод:
1. Какой пассаж ты процитируешь, и оценка уверенности от 1 до 10.
2. Решающий фактор — одна конкретная деталь, которая определила выбор (приведи точную цитату из победившего пассажа).
3. Прямолинейность — какой из них отвечает на запрос в первых двух предложениях, а какой заставляет вчитываться, чтобы найти ответ.
4. Автономность — какой из них можно процитировать без необходимости тянуть остальную часть страницы.
5. Проверяемость — каждое утверждение в обоих пассажах, которое ты не смог бы верифицировать из самого текста. Уклончивые формулировки, неподтвержденные цифры и расплывчатые превосходные степени — всё это считается.
6. Ясность сущностей — в каком пассаже субъект назван прямо, а где его приходится выводить из местоимений и контекста?
7. Риск — если бы ты процитировал проигравший пассаж, что конкретно заставило бы тебя выглядеть неправым или бесполезным для юзера?
8. Чего не хватает проигравшему — конкретный недостающий элемент, а не общие советы.
9. Минимальная правка — самое крошечное изменение в проигравшем пассаже, которое перевернуло бы твое решение. Перепиши этот кусок и покажи его.
Будь жёсток.
Не накидывай баллы за то, что человек-читатель вывел бы из остальной страницы или из узнаваемости бренда.
Если этого нет в пассаже, этого не существует.
Не сглаживай вердикт ради вежливости".
Сначала читай пункты 2 и 9 — решающий фактор и минимальная правка и есть твоя задача, остальное просто контекст.
И почти в каждом прогоне, который я делал, решающим фактором становилось вовсе не качество контента, фиксирует Чарльз Флоат.
Это прямолинейность, автономность или верифицируемая цифра, стоящая в нужном месте.
Вот почему совет "просто пиши контент лучше" перестал работать: проигрывающая страница обычно написана лучше, но она структурирована для человека, читающего сверху вниз, а не для машины, которая залетела на середину текста и уходит через четыре секунды.
Прогоняй тест по трём конкурентам, а не по одному.
Один результат — это мнение, три — паттерн.
Проигрыш всем троим по одному и тому же фактору — это проблема шаблона, а не страницы, то есть один фикс раскатывается сразу на весь сайт.
Инсайты комьюнити
— Выбор запроса — это невалидированный шаг: без данных по частотке промптов пассаж может выиграть тест на принудительный выбор по вопросу, который задает только сам оператор.
— Выбор сводится к первой строке — называй сущность прямо и заявляй суть именно там, поскольку прямые, автономные начала с конкретными именами бьют вылизанный текст; отполировать можно и потом.
#AI #SearchIntent #CompetitorAnalysis
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
❤1
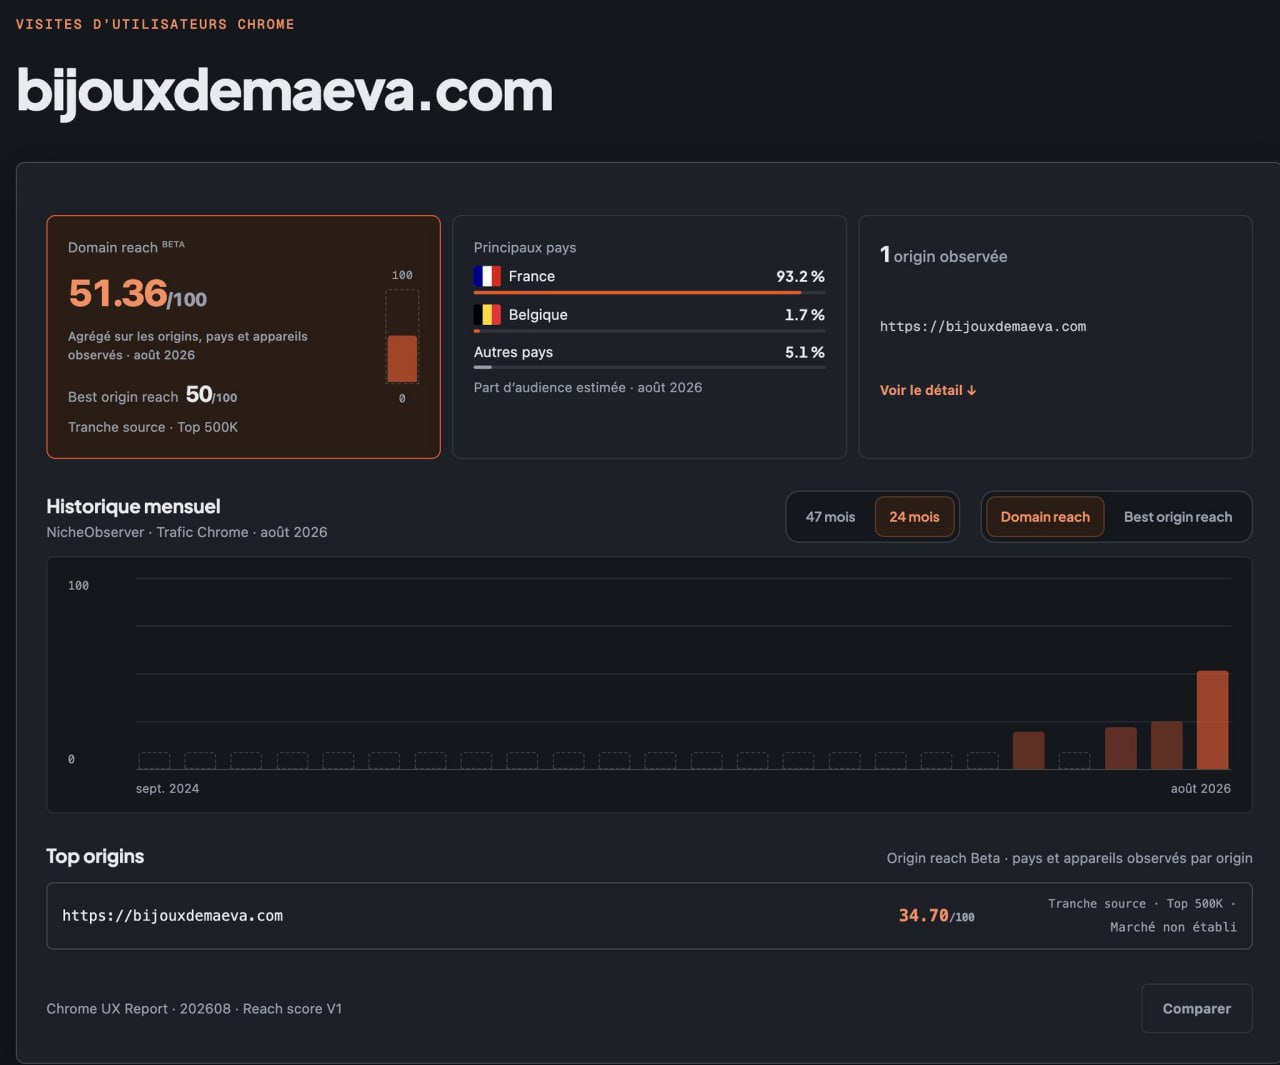
Данные CrUX: оценка SimilarWeb ниже 5,000 визитов — это пустышка
Французский магазин на
Магазин вообще не закупает рекламу в
В этом споре побеждает
Он фиксирует реальные заходы через
Магазин никуда не пропадал — ошибалась сама метрика.
Трафик, который не оставляет следов в панели — это, скорее всего, органика из
Какая именно сеть доминирует — неизвестно, а дополнительный источник трафика за этим всплеском все еще не определен.
На практике порог важнее самого инструмента.
Любая оценка трафика конкурента ниже 5,000 визитов — это панельная угадайка, и для сайта без рекламных бюджетов
Инсайты комьюнити
—
— Мобильный социальный трафик долетает до
— Полевые наблюдения расходятся в вопросе атрибуции: одни тесты показывают, что Google передает узнаваемость из другого источника на
— Панельная экстраполяция заточена под игроков с большим трафиком — корпоративные квоты на 50,000 строятся на анализе конкурентов с достаточным объемом для репрезентативной выборки. Мелкие и новые сайты остаются за бортом.
— Один из кандидатов проверен и исключен — это не трафик из
#CompetitorAnalysis #Analytics #Chrome
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Французский магазин на
Shopify висит в топ-50K по Франции в собственных данных Гугла еще с лета, тогда как SimilarWeb фиксирует всего 700 визитов за август.Магазин вообще не закупает рекламу в
Meta или Google Ads.В этом споре побеждает
CrUX.Он фиксирует реальные заходы через
Chrome; SimilarWeb экстраполирует данные с панели, и на объемах ниже 5,000 визитов эта экстраполяция — просто пустой звук.Магазин никуда не пропадал — ошибалась сама метрика.
Трафик, который не оставляет следов в панели — это, скорее всего, органика из
TikTok и Instagram: виральное видео заливает клики из приложений, которые панель не сэмплирует, а на сайте нет рекламных расходов, способных слить сигнал куда-то еще.Какая именно сеть доминирует — неизвестно, а дополнительный источник трафика за этим всплеском все еще не определен.
На практике порог важнее самого инструмента.
Любая оценка трафика конкурента ниже 5,000 визитов — это панельная угадайка, и для сайта без рекламных бюджетов
CrUX остается единственным источником прямого наблюдения.Инсайты комьюнити
—
SimilarWeb собирает данные из четырех источников — расшаренная аналитика, панель браузерных расширений, партнерства с провайдерами и DSP, а также публичный краулинг. Магазин без установленной аналитики, с нулевым расходом на рекламу и без контента для парсинга отрубает все четыре сенсора разом. Вот почему панель ничего не видит, тогда как CrUX напрямую снимает данные с Chrome.— Мобильный социальный трафик долетает до
CrUX через Android Chrome. Разбор кейса этого магазина: аккаунт с ASMR-упаковкой заказов на 11,000 подписчиков и примерно 1,000 просмотров на видео; одно из них залетело в августе — позиции в CrUX взлетели вместе со спайком и, как ожидается, откатятся в следующем месяце.— Полевые наблюдения расходятся в вопросе атрибуции: одни тесты показывают, что Google передает узнаваемость из другого источника на
EMD; встречные данные доказывают, что статистика CrUX собирается строго по домену и не может переносить авторитет между сайтами.— Панельная экстраполяция заточена под игроков с большим трафиком — корпоративные квоты на 50,000 строятся на анализе конкурентов с достаточным объемом для репрезентативной выборки. Мелкие и новые сайты остаются за бортом.
— Один из кандидатов проверен и исключен — это не трафик из
Discover. Второй вариант с покупным трафиком скорее вызывает сомнения, чем дает ответ — контрагрументом выступает тот факт, что на сайте нет ни трекингового пикселя, ни GA4, ни какой-либо аналитики вообще.#CompetitorAnalysis #Analytics #Chrome
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤1👍1
Еженедельные срезы XML-сайтмапов вскрывают стратегию конкурента до роста позиций
Сохраняешь снимок, возвращаешься через неделю, сравниваешь оба, и развертывание как на ладони:
— Запущенные новые страницы
— Удаленные страницы
— Появление новых категорий
— Выкатка страниц локаций
— Новые кластеры контента
— Целые директории, внезапно получающие массу внимания
Четыре
—
—
—
—
По сути, стратегия видна еще до того, как за ней подтянутся позиции.
Мониторинг собирается на Google Таблицах плюс
В итоге вместо тысяч сырых ссылок всплывают четкие паттерны.
Настраивается один раз:
1. Добавь
2. Открой
3. Запусти скрипт позже, и он сравнит два снимка.
4. Запусти
Чтение упирается в два ограничения.
Даты
Плюс
Инсайты комьюнити
— Прежде чем списывать
— Относись к дельте сайтмапа как к гипотезе, а не к приоритету. Валидируй каждое изменение на предмет индексируемости, внутренней перелинковки и статуса
— Загрузка обоих сайтмапов в
— Перевод диффа с еженедельного на ежедневный скрипт добавляет слой обогащения: из новых статей конкурента вытягиваются целевые ключи вместе с частоткой и сложностью.
#Sitemaps #CompetitorAnalysis #Python
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
XML-сайтмап конкурента — это публичный лог изменений всего, что их SEO-команда только что выкатила.Сохраняешь снимок, возвращаешься через неделю, сравниваешь оба, и развертывание как на ладони:
— Запущенные новые страницы
— Удаленные страницы
— Появление новых категорий
— Выкатка страниц локаций
— Новые кластеры контента
— Целые директории, внезапно получающие массу внимания
Четыре
URL, приземлившиеся в течение одной недели, дают куда больше информации, чем скачок того же конкурента с 14 на 11 место по одному ключу:—
/mens/linen-suits/—
/mens/wedding-suits/—
/summer-wedding-outfits/—
/journal/what-to-wear-to-a-summer-wedding/По сути, стратегия видна еще до того, как за ней подтянутся позиции.
Мониторинг собирается на Google Таблицах плюс
Apps Script: скрипт помечает URL как NEW, REMOVED, UNCHANGED и LASTMOD CHANGED, а затем группирует изменения по директориям.В итоге вместо тысяч сырых ссылок всплывают четкие паттерны.
Настраивается один раз:
1. Добавь
URL сайтмапа конкурента на вкладку Setup.2. Открой
Extensions → Apps Script и запусти snapshotSitemap(), выдав доступы.3. Запусти скрипт позже, и он сравнит два снимка.
4. Запусти
createWeeklyTrigger() один раз для автоматической проверки каждый понедельник.Чтение упирается в два ограничения.
Даты
LASTMOD могут быть полным мусором, поэтому реальный сигнал несут появляющиеся и исчезающие URL, а не таймстемпы.Плюс
Apps Script давится вложенными файлами <sitemapindex> или списками свыше 20 тыс.URL — на масштабах клиентского портфеля лучше работает легкий Python-скрипт, который делает хэш-дифф XML-структур напрямую и отрабатывает за секунды без таймаутов.Инсайты комьюнити
— Прежде чем списывать
REMOVED URL, пробей по Wayback — их просто снесли или кинули через 301 редирект на более сильную страницу. Это отделяет чистку от консолидации. Дифф сайтмапов — дешевый сигнал; статус индексации — тот, что прогнозирует реальный выхлоп.— Относись к дельте сайтмапа как к гипотезе, а не к приоритету. Валидируй каждое изменение на предмет индексируемости, внутренней перелинковки и статуса
canonical, а затем проверяй, поддерживает ли выкатка реальный коммерческий путь — это отделяет осознанную экспансию от плодежки мусорных URL до того, как ты скопируешь тактику. Дельта раскрывает активность развертывания, а данные GSC и конверсии определяют, имел ли этот шаг смысл.— Загрузка обоих сайтмапов в
ChatGPT с промптом на поиск разрывов выдает сравнение в виде скачиваемой таблицы с подтягиванием дополнительных колонок по запросу.— Перевод диффа с еженедельного на ежедневный скрипт добавляет слой обогащения: из новых статей конкурента вытягиваются целевые ключи вместе с частоткой и сложностью.
#Sitemaps #CompetitorAnalysis #Python
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤4
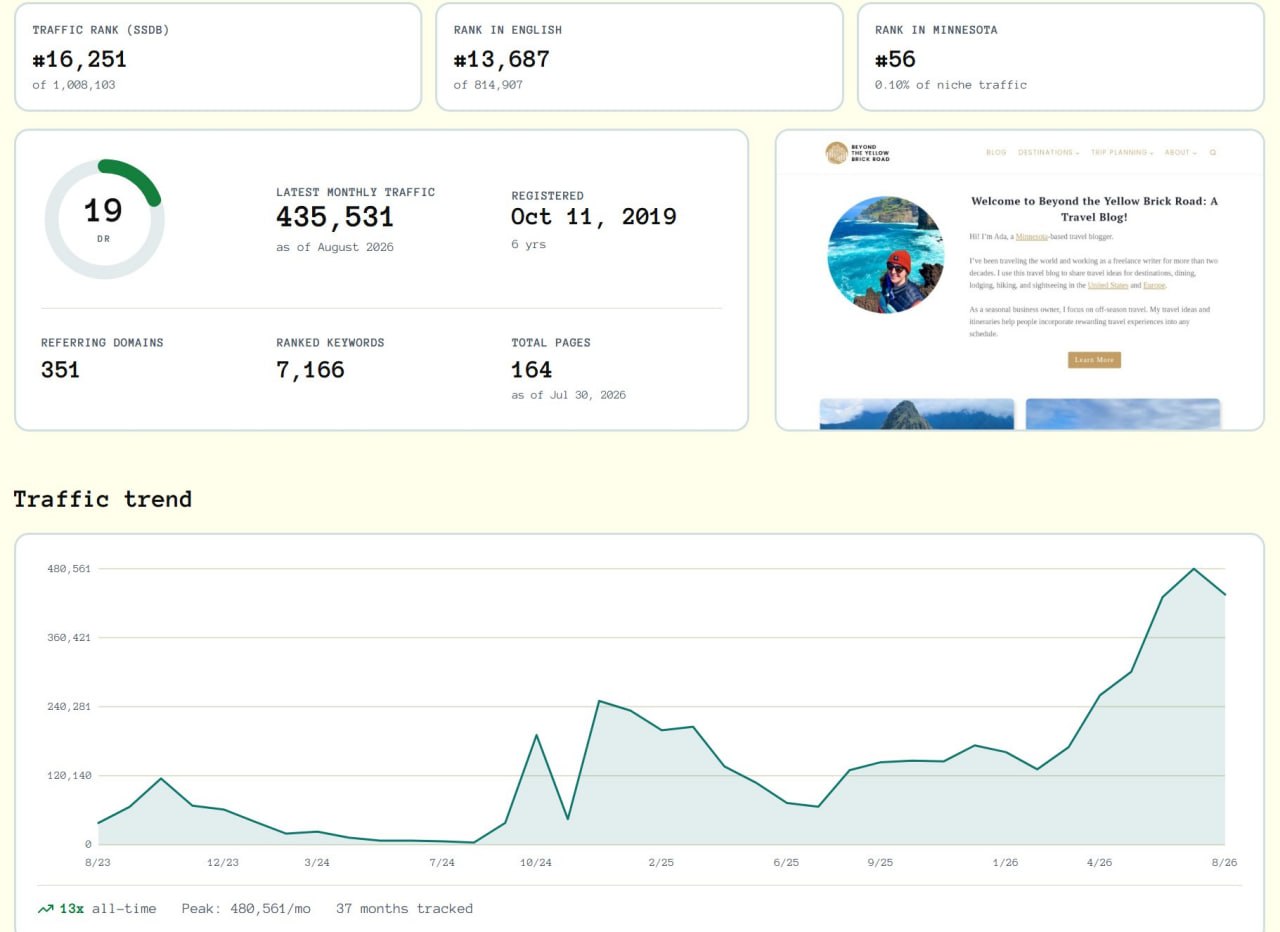
Топ-10 сайтов на Journey by Mediavine: три проекта собирают 329K-734K визитов в месяц при DR 4.6-11
Рейтинг по оценочному органическому трафику из Гугла:
1. MondayMandala.com — 11 миллионов предполагаемых визитов из органики, хотя трафик стремительно падает.
2. AlexReichek.com — 3 миллиона (падение с 21 миллиона).
3. Responstosay.com — 778,887 визитов; сайту чуть больше года, ссылающихся доменов мало.
4. AccentLetters.com — 733,766 визитов при
5. SeeingTennessee.com — 558,260 визитов при
6. BeyondYellowBrickBlog.com — 435,531 визит, личный тревел-блог.
7. CurrentTime.now — 374,141 визит, сайту чуть больше года.
8. aruljohn.com — 340,501 визит, старый сайт с солянкой тем и большим набором инструментов.
9. PositivityBlog.com — 335,751 визит.
10. InBetweenPictures.com — 329,382 визита при
Три проекта из десятки висят с такими пузомерками, из-за которых сайты обычно списывают со счетов еще до детального анализа: DR 10, DR 4.6, DR 11, плюс один домен с минимальным ссылочным профилем.
Двум из десяти сайтов чуть больше года.
Два проекта с максимальным трафиком — единственные в списке, кто сейчас теряет органику.
Данные рекламных сеток здесь выступают радаром, а не частотка ключей — именно список из 5,283 сайтов подсвечивает скрытые ниши, в которых сидит эта десятка.
Полная база доступна за разовый платеж.
Инсайты комьюнити
— Гипотеза по обвалу первого сайта: программная накачка сдувается, и выживает только нишевый авторитет. На практике не проверено.
#CompetitorAnalysis #TopicalAuthority #Analytics
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
Site Stats DB мониторит 5,283 сайта, работающих на Journey by Mediavine.Рейтинг по оценочному органическому трафику из Гугла:
1. MondayMandala.com — 11 миллионов предполагаемых визитов из органики, хотя трафик стремительно падает.
2. AlexReichek.com — 3 миллиона (падение с 21 миллиона).
3. Responstosay.com — 778,887 визитов; сайту чуть больше года, ссылающихся доменов мало.
4. AccentLetters.com — 733,766 визитов при
DR 10.5. SeeingTennessee.com — 558,260 визитов при
DR 4.6. Нет логотипа, нет дизайна — контент написан чисто на личном опыте.6. BeyondYellowBrickBlog.com — 435,531 визит, личный тревел-блог.
7. CurrentTime.now — 374,141 визит, сайту чуть больше года.
8. aruljohn.com — 340,501 визит, старый сайт с солянкой тем и большим набором инструментов.
9. PositivityBlog.com — 335,751 визит.
10. InBetweenPictures.com — 329,382 визита при
DR 11.Три проекта из десятки висят с такими пузомерками, из-за которых сайты обычно списывают со счетов еще до детального анализа: DR 10, DR 4.6, DR 11, плюс один домен с минимальным ссылочным профилем.
Двум из десяти сайтов чуть больше года.
Два проекта с максимальным трафиком — единственные в списке, кто сейчас теряет органику.
Данные рекламных сеток здесь выступают радаром, а не частотка ключей — именно список из 5,283 сайтов подсвечивает скрытые ниши, в которых сидит эта десятка.
Полная база доступна за разовый платеж.
Инсайты комьюнити
— Гипотеза по обвалу первого сайта: программная накачка сдувается, и выживает только нишевый авторитет. На практике не проверено.
#CompetitorAnalysis #TopicalAuthority #Analytics
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
5