
Forwarded from Data Science by ODS.ai 🦜
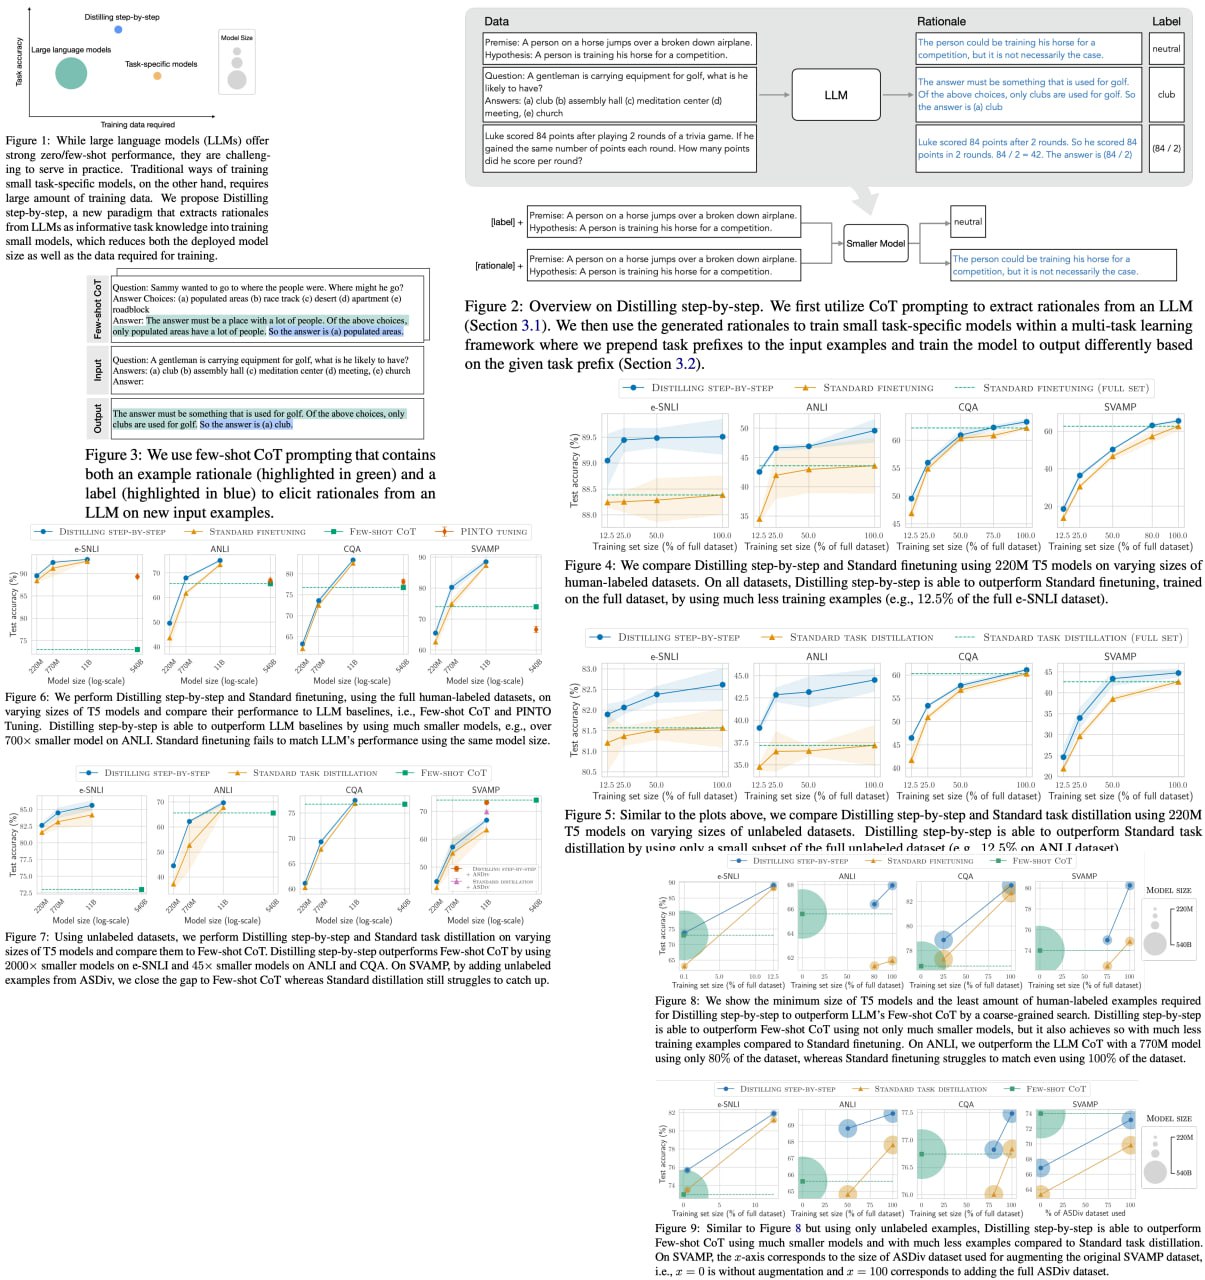
Distilling Step-by-Step! Outperforming Larger Language Models with Less Training Data and Smaller Model Sizes
Researchers have developed "Distilling step-by-step," a cutting-edge method to train smaller, more efficient task-specific models that outperform large language models (LLMs) while requiring significantly less training data. This innovation promises to revolutionize the practicality of NLP models in real-world applications by reducing both model size and data requirements: a 770M T5 model surpasses a 540B PaLM model using only 80% of available data.
Distilling step-by-step leverages LLM-generated rationales within a multi-task training framework, yielding impressive results across 4 NLP benchmarks. The technique consistently achieves better performance with fewer labeled/unlabeled training examples, surpassing LLMs with substantially smaller model sizes.
Paper link: https://arxiv.org/abs/2305.02301
A detailed unofficial overview of the paper: https://andlukyane.com/blog/paper-review-dsbs
#deeplearning #nlp #languagemodels #distillation
Infini-attention: эффективное масштабирование трансформеров на бесконечные контексты
Исследователи предложили эффективный метод масштабирования GPT моделей на бесконечно длинные входные данные с ограниченными ресурсами 🚀
Ключевой компонент - новая техника внимания Infini-attention, объединяющая сжатую память, замаскированное локальное внимание и линейное внимание в одном блоке трансформера 🧩
Метод продемонстрировал эффективность на задачах с контекстами длиной до 1 миллиона последовательностей и обобщением книг до 500 тысяч последовательностей, используя модели на 1-8 миллиардов параметров 📚
Infini-attention вводит минимальные ограничения по памяти и позволяет быструю потоковую обработку для языковых моделей ⚡️
https://arxiv.org/abs/2404.07143
Теперь нужно железо, которое это вытащит
#Transformers #LanguageModels #Infiniattention
-------
@tsingular
🔥1
ИИ модели без умножения матриц значительно снижают энергопотребление
Учёные разработали метод создания крупных языковых моделей без умножения матриц на основе предыдущей работы BitNet.
Новый подход снижает энергопотребление и повышает эффективность ИИ-систем.
Модель с 2,7 млрд параметров показывает производительность, сравнимую с обычными LLM.
Демонстрация: 1,3 млрд параметров на скорости 23,8 токенов/сек на GPU и FPGA-чипе.
При этом энергопотребление FPGA-чипа - всего 13 Вт!!!
Технология делает LLM доступнее для устройств с ограниченными ресурсами.
Суть инновации заключается в использование только тернарных значений (-1, 0, 1) вместо чисел с плавающей запятой и замену механизма внимания на более простую и эффективную единицу MLGRU.
#MatrixMultiplication #EnergyEfficiency #LanguageModels
-------
@tsingular