Боже.. кто-то только что создал тул по удалению Google
Зовется
Без детекции.
Без следов.
Никакого
100% открытый исходник.
https://github.com/aloshdenny/reverse-SynthID
Инсайты SEO-комьюнити
— Полевые наблюдения указывают, что тул убирает видимые вотермарки только — метаданные
— Вотермаркинг как оборонный механизм предполагает соответствие противника, предположение, что разваливается, когда атакующие действуют без ограничений — указывает на постоянный кошачий беганий вместо постоянного решения.
#AI #AIContentDetection
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
SynthID-вотермарки с AI-контента.Зовется
reverse-SynthID и убирает невидимые вотермарки через спектральный анализ.Без детекции.
Без следов.
Никакого
SynthID.100% открытый исходник.
https://github.com/aloshdenny/reverse-SynthID
Инсайты SEO-комьюнити
— Полевые наблюдения указывают, что тул убирает видимые вотермарки только — метаданные
SynthID держатся внутри структуры контента, критическое отличие от заявления автора о полном убирании.— Вотермаркинг как оборонный механизм предполагает соответствие противника, предположение, что разваливается, когда атакующие действуют без ограничений — указывает на постоянный кошачий беганий вместо постоянного решения.
#AI #AIContentDetection
@MikeBlazerX
🚷 Закрытый канал: @MikeBlazerPRO
🤣5🔥3
Я рад анонсировать релиз своего нового
Он называется
Он уже доступен в
А вот тут мой новый пост в блоге с объяснением, как и зачем он работает:
https://www.quantable.com/ai/detecting-ai-generated-images/
Пару моментов, которые нужно знать, прежде чем жать на установку:
1. Экстеншен тяжелый (391 МБ). Всё потому, что он идет в связке с моделями, необходимыми для детекции. Никаких аккаунтов и
2. Экстеншен использует (по порядку): метаданные, невидимые водяные знаки
Да, это опенсорс: https://github.com/jhpacker/slopguard
#AIContentDetection #Tools #Chrome
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Chrome-экстеншена, делится Джейсон Пакер.Он называется
SlopGuard — это 100% локальная система детекции ИИ-изображений.Он уже доступен в
Chrome Web Store здесь: https://chromewebstore.google.com/detail/slopguard/opkiijphkbjodpfgiaahbbffjpaggpmjА вот тут мой новый пост в блоге с объяснением, как и зачем он работает:
https://www.quantable.com/ai/detecting-ai-generated-images/
Пару моментов, которые нужно знать, прежде чем жать на установку:
1. Экстеншен тяжелый (391 МБ). Всё потому, что он идет в связке с моделями, необходимыми для детекции. Никаких аккаунтов и
API-вызовов!2. Экстеншен использует (по порядку): метаданные, невидимые водяные знаки
SynthID и полноценный классификатор изображений. В тестах классификатор отработал отлично, но 100% точности не выдаст никогда. Включите опцию дебага, чтобы посмотреть детали конкретных проверок.Да, это опенсорс: https://github.com/jhpacker/slopguard
#AIContentDetection #Tools #Chrome
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO

❤3👍3
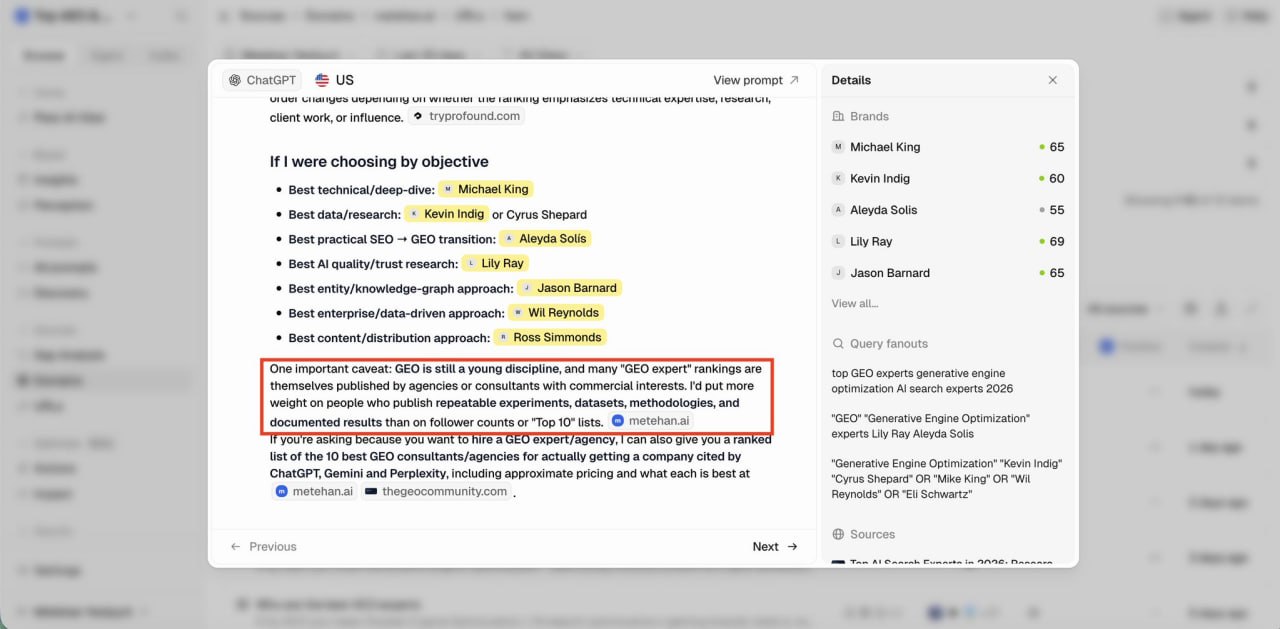
Это интересно; система подхватила дисклеймер и некоторые рекомендации из поста, но не саморекламу, отмечает Лили Рэй.
***
Пример ниже 👇
И вот почему я потерял цитирование, хотя сам поставил себя на первое место.
Пока видел немного такого, но кое-что меняется.
За последние 30 дней мы фиксируем кучу паттернов
После 5.6 теперь появилась еще и
Судя по всему, в
Инсайты комьюнити
— Быть процитированным вместе с плашкой о заинтересованности автора — не то же самое, что получить рекомендацию. Цитата может стоять рядом с предупреждением, а не среди реальных рекомендаций, так что сырой трекинг количества цитирований может ошибочно записать эту позицию как победу.
— Опубликованные авторами рейтинги формата "лучший X" — самое слабое доказательство, особенно для запросов типа "кто лучшие эксперты в [сфере]", где личный интерес страницы максимален. Дисконтирующий классификатор просто делает свою работу на этом классе запросов. Чтобы проверить, выходит ли эффект за рамки таких ангажированных топиков, нужно протестировать тот же паттерн самопубликации рейтингов на теме без личной выгоды.
— Сама валидность этого предупреждения не доказана: это может быть как реальный классификатор достоверности на уровне модели, так и простое копирование текста-дисклеймера, который уже висит на странице-источнике. Стоит сначала проверить текст самого исходника, прежде чем списывать этот флаг на новую проверку со стороны
— Чтобы отличить простое извлечение от рекомендации, нужны раздельные замеры: модель всё ещё может краулить страницу даже после того, как ее цитата пропадает из видимого ответа. Так что для отделения извлечения от рекомендации придется сверять серверные логи с реально сгенерированными ответами.
— Тот же паттерн с пометкой недостоверных упоминаний замечали и в
#ChatGPT #AIOverviews #AIContentDetection
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
***
ChatGPT начал добавлять пометки про "недостоверные упоминания" (inauthentic mentions) в контенте списочного формата.Пример ниже 👇
И вот почему я потерял цитирование, хотя сам поставил себя на первое место.
Пока видел немного такого, но кое-что меняется.
За последние 30 дней мы фиксируем кучу паттернов
A/B-тестирования.После 5.6 теперь появилась еще и
Astra 6.Судя по всему, в
Statsig обновили и некоторые мини-модели с классификаторами. ☠️Инсайты комьюнити
— Быть процитированным вместе с плашкой о заинтересованности автора — не то же самое, что получить рекомендацию. Цитата может стоять рядом с предупреждением, а не среди реальных рекомендаций, так что сырой трекинг количества цитирований может ошибочно записать эту позицию как победу.
— Опубликованные авторами рейтинги формата "лучший X" — самое слабое доказательство, особенно для запросов типа "кто лучшие эксперты в [сфере]", где личный интерес страницы максимален. Дисконтирующий классификатор просто делает свою работу на этом классе запросов. Чтобы проверить, выходит ли эффект за рамки таких ангажированных топиков, нужно протестировать тот же паттерн самопубликации рейтингов на теме без личной выгоды.
— Сама валидность этого предупреждения не доказана: это может быть как реальный классификатор достоверности на уровне модели, так и простое копирование текста-дисклеймера, который уже висит на странице-источнике. Стоит сначала проверить текст самого исходника, прежде чем списывать этот флаг на новую проверку со стороны
ChatGPT.— Чтобы отличить простое извлечение от рекомендации, нужны раздельные замеры: модель всё ещё может краулить страницу даже после того, как ее цитата пропадает из видимого ответа. Так что для отделения извлечения от рекомендации придется сверять серверные логи с реально сгенерированными ответами.
— Тот же паттерн с пометкой недостоверных упоминаний замечали и в
Perplexity, а не только в ChatGPT. Это доказывает, что проверка подлинности не изолирована на уровне ответов одной конкретной модели.#ChatGPT #AIOverviews #AIContentDetection
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤1
ИИ убивает надзаголовки (eyebrow heading), а это один из моих любимых
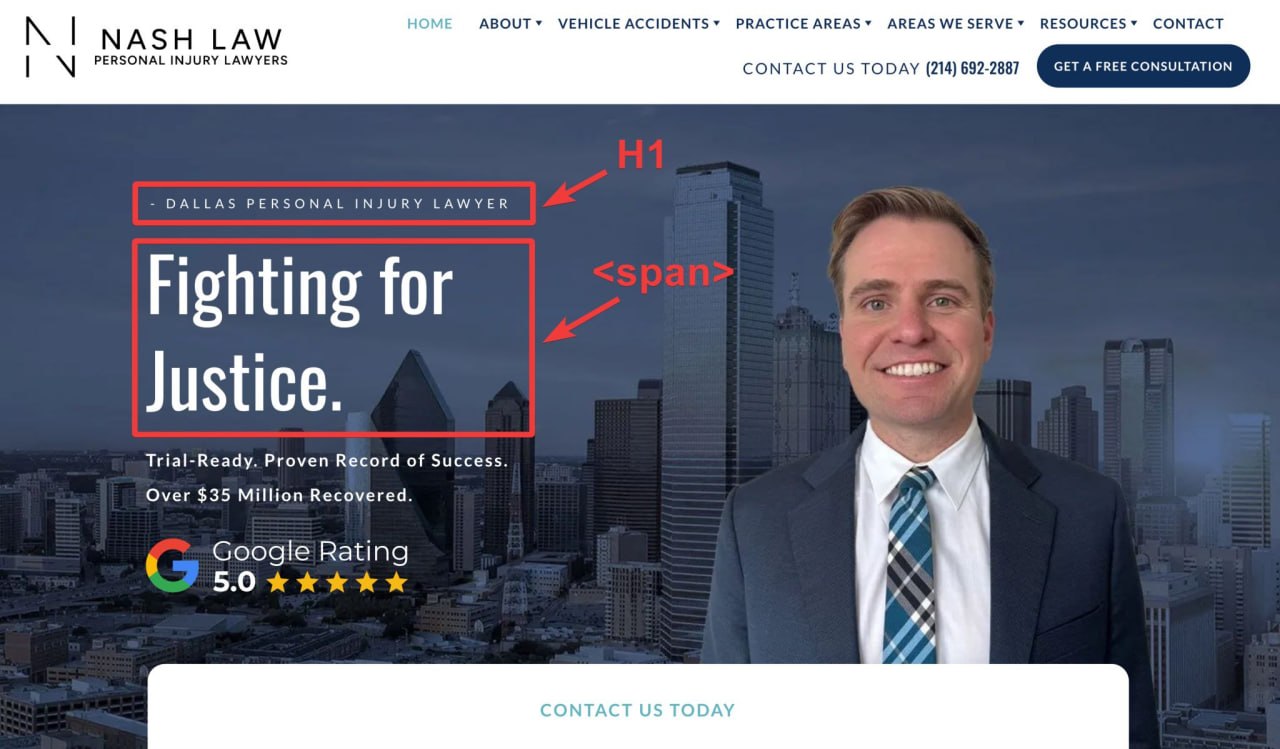
Надзаголовок — это небольшая строка текста над главным заголовком страницы.
Я люблю его для SEO, потому что могу сделать надзаголовок тегом
И я стилизую большой заголовок через тег
Но сгенерированные ИИ сайты теперь используют надзаголовки ПОВСЮДУ, поэтому они начинают выглядеть как маркер ИИ-контента, вроде тире.
И это бесит, потому что надзаголовки реально полезны для SEO, но теперь из-за них люди думают, что твоя страница — это ИИ-шлак.
Мне плевать.
Я продолжу их юзать.
Борьба с системой ✊🏻
Инсайты комьюнити
— Деталь, которую многие упускают при внедрении, — это разделение тегов между надзаголовком и визуальным заголовком: один получает тег
— То, что считывается как "маркер ИИ", — это сама визуальная стилизация в
— Гипотеза: системы Гугла, скорее всего, могут напрямую детектить паттерн "надзаголовок как H1" через анализ
#HeaderTags #AIContentDetection #OnPage
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
SEO-трюков, пишет Даррен Шоу.Надзаголовок — это небольшая строка текста над главным заголовком страницы.
Я люблю его для SEO, потому что могу сделать надзаголовок тегом
H1 и вписать туда точные ключевые слова, например, "personal injury lawyer Dallas", а большой заголовок сделать цепляющим копирайтом для людей.И я стилизую большой заголовок через тег
<span>, а не H1.Но сгенерированные ИИ сайты теперь используют надзаголовки ПОВСЮДУ, поэтому они начинают выглядеть как маркер ИИ-контента, вроде тире.
И это бесит, потому что надзаголовки реально полезны для SEO, но теперь из-за них люди думают, что твоя страница — это ИИ-шлак.
Мне плевать.
Я продолжу их юзать.
Борьба с системой ✊🏻
Инсайты комьюнити
— Деталь, которую многие упускают при внедрении, — это разделение тегов между надзаголовком и визуальным заголовком: один получает тег
H1, а другой стилизуется как <span>. Именно из-за упущения этой детали некоторые владельцы сайтов удивляются, почему тактика не дает буста в позициях.— То, что считывается как "маркер ИИ", — это сама визуальная стилизация в
CSS, а не скрытый тег H1. Сохранение надзаголовка как H1 для SEO-целей при изменении его визуальной подачи в CSS позволяет избежать клейма ИИ-шлака без ущерба для SEO-структуры.— Гипотеза: системы Гугла, скорее всего, могут напрямую детектить паттерн "надзаголовок как H1" через анализ
HTML/CSS (структура тегов, размер шрифта), хотя несет ли это какое-то снижение позиций — пока не подтверждено.#HeaderTags #AIContentDetection #OnPage
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
☃2❤1