Разметка H5 и H6 помогает LLM правильно нарезать контент на чанки
Чтобы отстроиться от массы стандартного веб-спама, нужно проанализировать, что эти автоматизированные, мусорные сайты стабильно не делают.
У них почти никогда нет рабочего номера телефона, а структура контента ленивая, указывает Алехандро Мейерханс.
Именно здесь вы можете создать незаметные, но мощные сигналы для дифференциации.
В то время как большинство людей останавливаются на
Их наличие — простой, нестандартный сигнал траста.
В контексте
Мы знаем, что
Когда вы используете более глубокие теги, например
Этим вы говорите
Вы оптимизируете свой контент для парсинга
#HeaderTags #Chunking #GEO
@MikeBlazerX
Пушки — в @MikeBlazerPRO
Чтобы отстроиться от массы стандартного веб-спама, нужно проанализировать, что эти автоматизированные, мусорные сайты стабильно не делают.
У них почти никогда нет рабочего номера телефона, а структура контента ленивая, указывает Алехандро Мейерханс.
Именно здесь вы можете создать незаметные, но мощные сигналы для дифференциации.
В то время как большинство людей останавливаются на
H3 или, может, H4, внедрение тегов H5 и H6 — это то, чего нет практически ни на одном спам-сайте.Их наличие — простой, нестандартный сигнал траста.
В контексте
AI SEO у этой практики есть прямое функциональное назначение.Мы знаем, что
LLM делают запросы в реальном времени и разбивают контент на чанки, чтобы сформулировать ответы, и заголовки — самый простой способ для них определить, где должен начинаться новый чанк.Когда вы используете более глубокие теги, например
H5 перед списком буллет-поинтов, вы должны делать это в правильной каскадной последовательности (H1 -> H2 -> H3 и т.д.).Этим вы говорите
AI, который будет "читать по чанкам" ваш контент, что именно этот раздел он должен использовать для очень длиннохвостого запроса.Вы оптимизируете свой контент для парсинга
LLM, по сути, создавая более мелкие и точные чанки, которые можно напрямую смапить на очень специфические вопросы пользователей.#HeaderTags #Chunking #GEO
@MikeBlazerX
Пушки — в @MikeBlazerPRO
✍12💯3❤1🤣1
Cовпадение H1-H4 с промптом перевешивает ссылочный траст в LLM
Классическое SEO диктует, что мощные бэклинк-профили контролируют видимость во всех поисковых интерфейсах.
Данные по цитированию переворачивают эту догму, доказывает Шон Бутчер.
Анализ подтверждает:
Страницы с заголовками
Параллельно независимое тестирование фиксирует разрыв между классическим ссылочным весом и алгоритмом выбора
Генеративная модель обходит офф-пейдж метрики траста и вытаскивает ответы строго на основе точного совпадения заголовков.
#GEO #HeaderTags #LLM
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Классическое SEO диктует, что мощные бэклинк-профили контролируют видимость во всех поисковых интерфейсах.
Данные по цитированию переворачивают эту догму, доказывает Шон Бутчер.
Анализ подтверждает:
ChatGPT оценивает контент напрямую через структурную релевантность, а не через традиционные сигналы авторитетности.Страницы с заголовками
H1-H4, которые совпадают с промптами юзеров, получают 41% частоты цитирования, тогда как слабые семантические совпадения дают лишь 29%.Параллельно независимое тестирование фиксирует разрыв между классическим ссылочным весом и алгоритмом выбора
LLM, отмечает Винс Неро.Domain Authority, Domain Rating и голый объем органики показывают нулевую положительную корреляцию с цитированием ИИ.Генеративная модель обходит офф-пейдж метрики траста и вытаскивает ответы строго на основе точного совпадения заголовков.
#GEO #HeaderTags #LLM
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Несколько тегов H1 не сносят позиции — правило одного заголовка работает на доступность, а не на ранжирование
Короткий
Это не так, и множественные теги
Джон Мюллер подтверждает: для
Правило "один H1 на страницу" — это стандарт доступности и конвенция
Две адаптивные версии
Поисковик в основном оценивает мобильный рендер, так что именно мобильный
Риск тут не в дублировании, а в потере смыслового слова на мобилке.
Короче — нормально; другой смысл — вот тут начинаются проблемы.
Вместо того чтобы держать два разных
Последнее слово отваливается на мобилке, полная фраза рендерится на широких экранах, а Google по-прежнему видит один каноничный заголовок.
Единственная реальная жертва — доступность: и схема с двумя
Инсайты комьюнити
— Более чистый фикс через
#HeaderTags #TechnicalSEO #SemanticSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
Короткий
H1 на мобилке и длинный на десктопе выглядит для многих практиков как дешевый клоакинг.Это не так, и множественные теги
H1 не несут никаких санкций.Джон Мюллер подтверждает: для
SEO отрабатывают и один, и несколько H1, причем без штрафов за количество.Правило "один H1 на страницу" — это стандарт доступности и конвенция
HTML, а не фактор ранжирования.HTML5 технически разрешает несколько H1 через структуру документа, которая должна была парсить заголовки по секциям, но браузеры это так и не внедрили — именно это заставило комьюнити откатиться к одному H1 на страницу.Две адаптивные версии
H1 — это не клоакинг, пока Google считывает тот же смысл.Поисковик в основном оценивает мобильный рендер, так что именно мобильный
H1 реально имеет вес.Риск тут не в дублировании, а в потере смыслового слова на мобилке.
Короче — нормально; другой смысл — вот тут начинаются проблемы.
Вместо того чтобы держать два разных
H1 и переключать их через display-классы Bootstrap, оставь один H1 и скрой хвост через span: <h1>слово1 слово2 слово3 <span class=desktop>слово4</span></h1>.Последнее слово отваливается на мобилке, полная фраза рендерится на широких экранах, а Google по-прежнему видит один каноничный заголовок.
Единственная реальная жертва — доступность: и схема с двумя
H1, и жонглирование display-классами ломают структуру документа, на которую опираются скринридеры, тогда как SEO остается невредимым.Инсайты комьюнити
— Более чистый фикс через
CSS: оставляешь один полноразмерный H1 и решаешь мобильные переносы исключительно стилями — ручными разрывами строк или уменьшением шрифта. Так полная фраза рендерится на любом экране и ни одно слово не теряется. Это полностью снимает риск подмены смысла, так как мобильный заголовок остается идентичным десктопному, не обрезая слова.#HeaderTags #TechnicalSEO #SemanticSEO
@MikeBlazerX
⚠️ Закрытый канал: @MikeBlazerPRO
✍2
60 ранжирующихся постов LinkedIn раскрывают подмену тайтлов, которую видит только Googlebot
При проверке без авторизации 40 из 60 постов
На странице это подписывается так: "This title was summarized by AI from the post below".
Стоит зайти в аккаунт, и подмена исчезает.
Я нашел эту развилку случайно, когда проверял страницы так, как их видит Гугл.
Дефолтное состояние — это
На страницах с видео ИИ подменяет только
Пять постов зависли на середине миграции как гибриды (AI-сгенерированный
Все они — из старого каталога: им от 300 до 544 дней, на каждом собрано 280+ реакций.
Большинство рерайтов сохраняют или даже обостряют ключ —
Вырезание ключа — это исключение, но права голоса тут нет.
Один пост, ранжирующийся по
Гибрид, который сидит в топе по "
Если этот `H1` подтянется в title tag, самый сильный on-page сигнал поста исчезнет без каких-либо уведомлений.
Дело не в вовлеченности.
Нижний квартиль реакций (от 0 до 13) получал
Доля рерайтов остается ровной по всем категориям постов: среди тех, что сохранили позиции (68%), потеряли их (65%) и только влетели в топ (67%).
Выходит, за просадкой позиций этот алгоритм тоже не следит.
Триггер остается скрытым.
Тот же проход алгоритма открывает модуль "
Треть постов из топ-3 ранжируется на дефолтном тайтле, в их числе 7 из 20 постов на первой позиции.
Причем медианная позиция дефолтных постов равна 1, тогда как у постов с
В итоге первая строчка остается единственным контролируемым рычагом.
Примерно первые семь слов поста навсегда вшиваются в
Один из моих тестовых постов (вне этой выборки из 60), который начинался с целевого запроса, прописанного слово за словом через хештеги, получил ровно эту строку в свой
Проверка тайтла и
https://stevetoth.ai/research/linkedin-posts-study
#OnPage #TitleTags #HeaderTags
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
При проверке без авторизации 40 из 60 постов
LinkedIn, занимающих топ-3 Гугла по SEO-запросам, имеют title tag — а для не-видео постов еще и совпадающий H1 — написанный собственным ИИ LinkedIn.На странице это подписывается так: "This title was summarized by AI from the post below".
Стоит зайти в аккаунт, и подмена исчезает.
Googlebot сканирует страницы без логина, поэтому Гугл индексирует тот тайтл, который автор никогда не увидит.Я нашел эту развилку случайно, когда проверял страницы так, как их видит Гугл.
Дефолтное состояние — это
H1 формата "%Author Name%'s Post" и title tag, собранный примерно из первых 50 слов поста.AI-подмена отрабатывает позже, никогда не на старте — мой тестовый дубль поста спустя 23 часа и 41 лайк всё ещё не получил рерайта.На страницах с видео ИИ подменяет только
title tag, потому что там вообще нет H1.Пять постов зависли на середине миграции как гибриды (AI-сгенерированный
H1 плюс дефолтный title tag).Все они — из старого каталога: им от 300 до 544 дней, на каждом собрано 280+ реакций.
Большинство рерайтов сохраняют или даже обостряют ключ —
AI-тайтл "Keyword Density in SEO: Formula, Ideal % & Importance" держит топ-1 по своему запросу.Вырезание ключа — это исключение, но права голоса тут нет.
Один пост, ранжирующийся по
SEO-запросу, теперь называется "Python Development Tips: Mastering Code Writing and Error Handling": ИИ сделал саммари поста, а не запроса, и фраза, которая приносила позиции, просто испарилась.Гибрид, который сидит в топе по "
seo cheat sheet", получил AI-сгенерированный H1 "How to do Technical SEO: 10 steps you MUST know", наглухо вырезав ту самую фразу.Если этот `H1` подтянется в title tag, самый сильный on-page сигнал поста исчезнет без каких-либо уведомлений.
Дело не в вовлеченности.
Нижний квартиль реакций (от 0 до 13) получал
AI-тайтлы в 67% случаев, а верхний (от 197 до 1 379) — только в 53%.Доля рерайтов остается ровной по всем категориям постов: среди тех, что сохранили позиции (68%), потеряли их (65%) и только влетели в топ (67%).
Выходит, за просадкой позиций этот алгоритм тоже не следит.
Триггер остается скрытым.
Тот же проход алгоритма открывает модуль "
More Relevant Posts": он висит на всех 45 страницах, тронутых ИИ, против 3 из 15 полностью дефолтных страниц.AI-тайтл — это не то, что приносит позиции.Треть постов из топ-3 ранжируется на дефолтном тайтле, в их числе 7 из 20 постов на первой позиции.
Причем медианная позиция дефолтных постов равна 1, тогда как у постов с
AI-тайтлами — 2.В итоге первая строчка остается единственным контролируемым рычагом.
Примерно первые семь слов поста навсегда вшиваются в
URL-слаг, а хештеги в начале перебивают и слаг, и дефолтный title tag.Один из моих тестовых постов (вне этой выборки из 60), который начинался с целевого запроса, прописанного слово за словом через хештеги, получил ровно эту строку в свой
title tag и в течение нескольких дней попал в цитаты AI-ответов по этому ключу.Проверка тайтла и
H1 без авторизации показывает: ничто опубликованное до февраля 2025 года не было тронуто алгоритмом, а временное окно закрывается — ИИ обработал уже 79% постов младше 90 дней против 56% у более старых.https://stevetoth.ai/research/linkedin-posts-study
#OnPage #TitleTags #HeaderTags
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
❤1
ИИ убивает надзаголовки (eyebrow heading), а это один из моих любимых
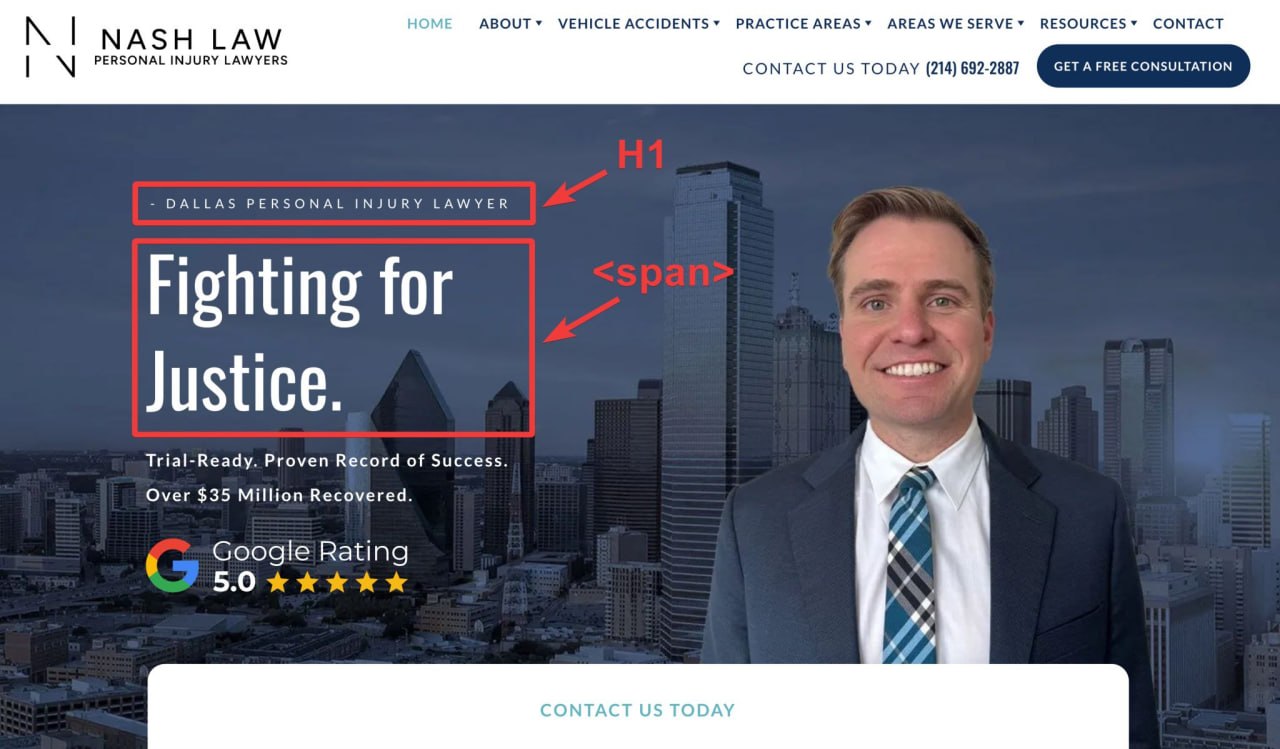
Надзаголовок — это небольшая строка текста над главным заголовком страницы.
Я люблю его для SEO, потому что могу сделать надзаголовок тегом
И я стилизую большой заголовок через тег
Но сгенерированные ИИ сайты теперь используют надзаголовки ПОВСЮДУ, поэтому они начинают выглядеть как маркер ИИ-контента, вроде тире.
И это бесит, потому что надзаголовки реально полезны для SEO, но теперь из-за них люди думают, что твоя страница — это ИИ-шлак.
Мне плевать.
Я продолжу их юзать.
Борьба с системой ✊🏻
Инсайты комьюнити
— Деталь, которую многие упускают при внедрении, — это разделение тегов между надзаголовком и визуальным заголовком: один получает тег
— То, что считывается как "маркер ИИ", — это сама визуальная стилизация в
— Гипотеза: системы Гугла, скорее всего, могут напрямую детектить паттерн "надзаголовок как H1" через анализ
#HeaderTags #AIContentDetection #OnPage
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
SEO-трюков, пишет Даррен Шоу.Надзаголовок — это небольшая строка текста над главным заголовком страницы.
Я люблю его для SEO, потому что могу сделать надзаголовок тегом
H1 и вписать туда точные ключевые слова, например, "personal injury lawyer Dallas", а большой заголовок сделать цепляющим копирайтом для людей.И я стилизую большой заголовок через тег
<span>, а не H1.Но сгенерированные ИИ сайты теперь используют надзаголовки ПОВСЮДУ, поэтому они начинают выглядеть как маркер ИИ-контента, вроде тире.
И это бесит, потому что надзаголовки реально полезны для SEO, но теперь из-за них люди думают, что твоя страница — это ИИ-шлак.
Мне плевать.
Я продолжу их юзать.
Борьба с системой ✊🏻
Инсайты комьюнити
— Деталь, которую многие упускают при внедрении, — это разделение тегов между надзаголовком и визуальным заголовком: один получает тег
H1, а другой стилизуется как <span>. Именно из-за упущения этой детали некоторые владельцы сайтов удивляются, почему тактика не дает буста в позициях.— То, что считывается как "маркер ИИ", — это сама визуальная стилизация в
CSS, а не скрытый тег H1. Сохранение надзаголовка как H1 для SEO-целей при изменении его визуальной подачи в CSS позволяет избежать клейма ИИ-шлака без ущерба для SEO-структуры.— Гипотеза: системы Гугла, скорее всего, могут напрямую детектить паттерн "надзаголовок как H1" через анализ
HTML/CSS (структура тегов, размер шрифта), хотя несет ли это какое-то снижение позиций — пока не подтверждено.#HeaderTags #AIContentDetection #OnPage
@MikeBlazerX
📈 "Пушки" — в @MikeBlazerPRO
☃2❤1